
Pubblicato il
La checklist STROBE-MR è lo standard di reporting di 20 elementi per gli studi che utilizzano varianti genetiche come variabili strumentali per stimare gli effetti causali. Skrivankova e colleghi l'hanno pubblicata nel 2021 come dichiarazione su JAMA e come un lungo articolo di spiegazione ed elaborazione sul BMJ [1] [2] . Gli autori incoraggiano le riviste a richiedere le checklist compilate al momento dell'invio. Questa guida spiega cosa chiede ogni elemento, mostra dove ogni risposta deve essere inserita in un manoscritto e quindi applica ogni elemento a un vero studio di randomizzazione mendeliana ad accesso aperto, riga per riga, con un puntatore di sezione e un verdetto per ciascuno.
In parole semplici
STROBE-MR è un elenco di 20 elementi da riportare negli articoli sulla randomizzazione mendeliana. Richiede agli autori di specificare come sono state scelte le varianti genetiche, quanto sono forti, da dove provengono i due set di dati, se i campioni si sovrappongono, quali test hanno verificato le ipotesi e dove è possibile reperire i dati e il codice. Un lettore dovrebbe essere in grado di valutare lo studio senza dover fare supposizioni. Se un elemento non è applicabile, è necessario specificarlo e motivarne la motivazione.
Cosa comprende la checklist STROBE-MR
STROBE-MR è la controparte della randomizzazione mendeliana delle linee guida STROBE per gli studi osservazionali, che trattiamo nella nostra guida STROBE . Il documento esplicativo illustra i 20 elementi con esempi pubblicati di reporting trasparente e gli autori mantengono la checklist come documento dinamico su un sito web dedicato [1] . L'hanno scritta perché esisteva poco consenso su come riportare questo disegno. Il lavoro empirico che citano ha rilevato che molti report non dichiaravano o non esaminavano le ipotesi di randomizzazione mendeliana e fornivano troppi pochi dettagli sulle loro fonti di dati [1].
Un audit del 2022 mostra quanto fosse ampio il divario. Woolf e colleghi hanno valutato 87 studi a due campioni che utilizzavano la piattaforma MR-Base e hanno riscontrato una rendicontazione generalmente scarsa, con una media del 53% degli elementi riportati per studio. Solo il 44% forniva dettagli sufficienti per valutare l'assunzione di rilevanza, il 31% per l'assunzione di indipendenza e il 32% per le ipotesi dei test di falsificazione, mentre l'89% forniva dettagli sufficienti per la restrizione di esclusione [4] . Tale audit ha utilizzato una propria checklist personalizzata anziché STROBE-MR, quindi le percentuali mostrano ciò che tende a mancare e non rappresentano un punteggio STROBE-MR.
Prima di aprire la checklist, è importante definire l'ambito dello studio. STROBE-MR è destinato ai report di analisi di randomizzazione mendeliana. Uno studio randomizzato segue le linee guida CONSORT, e CONSORT 2025 (30 elementi) ha sostituito CONSORT 2010, come spiegato nella nostra guida CONSORT . Uno studio di coorte o caso-controllo convenzionale segue le linee guida STROBE. Gli autori di STROBE-MR affermano inoltre che la checklist non è uno strumento formale per valutare la qualità dello studio, che non dovrebbe essere trasformata in una scala di qualità e che non è una guida per la progettazione o la conduzione di uno studio [1] . Teniamo presente questo aspetto quando valutiamo l'esempio seguente.
Elementi della checklist STROBE-MR per sezione del manoscritto
La Tabella 1 parafrasa i 20 elementi della checklist STROBE-MR dal documento esplicativo [1] e li raggruppa in base alla sezione del manoscritto a cui appartiene la risposta. I sotto-elementi contrassegnati da lettere sono elencati insieme. La colonna di destra indica un errore comune in ciascun gruppo, in base alla formulazione degli elementi stessi.
| Articolo STROBE-MR | Sezione | Cosa segnalare | Trappola comune |
|---|---|---|---|
| 1 | Titolo e abstract | Quando la randomizzazione mendeliana rappresenta uno degli obiettivi principali dello studio, si deve indicare questo metodo come disegno sperimentale. | Un abstract che menziona solo l'analisi genetica, senza specificare il disegno sperimentale. |
| 2 e 3 | Introduzione | Descrivi l'esposizione, valuta se un nesso causale sia plausibile, spiega perché la randomizzazione mendeliana sia adatta al quesito e indica gli obiettivi, specificando eventuali ipotesi causali predefinite. | Una giustificazione che non spiega mai perché uno studio clinico o una coorte non siano sufficienti. |
| 4 (da a a e) | Metodi, fonti di dati | Per ciascuna fonte, indicare il contesto, i partecipanti e la dimensione del campione, se la potenza statistica è stata calcolata in anticipo, come sono state misurate e filtrate le varianti, come sono state valutate l'esposizione e l'esito e se è stata ottenuta l'approvazione etica. Si consiglia di includere una tabella delle fonti. | Un set di dati denominato solo tramite il suo identificativo, senza alcuna definizione di popolazione o di caso. |
| 5 | Metodi, presupposti | Indicare i tre presupposti fondamentali (rilevanza, indipendenza, restrizione di esclusione) per l'analisi principale, oltre a eventuali presupposti aggiuntivi per le analisi di sensibilità. | Elencare le ipotesi senza specificare come ciascuna sia stata esaminata. |
| 6 (da a a e) | Metodi, analisi principale | Descrivi le unità di misura e la scala, come sono state gestite le varianti e i pesi, lo stimatore e le covariate, i dati mancanti e i test multipli. | Un effetto riportato per unità di una scala non spiegata. |
| 7 e 8 | Metodi, verifiche | Indica quali metodi o conoscenze pregresse supportano le ipotesi ed elenca ogni analisi di sensibilità o analisi aggiuntiva. | Una statistica F considerata come prova della validità degli strumenti. |
| 9 (a e b) | Metodi, software e registrazione | Indicare il software, i pacchetti, le versioni e le impostazioni, specificando se il protocollo è stato registrato, quando e dove. | Un pacchetto denominato senza versione. |
| 10 (da a a d) | Risultati e dati descrittivi | Riportare i numeri in ogni fase, le statistiche riassuntive, l'eterogeneità in qualsiasi fonte sottoposta a meta-analisi e, per i disegni a due campioni, la somiglianza delle associazioni tra varianti ed esposizione e la sovrapposizione tra i campioni. | Silenzio in caso di sovrapposizione quando entrambi i set di dati attingono alla stessa biobanca. |
| 11 (da a a d) | Risultati, principali conclusioni | Riportare le associazioni tra variante ed esposizione e tra variante ed esito, le stime di randomizzazione mendeliana su una scala interpretabile, il rischio assoluto ove pertinente e i grafici. | I valori logaritmici delle probabilità non sono stati convertiti e non è presente alcun grafico dei dati per variante. |
| 12 e 13 | Risultati, verifiche delle ipotesi e analisi di sensibilità | Riportare le verifiche delle ipotesi e le statistiche di eterogeneità, le analisi di sensibilità, eventuali test di direzione causale, il confronto con le stime ottenute tramite randomizzazione non mendeliana e grafici aggiuntivi come quelli del metodo leave-one-out. | Un test di pleiotropia è stato riportato senza alcun commento sulla sua potenza. |
| 14 e 15 | Discussione | Riassumere i risultati principali in relazione agli obiettivi, quindi discutere i limiti, riguardanti le ipotesi, altri bias e imprecisioni, inclusa la direzione e l'entità di eventuali bias. | Limitazioni che elencano i problemi senza specificare in che direzione influiscono sulla stima. |
| 16 e 17 | Discussione | Interpretare con cautela, discutere il meccanismo e l'equivalenza gene-ambiente, la rilevanza clinica e la generalizzabilità ad altre popolazioni, i tempi e i livelli di esposizione. | La formulazione causale è più forte di quanto le ipotesi lascino intendere. |
| 18 a 20 | Altre informazioni | Descrivi i finanziamenti e il ruolo degli enti finanziatori, fornisci l'accesso ai dati e al codice e dichiara eventuali conflitti di interesse. | Il codice è disponibile su richiesta. |
Le voci 4, 6, 10 e 13 della checklist STROBE-MR contengono il maggior numero di sottovoci e rappresentano la parte più impegnativa della stesura del report. I lettori interessati alle statistiche sottostanti possono iniziare consultando i nostri articoli sugli strumenti deboli e la statistica F , sulla pleiotropia e i quattro stimatori standard e il calcolo della potenza che la maggior parte degli articoli omette ; inoltre, la spiegazione della randomizzazione mendeliana illustra il metodo in modo esaustivo.
L'esempio ad accesso aperto che abbiamo utilizzato per la checklist STROBE-MR
Abbiamo scelto uno studio di randomizzazione mendeliana a due campioni pubblicato nell'ottobre 2026 su Endocrinology, Diabetes & Metabolism da Zaka e colleghi [3] . Esso si interroga se la 25-idrossivitamina D sierica geneticamente prevista sia associata al diabete di tipo 2 nei sud-asiatici. Gli autori affermano che il lavoro è riportato in conformità con STROBE-MR e il record PMC non elenca alcun file supplementare, quindi abbiamo valutato il testo completo, le tabelle e le figure rispetto alla checklist STROBE-MR. L'articolo è rilasciato con licenza CC BY 4.0. Crossref elenca la versione del record con tale licenza e Europe PMC e il record ad accesso aperto PMC hanno la stessa licenza.
- Design. Randomizzazione mendeliana a due campioni con statistiche riassuntive dal database OpenGWAS OpenGWAS.
- Esposizione. Livelli sierici di 25-idrossivitamina D provenienti da uno studio GWAS (n = 7,380) condotto su una biobanca britannica dell'Asia meridionale, con analisi strumentale a tre varianti.
- Risultato. Diabete di tipo 2 da una meta-analisi di 16 coorti dell'Asia meridionale (n = 50,533, con 16,677 casi) [5].
- Risultato principale. Odds ratio ponderato per la varianza inversa pari a 1.06 (IC 95% da 0.83 a 1.36) per ogni deviazione standard del livello di 25-idrossivitamina D geneticamente previsto.
Ogni verdetto riportato di seguito rappresenta la nostra interpretazione dell'articolo in relazione al quesito parafrasato. Utilizziamo quattro etichette. " Riportato" significa che l'articolo risponde al quesito con parole proprie. "Valutazione soggettiva" significa che lettori ragionevoli potrebbero avere un'opinione diversa, solitamente perché la risposta è parziale o si trova altrove. " Non presente nell'articolo" significa che non abbiamo trovato alcuna affermazione nel testo completo o nel PDF. " Non applicabile" significa che il quesito dipende da qualcosa che i dati riassuntivi non possono fornire, oppure da un'analisi che l'articolo non ha condotto e non spiega. Le citazioni sono testuali e brevi.
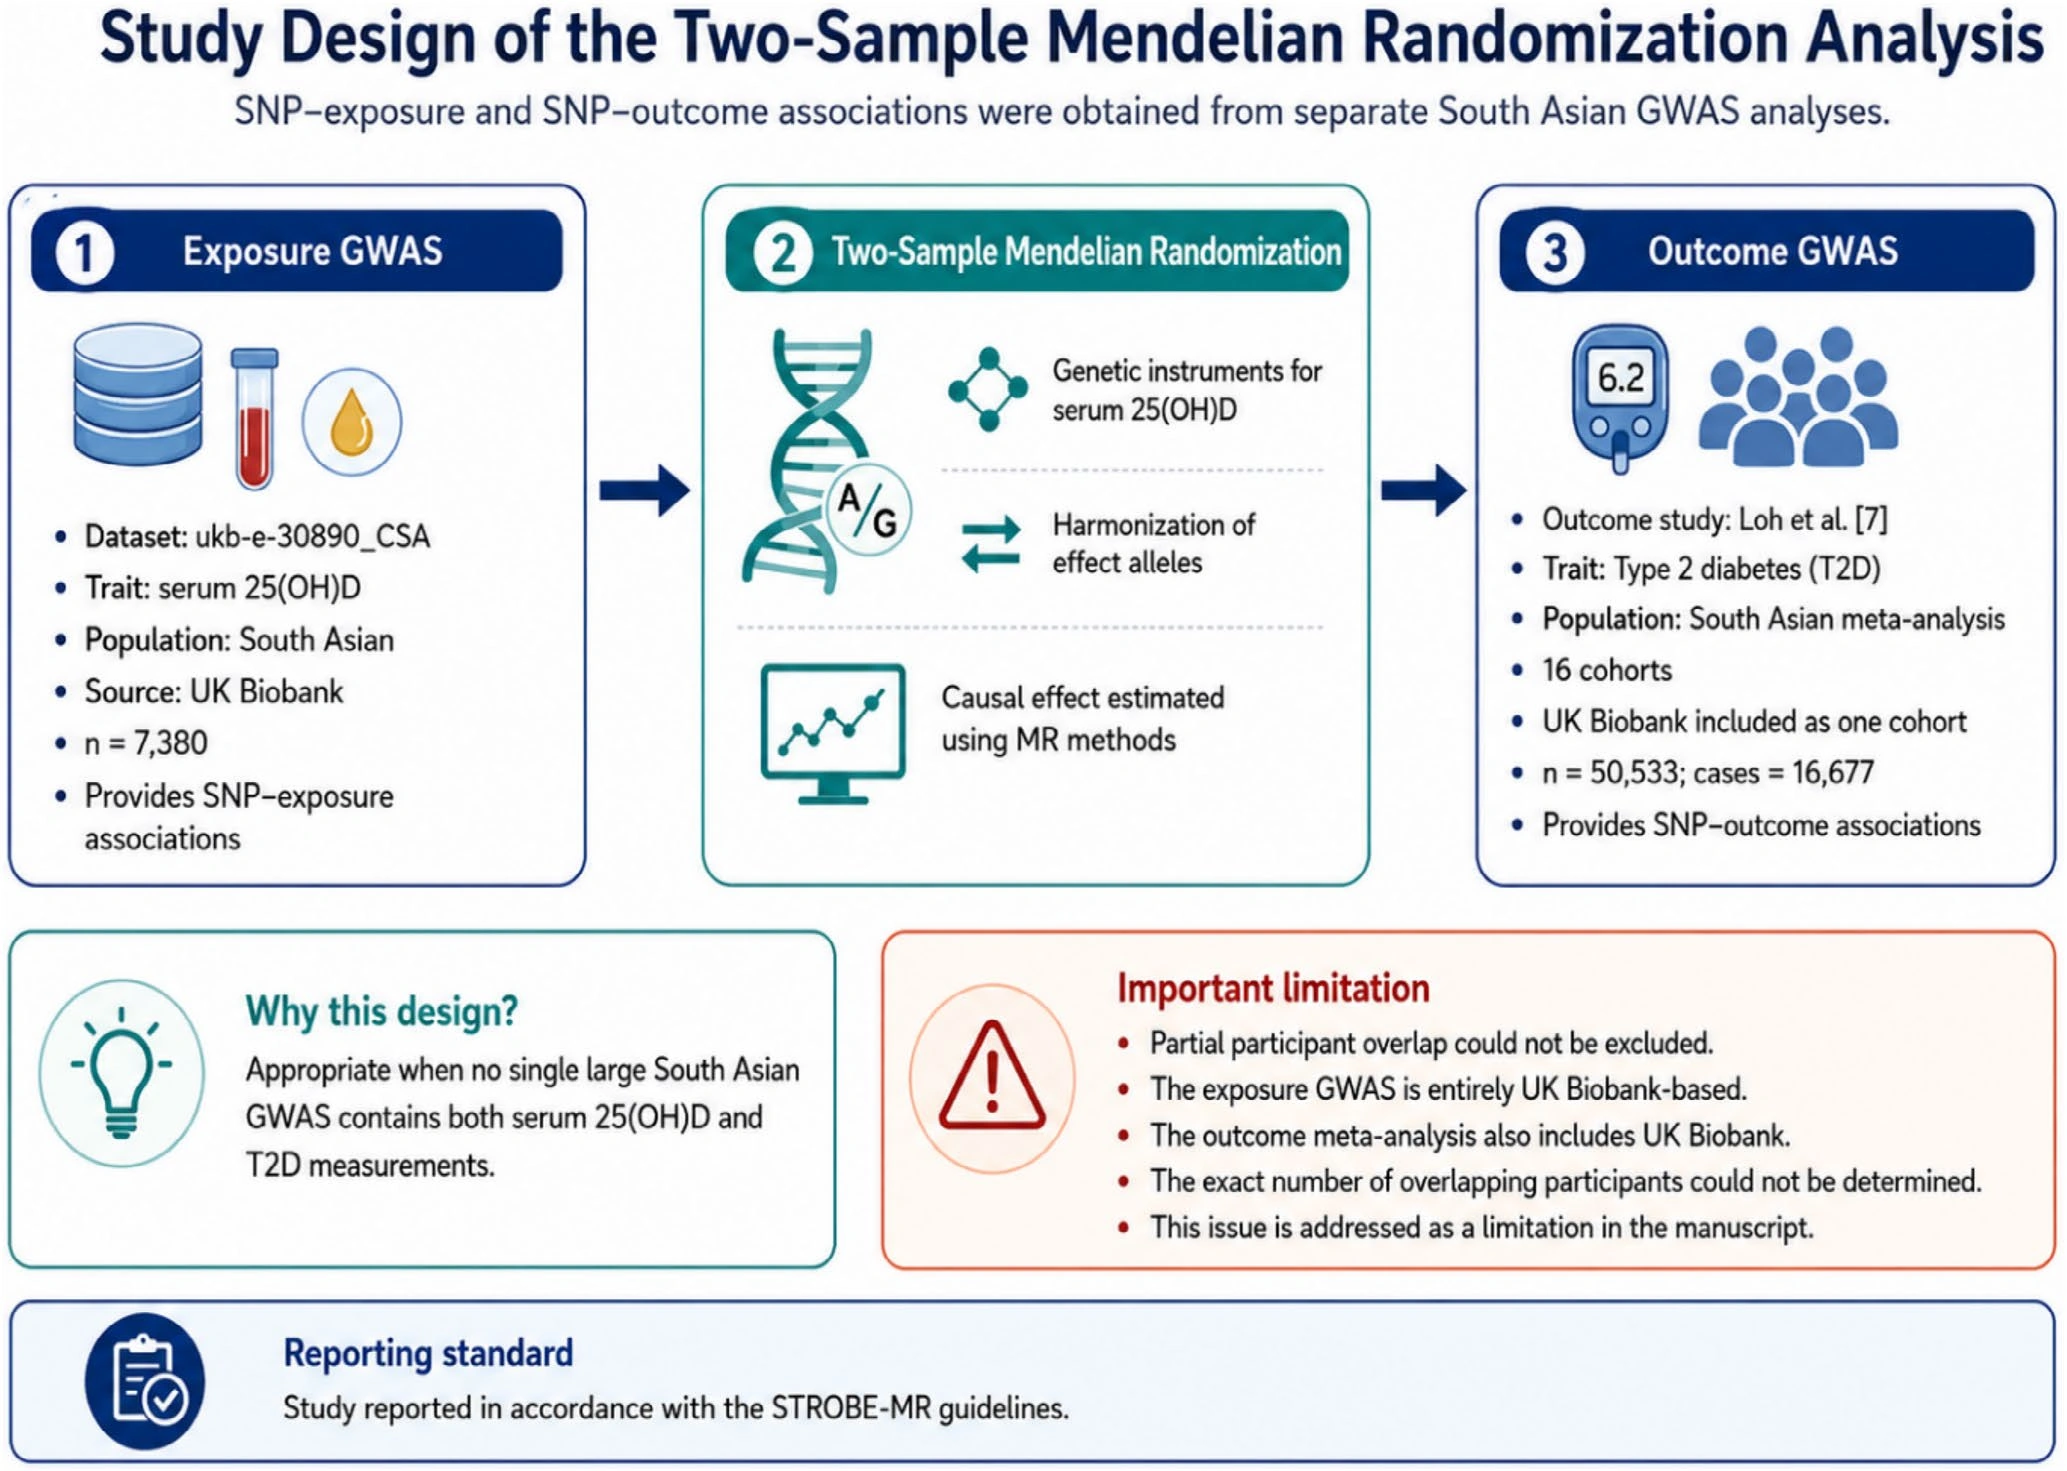
La Figura 1 risponde già in parte al punto 4, poiché mostra entrambe le fonti di dati, le relative dimensioni del campione e il problema della sovrapposizione in un'unica pagina. Si tratta del tipo di riepilogo preliminare della progettazione richiesto dal punto.
Lista di controllo STROBE-MR applicata all'esempio, elemento per elemento
| Articolo | Dove nell'articolo | Cosa fa l'articolo | Giudizio |
|---|---|---|---|
| 1 | titolo; Abstract | Il titolo definisce il disegno di ricerca come uno "Studio esplorativo di randomizzazione mendeliana a due campioni", e l'abstract Metodi si apre con un'analisi a due campioni utilizzando le statistiche riassuntive di OpenGWAS. | Segnalati |
| 2 | Introduzione | Il testo illustra il peso della carenza di vitamina D e del diabete di tipo 2 nell'Asia meridionale, un meccanismo che coinvolge i recettori nelle cellule beta pancreatiche, il problema dei fattori confondenti e della causalità inversa nei dati osservazionali e le argomentazioni a favore della randomizzazione mendeliana. | Segnalati |
| 3 | Fine dell'introduzione | Lo scopo dichiarato è "valutare l'associazione tra i livelli di vitamina D geneticamente predetti e il rischio di diabete di tipo 2 nelle popolazioni dell'Asia meridionale". L'obiettivo parla di associazione, ma non viene formulata alcuna ipotesi causale predefinita. | Decisione di giudizio |
| 4 | Sezione 2.1; Tabella 1; Figura 2 dell'articolo | Presenta il progetto fin dalle prime fasi, con una tabella contenente gli identificativi del set di dati, le caratteristiche, l'ascendenza e la dimensione del campione, oltre a un diagramma del progetto. | Segnalati |
| 4a | Sezioni 2.1 e 2.2 | Vengono citati lo studio GWAS sull'esposizione (sottoinsieme della UK Biobank per l'Asia meridionale) e la meta-analisi degli esiti di 16 coorti. I periodi di reclutamento e i contesti delle coorti partecipanti sono riportati negli articoli originali. | Decisione di giudizio |
| 4b | Sezione 2.2; Tabella 1; Sezione 2.6 | Vengono fornite le dimensioni del campione e la definizione del caso di diabete di tipo 2. Il calcolo della potenza statistica è descritto come post hoc, mentre la domanda chiede se sia stato effettuato prima dell'analisi principale. | Decisione di giudizio |
| 4c | Unità 2.3 | Riporta la soglia a livello dell'intero genoma, la soglia rilassata utilizzata per due varianti, il raggruppamento a r2 inferiore a 0.001 in una finestra di 10,000 kb rispetto a un pannello di riferimento dell'Asia meridionale, la gestione dei proxy e dei palindromi e la costruzione del genoma. | Segnalati |
| 4d | Unità 2.2 | Il testo definisce il diabete di tipo 2 in base all'anamnesi o al trattamento, alla glicemia a digiuno, alla glicemia a 2 ore o all'HbA1c, e specifica la scala normalizzata per rango della 25-idrossivitamina D. Il metodo di laboratorio per la misurazione dell'esposizione non è descritto. | Decisione di giudizio |
| 4e | Sezione 2.2; Dichiarazione etica | Si afferma che il lavoro consiste in un'analisi secondaria di dati riassuntivi pubblici e che "non era richiesta un'approvazione etica formale". | Segnalati |
| 5 | Unità 2.4 | Vengono elencati rilevanza, restrizione di esclusione e indipendenza come i tre presupposti fondamentali. I presupposti alla base degli stimatori di sensibilità compaiono solo come nota nella Tabella 3 (almeno il 50% di varianti valide per la mediana ponderata). | Decisione di giudizio |
| 6a | Sezioni 2.3 e 2.5 | Riporta gli effetti per 1 deviazione standard dell'esposizione normalizzata per rango, come log-odds convertiti in odds ratio. | Segnalati |
| 6b | Sezioni 2.3 e 2.5 | Tratta la singola variante a livello genomico come uno strumento basato sul rapporto di Wald e il set di tre varianti con pesi inversamente proporzionali alla varianza. | Segnalati |
| 6c | Unità 2.5 | Vengono indicati gli stimatori. L'articolo non specifica quali covariate siano state utilizzate in entrambi gli studi GWAS. | Decisione di giudizio |
| 6d | Unità 2.3 | Si afferma che tutte e tre le varianti erano disponibili nei dati relativi ai risultati e che non erano necessari indicatori indiretti. Non viene fornita alcuna indicazione più ampia sui dati mancanti. | Decisione di giudizio |
| 6e | Nessuna dichiarazione trovata | L'analisi si concentra su un'unica esposizione e un unico esito, quindi l'elemento potrebbe non essere rilevante, ma l'articolo non ne parla. | Decisione di giudizio |
| 7 | Sezioni 2.3 e 2.4 | Utilizza le statistiche F e la varianza spiegata per variante e afferma che "F > 10 indica una forza dello strumento convenzionale accettabile, ma non stabilisce di per sé le ipotesi di indipendenza o di esclusione-restrizione". | Segnalati |
| 8 | Sezioni 2.5 e 3.4 | Pianifica MR-Egger, mediana ponderata, modalità semplice e modalità ponderata, quindi aggiunge le esecuzioni a due soglie rilassate (varianti 68 e 18) e un risultato aggiustato per l'IMC. | Segnalati |
| 9a | Unità 2.5 | Si fa riferimento a R 4.3.1, al pacchetto TwoSampleMR versione 0.7.0 e al framework mRnd per il calcolo della potenza. | Segnalati |
| 9b | Nessuna dichiarazione trovata | Non compare alcuna dichiarazione di registrazione, sebbene l'analisi corretta per l'indice di massa corporea (BMI) sia definita "predefinita". | Non presente nell'articolo |
| 10a | Tabella 1 | Sono stati utilizzati dati di sintesi, quindi non esiste un flusso di partecipanti. La Tabella 1 riporta le dimensioni. | Non applicabile |
| 10b | Sezione 2.2; Tabella 1 | Vengono fornite le dimensioni del campione e la frazione di casi (0.330). Non vengono forniti la media o la deviazione standard dell'esposizione. | Decisione di giudizio |
| 10c | Unità 2.1 | Il risultato combina 16 coorti e non emerge alcuna statistica di eterogeneità tra di esse. L'articolo originale potrebbe riportarne una. | Decisione di giudizio |
| 10d (i) | Unità 2.1 | Entrambi i set di dati provengono dall'Asia meridionale e l'articolo spiega perché fosse necessario un disegno sperimentale a due campioni. Non confronta le associazioni tra varianti genetiche ed esposizione tra i due campioni. | Decisione di giudizio |
| 10d (ii) | Sezione 2.1; Sezione 5 | Afferma che "Il numero esatto di partecipanti sovrapposti alla UK Biobank non ha potuto essere determinato dal rapporto pubblicato o dai suoi dati supplementari", quindi limita il possibile bias con una proporzione di sovrapposizione nel caso peggiore pari a 0.146. | Decisione di giudizio |
| 11a | Tabella 2; Figura 3 dell'articolo | Gli effetti dell'esposizione alle varianti, gli errori standard e i valori p sono riportati nella Tabella 2. Gli effetti delle varianti sull'esito sono presenti solo nel grafico a dispersione. | Decisione di giudizio |
| 11b | Sezione 3.3; Tabella 3 | Riporta un odds ratio di 1.06 (IC 95% da 0.83 a 1.36) per 1 DS, con p = 0.630, su una scala interpretabile. | Segnalati |
| 11c | Nessuna dichiarazione trovata | Non si verifica alcuna conversione in rischio assoluto, il che si adatta a una stima primaria nulla, ma l'articolo non ne spiega il motivo. | Decisione di giudizio |
| 11d | Figure 3 e 4 dell'articolo | Fornisce un grafico a dispersione con linee per ogni stimatore e un grafico a imbuto. Non viene mostrato alcun grafico a foresta delle stime per variante. | Segnalati |
| 12a | Sezioni 3.1 e 3.2 | Il rapporto riporta valori di F-statistic compresi tra 26.4 e 33.4, Q p = 0.403 e un'intercetta di Egger p = 0.462, e aggiunge che "un'intercetta non significativa non dovrebbe essere interpretata come una prova rassicurante dell'assenza di pleiotropia orizzontale". | Segnalati |
| 12b | Sezione 3.2; Tabelle 3 e 4 | Fornisce il Q di Cochran per IVW e MR-Egger nell'analisi principale e per IVW alle due soglie rilassate. | Segnalati |
| 13a | Sezioni 3.4 e 3.5; Tabelle 3 e 4 | Vengono riportati quattro stimatori alternativi, due soglie meno restrittive e il risultato corretto in base all'indice di massa corporea (BMI). | Segnalati |
| 13b | Sezioni 3.5 e 3.6; Tabella 5 | Riporta l'analisi aggiustata per l'IMC e una potenza statistica di circa il 18%, il 51% e oltre il 99% per odds ratio di 1.1, 1.2 e 1.5. | Segnalati |
| 13c | Unità 2.3 | Non è stato effettuato alcun test di direzione causale. L'articolo afferma che non è stato applicato il filtro di Steiger e ne spiega il motivo, ovvero la conoscenza biologica pregressa degli strumenti. | Non applicabile |
| 13d | Unità 4.1 | Il testo confronta il risultato con studi di randomizzazione mendeliana precedenti e studi di integrazione, utilizzando le parole. Non viene calcolata alcuna stima basata su randomizzazione non mendeliana. | Decisione di giudizio |
| 13e | Unità 5 | Non mostra un grafico leave-one-out e afferma che le analisi MR-PRESSO e leave-one-out "non potevano essere eseguite con precisione adeguata". | Decisione di giudizio |
| 14 | Sezione 4, paragrafo introduttivo | Ribadisce il risultato nullo rispetto all'obiettivo e osserva che la stima MR-Egger era troppo imprecisa per confermarlo. | Segnalati |
| 15 | Unità 5 | Elenca sette limitazioni e, per la sovrapposizione dei campioni, stima l'entità del possibile bias utilizzando un approccio di delimitazione. | Segnalati |
| 16a | Sezioni 3.3, 4.1 e 6 | Interpreta il risultato nullo come "l'assenza di un'associazione rilevabile entro la precisione consentita dagli strumenti attuali" e lo confronta con lavori precedenti. | Segnalati |
| 16b | Unità 4.2 | Vengono proposte tre spiegazioni, tra cui gli effetti non lineari. Il termine equivalenza gene-ambiente non viene utilizzato. | Decisione di giudizio |
| 16c | Unità 4.3 | Sostiene che l'integrazione alimentare finalizzata alla prevenzione del diabete di tipo 2 non sia supportata dalle attuali evidenze causali e che non si possano escludere altri benefici. | Segnalati |
| 17 | Sezioni 4.2 e 5 | Si noti che i partecipanti residenti nel Regno Unito potrebbero differire dalle persone residenti in Pakistan, che l'esposizione genetica per tutta la vita è diversa dagli studi a tempo limitato e che i metodi lineari non possono rilevare effetti non lineari. | Segnalati |
| 18 | Nessuna dichiarazione trovata | Nel testo integrale e nel PDF non è presente alcuna indicazione sui finanziamenti, e Crossref non elenca alcun ente finanziatore per l'articolo. | Non presente nell'articolo |
| 19 | Dichiarazione sulla disponibilità dei dati | Fornisce gli identificativi OpenGWAS. Per il codice, indica che lo script e il dataset "vengono depositati in un repository pubblico", e il link deve essere aggiunto in seguito. | Decisione di giudizio |
| 20 | Conflitto di interessi | Si dichiara che gli autori non hanno alcun conflitto di interessi. | Segnalati |
Nelle 44 righe della checklist STROBE-MR, 22 sono "Segnalate", 18 sono "Valutazioni soggettive", 2 sono "Non presenti nell'articolo" e 2 sono "Non applicabili". Il conteggio descrive il grado di trasparenza dell'articolo rispetto agli elementi parafrasati e non rappresenta un punteggio di qualità. Diverse "Valutazioni soggettive" provengono da sotto-elementi che la checklist stessa contrassegna come condizionali.
Due righe meritano una nota sul metodo. Per il punto 4b, il documento esplicativo chiede se sia stato effettuato un calcolo di potenza prima dell'analisi principale, e un calcolo a posteriori risponde a una domanda diversa, quindi lo abbiamo contrassegnato come una valutazione discrezionale piuttosto che come una lacuna. Per il punto 19, l'articolo fornisce identificatori di dati che chiunque può seguire, ma la sua dichiarazione di codice è una promessa, e una promessa non può essere verificata.
Cosa mostrano i numeri nell'esempio
Una checklist per la redazione dei report è utile in parte perché permette al lettore di ricostruire i dati. Abbiamo ricavato nuovamente le quantità principali nella Tabella 3 dai valori riportati nell'articolo. Laddove coincidono, la rendicontazione è internamente coerente, che è proprio ciò che la checklist STROBE-MR si propone di rendere possibile. Laddove differiscono, l'elemento da verificare è quello che chiede agli autori di specificare i metodi e le impostazioni utilizzati.
| Quantità | La nostra derivazione dai valori stampati | Articoli | Commento |
|---|---|---|---|
| Statistica F, variante rs3755967 | (0.099 / 0.017)2 = 33.9 | 33.4 | Entro l'arrotondamento dell'errore standard visualizzato |
| Statistica F, variante rs2459139 | (0.108 / 0.020)2 = 29.2 | 29.0 | All'interno dell'arrotondamento |
| Statistica F, variante rs72744878 | (0.101 / 0.020)2 = 25.5 | 26.4 | Nell'ambito dell'arrotondamento, poiché un errore standard di 0.0197 viene stampato come 0.020 e dà 26.4 |
| Statistica F media | (33.4 + 29.0 + 26.4) / 3 = 29.6 | 29.6 | partita |
| Varianza totale spiegata | 0.405 + 0.342 + 0.309 = 1.056% | 1.06% | partita |
| rapporto di probabilità IVW | exp(0.058) = 1.06 | 1.06 | partita |
| Valore p IVW | z = 0.058 / 0.120 = 0.483, p = 0.629 | 0.630 | partita |
| Intervallo IVW 95% | exp(0.058 ± 1.96 × 0.120) = da 0.84 a 1.34 | 0.83 a 1.36 | Valutazione soggettiva. L'articolo non specifica come è stato calcolato l'intervallo. |
| Altri intervalli di stima | Mediana ponderata, modalità semplice, modalità ponderata e MR-Egger | Come stampato | Corrispondenza quando ricalcolato da ciascun beta ed errore standard |
L'unica differenza degna di nota riguarda l'intervallo IVW. Il valore riportato, compreso tra 0.83 e 1.36, corrisponde anche alla stima IVW aggiustata per BMI (beta 0.062, errore standard 0.125), mentre la stima primaria con errore standard 0.120 fornisce un intervallo compreso tra 0.84 e 1.34. La differenza è minima, ma l'arrotondamento dei valori stampati non può spiegarla, poiché un intervallo compreso tra 0.83 e 1.36 richiede un errore standard vicino a 0.126. Un metodo di calcolo dell'intervallo diverso, come ad esempio uno che sovrastima l'errore standard in presenza di eterogeneità, potrebbe essere una possibile spiegazione. Il punto 6 richiede agli autori di descrivere lo stimatore e le relative statistiche, e una clausola che specifichi il metodo di calcolo dell'intervallo eliminerebbe la domanda. Nella sezione relativa alle limitazioni, il passaggio sulla sovrapposizione riporta anche un bias pari a circa lo 0.32% e circa il 5.6% della stima IVW, quindi il lettore deve dedurre quale denominatore venga utilizzato in ciascun valore.
Quattro lezioni di reporting tratte dall'esempio della checklist STROBE-MR
L'esempio contiene quattro insegnamenti applicabili a qualsiasi checklist STROBE-MR tu completi.
Indica cosa non sei riuscito a ottenere e quantifica lo scenario peggiore.
La sovrapposizione dei campioni è l'elemento che più spesso viene descritto in modo vago. In questo caso, il GWAS sull'esposizione è interamente basato sui dati della UK Biobank e la meta-analisi sull'esito include anch'essa i dati della UK Biobank; gli autori scrivono che "Il numero esatto di partecipanti sovrapposti della UK Biobank non ha potuto essere determinato dal rapporto pubblicato o dai suoi dati supplementari". Successivamente, segnalano che lo strumento MRlap non ha funzionato perché il passaggio di covarianza ha restituito valori indefiniti e sostituiscono il calcolo con un limite con una proporzione di sovrapposizione ipotizzata di 0.146 e una correlazione fenotipica di -0.12. Questo è esattamente ciò che richiede l'elemento 10d, ovvero un numero laddove esiste e un limite laddove non esiste.
Distinguere la forza dello strumento dalla validità dello strumento.
L'articolo afferma che "F > 10 indica una forza dello strumento convenzionale accettabile, ma non stabilisce di per sé le ipotesi di indipendenza o di esclusione-restrizione". Il documento esplicativo fa un punto correlato, ovvero che una statistica F superiore a 10 non esclude la distorsione dovuta a strumenti deboli, e paragona la regola empirica a un valore limite per i p-value [1] . Scrivere entrambe le parti della frase protegge il documento da un revisore che interpreta la statistica F come un verdetto.
Diciamo quando una diagnostica non ha potenza
Con tre varianti, l'intercetta MR-Egger ha un grado di libertà residuo. Gli autori scrivono che "un'intercetta non significativa non dovrebbe essere interpretata come una prova rassicurante dell'assenza di pleiotropia orizzontale". Un test di pleiotropia riportato senza questa frase induce a pensare che lo studio sia privo di pleiotropia. Il nostro articolo su cosa protegge ciascuno stimatore di pleiotropia spiega perché il numero di varianti limita ciascun metodo.
Chiudere il cerchio tra Metodi, Limitazioni e l'elenco di riferimenti
Quattro dettagli nell'articolo pubblicato susciterebbero l'interesse di un redattore. La Sezione 2.3 afferma che il filtro di direzionalità di Steiger non è stato applicato, eppure la Sezione 5 afferma che i suoi dettagli "dovrebbero essere confermati e riportati nella sezione Metodi finale", il che suona come una nota di bozza. La Dichiarazione sulla disponibilità dei dati promette un link al repository che non è ancora presente nel testo. La figura del progetto (la nostra Figura 1) cita lo studio sui risultati come riferimento 7, mentre l'elenco delle referenze lo indica come riferimento 9, e il riferimento 7 è una revisione di Davey Smith e Hemani. L'approccio di sovrapposizione dei limiti è attribuito a Burgess e colleghi come riferimento 11, e l'elenco mostra il riferimento 11 come l'articolo sull'interpretazione di MR-Egger di Burgess e Thompson. Nessuno di questi dettagli altera i risultati. Tutto è correggibile in una revisione finale delle bozze, motivo per cui consigliamo di verificare ogni segnaposto e numero di citazione rispetto alla checklist prima dell'invio.
Come compilare la propria checklist STROBE-MR
La checklist STROBE-MR funziona al meglio se compilata durante la stesura del manoscritto, non dopo una richiesta da parte di un revisore. I passaggi seguenti seguono l'ordine in cui le risposte sono generalmente disponibili.
- Scarica la checklist dal Sito web di STROBE-MR o dal documento esplicativo [1]e aggiungi una colonna per la pagina o la sezione in cui si trova ciascuna risposta.
- Nella sezione Metodi, create una tabella delle fonti dati all'inizio, includendo gli identificativi del set di dati, il tratto, l'ascendenza, la dimensione del campione, il numero dei casi e la versione del genoma, come mostrato nell'esempio nella Tabella 1.
- Scrivi la frase relativa alla sovrapposizione anche quando la sovrapposizione è pari a zero. Se non puoi calcolarla, indica un limite.
- Riporta le statistiche F e la varianza spiegata per ciascuna variante, quindi aggiungi un'indicazione sulla potenza statistica per la dimensione dell'effetto rilevante.
- Indicare lo stato di registrazione, includendo una dichiarazione esplicita di mancata registrazione qualora sia questo il caso, poiché il punto 9b richiede una dichiarazione in entrambi i casi.
- Deposita il codice e il dataset armonizzato prima dell'invio e sostituisci ogni segnaposto con un link.
- Per le righe non pertinenti, scrivi una breve descrizione del motivo nella riga corrispondente anziché lasciarla vuota.
- Nella sezione Metodi, specificate che lo studio ha seguito il protocollo STROBE-MR e allegate la checklist compilata se richiesto dalla rivista. lista di controllo per la presentazione del manoscritto elenca gli altri file previsti dagli editor.
Errori comuni nella presentazione di uno studio di randomizzazione mendeliana
Questi sono gli errori che ci aspettiamo di riscontrare più spesso quando una checklist STROBE-MR viene compilata in ritardo, e ognuno di essi corrisponde a una voce specifica.
- Denominare i set di dati senza descriverli. Il punto 4 richiede la popolazione, le date, la dimensione del campione e la definizione del caso per ciascuna fonte.
- Riportare solo lo stimatore principale. I punti 8 e 13 richiedono ogni analisi di sensibilità, comprese quelle che non concordano.
- Tralasciando lo stato di registrazione. Il punto 9b richiede una dichiarazione in entrambi i sensi.
- Utilizzando un linguaggio causale, le ipotesi non possono essere sostenute. Il punto 16 chiede agli autori di affermare che le stime sono causali solo in presenza di ipotesi specificate.
- Codice promettente. L'elemento 19 richiede il codice o la sua posizione, e un collegamento futuro non è una posizione.
Domande frequenti sulla checklist STROBE-MR
Quanti elementi contiene la checklist STROBE-MR?
La checklist STROBE-MR ha 20 elementi, e molti di essi hanno sotto-elementi contrassegnati da lettere, quindi un modulo compilato ha più di 20 righe [1].
STROBE-MR sostituisce la checklist STROBE?
Per uno studio di randomizzazione mendeliana, la linea guida da seguire è STROBE-MR. Per uno studio osservazionale convenzionale, si utilizza STROBE, di cui si parla nel nostro tutorial.
È opportuno utilizzare STROBE-MR per valutare la qualità di uno studio pubblicato?
No. Gli autori affermano che la checklist STROBE-MR non dovrebbe essere trasformata in una scala di qualità e che esiste per rendere possibile la valutazione piuttosto che per eseguirla [1].
È necessario un calcolo della potenza per soddisfare il punto 4b?
Il punto 4b della checklist STROBE-MR richiede agli autori di indicare la dimensione del campione e se è stato effettuato un calcolo della potenza statistica o della dimensione del campione prima dell'analisi principale. Affermare che non è stato effettuato alcun calcolo è una risposta valida, e un calcolo a posteriori deve essere indicato come tale, come nell'esempio.
Strumenti di ricerca gratuiti da Editverse
- GraphProCrea grafici pronti per la pubblicazione, di 25 tipologie diverse, con test t, ANOVA, correlazione e valori p del chi-quadrato integrati. Gratuito, senza registrazione.
- StatiProCalcolatori statistici gratuiti e uno strumento di selezione dei test che copre confronti tra gruppi, risultati categorici, analisi del tempo all'evento e accuratezza diagnostica.
- Flowchart Pro: Genera diagrammi di flusso PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE e ARRIVE direttamente nel tuo browser.
Supporto professionale per un manoscritto sulla randomizzazione mendeliana
Una checklist può registrare solo ciò che l'analisi già contiene. Che tu stia pianificando l'analisi o preparandoti a completare la checklist STROBE-MR, Editverse supporta gli autori in entrambe le fasi e il nostro lavoro segue le linee guida COPE, ICMJE e GPP 2022, nel rispetto dei requisiti etici istituzionali e specifici del paese. Il pacchetto completo dello studio qui sotto include una checklist STROBE-MR compilata.
Prima di impegnarti
$450
Un analista senior verifica se la tua domanda ha già trovato risposta, se i dati la supportano e se disponi della potenza statistica necessaria, inclusa la robustezza dello strumento, per un disegno di randomizzazione mendeliana. Il lavoro verrà interamente accreditato per qualsiasi studio tu commissioni. 5 giorni lavorativi.
studio completo
$2,900
Randomizzazione mendeliana a due campioni da statistiche riassuntive GWAS pubbliche, con forza dello strumento, filtro di Steiger, quattro stimatori che analizzano la pleiotropia, MR-PRESSO, manoscritto, grafici, codice eseguibile TwoSampleMR e una checklist STROBE-MR. 15 giorni lavorativi.
Inviaci la bozza e la rivista a cui desideri inviare il tuo lavoro, e ti diremo quale delle due è più adatta alla tua situazione.
Conclusione
La checklist STROBE-MR trasforma un articolo sulla randomizzazione mendeliana da una semplice serie di risultati in qualcosa che il lettore può verificare. Applicata a uno studio reale ad accesso aperto, mostra come si presenta una buona rendicontazione, con casi peggiori quantificati, note oneste sui test a bassa potenza e un diagramma del disegno sperimentale nella prima pagina dei Metodi, e mostra dove anche un articolo accurato presenta delle lacune, ovvero registrazione, finanziamenti, covariate e codice. Completa la checklist prima dell'invio, scrivi una motivazione per ogni riga non pertinente e controlla ogni segnaposto e numero di citazione nelle bozze finali.
Referenze
- Skrivankova VW, Richmond RC, Woolf BAR, Davies NM, Swanson SA, VanderWeele TJ, et al. Rafforzamento della rendicontazione degli studi osservazionali in epidemiologia mediante randomizzazione mendeliana (STROBE-MR): spiegazione e approfondimento. BMJ2021;375:n2233. doi:10.1136/bmj.n2233. PMID 34702754. PMC8546498.
- Skrivankova VW, Richmond RC, Woolf BAR, Yarmolinsky J, Davies NM, Swanson SA, et al. Rafforzare la rendicontazione degli studi osservazionali in epidemiologia mediante la randomizzazione mendeliana. La dichiarazione STROBE-MR. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID 34698778.
- Zaka A, Khan S, Shah A, Khalid AA, Khalil I, Kamrul-Hasan ABM. Associazione tra livelli di 25-idrossivitamina D geneticamente predetti e rischio di diabete di tipo 2 nei sud-asiatici. Uno studio esplorativo di randomizzazione mendeliana su due campioni. Metab. 2026;9(6):e70359. doi:10.1002/edm2.70359. PMID 42912852. PMCID PMC13690357Licenza CC BY 4.0.
- Woolf B, Di Cara N, Moreno-Stokoe C, Skrivankova V, Drax K, Higgins JPT, et al. Indagine sulla trasparenza della rendicontazione nei dati riassuntivi a due campioni degli studi di randomizzazione mendeliana utilizzando la piattaforma MR-Base. Int J Epidemiol. 2022;51(6):1943-1956. doi:10.1093/ije/dyac074. PMID35383846. PMC9749715.
- Loh M, Zhang W, Ng HK, Schmid K, Lamri A, Tong L, et al. Identificazione degli effetti genetici alla base del diabete di tipo 2 nelle popolazioni dell'Asia meridionale e dell'Europa. Comune biologico. 2022; 5: 329. doi:10.1038/s42003-022-03248-5PMID 35393509.
Il testo delle linee guida è una parafrasi del documento esplicativo STROBE-MR, pubblicato sotto licenza CC BY 4.0. Le raccomandazioni dell'ICMJE sono disponibili sul sito icmje.org.