
En bref : une méta-analyse regroupe les estimations d’effet de plusieurs études en un résultat pondéré. Le processus en douze étapes comprend : une question PICO, une recherche systématique, une évaluation par deux relecteurs à l’aide d’un diagramme de flux PRISMA, une extraction standardisée des données, une évaluation du risque de biais (RoB 2 ou ROBINS-I), la sélection de la mesure d’effet, un modèle à effets aléatoires ou à effets fixes, la mise en commun des résultats par un graphique en forêt, le test d’hétérogénéité (I²) et le test du biais de publication (test d’Egger), l’évaluation de la certitude GRADE et la rédaction d’un rapport conforme aux recommandations PRISMA 2020. Des calculateurs gratuits pour chaque étape sont disponibles.
Une méta-analyse transforme un ensemble d'études distinctes en un résultat unique et fiable, dont la fiabilité dépend de la rigueur des douze étapes qui la sous-tendent. Qu'il s'agisse d'une première synthèse quantitative pour un chapitre de thèse ou d'un perfectionnement d'un protocole existant, la séquence ci-dessous décrit le parcours, de la formulation de la question à la rédaction d'un rapport prêt à être publié, en respectant scrupuleusement les seuils statistiques, les outils et les normes de présentation que les pairs examinent en premier lieu.
Qu'est-ce qu'une méta-analyse ?
Une méta-analyse est une technique statistique qui combine les résultats quantitatifs de plusieurs études indépendantes en une estimation globale de l'effet. Puisqu'elle tire parti de la puissance statistique de chaque étude incluse, une méta-analyse bien menée produit des intervalles de confiance plus étroits que n'importe quel essai individuel, peut mettre en évidence des effets trop faibles pour être détectés de manière fiable par les études individuelles et permet aux chercheurs de quantifier formellement le degré de divergence entre les études plutôt que de simplement l'affirmer.
La méta-analyse est une méthode statistique, et non un type de revue. Elle est presque toujours réalisée dans le cadre d'une revue systématique , qui garantit un processus de recherche et de sélection transparent et reproductible, condition essentielle à la justification de la mise en commun des données. Considérer les deux termes comme interchangeables est un moyen sûr de susciter l'objection des évaluateurs.
En termes simples : imaginez cinq petites études testant chacune l’efficacité d’un médicament pour faire baisser la tension artérielle. Prises individuellement, aucune ne compte suffisamment de patients pour être pleinement convaincantes. Une méta-analyse fait la moyenne de leurs résultats, en accordant une plus grande importance aux études les plus vastes et les plus précises ; ainsi, la réponse combinée est plus fiable que celle de chaque étude prise isolément.
Feuille de route de la méta-analyse
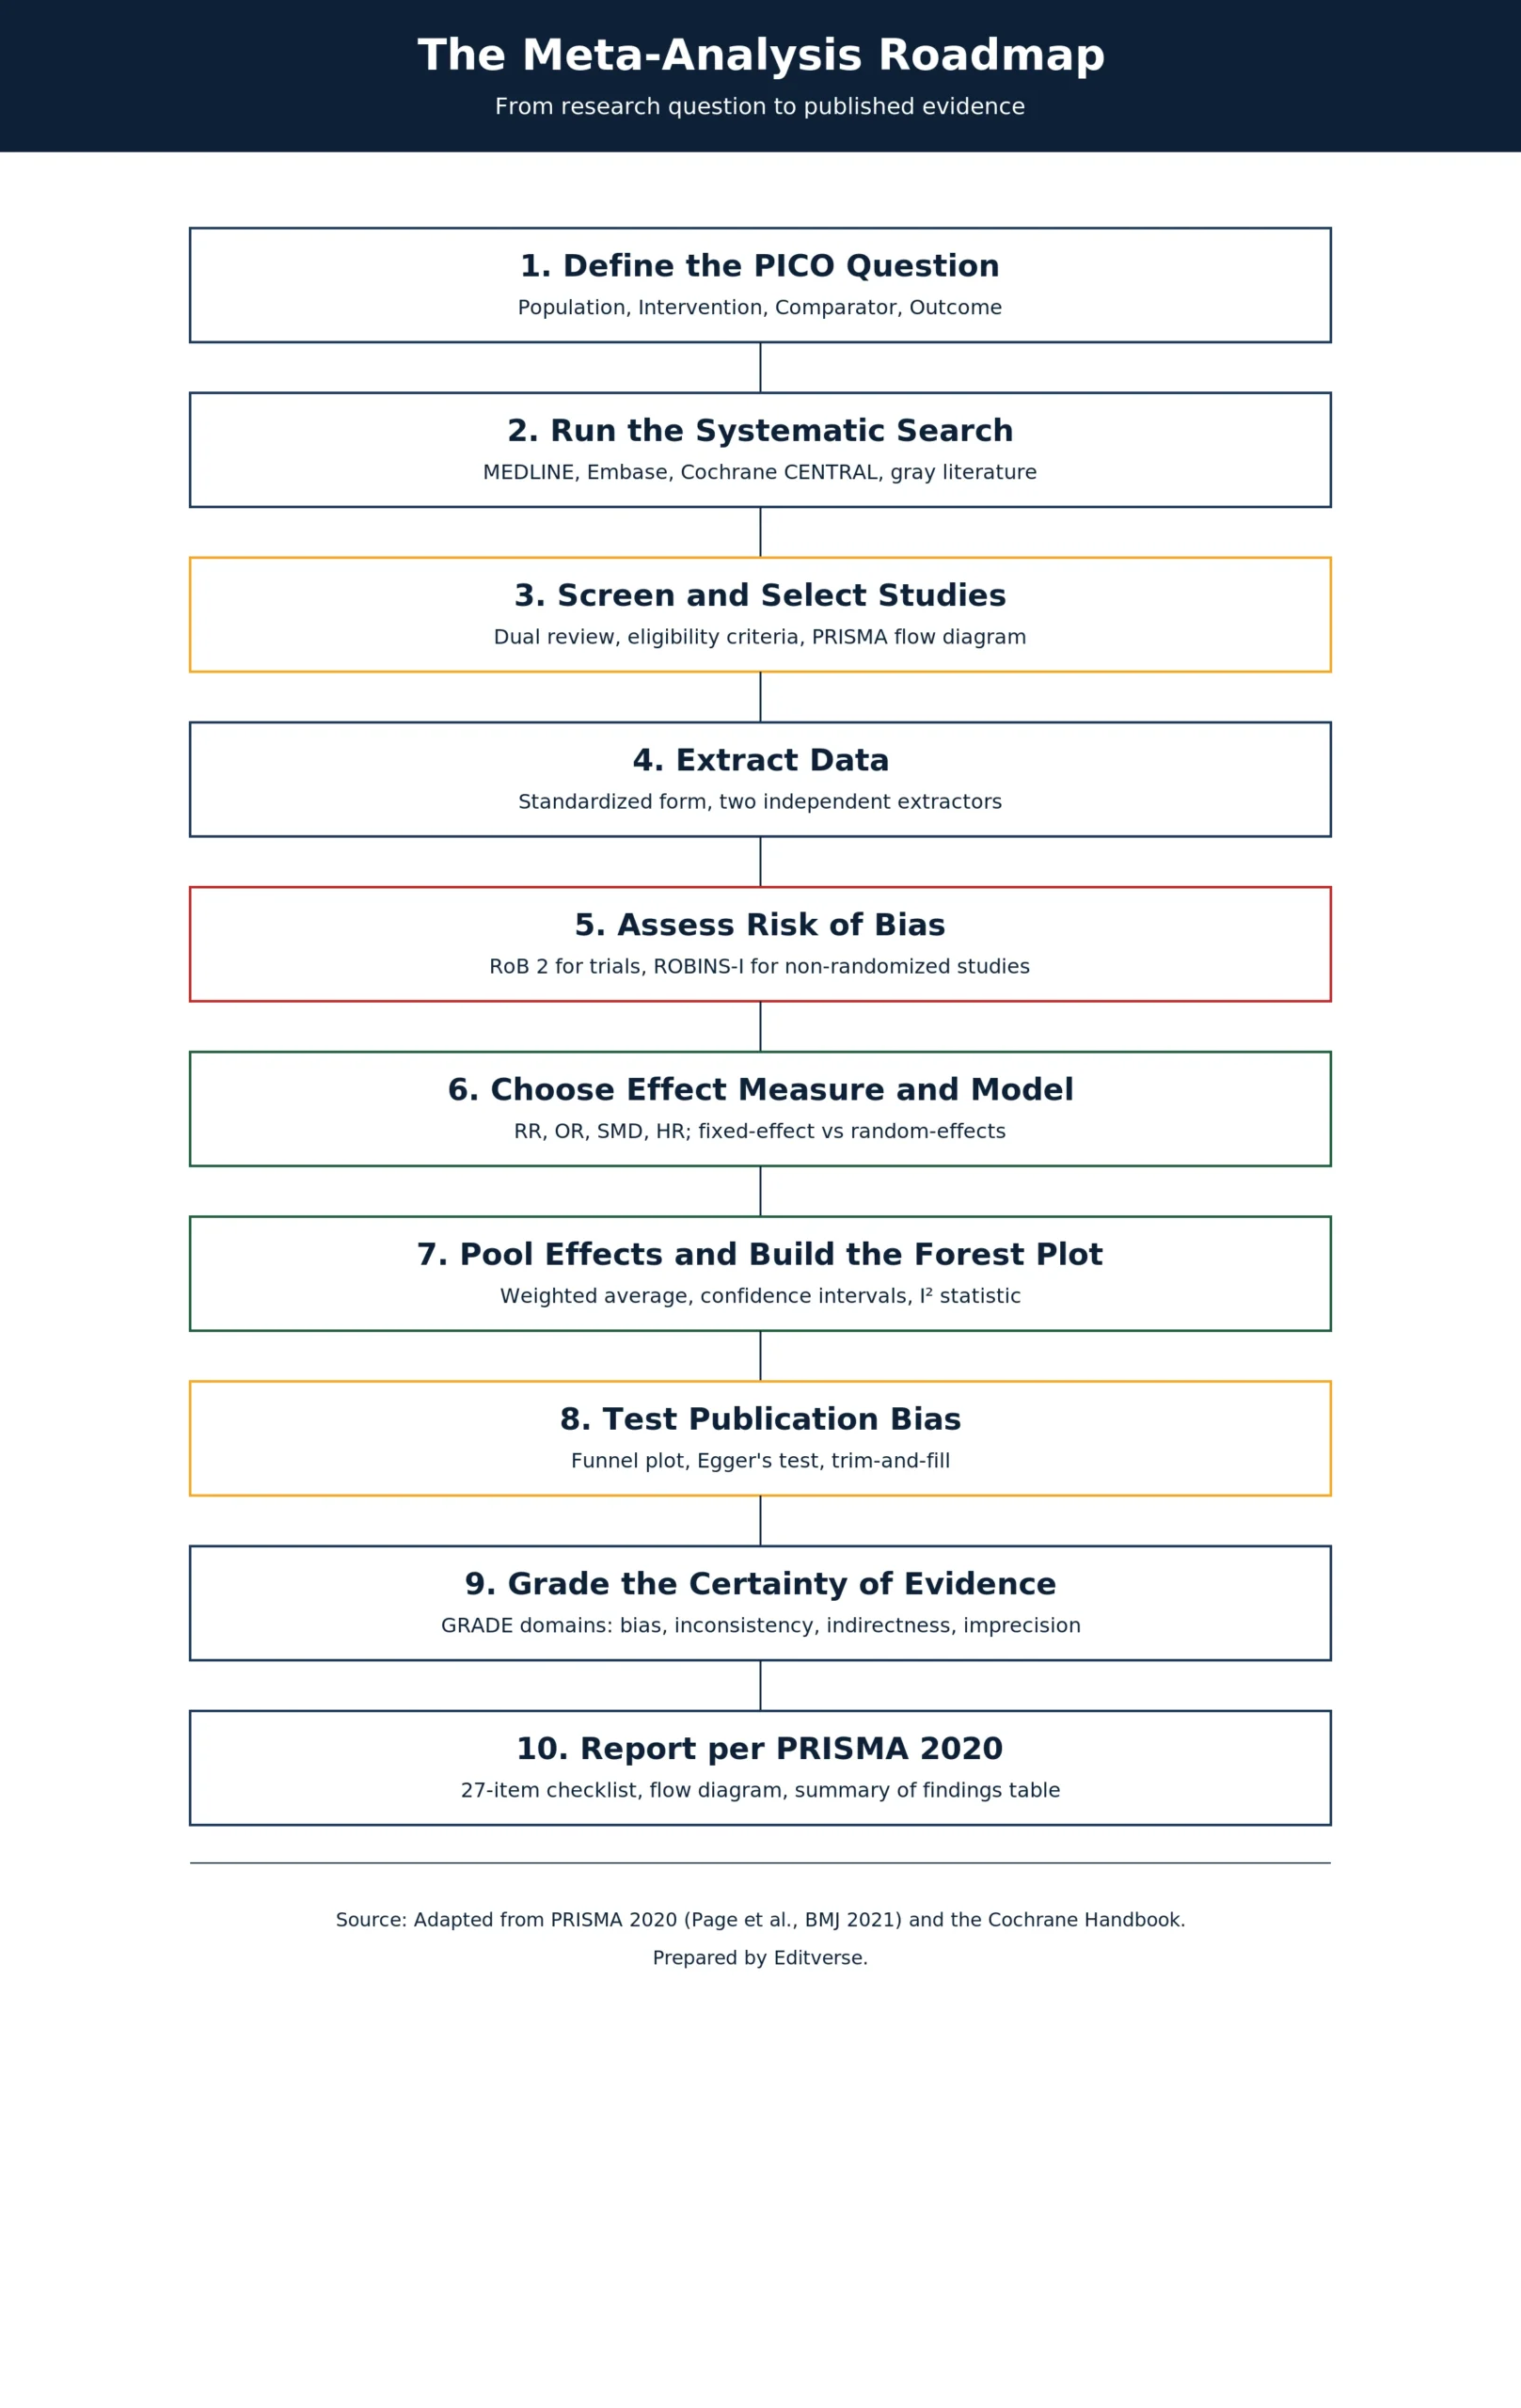
L'organigramme ci-dessous condense le processus complet en dix points de contrôle. Chacun est détaillé étape par étape dans les sections suivantes.
Étape 1 : Définissez votre question de recherche
Toute méta-analyse rigoureuse commence par une définition plus précise que prévu. Le cadre PICO impose cette restriction. Population identifie les personnes étudiées, Intervention ou Exposition désigne le traitement ou le facteur analysé, Comparateur précise le groupe témoin et Résultat définit exactement ce qui est mesuré. Un exemple concret : « Chez les adultes atteints de diabète de type 2, la metformine, comparée à un placebo, réduit-elle le taux d’HbA1c ? » C’est la précision de cette question qui permet de combiner les études de manière pertinente par la suite ; une question vague garantit un ensemble de données hétérogènes et ininterprétables.
Avant d'entreprendre une synthèse complète, il est judicieux de réaliser une analyse de puissance rapide sur le nombre probable d'études éligibles et la taille typique de leurs échantillons. Une méta-analyse de trois essais sous-dimensionnés restera généralement sous-dimensionnée.
Étape 2 : Effectuer une recherche systématique
L'exhaustivité d'une méta-analyse dépend de la qualité de la recherche qui l'alimente. Une identification exhaustive s'appuie généralement sur MEDLINE/PubMed et Embase pour la couverture biomédicale, Cochrane CENTRAL pour les essais cliniques, et des bases de données spécialisées telles que PsycINFO ou CINAHL, le cas échéant. La littérature grise (thèses, résumés de congrès), les registres d'essais cliniques comme ClinicalTrials.gov, les bibliographies des études incluses et le contact direct avec les auteurs complètent la recherche et permettent de repérer les éléments non couverts par l'indexation seule des bases de données.
Étape 3 : Examiner et sélectionner les études
Les critères d'éligibilité définis lors de l'enregistrement du protocole sont appliqués ici, idéalement par deux relecteurs travaillant indépendamment. Ces relecteurs examinent d'abord les titres et les résumés, puis le texte intégral des articles potentiellement éligibles, en documentant les raisons de chaque exclusion. Le résultat est un diagramme de flux PRISMA 2020 montrant précisément le nombre d'articles identifiés, examinés, exclus et finalement inclus. Ce diagramme est désormais une obligation de rapport et non plus une simple option. Les méta-analyses basées sur des données observationnelles plutôt que randomisées suivent la convention du diagramme de flux MOOSE .
Étape 4 : Extraire les données
Un formulaire d'extraction standardisé recueille les caractéristiques de l'étude (auteur, année, pays, méthodologie, taille de l'échantillon, durée du suivi), celles des participants (âge, répartition par sexe, gravité de la maladie, valeurs initiales), les détails de l'intervention (dose, fréquence, durée, co-interventions) et les données de résultats elles-mêmes : événements et totaux pour les résultats dichotomiques, ou moyennes, écarts types et tailles d'échantillon pour les résultats continus. L'extraction indépendante des données par deux relecteurs, les divergences étant résolues par la discussion plutôt que par un jugement unilatéral, permet de détecter les erreurs de transcription qui faussent silencieusement les estimations combinées.
Étape 5 : Évaluer le risque de biais
L'outil doit être adapté au plan d'étude. Pour les essais contrôlés randomisés, la norme actuelle est l'outil Cochrane RoB 2, introduit par Sterne et ses collègues dans le BMJ en 2019. Cet outil structure l'évaluation selon cinq domaines spécifiques : le processus de randomisation, les écarts par rapport aux interventions prévues, les données manquantes sur les résultats, la mesure du résultat et la sélection du résultat rapporté. Pour les études d'interventions non randomisées, ROBINS-I (Sterne et al., BMJ , 2016) étend cette logique à sept domaines, en y ajoutant les facteurs de confusion et le biais de sélection des participants, car aucun des deux n'est contrôlé par la randomisation. Il est préférable de présenter les résultats sous forme de graphique à feux tricolores ou de tableau récapitulatif plutôt que de les noyer dans le texte, car les relecteurs et les lecteurs les recherchent en premier.
Étape 6 : Choisissez votre mesure d’effet
Le type de résultat détermine la mesure. Pour les résultats dichotomiques, on utilise un rapport de risques lorsque le risque de base varie significativement d'une étude à l'autre, un odds ratio lorsque l'étude est cas-témoins ou l'analyse logistique, ou une différence de risques lorsqu'une valeur absolue et cliniquement interprétable est plus pertinente qu'une valeur relative. Pour les résultats continus, on utilise une différence moyenne lorsque toutes les études incluses ont mesuré le résultat sur la même échelle, ou une différence moyenne standardisée (d de Cohen, g de Hedges) lorsque les échelles diffèrent d'une étude à l'autre ; un convertisseur de taille d'effet gratuit permet d'effectuer les calculs entre ces formats. Les données de temps jusqu'à l'événement utilisent le rapport de risque issu de l'analyse de survie. Les méta-analyses de précision diagnostique constituent un cas à part, nécessitant des modèles bivariés ou HSROC plutôt qu'un simple ratio groupé ; un calculateur de méta-analyse diagnostique dédié couvre ce cas. Lorsque le test ou le modèle approprié reste incertain, un outil de sélection de tests statistiques permet de restreindre rapidement les options.
Étape 7 : Sélectionner le modèle d’analyse
Un modèle à effets fixes suppose que chaque étude incluse estime le même effet réel unique et n'est approprié que lorsque les études sont fonctionnellement identiques en termes de population, d'intervention et de contexte ; il fournit des intervalles de confiance plus étroits car il néglige toute variation réelle entre les études. Un modèle à effets aléatoires, en revanche, suppose que les effets réels varient d'une étude à l'autre pour des raisons cliniques ou méthodologiques légitimes, fournit des intervalles de confiance proportionnellement plus larges et plus conservateurs, et constitue le choix par défaut en recherche médicale précisément parce que l'hétérogénéité clinique entre les populations étudiées est la norme plutôt que l'exception.
Étape 8 : Mettre en commun les effets et construire le graphique de la forêt
Le choix du logiciel importe moins que la pertinence du modèle. RevMan reste la norme gratuite de Cochrane, Comprehensive Meta-Analysis (CMA) offre une interface commerciale plus guidée, et R… meta et metafor Les packages offrent une flexibilité totale gratuitement, et les utilisateurs de Stata optent généralement pour metan or metaanQuel que soit l'outil utilisé, les calculs sous-jacents restent les mêmes. Il s'agit de calculer la taille de l'effet pour chaque étude, de pondérer chaque effet par sa précision, de calculer la moyenne pondérée et de générer des intervalles de confiance autour de cette moyenne. Un outil gratuit calculateur de méta-analyse reproduit ce regroupement et affiche directement le graphique forestier.
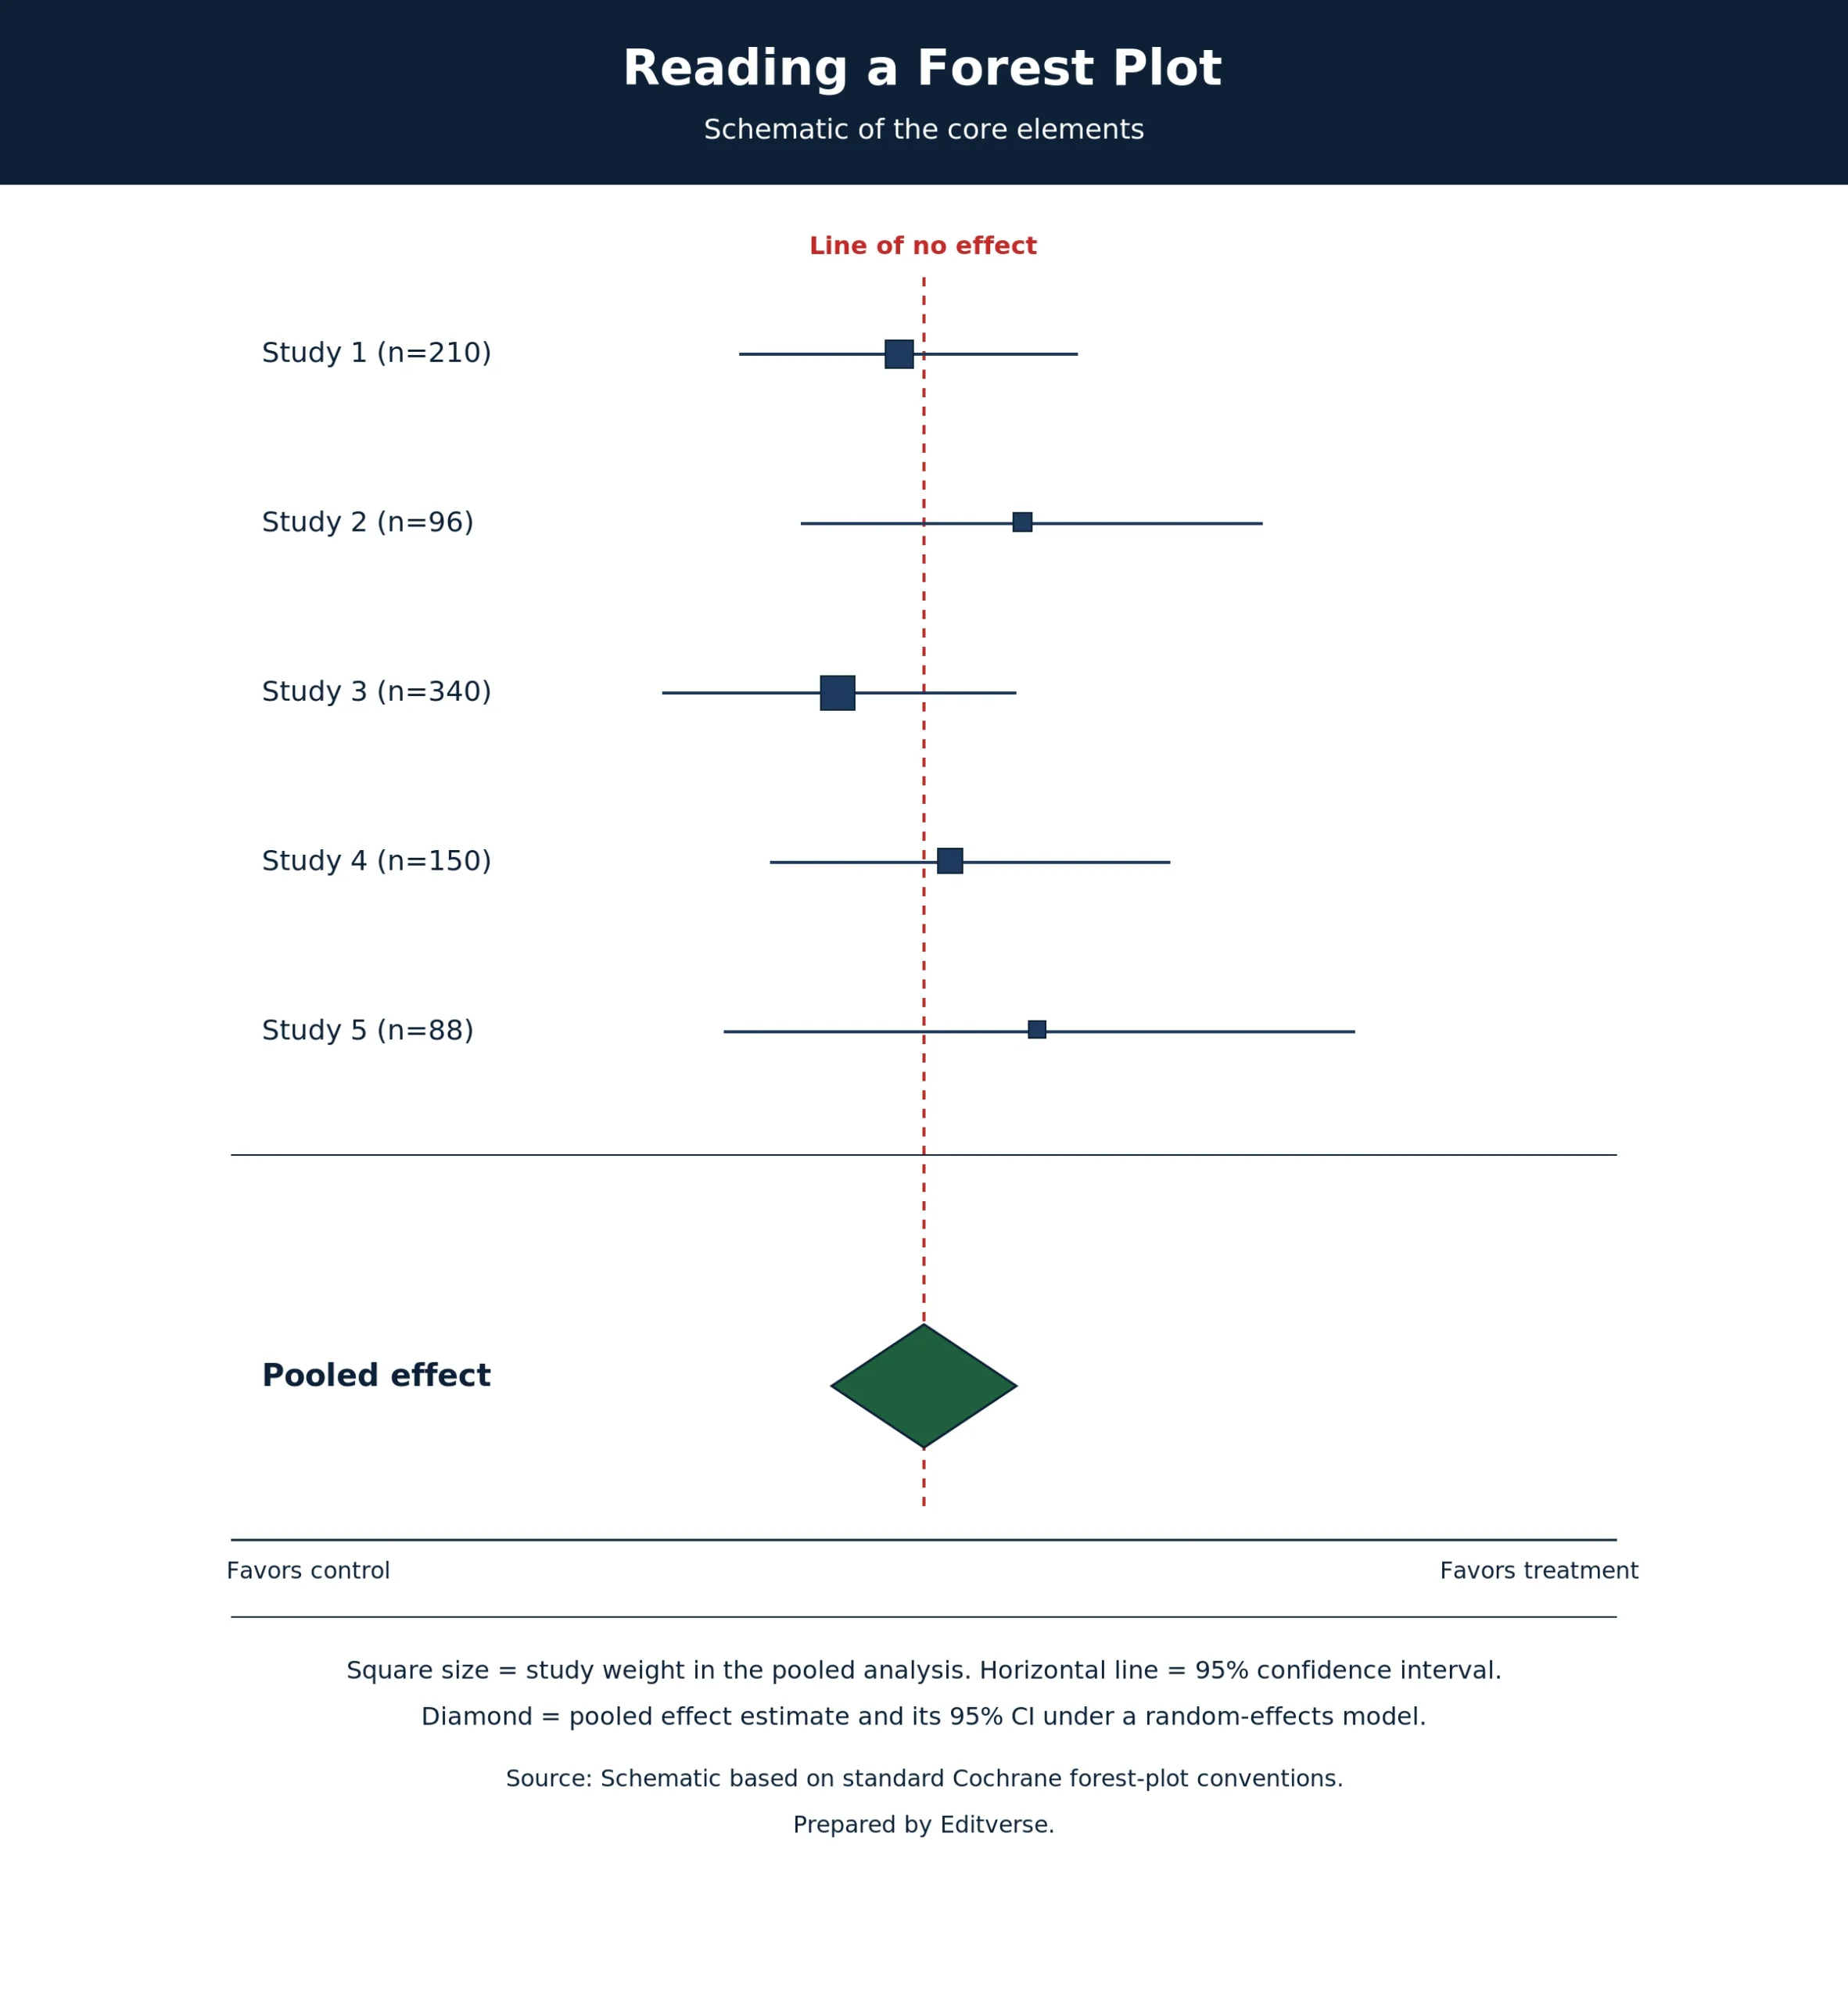
La bonne interprétation du graphique est aussi importante que sa construction. Le carré correspondant à chaque étude représente son estimation ponctuelle, sa taille étant proportionnelle à son poids dans l'analyse groupée ; la ligne horizontale qui le traverse représente l'intervalle de confiance à 95 % ; et le losange en bas indique l'effet groupé et son propre intervalle de confiance selon le modèle choisi.
Étape 9 : Évaluer l'hétérogénéité
L'hétérogénéité est le terme technique désignant les divergences entre les études. Higgins, Thompson, Deeks et Altman ont établi la norme de référence pour la mesurer dans un article du BMJ de 2003 , en introduisant la statistique I², qui exprime le pourcentage de la variation totale entre les études attribuable à une hétérogénéité réelle plutôt qu'au hasard. Par convention, une valeur de 0 à 25 % est considérée comme une faible hétérogénéité, de 25 à 50 % comme modérée, de 50 à 75 % comme substantielle et supérieure à 75 % comme considérable. La statistique Q (un test du χ²) et le tau² (l'estimation de la variance inter-études) complètent le trio standard de mesures. Un calculateur d'hétérogénéité dédié calcule ces trois statistiques à partir des données extraites des études. Une forte hétérogénéité incite à enquêter, que ce soit par une analyse de sous-groupes stratifiée selon des facteurs cliniques ou méthodologiques, une modélisation de méta-régression directe des modificateurs d'effet potentiels, ou une analyse de sensibilité « leave-one-out » qui exclut chaque étude tour à tour pour vérifier si une valeur aberrante influence le résultat global.
Étape 10 : Tester le biais de publication
Le biais de publication survient car les résultats statistiquement significatifs et favorables sont systématiquement plus susceptibles d'être publiés que les résultats nuls ou défavorables, ce qui fausse toute estimation globale construite uniquement à partir des données publiées. Egger, Davey Smith, Schneider et Minder ont formalisé la méthode de détection standard dans un article du BMJ de 1997 : un test de régression pour l'asymétrie du graphique en entonnoir induite par le biais de publication. Le test de corrélation de rang de Begg offre une vérification complémentaire. En cas d'asymétrie détectée, la méthode « trim-and-fill » impute les études manquantes afin d'estimer l'effet global corrigé. Un calculateur de biais de publication gratuit combine le graphique en entonnoir et le test d'Egger. Il est important de signaler à tout co-auteur ou relecteur que ces tests ont une faible puissance statistique avec moins de dix études incluses ; par conséquent, un résultat nul issu d'une petite méta-analyse n'est pas suffisamment rassurant.
Étape 11 : Évaluer le degré de certitude des preuves
Une estimation ponctuelle regroupée ne renseigne pas sur le degré de confiance à lui accorder. C’est précisément ce que l’approche GRADE, introduite par Guyatt et ses collègues dans le BMJ en 2008, vise à formaliser. GRADE évalue la certitude globale selon cinq domaines : le risque de biais dans les études contributives, l’incohérence (hétérogénéité inexpliquée), le caractère indirect (adéquation des données probantes à la population cible et à la question posée), l’imprécision (intervalles de confiance suffisamment larges pour couvrir des conclusions cliniquement différentes) et les signes de biais de publication. Le score obtenu (élevé, modéré, faible ou très faible) indique clairement au lecteur si des recherches supplémentaires sont susceptibles de modifier l’estimation.
Étape 12 : Présentez vos conclusions conformément à PRISMA 2020
Page et ses collègues ont publié la norme de publication actuelle, PRISMA 2020, dans le BMJ en 2021, actualisant ainsi la déclaration originale de 2009. Sa liste de contrôle en 27 points constitue désormais le référentiel que les rédacteurs en chef et les relecteurs examinent avant toute soumission de manuscrit. Un rapport conforme comprend le diagramme de flux de l'étape 3, un tableau complet des caractéristiques des études incluses, l'évaluation du risque de biais de l'étape 5, des graphiques en forêt pour chaque critère de jugement principal, des graphiques en entonnoir lorsque le biais de publication a été évalué, et un tableau de synthèse des résultats reprenant les scores GRADE de l'étape 11. Au-delà de la liste de contrôle elle-même, les estimations de l'effet doivent présenter clairement leurs intervalles de confiance à 95 %, les statistiques d'hétérogénéité doivent être rapportées plutôt qu'omises lorsque cela s'avère gênant, les limites de l'étude doivent être discutées avec transparence et l'interprétation clinique doit être dissociée de l'interprétation statistique. Nos services de rédaction de manuscrits sont conçus pour accompagner les manuscrits qui atteignent ce stade mais qui nécessitent encore une mise en forme, une adaptation aux exigences de la revue cible ou une révision complète avant soumission.
Erreurs courantes observées lors de la révision de manuscrits
Parmi les manuscrits soumis à Editverse pour une méta-analyse, les mêmes erreurs se répètent suffisamment souvent pour qu'il soit pertinent de les mentionner explicitement. Le regroupement d'études cliniquement ou méthodologiquement incompatibles en une seule estimation globale est l'erreur la plus fréquente, suivie de près par la présentation de statistiques d'hétérogénéité sans analyse de leurs causes. L'utilisation inappropriée de mesures d'effet (par exemple, un odds ratio alors qu'un risque relatif serait plus interprétable) est suffisamment fréquente pour suggérer que ce choix est dicté par les paramètres par défaut du logiciel plutôt que par le type de résultat. Les résultats de sous-groupes sont systématiquement présentés comme des confirmations plutôt que comme des signaux générateurs d'hypothèses, et l'évaluation GRADE est omise plus souvent que ne le permettent les recommandations des revues. Chacune de ces erreurs constitue un motif valable pour une demande de révision majeure ; leur accumulation est une cause fréquente de rejet immédiat.
Questions fréquemment posées
De combien d'études ai-je besoin pour une méta-analyse ?
Il n'y a pas de minimum fixe, et deux études peuvent techniquement être regroupées, mais les tests d'hétérogénéité et de biais de publication perdent tous deux en puissance statistique en dessous de dix études, les résultats provenant de très petits groupes doivent donc être interprétés avec prudence et rapportés comme tels.
Quelle est la différence entre une revue systématique et une méta-analyse ?
Une revue systématique est le processus reproductible d'identification, de sélection et d'évaluation de toutes les études pertinentes sur une question donnée. Une méta-analyse est la technique statistique, utilisée dans ce processus, qui regroupe les résultats quantitatifs des études en une seule estimation. Toutes les revues systématiques ne comportent pas de méta-analyse ; une méta-analyse réalisée en dehors d'une recherche systématique n'est pas valable.
Dois-je utiliser un modèle à effets fixes ou à effets aléatoires ?
Le modèle à effets aléatoires est privilégié par défaut en recherche médicale et sanitaire, car les différences cliniques et méthodologiques entre les études sont la norme. Le modèle à effets fixes n'est justifié que lorsque les études incluses sont quasi identiques sur le plan fonctionnel.
Que signifie un I² de 60 % ?
Cela signifie que 60 % de la variation totale des estimations d'effet de vos études regroupées est attribuable à une véritable hétérogénéité entre les études plutôt qu'au hasard, ce qui est considérable et devrait inciter à une analyse de sous-groupes ou de sensibilité avant que l'estimation regroupée ne soit rapportée comme résultat principal.
Quel logiciel dois-je utiliser pour effectuer une méta-analyse ?
RevMan est gratuit et constitue la norme de Cochrane ; celui de R meta et metafor Les logiciels disponibles sont gratuits et très flexibles ; Comprehensive Meta-Analysis (CMA) et Stata sont des options payantes appréciées pour leurs interfaces intuitives. Ces quatre logiciels permettent de réaliser des analyses de regroupement à effets fixes et à effets aléatoires, de créer des graphiques en forêt et de calculer les statistiques d’hétérogénéité standard.
Bénéficiez d'un soutien d'experts pour votre méta-analyse
Une méta-analyse rigoureuse s'appuie sur une expertise statistique et une rigueur méthodologique à chacune des douze étapes décrites ci-dessus, et chacune d'entre elles est vérifiée par des relecteurs de revues scientifiques à fort impact. Notre équipe vous accompagne dans la conception du protocole et de l'étude, l'élaboration du formulaire d'extraction de données, l'analyse statistique avec R, Stata ou RevMan, la création de graphiques en forêt et en entonnoir, l'évaluation GRADE, ainsi que la rédaction et la révision du manuscrit jusqu'à sa soumission. Découvrez notre service de rédaction de revues systématiques et de méta-analyses ou contactez-nous pour une consultation gratuite.
Références
- Page MJ, McKenzie JE, Bossuyt PM, et al. La déclaration PRISMA 2020 : une ligne directrice mise à jour pour la publication des revues systématiques. BMJ. 2021;372:n71. https://doi.org/10.1136/bmj.n71
- Sterne JAC, Savović J, Page MJ, et al. RoB 2 : un outil révisé pour évaluer le risque de biais dans les essais randomisés. BMJ. 2019;366:l4898. https://doi.org/10.1136/bmj.l4898
- Sterne JA, Hernán MA, Reeves BC, et al. ROBINS-I : un outil pour évaluer le risque de biais dans les études non randomisées d'interventions. BMJ. 2016;355 : i4919. https://doi.org/10.1136/bmj.i4919
- Higgins JPT, Thompson SG, Deeks JJ, Altman DG. Mesurer l'incohérence dans les méta-analyses. BMJ. 2003; 327: 557-560. https://doi.org/10.1136/bmj.327.7414.557
- Egger M, Davey Smith G, Schneider M, Minder C. Biais dans la méta-analyse détecté par un test graphique simple. BMJ. 1997; 315: 629-634. https://doi.org/10.1136/bmj.315.7109.629
- Guyatt GH, Oxman AD, Vist GE, et al. GRADE : un consensus émergent sur l'évaluation de la qualité des preuves et la force des recommandations. BMJ. 2008; 336: 924-926. https://doi.org/10.1136/bmj.39489.470347.AD
- Manuel Cochrane pour les revues systématiques des interventions. https://training.cochrane.org/handbook
Examiné par l'équipe de soutien à la recherche d'Editverse, forte de son expérience dans l'accompagnement de manuscrits de revues systématiques et de méta-analyses dans les domaines biomédicaux et cliniques. Dernière mise à jour : juillet 2026.