
Comment choisir le bon test statistique
Choisir le test statistique approprié n'est pas une question de préférence : cela dépend de trois facteurs : le type de variable mesurée, le nombre de groupes ou de mesures comparées et le caractère indépendant ou apparié des observations . Si ces trois facteurs sont correctement pris en compte, le test approprié s'impose presque toujours. Le sélecteur interactif ci-dessus vous guide précisément dans ces choix ; cette section explique le raisonnement sous-jacent afin que vous puissiez justifier votre choix auprès d'un examinateur.
Étape 1 — Identifiez le type de résultat (variable dépendante).
Tout commence ici. Une variable continue (pression artérielle, HbA1c, score) oriente vers des tests de comparaison de moyennes comme le test t ou l'ANOVA. Une variable catégorielle (guérison/absence de guérison, réponse/non-réponse) oriente vers des tests de comparaison de proportions comme le test du χ², le test exact de Fisher ou la régression logistique. Une variable ordinale (échelle de la douleur, stade) requiert généralement des méthodes non paramétriques. Une variable de type « délai avant événement » (survie, délai avant rechute) nécessite une analyse de survie, car elle doit prendre en compte les observations censurées qu'une simple comparaison de moyennes ne permet pas de traiter.
Étape 2 — Comptez vos groupes et vérifiez les appariements
Comparez-vous un groupe à une valeur connue , deux groupes , ou trois ou plus ? Les observations sont-elles indépendantes (sujets différents dans chaque groupe) ou appariées (mêmes sujets mesurés deux fois, ou appariés) ? L’appariement est la distinction la plus souvent négligée. Mesurer les mêmes patients avant et après un traitement constitue des données appariées ; les analyser comme si les deux séries de mesures provenaient de groupes indépendants revient à ignorer l’information même qui fait la force de l’étude, et il s’agit d’une erreur reconnue dans la littérature.
Étape 3 — Vérifier les hypothèses (paramétriques ou non paramétriques)
Les tests paramétriques (test t, ANOVA, corrélation de Pearson) supposent que la variable dépendante suit approximativement une loi normale et, pour les comparaisons de groupes, que les variances sont similaires. Lorsque ces hypothèses sont vérifiées — ou lorsque l'échantillon est suffisamment grand pour que le théorème central limite s'applique — les tests paramétriques sont plus puissants. En cas de données asymétriques, ordinales ou de petit échantillon, il convient d'utiliser l'équivalent non paramétrique : test de Mann-Whitney au lieu du test t pour échantillons indépendants, test de Wilcoxon au lieu du test t pour échantillons appariés, test de Kruskal-Wallis au lieu de l'ANOVA et corrélation de Spearman au lieu de Pearson.
Étape 4 — Associez le résultat au test, puis vérifiez-le à l'aide d'une calculatrice.
Une fois le type de résultat, la structure du groupe et les hypothèses définis, le test est déterminé. Utilisez le tableau comparatif ci-dessous comme aide-mémoire, ouvrez le calculateur gratuit correspondant et comparez votre résultat avec le code R affiché. Pour la planification de l'étude, effectuez toujours une analyse de la taille de l'échantillon et de la puissance statistique avant la collecte des données.
Guide visuel : Le système à 3 filtres en action
Chaque diapositive correspond directement à une étape du sélecteur interactif ci-dessus, de l'architecture au test.

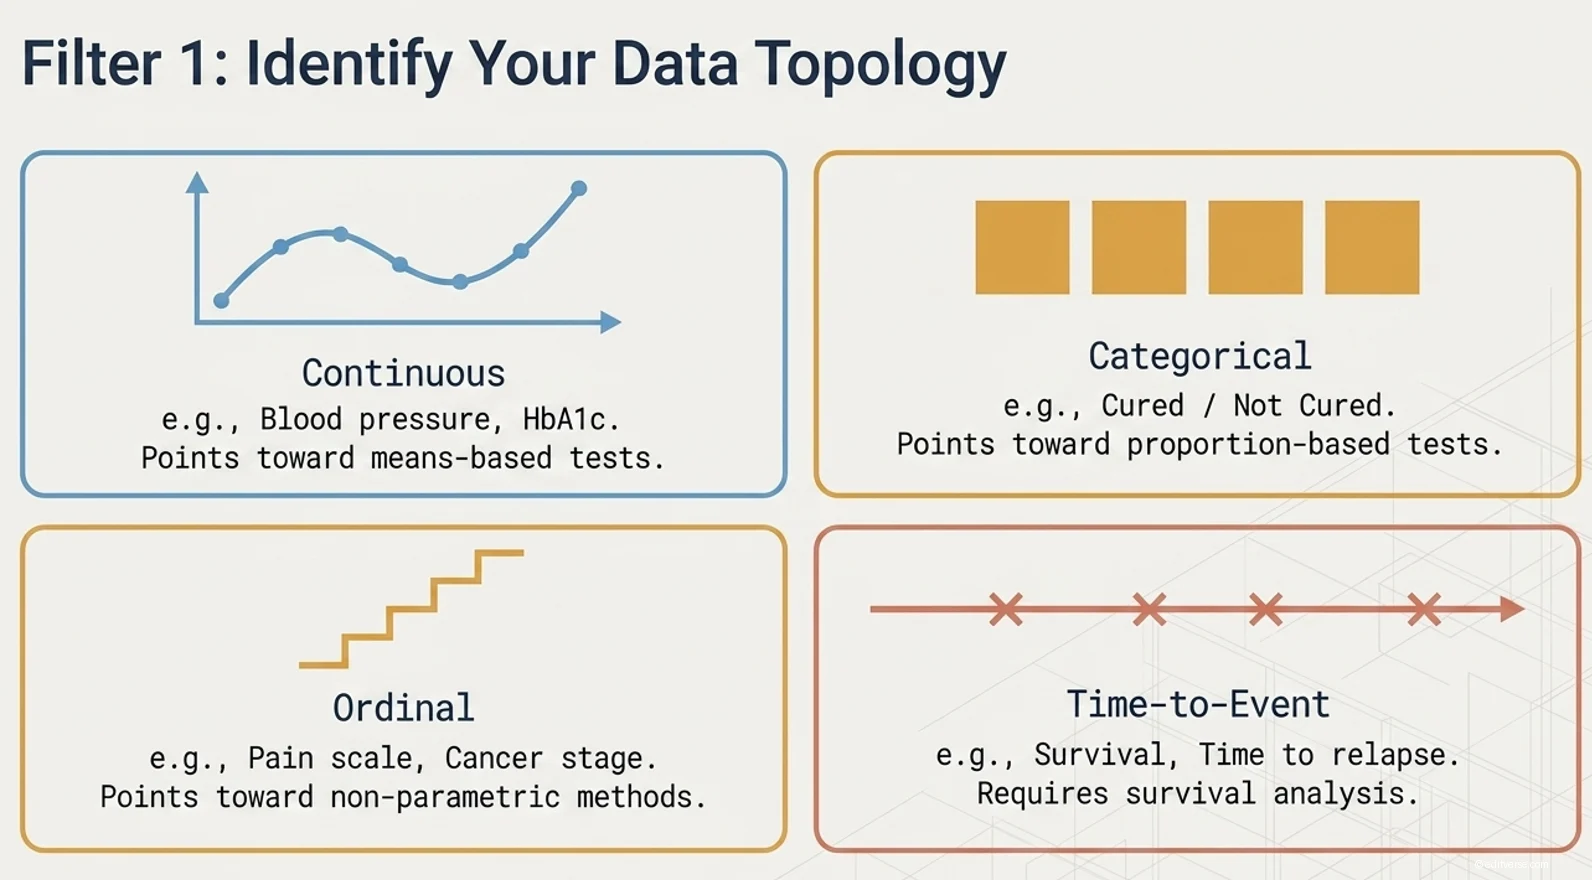
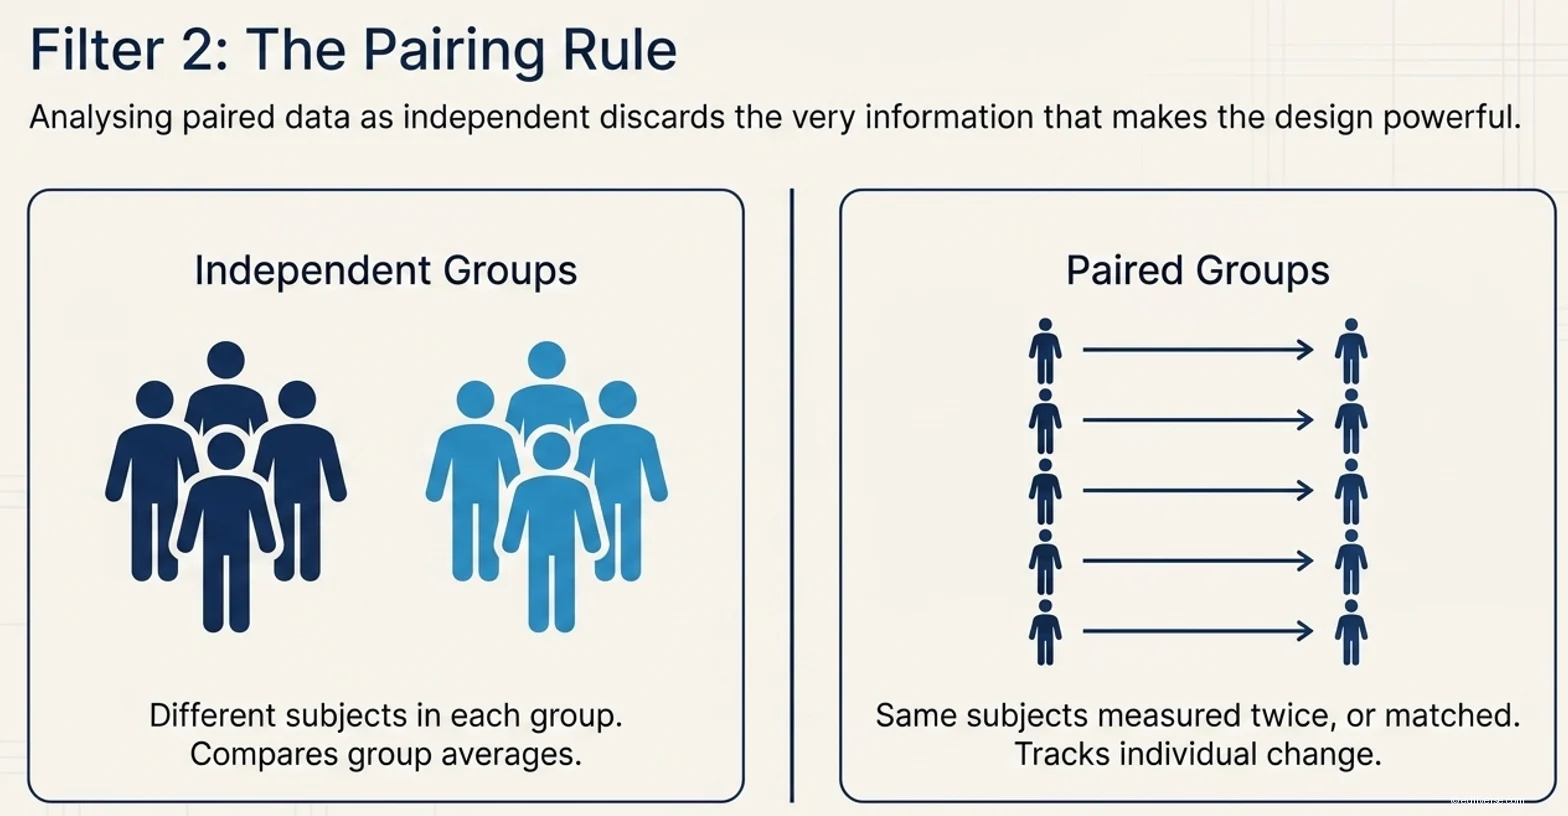
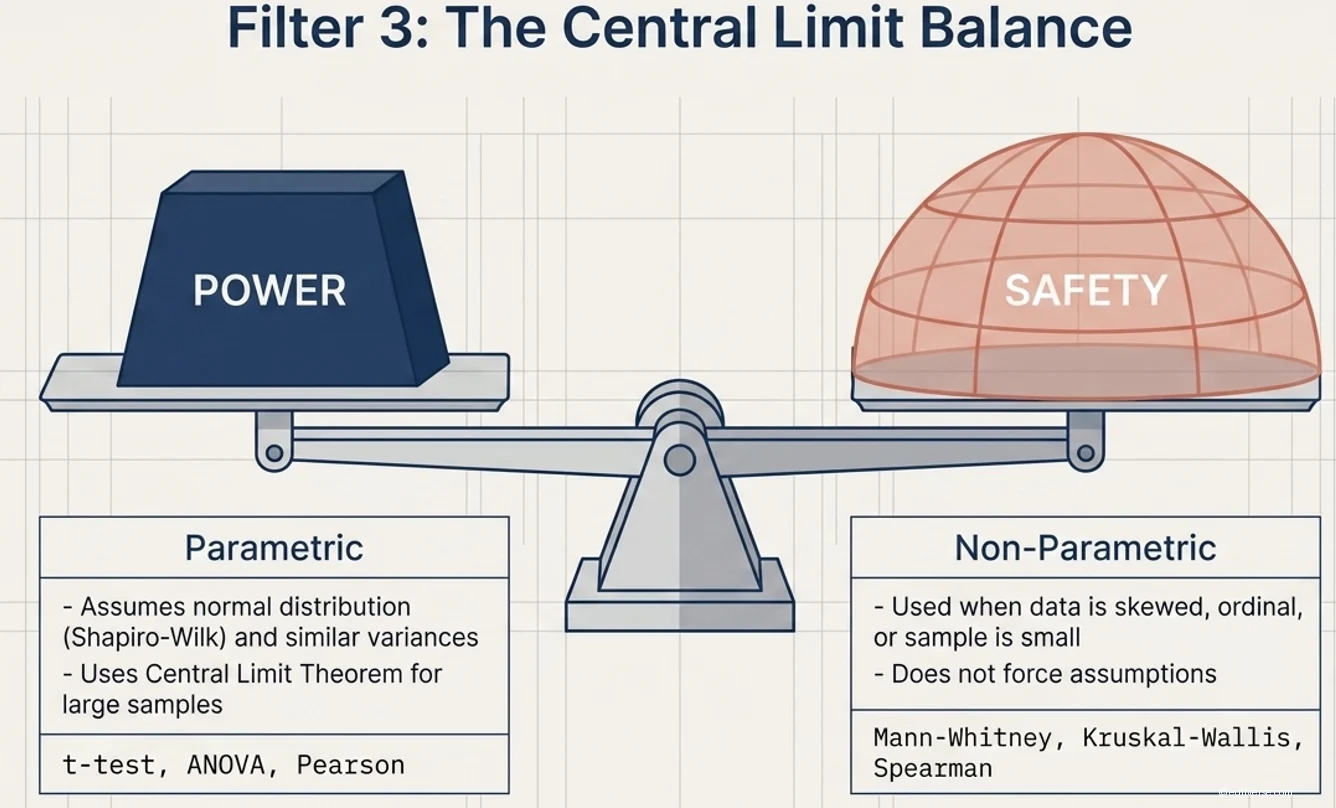

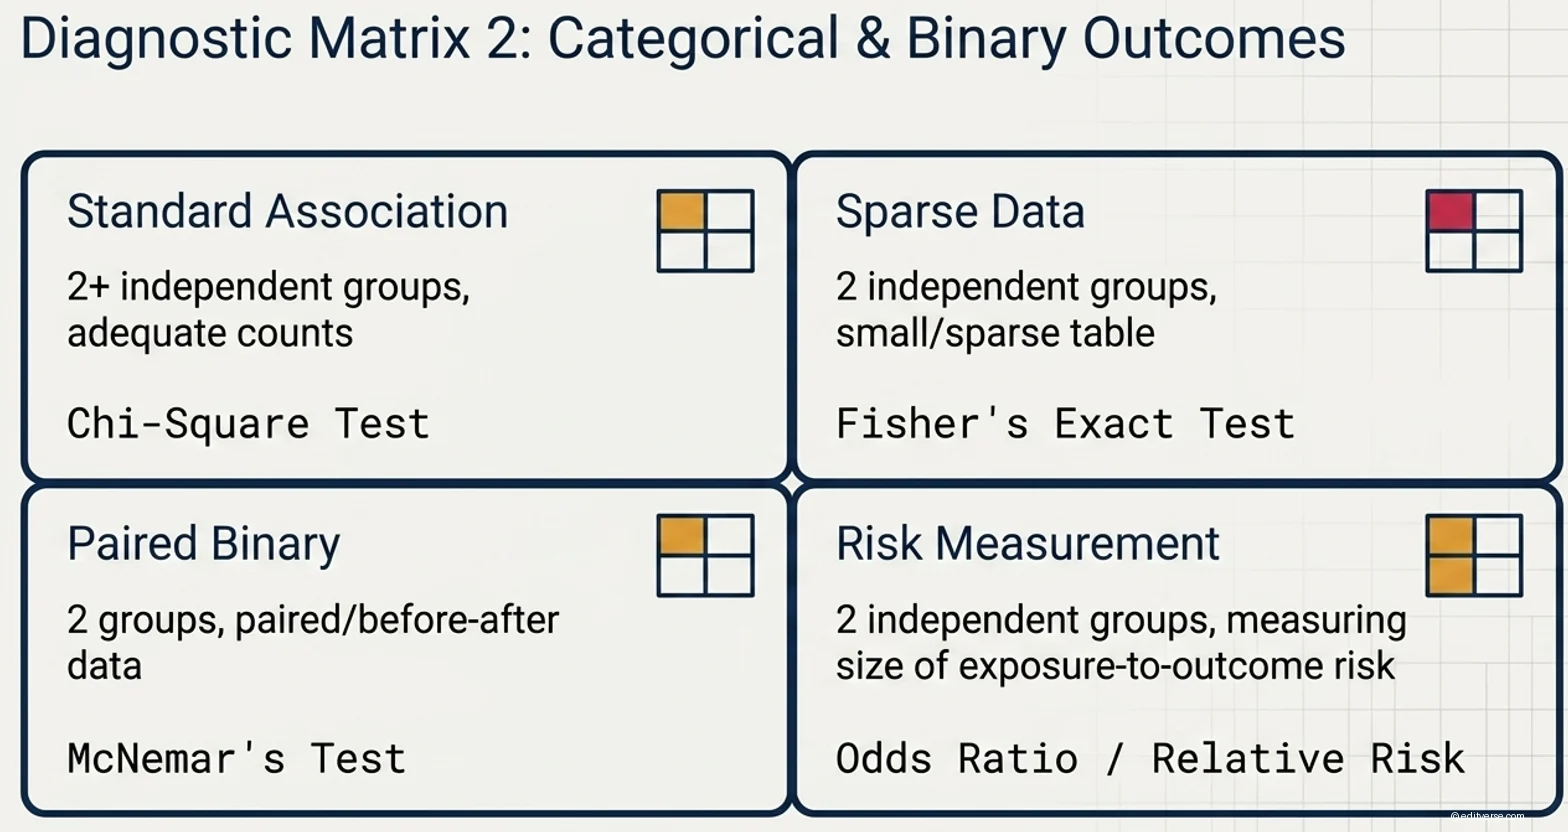


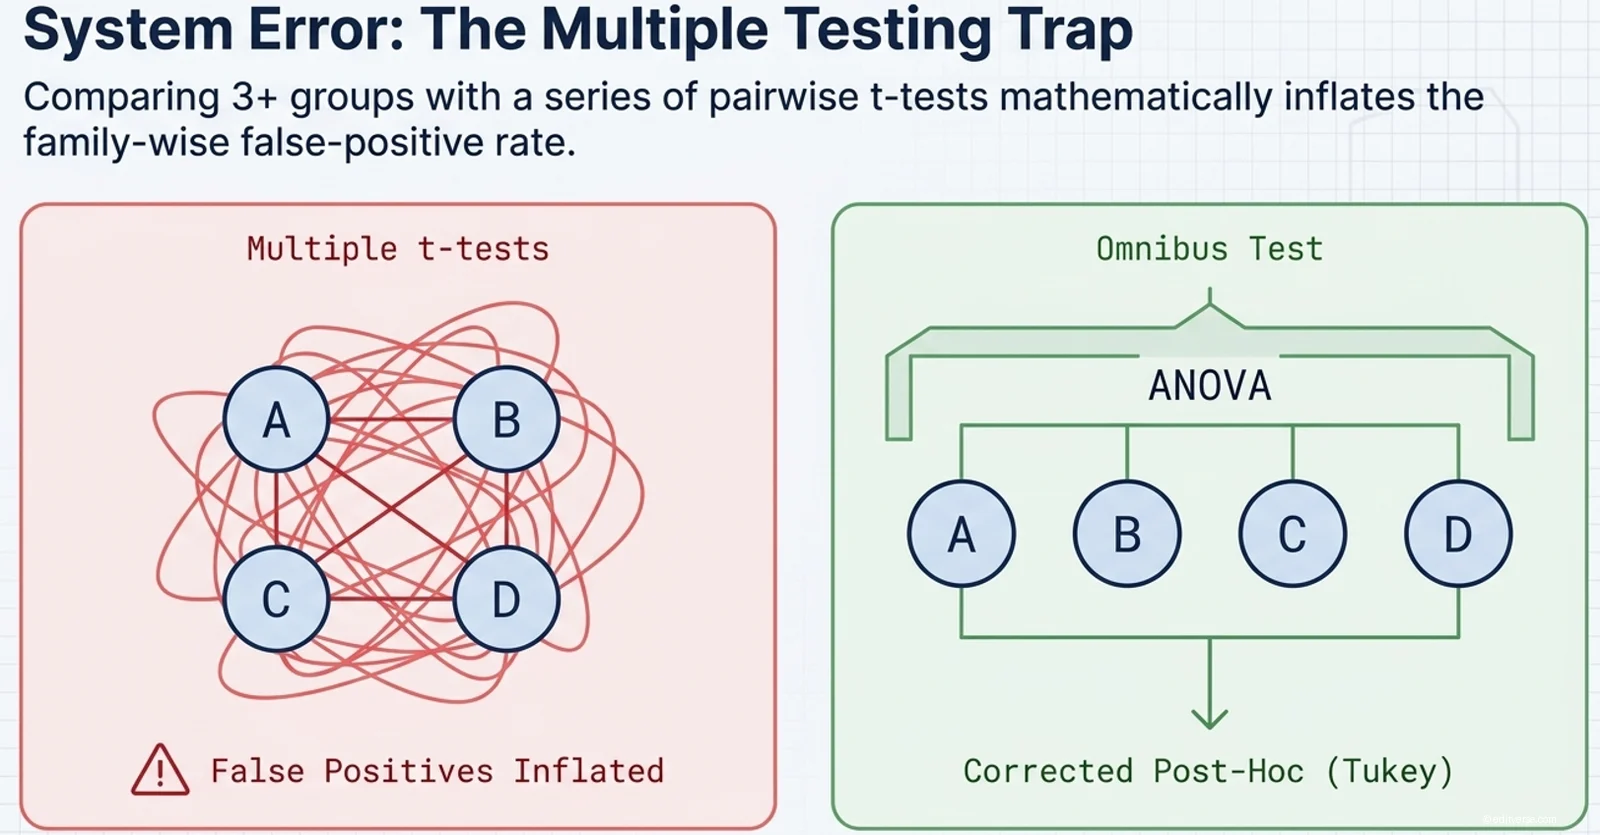
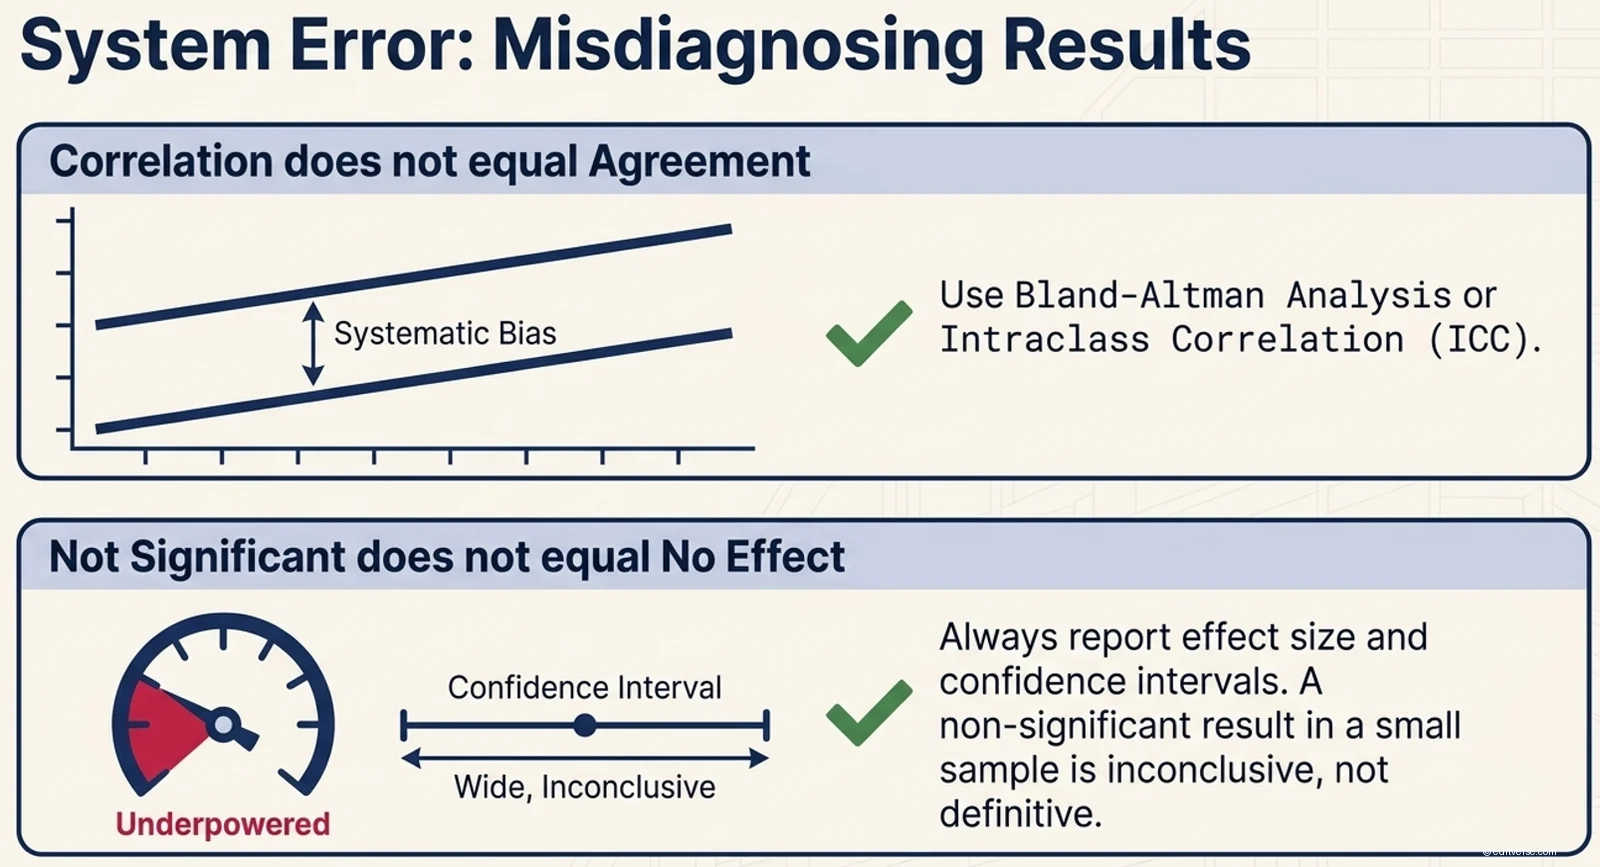
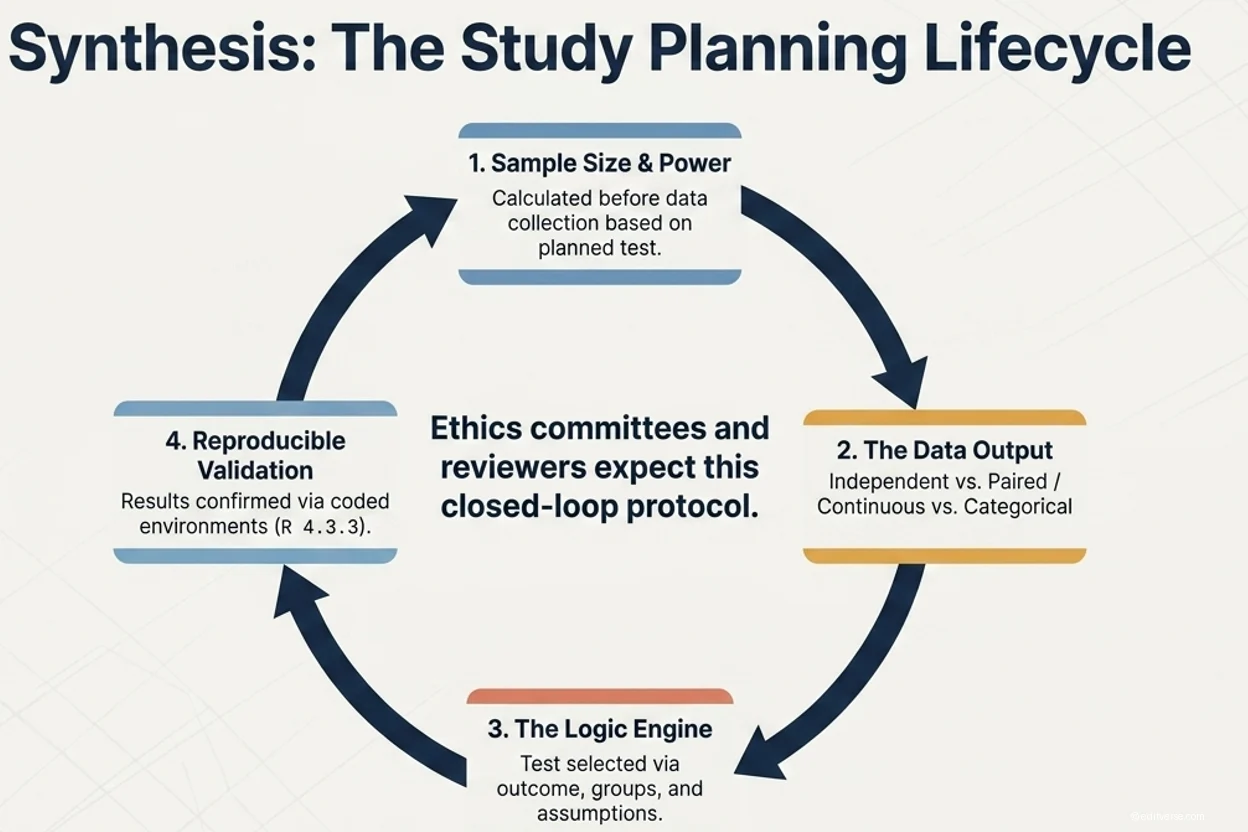
Tableau de sélection des tests statistiques
Adaptez votre programme d'études au test approprié, puis ouvrez le calculateur gratuit.
| Objectif / conception | Type de résultat | Groupes | Test recommandé | Calculatrice |
|---|---|---|---|---|
| Comparaison des groupes | ||||
| Deux groupes indépendants, données normales | Continu | 2 (indépendant) | Test t indépendant | Test t → |
| Deux groupes indépendants, asymétriques/ordinaux | Continu / ordinal | 2 (indépendant) | Université Mann-Whitney | Mann-Whitney → |
| Avant/après, mêmes sujets, normal | Continu | 2 (appariés) | Test t apparié | Test t → |
| Avant/après, mêmes sujets, biaisé | Continu / ordinal | 2 (appariés) | Wilcoxon Signed-Rank | Wilcoxon → |
| Trois groupes ou plus, normal | Continu | 3+ (indépendants) | ANOVA à un facteur + Tukey | ANOVA → |
| Trois groupes ou plus, non normaux | Continu / ordinal | 3+ (indépendants) | Kruskal-Wallis | Dans l'appli → |
| Résultats catégoriels | ||||
| Association, décomptes adéquats | Catégorique | 2+ (indépendants) | Chi-carré | Chi-carré → |
| Association, petit tableau/tableau clairsemé | Catégorique | 2 (indépendant) | Exact de Fisher | Fisher's → |
| Binaire apparié (avant/après) | binaire | 2 (appariés) | Test de Mc Nemar | McNemar → |
| Ampleur du risque (exposition → résultat) | binaire | 2 (indépendant) | Rapport de cotes / risque relatif | OU / RR → |
| Relations et prédiction | ||||
| Association entre deux variables | Continu | - | Corrélation de Pearson/Spearman | Corrélation → |
| Prédire un résultat continu | Continu | - | Régression Linéaire | Régression → |
| Prédire un résultat binaire | binaire | - | Régression logistique | Logistique → |
| Accord, diagnostic et survie | ||||
| Accord entre évaluateurs, catégories | Catégorique | 2 évaluateurs | Kappa de Cohen | Kappa → |
| Fiabilité / comparaison des méthodes | Continu | 2 évaluateurs/méthodes | CCI / Bland-Altman | ICC → |
| Test diagnostique vs référence | binaire | - | Sensibilité et spécificité | Sensibilité/Spécifications → |
| Performances des tests selon différents seuils | Continu → binaire | - | Courbe ROC et AUC | ROC → |
| Délai avant l'événement avec censure | Heure de l'événement | 2 000 à 4 000 groupes | Kaplan-Meier / Log-Rank | Survie → |
| Planification des études | ||||
| De combien de participants ai-je besoin ? | Toutes | - | Analyse de la taille de l'échantillon et de la puissance | Taille de l'échantillon → |
Erreurs courantes dans la sélection des tests
En ignorant le fait que les données sont appariées
Analyser des mesures répétées ou appariées comme si elles provenaient de groupes indépendants est l'une des erreurs les plus fréquentes et les plus lourdes de conséquences. Les plans expérimentaux appariés requièrent des tests appariés (test t apparié, test de Wilcoxon ou test de McNemar pour les données binaires) ; ignorer la dépendance compromet l'efficacité du plan et peut produire des résultats trompeurs.
Effectuer plusieurs tests t au lieu d'une ANOVA
La comparaison de trois groupes ou plus par une série de tests t appariés augmente le taux de faux positifs global. Il est préférable d'utiliser un test global unique (ANOVA ou Kruskal-Wallis) suivi d'une comparaison post-hoc corrigée.
Utilisation d'un test paramétrique sur des données asymétriques ou ordinales
Le test t et l'ANOVA supposent une distribution approximativement normale. Pour des échantillons clairement asymétriques, ordinaux ou de très petite taille, il est préférable d'utiliser le test non paramétrique équivalent plutôt que de recourir systématiquement à un test paramétrique.
Confondre corrélation et accord
Une forte corrélation de Pearson entre deux méthodes de mesure n'implique pas nécessairement leur concordance ; deux méthodes peuvent être parfaitement corrélées tout en présentant un biais systématique. Il convient d'utiliser le coefficient de corrélation intraclasse ou une analyse de Bland-Altman pour évaluer la concordance.
Considérer « non significatif » comme « aucun effet »
Un résultat non significatif dans une étude de puissance statistique insuffisante ne prouve pas l'absence d'effet. Indiquez la taille de l'effet et son intervalle de confiance, et prévoyez à l'avance un échantillon suffisamment puissant.
Tests multiples non corrigés
Tester de nombreux résultats ou ajuster de nombreux modèles sans corriger la multiplicité augmente le nombre de faux positifs et constitue une source reconnue de résultats non reproductibles.
Questions fréquemment posées
Comment savoir si mes données sont « normales » ?
Examinez un histogramme ou un graphique QQ, et pour une vérification formelle, utilisez un test de normalité (Shapiro-Wilk). Avec de grands échantillons, une légère non-normalité a peu d'importance grâce au théorème central limite ; avec de petits échantillons, privilégiez les tests non paramétriques en cas de doute.
Quelle est la différence entre des données appariées et des données indépendantes ?
Les données indépendantes proviennent de sujets différents et non liés au sein de chaque groupe. Les données appariées proviennent des mêmes sujets mesurés à deux reprises (avant/après) ou de paires appariées. L'appariement modifie le test utilisé ; il est donc essentiel de l'identifier avant l'analyse.
Paramétrique ou non paramétrique — lequel est le meilleur ?
Les tests paramétriques sont plus puissants lorsque leurs hypothèses sont vérifiées. Les tests non paramétriques sont plus sûrs pour les données asymétriques, ordinales ou issues de petits échantillons. Il est essentiel d'adapter le test à vos données, et non l'inverse.
Dois-je calculer la taille de l'échantillon avant de choisir un test ?
Oui. Le test que vous prévoyez d'utiliser détermine le calcul de la taille de l'échantillon , et les deux doivent être précisés dans votre protocole avant la collecte des données — les comités d'éthique et les examinateurs s'y attendent.
Un statisticien pourrait-il vérifier mon choix ?
Oui. Nos biostatisticiens examinent les plans d'étude, confirment le test approprié et effectuent l'analyse complète avec des résultats R reproductibles dans le cadre d'un logiciel d'analyse statistique.
Références et lectures complémentaires
Sources évaluées par des pairs et indexées dans PubMed sur la sélection et la présentation des tests statistiques.
Vous ne savez toujours pas quel test correspond à vos données ?
Nos biostatisticiens confirment le test approprié, vérifient les hypothèses et effectuent votre analyse complète avec des résultats R reproductibles.
Obtenez l'aide d'experts en statistiques