Veröffentlicht | Letzte Aktualisierung:
Ein Chi-Quadrat-Test beantwortet eine spezifische Frage: Unterscheiden sich die beobachteten Häufigkeiten in einer Reihe von Kategorien von den Vorhersagen, die Unabhängigkeit oder ein vorgegebenes Modell liefern würden? Karl Pearson führte den Test im Jahr 1900 ein , und Epidemiologen wenden ihn noch heute wöchentlich an, um Expositionsraten zwischen Gruppen zu vergleichen, Genotypdaten auf Fehler zu überprüfen und festzustellen, ob Krankheitsausbrüche saisonal gehäuft auftreten oder sich gleichmäßig über das Jahr verteilen. Andere Leitfäden zu diesem Thema wiederholen meist nur die Formel und belassen es dabei. Dieser Leitfaden hingegen erstellt zwei Kontingenztafeln manuell, überprüft jede Zahl mit unabhängiger Statistiksoftware und erklärt genau, wann die Chi-Quadrat-Approximation nicht mehr zuverlässig ist und stattdessen der Fisher-Exakt-Test angewendet werden sollte.
Wichtige Erkenntnisse
- A Chi-Quadrat-Test vergleicht die beobachteten Kategorienhäufigkeiten mit den unter einem Nullmodell erwarteten Häufigkeiten unter Verwendung der Statistik χ² = Σ(O − E)² / E.
- Das Chi-Quadrat-Unabhängigkeitstest prüft, ob zwei kategoriale Variablen miteinander in Zusammenhang stehen; Anpassungstest prüft, ob die Verteilung einer Variablen einem hypothetischen Muster entspricht.
- Freiheitsgrade Bei einer Kontingenztabelle entspricht die Anzahl der Zeilen − 1 × (Spalten − 1); bei der Anpassungsgüte entspricht sie der Anzahl der Kategorien minus 1, abzüglich aller aus den Daten geschätzten Parameter.
- Laut Cochrans Richtlinie von 1954 sollten nicht mehr als 20 % der Zellen eine erwartete Zellzahl unter 5 aufweisen, und keine Zelle sollte unter 1 fallen. Wird diese Grenze überschritten, Fishers exakter Test wird zur sichereren Wahl.
- Ein signifikantes Ergebnis des Chi-Quadrat-Tests zeigt einen Zusammenhang an. Die Stärke dieses Zusammenhangs ist eine separate Frage, die mit einer Odds Ratio, einem relativen Risiko oder Cramérs V beantwortet wird, nicht allein mit dem p-Wert.
In einfachen Worten
Stellen Sie sich zwei Patientengruppen vor, eine behandelte und eine unbehandelte, mit einem Ja/Nein-Ergebnis wie z. B. „genesen“. Ein Chi-Quadrat-Test untersucht, ob der Genesungsverlauf in beiden Gruppen gleich ist oder ob es tatsächlich Unterschiede gibt. Dazu wird eine kleine Tabelle mit Häufigkeiten erstellt, die Häufigkeiten berechnet, die sich ergeben würden, wenn die Behandlung keinen Unterschied machen würde, und gemessen, wie stark die tatsächlichen Häufigkeiten von diesem Wert abweichen. Eine große Abweichung zwischen tatsächlichen und erwarteten Häufigkeiten führt zu einem kleinen p-Wert und deutet auf einen tatsächlichen Zusammenhang zwischen Behandlung und Ergebnis hin. Eine geringe Abweichung bedeutet, dass das Muster in der Tabelle wahrscheinlich nur zufällig ist.
Bevor man dem Ergebnis vertraut, sind zwei Bedingungen zu beachten. Jede Kategorie muss tatsächlich voneinander getrennt sein, da ein Patient nicht doppelt gezählt werden kann, und die erwartete Häufigkeit in den meisten Zellen muss mindestens 5 betragen. Bei kleinen Stichproben ist stattdessen der Fisher-Exakt-Test erforderlich , der später in diesem Leitfaden erläutert wird.
Was ist ein Chi-Quadrat-Test?
Statistiker fassen Chi-Quadrat-Tests in einer Gruppe zusammen, die ein gemeinsames Merkmal aufweist: Jede Teststatistik folgt einer Chi-Quadrat-Verteilung, wenn die Nullhypothese zutrifft und der Stichprobenumfang ausreichend ist. Zwei dieser Tests decken nahezu alle Anwendungsfälle in der Forschungspraxis ab. Ein Chi-Quadrat-Unabhängigkeitstest untersucht zwei kategoriale Variablen, die an denselben Probanden gemessen wurden, beispielsweise Behandlungsgruppe und klinisches Ergebnis, und prüft, ob der Wert der einen Variable den Wert der anderen vorhersagt. Ein Chi-Quadrat-Anpassungstest untersucht eine einzelne kategoriale Variable und prüft, ob ihre beobachtete Verteilung einer vorab festgelegten Verteilung entspricht, beispielsweise einer gleichmäßigen Verteilung über vier Jahreszeiten oder einem Mendelschen Vererbungsverhältnis.
Die Wahl zwischen diesen beiden Tests sowie zwischen dem Chi-Quadrat-Test und einem völlig anderen Test hängt davon ab, wie die Daten erhoben wurden und welche Fragestellung gestellt wird. Leser, die sich noch nicht sicher sind, ob der Chi-Quadrat-Test überhaupt der richtige Test für ihre Daten ist, können vor dem Weiterlesen den interaktiven Testselektor von Editverse oder das Flussdiagramm für statistische Tests verwenden.
Beide Chi-Quadrat-Varianten basieren auf derselben Statistik.
χ² = Σ (O − E)² / E
O steht für die beobachtete Anzahl in einer Kategorie oder Zelle, E für die unter der Nullhypothese erwartete Anzahl. Die Summe erstreckt sich über alle Zellen der Tabelle. Durch Quadrieren der Differenz wird das Vorzeichen entfernt, sodass sowohl Über- als auch Unterzählungen den Wert erhöhen. Die Division durch E skaliert jede quadrierte Differenz mit der tatsächlich erwarteten Anzahl. Eine Zelle mit erwarteten 200 Beobachtungen kann eine Differenz von 10 problemlos verkraften. Eine Zelle mit erwarteten 5 Beobachtungen hingegen nicht, was sich in der Division durch E direkt widerspiegelt.
Wie die Chi-Quadrat-Teststatistik berechnet wird
Die erwarteten Häufigkeiten ergeben sich aus der Nullhypothese, nicht aus einer willkürlich gewählten runden Zahl. In einer Kontingenztabelle entspricht die erwartete Häufigkeit für eine Zelle dem Produkt aus Zeilen- und Spaltensumme, dividiert durch die Gesamtsumme. Diese Formel folgt direkt aus der Unabhängigkeitsannahme. Wenn zwei Variablen tatsächlich keinen Zusammenhang aufweisen, sollte der Anteil einer Spalte, der in einer bestimmten Zeile landet, dem Gesamtanteil dieser Zeile an der gesamten Tabelle entsprechen.
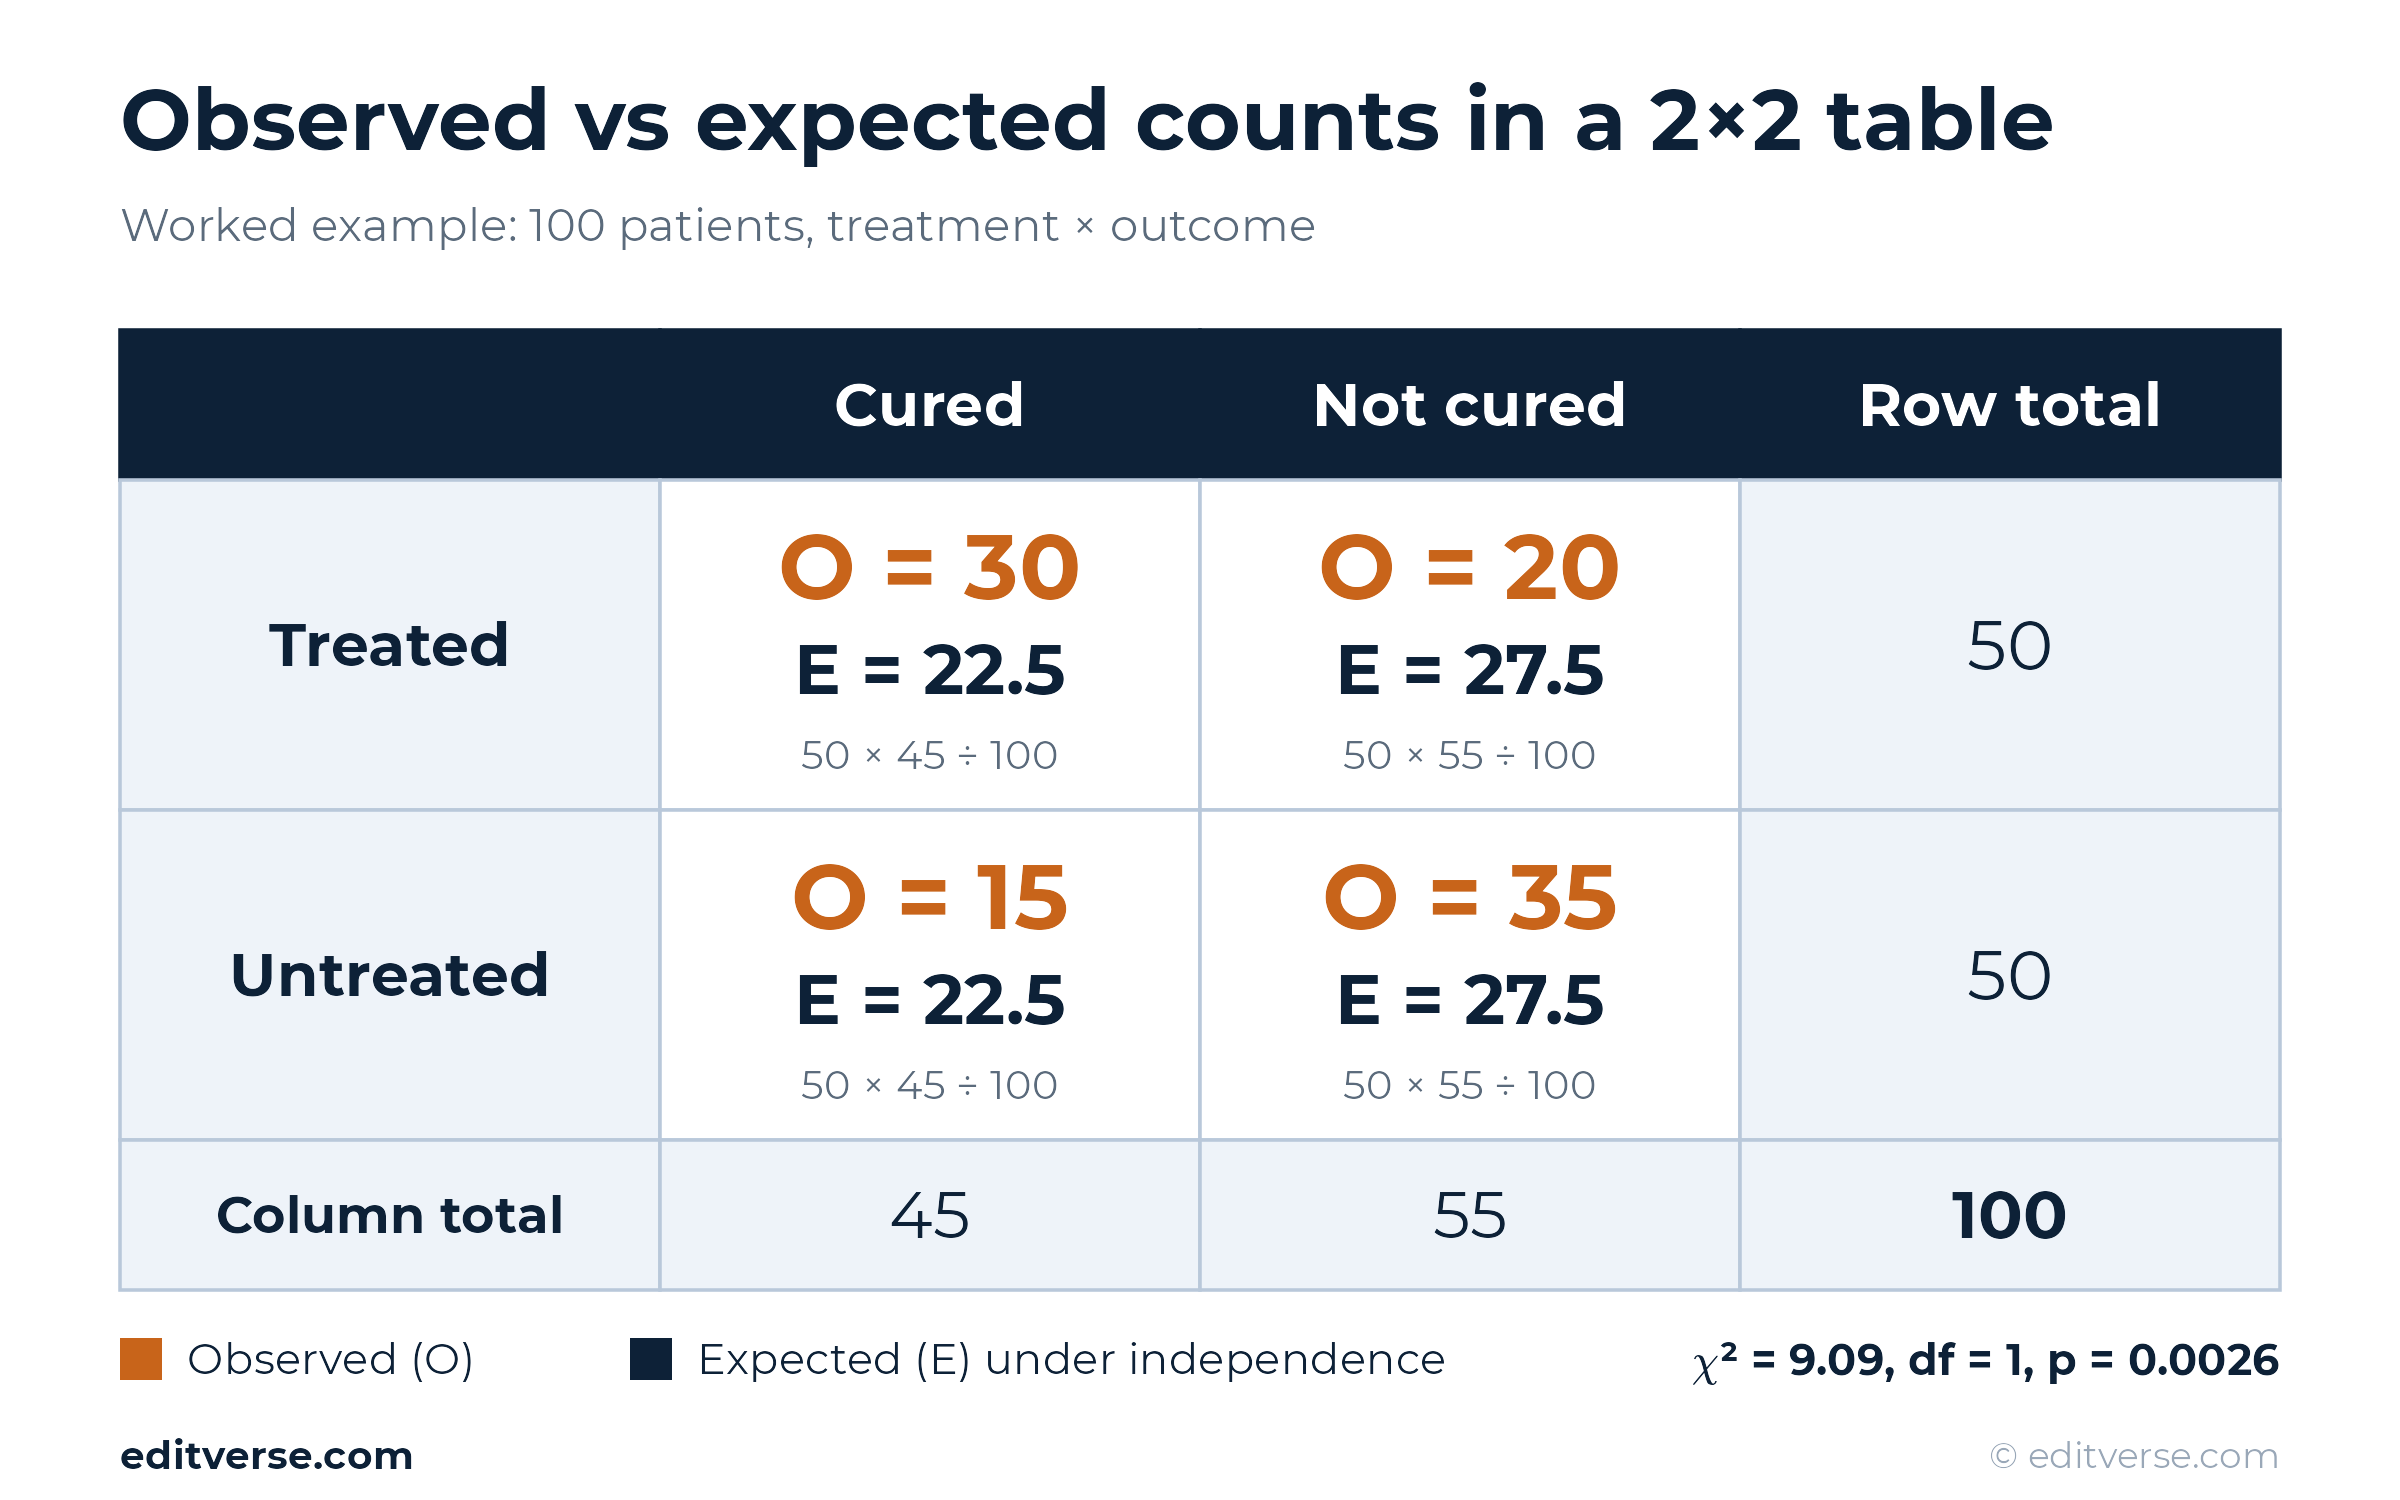
Ein kleines Beispiel verdeutlicht dies. Angenommen, 100 Patienten werden in 50 behandelte und 50 unbehandelte Patienten aufgeteilt, und 45 der 100 werden als geheilt und 55 als nicht geheilt eingestuft. Unter der Annahme der Unabhängigkeit sollte die behandelte Gruppe dieselbe Heilungsrate von 45 % aufweisen wie die unbehandelte Gruppe. Die erwartete Anzahl geheilter Patienten unter den Behandelten beträgt somit 50 × 45 ÷ 100, also 22.5. Erwartete Häufigkeiten müssen keine ganzen Zahlen sein. Nur beobachtete Häufigkeiten sind dies.
Die Güte der Anpassung wird anhand der erwarteten Fallzahlen überprüft, wobei diese jedoch auf einem angenommenen Anteil anstatt auf einer zweiten Variablen basieren. Um zu testen, ob sich 200 Krankheitsausbrüche gleichmäßig über vier Jahreszeiten verteilen, wird die erwartete Fallzahl für jede Jahreszeit auf 200 × 0.25, also 50, festgelegt. Anschließend wird gemessen, wie stark die tatsächlichen saisonalen Fallzahlen von dieser Nulllinie abweichen.
Freiheitsgrade beim Chi-Quadrat-Test
Die Freiheitsgrade bestimmen die Form der Chi-Quadrat-Verteilung. Ein falscher Wert für die Freiheitsgrade wird beim Verfassen des Ergebnisteils leicht übersehen, verändert aber den kritischen Wert, mit dem die Statistik verglichen wird, und kann eine grenzwertige Schlussfolgerung von signifikant zu nicht signifikant oder umgekehrt ändern. In einer Kontingenztafel mit r Zeilen und c Spalten entsprechen die Freiheitsgrade (r − 1)(c − 1). Eine Standard-2×2-Tabelle hat daher genau einen Freiheitsgrad, da nach Festlegung der Zeilen- und Spaltensummen nur noch eine Zelle frei variieren kann, bevor die übrigen durch Subtraktion verschwinden.
Die Freiheitsgrade für die Anpassungsgüte folgen einer verwandten, aber dennoch eigenständigen Regel. Sie entsprechen der Anzahl der Kategorien minus eins, abzüglich eines weiteren Freiheitsgrades für jeden Parameter, der anhand der Stichprobe geschätzt und nicht im Voraus festgelegt wird. Der Vergleich von vier Jahreszeiten mit einem pauschalen Erwartungswert von 25 % benötigt 4 − 1 = 3 Freiheitsgrade, da nichts anhand der Daten geschätzt wurde. Der Vergleich von Genotyphäufigkeiten mit Hardy-Weinberg-Proportionen ist komplexer, da die zur Berechnung der erwarteten Genotypanteile verwendete Allelfrequenz selbst anhand derselben Stichprobe geschätzt wird. Dieser Schätzschritt kostet einen zusätzlichen Freiheitsgrad über die einfache Regel „Häufigkeit minus eins“ hinaus.
Chi-Quadrat-Unabhängigkeitstest: Ein vollständig ausgearbeitetes Beispiel
Betrachten wir einen Vergleich von 100 Patienten in zwei Gruppen: 50 erhielten eine Behandlung, 50 nicht. Die Ergebnisse werden in einer Kreuztabelle dargestellt (geheilt/nicht geheilt). Dieser Datensatz kann auch im Chi-Quadrat-Test-Rechner von Editverse als Beispiel verwendet werden, sodass jeder der folgenden Schritte sofort nachvollzogen werden kann.
| Gehärtete | Nicht geheilt | Zeilensumme | |
|---|---|---|---|
| Behandelt | 30 | 20 | 50 |
| Unbehandelt | 15 | 35 | 50 |
| Spaltensumme | 45 | 55 | 100 |
Die erwarteten Häufigkeiten folgen der im vorherigen Abschnitt beschriebenen Regel (Zeilensumme mal Spaltensumme). Für behandelte und geheilte Patienten beträgt die erwartete Häufigkeit 50 × 45 ÷ 100 = 22.5. Für behandelte, aber nicht geheilte Patienten beträgt sie 50 × 55 ÷ 100 = 27.5. Für unbehandelte, aber geheilte Patienten beträgt sie ebenfalls 50 × 45 ÷ 100 = 22.5. Für unbehandelte, aber nicht geheilte Patienten beträgt sie ebenfalls 50 × 55 ÷ 100 = 27.5. Da alle erwarteten Häufigkeiten den Schwellenwert von 5 nach Cochran überschreiten, kann die übliche Chi-Quadrat-Approximation ohne Einschränkung angewendet werden.
Jede Zelle trägt (O − E)² ÷ E zum Gesamtwert bei. Behandelte und geheilte Zellen tragen (30 − 22.5)² ÷ 22.5 = 2.500 bei. Behandelte, aber nicht geheilte Zellen tragen (20 − 27.5)² ÷ 27.5 = 2.045 bei. Unbehandelte und geheilte Zellen tragen (15 − 22.5)² ÷ 22.5 = 2.500 bei. Unbehandelte, aber nicht geheilte Zellen tragen (35 − 27.5)² ÷ 27.5 = 2.045 bei. Die Summe dieser vier Beiträge ergibt χ² = 9.091 bei einem Freiheitsgrad, entsprechend p = 0.0026, was deutlich unter dem üblichen Signifikanzniveau von 0.05 liegt. Die Anwendung der Yates-Korrektur, die weiter unten ausführlich erläutert wird, senkt die Teststatistik auf 7.919 (p = 0.0049); ein unabhängig durchgeführter Fisher-Exakt-Test auf derselben Tabelle ergibt p = 0.0046. Alle drei Analysemethoden bestätigen, dass ein Zusammenhang zwischen Behandlung und Ergebnis besteht – genau die Art von Triangulation, die ein Gutachter in einem Ergebnisteil erwartet.
Signifikanz allein beschreibt nicht die Stärke des Zusammenhangs. Die Heilungschancen liegen bei behandelten Patienten zwischen 30 und 20, bei unbehandelten Patienten zwischen 15 und 35, was ein Odds Ratio von (30 × 35) ÷ (20 × 15) = 3.5 ergibt. Cramérs V, eine auf dem Chi-Quadrat-Test basierende Effektstärke zwischen 0 und 1 für eine 2×2-Tabelle, beträgt die Quadratwurzel aus (9.091 ÷ 100) bzw. 0.30 und liegt damit nach gängigen Maßstäben zwischen einem schwachen und einem mittleren Zusammenhang. Die Angabe des p-Werts neben dem Odds Ratio und Cramérs V anstelle des p-Werts allein unterscheidet einen publikationsreifen Ergebnisteil von einem, der Rückfragen bei Gutachtern auslöst. McHughs Ausführungen zu einer Studie über Impfungen am Arbeitsplatz folgen dem gleichen Ablauf: 23 von 92 ungeimpften Mitarbeitern erkrankten an einer Pneumokokken-Pneumonie, verglichen mit 5 von 92 Geimpften. Der Chi-Quadrat-Test belegt, dass der Unterschied nicht zufällig ist, und Cramérs V zeigt dann, wie stark er ist.
Kontingenztafel und erwartete Häufigkeiten: Ein praktisches 2×2-Beispiel
Eine Kontingenztabelle vergleicht zwei kategoriale Variablen, und der Chi-Quadrat-Test vergleicht die beobachtete Häufigkeit jeder Zelle mit ihrer erwarteten Häufigkeit : Zeilensumme × Spaltensumme ÷ Gesamtsumme. In der RECOVERY-Studie wurden hospitalisierte COVID-19-Patienten randomisiert entweder mit 6 mg Dexamethason täglich oder mit der Standardbehandlung behandelt. Die Todesfälle wurden innerhalb von 28 Tagen erfasst. Der Abschlussbericht ist auf PubMed Central frei zugänglich ; die Zusammenfassung enthält alle benötigten Daten: 2,104 Patienten in der Dexamethason-Gruppe, 4,321 in der Standardbehandlungsgruppe, 482 bzw. 1,110 Todesfälle.
| Gruppe an | Verstorben am 28. Tag | Überlebt | Gesamt |
|---|---|---|---|
| Dexamethasone | 482 | 1,622 | 2,104 |
| Übliche Pflege | 1,110 | 3,211 | 4,321 |
| Gesamt | 1,592 | 4,833 | 6,425 |
Schritt 1: erwartete Häufigkeiten
Wenn Dexamethason keinen Unterschied machen würde, würden sich die Todesfälle proportional zur Gruppengröße verteilen. Die Gesamtmortalität beträgt 1,592 / 6,425. Erwartete Todesfälle unter Dexamethason = 1,592 × 2,104 / 6,425 = 521.33 ; erwartete Todesfälle unter Standardbehandlung = 1,592 × 4,321 / 6,425 = 1,070.67 . Die beobachteten Todesfälle betragen 482 bzw. 1,110. Somit liegt die Mortalität unter Dexamethason 39.3 unter dem Erwartungswert und unter Standardbehandlung 39.3 darüber.

Schritt 2: die Teststatistik
χ² = Σ (O − E)² / E = 5.87 bei einem Freiheitsgrad, p = 0.015. Mit Yates-Korrektur χ² = 5.72 (p = 0.017). Die standardisierten Residuen betragen −1.72 (Dexamethason, verstorben) und +1.20 (Standardbehandlung, verstorben); keines überschreitet den Bereich von ±2, daher sticht keine Zelle hervor. Alle erwarteten Häufigkeiten liegen über 500, daher ist die Näherung für große Stichproben zulässig. R² chisq.test und Pythons scipy.stats.chi2_contingency zurückgegebene identische Werte.
Chi-Quadrat-Anpassungstest: Ein zweites Rechenbeispiel
Überwachungsteams stellen häufig eine andere Frage: nicht, ob zwei Variablen zusammenhängen, sondern ob die Verteilung einer Variablen einem erwarteten Muster entspricht. Angenommen, ein Gesundheitsamt erfasst 200 bestätigte Fälle einer Magen-Darm-Erkrankung im Laufe eines Kalenderjahres und möchte wissen, ob die Erkrankungsfälle saisonal gehäuft auftreten oder gleichmäßig verteilt sind. Unter der Nullhypothese, dass keine Saisonalität vorliegt, wären in jeder der vier Jahreszeiten 200 × 0.25 = 50 Fälle zu erwarten.
| Jahreszeit | Beobachtete | Voraussichtlich | (O − E)² ÷ E |
|---|---|---|---|
| Winter | 72 | 50 | 9.68 |
| Frühling | 38 | 50 | 2.88 |
| Sommer | 33 | 50 | 5.78 |
| Fallen | 57 | 50 | 0.98 |
Die Summe der Beiträge über alle vier Jahreszeiten beträgt χ² = 19.32 bei 4 − 1 = 3 Freiheitsgraden, was zu einem p-Wert von 0.00023 führt. Dieses Ergebnis verwirft die Nullhypothese einer gleichmäßigen Verteilung eindeutig. Der Beitrag des Winters (9.68) und der des Sommers (5.78) machen den größten Teil der Gesamtstatistik aus und weisen direkt auf die Ursache der Abweichung hin. Der Winter liegt deutlich über seinem erwarteten Anteil und der Sommer deutlich darunter, anstatt dass alle Jahreszeiten leicht in dieselbe Richtung driften. Diese Unterscheidung lässt sich durch den Gesamt-p-Wert allein nicht erfassen und erfordert die Betrachtung des Beitrags jeder einzelnen Zelle.
Diese Vorgehensweise findet sich in der gesamten Epidemiologie wieder, meist bei der Überprüfung, ob die Genotypzahlen dem Hardy-Weinberg-Gleichgewicht entsprechen (Qualitätskontrolle bei der Genotypisierung) oder ob eine Diagnose mit den erwarteten Anteilen einer Referenzpopulation übereinstimmt. Das Vorgehen bleibt dabei immer gleich: Man gibt die Nullproportionen an, multipliziert sie mit dem Gesamtstichprobenumfang, um die erwarteten Häufigkeiten zu erhalten, summiert die quadrierten standardisierten Abweichungen und vergleicht die Summe mit einer Chi-Quadrat-Verteilung mit den entsprechenden Freiheitsgraden.
Wann der Chi-Quadrat-Test versagt: Kleine erwartete Zellhäufigkeiten
Die Chi-Quadrat-Statistik ist immer nur eine Näherung. Ihre Referenzverteilung setzt voraus, dass sich die Zellhäufigkeiten hinreichend wie eine stetige, annähernd normalverteilte Größe verhalten, sodass die diskrete Summe der quadrierten Abweichungen eine glatte Chi-Quadrat-Kurve beschreibt. Diese Annahme beruht darauf, dass jede Zelle eine ausreichend große erwartete Häufigkeit aufweist, ähnlich wie eine Normalapproximation einer Binomialverteilung genügend Versuche benötigt, bevor sie in den Randbereichen keine Ungenauigkeiten mehr aufweist. Sobald die erwartete Häufigkeit auf 2 oder 3 sinkt, liegen die wenigen Werte, die die beobachtete Häufigkeit tatsächlich annehmen kann, weit auseinander im Verhältnis zu ihrer Streuung, die wahre Stichprobenverteilung der Statistik wird unregelmäßig statt glatt, und die Chi-Quadrat-Kurve passt schlecht dazu.
William Cochrans 1954 in der Fachzeitschrift „Biometrics“ veröffentlichte Arbeit machte aus dieser theoretischen Problematik eine bis heute gültige Regel. Nicht mehr als 20 % der Zellen sollten eine erwartete Häufigkeit unter 5 aufweisen, und keine einzelne Zelle sollte unter 1 liegen; wird eine dieser Grenzen überschritten, ist der angegebene p-Wert nicht mehr ohne Weiteres aussagekräftig. Simulationsstudien jener Zeit lieferten diese Regel, nicht etwa einen geschlossenen Beweis. Spätere Arbeiten bestätigen die zugrundeliegende Problematik immer wieder, auch wenn der genaue Schwellenwert weiterhin diskutiert wird. Dies gilt beispielsweise für die Methodenliteratur zum Hardy-Weinberg-Test, die den gewöhnlichen Chi-Quadrat-Anpassungstest als sehr empfindlich gegenüber kleinen Stichprobenumfängen oder seltenen Allelfrequenzen beschreibt.
Eine kleine Tabelle verdeutlicht die praktischen Konsequenzen. Betrachten wir eine 2×2-Tabelle mit den Häufigkeiten 4, 1, 1 und 4, wobei jede erwartete Häufigkeit 2.5 beträgt und damit deutlich unter dem Cochran-Niveau liegt. Die unkorrigierte Chi-Quadrat-Statistik ergibt 3.6 bei einem Freiheitsgrad und p = 0.058 – ein Ergebnis, das naheliegend auf Signifikanz hindeutet. Die Yates-Korrektur senkt die Werte für dieselbe Tabelle auf χ² = 1.6 (p = 0.206), und ein unabhängig durchgeführter Fisher-Exakt-Test liefert ebenfalls p = 0.206. Dieser Wert stimmt nahezu exakt mit der korrigierten Chi-Quadrat-Statistik überein und widerspricht der unkorrigierten Version deutlich. Die Angabe des unkorrigierten p-Werts würde die Evidenz für einen Zusammenhang überbewerten, den der exakte Test nicht bestätigt.
Yates' Stetigkeitskorrektur erklärt
Frank Yates schlug 1934 in einem Artikel im Journal of the Royal Statistical Society eine Korrektur für kleine 2×2-Tabellen vor . Da die Chi-Quadrat-Verteilung stetig ist, die Zellhäufigkeiten jedoch diskrete ganze Zahlen darstellen, empfahl Yates, vor dem Quadrieren jeweils 0.5 vom Absolutwert der Differenz (O − E) zu subtrahieren. Dadurch wird die Teststatistik verkleinert und der p-Wert im Vergleich zur unkorrigierten Version erhöht. In der oben genannten kleinen 4×2-Tabelle senkte diese Anpassung die Teststatistik von 3.6 auf 1.6 – genau die Art von Korrektur, die verhindern soll, dass der unkorrigierte Test in Tabellen mit wenigen Zellen eine zu hohe Signifikanz behauptet.
Ob diese Korrektur standardmäßig angewendet werden sollte, ist seit Jahrzehnten umstritten, ohne dass eine endgültige Klärung stattgefunden hat. Auch dieser Leitfaden erhebt nicht den Anspruch, die Angelegenheit sei abgeschlossen. Haviland argumentierte 1990 in „Statistics in Medicine“, dass die Yates-korrigierte Statistik übermäßig konservativ sei und ein einfacher Pearson-Chi-Quadrat-Test den Fehler 1. Art für die meisten 2×2-Tabellen, mit denen Forscher tatsächlich arbeiten, bereits ausreichend kontrolliere. Eine neuere Analyse kam zum gegenteiligen Schluss. Prescott empfiehlt 2021 in „Statistics in Medicine“ für medizinische Forschungsanwendungen, 2×2-Tabellen mit der doppelten einseitigen exakten Wahrscheinlichkeit des Fisher-Tests oder, als Näherungswert, mit dem Yates-korrigierten Chi-Quadrat-Test zu testen. Angesichts dieser anhaltenden Uneinigkeit unter Statistikern ist es ratsam, die verwendete Version anzugeben und bei kleinen Tabellen, bei denen die Wahl relevant ist, den Fisher-Test anstelle einer der Chi-Quadrat-Varianten zu verwenden.
Eine veröffentlichte Studie zeigt, wie stark die Ergebnisse der verschiedenen Versionen voneinander abweichen können. In der von Bewick, Cheek und Ball zur Veranschaulichung von Kontingenztafeltests verwendeten Studie mit intravenös verabreichtem Nitrat starben 3 von 50 behandelten Patienten und 8 von 45 Kontrollpersonen. Der unkorrigierte Chi-Quadrat-Test ergibt χ² = 3.21 bei einem Freiheitsgrad (p = 0.073), die Yates-korrigierte Statistik sinkt auf 2.16 (p = 0.141), und der Fisher-Exakt-Test, berechnet als doppelte einseitige Wahrscheinlichkeit, liefert p = 0.140. Die unkorrigierte Version liegt deutlich näher an der Signifikanzgrenze als die beiden anderen, weshalb im Methodenteil die verwendete Version angegeben werden sollte.

Benötigen Sie eine Durchführung oder Überprüfung dieser Analyse? Ein promovierter Biostatistiker prüft Ihr Studiendesign, führt die Analyse durch und verfasst den Abschnitt zu den statistischen Methoden für Ihr Manuskript.
Fisher-Exakt-Test: Die Alternative für kleine Stichproben
Ronald Fisher beschrieb den exakten Ansatz 1922 in einem Artikel im Journal of the Royal Statistical Society und baute dabei auf der gleichen Kontingenztafellogik auf, die Pearson zwei Jahrzehnte zuvor eingeführt hatte. Anstatt eine Stichprobenverteilung durch eine glatte Kurve anzunähern, fixiert Fishers exakter Test die Zeilen- und Spaltensummen und berechnet mithilfe der hypergeometrischen Verteilung die exakte Wahrscheinlichkeit jeder möglichen Tabelle, die mindestens so extrem ist wie die beobachtete. Der Verzicht auf einen Approximationsschritt bedeutet, dass kein Risiko der oben beschriebenen Abweichung von der glatten Kurve besteht. Genau deshalb ist der exakte Test dort zuverlässig, wo der gewöhnliche Chi-Quadrat-Test versagt.
Sahai und Khurshid erläutern in ihrer 1995 im Journal of Biopharmaceutical Statistics veröffentlichten Übersichtsarbeit die Vor- und Nachteile detailliert und weisen darauf hin, dass der exakte Test bei bestimmten Tabellenkonfigurationen selbst konservativ sein kann. Daher führt der Wechsel zum Fisher-Test nicht automatisch zu einem aussagekräftigeren Test, sondern lediglich zu einem besser begründeten, wenn die Stichproben klein sind. Aus dem oben genannten Schwellenwert von Cochran ergibt sich eine praktische Entscheidungsregel: Führen Sie den gewöhnlichen Chi-Quadrat-Test durch, wenn jede oder nahezu jede erwartete Häufigkeit 5 oder mehr beträgt. Wechseln Sie zum Fisher-Exakt-Test , sobald diese Bedingung nicht mehr erfüllt ist, unabhängig von der Größe der Gesamtstichprobe. Denn selbst eine große Gesamtzahl kann in einer unausgewogenen Tabelle eine einzelne Zelle mit geringer Datendichte verbergen.
Anwendungen des Chi-Quadrat-Tests in der Epidemiologie in der Praxis
Veröffentlichte epidemiologische Studien greifen häufig auf Chi-Quadrat-Tests zurück, fast immer als erste Überprüfung vor komplexeren Modellierungen. Hazra und Gogtay nennen in ihrem Biostatistik-Tutorial im Indian Journal of Dermatology den Pearson-Chi-Quadrat-Test, den McNemar-Chi-Quadrat-Test für gepaarte Binärdaten und den Mantel-Haenszel-Chi-Quadrat-Test für stratifizierte Tabellen als die drei Varianten, die in der klinischen Forschung am häufigsten verwendet werden. Jede dieser Varianten eignet sich für eine bestimmte Datenstruktur und ist nicht austauschbar.
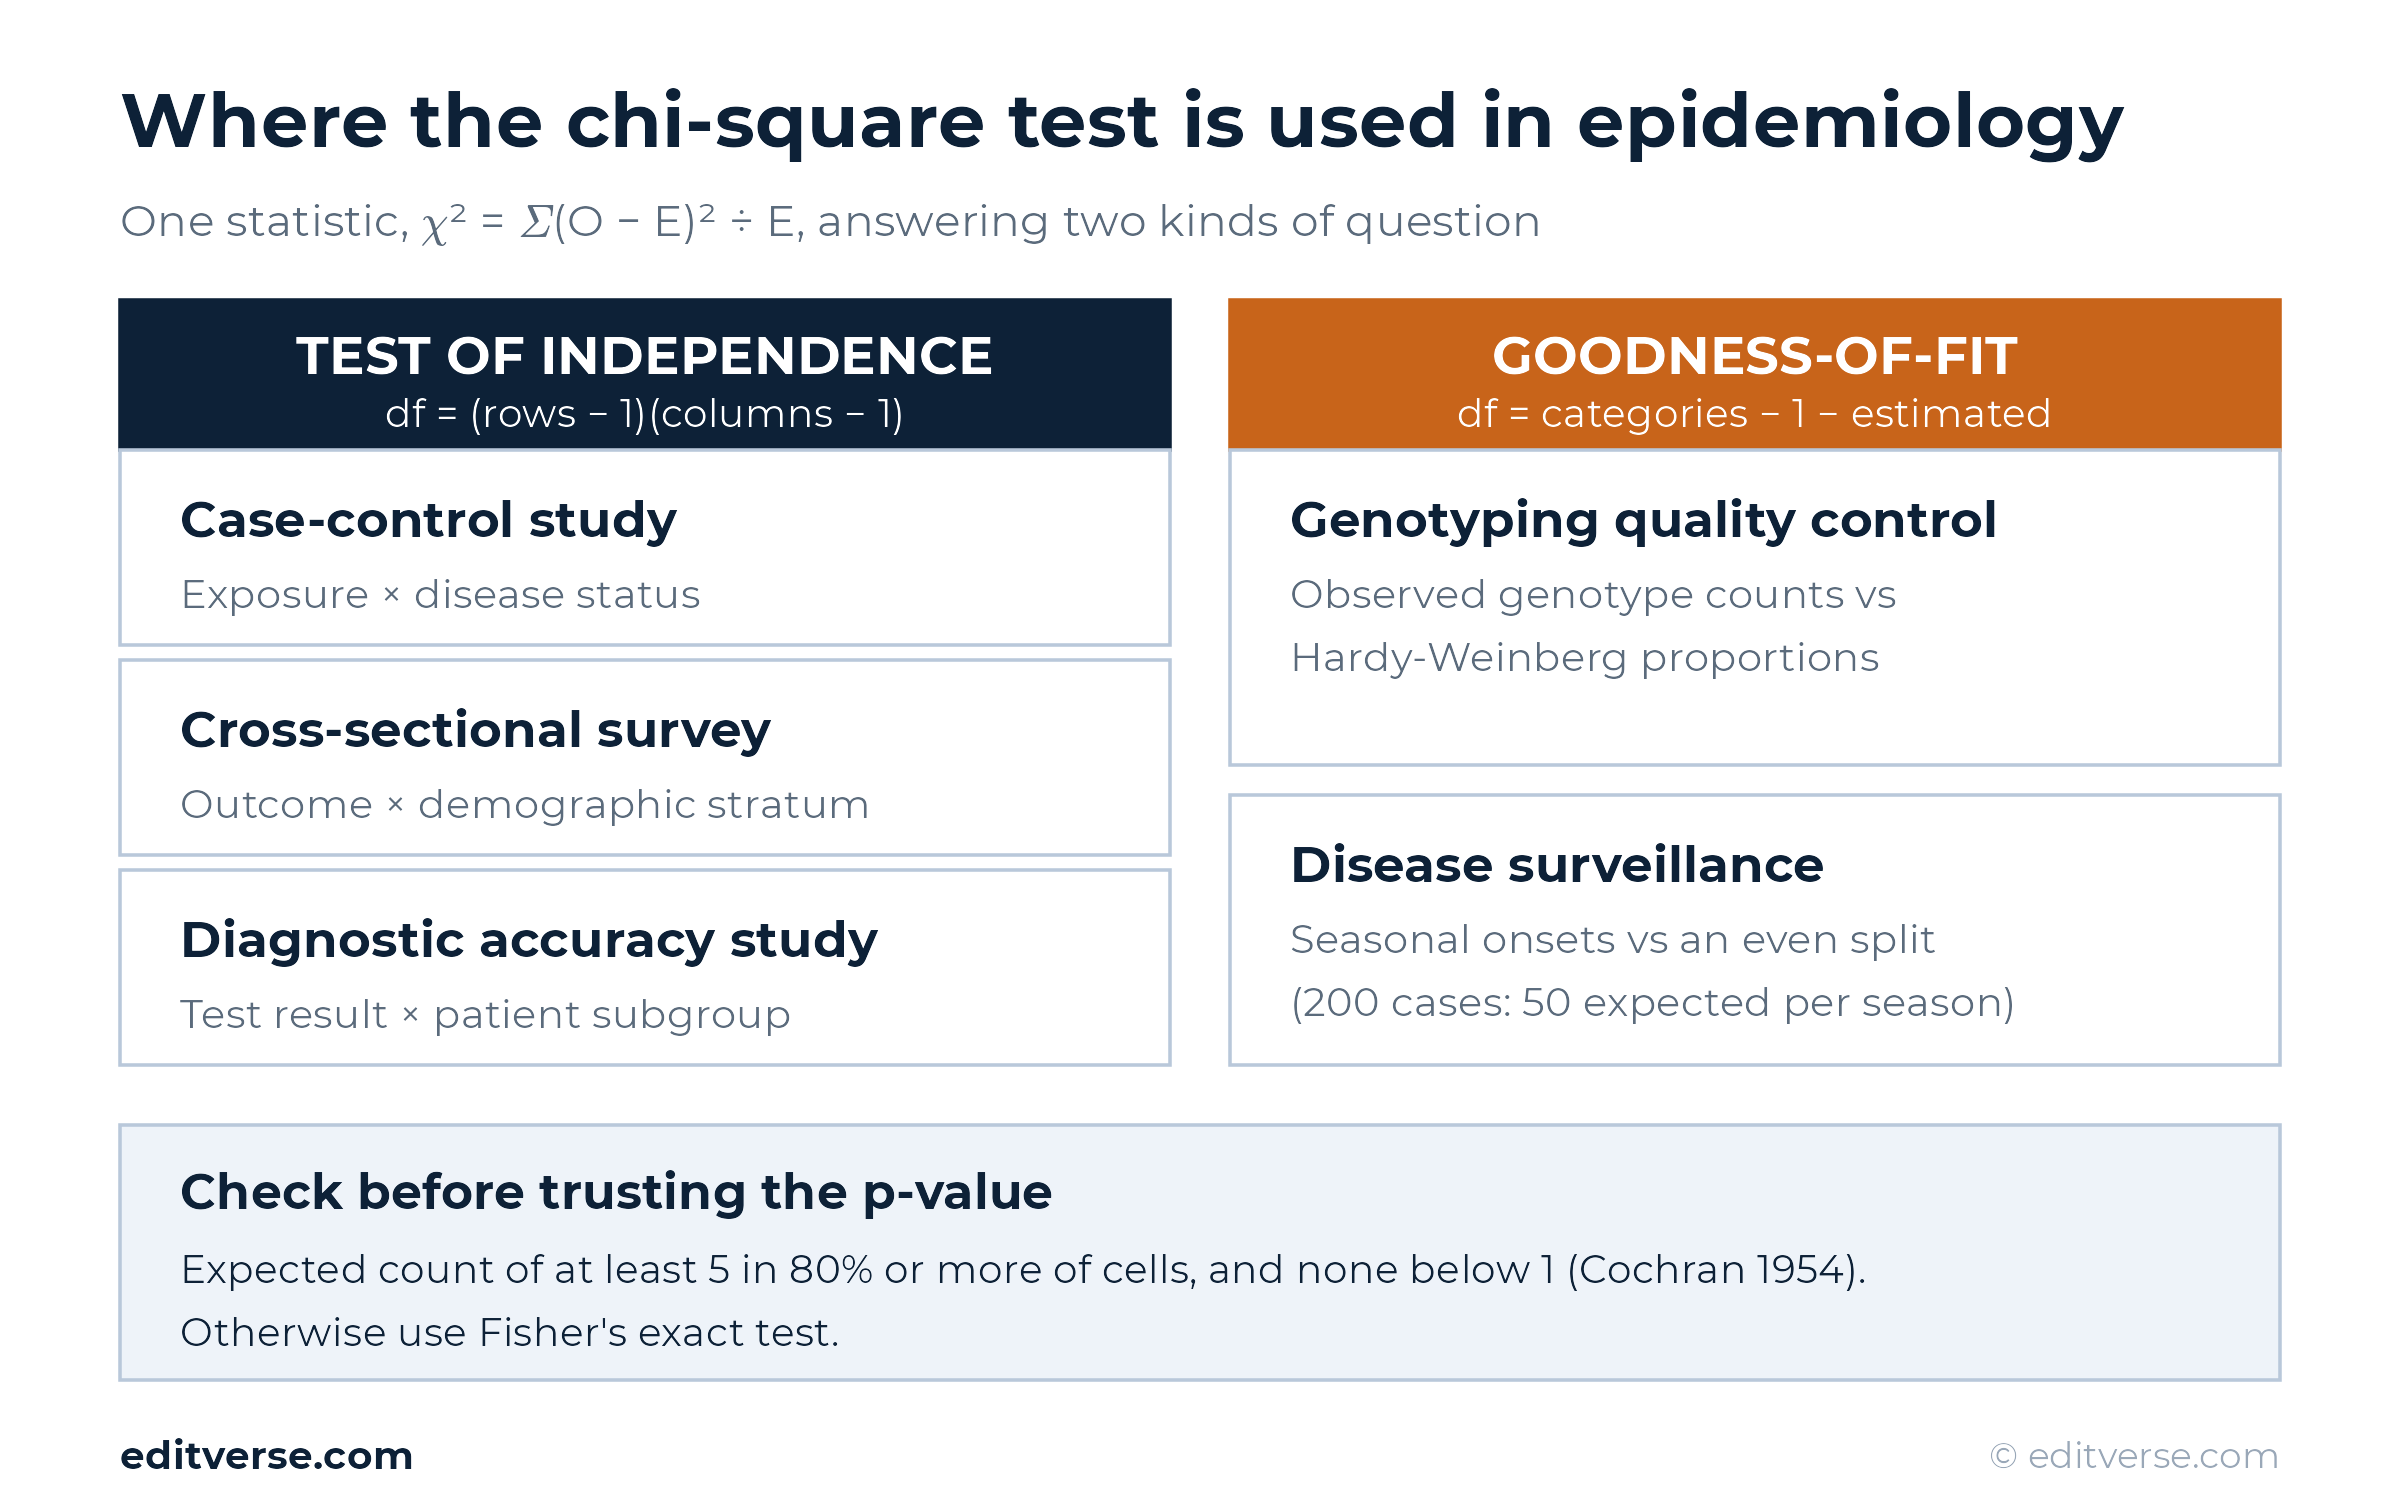
Die genetische Epidemiologie nutzt den Anpassungstest als routinemäßiges Qualitätskontrollverfahren. Genotypisierungsstudien prüfen, ob die beobachteten Genotyphäufigkeiten an einem bestimmten Locus den Hardy-Weinberg-Proportionen entsprechen. Eine signifikante Abweichung deutet häufig auf einen Genotypisierungsfehler, Populationsstratifizierung oder tatsächlichen Selektionsdruck hin und ist nicht ohne Weiteres als Ergebnis zu interpretieren. Diese Unterscheidung wird in den Kapiteln zu genetischen Methoden und dem Hardy-Weinberg-Test detailliert erläutert, insbesondere für Forschende, die genetische Assoziationsstudien durchführen. In einem Genom-Scan identifizierte ein Hardy-Weinberg-Test mit einem Freiheitsgrad, der über 44 Markerloci durchgeführt wurde, 7 Loci mit einem signifikanten Überschuss an scheinbaren Homozygoten (χ² > 6), ein Muster, das auf einen Typisierungsfehler hindeutet. Ein weit verbreitetes Tutorial zur 2×2-Tabelle, das in der Zeitschrift Disability and Rehabilitation veröffentlicht wurde, arbeitet eine Brustkrebs-Risikofaktorentabelle von Anfang bis Ende durch und argumentiert, dass Zeitschriftenherausgeber in jeder veröffentlichten Tabelle sowohl beobachtete als auch erwartete Zellhäufigkeiten verlangen sollten, nicht nur die Teststatistik, damit die Leser selbst beurteilen können, ob Cochrans Schwellenwert erreicht wurde.
Außerhalb der Genetik findet der Unabhängigkeitstest Anwendung in Fall-Kontroll-Studien zur Untersuchung des Zusammenhangs zwischen Exposition und Krankheitsstatus, in Querschnittsstudien zum Vergleich eines kategorialen Ergebnisses über demografische Schichten hinweg sowie in diagnostischen Studien zum Vergleich von Testergebnissen in verschiedenen Patientensubgruppen. Überwachungsdaten werden immer dann mit dem Anpassungstest geprüft, wenn sie mit einem erwarteten Muster, sei es saisonal oder anderweitig, verglichen werden müssen, wie oben dargestellt.
Häufige Fehler bei der Berichterstattung von Chi-Quadrat-Tests
Einige wenige Fehler treten sowohl in eingereichten Manuskripten als auch in veröffentlichten Artikeln immer wieder auf.
- Prozentangaben anstelle von absoluten Zahlen eingeben. Chi-Quadrat-Formeln basieren auf Häufigkeiten, nicht auf Anteilen. Daher ist es zwingend erforderlich, einen Prozentsatz vor dem Test in eine tatsächliche Anzahl umzurechnen.
- Die Schwelle für die erwartete Anzahl wird ignoriert. Die Veröffentlichung eines Chi-Quadrat-p-Werts aus einer Tabelle mit mehreren Zellen unter 5, ohne auf diese Einschränkung hinzuweisen oder auf den exakten Fisher-Test umzusteigen, zählt zu den am häufigsten vermeidbaren statistischen Fehlern in diesem Bereich.
- Anwendung des Unabhängigkeitstests auf gepaarte Daten. Vorher-Nachher-Messungen oder gepaarte Messungen an denselben Probanden verletzen die Unabhängigkeitsannahme kategorisch. McNemar-Test Existiert genau für solche Situationen.
- Signifikanz berichten, ohne eine Effektstärke anzugeben. Ein p-Wert bestätigt das Bestehen eines Zusammenhangs. Ob dieser Zusammenhang klinisch relevant ist, ist eine andere Frage; daher sind Cramérs V, Phi oder ein Wahrscheinlichkeit gehört zu jedem Chi-Quadrat-Ergebnis.
- Die Freiheitsgrade falsch einschätzen. Ein nicht übereinstimmender Wert ist für einen statistischen Gutachter leicht zu erkennen und signalisiert, dass die Analyse vor der Einreichung nicht sorgfältig geprüft wurde.
Wie man einen Chi-Quadrat-Test in seinem Manuskript berichtet
Die meisten Fachzeitschriften im Bereich der Gesundheitswissenschaften verwenden eine ähnliche Berichtsvorlage. Dabei werden der Testname, die Freiheitsgrade (in Klammern), der Stichprobenumfang, die Teststatistik und der p-Wert in dieser Reihenfolge angegeben, beispielsweise „χ²(1, N = 100) = 9.09, p = 003“. Unmittelbar darauf folgen die Effektstärke und, bei einer 2×2-Tabelle, die Odds Ratio oder das relative Risiko mit dem zugehörigen Konfidenzintervall. Ein vielbeachteter Leitfaden zur statistischen Fehlinterpretation, der im European Journal of Epidemiology veröffentlicht wurde, weist darauf hin, dass ein p-Wert allein, ohne Angabe eines Konfidenzintervalls, dazu verleitet, „signifikant“ fälschlicherweise als „groß“ oder „wichtig“ zu interpretieren.
Eine Ergebnistabelle sollte die absoluten Häufigkeiten für jede Zelle und nicht nur die Prozentwerte ausweisen, damit ein aufmerksamer Leser den Test selbstständig nachrechnen kann. Im Methodenteil sollte die angewandte Korrektur (falls vorhanden) angegeben werden (unkorrigierter Pearson-Test, Yates-korrigierter Test oder Fisher-Exakt-Test) sowie die verwendete Software und deren Version. Forschende, die den Chi-Quadrat-Test noch gegen andere Optionen für einen umfassenderen Analyseplan abwägen, finden möglicherweise auch den Leitfaden von Editverse zur Auswahl des richtigen statistischen Tests hilfreich, insbesondere für die Teile eines Manuskripts, die keine kategorialen Daten enthalten.
Benötigen Sie fachkundige Unterstützung bei Ihrer statistischen Analyse?
Die Biostatistiker von Editverse erstellen Kontingenztafeln, wählen korrekt zwischen Chi-Quadrat- und Fisher-Test und liefern publikationsfertige Ergebnisse mit vollständig reproduzierbarer R-Ausgabe. Berechnen Sie die Daten zunächst mit dem kostenlosen Chi-Quadrat-Testrechner oder übermitteln Sie die Rohdaten direkt über den Just Data Service für eine umfassende Analyse, die Erstellung des Berichts und die Unterstützung bei der Einreichung bei Fachzeitschriften.
Fazit
Die korrekte Durchführung eines Chi-Quadrat-Tests erfordert mehr als das bloße Einsetzen von Häufigkeitswerten in eine Formel. Die erwarteten Häufigkeiten müssen aus einer klar formulierten Nullhypothese abgeleitet werden, die Freiheitsgrade müssen der tatsächlichen Tabellenform entsprechen, und die Wahl zwischen dem gewöhnlichen Chi-Quadrat-Test, der Yates-korrigierten Version und dem Fisher-Exakt-Test sollte sich nach der Größe der kleinsten erwarteten Zelle richten und nicht nach Gewohnheit. Die beiden obenstehenden Tabellen, die in jedem Schritt mit unabhängiger Statistiksoftware überprüft wurden, zeigen, wie stark sich ein Ergebnis verändern kann, wenn die erwarteten Häufigkeiten klein werden, und warum ein p-Wert, der ungeprüft aus der Softwareausgabe übernommen wird, nur ein unvollständiges Bild liefert.
Kategorische Daten dieser Art stehen im Mittelpunkt von Fall-Kontroll-Studien, Untersuchungen zur diagnostischen Genauigkeit und genetischen Assoziationsstudien. Genau deshalb prüfen Gutachter diesen speziellen Test so genau. Werden die Annahmen von Anfang an korrekt erfüllt und die Effektstärke zusammen mit dem p-Wert angegeben, erübrigt sich die Aufforderung zur Überarbeitung, bevor das Manuskript überhaupt verfasst wird.
Kostenlose Tools für Ihre Analyse
- GraphPro: Druckfertige Diagramme mit integrierten Chi-Quadrat-p-Werten. Kostenlos, keine Anmeldung erforderlich.
- StatPro: kostenlose Statistikrechner und ein Testauswahltool für kategoriale Ergebnisse.
- Flowchart ProCONSORT-, STROBE- und PRISMA-Flussdiagramme in Ihrem Browser.
FAQ
Wozu dient ein Chi-Quadrat-Test?
Mit einem Chi-Quadrat-Test wird geprüft, ob die beobachteten Häufigkeiten in einer Kategorie von den unter der Nullhypothese erwarteten Häufigkeiten abweichen, entweder weil zwei kategoriale Variablen miteinander in Beziehung stehen (Unabhängigkeitstest) oder weil die Verteilung einer Variablen nicht einem vorgegebenen Muster entspricht (Anpassungstest).
Wie lautet die Formel für den Chi-Quadrat-Test?
χ² = Σ (O − E)² / E, wobei O die beobachtete Anzahl in jeder Zelle ist, E die erwartete Anzahl in dieser Zelle unter der Nullhypothese ist und die Summe über alle Zellen in der Tabelle läuft.
Wie viele Freiheitsgrade hat ein Chi-Quadrat-Test?
Eine Kontingenztafel hat (Zeilen − 1) × (Spalten − 1) Freiheitsgrade, eine 2×2-Tabelle hat also genau 1. Ein Anpassungstest hat die Anzahl der Kategorien minus 1, minus eins mehr für jeden aus der Stichprobe geschätzten Parameter.
Wann sollte ich den Fisher-Exakttest anstelle des Chi-Quadrat-Tests verwenden?
Wechseln Sie zum Fisher-Exakt-Test, wenn mehr als 20 % der Zellen einer Tabelle eine erwartete Häufigkeit unter 5 aufweisen oder wenn eine einzelne Zelle eine erwartete Häufigkeit unter 1 aufweist, gemäß den Empfehlungen von Cochran aus dem Jahr 1954.
Sollte ich immer die Stetigkeitskorrektur nach Yates anwenden?
Statistiker sind sich uneins. Einige Studien deuten darauf hin, dass die Korrektur bei größeren 2×2-Tabellen zu konservativ ist, während andere neuere Arbeiten sie – oder einen gleichwertigen exakten Test – insbesondere für die medizinische Forschung empfehlen. Die Angabe der verwendeten Version ist wichtiger als die Wahl einer universellen Standardmethode.
Worin besteht der Unterschied zwischen dem Chi-Quadrat-Unabhängigkeitstest und dem Anpassungstest?
Der Unabhängigkeitstest vergleicht zwei kategoriale Variablen in einer Kontingenztabelle miteinander. Der Anpassungstest vergleicht die beobachtete Verteilung einer einzelnen Variablen mit einer vorab festgelegten Verteilung.
Sagt mir ein signifikantes Chi-Quadrat-Ergebnis etwas über die Stärke des Zusammenhangs?
Nein. Signifikanz bedeutet lediglich, dass ein Zusammenhang auf dem gewählten Signifikanzniveau (α) wahrscheinlich nicht zufällig ist. Für die Stärke eines Zusammenhangs ist eine separate Effektstärkeberechnung erforderlich, beispielsweise Cramérs V, Phi oder eine Odds Ratio.
Können Chi-Quadrat-Tests auch auf kontinuierliche Daten angewendet werden?
Nicht direkt. Kontinuierliche Messwerte müssen zunächst in Kategorien eingeteilt werden, wodurch Informationen verloren gehen. Daher ist ein t-Test, eine ANOVA oder ein Regressionsmodell in der Regel die bessere Wahl, wenn das Ergebnis tatsächlich kontinuierlich ist.
Referenzen
- Pearson K. Über das Kriterium, dass ein gegebenes System von Abweichungen vom Wahrscheinlichen im Falle eines korrelierten Systems von Variablen so beschaffen ist, dass man vernünftigerweise annehmen kann, dass es durch Zufallsstichproben entstanden ist. Philos Mag. 1900;50(302):157–175. doi.org/10.1080/14786440009463897
- Fisher RA. Zur Interpretation von χ² aus Kontingenztafeln und zur Berechnung von P. JR Stat Soc. 1922;85(1):87–94. doi.org/10.2307/2340521
- Yates F. Kontingenztafeln mit kleinen Zahlen und der χ²-Test. Ergänzung JR Stat Soc. 1934;1(2):217–235. doi.org/10.2307/2983604
- Cochran WG. Einige Methoden zur Stärkung der gängigen χ²-Tests. Biometrie. 1954;10(4):417–451. doi.org/10.2307/3001616
- Haviland MG. Yates' Korrektur für Stetigkeit und die Analyse von 2 x 2 Kontingenztafeln. Statistik Med. 1990;9(4):363–367. PMID 2362976
- Prescott RJ. Zweiseitige Signifikanztests für 2 x 2 Kontingenztafeln. Was ist die Alternative? Statistik Med. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. Zur Analyse epidemiologischer Daten unter Verwendung einer 2 x 2 Kontingenztabelle: ein Überblick über den Fisher-Exakt-Test und die Yates-Korrektur für Stetigkeit. J Biopharm Stat. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. Biostatistik-Reihe Modul 4, Vergleich von Gruppen, kategoriale Variablen. Indian J Dermatol. 2016;61(4):385–392. PMID 27512183
- Wang J, Shete S. Prüfung der Abweichung von den Hardy-Weinberg-Proportionen. Methoden Mol Biol2012;850:77–102. PMID 22307695
- Rigby AS. Statistische Methoden in der Epidemiologie. VII. Ein Überblick über den Chi2-Test für die 2 x 2-Kontingenztafelanalyse. Behinderung Reha. 2002;23(16):693–697. PMID 11732558
- Greenland S, Senn SJ, Rothman KJ, et al. Statistische Tests, P-Werte, Konfidenzintervalle und Teststärke: Ein Leitfaden zu Fehlinterpretationen. Eur J Epidemiol. 2016;31(4):337–350. PMID 27209009
- RECOVERY Collaborative Group. Dexamethason bei hospitalisierten Patienten mit Covid-19. N Engl J Med. 2021;384(8):693–704. doi.org/10.1056/NEJMoa2021436
- Bewick V, Cheek L, Ball J. Statistics review 8: qualitative Daten, Tests auf Assoziation. Kritik Pflege. 2004;8(1):46–53. PMID 14975045
- McHugh ML. Der Chi-Quadrat-Test auf Unabhängigkeit. Biochemie Med. 2013;23(2):143–149. PMID 23894860
- Gomes I, Collins A, Lonjou C, et al. Hardy-Weinberg Qualitätskontrolle. Ann Hum Genet. 1999;63(6):535–538. PMID 11246455