
Pubblicato | Ultimo aggiornamento
Un coordinatore di uno studio clinico termina l'inserimento dei dati relativi a 400 pazienti sottoposti a intervento chirurgico e si trova di fronte a un quesito pratico. Quali delle quindici variabili registrate all'inizio dello studio predicono effettivamente chi verrà riammesso in ospedale, chi svilupperà una complicanza o chi sopravviverà cinque anni dopo la diagnosi? I modelli di regressione nella ricerca medica rispondono proprio a questa domanda. Essi stimano la relazione tra uno o più predittori e un risultato, mantenendo costanti gli altri predittori, separando così un segnale reale dal rumore che un semplice confronto tra due gruppi non riuscirebbe a rilevare.
Quattro famiglie di questi modelli coprono la maggior parte di ciò che appare oggi nelle riviste cliniche, e ciascuna esiste perché un diverso tipo di risultato richiede un proprio modello matematico. La pressione sanguigna e altri valori continui richiedono la regressione lineare. Un evento sì/no come la mortalità a 30 giorni richiede la regressione logistica. Un conteggio come il numero di cadute in una casa di cura richiede la regressione di Poisson o binomiale negativa, e un risultato di tipo tempo all'evento come la sopravvivenza libera da recidiva richiede la regressione di Cox. Questa guida illustra tutte e quattro le famiglie, spiega quanti predittori può effettivamente supportare un set di dati e si conclude con ciò che i revisori si aspettano ora di vedere riportato insieme a ciascun modello.
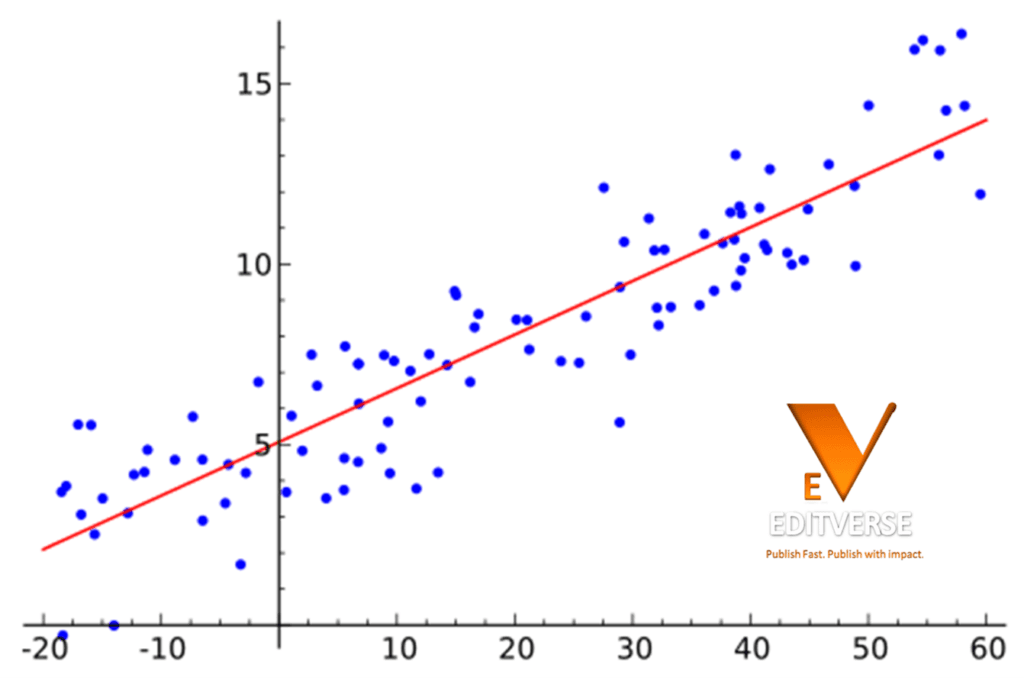
In parole semplici
Un modello di regressione è un modo per chiedersi "questo fattore è rilevante, e in che misura, una volta tenuto conto di tutto il resto che ho misurato?". Il funzionamento di base di ogni versione è lo stesso. Si sceglie un risultato, si elencano i predittori che si ritiene possano spiegarlo e il modello stima un valore per ciascun predittore, mostrando la sua relazione indipendente con quel risultato. La versione da utilizzare dipende solo dal tipo di risultato. Un numero viene analizzato con la regressione lineare, un evento sì/no con la regressione logistica, un conteggio con la regressione di Poisson o binomiale negativa e un intervallo di tempo fino a un evento con la regressione di Cox. Scegliendo la versione sbagliata, i coefficienti visualizzati dal software non avranno il significato che ci si aspetta.
A cosa servono i modelli di regressione nella ricerca medica
Ogni modello di regressione suddivide le variabili in due ruoli: un risultato e un insieme di predittori. I ricercatori chiamano il risultato variabile dipendente, ovvero ciò che uno studio vuole spiegare o prevedere, come ad esempio il ricovero ospedaliero o la pressione sanguigna sistolica. Età, gruppo di trattamento e creatinina basale diventano invece predittori, detti anche variabili indipendenti o covariate, ovvero i fattori che potrebbero influenzare tale risultato. Un modello stima un coefficiente per ciascun predittore che descrive la sua relazione con il risultato, mantenendo fissi gli altri predittori nell'equazione.
Quest'ultimo aspetto è la ragione principale per cui i ricercatori clinici preferiscono la regressione a un semplice test t o a un test del chi-quadrato. Un test t può dimostrare che un gruppo di trattamento e un gruppo di controllo differiscono in termini di esito. Un test t non può dire se tale differenza persiste una volta considerati contemporaneamente età, sesso, gravità della malattia e numero di comorbilità. La regressione, invece, sì, ed è per questo che è alla base della maggior parte delle analisi aggiustate, dei calcolatori di rischio e dei modelli prognostici pubblicati nelle riviste mediche. La scelta tra i test statistici disponibili per una determinata domanda di ricerca inizia con l'identificazione del tipo di esito, e questa stessa classificazione determina quale famiglia di regressione si applica.
Sei modelli di regressione utilizzati nella ricerca medica in sintesi
I sei modelli riportati di seguito rappresentano la stragrande maggioranza delle analisi di regressione pubblicate su riviste cliniche ed epidemiologiche, ciascuno associato al tipo di risultato che gestisce e all'ipotesi che più probabilmente viene violata nella pratica.
| Modello | Tipo di risultato | Coefficiente interpretato come | Presupposto più spesso violato |
|---|---|---|---|
| Regressione lineare | Continuo (pressione sanguigna, valori di laboratorio, punteggio) | Variazione unitaria del risultato per ogni variazione unitaria del predittore | Varianza costante dei residui rispetto ai valori stimati (omoschedasticità) |
| Regressione logistica | Binario (l'evento si è verificato o meno) | Rapporto di probabilità per unità di variazione del predittore | Numero adeguato di eventi per variabile in relazione alla dimensione del campione. |
| Regressione di Poisson | Conteggio (cadute, infezioni, ricoveri ospedalieri per periodo) | Rapporto del tasso di incidenza per unità di variazione del predittore | Equidispersione, ovvero la varianza è uguale alla media |
| Regressione binomiale negativa | Dati di conteggio sovradispersi | Rapporto dei tassi di incidenza, con l'aggiunta di un parametro di dispersione | Si presume comunque la stessa struttura tariffaria per tutti i soggetti |
| Regressione dei rischi proporzionali di Cox | Tempo all'evento (sopravvivenza, ricaduta, tempo alla dimissione) | Rapporto di rischio per unità di variazione del predittore | I rischi proporzionali sono stati mantenuti costanti per tutta la durata del follow-up. |
| Regressione logistica ordinale/multinomiale | Categorie ordinate o non ordinate (tre o più) | Odds ratio per soglia di categoria o per categoria rispetto a un riferimento | Probabilità proporzionali in base alle soglie (solo versione ordinale) |
Regressione lineare per risultati continui
La regressione lineare adatta una relazione lineare tra uno o più predittori e un risultato continuo. Ogni coefficiente rappresenta la variazione attesa nel risultato per un aumento di un'unità in quel predittore, mantenendo costante il resto del modello. Un coefficiente di 2.3 per l'età in un modello che predice la pressione sanguigna sistolica significa che il modello prevede un valore superiore di 2.3 mm Hg per ogni anno di età in più, a parità di tutte le altre variabili incluse.
Questo metodo si basa su quattro presupposti, e un grafico dei residui può verificarli tutti direttamente. I predittori e l'esito devono avere una relazione lineare piuttosto che curvilinea, le osservazioni devono essere indipendenti l'una dall'altra, i residui devono seguire una distribuzione approssimativamente normale e la loro dispersione deve rimanere pressoché costante nell'intervallo dei valori stimati. Un'analisi del 2020 pubblicata su Scientific Reports, basata sulla coorte della NIH Osteoarthritis Initiative, illustra come la regressione lineare e quella logistica vengano spesso utilizzate in parallelo nello stesso studio. I ricercatori hanno testato 19 potenziali biomarcatori rispetto alle caratteristiche radiografiche e cliniche dell'osteoartrite del ginocchio e hanno scoperto che solo quattro, Coll2-1 NO2 sierico, CS846, COMP e CTXII urinario, si sono dimostrati predittori indipendenti una volta che i modelli sono stati aggiustati per i fattori di rischio noti, in una malattia che colpisce oltre 500 milioni di persone in tutto il mondo.
Regressione logistica per risultati binari
La regressione logistica gestisce esiti con due possibili stati: una complicanza che si verifica o non si verifica, un test che risulta positivo o negativo, un paziente che sopravvive fino alla dimissione o meno. Invece di modellare direttamente l'esito, modella il logaritmo delle probabilità dell'evento come una funzione lineare dei predittori, il che mantiene la probabilità prevista compresa tra 0 e 1, indipendentemente da quanto estremi diventino i valori dei predittori. L'esponenziazione di un coefficiente lo converte in un odds ratio, il metodo standard utilizzato negli articoli clinici per riportare i risultati della regressione logistica.
Nella maggior parte degli articoli pubblicati, un modello logistico viene considerato una procedura di routine una volta che non si verificano errori, ma per ottenerlo correttamente è necessaria molta più attenzione. Un'analisi del 2017 pubblicata sulla rivista Medicine ha esaminato 316 articoli pubblicati tra il 2010 e il 2015 su cinque riviste cliniche cinesi ad alto impatto che utilizzavano la regressione logistica multivariata, valutando ciascuno di essi in base a 12 criteri di reporting e metodologici consolidati. I punteggi sono risultati bassi in generale, con una mediana di 5 su 12 e l'85.1% degli articoli al di sotto di 6, il che significa che la maggior parte dei modelli pubblicati non soddisfaceva i requisiti di base, come la descrizione di come sono state selezionate le variabili o la verifica dell'effettiva aderenza del modello ai dati. Gli studi di caso sulla regressione logistica, che trattano l'interpretazione dell'odds ratio e la valutazione della curva ROC, approfondiscono come leggere e validare questi risultati una volta che un modello è stato adattato, e l'abbinamento di un modello logistico con i calcoli corretti di sensibilità, specificità e valore predittivo è ciò che trasforma un insieme di odds ratio in uno strumento diagnostico o prognostico utilizzabile.
Regressione di Poisson e binomiale negativa per risultati di conteggio
Le variabili di conteggio, come il numero di cadute di un paziente in un anno, il numero di infezioni nosocomiali in un reparto o il numero di accessi al pronto soccorso dopo la dimissione, non si prestano facilmente alla regressione lineare o logistica. La regressione di Poisson è il punto di partenza standard, in quanto modella il logaritmo del conteggio atteso in funzione dei predittori e riporta i risultati come rapporti di incidenza. La regressione di Poisson si basa su un'ipotesi che non è mai valida nei dati clinici reali: la varianza dei conteggi è uguale alla media, una proprietà chiamata equidispersione.
I dati medici reali sono quasi sempre sovradispersi, con una maggiore dispersione rispetto a quanto previsto da un modello di Poisson, e fingere il contrario produce errori standard troppo piccoli e valori p che sembrano più significativi di quanto dovrebbero. Uno studio comparativo del 2022 pubblicato su BMC Medical Research Methodology ha testato i modelli di Poisson, binomiale negativo e le versioni con inflazione di zeri di entrambi, utilizzando i dati sulla durata della degenza ospedaliera tratti dal database MIMIC per le cure intensive. I modelli di Poisson semplice e di Poisson con inflazione di zeri si adattavano male ai dati sovradispersi sulla durata della degenza, mentre il modello binomiale negativo forniva il miglior adattamento complessivo ed evitava la significatività gonfiata che deriva dall'imporre un'ipotesi di equidispersione a dati che non la soddisfano. Quando la variabile dipendente è una variabile di conteggio, verificare la varianza rispetto alla media prima di scegliere tra Poisson e binomiale negativo non è facoltativo.
Regressione di Cox a rischi proporzionali per esiti di tempo all'evento
Gli esiti relativi al tempo all'evento necessitano di una quarta categoria a parte, poiché implicano due informazioni contemporaneamente: se un evento si è verificato e quanto tempo è trascorso, oltre alla complicazione che alcuni pazienti abbandonano lo studio prima che l'evento si verifichi o prima della fine del follow-up (censura). I modelli di regressione a rischi proporzionali di Cox modellano il rischio, ovvero il rischio istantaneo dell'evento in un dato momento, in funzione dei predittori, senza richiedere alcuna ipotesi sulla forma sottostante della curva di sopravvivenza stessa. I coefficienti sono riportati come hazard ratio e l'ipotesi fondamentale del modello è che il rapporto tra i rischi tra due gruppi qualsiasi rimanga costante per l'intero periodo di follow-up.
Uno studio di fase 3 condotto in 33 ospedali in Giappone mostra come si presenta in pratica un hazard ratio derivato dal modello di Cox. Lo studio JASPAC-01 ha randomizzato 385 pazienti con carcinoma pancreatico resecato a ricevere gemcitabina o S-1 in adiuvante, e un modello di Cox ha stimato l'hazard ratio di mortalità per S-1 rispetto alla gemcitabina a 0.57, con un intervallo di confidenza al 95% compreso tra 0.44 e 0.72. Ciò si traduce in un rischio di morte inferiore di circa il 43% in qualsiasi momento durante il follow-up per i pazienti trattati con S-1, in linea con la sopravvivenza globale a 5 anni del 44.1% nel gruppo S-1 rispetto al 24.4% con gemcitabina. La modellizzazione dei rischi proporzionali di Cox, trattata in dettaglio, compreso il modo in cui le funzioni di rischio e le covariate interagiscono , e i fondamenti dell'analisi di sopravvivenza per la ricerca clinica si basano direttamente sui meccanismi qui riassunti.
Regressione ordinale e multinomiale per risultati con più di due categorie
Alcuni risultati non si riducono nettamente a una dicotomia sì/no. La gravità del dolore, classificata come assente, lieve, moderata o grave, è ordinale, ovvero le categorie hanno un ordine naturale. Anche la risposta al trattamento, classificata come completa, parziale o assente senza una scala numerica, è ordinale. La risposta a una delle tre opzioni di trattamento non correlate, senza una gerarchia intrinseca, è invece nominale, il che richiede una regressione logistica multinomiale anziché ordinale.
La regressione logistica ordinale, spesso adattata come modello a probabilità proporzionali, presuppone che la relazione tra ciascun predittore e le probabilità di passare a una categoria superiore sia la stessa indipendentemente dalla soglia superata, un'ipotesi che vale la pena verificare piuttosto che accettare a priori. La regressione logistica multinomiale elimina questo requisito e stima invece un insieme separato di odds ratio per ciascuna categoria rispetto a una categoria di riferimento, a costo di richiedere un campione più ampio per stimare tutti questi parametri con precisione. Ridurre un risultato ordinale a uno binario per aggirare la scelta, ad esempio tra moderato o grave e lieve o assente, è una pratica comune, ma elimina le informazioni che la scala originale era stata concepita per catturare.
Quanti predittori può supportare il tuo modello di regressione
Un set di dati non supporta un numero illimitato di predittori, indipendentemente dalle dimensioni apparenti del campione. Per i modelli logistici e di Cox, la regola empirica consolidata prevede almeno 10 eventi, non 10 soggetti, per variabile predittiva, dove per evento si intende un decesso, una complicanza o qualsiasi altro risultato rappresentato. Questa regola risale a una simulazione Monte Carlo del 1996, basata su uno studio clinico cardiaco reale condotto su 673 pazienti con 252 decessi e sette potenziali predittori, per un rapporto eventi-per-variabile di 36 per l'intero campione. Ricampionando quel set di dati fino a rapporti di soli 2 eventi per variabile, i ricercatori hanno scoperto che al di sotto di un EPV di circa 10, i coefficienti risultavano distorti in entrambe le direzioni, gli intervalli di confidenza smettevano di coprire il valore reale con la frequenza dichiarata e le associazioni statisticamente significative che puntavano nella direzione sbagliata si presentavano più spesso del dovuto.
Le linee guida moderne hanno completamente superato il concetto di singolo rapporto. Un articolo metodologico del 2019 pubblicato su Statistics in Medicine ha proposto quattro obiettivi numerici che la dimensione del campione deve raggiungere per i modelli di previsione di esiti continui, limitando la riduzione degli effetti dei predittori a un fattore non superiore a 0.9, mantenendo il divario tra l'R-quadro apparente e quello corretto per l'ottimismo del modello al di sotto di 0.05 e mantenendo il margine di errore al di sotto del 10% sia per la deviazione standard residua che per l'esito medio previsto. In un esempio pratico di previsione della funzionalità polmonare in donne afroamericane a partire da 25 parametri predittivi, il raggiungimento di tutti e quattro i criteri ha richiesto almeno 918 soggetti, ovvero circa 37 soggetti per parametro predittivo, ben al di sopra di quanto suggerito da qualsiasi semplice scorciatoia EPV. Estensioni della stessa logica a quattro criteri ora coprono anche esiti binari, tempo all'evento e multinomiali. Eseguire un'analisi di potenza a priori e un calcolo della dimensione del campione prima dell'inizio della raccolta dati è l'unico modo per sapere da quale lato di queste soglie si collocherà uno studio pianificato.
Verificare la validità delle ipotesi del modello di regressione.
Applicare un modello di regressione e leggere i coefficienti senza verificarne le ipotesi è uno degli errori più comuni che si commettono quando si pubblica un'analisi. La multicollinearità, in cui due o più predittori presentano informazioni sovrapposte, aumenta gli errori standard e rende instabili i singoli coefficienti anche quando il modello nel suo complesso si adatta bene ai dati. Un fattore di inflazione della varianza superiore a 5 o 10 per qualsiasi predittore è solitamente il segnale per riconsiderare l'elenco delle variabili. Gli approcci di regressione multivariata per il controllo dei fattori confondenti negli studi clinici si basano su questo tipo di analisi diagnostica, che deve essere effettuata prima che i risultati vengano considerati attendibili, non dopo.
Ogni famiglia di modelli prevede controlli specifici, oltre a quelli generali. La regressione lineare richiede un grafico dei residui rispetto ai valori previsti per individuare la non linearità e la varianza disuguale, oltre a un grafico QQ per l'assunzione di normalità. La regressione logistica trae vantaggio da un test di Hosmer-Lemeshow o da un grafico di calibrazione che confronta le probabilità previste con quelle osservate nei decili di rischio. La regressione di Cox prevede un controllo specifico e obbligatorio, che testa i residui di Schoenfeld rispetto al tempo per confermare che l'assunzione di rischi proporzionali sia effettivamente valida, anziché assumerla passivamente, poiché un hazard ratio riportato per una covariata che viola la proporzionalità non è in realtà un singolo valore. Anche la gestione dei dati mancanti prima che un dataset raggiunga il modello di regressione è altrettanto importante, poiché l'eliminazione di un soggetto con un predittore mancante può falsare tutti i coefficienti del modello, non solo quelli relativi alla variabile incompleta. Gli studi con una struttura a cluster o annidata, pazienti all'interno di ospedali o visite ripetute per gli stessi pazienti, necessitano di un ulteriore passaggio nella modellazione multilivello o a effetti misti , poiché la regressione standard presuppone che ogni osservazione sia indipendente da tutte le altre.
Presentare i modelli di regressione in modo che revisori e lettori possano fidarsi di essi.
Un coefficiente di regressione ha poco significato per un lettore che non può vedere come è stato costruito il modello che lo sottende. La dichiarazione TRIPOD, pubblicata simultaneamente nel 2015 su undici riviste tra cui The BMJ , Annals of Internal Medicine e Circulation , definisce una checklist di 22 punti che copre le modalità di selezione dei predittori, la gestione dei dati mancanti, la validazione del modello e la misurazione delle sue prestazioni. Questa checklist è stata sviluppata durante un incontro di tre giorni tra esperti di metodologia e perfezionata negli anni successivi dal più ampio gruppo direttivo TRIPOD. Un aggiornamento del 2024, TRIPOD+AI, ha esteso la stessa checklist ai modelli predittivi costruiti con metodi di apprendimento automatico, oltre alla regressione tradizionale.
I dati sulla qualità della rendicontazione emersi dall'audit cinese sulla regressione logistica citato in precedenza non rappresentano un caso isolato. Gli studi che sviluppano o convalidano un modello predittivo omettono sistematicamente come è stata ristretta la lista dei potenziali predittori, non riportano il numero di eventi in relazione al numero di variabili o presentano un hazard ratio senza mai menzionare se l'ipotesi di rischi proporzionali sia stata testata. Nessuna di queste situazioni è insolita dal punto di vista statistico. Questa lacuna è una prassi consolidata nella documentazione, e la checklist TRIPOD esiste proprio per renderla visibile a un revisore prima della pubblicazione, piuttosto che a un lettore che cerca di riprodurre il risultato in seguito. La significatività statistica e la rendicontazione del p-value meritano la stessa trasparenza, poiché il p-value di un coefficiente di regressione assume un significato diverso a seconda di quante altre variabili e confronti sono stati testati nel percorso verso il modello finale.
Errori comuni che compromettono i modelli di regressione nella ricerca medica
- Selezione automatica graduale delle variabili. Consentire al software di aggiungere ed eliminare predittori in base a soglie di p-value gonfia l'apparente significatività di ciò che rimane e produce intervalli di confidenza che non significano più ciò che pretendono di significare. I predittori appartengono a un modello perché il ragionamento clinico o la letteratura precedente lo hanno stabilito, non perché un algoritmo stepwise li ha mantenuti.
- Ignorare gli eventi per variabile finché un revisore non lo richiede. Applicando un modello logistico a 12 predittori su 40 eventi si ottengono coefficienti non più affidabili del lancio di una moneta per molti di questi predittori, a prescindere da quanto grande possa sembrare la dimensione complessiva del campione sulla pagina del titolo.
- Riportare un odds ratio come se fosse un rapporto di rischio. Il rapporto di probabilità e il rapporto di rischio convergono solo quando l'evento è raro, in genere inferiore al 10%. Al di sopra di tale soglia, il rapporto di probabilità sovrastima sistematicamente il rischio associato, e i lettori che lo convertono direttamente in un rapporto di rischio mentalmente ne sovrastimeranno l'effetto.
- Trattare un risultato ordinale come continuo. L'esecuzione di una regressione lineare su una scala di sintomi a 5 punti presuppone che la distanza tra "nessuno" e "lieve" sia uguale alla distanza tra "moderato" e "grave", un presupposto che la regressione ordinale non richiede e che raramente si verifica.
- Non si verifica mai l'ipotesi dei rischi proporzionali. Un hazard ratio riportato senza un controllo dei residui di Schoenfeld, o un test equivalente, potrebbe essere una media su un effetto che varia sostanzialmente nel corso del periodo di follow-up, cosa che il singolo valore riportato non è in grado di rivelare da solo.
- Estrapolare un modello adattato al di fuori dell'intervallo dei dati utilizzati per costruirlo. Un'equazione di regressione costruita su pazienti di età compresa tra 40 e 75 anni non offre alcuna garanzia riguardo a una persona di 25 o 90 anni, a prescindere da quanto lineare possa sembrare la relazione all'interno dell'intervallo studiato.
Ottenere supporto statistico per i modelli di regressione nella ricerca medica
Alcune analisi di regressione sono di routine, basate su un singolo modello logistico con cinque predittori ben selezionati e un numero adeguato di eventi. Altre, invece, coinvolgono rischi competitivi, covariate variabili nel tempo, dati raggruppati o un elenco di predittori che necessita di essere ridotto prima che il modello possa essere applicato in modo responsabile. Gli statistici di Editverse si occupano di tutto, dalla verifica del numero di eventi per variabile previsti per un'analisi pianificata alla stesura della relazione sui risultati che verrà effettivamente letta da una commissione di tesi o da un revisore di una rivista.
Analisi statistica di tesi e manoscritti
$600
Gli statistici con dottorato di ricerca si occupano della selezione del modello di regressione, della verifica delle ipotesi e della stesura completa delle analisi utilizzando SPSS, R o STATA.
Servizi di scrittura di manoscritti
Preventivo personalizzato
Trasforma un'analisi di regressione completata in una sezione di metodi e risultati pronta per la pubblicazione, redatta secondo gli standard della rivista.
Domande frequenti sui modelli di regressione nella ricerca medica
Come posso scegliere tra regressione lineare, logistica, di Poisson e di Cox?
La scelta dipende interamente dalla variabile di esito. Un valore numerico continuo, come un valore di laboratorio o un punteggio, richiede la regressione lineare. Un esito binario sì/no richiede la regressione logistica. Un conteggio, come il numero di cadute o infezioni in un periodo fisso, richiede la regressione di Poisson o la regressione binomiale negativa. Un esito di tipo tempo-evento, che include i pazienti che abbandonano lo studio prima che l'evento si verifichi, richiede la regressione di Cox a rischi proporzionali. Definire correttamente questa classificazione è fondamentale prima di qualsiasi altra decisione di modellazione.
Che cosa significa concretamente un odds ratio di 2.0?
Un odds ratio di 2.0 per un predittore significa che la probabilità che si verifichi l'evento raddoppia per ogni aumento di un'unità in quel predittore, mantenendo costanti le altre variabili del modello. Questo non equivale a dire che la probabilità che si verifichi l'evento è doppia in termini assoluti. Probabilità e probabilità convergono solo quando l'evento è raro, quindi un odds ratio di 2.0 per un evento comune corrisponde a un aumento del rischio effettivo inferiore a quanto il numero possa suggerire a prima vista.
Di quanti eventi per variabile ha bisogno un modello di regressione?
Die regressione logistica e di Cox prevede tradizionalmente dieci eventi per variabile predittiva, sulla base di una simulazione del 1996 che mostrava come i coefficienti risultassero distorti e gli intervalli di confidenza perdessero di accuratezza al di sotto di tale rapporto. Ricerche più recenti hanno dimostrato che il vero minimo dipende dalla dimensione totale del campione e da quanto bene i predittori separano l'esito, non dal rapporto EPV in isolamento; pertanto, è consigliabile considerare 10 EPV come un valore minimo da verificare piuttosto che un obiettivo da raggiungere con precisione.
Qual è la differenza tra regressione multivariata e regressione multivariata?
La regressione multivariata si riferisce a un modello con più variabili predittive e un singolo risultato, che descrive la stragrande maggioranza dei modelli di regressione utilizzati nella ricerca medica. La regressione multivariata, in senso strettamente statistico, si riferisce a un modello con più variabili di risultato analizzate simultaneamente. Entrambi i termini vengono usati in modo intercambiabile in gran parte della letteratura medica applicata, ma i revisori delle riviste metodologicamente rigorose si aspettano sempre più spesso il termine preciso.
Perché il mio modello di Cox necessita di una verifica dei rischi proporzionali?
La regressione di Cox presuppone che il rapporto di rischio tra due gruppi qualsiasi rimanga costante per l'intero periodo di follow-up. Se il vero effetto di un predittore cambia nel tempo, ad esempio un trattamento chirurgico che riduce il rischio precocemente ma non in seguito, un singolo rapporto di rischio calcola la media di tale variazione e può rappresentare in modo errato l'effetto in un determinato momento. Un test dei residui di Schoenfeld verifica direttamente questa ipotesi, anziché lasciarla implicita.
Posso utilizzare la regressione con un campione di piccole dimensioni?
La regressione può tecnicamente essere eseguita su campioni di qualsiasi dimensione, ma i risultati diventano instabili quando il numero di predittori si avvicina al numero di eventi (per esiti binari o di tempo all'evento) o al numero di soggetti (per esiti continui). Una soluzione pratica consiste nel ridurre l'elenco dei predittori a variabili con una solida giustificazione clinica, utilizzare metodi di regressione penalizzata progettati per campioni più piccoli, oppure eseguire un calcolo a priori della dimensione del campione prima di impegnarsi in un modello con un dato numero di predittori.
Cos'è un TREPPIEDE e devo portarlo con me?
TRIPOD, acronimo di Transparent Reporting of a multivariable prediction model for Individual Prognosis Or Diagnosis (Reporting trasparente di un modello predittivo multivariabile per la prognosi o la diagnosi individuale), è una checklist di 22 elementi per la rendicontazione di studi che sviluppano o validano un modello predittivo. La maggior parte delle principali riviste cliniche e metodologiche ora si aspetta una checklist TRIPOD compilata insieme a qualsiasi manoscritto che riporti un modello predittivo basato sulla regressione, e i revisori verificano sempre più spesso le proposte direttamente in base a essa.
Dovrei combinare diversi modelli di regressione in un unico studio?
La combinazione di modelli è una pratica comune e spesso appropriata. Uno studio potrebbe utilizzare la regressione logistica per identificare i predittori di una complicanza e la regressione di Cox per modellare separatamente il tempo di recupero nella stessa coorte di pazienti. L'importante è che ogni modello corrisponda al proprio tipo di risultato e che l'articolo riporti le ipotesi, la dimensione del campione e gli eventi per variabile di ciascun modello in modo indipendente, anziché considerare una singola giustificazione relativa alla potenza statistica o alla dimensione del campione come valida per tutti i modelli presentati nell'articolo.
Punti chiave
- ✓ Il tipo di risultato, continuo, binario, di conteggio o tempo all'evento, determina quale famiglia di regressione si applica prima che venga presa qualsiasi altra decisione
- ✓ Dieci eventi per variabile predittiva rappresentano un valore minimo da verificare per i modelli logistici e di Cox, ma non sono di per sé una garanzia di stabilità del modello.
- ✓ I dati di conteggio sovradispersi richiedono una regressione binomiale negativa; imporre un modello di Poisson sovrastima la significatività.
- ✓ Il rapporto di rischio di un modello di Cox è significativo solo dopo che l'ipotesi dei rischi proporzionali è stata effettivamente verificata, non semplicemente assunta.
- ✓ La selezione automatica a passi successivi aumenta la significatività e dovrebbe lasciare il posto a predittori scelti su basi cliniche.
- ✓ La checklist TRIPOD, ora ampliata da TRIPOD+AI, è ciò che i revisori utilizzano sempre più spesso per verificare i modelli di previsione basati sulla regressione.
- ✓ La multicollinearità, la gestione dei dati mancanti e la struttura dei dati a cluster richiedono tutti controlli diagnostici separati dai risultati del modello principale.
Hai bisogno di aiuto per scegliere o eseguire il modello di regressione più adatto?
Gli statistici con dottorato di ricerca di Editverse si occupano della selezione dei modelli, della verifica delle ipotesi e della presentazione dei risultati per tesi di dottorato, manoscritti e domande di finanziamento in ogni disciplina clinica.
Risorse correlate a Editverse
→ Regressione logistica nella diagnostica medica: casi di studio e interpretazioni
→ Modello dei rischi proporzionali di Cox: guida illustrata per la ricerca sulle malattie croniche
→ Regressione multivariabile negli studi clinici
→ Comprendere l'analisi della sopravvivenza nella ricerca clinica
→ Analisi di potenza semplificata: calcoli delle dimensioni del campione con esempi
→ Guida ai test statistici: fare la scelta giusta
→ Gestire i dati mancanti: strategie e suggerimenti
→ Prove randomizzate su cluster master e modellazione multilivello
Referenze
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Reporting trasparente di un modello di previsione multivariabile per la prognosi o la diagnosi individuale (TRIPOD): la dichiarazione TRIPOD. BMJ. 2015; 350: g7594. https://pubmed.ncbi.nlm.nih.gov/25569120/
- Peduzzi P, Concato J, Kemper E, Holford TR, Feinstein AR. Uno studio di simulazione sul numero di eventi per variabile nell'analisi di regressione logistica. J Clin Epidemiol. 1996;49(12):1373-1379. https://pubmed.ncbi.nlm.nih.gov/8970487/
- van Smeden M, de Groot JAH, Moons KGM, Collins GS, Altman DG, Eijkemans MJC, Reitsma JB. Nessuna giustificazione razionale per il criterio di 1 variabile ogni 10 eventi per l'analisi di regressione logistica binaria. Metodo BMC Med Res. 2016, 16 (1): 163. https://pubmed.ncbi.nlm.nih.gov/27881078/
- Riley RD, Snell KIE, Ensor J, Burke DL, Harrell FE Jr, Moons KGM, Collins GS. Dimensione minima del campione per lo sviluppo di un modello di previsione multivariabile: Parte I – Risultati continui. Stat Med. 2019;38(7):1262-1275. https://pubmed.ncbi.nlm.nih.gov/30347470/
- Liem Y, Judge A, Kirwan J, Ourradi K, Li Y, Sharif M. Modelli di regressione logistica e lineare multivariata per l'identificazione di biomarcatori clinicamente utili per l'osteoartrite. Sci Rep. 2020, 10 (1): 11328. https://pubmed.ncbi.nlm.nih.gov/32647218/
- Zhang YY, Zhou XB, Wang QZ, Zhu XY. Qualità della rendicontazione dei modelli di regressione logistica multivariata nelle riviste mediche cliniche cinesi. Medicina (Baltimora). 2017; 96 (21): e6972. https://pubmed.ncbi.nlm.nih.gov/28538397/
- Fernandez GA, Vatcheva KP. Un confronto tra metodi statistici per la modellazione di dati di conteggio con un'applicazione alla durata della degenza ospedaliera. Metodo BMC Med Res. 2022, 22 (1): 211. https://pubmed.ncbi.nlm.nih.gov/35927612/
- Uesaka K, Boku N, Fukutomi A, Okamura Y, Konishi M, et al. Chemioterapia adiuvante di S-1 rispetto alla gemcitabina per il cancro del pancreas resecato: uno studio di fase 3, in aperto, randomizzato, di non inferiorità (JASPAC 01). Lancet. 2016;388(10041):248-257. https://pubmed.ncbi.nlm.nih.gov/27265347/