
Veröffentlicht
Die Berechnung der statistischen Power für eine Mendelsche Randomisierung ist der einzige Schritt im gesamten Prozess, der keine Kosten verursacht und trotzdem oft ausgelassen wird. Rosas-Chavez und Merriman überprüften 86 Zwei-Stichproben-MR-Studien zu Hyperurikämie und Gicht, die zwischen 2016 und 2024 veröffentlicht wurden, und stellten fest, dass nur 59 Prozent die statistische Power überhaupt berücksichtigten. Das bedeutet, dass 41 Prozent eine kausale Schätzung – positiv oder negativ – angaben, ohne anzugeben, ob die Studie den gesuchten Effekt hätte nachweisen können (Gout, Urate, and Crystal Deposition Disease 2025;3(2):8, doi:10.3390/gucdd3020008 ). Ein negatives Ergebnis aufgrund einer zu geringen statistischen Power und ein negatives Ergebnis aufgrund eines tatsächlich fehlenden Effekts sehen auf dem Papier identisch aus. Nur eine Poweranalyse verrät dem Leser, welches Ergebnis vorliegt.
Dieser Beitrag ist die dritte Simulation unserer Reihe zur Mendelschen Randomisierung und schließt eine Lücke, die die ersten beiden Beiträge aufgeworfen haben. Unser Beitrag zur Aussagekraft der F-Statistik zeigte, dass ein schwaches Instrument die Breite des Konfidenzintervalls und nicht die Punktschätzung erhöht. Unser Beitrag zu den Schutzmechanismen der vier Schätzer zeigte, dass Pleiotropie dazu führen kann, dass vier verschiedene Methoden zum selben falschen Ergebnis kommen. Keiner der beiden Beiträge beantwortete jedoch eine grundlegende Frage, die sich Gutachter stellen, bevor diese Diagnosen überhaupt relevant werden: Hätte Ihre Studie angesichts des verwendeten Instruments und der tatsächlichen Ergebnisstichprobe den Effekt nachweisen können, den Sie zu testen vorgeben? Wir haben ein Power-Modell für die Mendelsche Randomisierung mit zwei Stichproben entwickelt, es unabhängig in Python und R validiert und es für die in der Literatur üblicherweise vorkommenden Studiengrößen angewendet.
In einfachen Worten
Vor der Durchführung einer Mendelschen Randomisierungsstudie lässt sich die Wahrscheinlichkeit, einen tatsächlichen Effekt nachzuweisen, abschätzen – analog zur Berechnung der benötigten Patientenzahl in klinischen Studien. Zwei Faktoren sind dabei entscheidend: die Anzahl der Personen im Ergebnisdatensatz und der Anteil der Exposition, der durch das genetische Instrument erklärt wird. Viele veröffentlichte Mendelsche Randomisierungsstudien verwenden eine relativ kleine Fall-Kontroll-Studie und eine einzelne genetische Variante. Diese Kombination führt häufiger dazu, dass ein tatsächlicher, aber moderater Effekt übersehen als nachgewiesen wird. In solchen Fällen wird ein Nullergebnis berichtet, als hätte die Exposition keine kausale Wirkung, obwohl die Studie ehrlicherweise keine eindeutige Aussage treffen konnte.
Was Rezensenten heute tatsächlich prüfen
Die Mendelsche Randomisierung entwickelte sich innerhalb von etwa einem Jahrzehnt von einer Spezialmethode zu einem festen Bestandteil der Checkliste für Gutachter. Diese Checkliste besteht aus drei Teilen. Skrivankova und Kollegen formalisierten sie als STROBE-MR-Leitlinie, eine 20-Punkte umfassende Erweiterung von STROBE, die speziell für Studien mit genetischen Instrumentalvariablen entwickelt und gemeinsam im BMJ und JAMA veröffentlicht wurde (JAMA 2021;326(16):1614-1621, doi:10.1001/jama.2021.18236 ). Punkt 7 fordert die Autoren auf, zu beschreiben, wie sie ihre Annahmen bewertet haben. Das zugehörige Dokument nennt die F-Statistik explizit als Instrument zur Beurteilung der Instrumentenstärke – das Thema unseres ersten Beitrags. Punkt 4b behandelt eine andere Frage. Es verlangt von den Autoren, die Stichprobengröße anzugeben und zu erklären, ob vor der Hauptanalyse eine Power- oder Stichprobenumfangsberechnung durchgeführt wurde, wobei darauf hingewiesen wird, dass die Power am besten aus der Breite des 95-Prozent-Konfidenzintervalls nach Abschluss der Studie abgelesen werden kann (BMJ 2021;375:n2233, doi:10.1136/bmj.n2233 ).
Die Überprüfung von Gicht und Hyperurikämie ist die einzige quantifizierte Kontrollmethode, die wir finden konnten, um zu überprüfen, wie häufig dieses Kriterium tatsächlich erfüllt wird. Das Muster über alle drei Überprüfungen hinweg ist konsistent, aber nicht beruhigend. 66 % der 86 Studien erfüllten die Relevanzannahme bezüglich der Aussagekraft des Instruments, 51 % verwendeten nicht überlappende Expositions- und Ergebnisstichproben, 59 % befassten sich mit der statistischen Power, und nur 17 % erfüllten alle drei Kernannahmen für Instrumentvariablen gleichzeitig. Elf Prozent der nach 2021 veröffentlichten Studien entsprachen vollständig den STROBE-MR-Kriterien. Eine Studie kann daher eine hohe F-Statistik und ein sauberes Einzelstichproben-Design aufweisen und dennoch verschweigen, ob sie überhaupt eine Chance hatte, den im Abstract diskutierten Effekt nachzuweisen.
Die Formel hinter einer Berechnung der Teststärke bei der Mendelschen Randomisierung
Brion, Shakhbazov und Visscher legten den Grundstein für die bis heute gültige Forschung. Ausgehend von der asymptotischen Theorie für eine kontinuierliche Exposition und einen einzelnen genetischen Prädiktor zeigten sie, dass sich die statistische Power bei festem Stichprobenumfang auf zwei Größen reduziert: den Anteil der Varianz der Exposition, der durch das Instrument erklärt wird, und den tatsächlichen Kausalzusammenhang, der getestet wird (International Journal of Epidemiology 2013;42(5):1497-1501, doi:10.1093/ije/dyt179 ). Burgess erweiterte diesen Ansatz auf binäre Ergebnisse und berechnete den Stichprobenumfang umgekehrt, von einer angestrebten Power zurück zur benötigten Stichprobengröße (N) (International Journal of Epidemiology 2014;43(3):922-929, doi:10.1093/ije/dyu005 ).
Bei dem Zwei-Stichproben-Design, das in nahezu allen aktuellen MR-Studien Anwendung findet – also der Schätzung von Expositions- und Ergebnisassoziationen in separaten GWAS-Stichproben –, wird der Standardfehler der Verhältnis-Schätzung hauptsächlich durch die Ergebnisstichprobe bestimmt. Dies liegt daran, dass die Expositions-GWAS hinter einem gut untersuchten Merkmal in der Regel deutlich größer ist und ihre Schätzung in der ersten Stufe entsprechend präziser ausfällt. Für standardisierte Expositions- und Ergebnisvariablen skaliert der approximative Standardfehler der Kausalschätzung mit eins geteilt durch die Quadratwurzel der Ergebnisstichprobengröße multipliziert mit dem R² des Instruments. Ein schwaches Instrument und eine kleine Ergebnisstichprobe führen auf die gleiche Weise zu einer Verringerung dieses Produkts. Der Nichtzentralitätsparameter, der der Powerberechnung zugrunde liegt, ist der wahre Effekt multipliziert mit der Quadratwurzel dieser Größe. Die Angabe der F-Statistik und der Power beantwortet dieselbe grundlegende Frage aus zwei verschiedenen Perspektiven. Genau deshalb fordert STROBE-MR beides an.
So haben wir es getestet
Wir haben die oben beschriebene geschlossene Formel zur Berechnung der Teststärke nach Mendelian Randomization entwickelt und sie anhand von drei unabhängigen Datenquellen überprüft. Dabei folgten wir demselben Validierungskriterium wie in unseren beiden vorherigen Untersuchungen. Zunächst verglichen wir eine schnelle, vektorisierte Simulation, die die SNP-Expositions- und SNP-Outcome-Schätzungen jeder Replikation direkt aus ihren Stichprobenverteilungen zieht, mit einer langsamen Simulation, die Genotypen, Expositionen und Outcomes auf individueller Ebene generiert und die Regressionen für drei Parameterkombinationen durchführt. Beide Simulationen stimmten innerhalb der Monte-Carlo-Fehlertoleranz bei einigen hundert Replikationen überein. Anschließend führten wir das vollständige Raster zweimal durch, einmal in Python mit NumPy und einmal unabhängig in R, jeweils mit 200,000 Replikationen pro Zelle. Dabei verwendeten wir unterschiedliche Zufallszahlengeneratoren und keinen gemeinsamen Code. Abschließend verglichen wir beide Simulationsmodelle mit der geschlossenen Formel. Der Delta-Methoden-Standardfehler für das Zwei-Stichproben-Wald-Verhältnis, der die Unsicherheit sowohl aus den SNP-Expositions- als auch aus den SNP-Ergebnis-Schätzungen fortpflanzt, anstatt das Instrument als exakt bekannt zu behandeln, folgt dem zusammengefassten Datenrahmen von Burgess, Butterworth und Thompson (Genetic Epidemiology 2013;37(7):658-665, doi:10.1002/gepi.21758 ).
In beiden unten beschriebenen Experimenten stimmten alle Zellen in allen drei Prüfungen innerhalb von ein bis zwei Prozentpunkten der simulierten statistischen Power überein. Bei 200,000 Replikationen ist dies genauer als das Rauschen der Monte-Carlo-Simulation. Skripte und Ergebnisse sind auf Anfrage erhältlich. Die Übereinstimmung blieb über den für eine reale Studie relevanten Parameterbereich erhalten, daher ist die geschlossene Formel dort verlässlich. Im Folgenden werden simulierte Werte angegeben, die keine vereinfachenden Annahmen über ein perfekt bekanntes Instrument treffen.
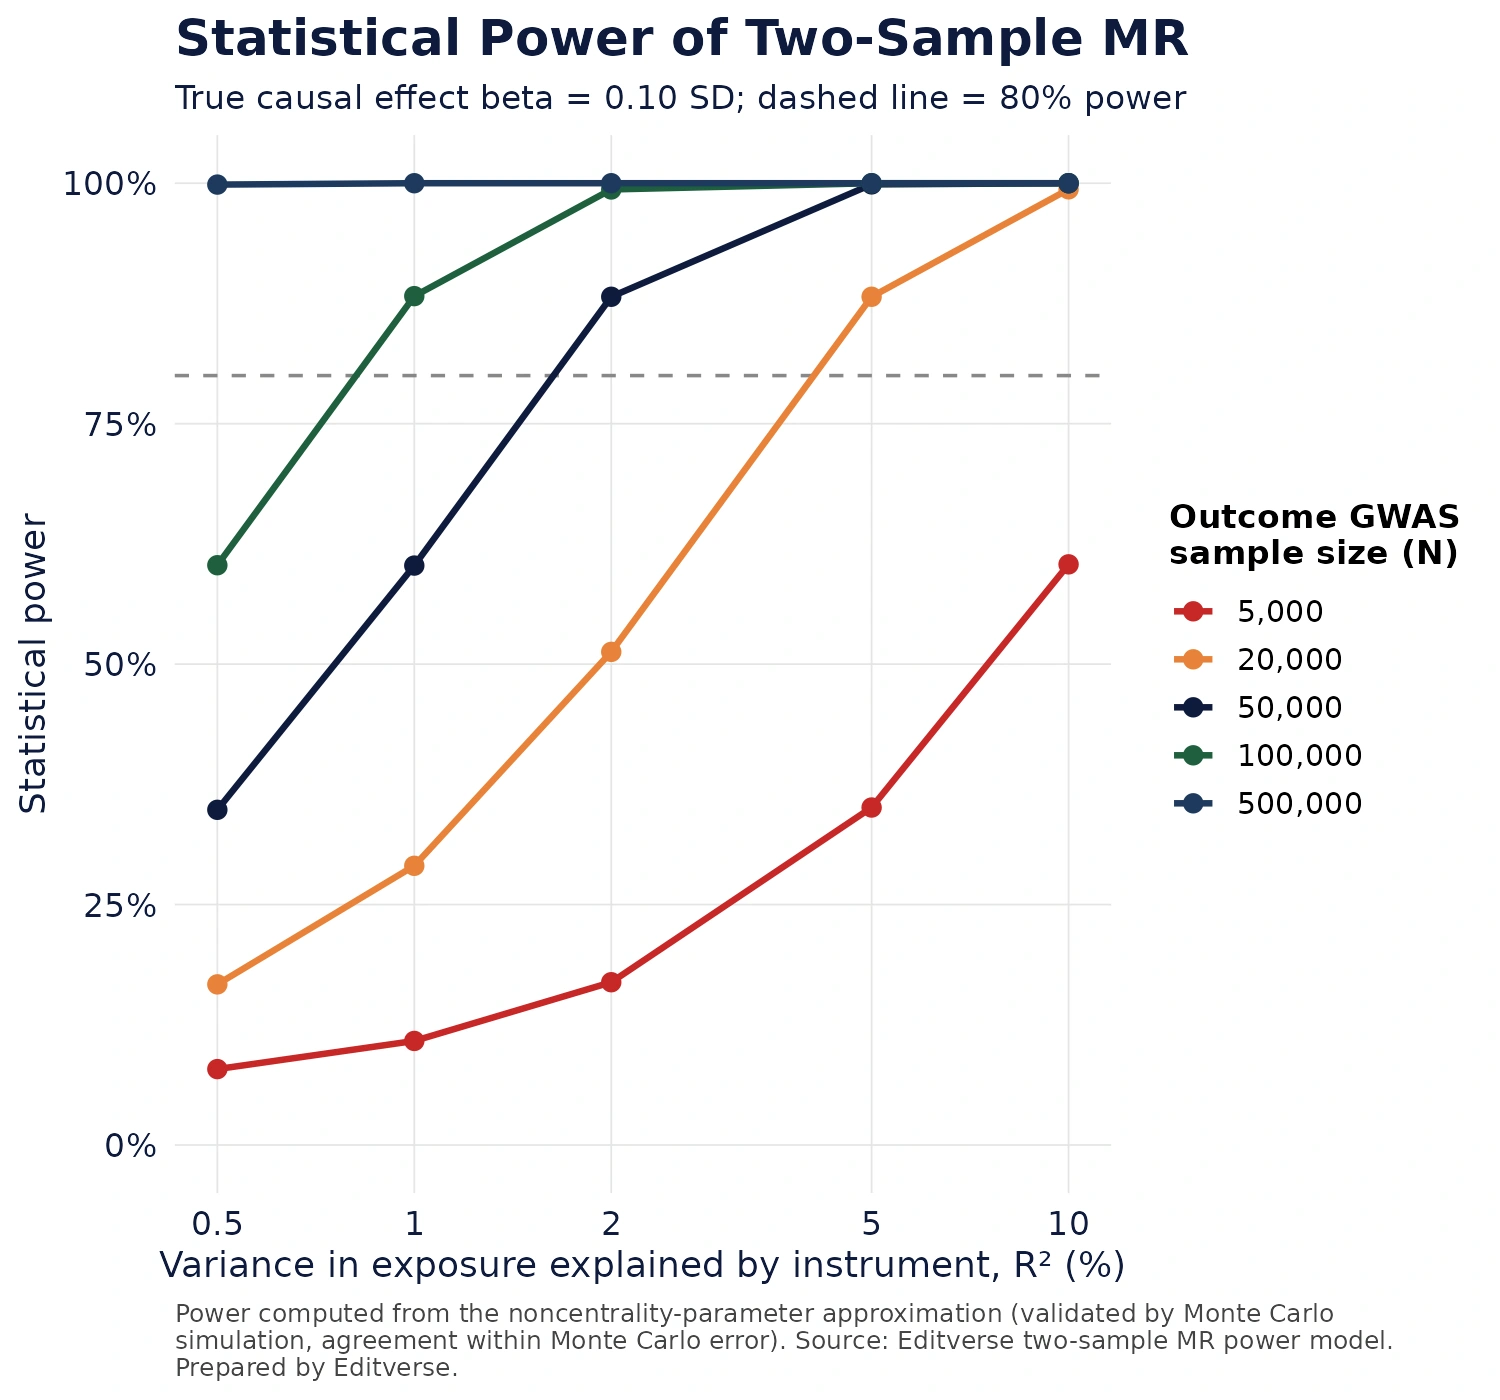
Die Oberflächenanalyse bestätigt die Form der Formel und liefert keine isolierten, überraschenden Ergebnisse – genau darum geht es bei deren Validierung. Bei einer Stichprobengröße von 500,000, dem üblichen Umfang großer Biobankanalysen, erreicht die statistische Power selbst bei der geringsten Instrumentenstärke im Raster über 99 Prozent. Bei einer Stichprobengröße von 5,000, einer immer noch gängigen Größe für Fall-Kontroll-Studien mit selteneren Endpunkten, erreicht die Power auf der von uns getesteten R²-Achse nirgends 80 Prozent und liegt selbst dann bei maximal 60 Prozent, wenn ein einzelnes Instrument großzügige 10 Prozent der Expositionsvarianz erklärt. Zwischen diesen Extremen verhalten sich die beiden Achsen direkt zueinander. Eine Stichprobengröße von 20,000 benötigt ein Instrument, das etwa 4 bis 5 Prozent der Expositionsvarianz erklärt, um eine konventionelle Power zu erreichen – eine Schwelle, die nur wenige Einzel-SNP-Instrumente überschreiten und die üblicherweise die Zusammenfassung mehrerer genomweit signifikanter Varianten zu einem polygenen Score erfordert.
Sechs Designs, eine Effektgröße
Eine Rasteranalyse abstrakter Parameter dient der Modellprüfung. Gutachter möchten wissen, ob ein in einem eingereichten Manuskript als gewöhnlich erscheinendes Studiendesign tatsächlich die behaupteten Ergebnisse liefern konnte. Wir erstellten sechs Studiendesigns, die das gesamte publizierte Spektrum abdeckten: eine Zwei-Stichproben-MR, eine kleine Fall-Kontroll-Studie mit einem einzelnen Leit-SNP, eine mittelgroße Kohortenstudie mit entweder einem einzelnen SNP oder einem gepoolten Multi-SNP-Score sowie eine große Biobankstudie. Dabei berücksichtigten wir drei Instrumentenstärken. Anschließend berechneten wir die statistische Power für jedes Design bei drei Effektstärken: einer geringen (0.05 SD), einer mittleren (0.10 SD) und einer hohen (0.20 SD).
| Technologie | Ergebnis N / R² | Leistung bei Beta = 0.05 | Leistung bei Beta = 0.10 | Leistung bei Beta = 0.20 |
|---|---|---|---|---|
| Kleine Fall-Kontroll-Studie mit einem einzelnen Leit-SNP | 4,000 / 0.5% | 5.5% | 7.3% | 14.1% |
| Mittlere Kohorte, einzelnes Lead-SNP | 25,000 / 0.8% | 10.7% | 29.3% | 79.1% |
| Instrument für die mittlere Kohorte mit mehreren SNPs | 25,000 / 2% | 19.9% | 60.4% | 99.2% |
| Große Biobank, einzelne Leit-SNP | 400,000 / 0.5% | 60.8% | 99.4% | 100% |
| Große Biobank, Multi-SNP-Instrument | 400,000 / 3% | 99.98% | 100% | 100% |
| Große Biobank, gut ausgestattete Expositionsstudie | 400,000 / 8% | 100% | 100% | 100% |
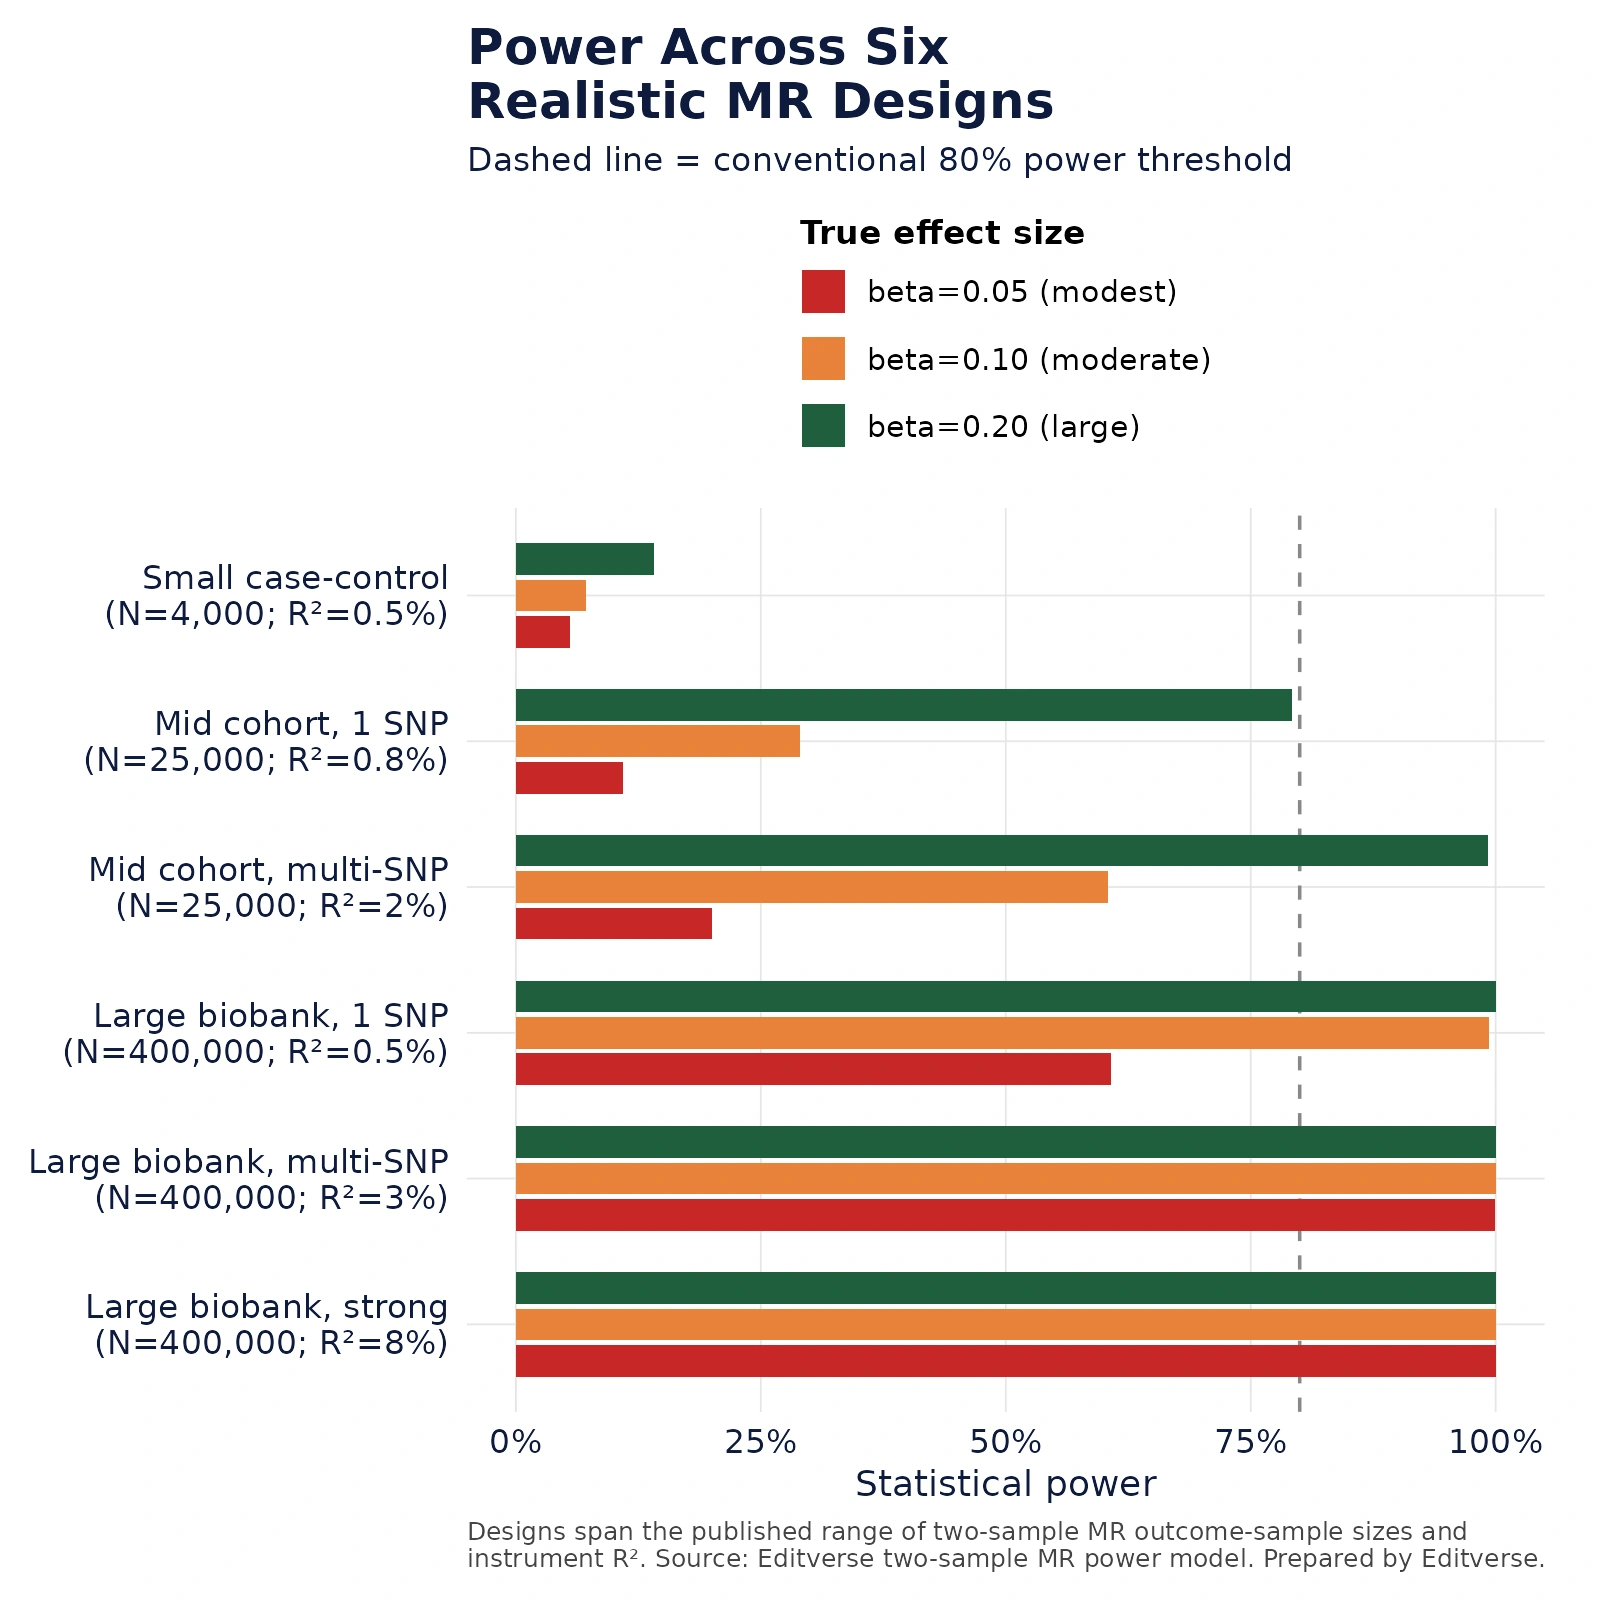
Zwei der sechs Studiendesigns erreichen selbst bei einem moderaten Effekt nie die übliche statistische Power, ein drittes nur knapp. Eine kleine Fall-Kontroll-Studie erreicht selbst bei einem großen Effekt von 0.20 SD keine Power von 15 Prozent. Das bedeutet, dass ein Nullbefund in diesem Design nahezu wertlos ist, unabhängig vom tatsächlichen Kausalzusammenhang. Die mittelgroße Kohorte mit einem einzelnen Leit-SNP benötigt einen großen Effekt, um die Power von 80 Prozent zu überschreiten. Bei den meisten Expositionen von praktischem Interesse – einer moderaten Veränderung eines Biomarkers oder eines Entzündungsmarkers – ist jedoch nicht zu erwarten, dass sie einen signifikanten Effekt haben. Nur die beiden Studiendesigns mit großen Biobanken und einem gepoolten Multi-SNP-Instrument erreichen selbst bei der kleinsten getesteten Effektstärke eine Power von über 80 Prozent. Diese Kombination hat sich in Krankheitsbereichen mit enormen Ressourcen für genomweite Assoziationsstudien, wie Lipiden, Blutdruck und Body-Mass-Index, als Standard etabliert und ist bei weniger untersuchten Expositionen deutlich seltener anzutreffen.
Warum ein leistungsschwaches Null-Monster trotzdem als echte Entdeckung veröffentlicht wird
Fehlende Evidenz wird in der Mendelschen Randomisierung häufiger als Beweis für deren Nichtvorhandensein gewertet, als die Methode eigentlich zulässt. Der Grund dafür ist, dass die Schätzung des Verhältnisses in einer Studie mit zu geringer statistischer Aussagekraft nicht weniger sicher erscheint als in einer Studie mit ausreichender Aussagekraft. Eine ursachenspezifische Hazard Ratio aus einer kleinen Kohorte weist zumindest ein sichtbar breites Konfidenzintervall auf, das man intuitiv erfassen kann. Eine Null-MR-Schätzung mit einem moderaten Konfidenzintervall wirkt wie ein eindeutiges Ergebnis, selbst wenn die Studie nie eine realistische Chance hatte, die Nullhypothese für die klinisch relevante Effektstärke zu verwerfen.
Dies ist der Grund dafür, dass 41 Prozent der Studien im Rosas-Chavez- und Merriman-Audit keine Angaben zur statistischen Power machten. Sobald eine Publikation eine Punktschätzung nahe Null und ein Konfidenzintervall, das diese einschließt, angibt, gilt das Manuskript auch ohne Angabe der Power als vollständig. Weder die Autoren noch, wie es scheint, die meisten Gutachter stellen die nächste Frage: War die Studie überhaupt darauf ausgelegt, einen Effekt von biologisch oder klinisch relevanter Größenordnung nachzuweisen? Punkt 4b der STROBE-MR-Leitlinie dient genau diesem Zweck: Autoren müssen von vornherein angeben, ob eine Poweranalyse durchgeführt wurde. Das zugehörige Erläuterungsdokument stellt unmissverständlich klar, dass die nachträglich ermittelte Breite des Konfidenzintervalls der ehrlichste Indikator dafür ist, welche Aussagekraft die Studie tatsächlich besitzt.
Eine praktische Lösung erfordert nur einen Absatz und eine Zahl. Vor der Beauftragung oder Einreichung einer MR-Analyse sollte eine Poweranalyse nach Mendelian Randomization für den minimal nachweisbaren Effekt bei einer Power von 80 % durchgeführt werden. Dabei sind das bekannte R² des Instruments und die bekannte Stichprobengröße zu berücksichtigen. Verwenden Sie hierfür denselben Ansatz zur Bestimmung des Nichtzentralitätsparameters wie in Abbildung 1 und geben Sie das Ergebnis zusammen mit der F-Statistik im Methodenteil an. Ein Nullergebnis neben einem minimal nachweisbaren Effekt von 0.03 SD ist ein realer Befund. Ein Nullergebnis neben einem minimal nachweisbaren Effekt von 0.25 SD, wobei die Literatur nahelegt, dass der tatsächliche Effekt – falls er existiert – eher bei 0.10 SD liegt, ist eine methodische Einschränkung, die als Schlussfolgerung getarnt ist.
Die Spannung mit den beiden anderen Speichen
Die Erhöhung der statistischen Aussagekraft durch Hinzufügen weiterer genetischer Varianten zum Instrument ist die naheliegende Reaktion auf ein niedriges R². Sie beeinflusst jedoch die beiden anderen in dieser Reihe beschriebenen Fehlerquellen, anstatt sie zu umgehen. Jedes zusätzliche SNP, das in einen Score einfließt, erhöht das R² und damit die statistische Aussagekraft, was im Hinblick auf das in diesem Beitrag diskutierte Problem positiv ist. Jede zusätzliche Variante birgt aber auch ein erhöhtes Risiko für horizontale Pleiotropie, die Fehlerquelle, die in unserem zweiten Beitrag quantifiziert wurde. Dabei kann ein gemeinsamer vorgelagerter Signalweg alle vier gängigen Schätzer in Richtung desselben falschen Ergebnisses lenken, obwohl dies wie Übereinstimmung aussieht. Ein großes, leistungsstarkes Instrument ist nicht automatisch ein valides Instrument, und die in dem vorherigen Beitrag beschriebenen Pleiotropie-Diagnostiken werden mit zunehmender Größe des Instruments nicht weniger notwendig.
Die Verzerrung durch schwache Instrumente wirkt sich in die entgegengesetzte Richtung auf die statistische Power aus. Unsere erste Untersuchung ergab, dass eine niedrige F-Statistik der ersten Stufe die Breite des Konfidenzintervalls vergrößert, ohne den Median der Punktschätzung im soeben identifizierten Fall zu verschieben. Dies deutet darauf hin, dass dadurch stets ein korrektes Nullergebnis und kein falsch positives Ergebnis erzielt wird. Kombiniert man dies mit dem hier vorliegenden Befund, so ist das korrekte Nullergebnis eines schwachen Instruments häufig auch ein unterpowertes Nullergebnis. Das bedeutet, dass derselbe Designfehler, der das Intervall verbreitert, auch die Wahrscheinlichkeit verringert, überhaupt einen realen Effekt zu entdecken. Eine Publikation kann ein breites, korrekt zentriertes, nicht signifikantes Intervall eines schwachen Einzel-SNP-Instruments berichten und gleichzeitig technisch unvoreingenommen, aber praktisch unfähig sein, ihre eigene Forschungsfrage zu beantworten. Dies ist das dritte Mal in dieser Reihe, dass eine Methode, die sich exakt wie von ihrer statistischen Theorie vorhergesagt verhält, dennoch eine irreführende Publikation hervorbringt, da die Theorie beschreibt, was der Schätzer tut, aber nichts darüber aussagt, ob das Studiendesign ihm genügend Informationen lieferte.
Kostenlose Recherchetools von Editverse
- GraphProErstellen Sie publikationsreife Diagramme (25 Typen) mit integrierten t-Tests, ANOVA, Korrelations- und Chi-Quadrat-p-Werten. Kostenlos, keine Anmeldung erforderlich.
- StatProKostenlose Statistikrechner und ein Testauswahltool für Gruppenvergleiche, kategoriale Ergebnisse, Zeit-bis-Ereignis-Analysen und diagnostische Genauigkeit.
- Flowchart Pro: Generieren Sie PRISMA 2020-, PRISMA-ScR-, CONSORT-, STROBE-, STARD-, MOOSE- und ARRIVE-Flussdiagramme direkt in Ihrem Browser.
Professionelle Unterstützung für eine Mendelsche Randomisierungsstudie
Eine Poweranalyse gehört in die Planungsphase, nicht erst in die Phase der Gutachterantworten. Denn eine Studie, die sich nach Vorliegen der Daten als unterpowert erweist, lässt sich nicht durch eine verbesserte Diskussion korrigieren. Unsere Biostatistiker führen die Berechnungen zur Instrumentenstärke und Power durch, bevor mit der Analyse begonnen wird. Sie berichten über den minimalen nachweisbaren Effekt bei jedem Nullergebnis und überprüfen das Instrument anhand von Pleiotropie-Diagnostiken mehrerer Schätzer. Dabei folgen sie der STROBE-MR-Checkliste Punkt für Punkt, anstatt sie erst nachträglich auf Nachfrage eines Gutachters anzupassen.
Machbarkeitsprüfung
$450
Ob für Ihre Exposition ein geeignetes Instrument existiert, wie hoch dessen wahrscheinlicher R²-Wert im Vergleich zu öffentlich zugänglichen GWAS-Daten ist und welcher minimale Effekt bei Ihrer verfügbaren Stichprobengröße nachweisbar ist, bevor Sie die vollständige Studie in Auftrag geben. Die Kosten werden Ihnen für jede anschließend in Auftrag gegebene Studie vollständig gutgeschrieben. Bearbeitungszeit: 5 Werktage.
Zwei-Proben-MR-Studie
$2,900
Vollständige Kausalanalyse mit F-Statistik, Power und minimaler nachweisbarer Effektstärke (MDE) zusammen mit der Schätzung; Pleiotropieprüfung mittels IVW, MR-Egger, gewichtetem Median und gewichtetem Modus; MR-PRESSO- und Steiger-Filterung; Manuskript, Abbildungen und eine ausgefüllte STROBE-MR-Checkliste. Öffentliche GWAS-Zusammenfassungsstatistiken werden von uns bezogen. Bearbeitungszeit: 15 Werktage.
Erweiterte Designs
Von $ 3,500
Multivariable MR über korrelierte Expositionen, bidirektionale und Steiger-gefilterte Designs, Instrumenten-PheWAS gegen potenzielle pleiotrope Signalwege und gemeinsame Powerberechnungen über zwei oder mehr gemeinsam analysierte Expositionen. Festpreis und schriftlicher Leistungsumfang vor Arbeitsbeginn.
Die zentrale Säule dieser Reihe, „Mendelsche Randomisierung erklärt“ , behandelt die gesamte Methode von der Instrumentenauswahl bis zur Berichterstattung. Unsere Erläuterung von Instrumentalvariablenansätzen legt die statistischen Grundlagen für die Poweranalyse dar. Falls Sie noch unentschlossen sind, ob die Mendelsche Randomisierung das richtige Studiendesign für Ihre Fragestellung ist, vergleichen wir in unserem Leitfaden zur Wahl der passenden Gesundheitsdatenbank die Mendelsche Randomisierung mit Register- und Umfragedesigns. Unser Leitfaden zu Evidenzstufen in der klinischen Forschung zeigt Ihnen, wo ein gut dimensioniertes Kausaldesign wie dieses im Vergleich zu Studienergebnissen einzuordnen ist.
Fazit
Die Berechnung der Teststärke mittels Mendelscher Randomisierung ist keine bloße Formalität, die nach Abschluss der Analyse hinzugefügt wird. Sie bestimmt, ob die zentrale Aussage der Studie – positiv oder negativ – auf der Exposition selbst oder auf der Stichprobengröße der Studie beruht. Unser validiertes Modell quantifiziert die beiden entscheidenden Größen: die Stichprobengröße und das Bestimmtheitsmaß (R²) des Instruments. Die sechs von uns getesteten realistischen Studiendesigns zeigen, dass ein beträchtlicher Anteil der in der Literatur immer noch häufig anzutreffenden Studienformen – eine moderate Kohortenstudie mit einem einzelnen Leitgenvarianten-Outcome – nicht die übliche Teststärke für einen Effekt erreicht, den die meisten Forscher als berichtenswert erachten würden.
Keiner der drei Aspekte dieser Reihe beschreibt eine fehlerhafte Methode. Die F-Statistik, die vier pleiotropierobusten Schätzer und die Powerberechnung erfüllen alle exakt die Anforderungen ihrer statistischen Theorie. Gemeinsam ist ihnen, dass keiner von ihnen die anderen beiden ersetzen kann. Eine Arbeit, die nur einen dieser Aspekte angibt – eine F-Statistik über 10 ohne Angabe der Power oder eine einfache Nullhypothese ohne minimalen nachweisbaren Effekt – erfüllt zwar formal die Kriterien der STROBE-MR-Checkliste, beantwortet aber nicht die Frage, die ein sorgfältiger Gutachter tatsächlich stellt. Die Angabe aller drei Aspekte kostet einen kurzen Absatz. Das Weglassen eines Aspekts führt dazu, dass eine methodische Einschränkung als publizierte Schlussfolgerung erscheint.
Referenzen
- Brion MJA, Shakhbazov K, Visscher PM. Berechnung der statistischen Power in Mendelschen Randomisierungsstudien. Int J Epidemiol. 2013;42(5):1497-1501. doi: 10.1093 / ije / dyt179
- Burgess S. Stichprobenumfangs- und Powerberechnungen bei der Mendelschen Randomisierung mit einer einzelnen Instrumentalvariablen und einem binären Ergebnis. Int J Epidemiol. 2014;43(3):922-929. doi:10.1093/ije/dyu005
- Burgess S, Butterworth A, Thompson SG. Mendelsche Randomisierungsanalyse mit multiplen genetischen Varianten unter Verwendung zusammengefasster Daten. Genet Epidemiol. 2013;37(7):658-665. doi:10.1002/gepi.21758
- Skrivankova VW, Richmond RC, Woolf BAR, et al. Verbesserung der Berichterstattung über Beobachtungsstudien in der Epidemiologie durch Mendelsche Randomisierung: die STROBE-MR-Leitlinie. JAMA. 2021;326(16):1614-1621. doi: 10.1001 / Grube.2021.18236
- Skrivankova VW, Richmond RC, Woolf BAR, et al. Stärkung der Berichterstattung über Beobachtungsstudien in der Epidemiologie mittels Mendelscher Randomisierung (STROBE-MR): Erklärung und Erläuterung. BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233
- Rosas-Chavez F, Merriman TR. Mendelsche Randomisierungsstudien: ein Maßstab zur Qualitätsbewertung. Gout Urate Crystal Deposition Dis. 2025;3(2):8. doi:10.3390/gucdd3020008