
Veröffentlicht | Letzte Aktualisierung:
Top-Experten haben 83 Beiträge zu KI-Datenvisualisierungstools verfasst. Dies hat die Art und Weise verändert, wie Forscher und Wissenschaftler ihre Erkenntnisse teilen. Das International Journal of Science and Research (IJSR) zeigt die große Rolle der KI im wissenschaftlichen Publizieren. Sie macht komplexe Daten für jedermann leichter verständlich.
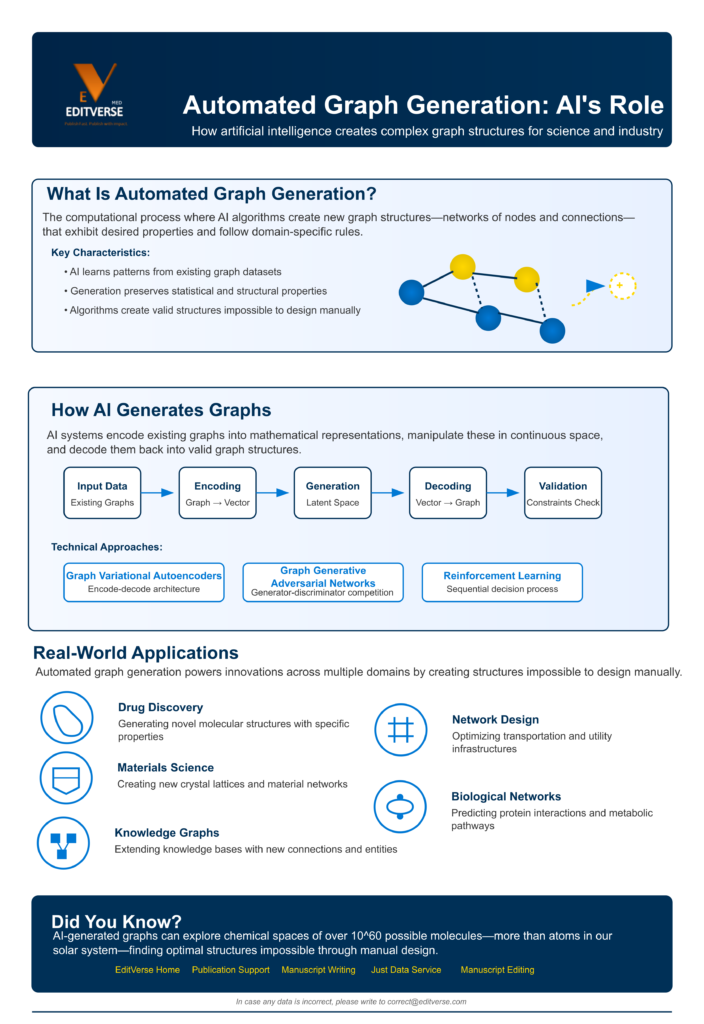
Kurznotiz | Was Sie über die automatische Graphengenerierung wissen müssen: Die Rolle der KI
| Aspekt | Schlüsselinformation |
|---|---|
| Definition | Automatisierte Graphgenerierung durch KI bezieht sich auf die Rechenprozesse, mit denen künstliche Intelligenzsysteme autonom grafische Darstellungen von Datenbeziehungen erstellen, bearbeiten und optimieren, ohne dass für jede Ausgabe eine explizite menschliche Programmierung erforderlich ist. Diese Technologie umfasst die Anwendung von Algorithmen des maschinellen Lernens, neuronalen Netzwerken, statistischen Methoden und Techniken zur Wissensdarstellung, um Rohdaten in aussagekräftige visuelle Netzwerkstrukturen, Hierarchien, Entscheidungsbäume und andere graphenbasierte Darstellungen umzuwandeln. Diese Systeme verwenden Mustererkennungsfunktionen, um implizite Beziehungen zu identifizieren, geeignete topologische Strukturen zu generieren, optimale Layouts zu bestimmen und visuelle Kodierungsschemata anzuwenden, die die Informationsübertragung maximieren und gleichzeitig die kognitive Belastung minimieren. Die Technologie weist drei unterschiedliche Betriebsmodalitäten auf: datengesteuerte Generierung (Extrahieren von Graphstrukturen direkt aus empirischen Datensätzen), wissensgesteuerte Generierung (Umwandeln symbolischer oder ontologischer Informationen in Graphdarstellungen) und generative Synthese (Erstellen neuartiger Graphstrukturen basierend auf erlernten Mustern aus Trainingsbeispielen). Moderne Implementierungen umfassen mehrere KI-Ansätze, darunter Deep-Learning-Architekturen zur Musterextraktion, Verstärkungslernen zur Layoutoptimierung, Verarbeitung natürlicher Sprache zur Konvertierung von Textdaten und Computer-Vision-Techniken zur bildbasierten Graphextraktion. Das entscheidende Merkmal der KI-gestützten Graphengenerierung ist ihre Fähigkeit, autonom komplexe Entscheidungen über Beziehungsidentifizierung, strukturelle Organisation, visuelle Kodierung und ästhetische Präsentation zu treffen und sich gleichzeitig an unterschiedliche Datendomänen, Graphenkomplexitäten und Anwendungskontexte anzupassen, ohne dass für jedes neue Szenario oder jeden neuen Datentyp eine explizite Neuprogrammierung erforderlich ist. |
| Materialien |
|
| Eigenschaften im Vergleich |
|
| Anwendungen |
Wissenschaftliche Forschung und Erkenntnisgewinnung:
|
| Herstellungstechniken |
|
| Challenges |
|
KI-gestützte Tools sind für Unternehmen und Wissenschaftler von entscheidender Bedeutung. Sie helfen dabei, Big Data zu verstehen. Diese Tools sind über einfache Diagramme hinausgegangen. Sie finden Muster in riesigen Datensätzen und helfen uns, bessere Entscheidungen zu treffen.
Wichtige Erkenntnisse
- KI-gestützte Visualisierungstools reduzieren die kognitive Belastung, die mit manuellen Analysen verbunden ist
- KI-gestützte Visualisierungstools demokratisieren die Dateninterpretation und machen fortgeschrittene Analysen für Benutzer aller Fähigkeitsstufen zugänglich.
- Die automatische Graphengenerierung vereinfacht die akademische Visualisierung, ermöglicht schnellere Entscheidungen und verbessert das Datenverständnis.
- KI-Datenvisualisierungstools können Zeit sparen, die Genauigkeit verbessern, das Engagement steigern und klare Erklärungen und Empfehlungen liefern
- Der Einsatz von KI-gestützten Visualisierungstools wird im wissenschaftlichen Publizieren immer wichtiger, wobei Spitzenexperten an ihrer Entwicklung mitwirken
Automatisierte Diagramme im akademischen Umfeld verstehen
Automatisierte Grafiken sind in der akademischen Forschung unerlässlich. Sie helfen Forschern, komplexe Daten zu visualisieren und Muster zu erkennen. Wir nutzen Datenvisualisierungssoftware, um diese Grafiken interaktiv und dynamisch zu gestalten. Dadurch werden Forschungsergebnisse leichter verständlich.
Das Grafiktool vereinfacht die Erstellung dieser visuellen Datendarstellungen. Es trägt dazu bei, Forschungsergebnisse verständlich zu vermitteln.
Definition automatisierter Graphen
Automatisierte Grafiken werden mithilfe von Algorithmen und maschinellem Lernen erstellt. Sie zeigen Trends, Muster und Korrelationen in großen Datensätzen auf.
Bedeutung in der akademischen Forschung
Automatisierte Grafiken sind in der Forschung unerlässlich. Sie machen komplexe Daten leicht verständlich. Mithilfe von Datenvisualisierungssoftware können Forschende interaktive Grafiken erstellen. Diese Grafiken helfen dabei, verschiedene Szenarien zu untersuchen und Ergebnisse vorherzusagen.
Wie sie die Dateninterpretation verbessern
Automatisierte Grafiken erleichtern das Verständnis von Daten. Sie stellen komplexe Daten visuell dar . Dies hilft Forschern, Muster und Trends schnell zu erkennen.
Mithilfe eines Grafiktools lassen sich Korrelationen und Zusammenhänge aufzeigen. Dies führt zu neuen Erkenntnissen und einem tieferen Verständnis des Themas.
Tools wie Tableau, Google Data Studio und Power BI sind beliebt für die automatisierte Erstellung von Diagrammen. Sie bieten Funktionen zur Erstellung interaktiver und dynamischer Diagramme . Forscher können mit diesen Tools verschiedene Szenarien untersuchen und Ergebnisse vorhersagen.
| Werkzeug | Eigenschaften |
|---|---|
| Tableau | Interaktive Grafiken, Datenvisualisierung, prädiktive Analysen |
| Google Datenstudio | Interaktive Grafiken, Datenvisualisierung, Echtzeitdaten |
| Power BI | Interaktive Grafiken, Datenvisualisierung, Business Intelligence |
Die Vorteile der KI-Visualisierung für Wissenschaftler
KI-Visualisierung verändert die Art und Weise, wie Wissenschaftler Daten analysieren. Sie nutzt maschinelles Lernen, um Muster schnell zu erkennen. Dies trägt zu besseren Entscheidungen bei, insbesondere im Bildungsbereich.
KI-Tools machen Daten für jedermann leichter verständlich. Sie verwandeln komplexe Daten in interaktive Visualisierungen. Dies hilft Wissenschaftlern, ihre Erkenntnisse sowohl innerhalb als auch außerhalb ihres Fachgebiets besser zu teilen.
KI hilft auch dabei, neue Forschungsbereiche und Ideen zu finden. Dies treibt Innovationen in vielen Bereichen voran.
Einige wichtige Vorteile der KI-Visualisierung für Wissenschaftler sind:
- Verbesserte Genauigkeit und Geschwindigkeit bei der Datenanalyse und -interpretation
- Verbesserte Zugänglichkeit für nicht-technische Benutzer
- Höhere Effektivität bei der Kommunikation von Forschungsergebnissen
- Erleichterte Identifizierung von Bereichen für weitere Forschung und Entwicklung neuer Hypothesen
Durch den Einsatz von KI-Visualisierung können Wissenschaftler neue Wege der Datenerhebung und -präsentation erkunden. Dies trägt zur Erweiterung des Wissens in ihren Fachgebieten bei.
| Vorteile der KI-Visualisierung | Beschreibung |
|---|---|
| Schnelle Datenanalyse | KI-gestützte Tools können große Datensätze schnell analysieren und so zeitnahe Entscheidungen ermöglichen. |
| Barierrefreiheit | Nicht-technische Benutzer können sich durch interaktive und dynamische Visualisierungen mit komplexen Daten auseinandersetzen. |
| Verbesserte Präsentation | Durch KI-Visualisierung können Forschungsergebnisse besser kommuniziert werden, sodass sie für ein vielfältigeres Publikum interessanter und zugänglicher werden. |
Hauptmerkmale KI-gestützter akademischer Tools
Intelligente Datenvisualisierung ist in der akademischen Forschung unerlässlich. Deshalb konzentrieren wir uns auf intelligente Diagrammlösungen . Diese Tools verbessern die Forschung – von der Datenanalyse bis zur Ergebnispräsentation.
Anpassung und Flexibilität
KI-gestützte Werkzeuge ermöglichen es Forschern, ihre Arbeit individuell anzupassen. Diese Flexibilität ist für eine aussagekräftige Datenvisualisierung unerlässlich . Sie hilft Wissenschaftlern, intelligente Diagrammlösungen zu nutzen , die ihre Forschungsergebnisse optimal darstellen.
Integration mit gängiger Software
Diese Tools lassen sich auch gut in gängige Software integrieren. Dies sorgt für einen reibungslosen Arbeitsablauf. Indem Forscher KI-Tools mit dem kombinieren, was sie bereits verwenden, können sie sich ohne Probleme auf ihre Arbeit konzentrieren.
Zu den großartigen Eigenschaften dieser Tools gehören:
- Sie helfen dabei, Daten durch intelligente Visualisierung besser zu verstehen
- Sie machen die Arbeit effizienter mit intelligenten Diagrammen
- Sie erleichtern die Teamarbeit durch die gemeinsame Nutzung von Tools
Der Einsatz von KI-Tools in der Forschung kann neue Entdeckungen ermöglichen. Intelligente Datenvisualisierung und aussagekräftige Diagramme eröffnen vielfältige Forschungsrichtungen.
| Werkzeug | Eigenschaften | Vorteile |
|---|---|---|
| Tableau | Datenvisualisierung, Echtzeitanalyse | Verbesserte Dateninterpretation, erhöhte Produktivität |
| Power BI | Geschäftsanalysen, Datenvisualisierung | Verbesserte Entscheidungsfindung, optimierter Workflow |
Beliebte KI-Tools zur automatischen Graphengenerierung
Wir haben mehrere KI-Tools zur Erstellung hochwertiger, automatisierter Grafiken gefunden. Dazu gehören GraphPad Prism, Tableau und Google Data Studio. Sie bieten zahlreiche Funktionen zur Unterstützung der Datenanalyse und -visualisierung.
KI-Visualisierungstools wie GraphPad Prism und Tableau erleichtern die Erstellung automatisierter Grafiken . Sie helfen Wissenschaftlern, ihre Forschungsergebnisse wirkungsvoll zu präsentieren.
Diese Tools verfügen über einige wichtige Funktionen:
- Anpassung und Flexibilität bei der Erstellung automatisierter Diagramme
- Integration mit gängiger Software und Datenquellen
- Aufrechterhaltung der Datenintegrität und -sicherheit
Mithilfe dieser KI-Tools können Wissenschaftler hochwertige automatisierte Grafiken erstellen. Dies steigert ihre Forschungsproduktivität. Der globale KI-Markt ist im Jahr 455 fast 2023 Milliarden US-Dollar wert. KI wird in Bereichen wie der akademischen Visualisierung immer wichtiger.
Fallstudien: Erfolgreiche Implementierung im akademischen Bereich
KI-gestützte Werkzeuge haben Forschung und Lehre erheblich verbessert. Betrachten wir einige Beispiele für ihren erfolgreichen Einsatz in Schulen. Die Nutzung von Datenvisualisierungssoftware hat Lehrkräften geholfen, Präsentationen ansprechender und interaktiver zu gestalten.
Die University of Massachusetts Boston nutzt Datenvisualisierung, um die Studierendenzahlen besser zu verstehen. Dies hilft ihr, fundiertere Entscheidungen zu treffen und den Studienerfolg zu verbessern. Außerdem helfen grafische Darstellungen dabei, Studierende mit Schwierigkeiten zu identifizieren, damit diese die benötigte Unterstützung erhalten.
Einige der Hauptvorteile von KI-Tools in Schulen sind:
- Sie machen die Datenanalyse einfacher und genauer.
- Sie tragen dazu bei, Forschungsergebnisse ansprechender zu präsentieren.
- Sie steigern das Interesse und die Lernergebnisse der Schüler.
Durch den Einsatz dieser Tools können Lehrer ihre Forschungsarbeit verbessern. Sie können auch Präsentationen effektiver gestalten. All dies hilft den Schülern, mehr zu lernen und den Prozess zu genießen. Da wir KI-Tools weiterhin erforschen, ist klar, dass sie eine Schlüsselrolle bei der Gestaltung der Zukunft der Bildung spielen werden.
| Universität | Verwendung der Datenvisualisierung | Vorteile |
|---|---|---|
| Universität von Massachusetts Boston | Einschreibungsdaten verstehen und Trends in der Studentenpopulation identifizieren | Verbesserte Entscheidungsfindung und bessere Lernergebnisse |
| Andere Universitäten | Überwachung von Studierenden mit Risiko des Durchfallens oder Abbruchs | Proaktives Engagement und Unterstützung |
Der Prozess der Erstellung automatisierter Diagramme
Wir unterstützen den Einsatz von Machine-Learning-Analysen in der Bildungstechnologie . Die Erstellung automatisierter Diagramme umfasst mehrere Schritte. Dazu gehören das Sammeln und Aufbereiten von Daten, die Auswahl des geeigneten Visualisierungsformats und die Präsentation der Diagramme.
Eine Studie zur prädiktiven Analytik in der akademischen Forschung verdeutlicht die Rolle von KI. Sie unterstützt Forschende bei der Auswahl des optimalen Visualisierungsformats für ihre Daten. Dadurch verbessert sich die Art und Weise, wie sie ihre Forschungsergebnisse präsentieren.
Der Einsatz von Bildungstechnologien wie der automatisierten Diagrammerstellung bietet viele Vorteile. Er steigert die Effizienz und reduziert Fehler. Künstliche Intelligenz ermöglicht es Forschern, sich auf die Analyse und Interpretation von Daten zu konzentrieren , anstatt nur Diagramme zu erstellen. Tools wie Ajelix, ChartAI und Piktochart bieten Anpassungsmöglichkeiten und lassen sich mit Datenquellen wie Google Sheets oder SQL-Servern verbinden.
Hier sind einige wichtige Statistiken zu KI-generierten Diagrammen:
- 80 % der Branchenführer nutzen die automatische Diagrammerstellung für Marketingzwecke.
- 75 % der HR- und Learning-and-Development-Berichte verwenden KI-generierte Diagramme.
- 60 % der NGOs und Regierungsorganisationen verwenden KI-generierte Diagramme, um die Auswirkungen auf die Gemeinschaft und die finanzielle Gesundheit darzustellen.
Durch den Einsatz von maschinellem Lernen und Bildungstechnologien können Forschende die automatisierte Diagrammerstellung optimal nutzen. Dies führt zu einer besseren Kommunikation ihrer Ergebnisse und einer größeren Wirkung in ihren Fachgebieten.
| Diagrammtyp | Häufigkeit der Nutzung |
|---|---|
| Balkendiagramme | 40% |
| Liniendiagramme | 30% |
| Kreisdiagramme | 15% |
| Streudiagramme | 10% |
| Histogramme | 5% |
Herausforderungen und Grenzen der KI-Visualisierung
KI-Visualisierung bringt viele Vorteile mit sich, wie Smart Data und intelligente Diagramme. Aber sie bringt auch ihre eigenen Herausforderungen mit sich. Ein großes Problem ist die Datenqualität. Schlechte Daten können Visualisierungen falsch oder irreführend machen.
Für gute KI-Visualisierungen ist es entscheidend, dass die Daten sauber und zuverlässig sind. Dadurch wird sichergestellt, dass die Informationen vertrauenswürdig sind.
Ein weiteres Problem ist der Bedarf an technischen Fähigkeiten. Benutzer müssen die Daten und KI-Tools gut verstehen. Das kann für manche schwierig sein, beispielsweise für Forscher ohne technischen Hintergrund.
Es besteht auch die Möglichkeit, die Visualisierungen falsch zu interpretieren. Die KI könnte Ergebnisse anzeigen, die nicht stimmen oder unwichtige Muster hervorheben. Es ist wichtig, diese mit einem kritischen Auge zu betrachten und andere Quellen zu prüfen, bevor man Schlussfolgerungen zieht.

Um diese Probleme anzugehen, müssen wir in bessere KI-Datenlösungen investieren. Wir sollten daran arbeiten, die Datenqualität zu verbessern, den Benutzern den Umgang mit Technologie näherzubringen und KI-Algorithmen intelligenter zu machen. Auf diese Weise können wir die KI-Visualisierung voll ausnutzen, um in vielen Bereichen bessere Entscheidungen zu treffen.
Zukünftige Trends bei automatisierten Graphen
Dank KI-Visualisierungstools erwarten uns große Veränderungen bei automatisierten Diagrammen. Diese Tools werden Forschern helfen, neue Erkenntnisse und Muster zu finden. Dies könnte zu großen Durchbrüchen führen.
Zu den wichtigsten Trends, die Sie im Auge behalten sollten, gehören:
- Fortschritte bei Algorithmen des maschinellen Lernens ermöglichen eine genauere und effizientere Datenanalyse
- Verbesserte Integration mit Big Data, wodurch die Analyse größerer und komplexerer Datensätze möglich wird
- Prognosen für 2027 und darüber hinaus, einschließlich des Potenzials für automatisierte Graphen revolutionieren das Feld der akademischen Visualisierung
Mit der Verbesserung von KI-Tools werden sich automatisierte Diagramme deutlich verbessern. Dies wird viele Bereiche verändern, wie Forschung und Bildung. Wissenschaftler werden neue Bereiche entdecken, die sie erforschen und neue Theorien entwickeln können.
KI-Tools werden auch die Verbreitung von Forschungsergebnissen erleichtern. Automatisierte Grafiken helfen dabei, komplexe Daten auf unterhaltsame und interaktive Weise darzustellen.
| Jahr | Fortschritte bei automatisierten Graphen |
|---|---|
| 2025 | Verstärkter Einsatz von KI-gestützten Datenvisualisierungstools |
| 2026 | Fortschritte bei maschinellen Lernalgorithmen für die Datenanalyse |
| 2027 und darüber hinaus | Prognosen zum Potenzial automatisierter Graphen revolutionieren die akademische Visualisierung |
Fazit: Die wachsende Bedeutung von KI in akademischen Tools
Künstliche Intelligenz (KI) verändert die Art und Weise, wie wir in der Wissenschaft forschen und schreiben. Tools wie Datenvisualisierungssoftware helfen Wissenschaftlern, ihre Ergebnisse anschaulich darzustellen. Studien zeigen, dass KI in etwa 2.2 % der wissenschaftlichen Arbeiten eingesetzt wird, was ihre zunehmende Verbreitung belegt.
KI macht die Forschung schneller und besser. So kann sie beispielsweise die Zeit für die Datenerfassung um 40–50 % verkürzen. Außerdem hilft sie Teams, besser zusammenzuarbeiten, was die Produktivität um 20–25 % steigert.
Wir sollten die Nutzung von KI in schulischen Tools weiter erforschen. Sie macht Präsentationen ansprechender und unterstützt Schülerinnen und Schüler beim Lernen. KI erleichtert zudem Recherche und schriftliche Arbeiten, macht sie präziser und fördert die Kreativität. Weitere Informationen zu KI im schulischen Schreiben und Recherchieren finden Sie in dieser Ressource.
Der Einsatz von KI in der Forschung hat viele Vorteile:
- Es macht die Arbeit effizienter und produktiver.
- Dadurch werden die Ergebnisse genauer und zuverlässiger.
- Es hilft, Daten klarer darzustellen.
- Es erleichtert die Recherche und das Schreiben.
Kurz gesagt, ist KI für schulische Anwendungen von großer Bedeutung. Wir sollten KI künftig verstärkt nutzen, um Forschung und Lehre zu verbessern. Mithilfe von Tools wie Datenvisualisierungssoftware können Wissenschaftler Präsentationen erstellen, die fesselnd und lehrreich sind und so zum Wissenszuwachs in ihren Fachgebieten beitragen.
Forschungs- und Datenanalysedienste | Editverse.com
Wir bieten erstklassige Forschungs- und Datenanalysedienstleistungen. Mithilfe von maschinellem Lernen erzielen wir präzisere und genauere Ergebnisse. Unser Expertenteam nutzt innovative Technologien, um die Datenanalyse zu beschleunigen und effektiver zu gestalten.
Zu unseren Dienstleistungen gehören die Visualisierung von Daten, die Durchführung statistischer Analysen und die Unterstützung bei der Forschungsgestaltung. Wir verwenden fortschrittliche Tools wie Data Formulator. Diese Tools helfen uns bei der Erstellung interaktiver und dynamischer Visualisierungen. Dies erleichtert die Datenerhebung und das Gewinnen von Erkenntnissen.
Einige Vorteile unserer Dienste sind:
- Verbesserte Forschungsergebnisse dank maschineller Lernanalyse und Bildungstechnologie
- Mehr Produktivität und Effizienz bei der Datenanalyse und -interpretation
- Bessere Datenvisualisierung und -präsentation
Bei Editverse.com möchten wir hervorragende Forschungs- und Datenanalysedienste anbieten. Unser Team ist bestrebt, innovative Lösungen zu finden. Wir verwenden die neuesten maschinellen Lernanalysen und Bildungstechnologien, um die Anforderungen unserer Kunden zu erfüllen.
Statistische Analysedienste
Wir bieten im Rahmen unserer Dienstleistungen auch fortgeschrittene statistische Modellierung an. Mithilfe intelligenter Datenvisualisierung liefern wir klare und aussagekräftige Ergebnisse. Unser Expertenteam erkennt Muster und Trends in komplexen Daten und unterstützt unsere Kunden so bei fundierten Entscheidungen.
Unsere statistischen Analysedienste bieten viele Vorteile:
- Sie verbessern Forschungsergebnisse mit fortschrittlichen statistischen Modellen.
- Sie machen die Datenanalyse effizienter und produktiver.
- Sie verbessern die Anzeige und Präsentation von Daten.
Unsere Dienstleistungen zielen darauf ab, Forscher und Wissenschaftler zu unterstützen. Mithilfe prädiktiver Analysen helfen wir dabei, neue Erkenntnisse und Trends in den Daten aufzudecken.
Mit unseren Kompetenzen in statistischer Analyse und intelligenten Diagrammlösungen unterstützen wir unsere Kunden beim Erreichen ihrer Forschungsziele. Wir streben die Veröffentlichung ihrer Ergebnisse in führenden Fachzeitschriften an. Unsere Dienstleistungen sind individuell auf die Bedürfnisse jedes Kunden zugeschnitten, und wir legen größten Wert auf die Qualität unserer Ergebnisse.
Hervorragende Datenvisualisierung
Wir sind spezialisiert auf die Erstellung von Datenvisualisierungsdiensten für Forschende . Unsere Kompetenzen in der automatisierten Diagrammerstellung und im Einsatz von KI helfen Wissenschaftlern, komplexe Daten verständlich darzustellen. Dadurch wird das Verständnis für andere erleichtert.
Heute generieren wir eine Menge Daten. Bis 2025 werden weltweit über 180 Zettabyte an Daten generiert. Der Großteil davon, 80 %, wird unstrukturiert sein. Unsere Dienste wandeln komplexe Daten in einfache Diagramme um. Dies hilft, Muster zu erkennen und Erkenntnisse zu gewinnen.
Publikationsreife wissenschaftliche Grafiken
Wir erstellen wissenschaftliche Grafiken, die direkt veröffentlicht werden können . Unser Team nutzt die neuesten Tools wie Tableau, Power BI und Google Data Studio. Sie erstellen interaktive und dynamische Visualisierungen.
Benutzerdefinierte Diagrammerstellung
Mit unseren benutzerdefinierten Diagrammdiensten können Forscher einzigartige Visualisierungen erstellen. Wir verwenden KI, um Erkenntnisse und Trends zu finden. Dies erleichtert das Erkennen von Mustern und Beziehungen.
| Werkzeug | Eigenschaften |
|---|---|
| Tableau | Ask Data, Abfragen in natürlicher Sprache |
| Power BI | Q&A Visuelle, KI-gesteuerte Erkenntnisse |
| Google Datenstudio | Integration mit Google-Produkten, Community Connectors |
Unsere Datenvisualisierungsdienste helfen Forschern, ihre Ziele zu erreichen. Wir verwenden automatisierte Grafiken und KI, um hochwertige Visualisierungen zu erstellen. Diese entsprechen Ihren spezifischen Anforderungen.
Forschungsförderungsdienste
Wir bieten Wissenschaftlern vielfältige Dienstleistungen für ihre Forschung an. Unsere Unterstützung umfasst systematische Reviews, Metaanalysen und die Entwicklung von Forschungsdesigns. Darüber hinaus helfen wir bei der Methodikentwicklung. Mit unserer Datenvisualisierungssoftware möchten wir die Qualität und Validität von Studien verbessern.
Unsere Experten unterstützen Sie bei der Auswahl und effektiven Anwendung von Grafiktools . So stellen wir eine übersichtliche Datenpräsentation sicher. Darüber hinaus beraten wir Sie zu Forschungsdesign und Methodik. Dies hilft Wissenschaftlern, fundierte und verlässliche Studien zu erstellen.
Systematische Überprüfungsunterstützung
- Umfangreiche Literaturrecherchen
- Studienauswahl und Screening
- Datenextraktion und -analyse
Meta-Analyse-Expertise
Unser Team unterstützt Sie bei Metaanalysen, einschließlich Datenzusammenführung und statistischer Auswertung. Wir verwenden fortschrittliche Datenvisualisierungssoftware , um die Ergebnisse leicht verständlich zu machen.
Spezialisierte Analytik
Bei Editverse.com bieten wir mehr als nur grundlegende Analysen. Wir unterstützen Wissenschaftler dabei, tiefgreifende Erkenntnisse aus ihren Daten zu gewinnen. Unsere Tools, die auf Bildungstechnologie und maschinellem Lernen basieren , vereinfachen die Datenanalyse. So können Sie sich darauf konzentrieren, Ihre Ergebnisse in wirkungsvolle Forschung umzusetzen.
Unser Team hilft mit Umfragedaten und Analysen klinischer Studien. Datenwissenschaftler und Statistiker unterstützen Sie bei Ihrer Forschung. Wir bewältigen die Herausforderungen der Datenanalyse und sorgen dafür, dass Ihre Arbeit in der akademischen Welt glänzt.
Abschnitt>
FAQ
Was sind automatisierte Diagramme und wie werden sie im akademischen Umfeld eingesetzt?
Automatisierte Graphen verwenden KI und maschinelles Lernen, um Visualisierungen zu erstellen. In Schulen helfen sie bei der Datenanalyse und machen Forschungsergebnisse verständlicher.
Welchen Nutzen kann die KI-Visualisierung Wissenschaftlern bringen?
Mithilfe der KI-Visualisierung können Wissenschaftler Daten schnell analysieren und ihre Ergebnisse problemlos teilen. Sie macht die Forschung interaktiv und dynamisch.
Was sind die Hauptmerkmale KI-gestützter akademischer Tools?
KI-Tools sind anpassbar und flexibel. Sie funktionieren gut mit gängiger Software und schützen Daten. Dies hilft Wissenschaftlern, effizienter zu arbeiten.
Welche KI-Tools gibt es zur automatischen Diagrammerstellung?
Zu den beliebtesten KI-Tools zählen GraphPad Prism, Tableau und Google Data Studio. Jedes davon verfügt über einzigartige Funktionen für den akademischen Einsatz.
Was sind die Herausforderungen und Grenzen der KI-Visualisierung?
Bei der KI-Visualisierung stehen Probleme wie Datenqualität und erforderliche technische Fähigkeiten im Vordergrund. Es ist entscheidend, sicherzustellen, dass die Ergebnisse zuverlässig und vertrauenswürdig sind.
Was sind die zukünftigen Trends bei automatisierten Grafiken?
Zu den zukünftigen Trends gehören besseres maschinelles Lernen und mehr Datenintegration. Diese Fortschritte werden die akademische Visualisierung noch stärker verändern.
Welche Forschungs- und Datenanalysedienste bietet Editverse.com an?
Editverse.com bietet verschiedene Dienste wie Recherche und Datenanalyse. Sie bieten statistische Analysen, Datenvisualisierung und mehr.
Quellenlinks
- https://www.ijsr.net/archive/v13i2/SR240210115511.pdf – Datenvisualisierung: KI – Verbesserte Visualisierungstools zur besseren Interpretation komplexer Datenmuster
- https://www.restack.io/p/generating-graphs-from-text-answer-cat-ai – Generieren von Diagrammen aus Text mit KI | Restackio
- https://www.linkedin.com/advice/3/what-most-innovative-ai-data-visualization-iwd7e – Welches sind die innovativsten KI-Datenvisualisierungstools, die heute verfügbar sind?
- https://support.park.edu/support/solutions/articles/6000275102-ai-in-research-enhancing-data-analysis-and-visualization – KI in der Forschung: Verbesserung der Datenanalyse und -visualisierung
- https://jenni.ai/artificial-intelligence/data-visualization-tools – KI-Datenvisualisierung verstehen: Ein umfassender Leitfaden – Jenni AI
- https://aicontentfy.com/en/blog/ai-generated-content-for-data-visualization-and-infographics – KI-generierte Inhalte für Datenvisualisierung und Infografiken
- https://www.linkedin.com/advice/3/how-can-ai-powered-data-visualization-tools-fnh8c – Wie können KI-gestützte Datenvisualisierungstools Ihre Karriere verbessern?
- https://www.digitalocean.com/resources/articles/ai-research-tools – 12 KI-Forschungstools zur Förderung der Wissenserkundung | DigitalOcean
- https://www.thoughtspot.com/data-trends/ai/ai-tools-for-data-visualization – Die 5 wichtigsten KI-Tools zur Datenvisualisierung, die im Jahr 2025 in Betracht gezogen werden sollten
- https://clickup.com/blog/ai-tools-for-data-visualization/ – 10 erstklassige KI-Tools zur Datenvisualisierung im Jahr 2024 | ClickUp
- https://insight7.io/best-7-ai-academic-research-tools/ – Die 7 besten KI-Forschungstools für Hochschulen – Insight7 – KI-Tool für Interviewanalyse und Marktforschung
- https://editverse.com/automated-graph-generation-ais-role-in-academic-visualization-2024-2025/ – Automatisierte Graphengenerierung: Die Rolle der KI bei der Optimierung der akademischen Visualisierung (2024–2025)
- https://www.allaboutai.com/best-ai-tools/generator/chart-and-graph/ – Die 10 besten KI-Diagramm- und Graphengeneratoren
- https://www.wandr.studio/blog/data-visualization-in-education – Visualisierung von Bildung: Die Wirkung von Daten
- https://www.mdpi.com/2071-1050/15/16/12451 – Neues Zeitalter der künstlichen Intelligenz im Bildungswesen: Auf dem Weg zu einer nachhaltigen, vielschichtigen Revolution
- https://educationaltechnologyjournal.springeropen.com/articles/10.1186/s41239-023-00392-8 – Künstliche Intelligenz in der Hochschulbildung: der aktuelle Stand – International Journal of Educational Technology in Higher Education
- https://piktochart.com/ai-graph-generator/ – Kostenloser KI-Diagrammgenerator – Piktochart AI
- https://ajelix.com/tools/ai-graph-generator/ – Kostenloser KI-Graphgenerator online: Keine Anmeldung erforderlich – Ajelix
- https://arxiv.org/html/2409.06892v1 – Formative Studie zur KI-gestützten Datenvisualisierung
- https://www.cut-the-saas.com/informative/things-you-should-know-before-implementing-ai-tools-in-your-data-visualization-workflow-and-strategies – KI-Tools zur Datenvisualisierung: Auswirkungen, Herausforderungen und Best Practices
- https://saxon.ai/blogs/ai-in-data-visualization-everything-you-should-know/ – KI in der Datenvisualisierung: Vorteile, Herausforderungen und mehr
- https://medium.com/@mokkup/the-future-of-data-visualization-2024-and-beyond-3173a8e60494 – Die Zukunft der Datenvisualisierung: 2024 und darüber hinaus
- https://www.geeksforgeeks.org/ai-tools-for-data-visualization/ – Top 7 KI-Tools zur Datenvisualisierung: Auswahl 2024 – GeeksforGeeks
- https://www.educause.edu/ecar/research-publications/2024/2024-educause-ai-landscape-study/the-future-of-ai-in-higher-education – Die Zukunft der KI in der Hochschulbildung
- https://fuse.franklin.edu/cgi/viewcontent.cgi?article=1119&context=facstaff-pub – KI-Technologie und wissenschaftliches Schreiben: Die „handwerklichen Fähigkeiten“ kennen und beherrschen
- https://insight7.io/best-6-ai-tools-for-academic-research/ – Die 6 besten KI-Tools für die akademische Forschung – Insight7 – KI-Tool für Interviewanalyse und Marktforschung
- https://www.microsoft.com/en-us/research/blog/data-formulator-a-concept-driven-ai-powered-approach-to-data-visualization/ – Data Formulator: Ein konzeptbasierter, KI-gestützter Ansatz zur Datenvisualisierung
- https://www.polymersearch.com/blog/the-best-ai-tools-to-analyze-data – Die 12 besten KI-Tools zur Datenanalyse · Polymer
- https://www.simplilearn.com/data-visualization-tools-article – 23 beste Datenvisualisierungstools, die Sie nicht verpassen dürfen!
- https://www.datapad.io/blog/best-ai-tools-for-data-visualization – 9 beste KI-Tools zur Datenvisualisierung
- https://www.teradata.com/insights/ai-and-machine-learning/ai-for-data-analysis-and-visualization – KI für Datenanalyse und Visualisierung | Teradata
- https://www.thebricks.com/resources/ai-tools-for-data-visualization – Top 10 KI-Tools zur Datenvisualisierung
- https://medium.com/@melissamatiasf/ai-data-visualization-how-generative-ai-is-transforming-data-visualization-and-product-design-1d0fc542183a – KI und Datenvisualisierung: Wie generative KI die Datenvisualisierung und das Produktdesign verändert
- https://codex.northwestern.edu/program/visualizations/ – Visualisierungsherausforderung: Berechnung und Datenaustausch – Northwestern University
- https://aarontay.medium.com/3-new-tools-to-try-for-literature-mapping-connected-papers-inciteful-and-litmaps-a399f27622a – 3 neue Tools zum Ausprobieren für die Literaturzuordnung – Connected Papers, Inciteful und Litmaps
- https://onlinedegree.fgcu.edu/programs/mba-data-analytics/artificial-intelligence-insights/ – Entdecken Sie mit FGCU, wie künstliche Intelligenz die Datenvisualisierung gestaltet
- https://www.juiceanalytics.com/writing/best-data-storytelling-solutions – Die 15 besten Tools zum Data Storytelling — Juice Analytics
- https://www.analyticodigital.com/blog/ai-powered-data-visualization-automation-and-insights – KI-gestützte Datenvisualisierung: Automatisierung und Erkenntnisse