
Hoe kies je de juiste statistische test?
Het kiezen van de juiste statistische toets is geen kwestie van smaak, maar wordt bepaald door drie factoren: het type uitkomst dat u meet, het aantal groepen of metingen dat u vergelijkt, en of uw waarnemingen onafhankelijk of gepaard zijn . Als u deze drie factoren correct invult, volgt de juiste toets vrijwel altijd vanzelf. De interactieve selectietool hierboven begeleidt u bij deze beslissingen; in dit gedeelte wordt de logica erachter uitgelegd, zodat u uw keuze kunt onderbouwen aan een beoordelaar.
Stap 1 — Bepaal het type uitkomstvariabele (afhankelijke variabele)
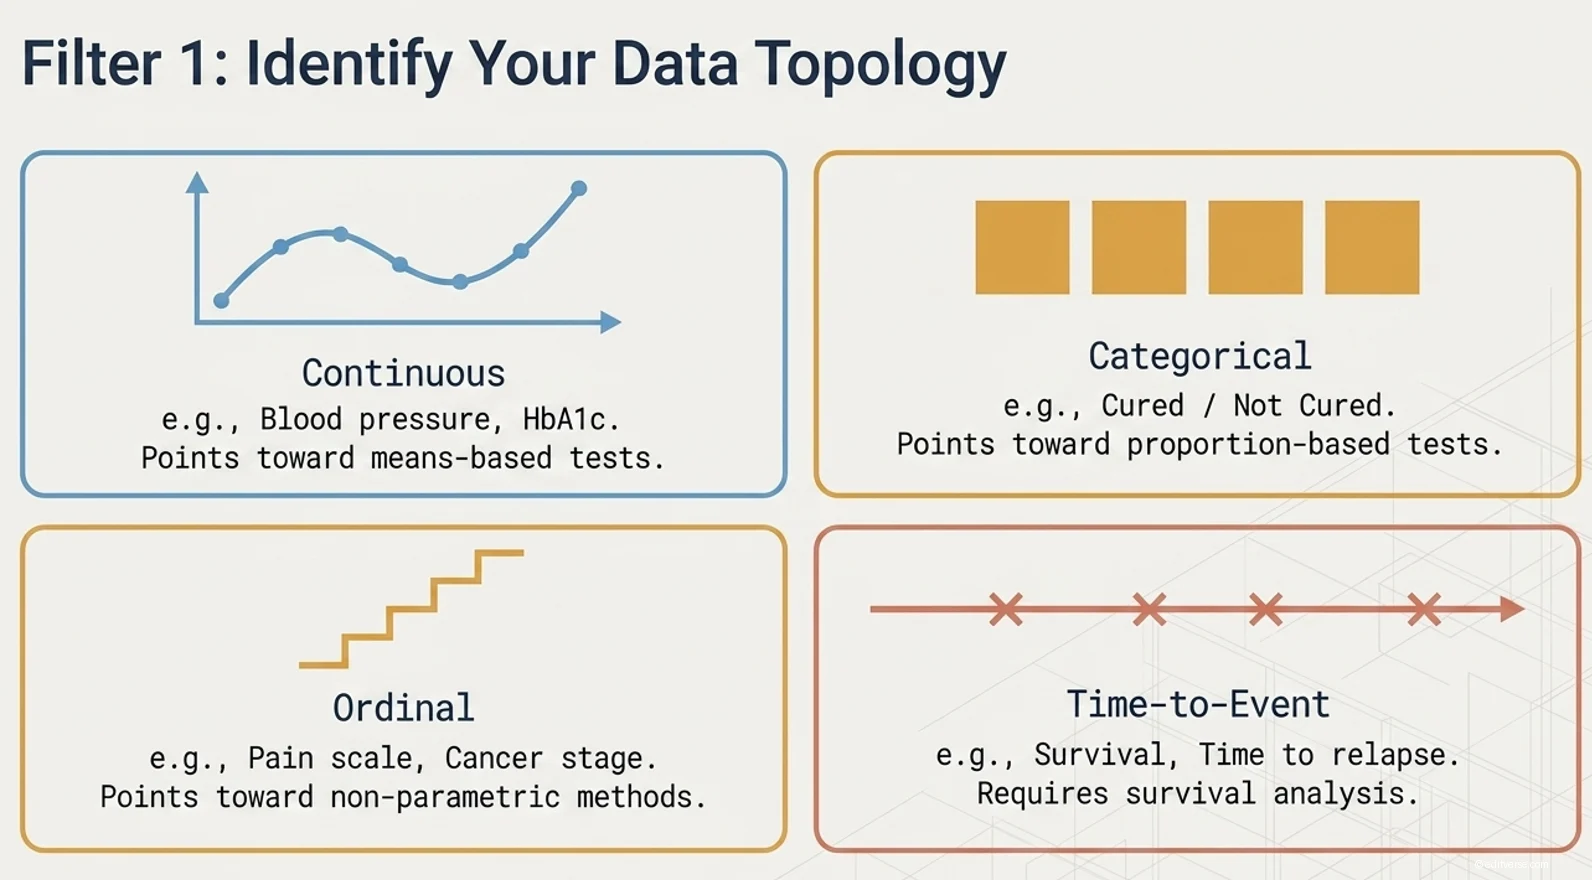
Alles begint hier. Een continue uitkomst (bloeddruk, HbA1c, een score) vraagt om op gemiddelden gebaseerde toetsen zoals de t-toets of ANOVA. Een categorische uitkomst (genezen/niet genezen, respons/geen respons) vraagt om op proporties gebaseerde toetsen zoals de chi-kwadraattoets, de exacte toets van Fisher of logistische regressie. Een ordinale uitkomst (een pijnschaal, een stadium) vraagt meestal om niet-parametrische methoden. Een uitkomst die de tijd tot een gebeurtenis weergeeft (overleving, tijd tot terugval) vereist overlevingsanalyse, omdat er rekening moet worden gehouden met gecensureerde waarnemingen, wat bij een eenvoudige vergelijking van gemiddelden niet mogelijk is.
Stap 2 — Tel je groepen en controleer of de koppelingen kloppen.
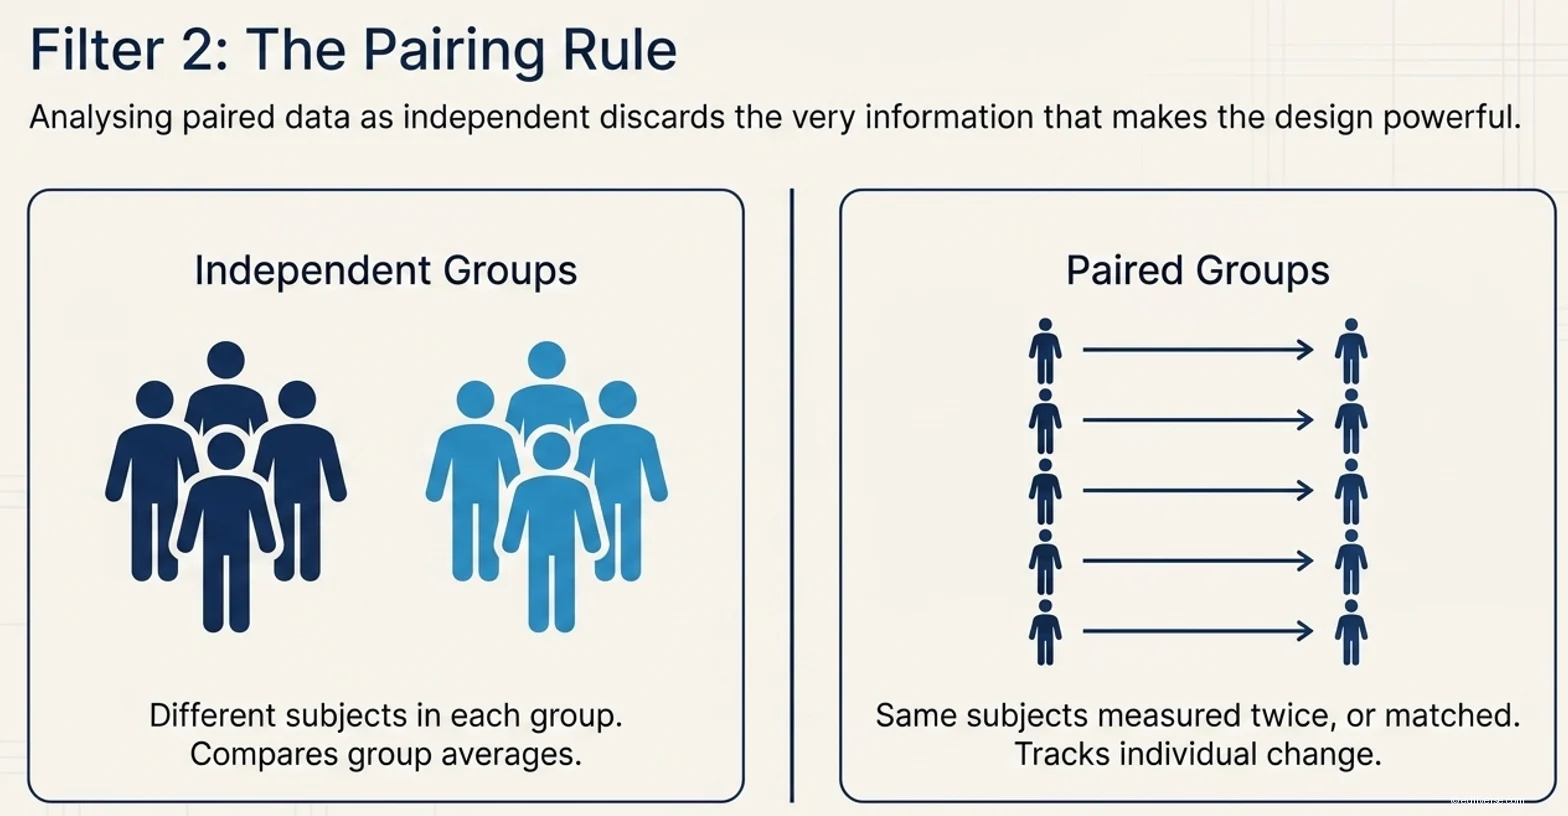
Vergelijkt u één groep met een bekende waarde , twee groepen , of drie of meer ? En zijn de waarnemingen onafhankelijk (verschillende proefpersonen in elke groep) of gepaard (dezelfde proefpersonen tweemaal gemeten, of gematcht)? Het onderscheid tussen gepaarde en gematchte gegevens wordt het vaakst over het hoofd gezien. Het meten van dezelfde patiënten vóór en na een behandeling levert gepaarde gegevens op; het analyseren ervan alsof de twee sets metingen afkomstig zijn van onafhankelijke groepen, negeert juist de informatie die het onderzoeksontwerp zo krachtig maakt en is een in de literatuur erkende fout.
Stap 3 — Controleer de aannames (parametrisch versus niet-parametrisch)
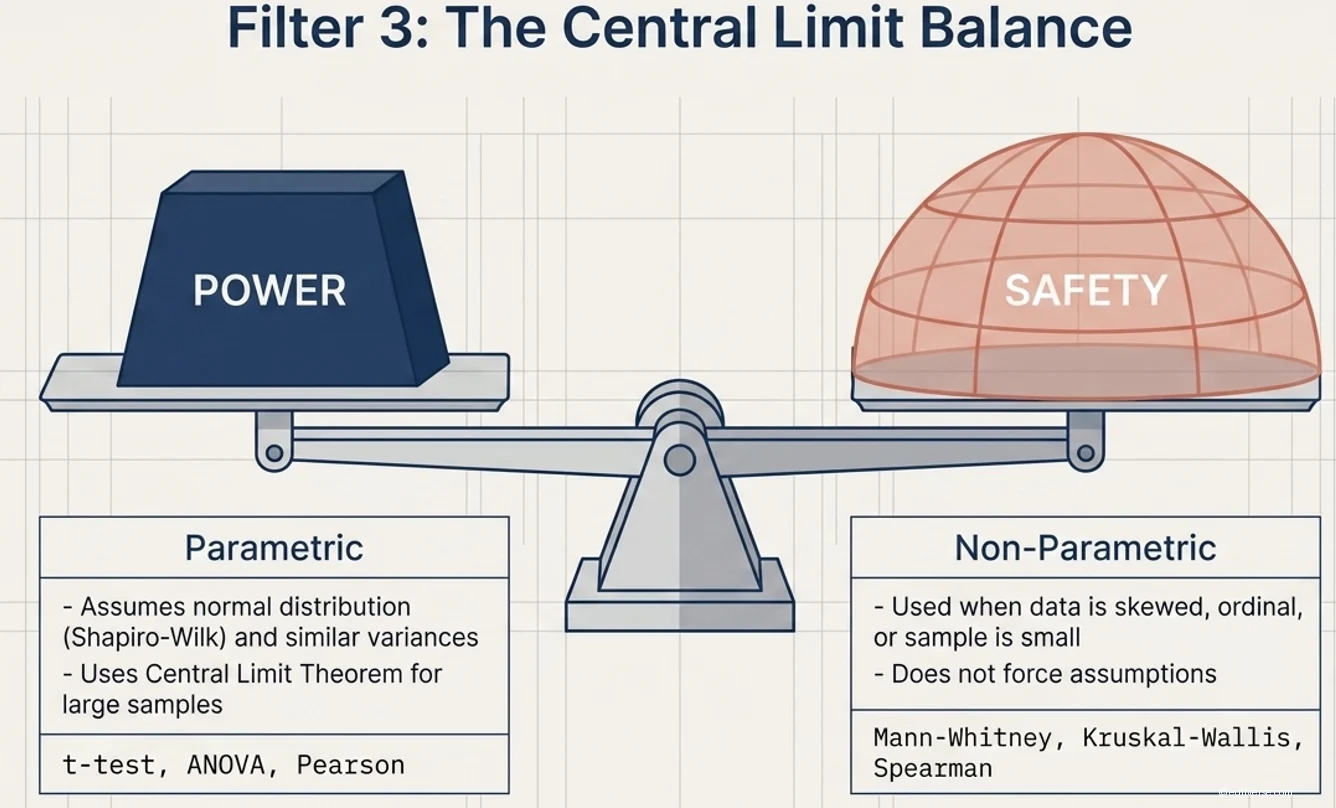
Parametrische toetsen (t-toets, ANOVA, Pearson-correlatie) gaan ervan uit dat de uitkomstvariabele bij benadering normaal verdeeld is en, voor groepsvergelijkingen, dat de varianties vergelijkbaar zijn. Wanneer aan deze aannames wordt voldaan – of de steekproef groot genoeg is om de centrale limietstelling toe te passen – zijn parametrische toetsen krachtiger. Wanneer de gegevens scheef verdeeld zijn, ordinaal zijn of de steekproef klein is, kunt u overschakelen naar het niet-parametrische equivalent: de Mann-Whitney-toets in plaats van de onafhankelijke t-toets, de Wilcoxon-toets in plaats van de gepaarde t-toets, de Kruskal-Wallis-toets in plaats van ANOVA en de Spearman-correlatie in plaats van de Pearson-correlatie.
Stap 4 — Vergelijk met de toets en controleer vervolgens met een rekenmachine.
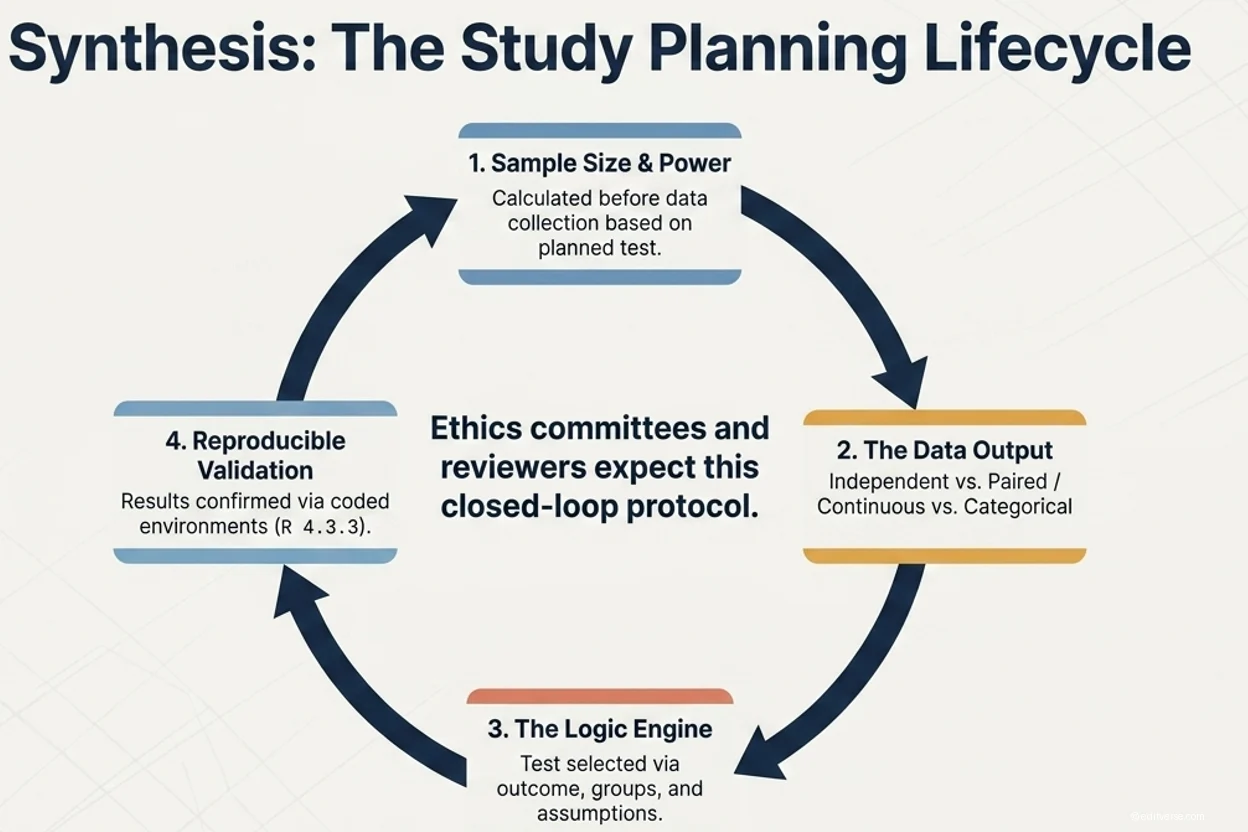
Zodra het type uitkomst, de groepsstructuur en de aannames vaststaan, wordt de test bepaald. Gebruik de onderstaande vergelijkingstabel als snel naslagwerk, open de gratis matching calculator en bevestig uw resultaat aan de hand van de weergegeven R-code. Voer voor de studieplanning altijd een steekproefomvang- en poweranalyse uit voordat u gegevens verzamelt.
Visuele handleiding: Het 3-filtersysteem in actie
Elke dia komt rechtstreeks overeen met een stap in de interactieve selector hierboven — van framework tot test.




Tabel voor de selectie van statistische toetsen
Stem je studieopzet af op de juiste toets en open vervolgens de gratis calculator.
| Doel / ontwerp | Resultaattype | Groepen | Aanbevolen test | Calculator |
|---|---|---|---|---|
| Groepen vergelijken | ||||
| Twee onafhankelijke groepen, normale gegevens | Doorlopend | 2 (onafhankelijk) | Onafhankelijke t-toets | t-toets → |
| Twee onafhankelijke groepen, scheef/ordinaal | Continu / ordinaal | 2 (onafhankelijk) | Mann-Whitney Universiteit | Mann-Whitney → |
| Voor/na, dezelfde proefpersonen, normaal | Doorlopend | 2 (gepaard) | Gepaarde t-test | t-toets → |
| Voor/na, dezelfde proefpersonen, vertekend | Continu / ordinaal | 2 (gepaard) | Wilcoxon Signed-Rank | Wilcoxon → |
| Drie of meer groepen, normaal | Doorlopend | 3+ (onafhankelijk) | Eénwegs ANOVA + Tukey | ANOVA → |
| Drie of meer groepen, niet-normaal | Continu / ordinaal | 3+ (onafhankelijk) | Kruskal-Wallis | In de app → |
| Categorische uitkomsten | ||||
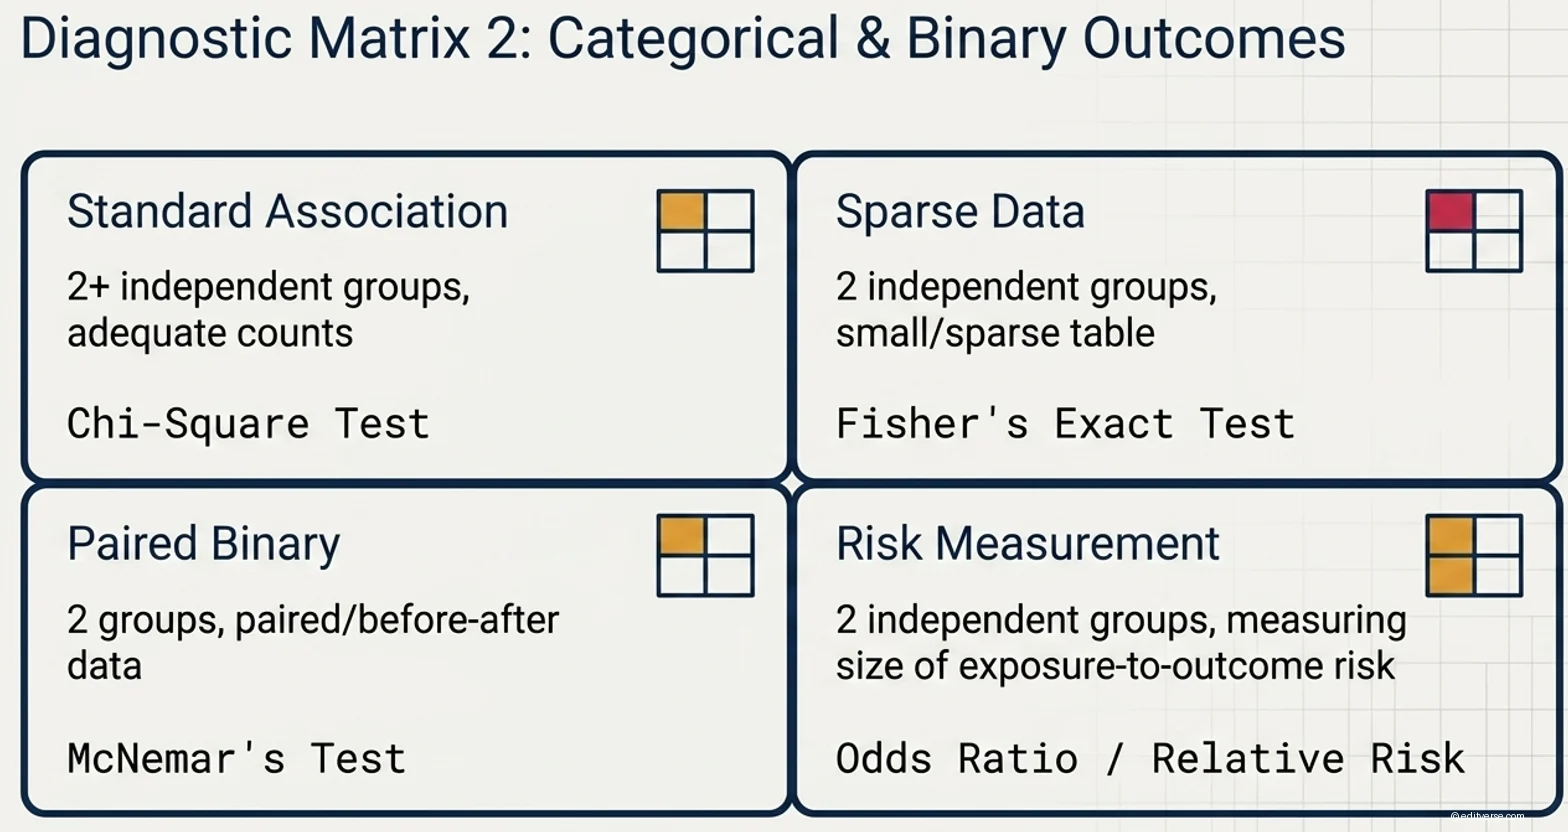
| Vereniging, voldoende aantallen | categorisch | 2+ (onafhankelijk) | Chi-plein | Chi-kwadraat → |
| Associatie, kleine/dunne tabel | categorisch | 2 (onafhankelijk) | Fisher's Exact | Vissers → |
| Gekoppelde binaire gegevens (voor/na) | binair | 2 (gepaard) | McNemars test | McNemar → |
| Omvang van het risico (blootstelling → uitkomst) | binair | 2 (onafhankelijk) | Oddsratio / Relatief risico | OF / RR → |
| Relaties en voorspellingen | ||||
| Verband tussen twee variabelen | Doorlopend | - | Pearson/Spearman-correlatie | Correlatie → |
| Voorspel een continue uitkomst | Doorlopend | - | Lineaire regressie | Regressie → |
| Voorspel een binaire uitkomst | binair | - | Logistische regressie | Logistiek → |
| Overeenkomst, diagnose en overleving | ||||
| Beoordelaarsovereenkomst, categorieën | categorisch | 2 beoordelaars | Cohens Kappa | Kappa → |
| Betrouwbaarheid / methodevergelijking | Doorlopend | 2 beoordelaars/methoden | ICC / Bland-Altman | ICC → |
| Diagnostische test versus referentie | binair | - | Gevoeligheid en specificiteit | Gevoeligheid/Specificatie → |
| Test de prestaties over verschillende drempelwaarden. | Continu → binair | - | ROC-curve en AUC | ROC → |
| Tijd tot gebeurtenis met censuur | Tijd tot gebeurtenis | 1–2 groepen | Kaplan-Meier / Log-Rank | Overleven → |
| Studieplanning | ||||
| Hoeveel deelnemers heb ik nodig? | Elke | - | Analyse van steekproefomvang en power | Steekproefomvang → |
Veelgemaakte fouten bij het selecteren van tests
Er wordt genegeerd dat de gegevens gepaard zijn.
Het analyseren van herhaalde of gepaarde metingen alsof ze afkomstig zijn van onafhankelijke groepen is een van de meest voorkomende en ernstige fouten. Gepaarde onderzoeksopzetten vereisen gepaarde toetsen (gepaarde t-toets, Wilcoxon-rangtekentoets of McNemar-toets voor binaire gegevens); het negeren van de afhankelijkheid ondermijnt de efficiëntie van het onderzoeksontwerp en kan misleidende resultaten opleveren.
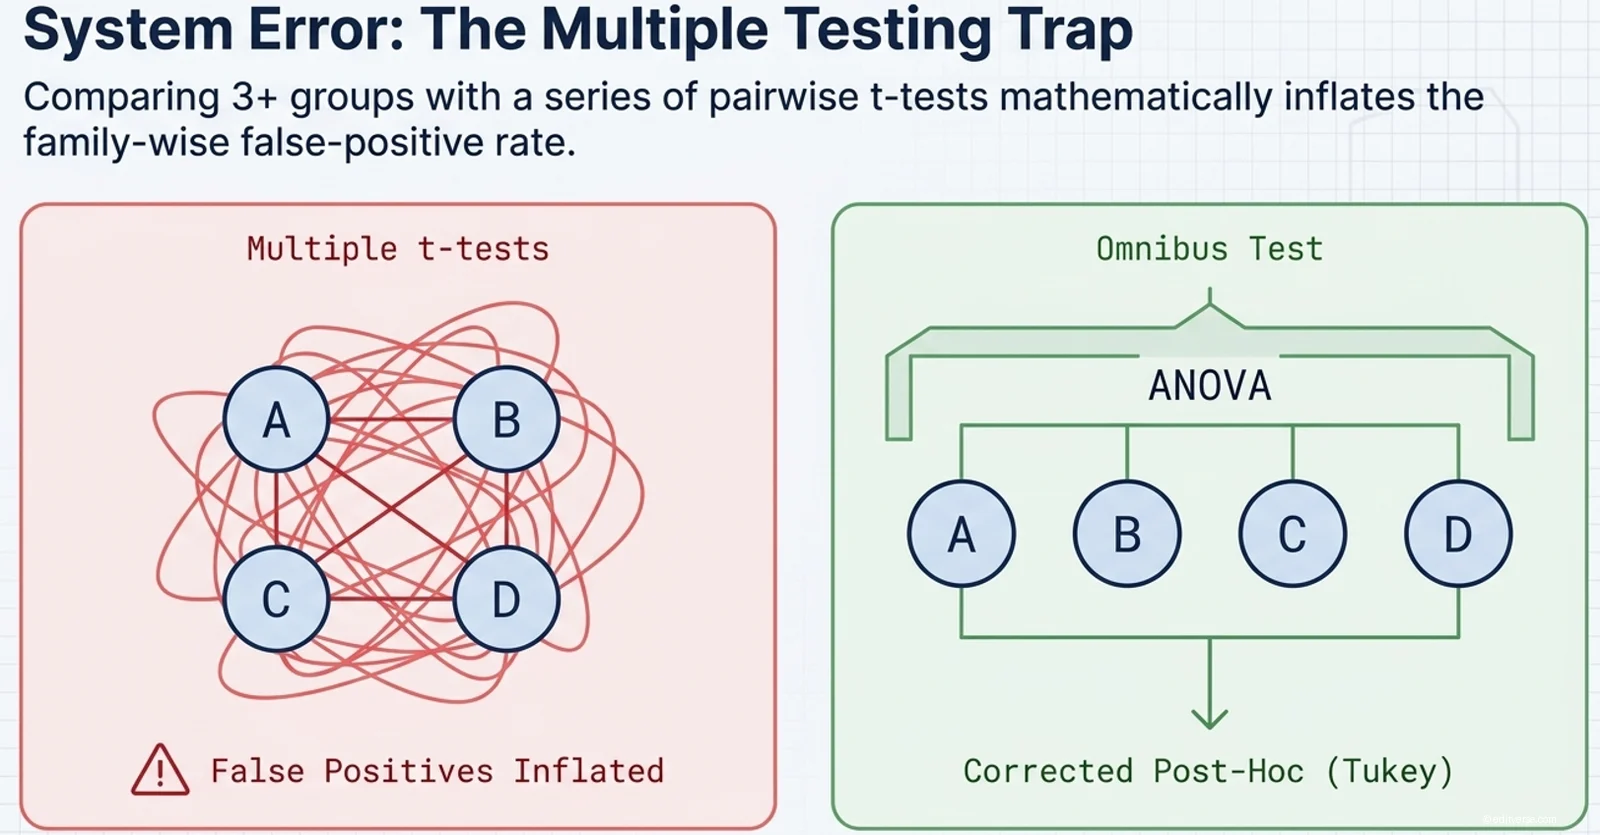
Meerdere t-toetsen uitvoeren in plaats van ANOVA.
Het vergelijken van drie of meer groepen met een reeks paarsgewijze t-toetsen verhoogt het aantal valse positieven binnen de gehele reeks. Gebruik daarom één enkele omnibustoets (ANOVA of Kruskal-Wallis) gevolgd door een gecorrigeerde post-hocvergelijking.
Het toepassen van een parametrische toets op scheve of ordinale gegevens
De t-test en ANOVA gaan uit van een benaderende normaliteit. Bij duidelijk scheve, ordinale of zeer kleine steekproeven is het raadzaam over te schakelen naar het niet-parametrische equivalent in plaats van een parametrische test te forceren.
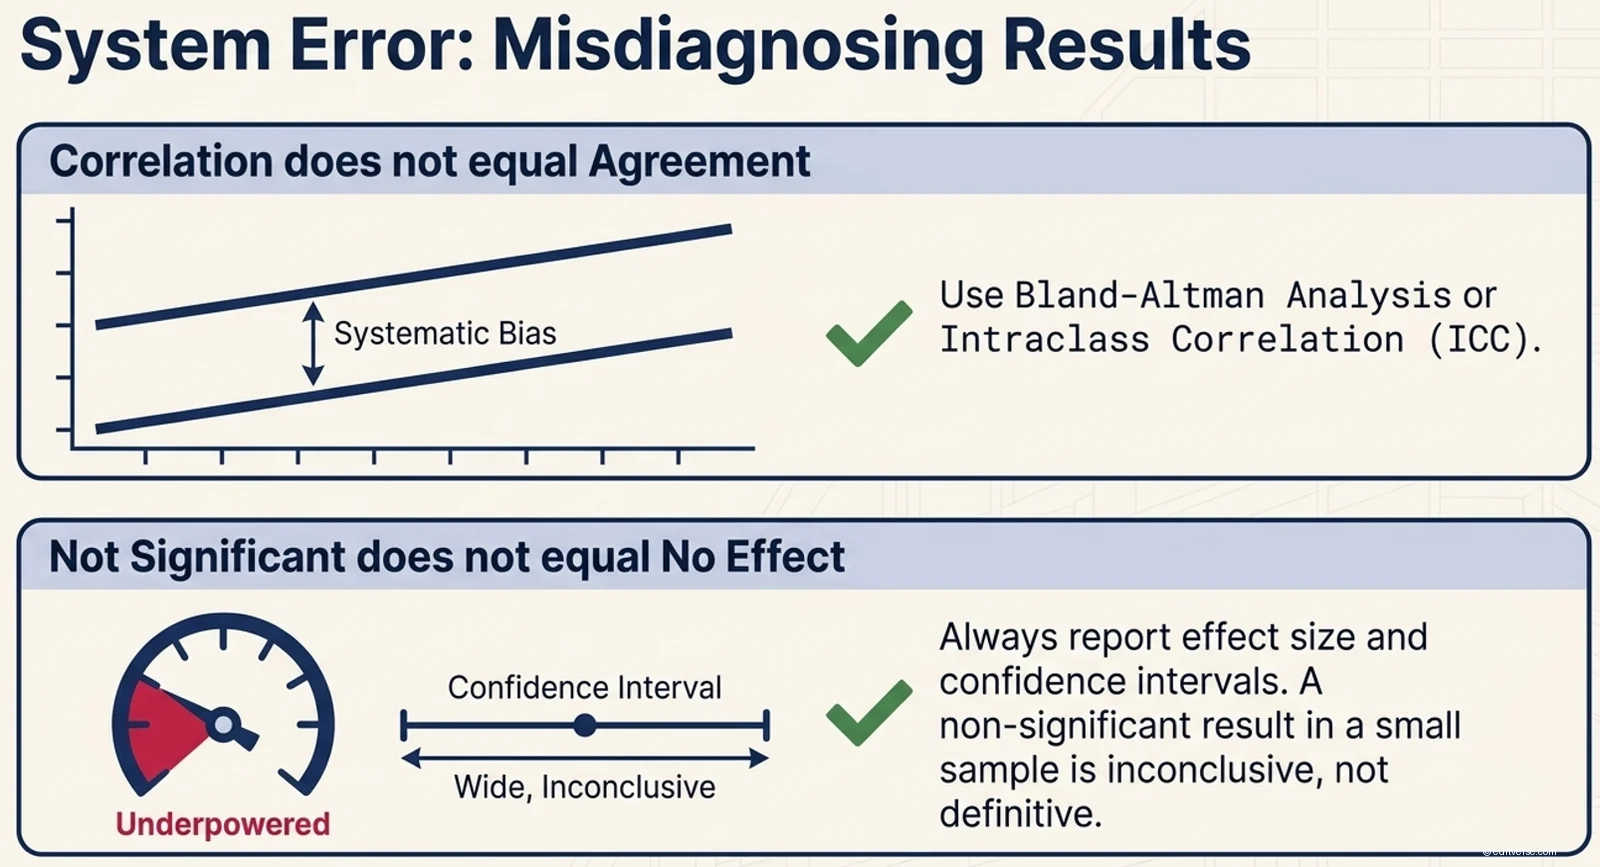
Correlatie verwarren met overeenstemming
Een hoge Pearson-correlatie tussen twee meetmethoden betekent niet dat ze overeenkomen — twee methoden kunnen perfect gecorreleerd zijn, maar toch systematisch vertekend. Gebruik de intraclaskorrelatie of een Bland-Altman-analyse om de overeenstemming te beoordelen.
"Niet significant" behandelen als "geen effect".
Een niet-significant resultaat in een onderzoek met onvoldoende statistische power is geen bewijs dat er geen effect is. Rapporteer de effectgrootte en het betrouwbaarheidsinterval en plan vooraf een voldoende grote steekproefomvang.
Niet-gecorrigeerde meervoudige testen
Het testen van veel uitkomsten of het aanpassen van veel modellen zonder te corrigeren voor meervoudige toetsing leidt tot een overschatting van het aantal valse positieven en is een erkende bron van niet-reproduceerbare resultaten.
Veelgestelde Vragen / FAQ
Hoe weet ik of mijn gegevens "normaal" zijn?
Bekijk een histogram of QQ-plot en gebruik voor formele toetsing een normaliteitstoets (Shapiro-Wilk). Bij grote steekproeven maakt een lichte afwijking van de normaliteit weinig uit vanwege de centrale limietstelling; bij kleine steekproeven is het raadzaam om, indien twijfel, niet-parametrische toetsen te gebruiken.
Wat is het verschil tussen gepaarde en onafhankelijke data?
Onafhankelijke data zijn afkomstig van verschillende, niet-gerelateerde proefpersonen in elke groep. Gepaarde data zijn afkomstig van dezelfde proefpersonen die tweemaal zijn gemeten (voor/na) of van gematchte paren. Het gebruik van gepaarde data beïnvloedt de test die je gebruikt, dus identificeer dit voordat je de analyse uitvoert.
Parametrisch of niet-parametrisch: wat is beter?
Parametrische toetsen zijn krachtiger wanneer hun aannames kloppen. Niet-parametrische toetsen zijn veiliger voor scheve, ordinale of kleine steekproefgegevens. Stem de toets af op uw gegevens, niet andersom.
Moet ik de steekproefomvang berekenen voordat ik een test kies?
Ja. De test die u wilt gebruiken, bepaalt de berekening van de steekproefomvang , en beide moeten in uw protocol worden gespecificeerd vóór de gegevensverzameling — ethische commissies en beoordelaars verwachten dit.
Kan een statisticus mijn keuze controleren?
Ja. Onze biostatistici beoordelen onderzoeksopzetten, bevestigen de juiste test en voeren de volledige analyse uit met reproduceerbare R-output als onderdeel van een statistisch analysepakket.
Referenties en verder lezen
Peer-reviewed, in PubMed geïndexeerde bronnen over de selectie en rapportage van statistische toetsen.
Weet je nog steeds niet welke test het beste bij jouw gegevens past?
Onze biostatistici bevestigen de juiste test, controleren de aannames en voeren uw volledige analyse uit met reproduceerbare R-output.
Krijg deskundige statistische hulp