
適切な統計検定の選び方
適切な統計検定を選択することは、好みの問題ではありません。それは、測定した結果の種類、比較するグループまたは測定値の数、そして観測値が独立しているか対応しているかという3つの要素によって決まります。これら3つの要素を正しく理解すれば、検定方法はほぼ必ず導き出されます。上記のインタラクティブセレクターは、まさにこれらの判断基準に基づいて選択をガイドします。このセクションでは、その背後にある論理を説明し、審査員に選択理由を説明できるようにします。
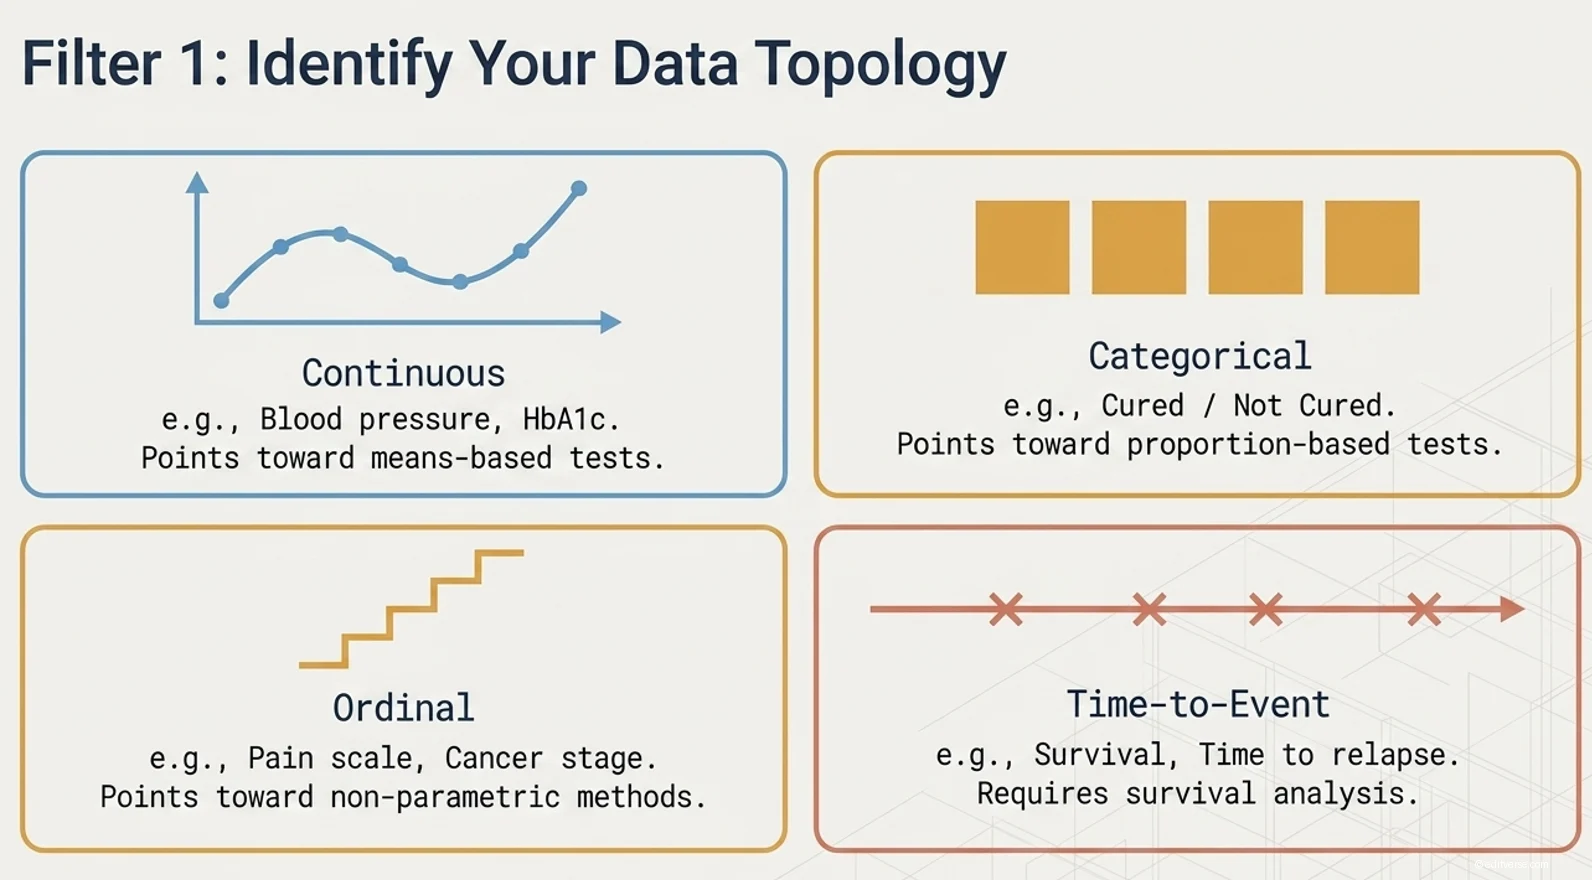
ステップ1 — 結果変数(従属変数)の種類を特定する
すべてはここから始まります。連続的な結果(血圧、HbA1c、スコアなど)は、t検定やANOVAなどの平均値に基づく検定に適しています。カテゴリカルな結果(治癒/未治癒、反応者/非反応者など)は、カイ二乗検定、フィッシャーの正確確率検定、ロジスティック回帰などの比率に基づく検定に適しています。順序尺度の結果(疼痛スケール、病期など)は、通常、ノンパラメトリック法を必要とします。イベント発生までの時間の結果(生存、再発までの時間など)は、単純な平均値の比較では考慮できない打ち切り観測値を考慮する必要があるため、生存分析が必要です。
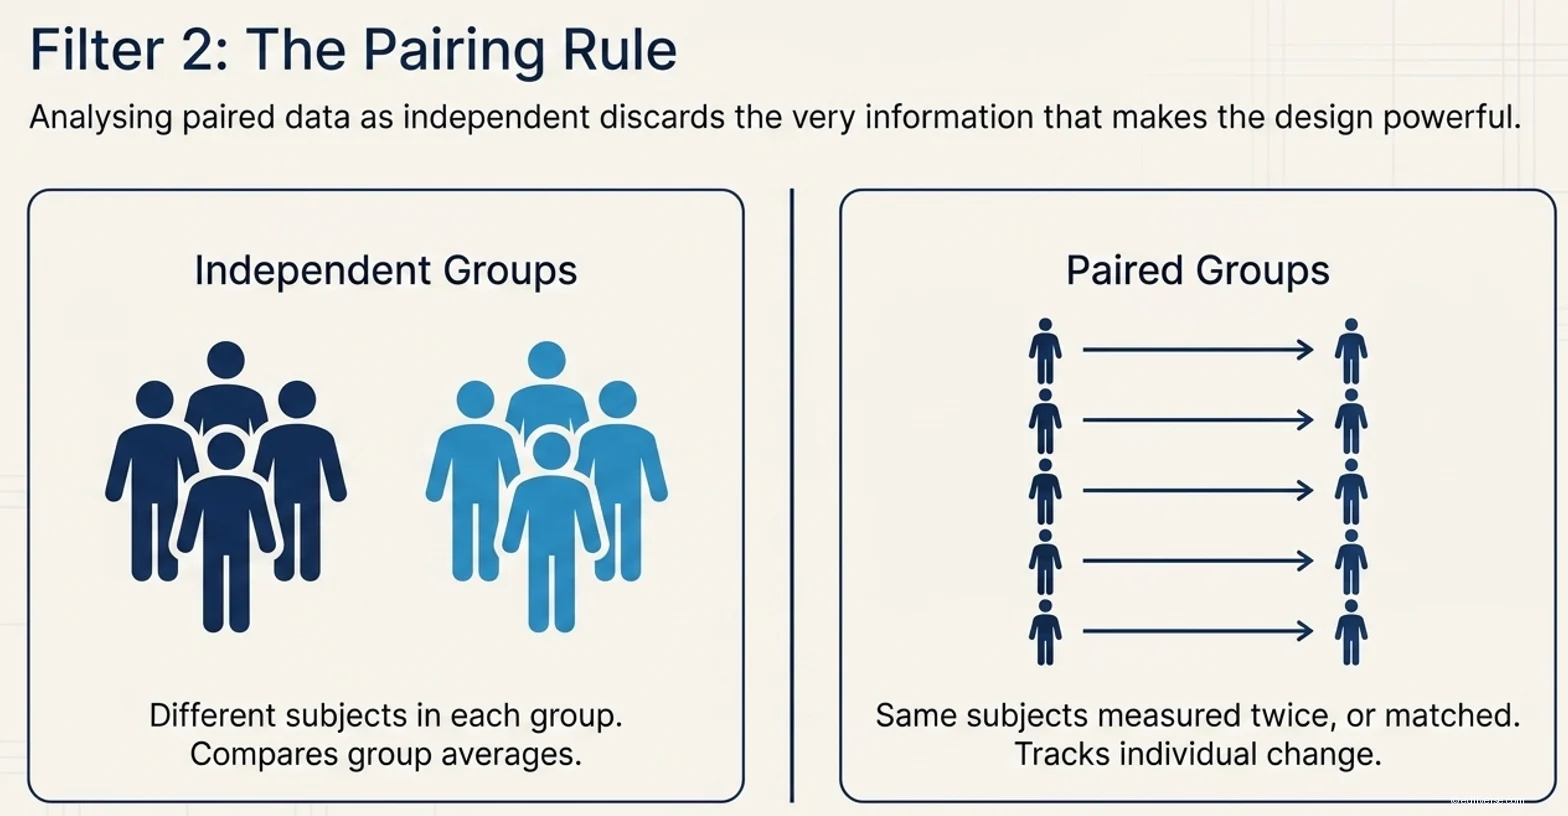
ステップ2 — グループの数を数え、ペアリングを確認します
既知の値と比較しているのは、 1つのグループですか、 2つのグループですか、それとも3つ以上のグループですか?また、観測値は独立していますか(各グループに異なる被験者が含まれていますか)、それともペアになっていますか(同じ被験者を2回測定したり、マッチングさせたりしていますか)?ペアリングは最も見落とされがちな区別です。治療の前後に同じ患者を測定することはペアデータです。2つの測定値が独立したグループから得られたかのように分析すると、そのデザインを強力にする情報そのものが失われ、文献でも認識されている誤りとなります。
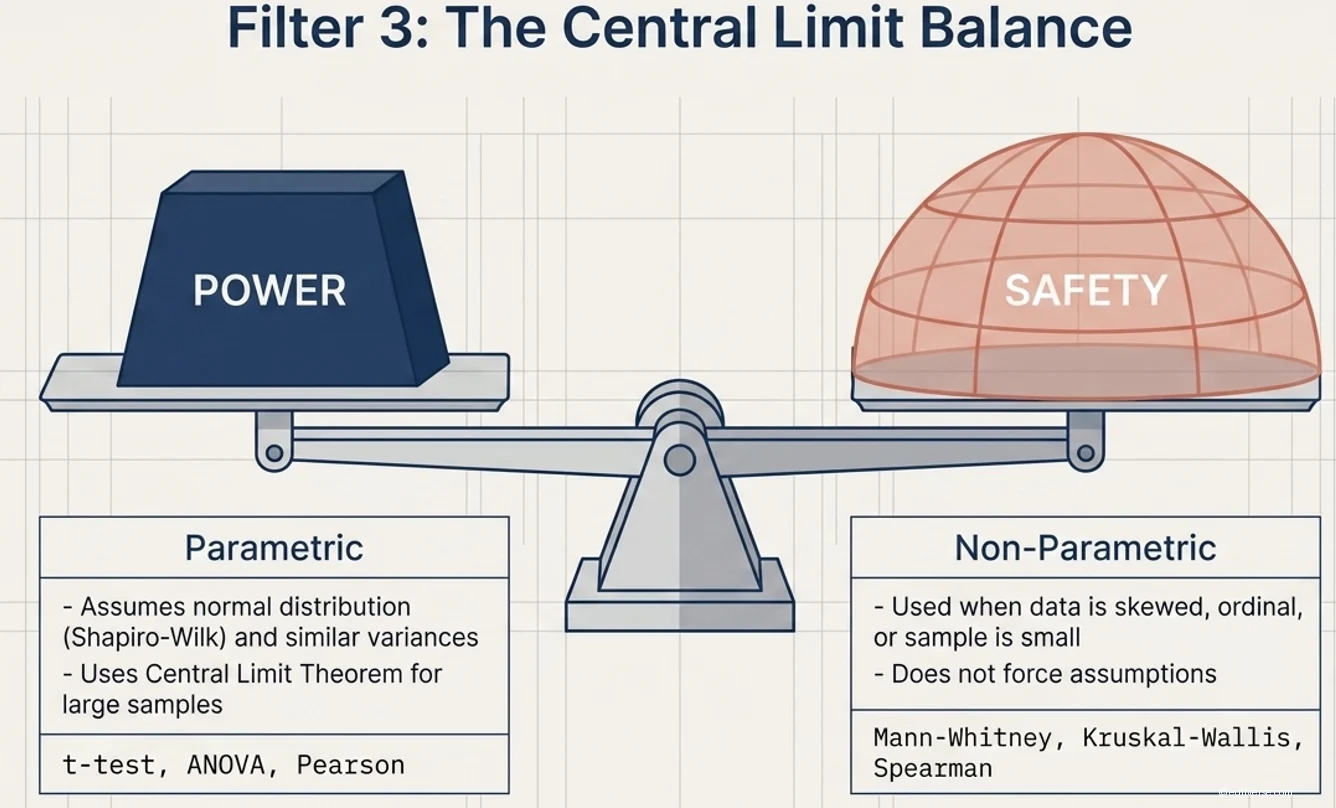
ステップ3 — 前提条件の確認(パラメトリックかノンパラメトリックか)
パラメトリック検定(t検定、ANOVA、ピアソン相関係数)は、結果がほぼ正規分布に従うこと、およびグループ比較の場合は分散が類似していることを前提としています。これらの前提が成り立つ場合、または中心極限定理が適用できるほどサンプルサイズが大きい場合は、パラメトリック検定の方が検出力に優れています。データが歪んでいる場合、順序尺度である場合、またはサンプルサイズが小さい場合は、ノンパラメトリック検定に切り替えてください。独立t検定の代わりにマン・ホイットニー検定、対応のあるt検定の代わりにウィルコクソン検定、ANOVAの代わりにクラスカル・ウォリス検定、ピアソン相関係数の代わりにスピアマン相関係数を使用します。
ステップ4 — テストと照合し、電卓で確認する
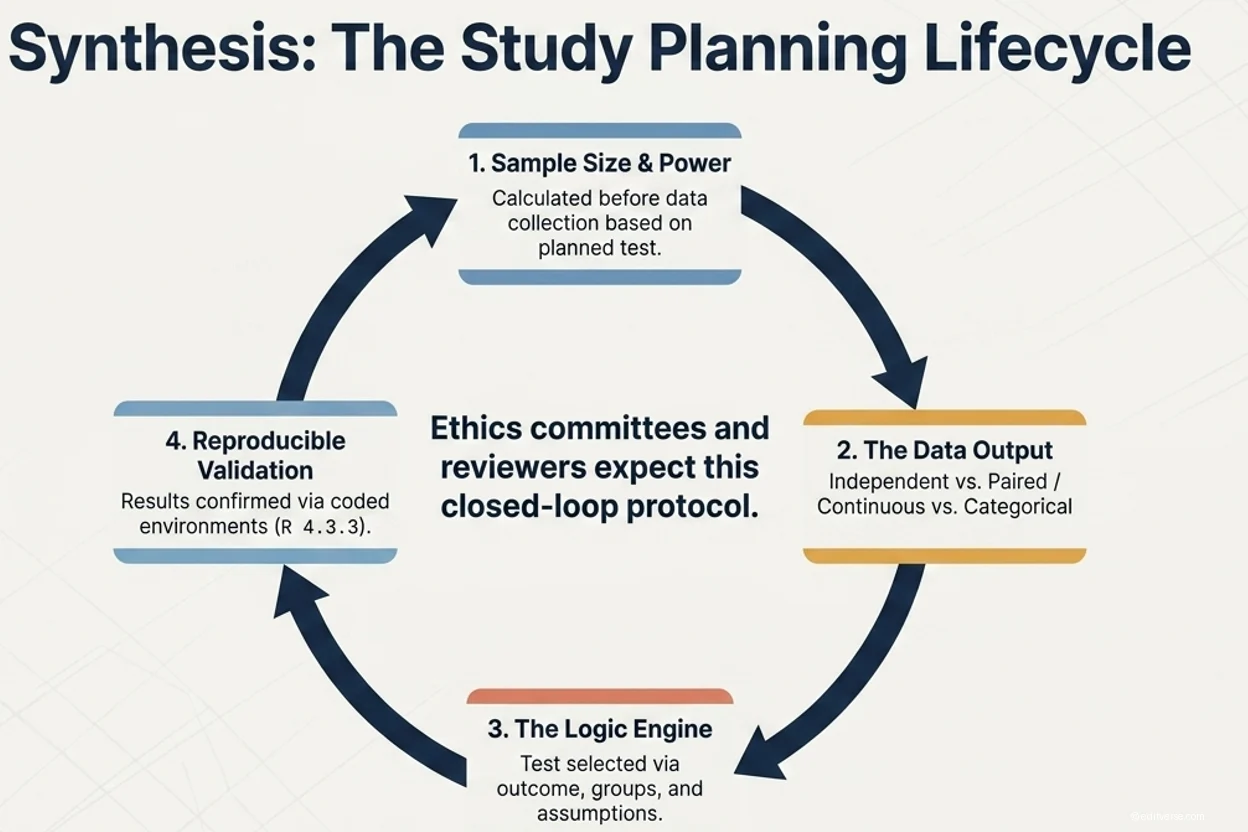
結果の種類、グループ構成、および前提条件が確定したら、テストが決定されます。以下の比較表を参考に、対応する無料計算ツールを開き、表示されたRコードと照らし合わせて結果を確認してください。研究計画を立てる際は、データ収集前に必ずサンプルサイズと検出力の分析を実施してください。
ビジュアルガイド:3フィルターシステムの動作
各スライドは、上記のインタラクティブセレクターの手順(フレームワークからテストまで)に直接対応しています。




統計検定選択表
学習計画に合ったテストを選び、無料の計算ツールを開いてください。
| 目標/デザイン | 結果の種類 | グループ | 推奨される検査 | コンピュータ |
|---|---|---|---|---|
| グループの比較 | ||||
| 2つの独立したグループ、正規データ | 連続的な | 2(独立) | 独立t検定 | t検定 → |
| 2つの独立したグループ、偏り/順序 | 連続尺度/順序尺度 | 2(独立) | マン・ホイットニー大学 | マン・ホイットニー → |
| 前後比較、同一被験者、正常 | 連続的な | 2(ペア) | 対応のあるt検定 | t検定 → |
| 前後比較、同一被験者、偏りあり | 連続尺度/順序尺度 | 2(ペア) | ウィルコクソン符号順位 | ウィルコクソン → |
| 3つ以上のグループ、正常 | 連続的な | 3歳以上(自立) | 一元配置分散分析+テューキー検定 | 分散分析 → |
| 3つ以上のグループ、非正規分布 | 連続尺度/順序尺度 | 3歳以上(自立) | クラスカル・ウォリス | アプリ内 → |
| カテゴリー別結果 | ||||
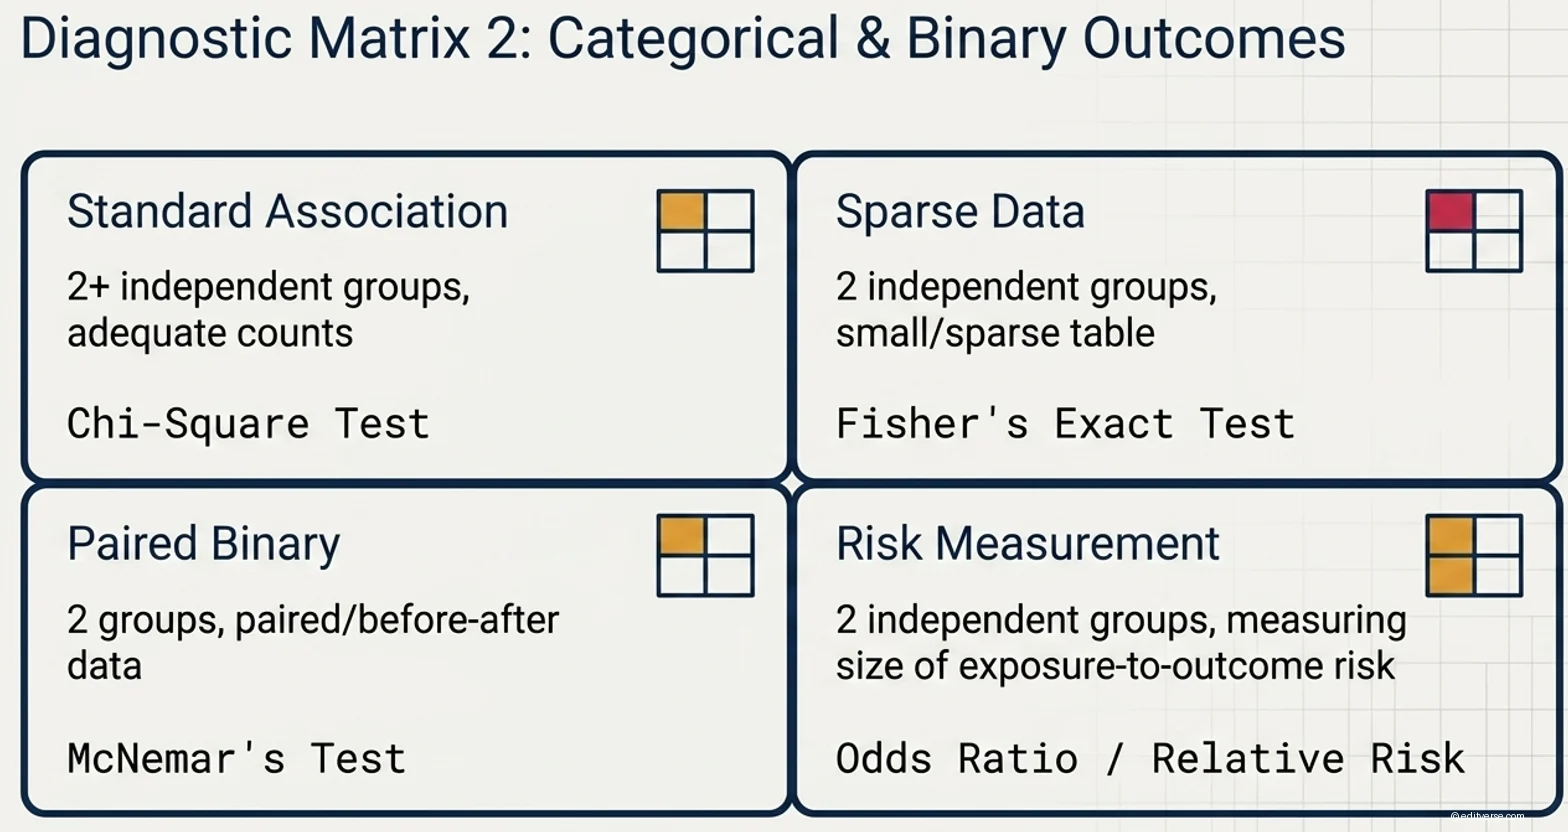
| 協会、適切な数 | カテゴリー | 2歳以上(自立) | Chi-Square | カイ二乗 → |
| 関連付け、小規模/疎なテーブル | カテゴリー | 2(独立) | フィッシャーの正確確率検定 | フィッシャーの→ |
| ペアになったバイナリデータ(前/後) | バイナリ | 2(ペア) | マクネマー検定 | マクネマー → |
| リスクの大きさ(曝露→結果) | バイナリ | 2(独立) | オッズ比/相対リスク | OR / RR → |
| 関係性と予測 | ||||
| 2つの変数間の関連性 | 連続的な | - | ピアソン/スピアマン相関係数 | 相関関係 → |
| 連続的な結果を予測する | 連続的な | - | 直線回帰 | 回帰 → |
| 二値結果を予測する | バイナリ | - | ロジスティック回帰 | 物流 → |
| 合意、診断、生存 | ||||
| 評価者間の一致度、カテゴリー | カテゴリー | 評価者2名 | コーエンのカッパ | カッパ → |
| 信頼性/方法比較 | 連続的な | 評価者/評価方法2件 | ICC / ブランド・アルトマン | ICC → |
| 診断検査と基準値の比較 | バイナリ | - | 感度と特異度 | 感度/仕様 → |
| しきい値ごとのテストパフォーマンス | 連続型 → バイナリ型 | - | ROC曲線とAUC | 中華民国 → |
| 検閲ありのイベント発生までの時間 | イベントまでの時間 | 1~2グループ | カプラン・マイヤー法/ログランク法 | サバイバル → |
| 学習計画 | ||||
| 参加者は何人必要ですか? | 任意 | - | サンプルサイズと検出力の分析 | サンプルサイズ → |
テスト選択におけるよくある間違い
データがペアになっていることを無視して
繰り返し測定やマッチング測定を、あたかも独立したグループから得られたものであるかのように分析することは、最も一般的で重大な誤りの1つです。ペアデザインにはペア検定(ペアt検定、ウィルコクソン符号順位検定、または二値データの場合はマクネマー検定)が必要です。依存関係を無視すると、デザインの効率性が損なわれ、誤解を招く結果が生じる可能性があります。
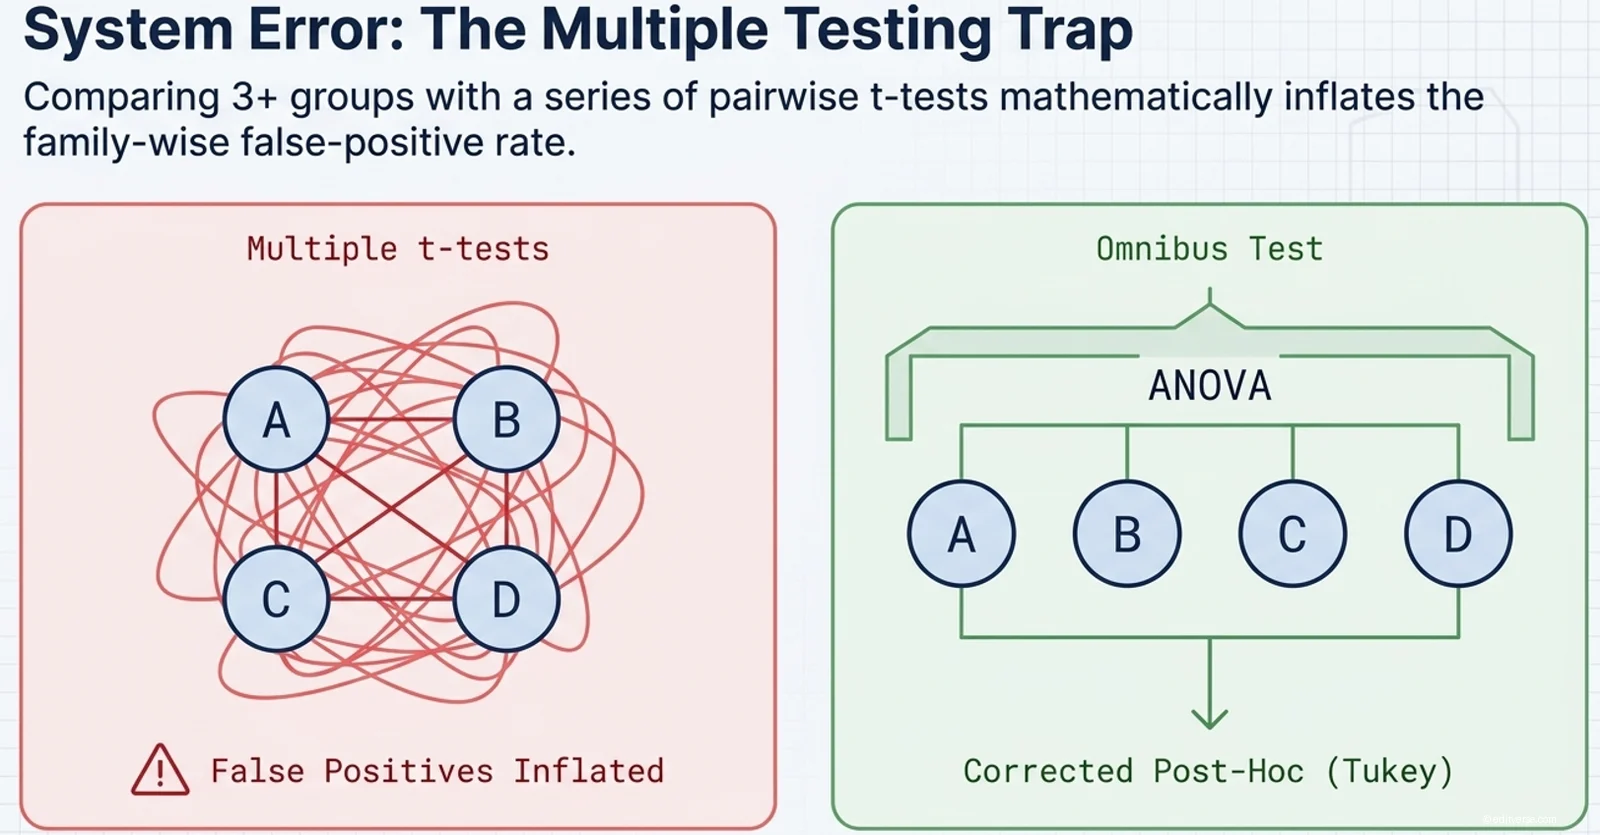
ANOVAの代わりに複数のt検定を実行する
3つ以上のグループをペアワイズt検定で比較すると、ファミリーワイズ偽陽性率が高くなります。単一の包括的検定(ANOVAまたはKruskal-Wallis検定)を行い、その後補正後の事後比較を実施してください。
歪んだデータまたは順序データに対するパラメトリック検定の使用
t検定とANOVAは、近似的な正規分布を前提としています。明らかに歪んだ分布、順序尺度、または非常に小さなサンプルについては、パラメトリック検定を強制するのではなく、ノンパラメトリックな同等の手法に切り替えてください。
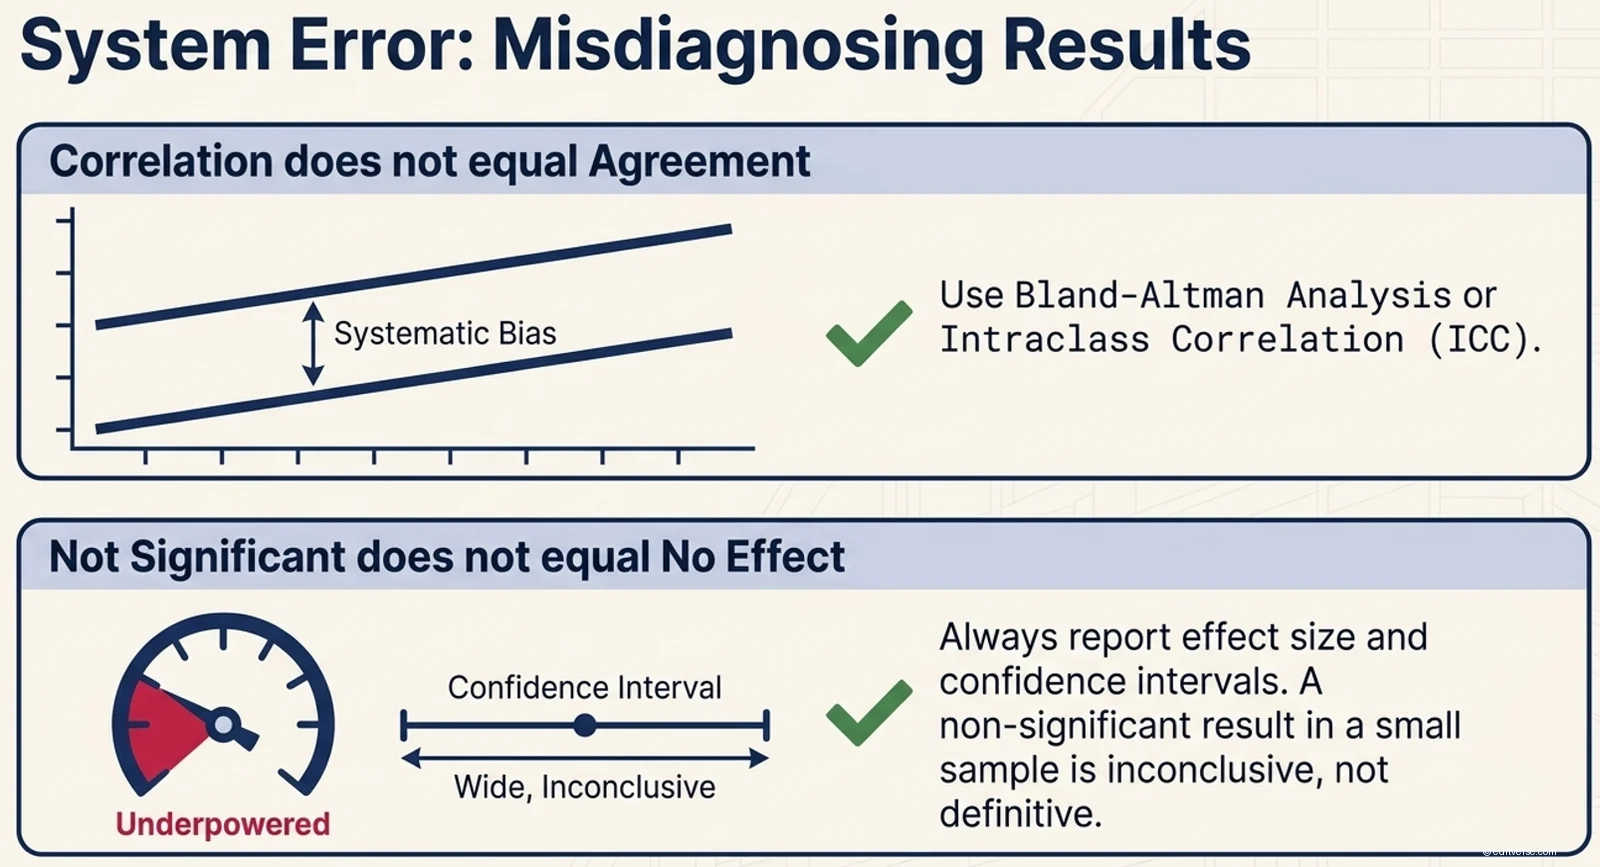
相関関係と一致を混同する
2つの測定方法間のピアソン相関係数が高いからといって、それらが一致しているとは限りません。2つの方法は完全に相関していても、系統的な偏りがある可能性があります。一致度を評価するには、級内相関係数またはBland-Altman分析を使用してください。
「有意ではない」を「効果なし」とみなす
検出力が不足している研究で有意差が認められなかったとしても、それは効果がないことの証拠にはなりません。効果量と信頼区間を報告し、事前に十分な検出力を持つサンプルサイズを計画してください。
補正されていない多重検定
多重比較補正を行わずに多数の結果をテストしたり、多数のモデルを当てはめたりすると、偽陽性が増加し、再現性のない結果の原因となることが知られています。
よくある質問
自分のデータが「正常」かどうかは、どうすればわかりますか?
ヒストグラムまたはQQプロットを確認し、正式な検定には正規性検定(シャピロ・ウィルク検定)を使用します。サンプルサイズが大きい場合は、中心極限定理により軽度の非正規性はほとんど問題になりません。サンプルサイズが小さい場合は、疑わしい場合はノンパラメトリック検定を使用することをお勧めします。
ペアデータと独立データの違いは何ですか?
独立データは、各グループ内の異なる、無関係な被験者から得られます。ペアデータは、同じ被験者を2回(測定前/測定後)測定したデータ、またはマッチングされたペアから得られます。ペアリングによって使用する検定方法が変わるため、分析前にペアリングを特定する必要があります。
パラメトリックかノンパラメトリックか ― どちらが良いのか?
パラメトリック検定は、前提条件が満たされている場合に最も効果的です。一方、ノンパラメトリック検定は、歪んだデータ、順序尺度データ、または小標本データに適しています。データに合わせて検定方法を選択することが重要です。
検査方法を選択する前に、サンプルサイズを計算する必要がありますか?
はい。使用する検査方法によってサンプルサイズの計算方法が決まります。データ収集前に、検査方法とサンプルサイズの両方をプロトコルに明記する必要があります。倫理委員会や審査員はこれを期待しています。
統計学者に私の選択を検証してもらうことはできますか?
はい。当社の生物統計学者が研究デザインを精査し、適切な検定方法を確認し、統計解析パッケージの一部として再現可能なR出力を含む完全な解析を実行します。
参考文献と参考文献
統計的検定の選択と報告に関する、査読済みでPubMedに索引付けされている文献。
どのテストがあなたのデータに最適かまだわからない?
当社の生物統計学者が適切な検定方法を確認し、前提条件を検証した上で、再現可能なR出力による完全な解析を実行します。
統計の専門家によるサポートを受けましょう