
F統計量は、メンデルランダム化論文において査読者がまず最初に探す数値であり、Fが10を超えたらその手法は適切であるというルールは、2011年以降に書かれたほぼすべての方法論のセクションで引用されています。Editverseは1,100件以上の論文をサポートしてきましたが、当社の統計学者が扱うレジストリや遺伝疫学の研究において、F統計量は、査読者からその数値が何をもたらすのかを尋ねられた際に、著者が最も説明できない数値でもあります。
そこで、実際に測定してみました。さまざまな測定ツールの強度とサンプル重複条件で13万5000件のメンデルランダム化研究をシミュレーションし、それぞれ独立して作成した2つのプログラムで2回実行して、結果を比較しました。その結果は、多くのチュートリアルで示唆されているものとは異なっていました。測定ツールの強度が弱い場合、通常は間違った答えが返ってくるわけではありません。むしろ、答えが出せないほど広い区間が返ってくるのです。しかも、それは推定値自体がずれ始めるずっと前のことです。
簡単な言葉で言うと
遺伝子操作は、ごくわずかな働きかけだと考えてください。働きかけが強ければ、変異遺伝子を持つ人は実際に曝露量が増え、病気のリスクにどのような変化が生じるかが分かります。働きかけが弱ければ、変異遺伝子を持つ人と持たない人の差はほとんどなく、病気への影響はノイズに埋もれてしまいます。F統計量は、働きかけの強さを測定する指標です。F統計量が小さい場合、分析結果は非常に広い範囲を示し、大きな有害効果、全く効果がない、大きな保護効果といったあらゆる可能性を同時に含んでしまいます。この研究は嘘をついているわけではありません。単に何も測定できていないだけなのです。
F値が10を超える場合のルールはどこから来たのか
この閾値は遺伝学から派生したものではなく、借用されたものです。これは計量経済学に由来し、StaigerとStock(1997)は、操作変数が曝露をほとんど説明しない場合の2段階最小二乗法を研究し、結果として生じるバイアスが許容範囲内である場合の経験則として、第1段階のF値を10とすることを提案しました。このルールは、BurgessとThompson(2011)によって遺伝疫学にも応用され、彼らはメンデルランダム化における弱い操作変数バイアスを具体的に調査し、推定値は交絡した観察的関連性の方向に引っ張られ、その引っ張りの大きさはF統計量によって決まることを示しました。
その系統に関して重要な点が2つありますが、通常は省略されています。まず、元の結果は複数の操作変数を用いた2段階最小二乗法に関するものであり、それが示すバイアスは含まれる操作変数の数が増えるにつれて大きくなります。次に、閾値は合格点ではなく、大まかな目安として提示されたものです。Pierce 、Ahsan、VanderWeele(2011)は、操作変数の強さと統計的検出力は別個の問題であり、操作変数がF=10を楽々とクリアしても、その操作変数が構築された目的の質問に答えるには研究の精度が低すぎる可能性があるという関連指摘をしています。私たちのシミュレーションは、この2つがどれほどかけ離れているかを正確に示しています。デザイン自体が初めての場合は、メンデルランダム化とは何か、どのように実施するかについてのガイドで、この記事で既に知っていると想定している3つの操作変数仮定について説明しています。また、操作変数と2段階最小二乗法についての解説では、推定量自体について説明しています。
シミュレーションの内容と、それを検証する方法
設定は意図的にシンプルにしている。シンプルな設計であれば、複雑なモデルの中に故障モードを隠すのではなく、故障モードが明確にわかるからである。各シミュレーション研究では、サンプルごとに 5,000 人の被験者がいる。マイナーアレル頻度が 0.3 の単一の遺伝子変異が操作変数として機能する。測定されていない交絡因子が曝露と結果の両方に影響を与え、それがそもそも観察による関連性を誤解を招くものにしている。曝露が結果に及ぼす真の因果効果は 0.20 である。交絡因子のため、曝露に対する結果の通常の回帰では約 0.40 を返すため、観察による推定値は真実を 2 倍過大評価している。
次に、第1段階のF統計量が3、5、10、20、50、100付近になるように操作変数の強度を変化させ、各レベルで2つの条件の下で5,000回の反復研究を実行しました。1つは曝露と結果の関連性を同じ参加者で推定する場合、もう1つはそれらが完全に別々の2つのサンプルから得られる場合です。各反復研究について、因果推定値、デルタ法による標準誤差、結果として得られた95%信頼区間、およびその区間に真の効果0.20が含まれているかどうかを記録しました。
以下の図はすべて2回作成されました。1つはR言語で実装されており、複製ブロックに対する行列演算を使用しています。もう1つはPythonで実装されており、異なる乱数発生器を使用し、コードを共有せずに十分な統計量から同じ量を計算しています。2つのエンジンは、何も記述する前に比較されました。モンテカルロ誤差の範囲内で、すべての安定した量について一致しており、一致しない場合は、その不一致自体が発見です。NHANES調査ウェイトが何を修正し、何を修正しないかについての解説と同様に、公開するすべてのデータ図をこの2つのエンジンの基準に照らして検証しています。
弱い手段が推定値に実際に及ぼす影響
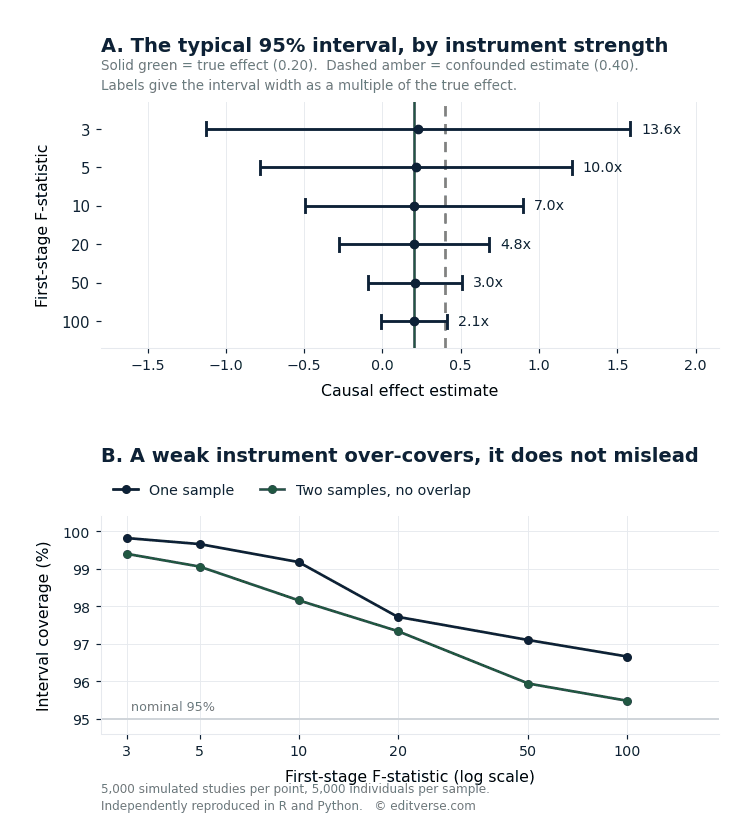
区間は点推定値よりもずっと早く崩壊する。
図Aは、議論全体を1枚の図にまとめたものです。テストしたすべての測定機器の強度において、中央値の推定値は真の効果である0.20に近く、交絡のある観測値である0.40には遠く及ばないことがわかります。劇的に変化するのは、その値を中心とした区間の幅です。
| 第1段階F | 中央値推定値 | 中央値 95%信頼区間幅 | 幅は真の効果の倍数として表される | カバレッジ |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8% |
| 5 | 0.213 | 1.99 | 10.0x | 99.7% |
| 10 | 0.200 | 1.39 | 7.0x | 99.2% |
| 20 | 0.202 | 0.96 | 4.8x | 97.7% |
| 50 | 0.205 | 0.60 | 3.0x | 97.1% |
| 100 | 0.199 | 0.42 | 2.1x | 96.7% |
4列目を読むと、その実質的な意味が明らかになります。F値が3の場合、典型的な信頼区間は、研究で検出しようとしている効果の13.6倍の幅になります。この区間は、おおよそマイナス1.1からプラス1.6まで広がっています。この区間には、大きな保護効果、効果なし、大きな有害効果が含まれています。データには、これらを区別する要素は何もありません。F値が100の場合でも、信頼区間は真の効果の約2倍の大きさであり、方向性を確立するには十分ですが、それ以上のことは期待できません。
区間幅は F の逆平方根に近く縮小します。各幅にその F の平方根を掛けると、6 つのレベル全体で 4.63、4.51、4.37、4.30、4.25、4.24 となり、これはほぼ一定で、デルタ法の標準誤差自体が劣化し始める最も弱い機器でのみ上昇します。実際的な結果として、精度を 2 倍にするには、機器の強度をほぼ 4 倍にする必要があります。これは、2 サンプル設計では、わずかに緩和された p 値の閾値ではなく、はるかに大きな曝露 GWAS を意味します。
区間がオーバーカバーしているが、それは間違っているということではない
パネルBはカバレッジを示しています。これは、95%信頼区間が真の効果を包含した反復研究の割合です。この方法が宣伝どおりに機能していれば、これはどこでも95%になるはずです。しかし、そうではありません。F値が3の場合、1サンプル信頼区間は99.8%の確率で真の効果を包含し、F値が100になると96.7%に低下します。2サンプル信頼区間は1サンプル信頼区間よりわずかに低い値を示し、最も高い信頼度でも95.5%に達します。
過剰カバレッジは、利用可能な情報に対して標準誤差が大きすぎることを示す兆候です。つまり、弱い測定ツールでは、誤解を招くのではなく、保守的な区間が生成されてしまうということです。これは、発表された無効結果を解釈する人にとって、非常に重要な区別です。弱い測定ツールに基づいて効果がないと報告したメンデルランダム化研究論文は、効果が存在しないことを示したわけではありません。その研究デザインでは効果を検出できなかったことを示しただけです。これらは異なる主張であり、査読者は著者にどちらの主張をしているのかを明記するよう求めることが増えています。
平均値は存在しない、そして2つのエンジンがそれを証明した
2つの実装間で一致しなかった量が1つあり、その不一致は示唆に富むものでした。F値が3の場合、Rエンジンは1サンプル条件で平均推定値0.64を返しました。同じ設計で実行したPythonエンジンは0.24を返しました。2サンプル条件では、2つのエンジンは0.77と1.01を返しました。この記事で取り上げた他のすべての量はモンテカルロ誤差の範囲内で一致しましたが、この量だけは一致しませんでした。
これはどちらのプログラムにもバグではありません。ここでの因果推定は2つの回帰係数の比であり、分母が任意にゼロに近づく可能性がある場合、その比には有限の期待値がありません。このような量の標本平均は、何度繰り返しても収束しないため、2つの正直なプログラムはこれについて永遠に意見が一致しません。中央値、区間幅、およびカバレッジはすべて正常に収束するため、上記の表では平均ではなくこれらが報告されています。裾の重い分布を考慮せずに変異体全体の平均に依存するメンデルランダム化の結果はすべて、同じ不安定な基盤の上に立っています。これが、メインのメンデルランダム化ガイドで説明されている多面発現に頑健な推定量が、単純な平均ではなく中央値と最頻値を使用する理由の1つです。これら4つの推定量のそれぞれが実際に何からあなたを守るかについての付随するシミュレーションでは、6つの多面発現レジームにわたってテストし、4つすべてが一致し、4つすべてが間違っているレジームを1つ見つけました。
サンプル重複は、機器の性能が弱い場合にのみ有効です。
2サンプルメンデルランダム化では、曝露GWASと結果GWASが異なる人々で測定されたと仮定します。実際には、ごく少数の非常に大規模なバイオバンクが発表されたGWASの大部分を占めており、著者が必ずしも認識していないにもかかわらず、同じ参加者が分析の両側に現れるため、この仮定は常に破られています。Burgess 、Davies、Thompson(2016)は、重複によって2サンプル推定値が1サンプル挙動に近づき、つまり交絡した観察関連に近づくことを明らかにしました。
我々は、3つの測定器の強度において、重なりを0%から100%まで変化させることで、その効果の大きさを直接的に検証した。
| 参加者の重複 | F = 3 における中央値バイアス | F = 5 における中央値バイアス | F = 10 における中央値バイアス |
|---|---|---|---|
| 0% | -0.004 | -0.011 | -0.003 |
| 25% | -0.016 | -0.008 | -0.010 |
| 50% | -0.003 | -0.012 | 0.000 |
| 75% | +0.015 | -0.005 | +0.011 |
| 100% | +0.026 | +0.005 | +0.005 |
完全な重複を伴う F 値が 3 の場合、中央値の推定値は真の効果 0.20 に対して約 0.026 だけ上方に引っ張られ、交絡値に向かって約 13% シフトし、両方のエンジンが独立してこれを再現しました。F 値が 10 の場合、順序付けられたパターンは残っていません。2 つの問題は加算ではなく乗算されます。重複は弱い操作変数を偏った操作変数に変換しますが、強い操作変数ではほとんど影響しません。
報告上の意味合いは明白です。2つのGWASが重複していると述べるだけでは不十分であり、重複していないと主張するだけでも不十分です。査読者が必要とするのは、重複率とインストゥルメント強度です。なぜなら、重複率はインストゥルメント強度を考慮して初めて解釈可能になるからです。両方の値が好ましくない場合、誠実な対応は議論の中で注意書きを添えるのではなく、別のデータソースを提示することです。
F値が10を超えるというルールが、我々の研究結果が示唆する以上に依然として重要である理由
我々のシミュレーションでは単一のインストゥルメントを使用しているため、そこから弱いインストゥルメントは無害であると結論付けるのは重大な誤解となるだろう。今回テストしたケースは、最も好ましいケースである。BurgessとThompson(2011)が説明したバイアスはインストゥルメントの数とともに増加するため、200個のわずかに有意なバリアントを持つデザインは、我々の単一バリアント設定では示せないものにさらされることになる。これはまさに、より多くのインストゥルメントを得るためにゲノム全体の有意性閾値を5 x 10⁻⁸から1 x 10⁻⁵に緩和することによって生じる状況であり、これは現在、遺伝的構造が疎な曝露に対して一般的な手法となっている。
誠実な分析を行う上で、さらに2つの点を指摘しておく必要がある。多変量メンデルランダム化において、関連する量は通常のF統計量ではなく、Sandersonら(2019)が導入した条件付きF統計量である。これは、各測定変数が曝露を個別に予測するのではなく、互いに区別できるかどうかを測定するものである。論文では、ここで誤った統計量が報告されていることが多い。また、測定変数に誤差がある場合、MR-Egger推定値は信頼できなくなる。その診断には、Bowdenら(2016)のI-squared-GX統計量を用いる。この値が低いということは、多面発現を防ぐために用いていた感度分析自体が信頼できないことを意味する。
査読者が実際に発表されたMR論文で発見すること
上記で説明した基準と実際に適用されている基準との間のギャップが、今回測定されました。Rosas -ChavezとMerriman(2025)は、2016年から2024年の間に発表された高尿酸血症と痛風に関する86件の2標本メンデルランダム化研究を体系的に評価し、それぞれを構造化された品質指標に基づいて採点しました。彼らの調査結果(数値)は以下のとおりです。
- 66% 関連性の仮定を満たしている、つまりゲノムワイドな有意性、または報告されたF統計量が10以上である。3つの論文のうち1つはそうではなかった。
- 51% 参加者の重複がないデータセットを使用しているが、彼ら自身の報告によれば、文献のおよそ半分が上述の相互作用にさらされていることになる。
- 59% 統計的検出力については全く触れていない。
- 17% 操作変数法の3つの主要な仮定すべてを満たした。
- 14% 複製解析は実施しなかった。
- 11% 2021年以降に発表された論文のうち、 STROBE-MR報告ガイドライン.
そのレビューにおける全体的な品質スコアは、21 までの範囲で 0 から 19 までで、平均は 9.1 でした。これは 1 つの疾患領域であり、他の分野では異なる可能性がありますが、これは現在入手可能な MR 報告品質の最も体系的な監査であり、それが示す方向性は、投稿された原稿で当社の統計学者が見ているものと一致しています。6 つの論文のうち 5 つが、結論の根拠となる前提条件を満たしていない場合、編集者は全員の基準を引き上げることで対応します。これが、方法論の完全性がスタイルの問題ではなくゲートキーピングの問題になっている理由です。観察研究の STROBE 報告に関する当社のガイドは、STROBE-MR が拡張する親ガイドラインをカバーしています。
審査員が確認できるように、機器の強度を報告する方法
単一の数値を報告して次に進むことが、このクエリを生成する原因です。以下は、当社の統計担当者が方法論のセクションに記述する内容であり、方法論レビュー担当者がレビューを開いた際に確認する内容です。
- 機器ごとのF統計量と、それらを合わせたF統計量。 両方を報告してください。それぞれF値が1.3に近い30個のバリアントから構築された合計F値40は、3つの強力なバリアントから構築された合計F値40とは異なるオブジェクトであり、バリアントごとの表でのみどちらであるかがわかります。
- 曝露量の変動のうち、説明できる割合。 測定機器セットのR二乗値を明記してください。これは精度を決定するものであり、読者が測定間隔が十分に狭く、有用な値になり得たかどうかを判断するために必要な量です。
- 選抜基準値は、結果発表前に明示されています。 ゲノムワイド有意水準を下回る水準まで有意水準を緩和した場合は、その旨と理由を明記し、両方の閾値での解析結果を報告してください。そうすることで、読者は結果が有意水準の緩和に依存するかどうかを確認できます。
- 凝集パラメータと参照パネル。 連鎖不平衡の閾値、ウィンドウサイズ、および使用されたパネル。独立していない測定機器は、見かけ上の強度を過大評価する。
- 重複率とその発生源。 各GWASに貢献したコホート名を挙げ、共通する割合を推定してください。推定できない場合はその旨を明記し、解釈にあたっては解析を単一サンプルデザインとして扱ってください。
- 重要性を示すだけでなく、正確性を示すことも重要です。 実験デザインで検出できた最小効果量を報告してください。上記のカバレッジ結果が示すように、これがないと有意差なしの結果は解釈できません。
- あらゆる多変量解析における条件付きF統計量。 通常のF値は、多変数メンデルランダム化が問いかける疑問に答えるものではない。
この失敗を引き起こす3つの間違い
F値が10より大きいことを、最低基準ではなく合格点として扱う。10をクリアしたからといって、研究が適切であるとは限らない。我々の数値では、F値が10であっても、測定対象の効果よりも7倍も広い区間が残る。この閾値は、バイアスが問題となる点を示すものであり、精度が十分となる点を示すものではない。
p値の閾値を緩和して、より多くのインストゥルメントを取得する。これは、弱いインストゥルメント領域に陥る最も一般的な方法であり、著者の意図とは正反対の結果をもたらす。インストゥルメントの数を増やしながら、ほとんど寄与しないバリアントを追加してしまうため、古典的なバイアス結果が警告している組み合わせとなる。曝露因子にゲノムワイド有意なバリアントが少なすぎる場合、それは研究を進めるべきかどうかに関する情報であり、回避すべき障害ではない。
効果がないという証拠としてヌル結果を報告する。弱い測定機器の場合、その区間はほぼすべてを網羅しているため、99.8% の確率で真実をカバーします。検出力の低いデザインからのヌル結果は、そのデザインに関する声明であり、これを理解している査読者はそう述べるでしょう。臨床研究におけるエビデンスレベルに関するガイドでは、適切に実施されたMR結果が試験エビデンスと比較してどこに位置するかを解説しており、疫学における因果推論の概要では、このデザインが属するより広範なデザイン群を解説しています。弱い測定機器デザインからのヌル結果は、それ自体では解釈不可能であり、これはメンデルランダム化論文がデスクリジェクトされる理由に関する関連記事の主題となっています。
メンデルランダム化研究のための専門家によるサポート
統計学者が最初に確認するのは、分析手法の妥当性です。分析依頼前に必ず確認を行い、事後報告は行いません。曝露因子にゲノムワイド有意な独立変異が少なすぎる場合、あるいは利用可能な唯一のアウトカムGWASが曝露因子GWASと相当数のサンプルを共有している場合は、その旨を最初に明記します。そうしないと、技術的には正しい分析結果であっても、査読者に受け入れられず、読者にも利用できないものになってしまうからです。
実現可能性チェック
$450
契約締結前に、機器数、F統計量、サンプル重複度、既存文献などを確認してください。契約の継続、変更、中止は書面にてご連絡ください。その後、お客様が依頼される他の調査に対して全額返金いたします。納期は5営業日です。
2標本MR
$2,900
公開されているGWAS要約統計データに基づく完全な研究データ:4つの推定法、MR-PRESSO、Steigerフィルタリング、インストゥルメンタルPheWAS、リーブワンアウトに加え、完成済みのSTROBE-MRチェックリストと実行可能なRコードが含まれます。納期は15営業日です。
拡張デザイン
$ 3,500から
条件付きF統計量を用いた多変量メンデルランダム化分析、媒介メンデルランダム化分析、共局在分析、薬剤標的メンデルランダム化分析、非線形メンデルランダム化分析。作業開始前に固定価格の見積もりと作業範囲を文書で提示します。
遺伝子研究デザインと、アンケート調査、がん登録、外傷登録分析のどれを使用するかまだ迷っている場合は、研究にどの健康データベースを使用すべきかに関するガイドを参照してください。このガイドでは、各情報源で回答できることとできないことを説明しています。
Editverseの無料リサーチツール
メンデルランダム化におけるインストゥルメント強度に関するよくある質問
F統計量が10以上であれば、論文として発表するのに十分でしょうか?
これは必要条件ではあるが、十分条件ではない。我々のシミュレーションによると、F値が10の場合でも、典型的な95%信頼区間は推定される効果の7倍も広く、これは研究デザインに深刻な偏りがないことを示すには十分だが、ほとんどの研究課題に答えるには不十分である。査読者は、F統計量に加えて、研究で検出できた最小効果を示す精度に関する記述をますます求めるようになっている。
複数の計測機器についてF統計量を計算するにはどうすればよいですか?
独立した変異体群の場合、説明された曝露分散の総割合とサンプルサイズから、F値を計算できます。Fは、R二乗にnマイナスkマイナス1を掛け、それを1マイナスR二乗にkを掛けた値で割ったものです。ここでkは操作変数の数です。高い複合値は、少数の強力な操作変数または多数の弱い操作変数によって生成される可能性があり、前者のみが安心できる結果となるため、各変異体ごとのF統計量も報告してください。
弱い操作変数バイアスは、帰無仮説の方向へ、それとも交絡推定値の方向へ影響を与えるのか?
それは研究デザインによります。1標本分析では、バイアスは交絡した観察的関連性の方に向かいます。参加者の重複がない真の2標本分析では、バイアスは帰無仮説の方に向かいます。部分的な重複はその中間に位置するため、重複率は操作変数の強度と併せて報告する必要があり、操作変数の強度に取って代わるものではありません。
より多くの測定機器を取得するために、p値の閾値を緩和することはできますか?
可能ですが、通常は問題を改善するどころか悪化させます。閾値を緩めて選択された変異は、曝露量の分散の説明率にはほとんど寄与せず、操作変数の数を増やすだけです。また、過剰識別の場合、操作変数の数が増えるにつれて、操作変数の弱バイアスが増大します。閾値を緩める場合は、両方の閾値での分析結果を報告し、読者が結果が維持されるかどうかを確認できるようにしてください。
もし私の曝露によってゲノムワイドで有意な変異がごく少数しか検出されなかった場合はどうなりますか?
そうなると、正直なところ、メンデルランダム化研究は、その曝露に対してはまだ適切な研究デザインではないと言えるでしょう。区間が広すぎてほとんどあらゆる事象が含まれる可能性があり、推定値も、そこから得られる否定的な結果も解釈不可能になります。これは、分析後ではなく分析前に解決しておくべき問題であり、実現可能性評価はそのためのものです。
2つのGWASが同じ参加者を共有しているかどうかは、どうすればわかりますか?
各論文および補足資料に記載されている参加コホートリストをお読みください。大規模なバイオバンクは、発表されているGWASのかなりの割合に登場します。そのため、共通の形質に関する2つの大規模研究については、確認するまでは何らかの重複が存在すると想定しておくべきです。重複を定量化できない場合は、解析結果を1サンプルデザインとして解釈してください。
結論
2つのプログラムで独立して再現された13万5000件のメンデルランダム化シミュレーション研究において、F統計量は、通常用いられる目的とは異なる何かを支配していることが判明した。中央値の推定値は、テストしたすべての操作変数の強度において、真の値に近かった。6倍も変化したのは、その周囲の区間の幅であり、Fが100の場合の真の効果の2.1倍から、Fが3の場合の13.6倍まで変化した。サンプルの重複は、操作変数がすでに弱い場合にのみ検出可能な変化をもたらしたが、その場合でも、周囲の不正確さに比べれば変化は小さかった。
実務的な解釈としては、測定機器の強さとは、研究が何らかの答えを出せるかどうかという問題であり、バイアスに関する問題は二次的なものに過ぎない。この考え方の転換によって、チェックを行うべき時期が変わる。結果表に報告されるF統計量は、既に実施された研究の説明である。一方、設計段階で計算されるF統計量は、その研究を実施するかどうかの決定である。最も体系的に公開された監査論文のうち、3つの主要な前提条件すべてを満たしていたのはわずか17%であり、再現性を試みたのはわずか14%であったことを考えると、分析前に行われるチェックこそが、査読を通過する論文と通過しない論文を分けるものとなる。
参考情報
- Staiger D、Stock JH。弱い操作変数を用いた操作変数回帰。 エコノメトリカ. 1997;65(3):557-586. doi:10.2307 / 2171753
- Burgess S、Thompson SG。メンデルランダム化研究における弱い測定器によるバイアスの回避。 疫学の国際ジャーナル. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL、Ahsan H、VanderWeele TJ。複数の遺伝子変異体を用いたメンデルランダム化研究における検出力と測定機器の強度要件。 疫学の国際ジャーナル. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S、Davies NM、Thompson SG。2標本メンデルランダム化における参加者の重複によるバイアス。 遺伝疫学. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J、Del Greco MF、Minelli C、Davey Smith G、Sheehan NA、Thompson JR. MR-Egger回帰を用いた2標本メンデルランダム化分析における要約データの適合性の評価:I二乗統計量の役割。 疫学の国際ジャーナル. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E、Davey Smith G、Windmeijer F、Bowden J. 単一サンプルおよび2サンプル要約データ設定における多変数メンデルランダム化の検討。 疫学の国際ジャーナル. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F、Merriman TR。メンデルランダム化研究:品質評価のための指標。 痛風、尿酸塩、結晶沈着症。 2025; 3(2):8 doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW、Richmond RC、Woolf BAR、他。メンデルランダム化を用いた疫学における観察研究の報告の強化:STROBE-MR声明。 JAMA. 2021;326(16):1614-1621. 土井:10.1001 / jama.2021.18236
シミュレーションの詳細: サンプルあたり 5,000 人、マイナーアレル頻度 0.3 の単一の二対立遺伝子インストゥルメント、曝露と結果の両方に対する未測定交絡因子負荷 0.5、真の因果効果 0.20、交絡された観察関連 0.40。インストゥルメント強度は、第 1 段階の F 値を 3、5、10、20、50、100 に目標とするように較正されています。セルあたり 5,000 回の繰り返し。R 4.3.3 と NumPy を使用した Python 3 で独立して実装。報告されたすべての量は、有限の期待値を持たない比率推定値の平均を除いて、モンテカルロ誤差の範囲内でエンジン間で一致しました。比率推定値の平均については、上記で説明しています。