
Pubblicato | Ultimo aggiornamento
Gli epidemiologi ricorrono sempre più spesso ai metodi bayesiani in epidemiologia quando uno studio presenta un numero insufficiente di casi perché gli strumenti frequentisti standard risultino efficaci, quando ricerche precedenti indicano già un intervallo plausibile per un parametro, o quando è necessario mappare il rischio di malattia su centinaia di piccole aree contemporaneamente. Anziché produrre una singola stima puntuale e un valore p, un'analisi bayesiana combina le conoscenze pregresse su un parametro con i nuovi dati dello studio, riportando poi una distribuzione di probabilità completa per quel parametro anziché un singolo valore numerico. Di seguito, vengono illustrati i meccanismi di tale processo, i problemi epidemiologici specifici in cui la maggiore complessità si rivela vantaggiosa, i software utilizzati dai ricercatori e uno studio pubblicato sulla sorveglianza del cancro che mostra l'applicazione di questo approccio a 218 comunità reali.
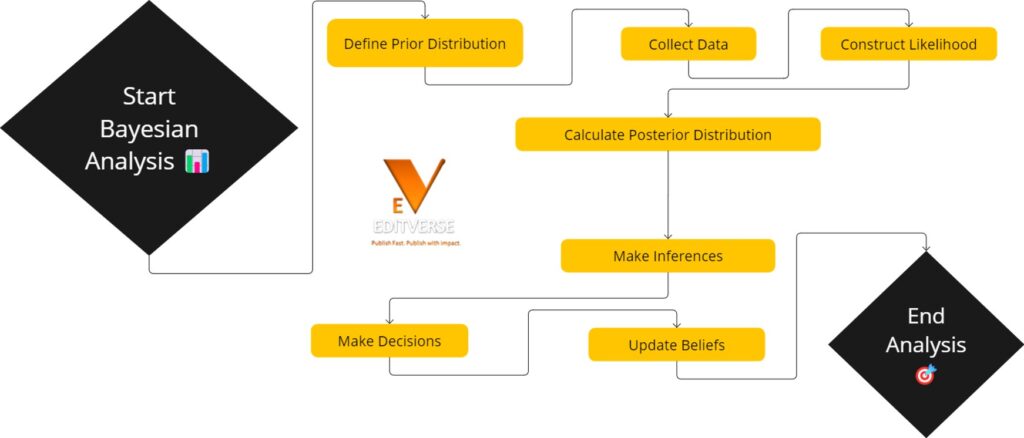
Cosa apportano i metodi bayesiani all'epidemiologia
La statistica frequentista ha dominato la ricerca medica per gran parte del ventesimo secolo, basandosi su valori p, intervalli di confidenza e una rigida regola che vietava l'utilizzo di dati diversi da quelli correnti. La statistica bayesiana per la ricerca clinica, descritta in una revisione metodologica del 2024 pubblicata su Lancet da Goligher, Heath e Harhay , tratta la probabilità come una misura della forza della convinzione piuttosto che come una frequenza a lungo termine, consentendo a uno studio di combinare formalmente le informazioni a priori con nuovi dati per produrre una distribuzione di probabilità aggiornata, o a posteriori, per ogni quantità di interesse. L'informatica moderna ha rimosso il principale ostacolo pratico a questo approccio. La stima basata sulla simulazione, che un tempo richiedeva hardware specializzato, ora funziona su un laptop, e questo è uno dei motivi principali per cui i metodi bayesiani sono passati da una filosofia statistica di nicchia a un uso di routine nella sorveglianza del cancro, nella farmacovigilanza e nella modellizzazione delle epidemie negli ultimi due decenni.
Il teorema di Bayes e la logica dell'aggiornamento delle credenze
Ogni modello bayesiano si basa sulla stessa equazione. Il teorema di Bayes afferma che la probabilità a posteriori di un parametro, dati i dati, è proporzionale alla verosimiglianza dei dati dato quel parametro, moltiplicata per la probabilità a priori del parametro stesso. Espressa in termini di un parametro θ e di dati osservati X, la relazione è P(θ|X) ∝ P(X|θ) × P(θ). Tre elementi svolgono tutto il lavoro qui. La probabilità a priori, P(θ), cattura ciò che è già noto o ragionevolmente ipotizzato sul parametro prima dell'esecuzione dello studio in corso. La verosimiglianza, P(X|θ), descrive quanto sarebbero probabili i dati osservati in corrispondenza di diversi valori candidati del parametro. La probabilità a posteriori, P(θ|X), è la distribuzione aggiornata che risulta dalla combinazione delle due e diventa l'oggetto che un epidemiologo bayesiano effettivamente riporta e interpreta.
Il teorema stesso precede l'epidemiologia moderna di due secoli. Il teorema di Bayes prende il nome da Thomas Bayes, un ministro che non pubblicò mai il risultato, e il saggio che lo conteneva fu letto postumo alla Royal Society dal filosofo Richard Price nel 1763, una pietra miliare che una rassegna storica del 2014 su Cadernos de Saúde Pública di Martinez e Achcar ha celebrato in occasione del suo 250° anniversario nel 2013. I metodi frequentisti hanno relegato gli approcci bayesiani ai margini della statistica applicata per gran parte dei due secoli successivi, e sono tornati all'uso epidemiologico di routine solo quando il calcolo Monte Carlo a catena di Markov ha reso trattabili le complesse distribuzioni a posteriori.
A priori, verosimiglianza e a posteriori nella pratica
Un esempio illustrativo mostra il meccanismo senza bisogno di un set di dati completo. Supponiamo che un dipartimento sanitario voglia stimare la prevalenza di un agente patogeno appena identificato in un distretto prima che vengano effettuati test locali. La sorveglianza nazionale suggerisce una prevalenza intorno al 4%, ma con una reale incertezza, quindi il team codifica questa convinzione come una distribuzione a priori Beta(4, 96), centrata sul 4%, pur consentendo valori da ben al di sotto dell'1% a oltre il 10%. Un'indagine su 200 residenti locali rileva quindi 14 casi positivi. Poiché la distribuzione beta è la distribuzione a priori coniugata per una verosimiglianza binomiale, la distribuzione a posteriori è semplicemente un'altra distribuzione beta, Beta(4 + 14, 96 + 186), che risulta essere Beta(18, 282) e centrata su una stima a posteriori della prevalenza di circa il 6%, estratta tra la distribuzione a priori nazionale e i dati locali in proporzione alla quantità di informazione che ciascuno di essi contiene. Queste cifre sono illustrative e non derivano da uno specifico focolaio pubblicato, ma sono state scelte solo per mostrare come una distribuzione a priori e una probabilità si combinino aritmeticamente per generare una distribuzione a posteriori.
| Termine | Cosa rappresenta | Esempio epidemiologico |
|---|---|---|
| Distribuzione del discorso | Credenza riguardo a un parametro prima di aver esaminato i dati dello studio in corso. | Stima della prevalenza regionale basata su una precedente indagine nazionale. |
| Funzione di verosimiglianza | Probabilità dei dati osservati in corrispondenza di diversi valori dei parametri | Probabilità di osservare 14 test positivi su 200 data una prevalenza reale |
| Distribuzione posteriore | Credenza aggiornata dopo aver combinato la probabilità a priori e quella di verosimiglianza | Stima rivista della prevalenza a livello distrettuale a seguito dell'indagine locale. |
| Intervallo di credibilità | Intervallo contenente il parametro con una probabilità a posteriori dichiarata | Intervallo di credibilità del 95% per la vera prevalenza nel distretto |
| Coniugato precedente | Una distribuzione a priori che, combinata con una data verosimiglianza, produce una distribuzione a posteriori della stessa famiglia | Beta prior abbinato a una verosimiglianza binomiale per una proporzione |
| Catena Markov Monte Carlo | Metodo di simulazione per il campionamento da distribuzioni a posteriori senza soluzione in forma chiusa | Stima di un modello di mappatura spaziale delle malattie con centinaia di parametri |
Intervalli credibili contro intervalli di confidenza
I ricercatori spesso fraintendono il significato di un intervallo di confidenza al 95%, interpretandolo come una probabilità del 95% che il valore reale rientri in un intervallo specifico calcolato. Un intervallo di confidenza garantisce solo che, in numerosi studi ripetuti, il 95% degli intervalli costruiti in questo modo conterrà il parametro reale, il che rappresenta un'affermazione sulla procedura, non sullo specifico intervallo in esame. Un intervallo di credibilità bayesiano, invece, afferma esattamente ciò che si desidera che un intervallo di confidenza comunichi: dati i dati osservati e la distribuzione a priori scelta, esiste una probabilità a posteriori del 95% che il parametro rientri nell'intervallo specificato. La revisione di Goligher, Heath e Harhay pubblicata su Lancet nel 2024 analizza questa distinzione, considerandola una delle differenze più importanti dal punto di vista pratico tra i due approcci, poiché modifica il modo in cui un intervallo di credibilità può essere legittimamente descritto a clinici, redattori di riviste scientifiche e responsabili politici.
Perché gli epidemiologi scelgono i metodi bayesiani
I campioni di piccole dimensioni rappresentano la prova più evidente dell'efficacia di un approccio bayesiano. Un'analisi del 2025 pubblicata sul Journal of Data Science da Xie, Rolka e Barker ha modellato la prevalenza di malattie rare a livello di contea utilizzando un modello bayesiano gerarchico ponderato per il campionamento con inflazione di zeri, specificamente perché molte contee presentavano un numero insufficiente di casi osservati per consentire alle stime standard basate su sondaggi di produrre risultati stabili. Gli studi clinici pediatrici e sulle malattie rare si trovano ad affrontare un problema simile, e un articolo metodologico del 2022 pubblicato su BMC Medical Research Methodology da Turner e colleghi ha descritto l'utilizzo di informazioni provenienti da sottogruppi di pazienti in uno studio clinico pediatrico sull'HIV, impiegando un modello bayesiano gerarchico in modo che la stima di un piccolo sottogruppo potesse trarre forza statistica da sottogruppi correlati, anziché basarsi esclusivamente su pochi partecipanti. I modelli bayesiani gestiscono naturalmente questo tipo di aggregazione parziale, poiché ogni parametro a livello di gruppo è a sua volta estratto da una distribuzione condivisa a livello di popolazione, anziché essere stimato in isolamento.
L'integrazione di dati pregressi autentici è altrettanto importante quanto la gestione di campioni di piccole dimensioni. Quando una revisione sistematica, uno studio precedente o una linea di base regionale ben consolidata definiscono già la probabile collocazione di un parametro, l'analisi bayesiana consente a uno studio di utilizzare formalmente tali informazioni anziché scartarle e ricalcolare tutto da zero, un approccio che si avvicina maggiormente al ragionamento informale degli epidemiologi.
Modelli gerarchici e multilivello per dati di popolazione annidati
I dati sulla salute pubblica raramente si presentano a un singolo livello. I pazienti si raggruppano all'interno delle cliniche, le cliniche all'interno dei distretti e i distretti all'interno dei paesi, e ogni livello di questa struttura porta con sé la propria fonte di variazione. I modelli bayesiani gerarchici, o multilivello, rappresentano esplicitamente ogni livello, consentendo ai parametri per le singole cliniche o distretti di variare attorno a una distribuzione condivisa di livello superiore, invece di imporre un singolo effetto fisso su ogni gruppo o, all'estremo opposto, di stimare ogni gruppo in completo isolamento. Le stime per i gruppi piccoli o atipici vengono "ridotte" verso la media generale in proporzione alla scarsità di dati locali a supporto, mentre i gruppi con dati abbondanti sono lasciati parlare perlopiù da soli. Questa riduzione è proprio ciò che ha permesso a Turner e colleghi di produrre stime utilizzabili dell'effetto del trattamento specifiche per sottogruppi da uno studio pediatrico troppo piccolo per analizzare un singolo sottogruppo in modo indipendente utilizzando i metodi convenzionali. Una guida complementare sulla modellazione multilivello per dati medici annidati approfondisce i meccanismi degli effetti fissi e casuali alla base di questo approccio.
Mappatura bayesiana delle malattie e stima per piccole aree
La mappatura del rischio di malattia in numerose piccole aree geografiche è uno dei contesti in cui i metodi bayesiani in epidemiologia superano costantemente le alternative più semplici. I tassi di incidenza delle malattie in piccole aree sono notoriamente instabili, poiché un comune di 3,000 abitanti può vedere il proprio tasso oscillare drasticamente a causa di due o tre casi in più in un solo anno. Il modello Besag-York-Mollié, o BYM, affronta questo problema combinando un effetto casuale non strutturato con un effetto spazialmente strutturato che trae forza dalle aree geograficamente vicine, attenuando il rumore e preservando al contempo i veri cluster spaziali di rischio elevato o ridotto. Lo statistico Andrew Gelman e i suoi coautori hanno pubblicato un'implementazione completa e funzionante del modello BYM nel linguaggio di programmazione probabilistica Stan in un articolo del 2020 su Spatial and Spatio-temporal Epidemiology , rendendo il metodo molto più accessibile agli epidemiologi applicati rispetto al software specializzato che originariamente richiedeva. Un precedente studio di Catelan, Lagazio e Biggeri ha sviluppato un modello bayesiano gerarchico a tre livelli per analizzare la mortalità per cancro al polmone in 287 comuni della Toscana, nel periodo compreso tra il 1995 e il 1999, utilizzando probabilità di classificazione a posteriori per individuare le aree a rischio effettivamente elevato, tenendo conto del problema dei test multipli che si presenta quando si confrontano simultaneamente centinaia di piccole aree. I fattori di rischio spaziali e ambientali interagiscono con questo tipo di modellizzazione in modi ulteriormente approfonditi in un articolo correlato sulla statistica ambientale e spaziale nella sanità pubblica.
Un esempio pratico: la mappatura dei tumori in aree circoscritte nella Columbia Britannica.
Uno studio del 2022 pubblicato su Frontiers in Oncology da Simkin e colleghi del BC Cancer mostra l'intero flusso di lavoro applicato a dati di sorveglianza reali anziché a una simulazione. Il team ha estratto i casi incidenti di tumore al polmone, al seno femminile, alla cervice uterina e al colon-retto diagnosticati tra i residenti della Columbia Britannica tra il 2011 e il 2018 dal Registro dei tumori della Columbia Britannica, quindi ha mappato il rischio in 218 aree di servizi sanitari comunitari utilizzando un modello BYM2 modificato. La standardizzazione indiretta per età ha prodotto il numero di casi attesi e i rapporti di incidenza standardizzati per ciascuna area rispetto al tasso provinciale, l'indice di Moran ha quantificato quanto le aree limitrofe condividessero livelli di rischio simili e il modello BYM2 stesso ha generato i rischi relativi mediani a posteriori con intervalli di credibilità completi per ogni area, uniformando i conteggi instabili delle piccole aree e segnalando comunque i cluster locali reali.
| Tipo di cancro | Casi di incidenti, 2011-2018 | unità geografiche |
|---|---|---|
| Polmone | 26,448 | 218 aree di servizi sanitari comunitari |
| seno femminile | 28,466 | |
| Cervicale | 1,478 | |
| colorettale | 25,457 |
Il vantaggio pratico di questo studio è stato l'accessibilità tanto quanto l'accuratezza. Simkin e colleghi hanno racchiuso l'intero flusso di lavoro di modellazione e mappatura nel pacchetto R open-source smallareamapp proprio perché, come sottolineano, la capacità tecnica per questi metodi rimane limitata nei registri dei tumori, e uno strumento riproducibile riduce le difficoltà per altri registri provinciali e statali nell'eseguire la stessa analisi sui propri dati.
Metodi bayesiani nella sorveglianza delle malattie e nell'individuazione dei segnali
La farmacovigilanza ha adottato precocemente il rilevamento bayesiano dei segnali, ben prima che il termine "bayesiano" diventasse di uso comune nell'epidemiologia generale. Una revisione metodologica del 2009 pubblicata su Pharmacoepidemiology and Drug Safety da Bate ed Evans descriveva come gli enti regolatori esaminassero le segnalazioni spontanee di reazioni avverse ai farmaci utilizzando metodi bayesiani empirici come la media geometrica bayesiana empirica, che riduce i rapporti di segnalazione grezzi e rumorosi verso una stima più conservativa per le coppie farmaco-evento con poche segnalazioni, riducendo i falsi allarmi senza obbligare gli analisti a ignorare segnali di sicurezza rari ma reali. La sorveglianza oncologica mostra una tendenza parallela a livello di popolazione. Una revisione sistematica pubblicata sull'International Journal of Public Health da Wah, Ahern e Earnest ha identificato 38 studi pubblicati tra il 2014 e il 2018 che applicavano modelli spazio-temporali completamente bayesiani ai dati di incidenza e mortalità del cancro, a dimostrazione che la stessa logica di riduzione alla base del rilevamento dei segnali di farmacovigilanza è ora alla base del modo in cui i registri monitorano il rischio di cancro che cambia sia nello spazio che nel tempo.
Software per l'epidemiologia bayesiana
Oggigiorno, la maggior parte del lavoro applicato in epidemiologia bayesiana si basa su quattro piattaforme principali. Stan utilizza il campionamento Monte Carlo hamiltoniano ed è alla base dell'implementazione BYM per la mappatura delle malattie, pubblicata da Gelman e colleghi, gestendo modelli gerarchici e spaziali di grandi dimensioni in modo sufficientemente efficiente per il lavoro di routine su scala di registro. JAGS, un motore più datato ma ancora ampiamente insegnato, utilizza il campionamento di Gibbs ed è tuttora comune nei corsi di epidemiologia e nel codice di analisi preesistente. WinBUGS è stato il pioniere del software MCMC accessibile agli epidemiologi negli anni '1990 ed è ancora occasionalmente presente in vecchi metodi pubblicati, sebbene la maggior parte dei progetti attivi sia da allora migrata a Stan o JAGS. Il pacchetto R brms, sviluppato da Paul-Christian Bürkner e dimostrato per i modelli di regressione ordinale in un articolo del 2021 pubblicato sul British Journal of Mathematical and Statistical Psychology , consente ai ricercatori di specificare i modelli Stan utilizzando la sintassi familiare delle formule di regressione di R, rendendo così la modellazione gerarchica bayesiana completa accessibile agli epidemiologi senza una formazione specifica in programmazione probabilistica. Un confronto tra i diversi approcci di regressione, compresi i casi in cui la correzione bayesiana modifica il risultato, è trattato in un articolo correlato sui modelli di regressione nella ricerca medica.
Catena di Markov Monte Carlo e verifica della convergenza
Le distribuzioni a posteriori in forma chiusa esistono solo per un piccolo insieme di modelli semplici, quindi la maggior parte dell'epidemiologia bayesiana applicata si basa sul metodo Monte Carlo a catena di Markov, una famiglia di algoritmi che estrae campioni correlati da una catena di Markov costruita per convergere sulla distribuzione a posteriori target. L'esecuzione di diverse catene indipendenti, in genere almeno tre o quattro, a partire da valori iniziali differenti, è una pratica standard, poiché le catene che giungono a risultati simili partendo da punti di partenza diversi forniscono una prova diretta di convergenza, mentre la discordanza tra le catene segnala un problema che l'analista deve risolvere prima di poter considerare attendibile qualsiasi stima riportata. Gli analisti in genere scartano una fase iniziale di riscaldamento, quindi esaminano i grafici delle tracce, la potenziale statistica di riduzione della scala talvolta chiamata R-hat e la dimensione effettiva del campione per valutare se le catene hanno esplorato adeguatamente la distribuzione a posteriori e se le stime risultanti sono sufficientemente precise da poter essere riportate. I modelli gerarchici e spaziali complessi, esattamente del tipo utilizzato nella mappatura delle malattie, sono più inclini a problemi di miscelazione lenta e di convergenza rispetto ai semplici modelli di regressione, quindi la diagnostica della convergenza merita almeno la stessa attenzione nella sezione dei metodi di un manoscritto quanto la specificazione del modello stesso.
Errori comuni nella rendicontazione epidemiologica bayesiana
In alcune parti della letteratura bayesiana, l'adozione di metodi bayesiani ha superato la rigorosa rendicontazione. Una revisione sistematica del 2026 pubblicata su BMC Medical Research Methodology da Marks e colleghi ha esaminato la determinazione della dimensione del campione negli studi clinici randomizzati bayesiani pubblicati e ha scoperto che i metodi completamente bayesiani, nonostante la loro popolarità teorica, sono raramente utilizzati correttamente nella pratica, con molti studi che prendono in prestito il linguaggio bayesiano per un disegno che rimane in realtà frequentista. Tre errori pratici si ripetono nei manoscritti presentati. L'analisi di sensibilità rispetto a distribuzioni a priori alternative e ragionevoli spesso non viene riportata, impedendo ai lettori di valutare quanto la distribuzione a priori scelta abbia effettivamente influenzato la conclusione. Le diagnostiche di convergenza per le catene MCMC vengono spesso omesse del tutto, anche se una catena mal miscelata può produrre una distribuzione a posteriori apparentemente sicura ma errata. Le distribuzioni a priori vaghe e poco informative vengono talvolta rietichettate come "oggettive" senza riconoscere che una distribuzione a priori genuinamente piatta può comunque influenzare significativamente i risultati in contesti con piccoli campioni, che sono proprio i contesti in cui i ricercatori ricorrono ai metodi bayesiani. Un revisore statistico di una rivista scientifica prenderà in considerazione tutti e tre questi aspetti prima di accettare un'analisi bayesiana, e i manoscritti che li affrontano fin dall'inizio superano la revisione paritaria con un numero di richieste di revisione sostanziale decisamente inferiore.
Come gli statistici di Editverse supportano i progetti di epidemiologia bayesiana
Specificare una distribuzione a priori appropriata, costruire un modello gerarchico o spaziale che corrisponda alla struttura dei dati effettiva di uno studio e diagnosticare i problemi di convergenza MCMC richiedono tutti una solida esperienza pratica nella modellazione bayesiana, che molti manoscritti non possiedono e non superano la fase di revisione paritaria. Il team di biostatistica di Editverse collabora direttamente con i ricercatori in epidemiologia per quanto riguarda la specificazione delle distribuzioni a priori, il codice dei modelli Stan e brms, la diagnostica della convergenza e il linguaggio della sezione Metodi che soddisfa i revisori statistici delle riviste, le quali si aspettano sempre più rigore bayesiano piuttosto che abitudini frequentiste mutuate. I servizi di analisi statistica e di redazione dei manoscritti di Editverse coprono questo lavoro, dalla specificazione iniziale del modello fino alla presentazione finale del manoscritto, e il selettore di test statistici gratuito è un utile punto di partenza per verificare se un approccio bayesiano o un test frequentista convenzionale si adatti meglio a un dato set di dati prima di optare per l'uno o per l'altro.

Letture correlate sui metodi bayesiani ed epidemiologici
- Le statistiche bayesiane alimentano la ricerca medica per i principianti per un primo approccio più delicato alle stesse idee fondamentali.
- Analisi bayesiana nella pratica: casi di studio da studi clinici adattivi per capire come questi stessi strumenti cambiano la progettazione degli studi clinici piuttosto che la sorveglianza.
- L'impatto dell'inferenza causale sull'epidemiologia e sulla salute pubblica. per comprendere come si intersecano i modelli bayesiani e causali.
- Modelli avanzati per i dati sulle malattie infettive per modelli non lineari e compartimentali che spesso si abbinano alla stima bayesiana.
- Analisi di potenza semplificata per capire come la pianificazione della dimensione del campione differisce tra i modelli frequentisti e bayesiani.
- Analisi di sopravvivenza di Kaplan-Meier per la controparte frequentista della modellazione bayesiana della sopravvivenza nei dati oncologici.
Domande frequenti
Qual è la principale differenza pratica tra l'epidemiologia bayesiana e quella frequentista?
Un'analisi frequentista produce una stima puntuale, un valore p e un intervallo di confidenza costruiti interamente a partire dai dati dello studio in corso. Un'analisi bayesiana combina questi dati con una distribuzione a priori che rappresenta le conoscenze esistenti, quindi riporta una distribuzione a posteriori completa e un intervallo di credibilità che può essere interpretato direttamente come un'affermazione di probabilità sul parametro stesso.
Quando un approccio bayesiano fa la differenza maggiore in epidemiologia?
Campioni di piccole dimensioni o relativi a malattie rare, mappatura delle malattie in aree circoscritte e distribuite su numerose unità geografiche, e dati gerarchici con cliniche o distretti annidati all'interno di regioni più ampie sono gli ambiti in cui i modelli gerarchici bayesiani superano più nettamente gli approcci convenzionali a effetti fissi, principalmente grazie all'aggregazione parziale che applicano tra gruppi correlati.
Un intervallo di credibilità al 95% è la stessa cosa di un intervallo di confidenza al 95%?
No. Un intervallo credibile afferma che, dati i dati e la distribuzione a priori scelta, esiste una probabilità a posteriori del 95% che il vero parametro si trovi all'interno dell'intervallo. Un intervallo di confidenza garantisce solo che il 95% degli intervalli costruiti nello stesso modo in studi ripetuti conterrebbe il vero valore, il che rappresenta un'affermazione sulla procedura a lungo termine piuttosto che sullo specifico intervallo calcolato.
Quali software utilizzano gli epidemiologi per eseguire i modelli bayesiani?
Stan e il pacchetto R brms gestiscono la maggior parte del lavoro attuale, JAGS rimane comune nell'insegnamento e nel codice legacy, e WinBUGS è stato un pioniere nel settore negli anni '1990, ma è stato in gran parte sostituito da strumenti più veloci e flessibili come Stan.
Un'analisi bayesiana richiede una grande quantità di dati preliminari per essere utile?
No. Uno studio può utilizzare una distribuzione a priori deliberatamente debole e minimamente informativa, lasciando che i dati osservati dominino la distribuzione a posteriori, una pratica comune quando non esistono solide prove a priori. Questo approccio fornisce comunque la distribuzione a posteriori completa e intervalli di credibilità validi anche in presenza di una distribuzione a priori debole.
Come valutano i revisori un'analisi bayesiana in un manoscritto inviato?
I revisori statistici in genere verificano che la distribuzione a priori scelta sia giustificata e che la sua influenza sia testata tramite analisi di sensibilità, che vengano riportati i parametri diagnostici di convergenza MCMC come R-hat e la dimensione effettiva del campione, e che l'articolo interpreti correttamente gli intervalli di credibilità anziché descriverli con un linguaggio frequentista mutuato dagli intervalli di confidenza.