
Cómo elegir la prueba estadística adecuada
Seleccionar la prueba estadística correcta no es cuestión de gustos, sino que depende de tres factores: el tipo de resultado medido, el número de grupos o mediciones que se comparan y si las observaciones son independientes o pareadas . Si se aciertan estos tres factores, la prueba suele ser la adecuada. El selector interactivo anterior le guía a través de estas decisiones; esta sección explica la lógica subyacente para que pueda justificar su elección ante un revisor.
Paso 1: Identifique el tipo de resultado (variable dependiente).
Todo comienza aquí. Un resultado continuo (presión arterial, HbA1c, una puntuación) apunta a pruebas basadas en medias como la prueba t o el ANOVA. Un resultado categórico (curado/no curado, respondedor/no respondedor) apunta a pruebas basadas en proporciones como la prueba de chi-cuadrado, la prueba exacta de Fisher o la regresión logística. Un resultado ordinal (una escala de dolor, una etapa) generalmente requiere métodos no paramétricos. Un resultado de tiempo hasta el evento (supervivencia, tiempo hasta la recaída) requiere análisis de supervivencia, porque debe tener en cuenta las observaciones censuradas que una simple comparación de medias no puede.
Paso 2: Cuenta tus grupos y comprueba si hay parejas.
¿Está comparando un grupo con un valor conocido , dos grupos o tres o más ? ¿Y las observaciones son independientes (sujetos diferentes en cada grupo) o pareadas (los mismos sujetos medidos dos veces)? El emparejamiento es la distinción que más se suele pasar por alto. Medir a los mismos pacientes antes y después de un tratamiento constituye datos pareados; analizarlos como si los dos conjuntos de mediciones provinieran de grupos independientes descarta la información que hace que el diseño sea potente y es un error reconocido en la literatura.
Paso 3: Comprobar los supuestos (paramétricos frente a no paramétricos).
Las pruebas paramétricas (prueba t, ANOVA, correlación de Pearson) asumen que la variable de respuesta sigue una distribución aproximadamente normal y, para comparaciones entre grupos, que las varianzas son similares. Cuando se cumplen estos supuestos —o la muestra es lo suficientemente grande como para que se aplique el teorema del límite central—, las pruebas paramétricas son más potentes. Cuando los datos presentan asimetría, son ordinales o la muestra es pequeña, conviene utilizar el equivalente no paramétrico: la prueba de Mann-Whitney en lugar de la prueba t para muestras independientes, la prueba de Wilcoxon en lugar de la prueba t para muestras pareadas, la prueba de Kruskal-Wallis en lugar de ANOVA y la correlación de Spearman en lugar de la de Pearson.
Paso 4: Compárelo con la prueba y luego verifíquelo con una calculadora.
Una vez definidos el tipo de resultado, la estructura del grupo y los supuestos, se determina la prueba. Utilice la tabla comparativa que aparece a continuación como referencia rápida, abra la calculadora gratuita correspondiente y confirme su resultado con el código R que se muestra. Para la planificación del estudio, realice siempre un análisis del tamaño de la muestra y de la potencia estadística antes de recopilar los datos.
Guía visual: El sistema de 3 filtros en acción
Cada diapositiva se corresponde directamente con un paso del selector interactivo superior, desde el marco de trabajo hasta la prueba.

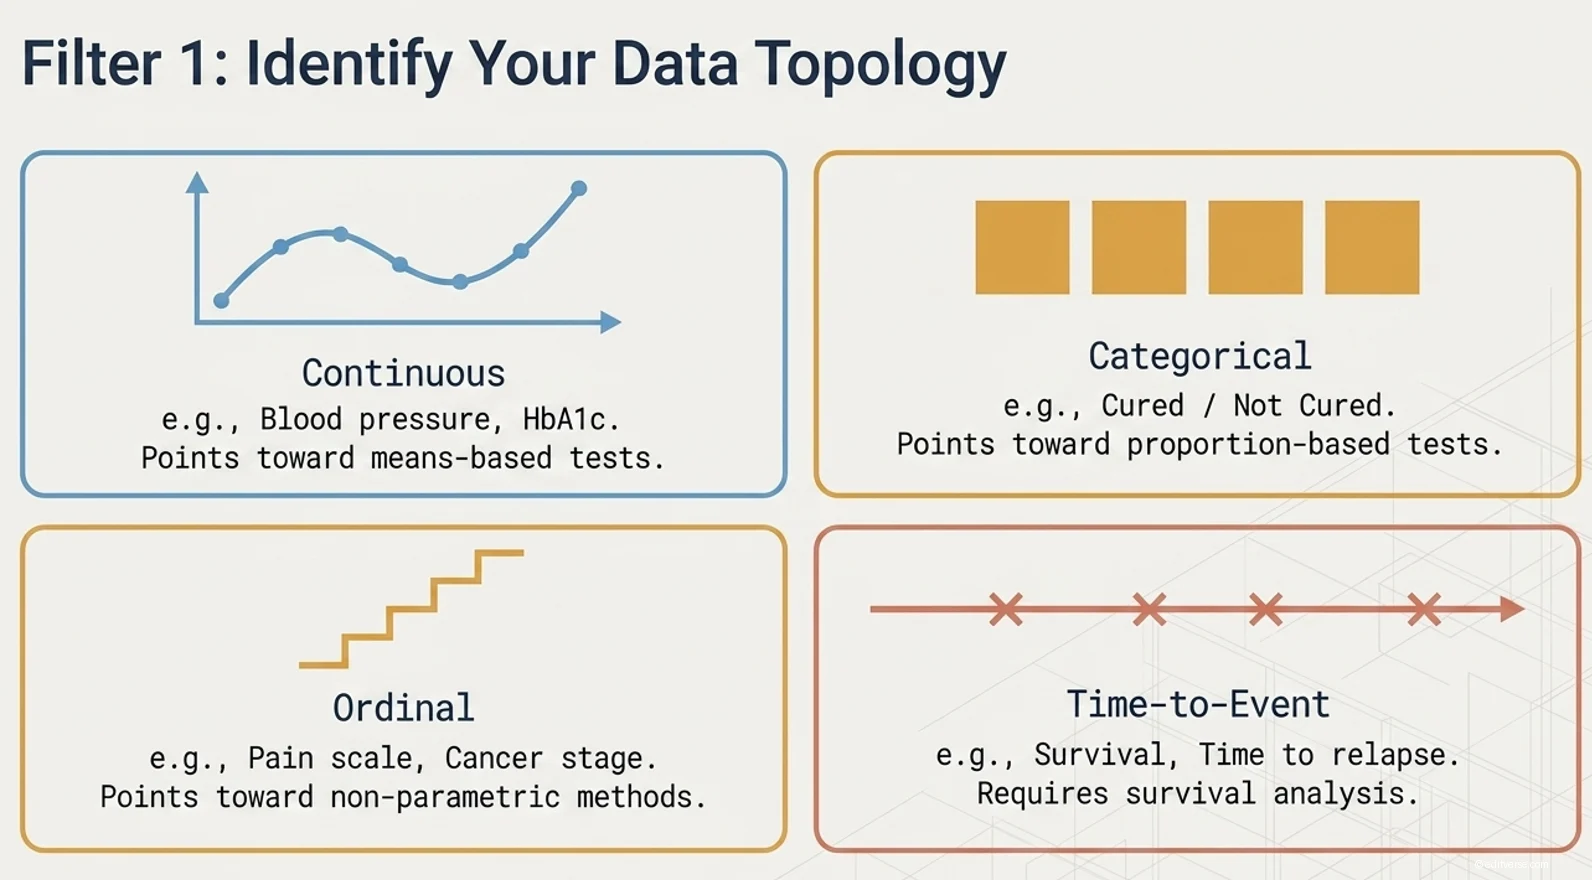
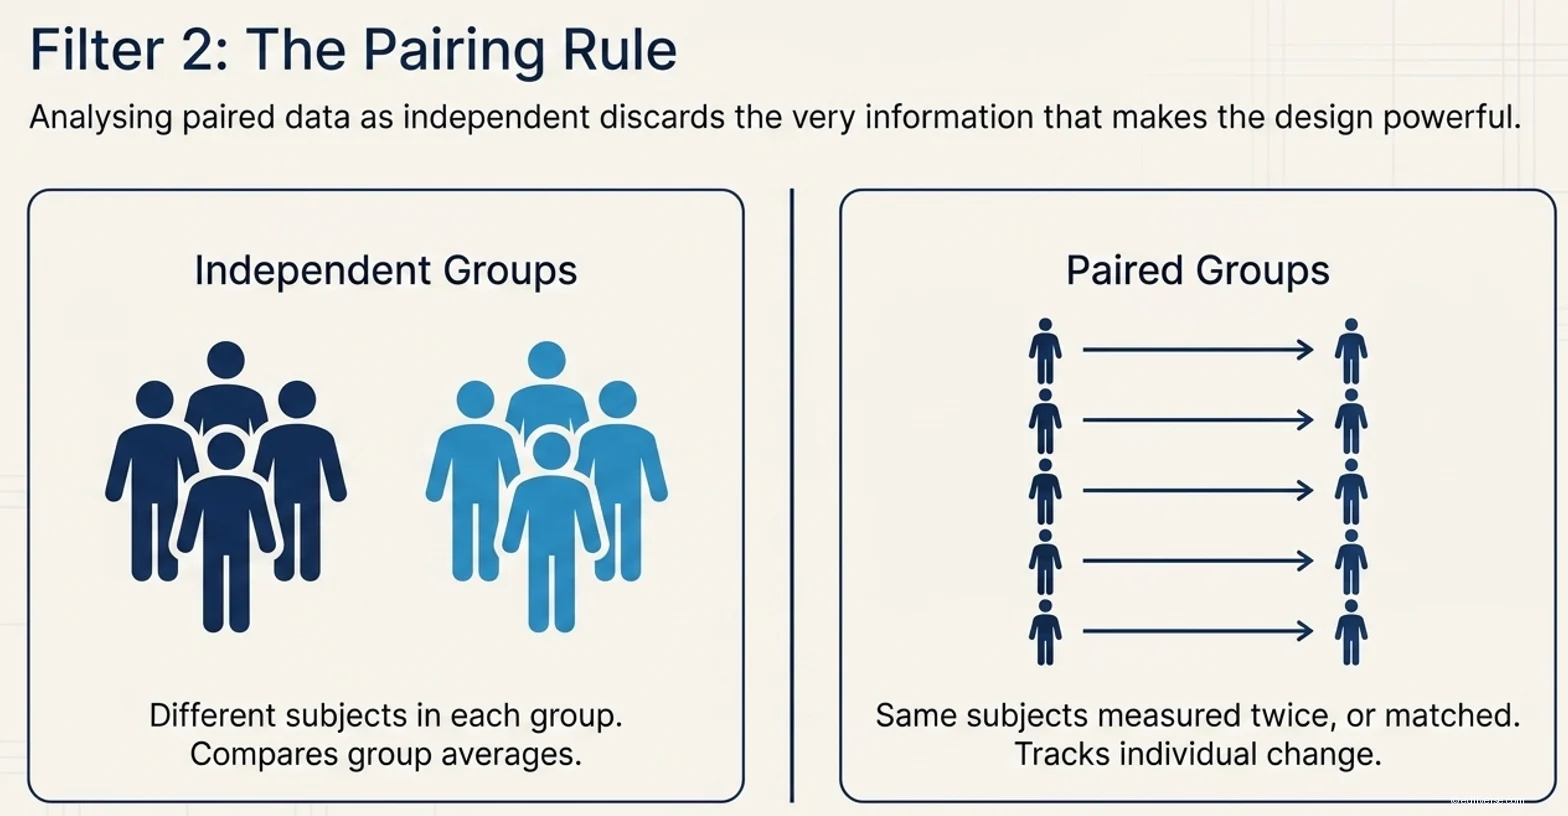
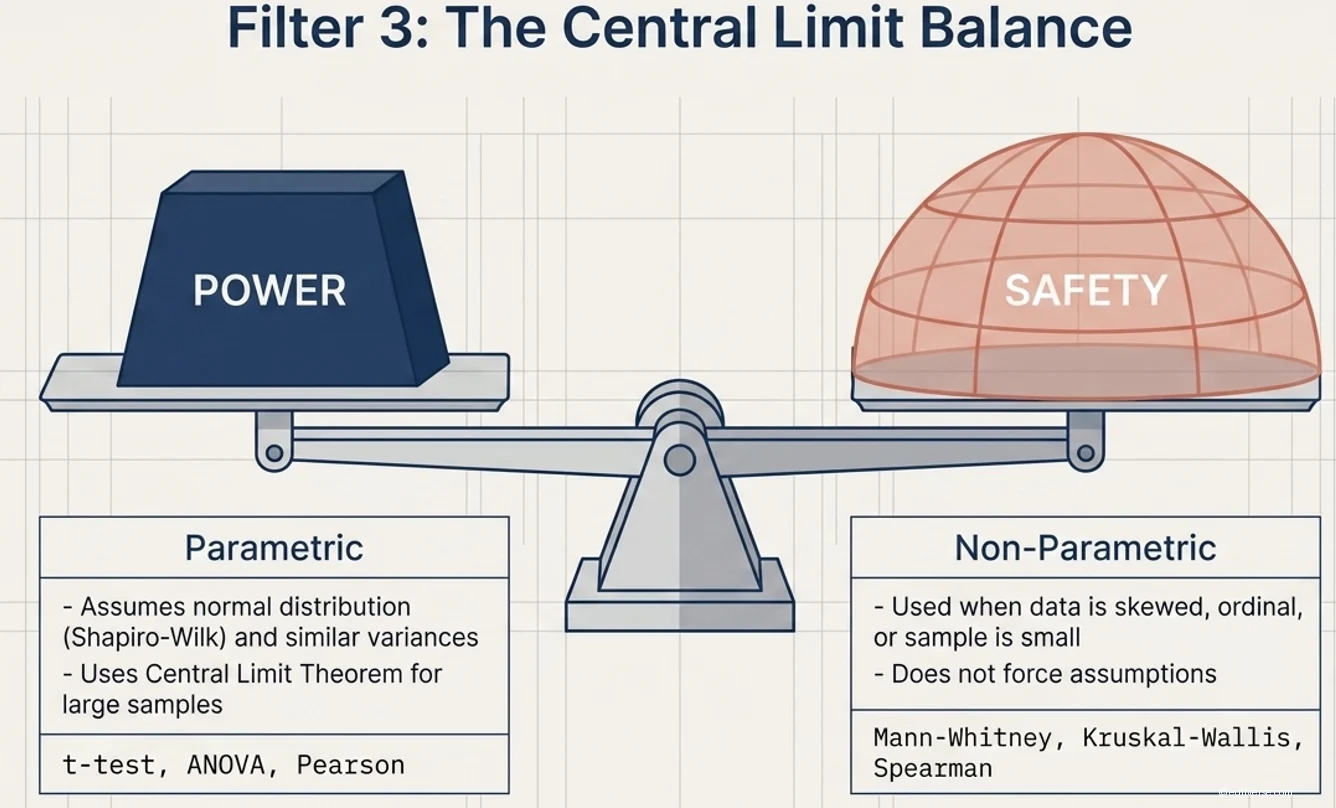

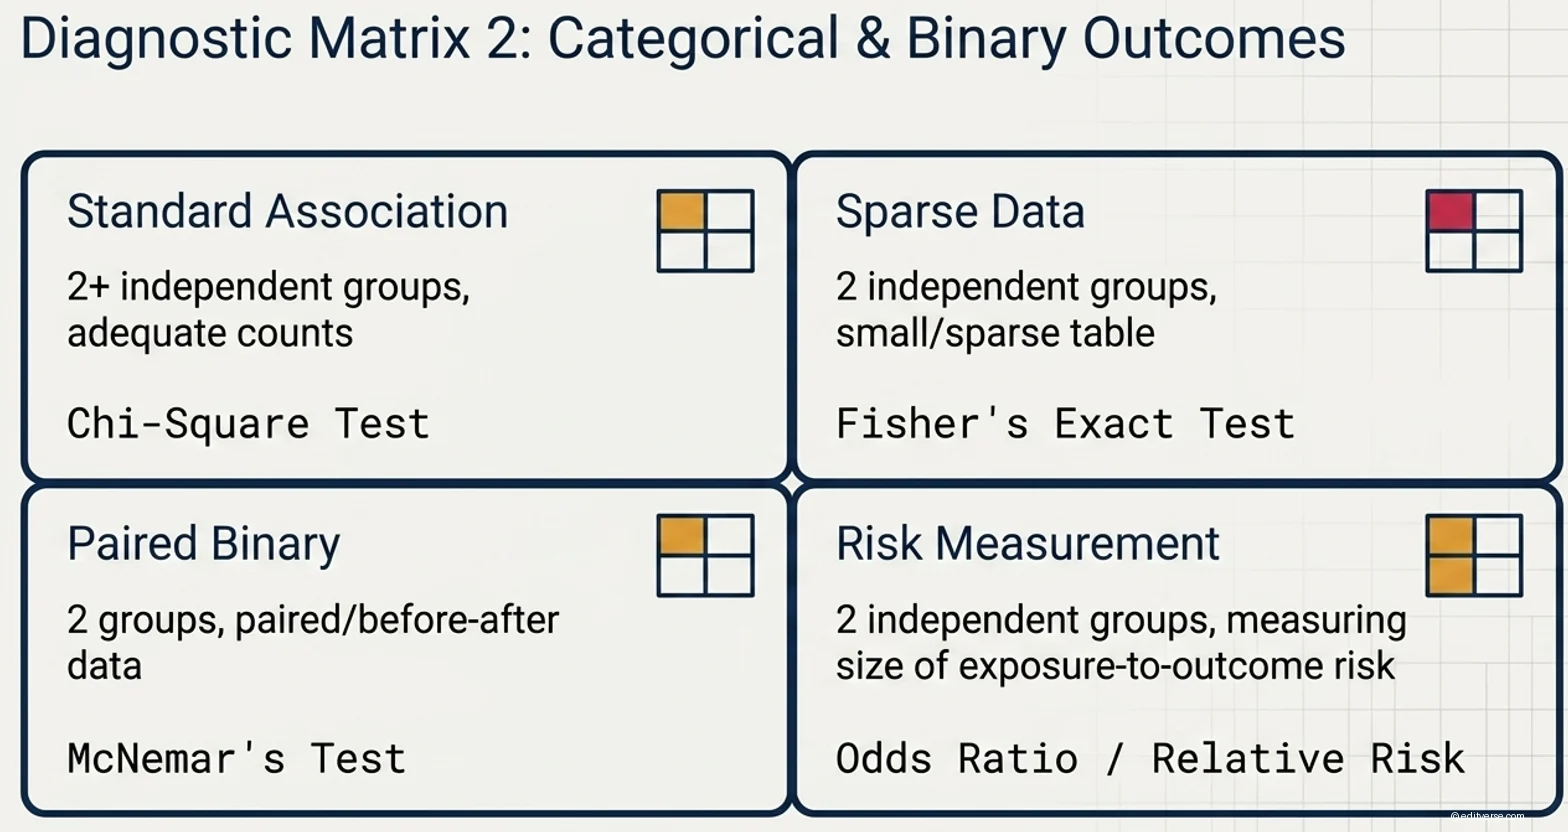


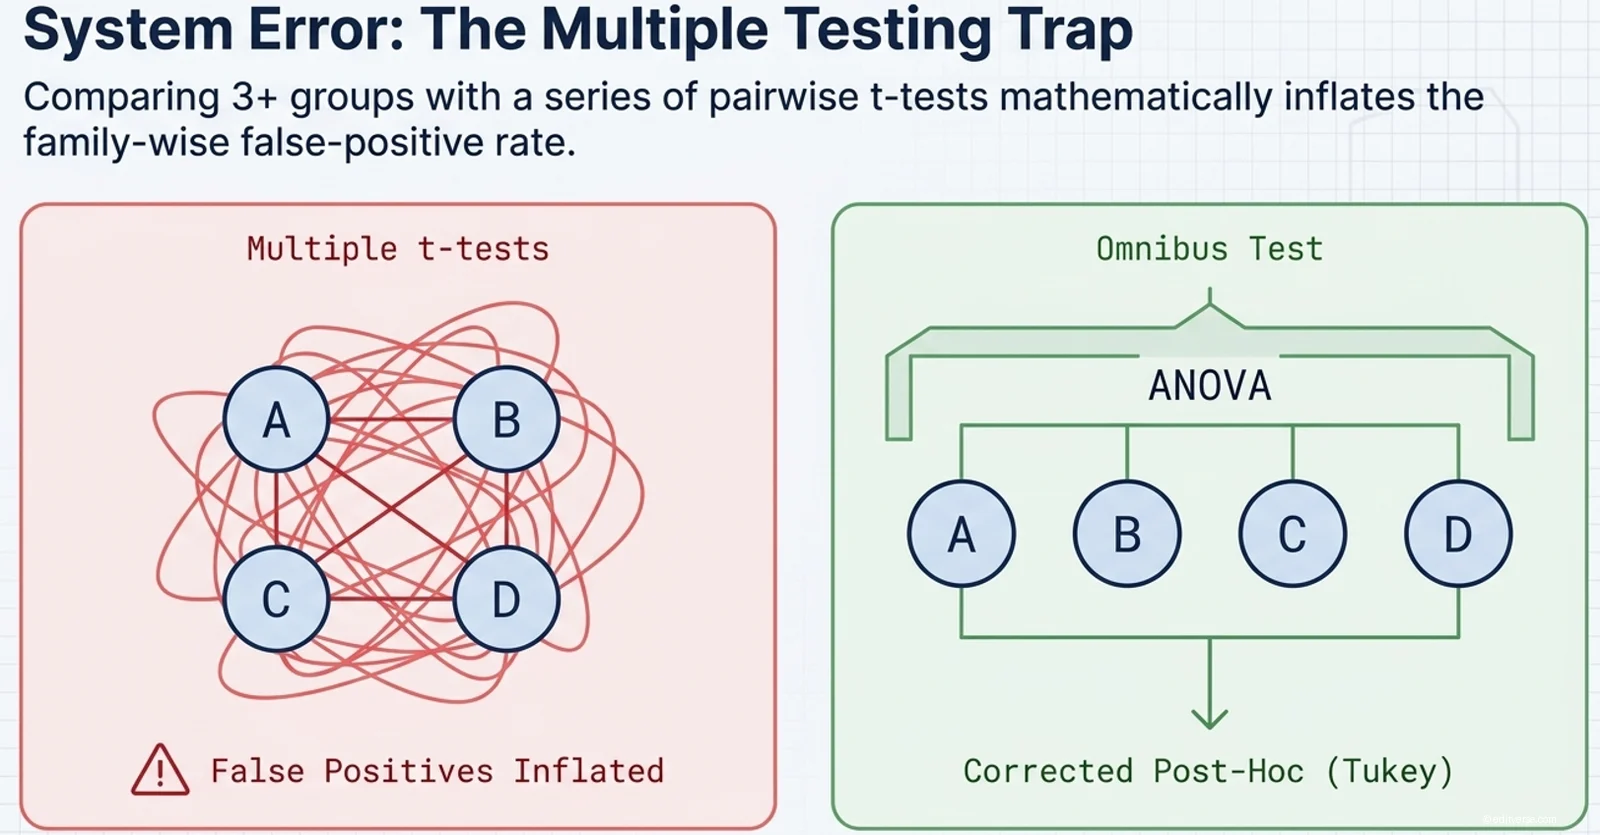
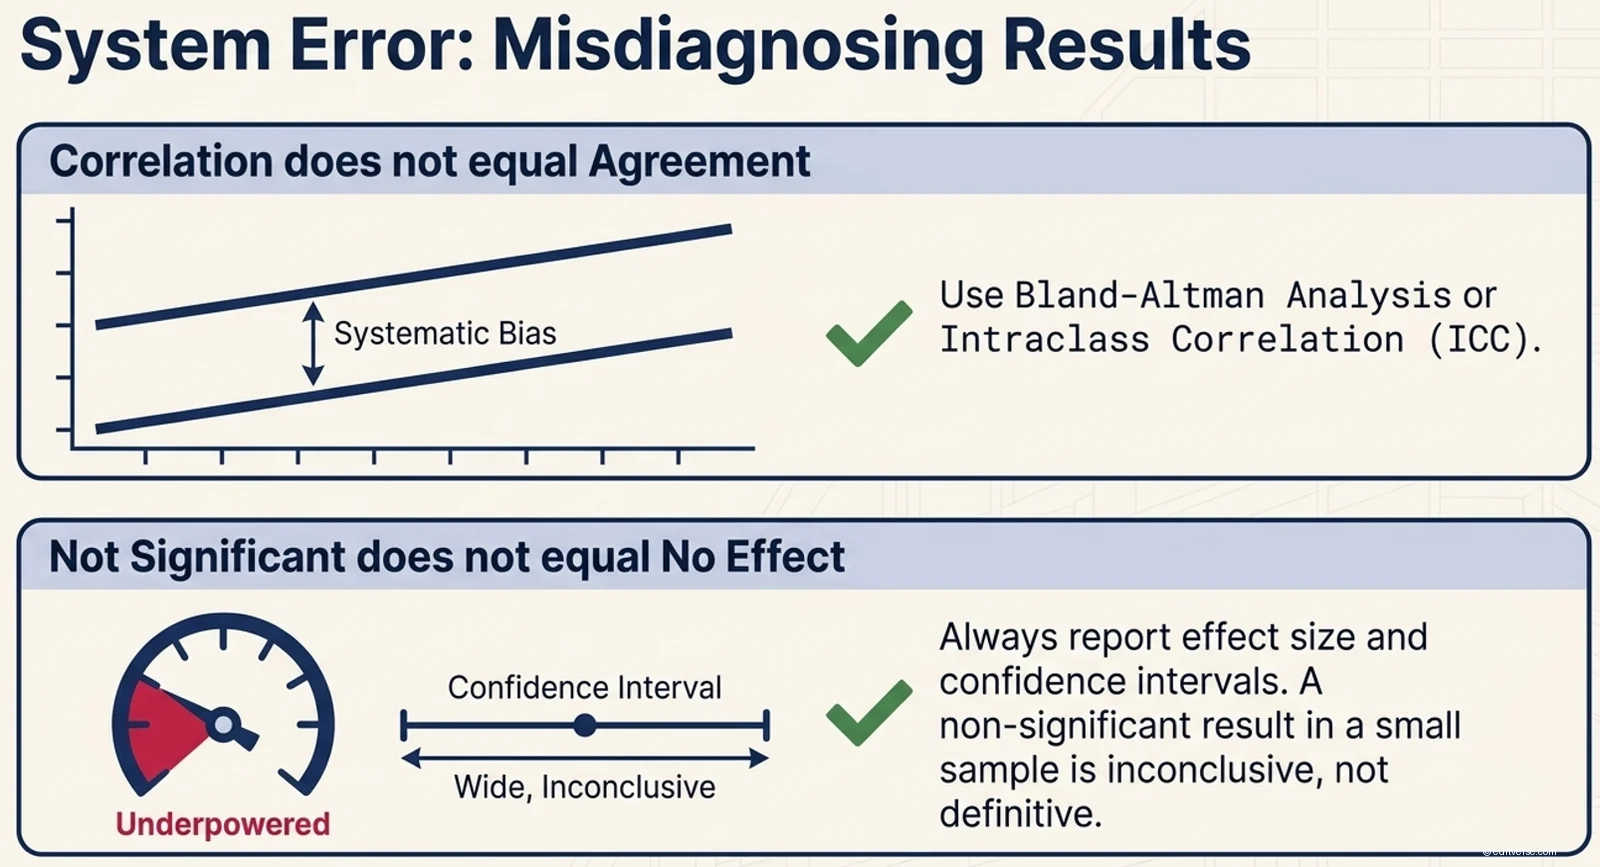
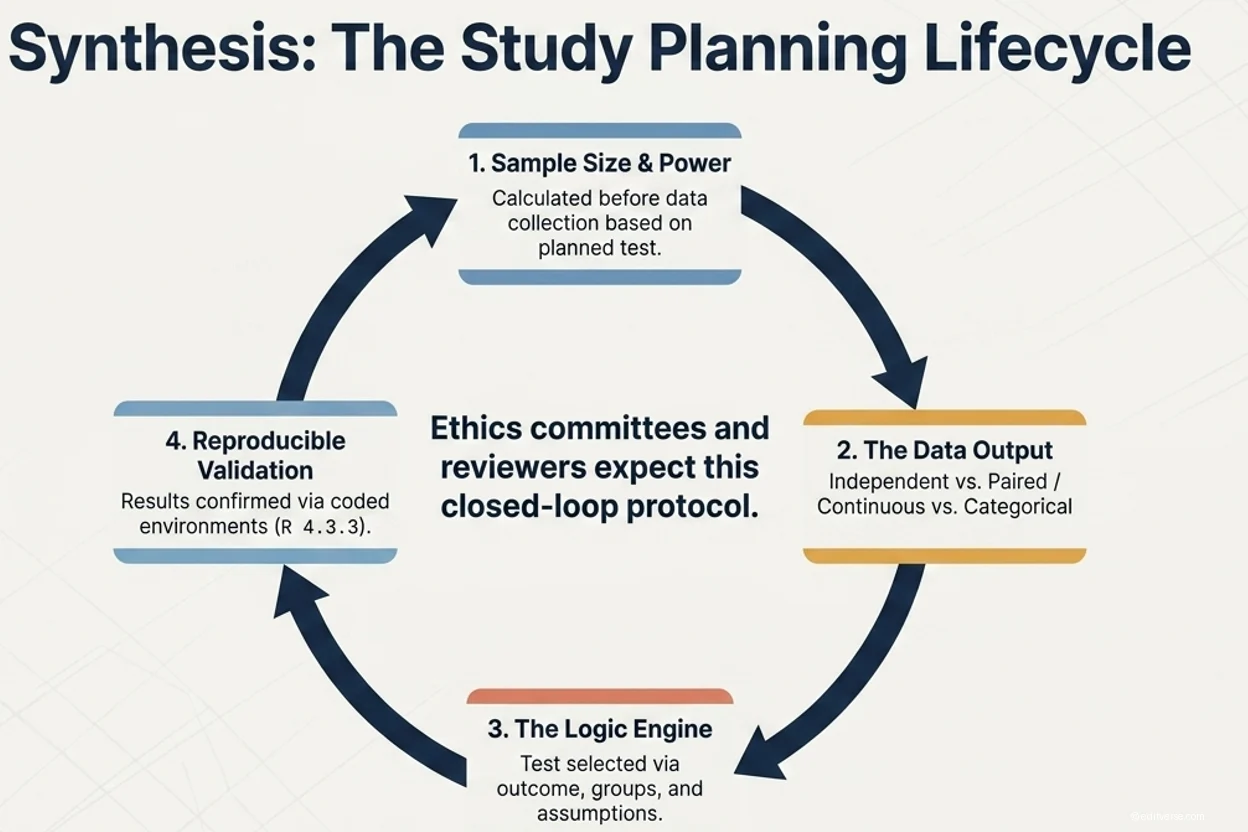
Tabla de selección de pruebas estadísticas
Adapta el diseño de tu estudio a la prueba adecuada y, a continuación, abre la calculadora gratuita.
| Objetivo / diseño | Tipo de resultado | Grupos | Prueba recomendada | Calculadora |
|---|---|---|---|---|
| Comparando grupos | ||||
| Dos grupos independientes, datos normales | Continuo | 2 (independiente) | Prueba t independiente | Prueba t → |
| Dos grupos independientes, asimétricos/ordinales | Continuo / ordinal | 2 (independiente) | Universidad Mann-Whitney | Mann-Whitney → |
| Antes/después, mismos sujetos, normal | Continuo | 2 (emparejados) | Prueba t pareada | Prueba t → |
| Antes/después, mismos sujetos, sesgado | Continuo / ordinal | 2 (emparejados) | Wilcoxon, rango firmado | Wilcoxon → |
| Tres o más grupos, normal | Continuo | 3+ (independiente) | ANOVA unidireccional + Tukey | ANOVA → |
| Tres o más grupos, no normales | Continuo / ordinal | 3+ (independiente) | Kruskal-Wallis | En la aplicación → |
| Resultados categóricos | ||||
| Asociación, recuentos adecuados | Categórico | 2+ (independiente) | Chi-cuadrado | Chi-cuadrado → |
| Asociación, mesa pequeña/escasa | Categórico | 2 (independiente) | Exacto de Fisher | De Fisher → |
| Binario emparejado (antes/después) | Binario | 2 (emparejados) | Prueba de McNemar | McNemar → |
| Magnitud del riesgo (exposición → resultado) | Binario | 2 (independiente) | Razón de probabilidades / Riesgo relativo | OR / RR → |
| Relaciones y predicción | ||||
| Asociación entre dos variables | Continuo | - | Correlación de Pearson/Spearman | Correlación → |
| Predecir un resultado continuo | Continuo | - | Regresión lineal | Regresión → |
| Predice el resultado binario | Binario | - | Regresión logística | Logística → |
| Acuerdo, diagnóstico y supervivencia | ||||
| Acuerdo del evaluador, categorías | Categórico | 2 evaluadores | Kappa de Cohen | Kappa → |
| Comparación de fiabilidad/métodos | Continuo | 2 evaluadores/métodos | CCI / Bland-Altman | CCI → |
| Prueba diagnóstica frente a prueba de referencia | Binario | - | Sensibilidad y especificidad | Sensibilidad/Especificación → |
| Prueba el rendimiento en diferentes umbrales | Continuo → binario | - | Curva ROC y AUC | ROC → |
| Tiempo hasta el evento con censura | Tiempo hasta el evento | 1–2 grupos | Kaplan-Meier / Log-Rank | Supervivencia → |
| Planificación del estudio | ||||
| ¿Cuántos participantes necesito? | Año | - | Análisis del tamaño de la muestra y de la potencia estadística | Tamaño de la muestra → |
Errores comunes en la selección de pruebas
Ignorando que los datos están emparejados
Analizar mediciones repetidas o emparejadas como si provinieran de grupos independientes es uno de los errores más comunes y con mayores consecuencias. Los diseños pareados requieren pruebas pareadas (prueba t pareada, prueba de rangos con signo de Wilcoxon o prueba de McNemar para datos binarios); ignorar la dependencia anula la eficiencia del diseño y puede producir resultados engañosos.
Realizar múltiples pruebas t en lugar de ANOVA.
Comparar tres o más grupos con una serie de pruebas t por pares aumenta la tasa de falsos positivos en el conjunto de los datos. Utilice una única prueba global (ANOVA o Kruskal-Wallis) seguida de una comparación post hoc corregida.
Utilizar una prueba paramétrica en datos asimétricos u ordinales.
La prueba t y el ANOVA presuponen una normalidad aproximada. En muestras claramente asimétricas, ordinales o muy pequeñas, se recomienda utilizar la prueba no paramétrica equivalente en lugar de forzar una prueba paramétrica.
Confundir correlación con acuerdo
Una alta correlación de Pearson entre dos métodos de medición no significa que coincidan; dos métodos pueden estar perfectamente correlacionados y, sin embargo, presentar un sesgo sistemático. Para evaluar la concordancia, utilice la correlación intraclase o un análisis de Bland-Altman.
Considerar "no significativo" como "sin efecto".
Un resultado no significativo en un estudio con potencia estadística insuficiente no implica la ausencia de efecto. Informe el tamaño del efecto y el intervalo de confianza, y planifique con antelación un tamaño de muestra con la potencia estadística adecuada.
Pruebas múltiples no corregidas
Probar muchos resultados o ajustar muchos modelos sin corregir la multiplicidad aumenta los falsos positivos y es una fuente reconocida de resultados irreproducibles.
Preguntas frecuentes
¿Cómo puedo saber si mis datos son "normales"?
Analice un histograma o un gráfico QQ y, para pruebas formales, utilice una prueba de normalidad (Shapiro-Wilk). Con muestras grandes, una ligera desviación de la normalidad tiene poca importancia debido al teorema del límite central; con muestras pequeñas, en caso de duda, prefiera las pruebas no paramétricas.
¿Cuál es la diferencia entre datos pareados e independientes?
Los datos independientes provienen de sujetos diferentes y no relacionados dentro de cada grupo. Los datos pareados provienen de los mismos sujetos medidos dos veces (antes/después) o de pares coincidentes. El emparejamiento modifica la prueba que se utiliza, por lo que es importante identificarlo antes del análisis.
¿Paramétrico o no paramétrico? ¿Cuál es mejor?
Las pruebas paramétricas son más potentes cuando se cumplen sus supuestos. Las pruebas no paramétricas son más seguras para datos asimétricos, ordinales o con muestras pequeñas. Adapta la prueba a tus datos, no al revés.
¿Necesito calcular el tamaño de la muestra antes de elegir una prueba?
Sí. La prueba que planea utilizar determina el cálculo del tamaño de la muestra , y ambos deben especificarse en su protocolo antes de la recopilación de datos; los comités de ética y los revisores lo esperan.
¿Puede un estadístico comprobar mi elección?
Sí. Nuestros bioestadísticos revisan los diseños de los estudios, confirman la prueba correcta y realizan el análisis completo con resultados reproducibles en R como parte de un paquete de análisis estadístico.
Referencias y lecturas adicionales
Fuentes revisadas por pares e indexadas en PubMed sobre selección e informe de pruebas estadísticas.
¿Aún no está seguro de qué prueba se ajusta mejor a sus datos?
Nuestros bioestadísticos confirman la prueba correcta, verifican los supuestos y ejecutan su análisis completo con resultados reproducibles en R.
Obtenga ayuda estadística experta