
Shrnutí: Metaanalýza sdružuje odhady účinků z více studií do jednoho váženého výsledku. Dvanáctikroková cesta vede od otázky PICO přes systematické vyhledávání, screening se dvěma recenzenty pomocí vývojového diagramu PRISMA, standardizovanou extrakci dat , posouzení rizika zkreslení (RoB 2 nebo ROBINS-I), výběr míry účinku, model s náhodnými nebo fixními efekty, sdružování forest-plot, testování heterogenity (I²) a publikačního zkreslení (Eggerův test), hodnocení jistoty GRADE a reporting v souladu s PRISMA 2020. Bezplatné kalkulačky pro každou fázi jsou propojeny v celém textu.
Metaanalýza promění regál samostatných studií v jedno obhajitelné číslo a toto číslo je jen tak důvěryhodné , jako dvanáct kroků, které za ním stojí. Ať už se jedná o první kvantitativní syntézu pro kapitolu diplomové práce, nebo o zdokonalení stávajícího protokolu, níže uvedená sekvence vede od formulace otázek až po zprávu připravenou k publikaci s přesnými statistickými prahovými hodnotami, nástroji a standardy pro podávání zpráv, které recenzenti kontrolují jako první.
Co je metaanalýza?
Metaanalýza je statistická technika, která kombinuje kvantitativní výsledky z více nezávislých studií do jednoho souhrnného odhadu účinku. Protože si vypůjčuje statistickou sílu ze všech zahrnutých studií najednou, dobře provedená metaanalýza vytváří užší intervaly spolehlivosti než jakákoli jednotlivá studie, dokáže odhalit účinky, které jsou příliš malé na to, aby je jednotlivé studie spolehlivě detekovaly, a umožňuje výzkumníkům formálně kvantifikovat, do jaké míry se studie vzájemně neshodují, spíše než aby jednoduše tvrdili, že se neshodují.
Metaanalýza je statistická metoda, nikoli typ přehledu. Téměř vždy se provádí v rámci systematického přehledu , který poskytuje transparentní a reprodukovatelný proces vyhledávání a screeningu, díky kterému je sdružování dat v první řadě obhajitelné. Zacházení s těmito dvěma pojmy jako shodnými je jedním z nejrychlejších způsobů, jak vznést námitku recenzenta.
Jednoduše řečeno: Představte si pět malých studií, z nichž každá testuje, zda lék snižuje krevní tlak. Jednotlivě žádná z nich nemá dostatek pacientů, aby byla plně přesvědčivá. Metaanalýza zprůměruje jejich výsledky a větší váhu přikládá větším a přesnějším studiím, takže kombinovaná odpověď je spolehlivější než kterákoli samostatná studie.
Plán metaanalýzy
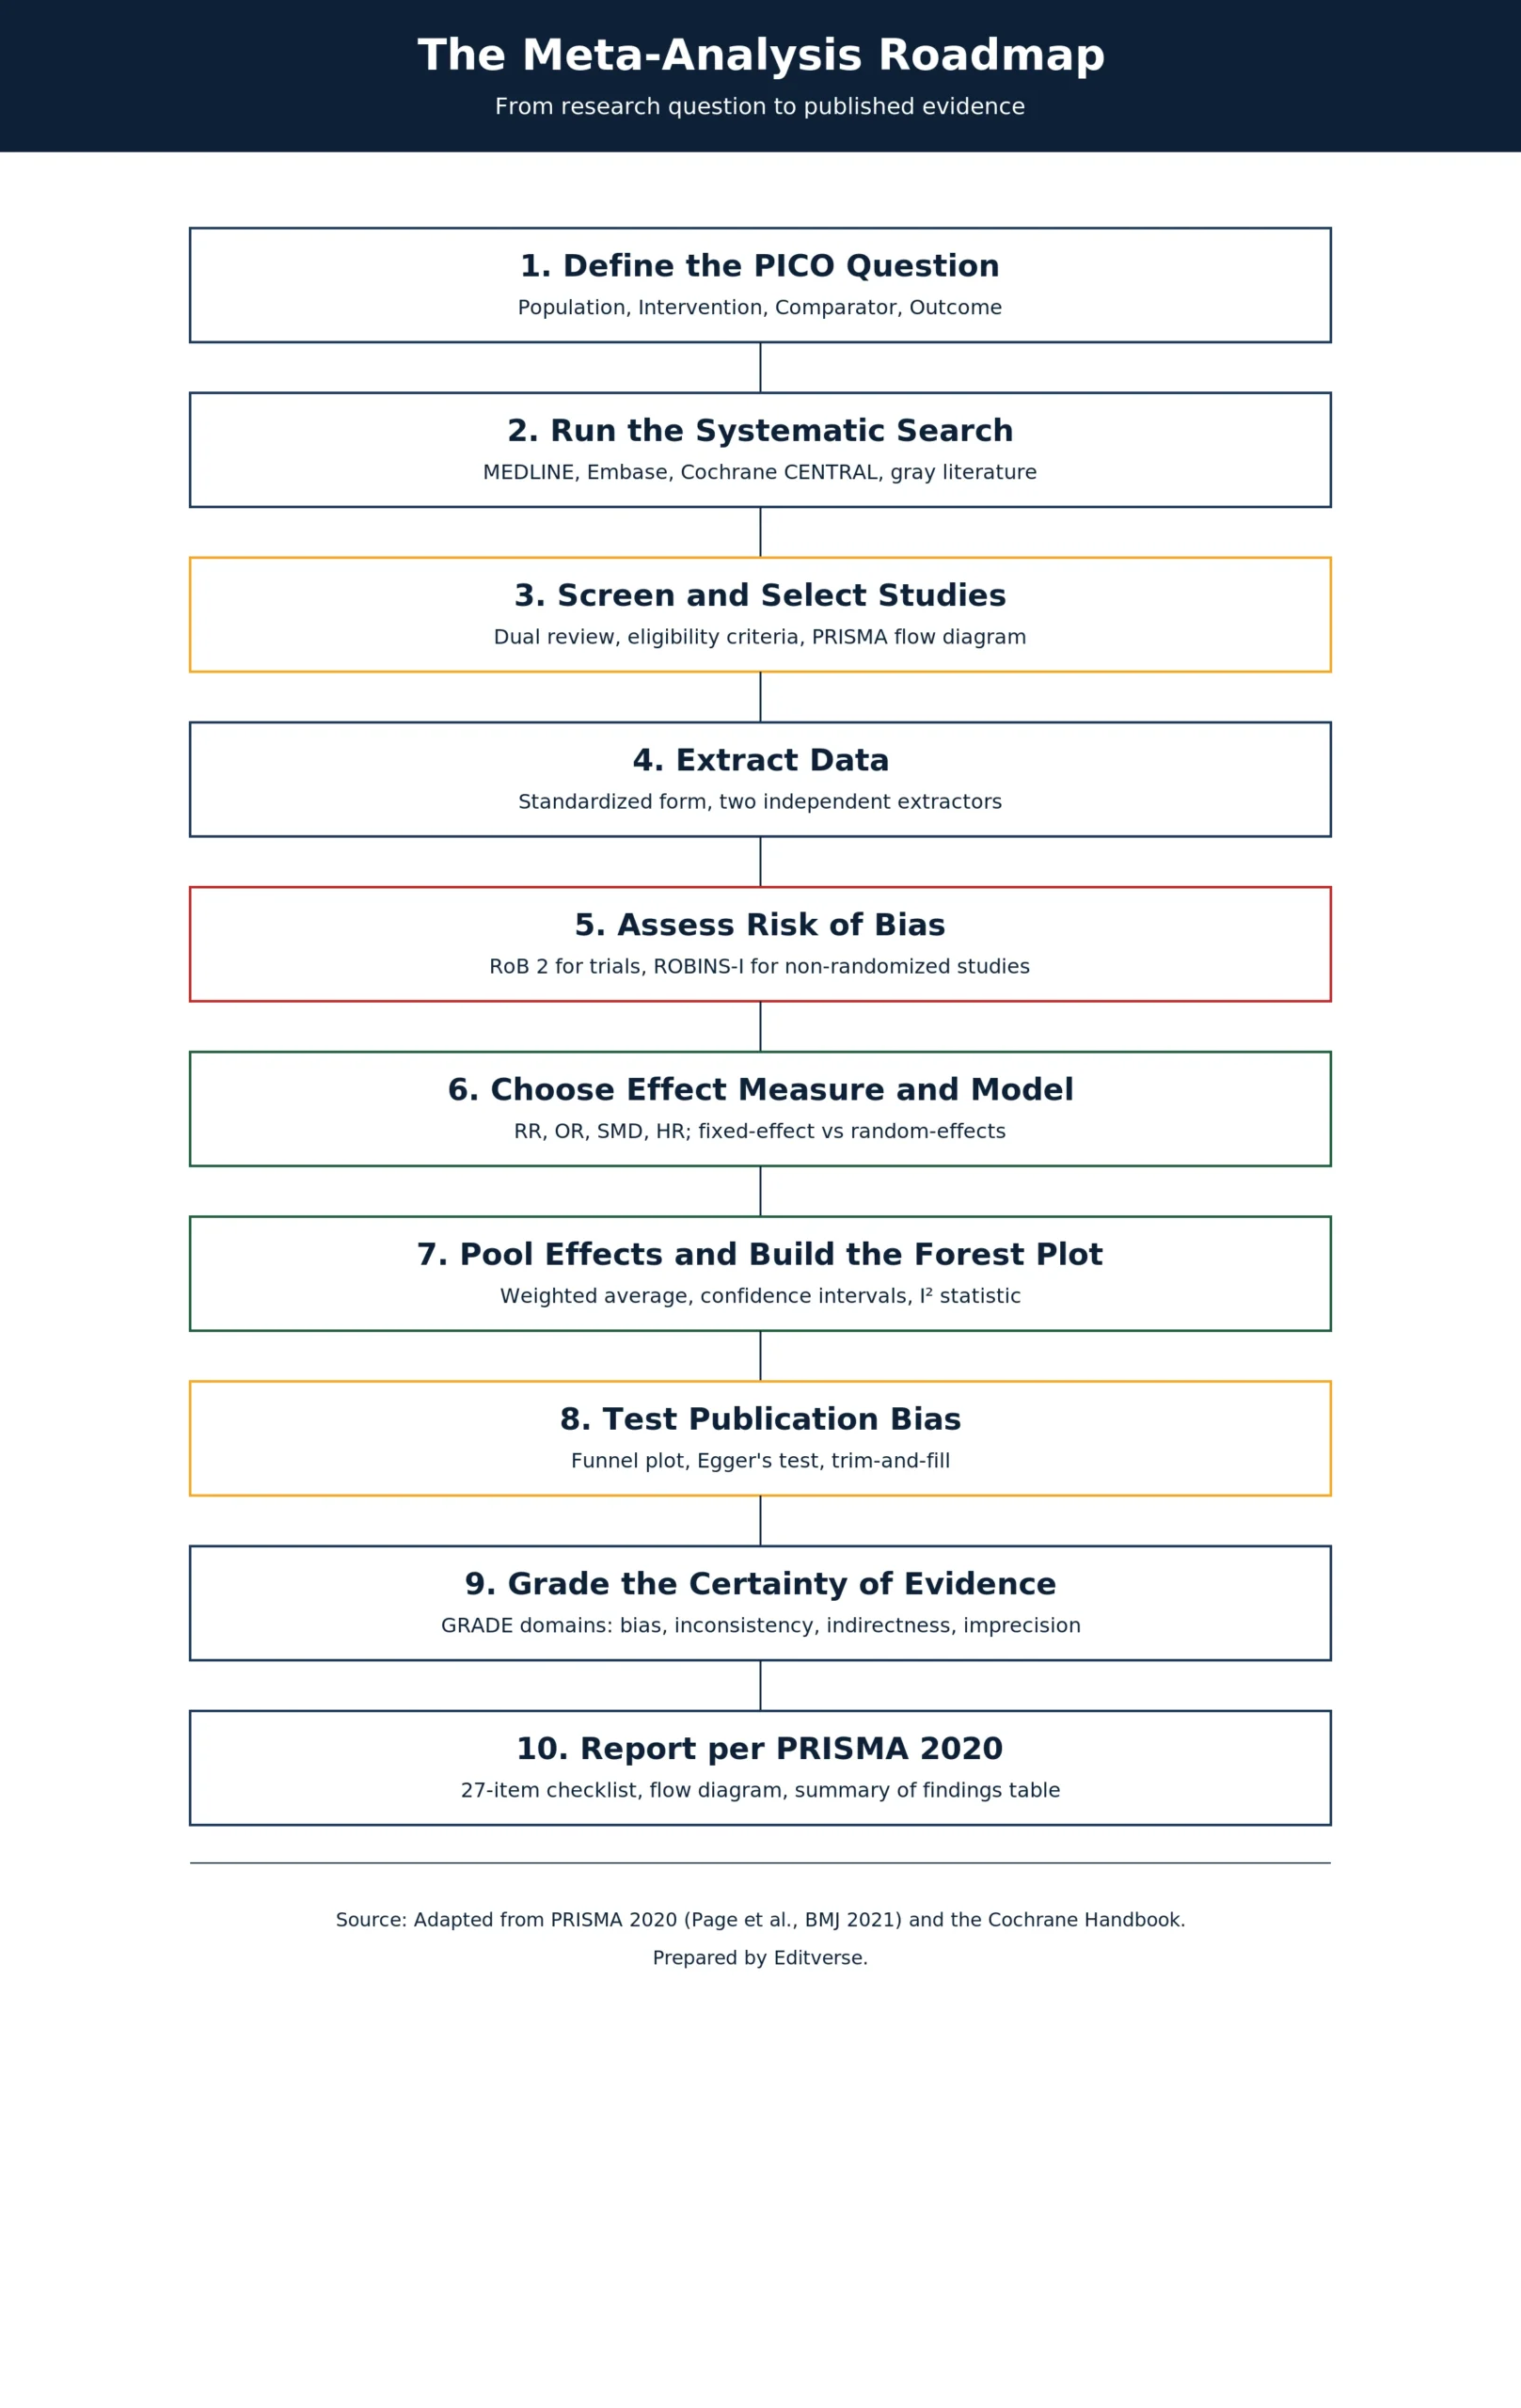
Níže uvedený vývojový diagram shrnuje celý proces do deseti kontrolních bodů. Každý z nich je krok za krokem rozveden v následujících částech.
Krok 1: Definujte svou výzkumnou otázku
Každá obhájitelná metaanalýza začíná užším záběrem, než vědci očekávají. Rámec PICO toto zúžení vynucuje. Populace identifikuje, kdo je studován, intervence nebo expozice pojmenuje léčbu nebo faktor, který je zkoumán, komparátor uvádí kontrolní podmínku a výsledek přesně určuje, co se měří. Funkční příklad zní: „Snižuje metformin ve srovnání s placebem hladiny HbA1c u dospělých s diabetem 2. typu?“ Takto specifická otázka zní, co umožňuje smysluplné kombinování studií později; vágní otázka zaručuje heterogenní a neinterpretovatelný soubor.
Než se pustíme do úplné syntézy, je vhodné provést rychlou analýzu síly metaanalýzy pravděpodobného počtu vhodných studií a jejich typické velikosti vzorku. Metaanalýza tří studií s nízkou sílou metaanalýzy bude obvykle stále s nízkou sílou metaanalýzy.
Krok 2: Spusťte systematické vyhledávání
Metaanalýza je jen tak úplná, jako je úplnost vyhledávání, které ji zaujímá. Komplexní identifikace obvykle zahrnuje databáze MEDLINE/PubMed a Embase pro biomedicínské pokrytí, Cochrane CENTRAL pro klinické studie a v případě potřeby i oborově specifické databáze, jako je PsycINFO nebo CINAHL. Šedá literatura (disertační práce, abstrakty z konferencí), registry studií, jako je ClinicalTrials.gov, seznamy literatury zahrnutých studií a přímý kontakt s autory studií doplňují vyhledávání a zachycují to, co samotné indexování databází opomíjí.
Krok 3: Prověření a výběr studií
Kritéria způsobilosti definovaná během registrace protokolu se zde uplatňují, ideálně dvěma nezávisle pracujícími recenzenty, kteří nejprve prověří názvy a abstrakty, poté plné texty všeho, co by potenciálně mohlo být způsobilým, s zdokumentovanými důvody pro každé vyloučení, nikoli zahozené. Výstupem je vývojový diagram PRISMA 2020 , který přesně ukazuje, kolik záznamů bylo identifikováno, prověřeno, vyloučeno a nakonec zahrnuto, což je nyní povinný prvek hlášení, nikoli volitelný detail. Metaanalýzy postavené na observačních, nikoli randomizovaných důkazech, se místo toho řídí paralelní konvencí vývojového diagramu MOOSE.
Krok 4: Extrakce dat
Standardizovaný formulář pro extrakci zachycuje charakteristiky studie (autor, rok, země, design, velikost vzorku, sledování), charakteristiky účastníků (věk, pohlaví, závažnost onemocnění, výchozí hodnoty), podrobnosti o intervenci (dávka, frekvence, trvání, kointervence) a samotná výsledná data, ať už se jedná o události a součty pro dichotomické výsledky nebo průměry, směrodatné odchylky a velikosti vzorků pro kontinuální výsledky. Dva recenzenti, kteří extrahují nezávisle na sobě, přičemž nesrovnalosti jsou řešeny diskusí, nikoli jednostranným úsudkem jedné osoby, zachycují chyby v transkripci, které tiše zkreslují sdružené odhady.
Krok 5: Posouzení rizika zkreslení
Nástroj musí odpovídat designu studie. Pro randomizované kontrolované studie je současným standardem nástroj Cochrane RoB 2, který v roce 2019 představili Sterne a kolegové v BMJ a který strukturuje hodnocení do pěti specifických oblastí, a to proces randomizace, odchylky od zamýšlených intervencí, chybějící data o výsledcích, měření výsledku a výběr hlášeného výsledku. U nerandomizovaných studií intervencí rozšiřuje ROBINS-I (Sterne a kol., BMJ , 2016) tuto logiku do sedmi oblastí a do seznamu přidává matoucí faktory a zkreslení výběru účastníků, protože ani jeden z nich není kontrolován randomizací. Výsledky je nejlépe prezentovat jako semaforový graf nebo souhrnnou tabulku, než aby byly skryty v textu, protože recenzenti i čtenáři je nejprve prohledají.
Krok 6: Vyberte si míru efektu
Typ výsledku určuje míru. Dichotomické výsledky vyžadují poměr rizik, pokud se základní riziko v jednotlivých studiích významně liší, poměr šancí, pokud je design studie případ-kontrola nebo analýza logistická, nebo rozdíl rizik, pokud absolutní, klinicky interpretovatelné číslo má větší význam než relativní. Kontinuální výsledky používají průměrný rozdíl, pokud každá zahrnutá studie měřila výsledek na stejné škále, nebo standardizovaný průměrný rozdíl (Cohenovo d, Hedgesovo g), pokud se škály v jednotlivých studiích liší; volný převodník velikosti účinku zpracovává aritmetiku mezi těmito formáty. Data o době do události používají poměr rizik odvozený z analýzy přežití. Metaanalýzy diagnostické přesnosti jsou zcela samostatným případem a vyžadují spíše bivariační nebo HSROC modely než jediný sdružený poměr; tento scénář pokrývá specializovaná kalkulačka diagnostických metaanalýz . Pokud je správný test nebo model skutečně nejasný, statistický selektor testů rychle zúží možnosti.
Krok 7: Výběr analytického modelu
Model s fixními efekty předpokládá, že každá zahrnutá studie odhaduje stejný jediný skutečný efekt, a je vhodný pouze tehdy, jsou-li studie funkčně identické v populaci, intervenci a prostředí; vrací užší intervaly spolehlivosti, protože předpokládá jakoukoli skutečnou variabilitu mezi studiemi. Model s náhodnými efekty místo toho předpokládá, že skutečné efekty se liší od studie ke studii z legitimních klinických nebo metodologických důvodů, vrací odpovídajícím způsobem širší a konzervativnější intervaly a je výchozí volbou v lékařském výzkumu právě proto, že klinická heterogenita napříč populacemi v rámci studie je spíše normou než výjimkou.
Krok 8: Sdružení efektů a vytvoření lesního grafu
Výběr softwaru je méně důležitý než správné nastavení modelu. RevMan zůstává bezplatným Cochranovým standardem, Komplexní metaanalýza (CMA) nabízí lépe řízené komerční rozhraní, R... meta a metafor balíčky poskytují plnou flexibilitu zdarma a uživatelé Stata obvykle sahají po metan or metaanAť už se použije jakýkoli nástroj, základní aritmetika je stejná. Vypočítejte velikost účinku pro každou studii, vážte každou podle její přesnosti, vypočítejte vážený průměr a vygenerujte kolem něj intervaly spolehlivosti. Bezplatný... kalkulačka metaanalýzy reprodukuje toto sdružování a přímo vykresluje lesní graf.
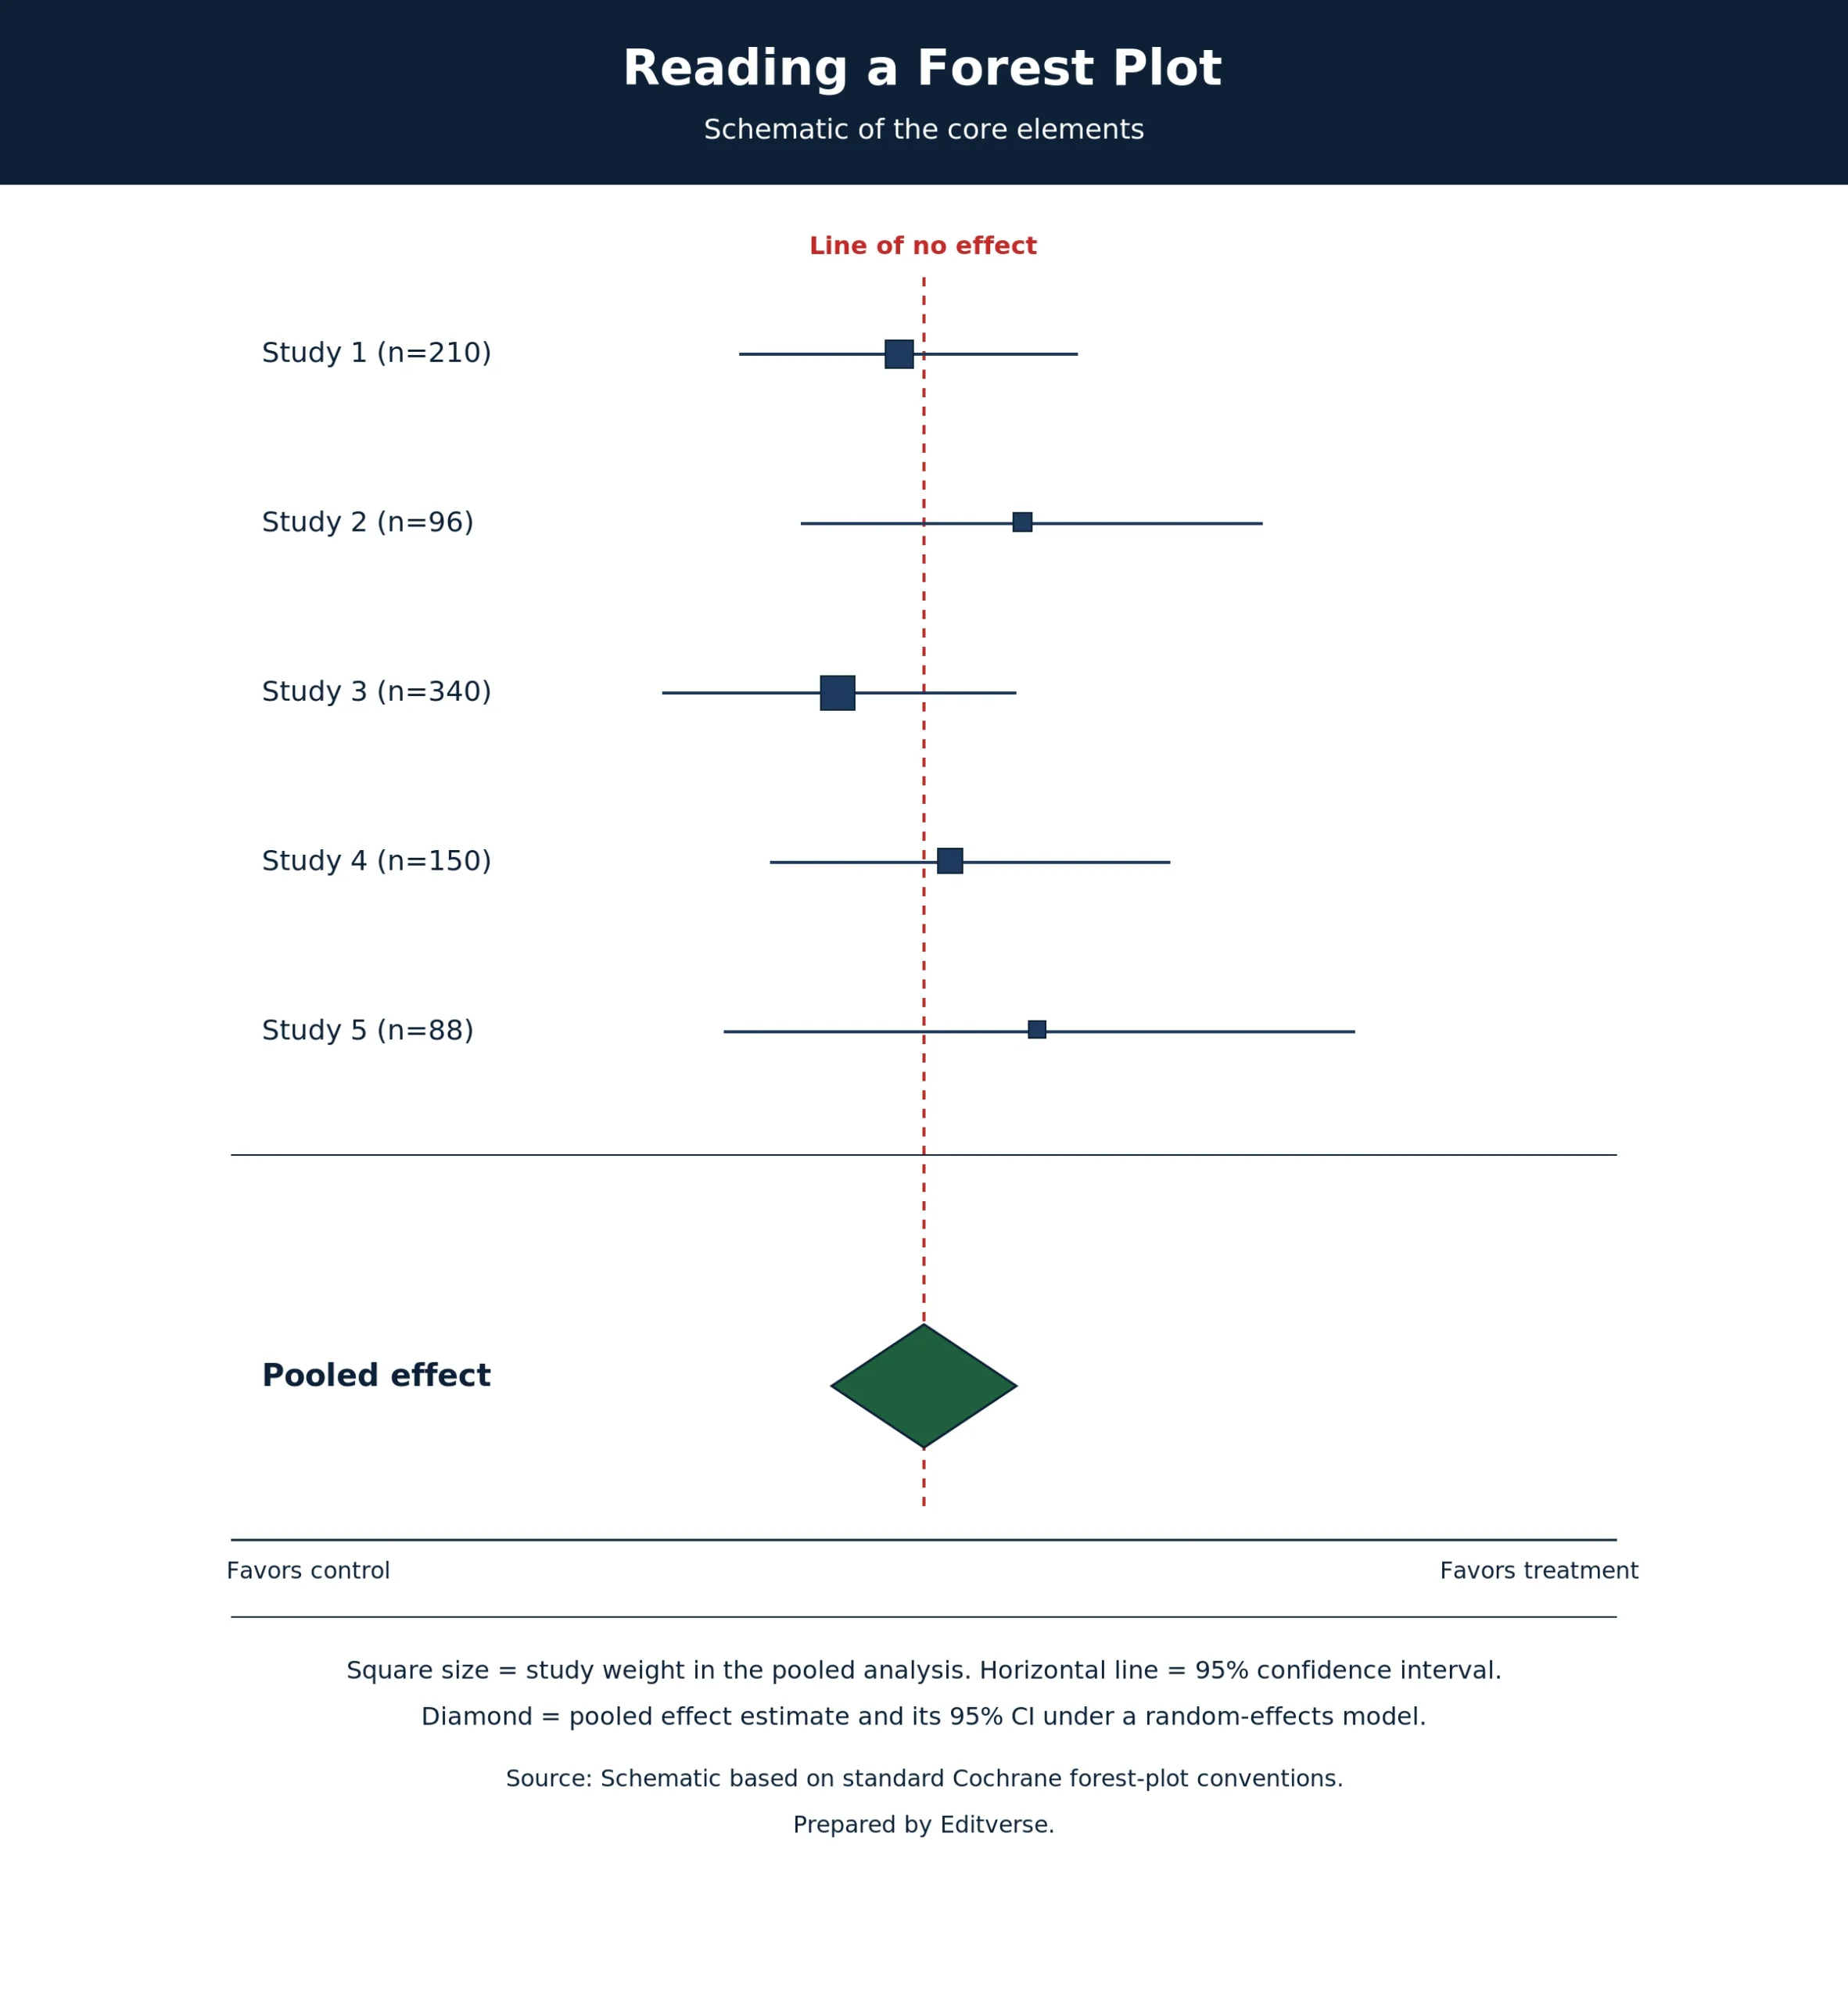
Správné čtení grafu je stejně důležité jako jeho sestavení. Čtverec každé studie se nachází ve svém bodovém odhadu, jehož velikost je úměrná jeho váze v souhrnné analýze; vodorovná čára, která jej prochází, představuje 95% interval spolehlivosti; a kosočtverec dole označuje souhrnný efekt a jeho vlastní interval spolehlivosti podle zvoleného modelu.
Krok 9: Posouzení heterogenity
Heterogenita je technický název pro neshodu mezi studiemi a Higgins, Thompson, Deeks a Altman v roce 2003 v článku BMJ zavedli pro tento obor standardní měřítko, které vyjadřuje procento celkové variability napříč studiemi, jež lze připsat skutečné heterogenitě, nikoli náhodě. Obvykle se 0 až 25 procent chápe jako nízká heterogenita, 25 až 50 procent jako střední, 50 až 75 procent jako značná a nad 75 procent jako značná. Standardní trio pro vykazování heterogenity doplňuje doprovodná Q statistika (chí-kvadrát test) a tau-kvadrát (samotná odhadovaná rozptyl mezi studiemi). Specializovaná kalkulačka heterogenity vypočítává všechny tři statistiky z extrahovaných dat ze studií. Vysoká heterogenita je podnětem k prozkoumání, ať už prostřednictvím analýzy podskupin stratifikované podle klinických nebo metodologických faktorů, metaregresního modelování potenciálních modifikátorů účinků přímo, nebo analýzy citlivosti typu „vynechej jednu studii“, která postupně vylučuje každou studii, aby se zkontrolovalo, zda jeden odlehlý údaj neovlivňuje sdružený výsledek.
Krok 10: Test publikačního zkreslení
Publikační zkreslení vzniká proto, že statisticky významné, příznivé výsledky se systematicky s větší pravděpodobností dostanou do tisku než nulové nebo nepříznivé výsledky, což zkresluje jakýkoli společný odhad sestavený pouze z toho, co bylo publikováno. Egger, Davey Smith, Schneider a Minder formalizovali standardní detekční metodu v článku BMJ z roku 1997 , regresní test pro asymetrii trychtýřového grafu, kterou publikační zkreslení produkuje; Beggův test pořadové korelace nabízí doplňkovou kontrolu. Pokud je detekována asymetrie, metoda ořezání a doplnění imputuje studie, které se zdají chybět, aby odhadla, jak by vypadal korigovaný společný efekt. Bezplatná kalkulačka publikačního zkreslení propojí trychtýřový graf a Eggerův test. Stojí za to upozornit každého spoluautora nebo recenzenta, že tyto testy mají skutečně nízkou statistickou sílu s méně než deseti zahrnutými studiemi, takže nulový výsledek z malé metaanalýzy není v žádném případě silným ujištěním.
Krok 11: Ohodnoťte jistotu důkazů
Souhrnný bodový odhad neříká nic o tom, kolik mu lze důvěřovat, což je přesně to, k čemu má formalizovat přístup GRADE, který v roce 2008 představili Guyatt a kolegové v BMJ . GRADE hodnotí celkovou jistotu v pěti oblastech, a to riziko zkreslení v přispívajících studiích, nekonzistenci (nevysvětlitelnou heterogenitu), nepřímost (jak dobře se důkazy mapují na cílovou populaci a otázku), nepřesnost (intervaly spolehlivosti dostatečně široké, aby zahrnovaly klinicky odlišné závěry) a důkazy o publikačním zkreslení. Výsledné hodnocení (vysoké, střední, nízké nebo velmi nízké) čtenáři jasně říká, zda další výzkum pravděpodobně odhad vůbec změní.
Krok 12: Nahlaste svá zjištění podle PRISMA 2020
Page a kolegové publikovali v roce 2021 v časopise BMJ aktuální standard pro podávání zpráv, PRISMA 2020, jako aktualizaci původního prohlášení z roku 2009 a jeho 27položkový kontrolní seznam je nyní základem, podle kterého editoři časopisů a recenzenti kontrolují předložený rukopis před čímkoli jiným. Zpráva v souladu s předpisy zahrnuje vývojový diagram z kroku 3, úplnou tabulku charakteristik zahrnutých studií, posouzení rizika zkreslení z kroku 5, Forestovy grafy pro každý primární výsledek, trychtýřové grafy, kde bylo posouzeno publikační zkreslení, a tabulku Souhrn zjištění s hodnocením GRADE z kroku 11. Kromě samotného kontrolního seznamu je třeba jasně uvést 95% intervaly spolehlivosti odhadů účinků, uvést statistiky heterogenity, nikoli je vynechat, pokud je to nepohodlné, otevřeně prodiskutovat omezení a klinickou interpretaci oddělit od statistické. Rukopisy, které dosáhnou této fáze, ale stále potřebují formátování, sladění s cílem časopisu nebo úplnou revizi před odesláním, jsou přesně to, co naše služby psaní rukopisů podporují.
Časté chyby, kterých se dopouštíme při recenzování rukopisů
V rukopisech, které procházejí Editverse za účelem podpory metaanalýzy, se stejná hrstka chyb opakuje dostatečně často, aby stálo za to je přímo jmenovat. Nejčastější je kombinování klinicky nebo metodologicky nekompatibilních studií pod jedním souhrnným odhadem, těsně následované hlášením statistik heterogenity, aniž by se kdy zkoumalo, co je řídí. Neshodující se míry účinků (například s použitím poměru šancí, kde by byl poměr rizik interpretovatelnější) se objevují dostatečně často, aby naznačovaly, že volba je provedena na základě výchozího nastavení softwaru, nikoli na základě typu výsledku. Zjištění podskupin jsou běžně prezentována jako potvrzující, nikoli jako signály generující hypotézu, kterými ve skutečnosti jsou, a hodnocení GRADE se vynechává častěji, než technicky umožňují směrnice časopisů. Kterákoli z těchto chyb je pravděpodobným důvodem pro žádost o zásadní revizi; více než jedna chyba dohromady je běžnou cestou k odmítnutí.
Často kladené dotazy
Kolik studií potřebuji pro metaanalýzu?
Neexistuje žádné pevné minimum a technicky lze sloučit dvě studie, ale testy heterogenity a publikačního zkreslení ztrácejí statistickou sílu pod deseti studiemi, takže výsledky z velmi malých souborů by měly být interpretovány opatrně a jako takové by měly být i hlášeny.
Jaký je rozdíl mezi systematickým přehledem a metaanalýzou?
Systematický přehled je reprodukovatelný proces identifikace, screeningu a hodnocení všech relevantních studií k dané otázce. Metaanalýza je statistická technika používaná v rámci tohoto procesu, která sdružuje kvantitativní výsledky studií do jednoho odhadu. Ne každý systematický přehled obsahuje metaanalýzu; metaanalýza mimo proces systematického vyhledávání není obhajitelná.
Mám použít model s fixními efekty, nebo s náhodnými efekty?
Studie s náhodnými efekty jsou pro lékařský a zdravotnický výzkum standardem, protože klinické a metodologické rozdíly mezi studiemi jsou očekávanou normou. Studie s fixními efekty je obhajitelná pouze tehdy, jsou-li zahrnuté studie funkčně téměř identické.
Co znamená I² 60 %?
To znamená, že 60 % celkové variability napříč odhady účinků vašich sdružených studií lze připsat skutečné heterogenitě mezi studiemi spíše než náhodě, což spadá do značného rozmezí a mělo by vést k analýze podskupin nebo citlivosti předtím, než bude sdružený odhad uveden jako hlavní nález.
Jaký software bych měl použít k provedení metaanalýzy?
RevMan je zdarma a je Cochranovým vlastním standardem; R's meta a metafor Balíčky jsou zdarma a vysoce flexibilní; Komplexní metaanalýza (CMA) a Stata jsou placené možnosti, které jsou preferovány pro svá řízená rozhraní. Všechny čtyři zvládají sdružování fixních a náhodných efektů, lesní grafy a standardní statistiky heterogenity.
Získejte odbornou podporu pro vaši metaanalýzu
Důkladná metaanalýza čerpá ze statistických znalostí a metodologické disciplíny v každém z dvanácti výše uvedených kroků a recenzenti z časopisů s vysokým impaktem kontrolují každý z nich. Náš tým podporuje návrh protokolů a studií, vývoj formulářů pro extrakci dat, statistickou analýzu v R, Stata nebo RevMan, generování lesních a trychtýřových grafů, hodnocení GRADE a psaní a revize rukopisů až po jejich odevzdání. Prozkoumejte naši službu psaní systematických přehledů a metaanalýz nebo nás kontaktujte pro bezplatnou konzultaci.
Reference
- Page MJ, McKenzie JE, Bossuyt PM a kol. Prohlášení PRISMA 2020: aktualizované pokyny pro hlášení systematických přehledů. BMJ. 2021;372:n71. https://doi.org/10.1136/bmj.n71
- Sterne JAC, Savović J, Page MJ a kol. RoB 2: revidovaný nástroj pro posouzení rizika zkreslení v randomizovaných studiích. BMJ. 2019;366:l4898. https://doi.org/10.1136/bmj.l4898
- Sterne JA, Hernán MA, Reeves BC a kol. ROBINS-I: nástroj pro posouzení rizika zkreslení v nerandomizovaných studiích intervencí. BMJ. 2016;355:i4919. https://doi.org/10.1136/bmj.i4919
- Higgins JPT, Thompson SG, Deeks JJ, Altman DG. Měření nekonzistence v metaanalýzách. BMJ. 2003; 327: 557-560. https://doi.org/10.1136/bmj.327.7414.557
- Egger M, Davey Smith G, Schneider M, Minder C. Zkreslení v metaanalýze detekované jednoduchým grafickým testem. BMJ. 1997; 315: 629-634. https://doi.org/10.1136/bmj.315.7109.629
- Guyatt GH, Oxman AD, Vist GE a kol. GRADE: vznikající konsenzus ohledně hodnocení kvality důkazů a síly doporučení. BMJ. 2008; 336: 924-926. https://doi.org/10.1136/bmj.39489.470347.AD
- Cochrane Handbook pro systematické přehledy intervencí. https://training.cochrane.org/handbook
Recenzováno výzkumným podpůrným týmem Editverse s využitím zkušeností s podporou systematických přehledů a metaanalýz rukopisů napříč biomedicínskými a klinickými obory. Poslední aktualizace: červenec 2026.