发布日期:|最后更新日期
PRISMA流程图(PRISMA 2020流程图)记录了系统评价检索到的文献数量、筛选结果、排除的文献数量以及纳入和排除的原因。每个方框中的数据都必须与其前一个方框中的数据相符。本指南提供了可供选择的模板、每个流程图必须满足的五条计算规则,以及一个示例:一篇已发表的评价,其所有方框中的数据均正确无误。
用简单的话
从四个 PRISMA 2020 模板中选择一个。在每个方框中填写计数。检查每个计数是否等于前一个方框的计数减去你移除的计数。确保摘要、方法和结果部分都包含相同的数字。
您需要哪种PRISMA 2020流程图模板?
PRISMA 2020(Page 等人,2021)提供了四个模板。请根据两个问题进行选择:这是一篇新的综述还是一篇更新的综述?您是否仅检索了数据库和注册库,还是也检索了其他来源,例如网站、组织和引文检索?
| 意见或建议 | 版型 | 它增加了什么 |
|---|---|---|
| 仅限新评论、数据库和注册表 | 模板1 | 从数据库和登记册中识别、筛选和纳入 |
| 新增评论,以及其他搜索方法 | 模板2 | 第二栏用于网站、组织和引文检索 |
| 仅更新评论、数据库和注册表 | 模板3 | 先前版本的研究结果已纳入总数 |
| 更新后的评论,以及其他搜索方法 | 模板4 | 以上两种 |
官方模板可在PRISMA 网站上找到。如果您更喜欢输入数字并导出图形,PRISMA2020 Shiny 应用程序(Haddaway 等人,2022 年)和 Editverse Flowchart Pro(链接如下)均可实现此功能。
每个 PRISMA 流程图都必须满足以下五条规则
流程图本质上是算术运算。审稿人和编辑在阅读方法部分之前,都会用计算器核对流程图。这五条规则几乎可以发现所有错误。
| 违反的规则 | 算术 | 检查地点 |
|---|---|---|
| 1. 已筛选 | 已识别记录数 – 筛选前已移除的记录数 = 已筛选记录数 | 识别箱到筛查箱 |
| 2. 寻求 | 已筛选记录 – 已排除记录 = 待检索报告 | 标题和摘要阶段 |
| 3. 已评估 | 已索取报告 – 未获取报告 = 已评估报告的资格 | 回收阶段 |
| 4. 包括 | 已评估报告数 – 已排除报告数(附排除理由)= 已纳入研究数。排除理由之和必须等于已排除报告数。 | 全文阶段 |
| 5。 资料来源 | 每个数据库的重复项数量之和等于已识别重复项总数;每个数据库的重复项数量之和等于已移除重复项总数。 | 识别盒 |
然后检查文本。图表中的数字必须与摘要、方法和结果部分中的数字完全一致。图表与文字不符是编辑最常遇到的问题之一。
示例:一篇已发表的评论,其中每个方框都相互吻合
例如,Lidströmer 等人 (2024) 发表于《自然通讯》( Nature Communications)的系统评价和荟萃分析,已在 PROSPERO 注册(CRD42022342597)。作者检索了七个数据库和注册库,由两位审稿人进行筛选,并由第三位审稿人进行仲裁,同时还使用了 Rayyan 进行筛选。他们的流程图如下所示,并遵循 CC BY 4.0 许可协议。
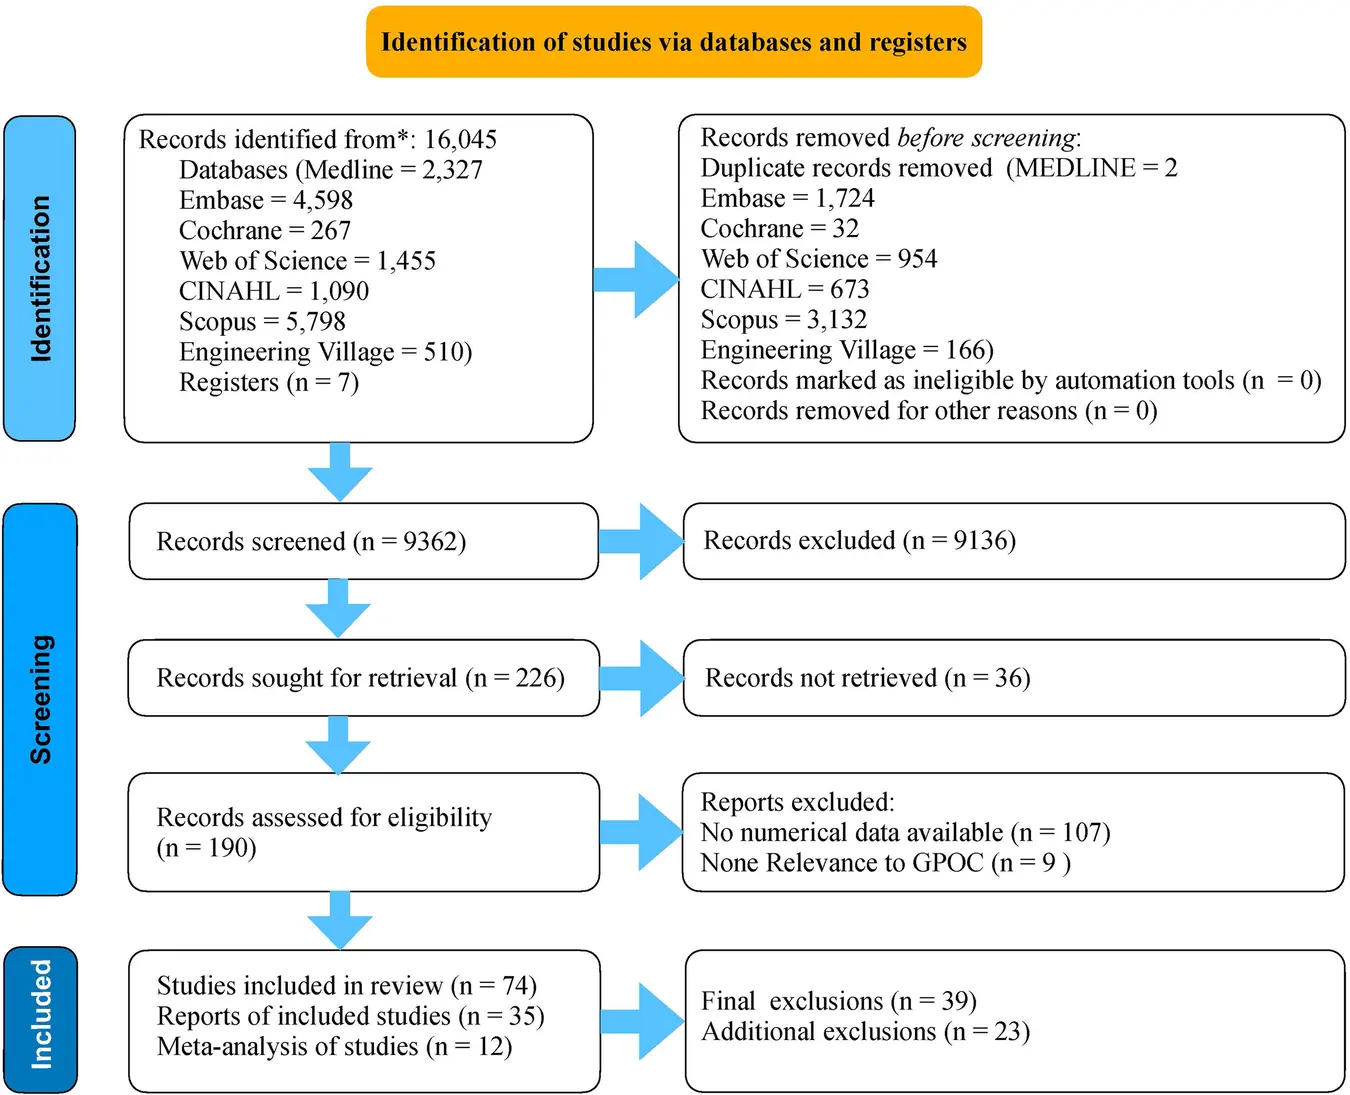
现在将这五条规则应用于图中的数字。每一行都符合要求。以下所有总和均分别使用 R 和 Python 独立计算得出。
| 违反的规则 | 图中的数字 | 成果 |
|---|---|---|
| 5. 资料来源(已确定) | 来自七个数据库的数据为 2,327 + 4,598 + 267 + 1,455 + 1,090 + 5,798 + 510 = 16,045。该数字还列出了 7 条登记记录。 | 数据库中的数据与总数 16,045 条相符;但有 7 条登记记录不在其中(见下文)。 |
| 5. 来源(重复项) | 2 + 1,724 + 32 + 954 + 673 + 3,132 + 166 = 6,683 个重复项;0 个由自动化工具生成;0 个因其他原因生成 | 6,683 已移除 |
| 1. 已筛选 | 16,045-6,683 = 9,362 | 筛选了 9,362 场比赛 |
| 2. 寻求 | 9,362 – 9,136(已排除)= 226 | 共搜索到 226 个匹配项 |
| 3. 已评估 | 226 – 36 未检索 = 190 | 已评估的比赛 190 场 |
| 4. 包括 | 190 – 107(无数值数据) – 9(无关) = 74 | 匹配 74 项研究;理由总计 116 条 |
| 最终盒子 | 最后一个方框列出了 74 项研究、35 份报告和 12 项荟萃分析研究。侧边栏列出了 39 项最终排除研究和 23 项额外排除研究。74 – 39 = 35,35 – 23 = 12 | 虽然协调一致,但侧边栏标签没有说明每项排除项适用于哪个计数。 |
如何解读?在筛选的9,362条记录中,只有226条(2.4%)达到了全文检索标准,其中190条进行了评估。这对于广泛检索来说是正常的:大多数记录仅停留在标题和摘要阶段。该图表的可信度在于,读者可以根据前一个方框重建每个方框。另请注意,重复项是按数据库分类的,这使得其他团队可以复现去重过程。
即使是细心的读者也会对此提出疑问。这张已发布的图表中的两个细节表明,一些细微的标签选择会引发疑问。首先,16,045 条记录的总数仅相当于七个数据库,因此这 7 条登记记录既不在总数之内,也不在已筛选的 9,362 条记录之内。读者无法判断这些记录是否经过筛选。应该说明登记记录的去向:是将其添加到已确定的总数中,还是说明它们被单独处理。其次,最后一个侧边栏给出了两个排除计数,但没有说明它们分别属于哪个阶段。应该在每个排除项旁边标注它所减少的计数。

需要我们为您制作流程图吗?请发送您的筛查计数,我们将使用正确的模板为您生成一份 PRISMA 2020 流程图,并在每个阶段核对您的数字。
逐盒详解:PRISMA 2020 的每个盒子里都装了些什么?
识别。输入从每个数据库和注册表中识别出的记录。尽可能列出每个来源的记录数量。然后,在三行中分别记录筛选前移除的内容:重复项、自动化工具标记为不合格的记录以及因其他原因移除的记录。如无适用项,则填写 0,如示例所示。
筛选。筛选出的记录和排除的记录各计1例,不说明理由。接下来,统计已检索到的报告和未检索到的报告。然后,评估报告的资格。
排除的报告及其原因。请为每组排除的全文提供具体原因,并确保排除原因的数量之和等于排除总数。例如,107 份报告缺少数值数据,9 份报告与评审问题无关。请使用与您预先设定的资格标准相关的理由,而非笼统的语句。
已纳入。请列出新增的研究及其报告。一项研究可能包含多份报告,因此这两个数字可能有所不同。更新后的综述会添加从先前版本中沿用的研究。
记录与报告。记录是指数据库中的标题或摘要条目。报告是指描述一项研究的文档:期刊文章、预印本、会议摘要、注册登记条目或临床研究报告。将它们分开计数是与 2009 年图表相比的主要结构变化。
如何根据筛选电子表格构建图表
最后再画图形。先列出数字,在跟踪表中,每行记录一条记录,这样每个方框都是筛选计数,而不是手动计数。
- 出口并贴标。 为每条记录分配一个唯一的 ID 和一个来源列(MEDLINE、Embase、注册名称)。标识框中显示的每种来源的计数即为该列的计数。
- 在同一位置进行去重。 标记重复项并注明其来源,而不是删除行。该标记可提供每个数据库的重复项计数,并确保删除操作可审计。
- 添加阶段列。 使用固定值:重复项、标题和摘要已排除、未检索、全文已排除、已包含。每一行都只包含一个阶段,因此各阶段计数之和必须等于已识别的总数。
- 添加全文排除原因列。 每个报告使用一个理由,该理由可从您的方案中列出的列表中选择,并进行统计。
- 将这五条规则作为公式运行。 将规则表中的五个减法算式放在你的计数旁边。任何与下一个方框不相等的单元格都是错误,需要在绘图前修正。
- 根据计数结果抽取样本。 将数字输入到官方模板或 PRISMA2020 应用程序中,然后再次将数字与表格进行比较。
示例中使用的筛选软件 Rayyan 会导出这些决策,但请务必将其计数与您自己的表格进行核对:不同的工具对记录的计数和报告方式可能有所不同。如果您使用机器学习分类器或其他自动化工具删除了记录,请在指定框(第 8 项)中填写工具名称及其删除的记录数量。
稿件中还有哪些地方需要出现这些数字?
流程图是PRISMA 2020第16a项的一部分,该项要求您描述检索和筛选过程的结果,从识别出的记录到最终纳入的研究,最好附上流程图。第16b项要求您引用那些看似符合纳入标准但最终被排除的研究,并解释原因。第8项要求您报告每条记录和报告的审阅者人数、他们是否独立工作以及使用了哪些自动化工具。第7项涵盖检索策略。这些项目在PRISMA 2020的解释和阐述文件(Page等人,2021)中提供了示例。
首先注册您的研究方案,才能确保所有数据都具有可信度。请参阅我们的PROSPERO 注册指南,以及医学论文各章节对应的报告指南,请参阅《医学论文报告指南》。
五个容易引起审阅者意见的PRISMA流程图错误
- 总计不符。 在绘制任何内容之前,请先将这五条规则应用到您自己的电子表格中。
- 排除理由无法汇总。 排除原因的数量必须等于全文阶段排除的报告数量。
- 混合记录和报告。 给每个盒子贴上标签,标明它统计的是什么:“记录”代表数据库条目,“报告”代表文档。
- 使用 2009 年的图表。 如果您遵循 PRISMA 2020,请使用 2020 年的四个模板之一,包括筛选前的三个删除行。
- 更新时选错了模板。 更新后的审查使用模板 3 或 4,而不是模板 1 或 2。
适用于 PRISMA 流程图的免费研究工具
Editverse提供的免费研究工具
为符合PRISMA标准的系统评价提供专业支持
以下每个软件包都会生成审核人员首先要检查的文件:包含去重计数的已记录搜索结果、已注册的协议以及用于核对数据的流程图。相关领域的专家和信息专家按照 PRISMA 2020 标准开展工作。
正在撰写评论?请参阅稿件撰写服务。Editverse 的实践符合 COPE、ICMJE 和 GPP 2022 标准。
结语
PRISMA流程图通过精确的计算赢得信任:五条规则、一个模板,以及与文本相符的数字。示例展示了在已发表的真实综述中,如何将16,045条记录筛选至74项研究,并且每个方框都与前一个方框的内容相符。选择合适的模板,将规则应用于您自己的统计,并在提交前将图表与您的摘要进行核对。
常見問題解答
什么是PRISMA流程图?
PRISMA流程图(正式名称为PRISMA 2020流程图)展示了系统评价识别、筛选、排除和纳入的文献数量,以及全文排除的原因。该流程图在PRISMA 2020清单的第16a项中报告。
PRISMA 2009 和 PRISMA 2020 流程图有什么区别?
PRISMA 2020 将记录(数据库条目)与报告(文档)分开,增加了用于标记因重复、自动化工具或其他原因在筛选前移除的记录的方框,并提供了四种模板:新建或更新的审核,每种模板都包含或不包含其他搜索方法。2009 版流程图只有一个模板,并且没有区分自动化和报告。
PRISMA 2020 清单中有多少项?
PRISMA 2020 清单共有 27 个项目。流程图支持第 16a 项,第 16b 项要求您引用看似符合条件但被排除在外的研究,并说明原因。
我是否需要提供标题和摘要筛选中排除记录的原因?
不。PRISMA 2020 仅要求提供全文评估中排除的报告的理由。标题和摘要排除栏只计入一次。
记录和报告有什么区别?
记录是指数据库或注册表中的标题或摘要条目。报告是描述研究的文档,例如期刊文章、预印本、会议摘要或注册表条目。一项研究可能包含多份报告,因此最后一个方框分别列出了研究和报告。
更新系统评价时应该使用哪个模板?
如果更新仅检索了数据库和注册表,请使用模板 3;如果还检索了网站、组织或引用,请使用模板 4。更新后的综述模板会添加一些框,用于存放从先前版本继承的研究。
PRISMA 2020 是否要求双重筛选?
第 8 项要求您报告每份记录和报告的审阅者人数、他们是否独立工作以及使用的任何自动化工具。独立双重审阅是常见做法,但声明中并未强制要求。
如果我无法检索到某些全文怎么办?
请在“未检索报告”框中填写未检索报告的数量。在示例中,226 份报告中有 36 份无法检索,因此剩余 190 份报告用于资格评估。
我可以使用官方模板还是生成器?
是的。PRISMA 网站提供了四种模板,PRISMA2020 Shiny 应用可以根据您提供的数据生成符合规范的流程图。Editverse 的 Flowchart Pro 也支持在浏览器中免费创建 PRISMA 2020 流程图。
案例
- Page MJ、McKenzie JE、Bossuyt PM 等。PRISMA 2020 声明:系统评价报告指南更新。BMJ。2021;372:n71。doi:10.1136/英国医学杂志.n71
- Page MJ、Moher D、Bossuyt PM 等。PRISMA 2020 解释和阐述:系统评价报告的更新指南和示例。BMJ。2021;372:n160。doi:10.1136/英国医学杂志.n160
- Haddaway NR、Page MJ、Pritchard CC、McGuinness LA. PRISMA2020:用于生成符合 PRISMA 2020 标准的流程图的 R 包和 Shiny 应用程序。Campbell Syst Rev. 2022;18(2):e1230。doi:10.1002/cl2.1230
- Lidströmer N、Davids J、ElSharkawy M、Ashrafian H、Herlenius E. 全球患者共同拥有云(GPOC)的系统评价和荟萃分析。Nat Commun. 2024;15:2186。doi:10.1038/s41467-024-46503-5
示例图根据 CC BY 4.0 许可从参考文献 4 中复制。算术运算分别在 R 和 Python 中独立完成。