发布日期:|最后更新日期
卡方检验回答一个特定问题:观察到的各类别计数是否与独立性假设或既定模型预测的结果存在差异?卡尔·皮尔逊于1900年引入了卡方检验,流行病学家至今仍每周使用它来比较不同人群的暴露率、筛查基因型数据中的错误,以及检验疾病发病是否具有季节性聚集性,而非全年均匀分布。其他关于此主题的指南往往只是复述公式,仅此而已。而本指南则需要手动处理两个列联表,每个数值都需与独立的统计软件进行比对,并详细解释卡方近似何时不再可靠,此时应改用费舍尔精确检验。
关键精华
- A 卡方检验 使用统计量 χ² = Σ(O − E)² / E 将观察到的类别计数与零模型下的预期计数进行比较。
- 此 独立性卡方检验 检查两个分类变量是否相关; 拟合优度检验 检查一个变量的分布是否符合假设的模式。
- 自由程度 对于列联表,其值为(行数 - 1)×(列数 - 1);对于拟合优度,其值为类别数减 1,再减去从数据中估计的任何参数。
- 科克伦1954年的指导原则认为,预期计数低于5的细胞比例不应超过20%,且任何细胞的预期计数都不应低于1。越过这条界限, 费舍尔精确检验 成为更安全的选择。
- 显著的卡方检验结果表明存在关联。关联强度是另一个问题,需要用比值比、相对风险或克莱默V系数来回答,而不能仅凭p值来判断。
用简单的话
假设有两组患者,一组接受治疗,另一组未接受治疗,治疗结果只有“是”或“否”,例如是否康复。卡方检验旨在检验两组患者的康复情况是否相同,或者是否存在显著差异。它首先建立一个包含计数的表格,计算出如果治疗完全无效,这些计数应该是多少,然后衡量实际计数与预期计数之间的偏差程度。实际计数与预期计数之间的差距越大,p 值越小,表明治疗与康复结果之间可能存在真正的关联。而差距越小,则表明表格中的模式很可能只是偶然现象。
在信任结果之前,有两个关键因素需要考虑。首先,每个类别必须真正独立,因为同一患者不能计数两次;其次,大多数单元格的预期计数必须至少达到 5。对于小样本,则需要使用Fisher 精确检验,本指南稍后会详细介绍。
什么是卡方检验?
统计学家将卡方检验方法归为一类,它们都具有一个共同特征:当零假设为真且样本量充足时,每个检验统计量都服从卡方分布。这类方法中的两种几乎涵盖了研究人员在实践中遇到的所有应用场景。卡方独立性检验针对同一受试者测量的两个分类变量(例如治疗组和临床结果),检验其中一个变量的值是否能预测另一个变量的值。卡方拟合优度检验则针对单个分类变量,检验其观测分布是否与预先指定的分布相符,例如均匀分布于四季或符合孟德尔遗传比例。
在这两种方法之间进行选择,以及在卡方检验和完全不同的其他检验方法之间进行选择,取决于数据的收集方式和所提出的问题。仍在犹豫卡方检验是否适合自身数据的读者,可以在继续阅读之前,先使用Editverse 的交互式检验选择器或统计检验流程图进行评估。
两种卡方检验方法都基于相同的统计量。
χ² = Σ (O − E)² / E
O 代表类别或单元格中的观测计数,E 代表零假设下的预期计数,求和遍及表格中的每个单元格。平方差值会消除符号,因此高估和低估都会使统计量增大;除以 E 则将每个平方差值相对于该单元格的实际预期计数进行缩放。预期容纳 200 个观测值的单元格可以轻松容纳 10 个观测值的偏差。预期容纳 5 个观测值的单元格则无法容纳,而除以 E 的结果直接反映了这一点。
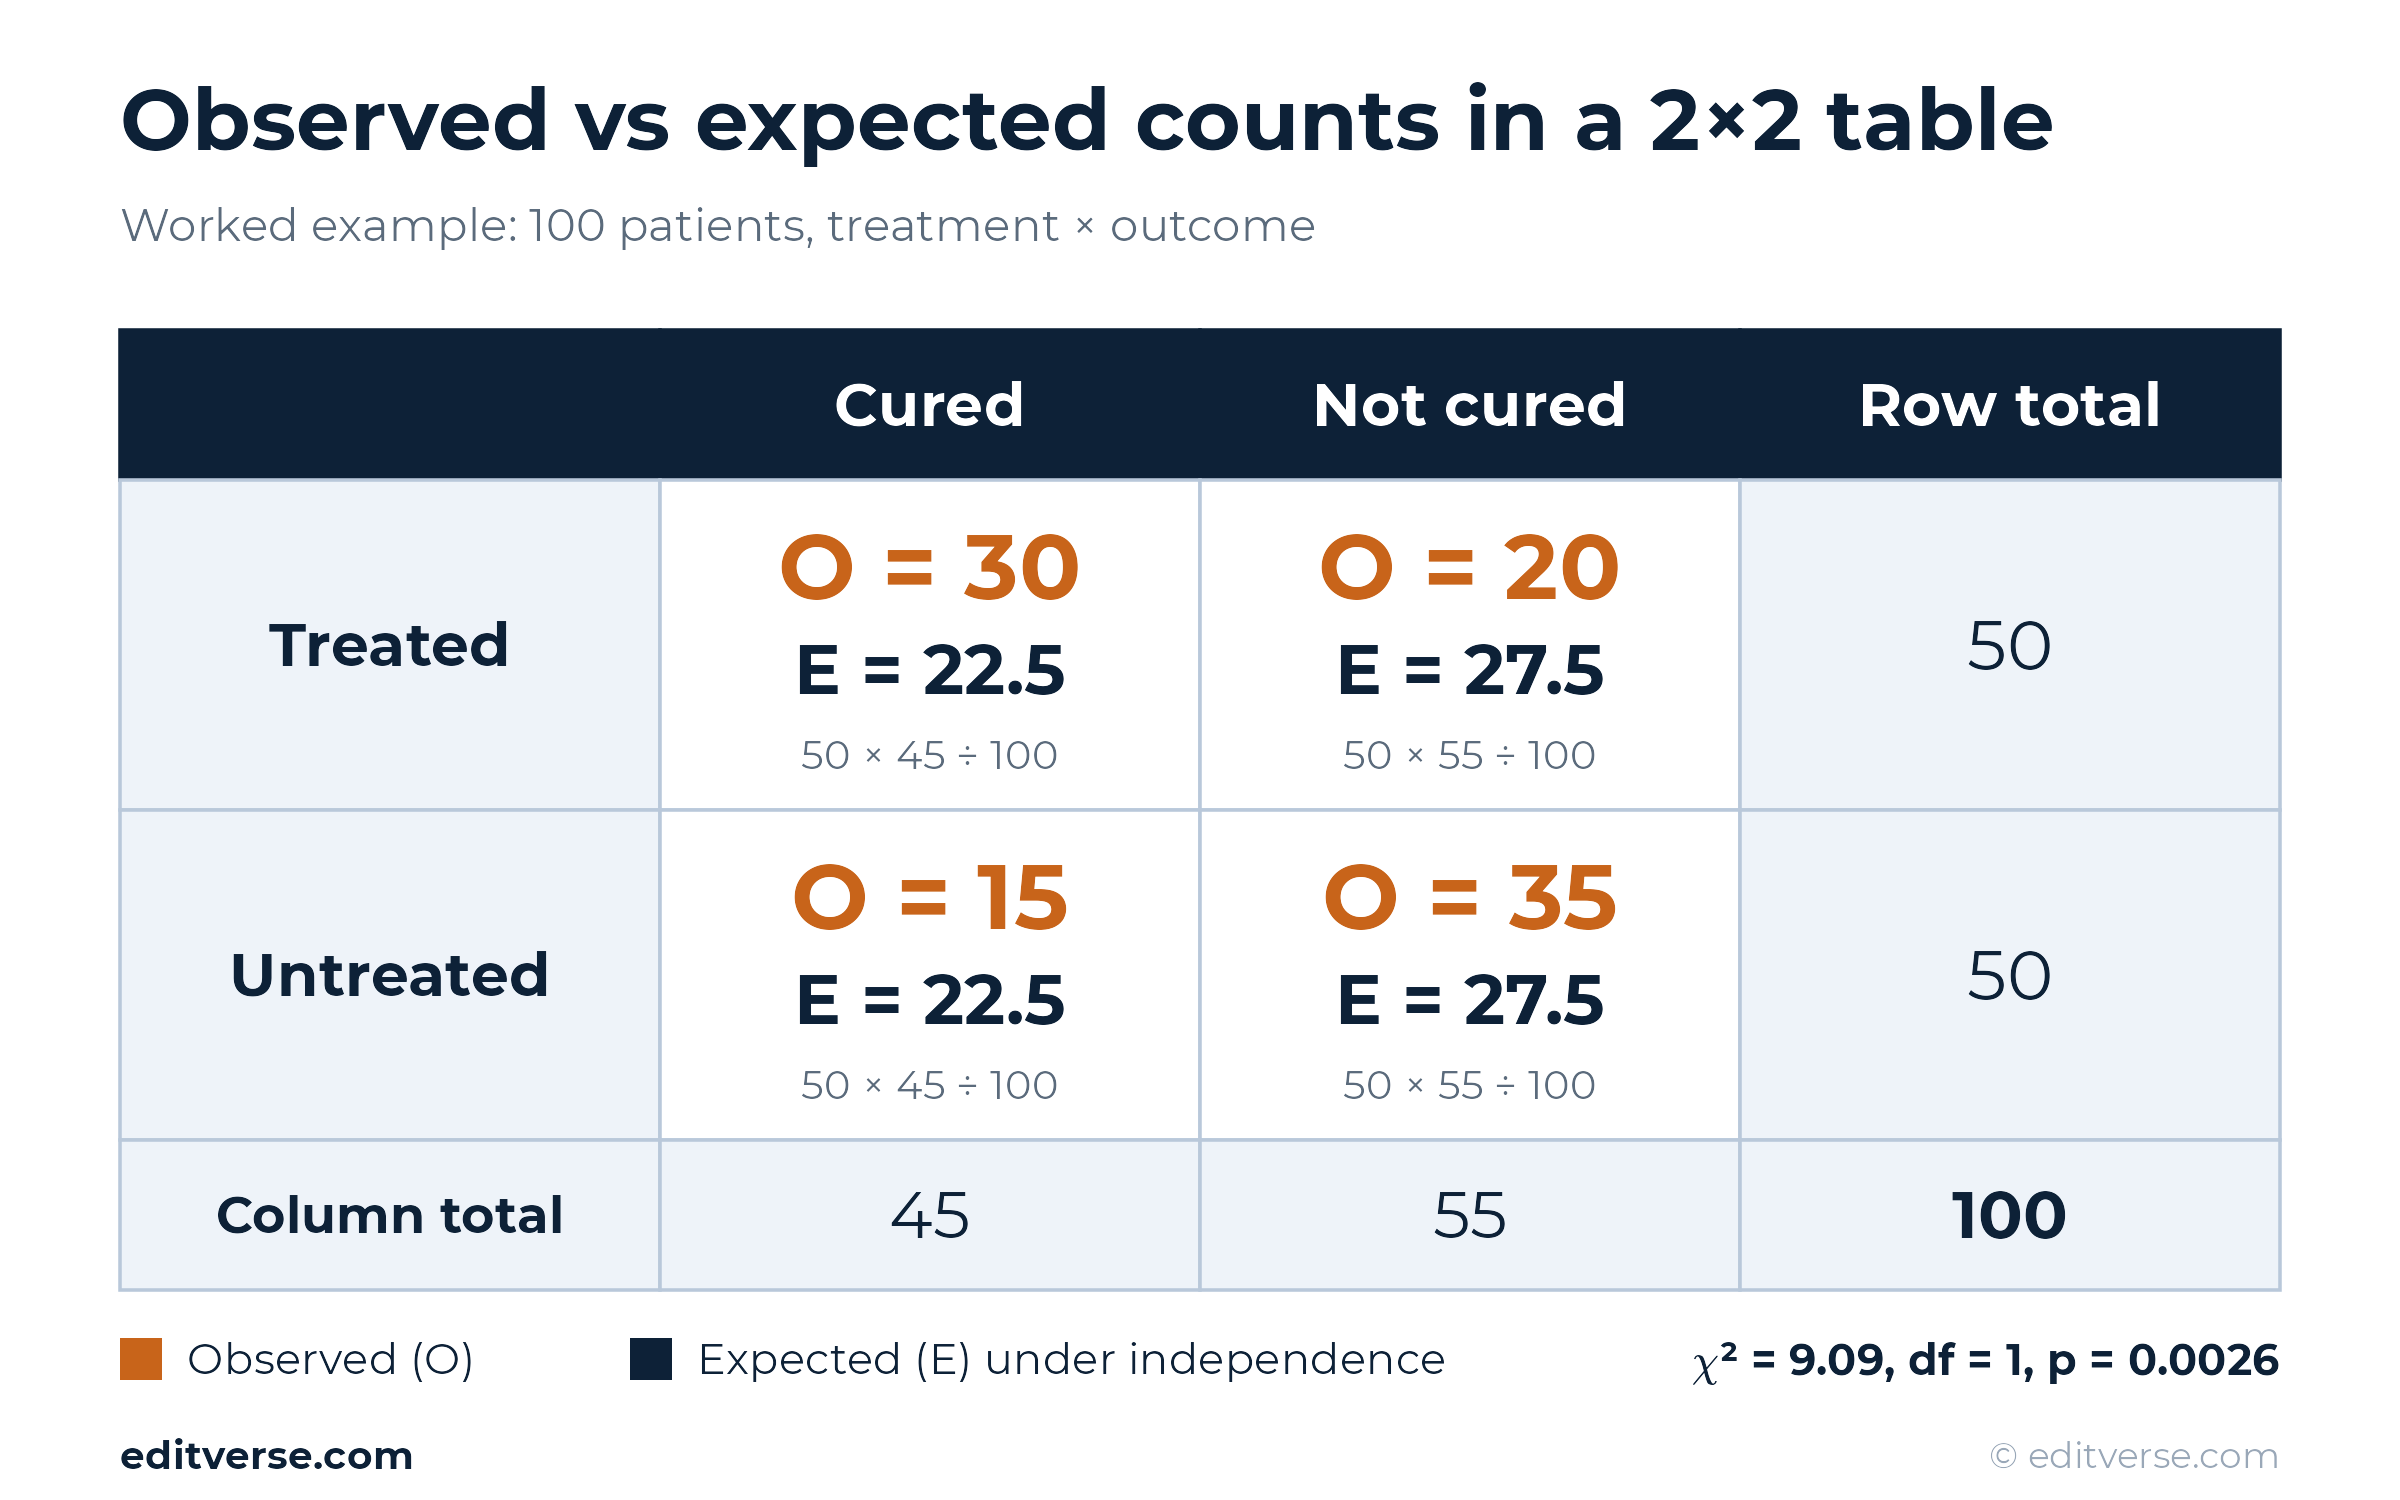
卡方检验统计量的计算方法
期望频数来源于零假设,而非为了方便而随意选取的整数。在列联表中,任何单元格的期望计数等于其所在行的总数乘以其所在列的总数,再除以总和。该公式直接源于独立性假设。如果两个变量之间确实没有任何关联,那么某一列中对应行的元素比例应该与该行在整个列联表中的元素比例相符。
一个简单的例子可以更具体地说明这一点。假设100名患者分为50名接受治疗和50名未接受治疗两组,分别计算出100名患者中45名被判定为治愈,55名被判定为未治愈。在相互独立的情况下,接受治疗组的治愈率应该与未接受治疗组相同,均为45%,因此接受治疗组中治愈患者的预期人数为50 × 45 ÷ 100,即22.5。预期人数不必是整数,只有实际观察到的人数才是整数。
拟合优度预期计数的工作原理相同,但它基于假设的比例,而不是第二个变量。例如,检验 200 例疾病发作是否均匀分布在四个季节,则每个季节的预期计数设定为 200 × 0.25,即 50,然后检验实际的季节性计数与该水平线的偏差程度。
卡方检验中的自由度
自由度决定了卡方分布的形状。在撰写结果部分时,很容易忽略自由度值不匹配的问题,但它会改变统计量所参照的临界值,并可能导致原本接近显著的结论变为不显著,反之亦然。对于一个有 r 行 c 列的列联表,自由度等于 (r − 1)(c − 1)。因此,一个标准的 2×2 列联表恰好具有一个自由度,因为一旦行和列的总和固定,就只有一个单元格可以自由变化,否则其余单元格的值都会因相减而减少。
拟合优度的自由度遵循一个相关但不同的规则。它等于类别数减 1,再减去每个从样本中估计而非预先设定的参数的自由度。例如,用 4 − 1 = 3 个自由度来检验四个季节与 25% 的预期值是否一致,因为没有从数据中估计任何参数。用哈迪-温伯格平衡检验基因型计数则更为复杂,因为用于构建预期基因型比例的等位基因频率本身也是从同一样本中估计的,而这一估计步骤会消耗一个额外的自由度,超出简单的计数减 1 规则。
卡方独立性检验:完整示例
考虑一项包含 100 名患者的双臂比较研究,其中 50 名患者接受治疗,50 名患者未接受治疗,并将结果以治愈或未治愈的二元变量进行交叉分析。该数据集也作为Editverse 卡方检验计算器的可加载示例运行,因此以下每个步骤都可以立即重现。
| 治愈 | 未治愈 | 行总计 | |
|---|---|---|---|
| 治疗 | 30 | 20 | 50 |
| 未处理 | 15 | 35 | 50 |
| 列总计 | 45 | 55 | 100 |
预期计数遵循上一节所述的行总数乘以列总数的规则。治疗治愈组的预期计数为 50 × 45 ÷ 100 = 22.5。治疗未治愈组的预期计数为 50 × 55 ÷ 100 = 27.5。未治疗治愈组的预期计数为 50 × 45 ÷ 100 = 22.5。未治疗未治愈组的预期计数为 50 × 55 ÷ 100 = 27.5。所有预期计数均小于 Cochran 阈值 5,因此可以直接使用普通的卡方近似法。
每个细胞对总和的贡献为 (O − E)² ÷ E。经处理并治愈的细胞贡献为 (30 − 22.5)² ÷ 22.5 = 2.500。经处理但未治愈的细胞贡献为 (20 − 27.5)² ÷ 27.5 = 2.045。未经处理但治愈的细胞贡献为 (15 − 22.5)² ÷ 22.5 = 2.500。未经处理且未治愈的细胞贡献为 (35 − 27.5)² ÷ 27.5 = 2.045。这四个贡献相加,自由度为 1 时,χ² = 9.091,对应的 p = 0.0026,远低于传统的 0.05 阈值。应用下文将详细介绍的 Yates 连续性校正后,统计量降至 7.919 (p = 0.0049);对同一表格独立运行的 Fisher 精确检验得出 p = 0.0046。这三种方法均表明治疗与结果相关,这正是审稿人希望在结果部分看到的三角验证。
仅凭显著性并不能描述关联的强度。接受治疗的患者治愈的几率是未接受治疗患者的 30 倍,而未接受治疗的患者治愈的几率是未接受治疗患者的 15 倍,因此比值比为 (30 × 35) ÷ (20 × 15) = 35。Cramér's V 是基于卡方检验的效应量,在 2×2 列联表中取值范围为 0 到 1,其值为 (9.091 ÷ 100) 的平方根,即 0.30,按照传统标准,其关联强度介于弱关联和中等关联之间。将 p 值与比值比和 Cramér's V 一起报告,而不是单独报告 p 值,可以区分哪些结果部分可以直接发表,哪些结果部分会引起审稿人的质疑。McHugh 对一项工作场所疫苗接种研究的分析遵循相同的顺序:92 名未接种疫苗的员工中有 23 人患上了肺炎球菌性肺炎,而 92 名接种疫苗的员工中只有 5 人患上了肺炎球菌性肺炎;卡方检验表明这种差异并非偶然;然后 Cramér's V 系数显示了这种差异的强度。
列联表和期望频数:一个真实的 2×2 列联表示例
列联表对两个分类变量进行交叉制表,卡方检验比较每个单元格的观测值与其预期值:行总数 × 列总数 ÷ 总计。RECOVERY 试验将住院的新冠肺炎患者随机分为两组,分别接受每日 6 毫克地塞米松治疗或常规治疗,并统计 28 天内的死亡人数。最终报告可在PubMed Central上免费阅读,其摘要提供了所有必要的统计数据:地塞米松组 2,104 例患者,常规治疗组 4,321 例患者,死亡人数分别为 482 例和 1,110 例。
| 团队 | 第28天死亡 | 幸存下来 | 合计 |
|---|---|---|---|
| 地塞米松 | 482 | 1,622 | 2,104 |
| 平时护理 | 1,110 | 3,211 | 4,321 |
| 合计 | 1,592 | 4,833 | 6,425 |
步骤 1:预期频率
如果地塞米松无效,死亡人数将按组别规模比例分配。总死亡率为 1,592 / 6,425。预期地塞米松组死亡人数 = 1,592 × 2,104 / 6,425 = 521.33;预期常规治疗组死亡人数 = 1,592 × 4,321 / 6,425 = 1,070.67。实际观察到的死亡人数分别为 482 和 1,110,因此地塞米松组的死亡人数比预期低 39.3,而常规治疗组的死亡人数比预期高 39.3。

步骤 2:检验统计量
χ² = Σ (O − E)² / E = 5.87,自由度为 1,p = 0.015。经 Yates 校正后,χ² = 5.72 (p = 0.017)。标准化残差分别为 -1.72(地塞米松组,死亡)和 +1.20(常规治疗组,死亡);均未超过 ±2,因此没有单个单元格异常突出。所有期望计数均高于 500,因此大样本近似是安全的。R 的 chisq.test 以及 Python 的 scipy.stats.chi2_contingency 返回相同的值。
卡方拟合优度检验:第二个实例
监测团队经常会问另一种问题:不是两个变量是否相关,而是某个变量的分布是否符合预期模式。假设某个卫生部门记录了一年内200例确诊的胃肠道疾病病例,并想知道发病是否具有季节性聚集性,还是均匀分布。在分布均匀、无季节性的零假设下,四个季节中每个季节的预期病例数为200 × 0.25 = 50例。
| 季节 | 观察 | 期望 | (O − E)² ÷ E |
|---|---|---|---|
| 冬季 | 72 | 50 | 9.68 |
| 春季 | 38 | 50 | 2.88 |
| Summer | 33 | 50 | 5.78 |
| 秋季 | 57 | 50 | 0.98 |
四个季节的总贡献值 χ² = 19.32,自由度为 4 − 1 = 3,对应的 p 值为 0.00023。该结果有力地拒绝了均匀分布的零假设。冬季的贡献值为 9.68,夏季的贡献值为 5.78,两者占总统计量的大部分,直接指出了偏差的实际来源。冬季的贡献值远高于预期,而夏季的贡献值远低于预期,而不是每个季节都略微向同一方向偏移。这种区别仅凭总体 p 值无法揭示,需要逐个检查每个单元格的贡献值才能发现。
这种结构在流行病学中随处可见,最常见的是在基因分型质量控制步骤中检查基因型计数是否符合哈迪-温伯格平衡,或者检查诊断结果是否与参考人群的预期比例相符。其原理始终不变:首先确定零假设比例,然后乘以总样本量得到预期计数,接着将标准化间隙的平方相加,最后将总和与具有相应自由度的卡方分布进行比较。
卡方检验失效的情况:预期单元格计数过小
卡方统计量始终只是一个近似值。它的参考分布假设单元格计数表现得足够像一个连续的、近似正态分布的量,使得离散的平方偏差之和能够描绘出一条平滑的卡方曲线。这一假设的前提是每个单元格都具有相当大的期望计数,这与正态分布对二项比例的近似需要足够的试验次数才能使其在尾部不再出现偏差非常相似。一旦期望计数降至 2 或 3,观测计数实际可以取的少数几个值相对于其分布范围而言就相距甚远,统计量的真实抽样分布就会变得不规则而非平滑,卡方曲线的拟合效果也会变差。
威廉·科克伦 (William Cochran) 1954 年发表在《生物统计学》(Biometrics) 上的论文将这一理论担忧转化为一条至今仍在沿用的工作规则。预期计数低于 5 的细胞比例不应超过 20%,且任何单个细胞的预期计数均不应低于 1;一旦超过这两条线中的任何一条,所报告的 p 值就不再可信。当时的模拟研究得出了这条规则,而非给出封闭形式的证明。后来的研究不断证实了这一基本担忧,尽管具体的阈值仍存在争议,例如关于哈迪-温伯格平衡检验的方法文献指出,普通的卡方拟合优度检验对小样本量或罕见等位基因频率非常敏感。
一个简单的表格清晰地展示了实际意义。假设有一个 2×2 的列联表,计数分别为 4、1、1 和 4,每个期望计数均为 2.5,远低于 Cochran 的下限。未经校正的卡方统计量在自由度为 1 时为 3.6,对应的 p 值为 0.058,这个结果很容易让人联想到“接近显著性”。Yates 连续性校正后,该列联表的卡方统计量降至 χ² = 1.6 (p = 0.206),而独立运行的 Fisher 精确检验也得出 p = 0.206 的结果,与校正后的卡方统计量几乎完全一致,并与未经校正的卡方统计量截然相反。如果在此报告未经校正的 p 值,则会夸大精确检验不支持的关联性证据。
耶茨连续性校正详解
弗兰克·耶茨在1934年发表于《皇家统计学会杂志》的一篇论文中提出了一种针对小型2×2列联表的修正方法。由于卡方分布是连续的,而单元格计数是离散整数,耶茨建议在平方之前,先从每个(O-E)差值的绝对值中减去0.5,这样可以缩小统计量,并使p值相对于未修正的版本向上移动。在上面的小型4-1-1-4列联表中,这种调整使统计量从3.6降至1.6,这正是旨在防止未修正的检验在稀疏列联表中高估显著性的那种修正方法。
关于是否应默认应用Yates校正统计量,几十年来一直争论不休,至今仍未有定论,本指南也不认为此问题已得到解决。Haviland 1990年发表于《医学统计学》的论文指出,Yates校正统计量过于保守,而对于大多数研究人员实际遇到的2×2列联表,普通的Pearson卡方检验已足以控制I类错误。然而,最近的一项分析却得出了相反的结论。Prescott 2021年发表于《医学统计学》的论文建议,在医学研究应用中,应使用Fisher精确检验的单侧精确概率的两倍,或使用Yates校正卡方检验作为其近似值来检验2×2列联表。鉴于严谨的统计学家们对此仍存在分歧,最稳妥的做法是报告所使用的版本,并在列联表规模较小、选择至关重要时,优先采用Fisher精确检验,而非任何一种卡方检验。
一项已发表的试验表明,不同版本之间的差异可能非常大。在Bewick、Cheek和Ball用于教授列联表检验的静脉注射硝酸盐试验中,50名治疗组患者中有3人死亡,45名对照组患者中有8人死亡。未经校正的卡方检验结果为χ² = 3.21(自由度为1,p = 0.073),Yates校正后的统计量降至2.16(p = 0.141),而Fisher精确检验(取单侧概率的两倍)的p值为0.140。未经校正的版本明显比其他两个版本更接近显著性水平,这正是方法部分应该明确指出所使用的版本的原因。

需要运行或检查这项分析吗?一位拥有博士学位的生物统计学家将审核您的研究设计,运行分析并为您的论文撰写统计方法部分。
Fisher精确检验:小样本情况下的替代方法
罗纳德·费舍尔在1922年发表于《皇家统计学会杂志》的一篇论文中详细描述了这种精确方法,该方法基于皮尔逊二十年前提出的列联表逻辑。费舍尔精确检验并非用平滑曲线近似抽样分布,而是固定行和列的总和,并使用超几何分布计算每个至少与观测到的表格一样极端的表格的精确概率。由于没有近似步骤,因此不存在上述平滑曲线不匹配的风险,这正是精确检验有效而普通卡方检验无效的原因所在。
Sahai 和 Khurshid 于1995 年在《生物制药统计学杂志》上发表的综述详细分析了各种权衡取舍,并指出对于某些表格结构,精确检验本身可能过于保守,因此切换到 Fisher 精确检验并不会自动产生更有效的检验,而只是在样本量较小时产生更可靠的检验。一个实用的决策规则直接源于 Cochran 上述的阈值。当每个或几乎所有预期计数都达到 5 或更大时,运行普通的卡方检验;一旦该条件不成立,无论总体样本量看起来有多大,都应切换到Fisher 精确检验,因为即使总体样本量很大,仍然可能在不平衡的表格中隐藏一个稀疏单元格。
卡方检验在流行病学中的实际应用
已发表的流行病学研究经常依赖卡方检验,几乎总是将其作为更复杂建模之前的初步筛选步骤。Hazra 和 Gogtay在《印度皮肤病学杂志》上发表的生物统计学教程列出了临床研究人员最常遇到的三种卡方检验:Pearson 卡方检验、用于配对二元数据的 McNemar 卡方检验以及用于分层表的 Mantel-Haenszel 卡方检验,每种检验都适用于不同的数据结构,而非可以互换使用。
遗传流行病学将拟合优度检验作为常规的质量控制步骤。基因分型研究检验特定位点的基因型计数是否符合哈迪-温伯格平衡,显著偏差通常表明存在基因分型错误、群体分层或真实的选择压力,而非直接报告结果。遗传学方法中关于哈迪-温伯格检验的章节详细阐述了这一区别,以帮助研究人员构建遗传关联研究。在一项全基因组扫描中,对44个标记位点进行单自由度哈迪-温伯格检验,发现其中7个位点的表观纯合子显著过多(χ² > 6),这种模式提示可能存在分型错误。 《残疾与康复》杂志上发表的一篇关于 2×2 表格的广泛使用的教程,完整地分析了一个乳腺癌风险因素表,并指出期刊编辑应该要求在每个已发表的表格中同时提供观察到的单元格计数和预期单元格计数,而不仅仅是检验统计量,以便读者可以自行判断是否达到了 Cochran 的阈值。
在遗传学之外,独立性检验还应用于病例对照研究中,例如按疾病状态比较暴露情况;横断面调查中比较不同人口统计阶层中的分类结果;以及诊断研究中比较不同患者亚组的检测结果。正如上文所述,当需要将监测数据与预期模式(无论是否具有季节性)进行比较时,都会使用拟合优度检验来验证数据。
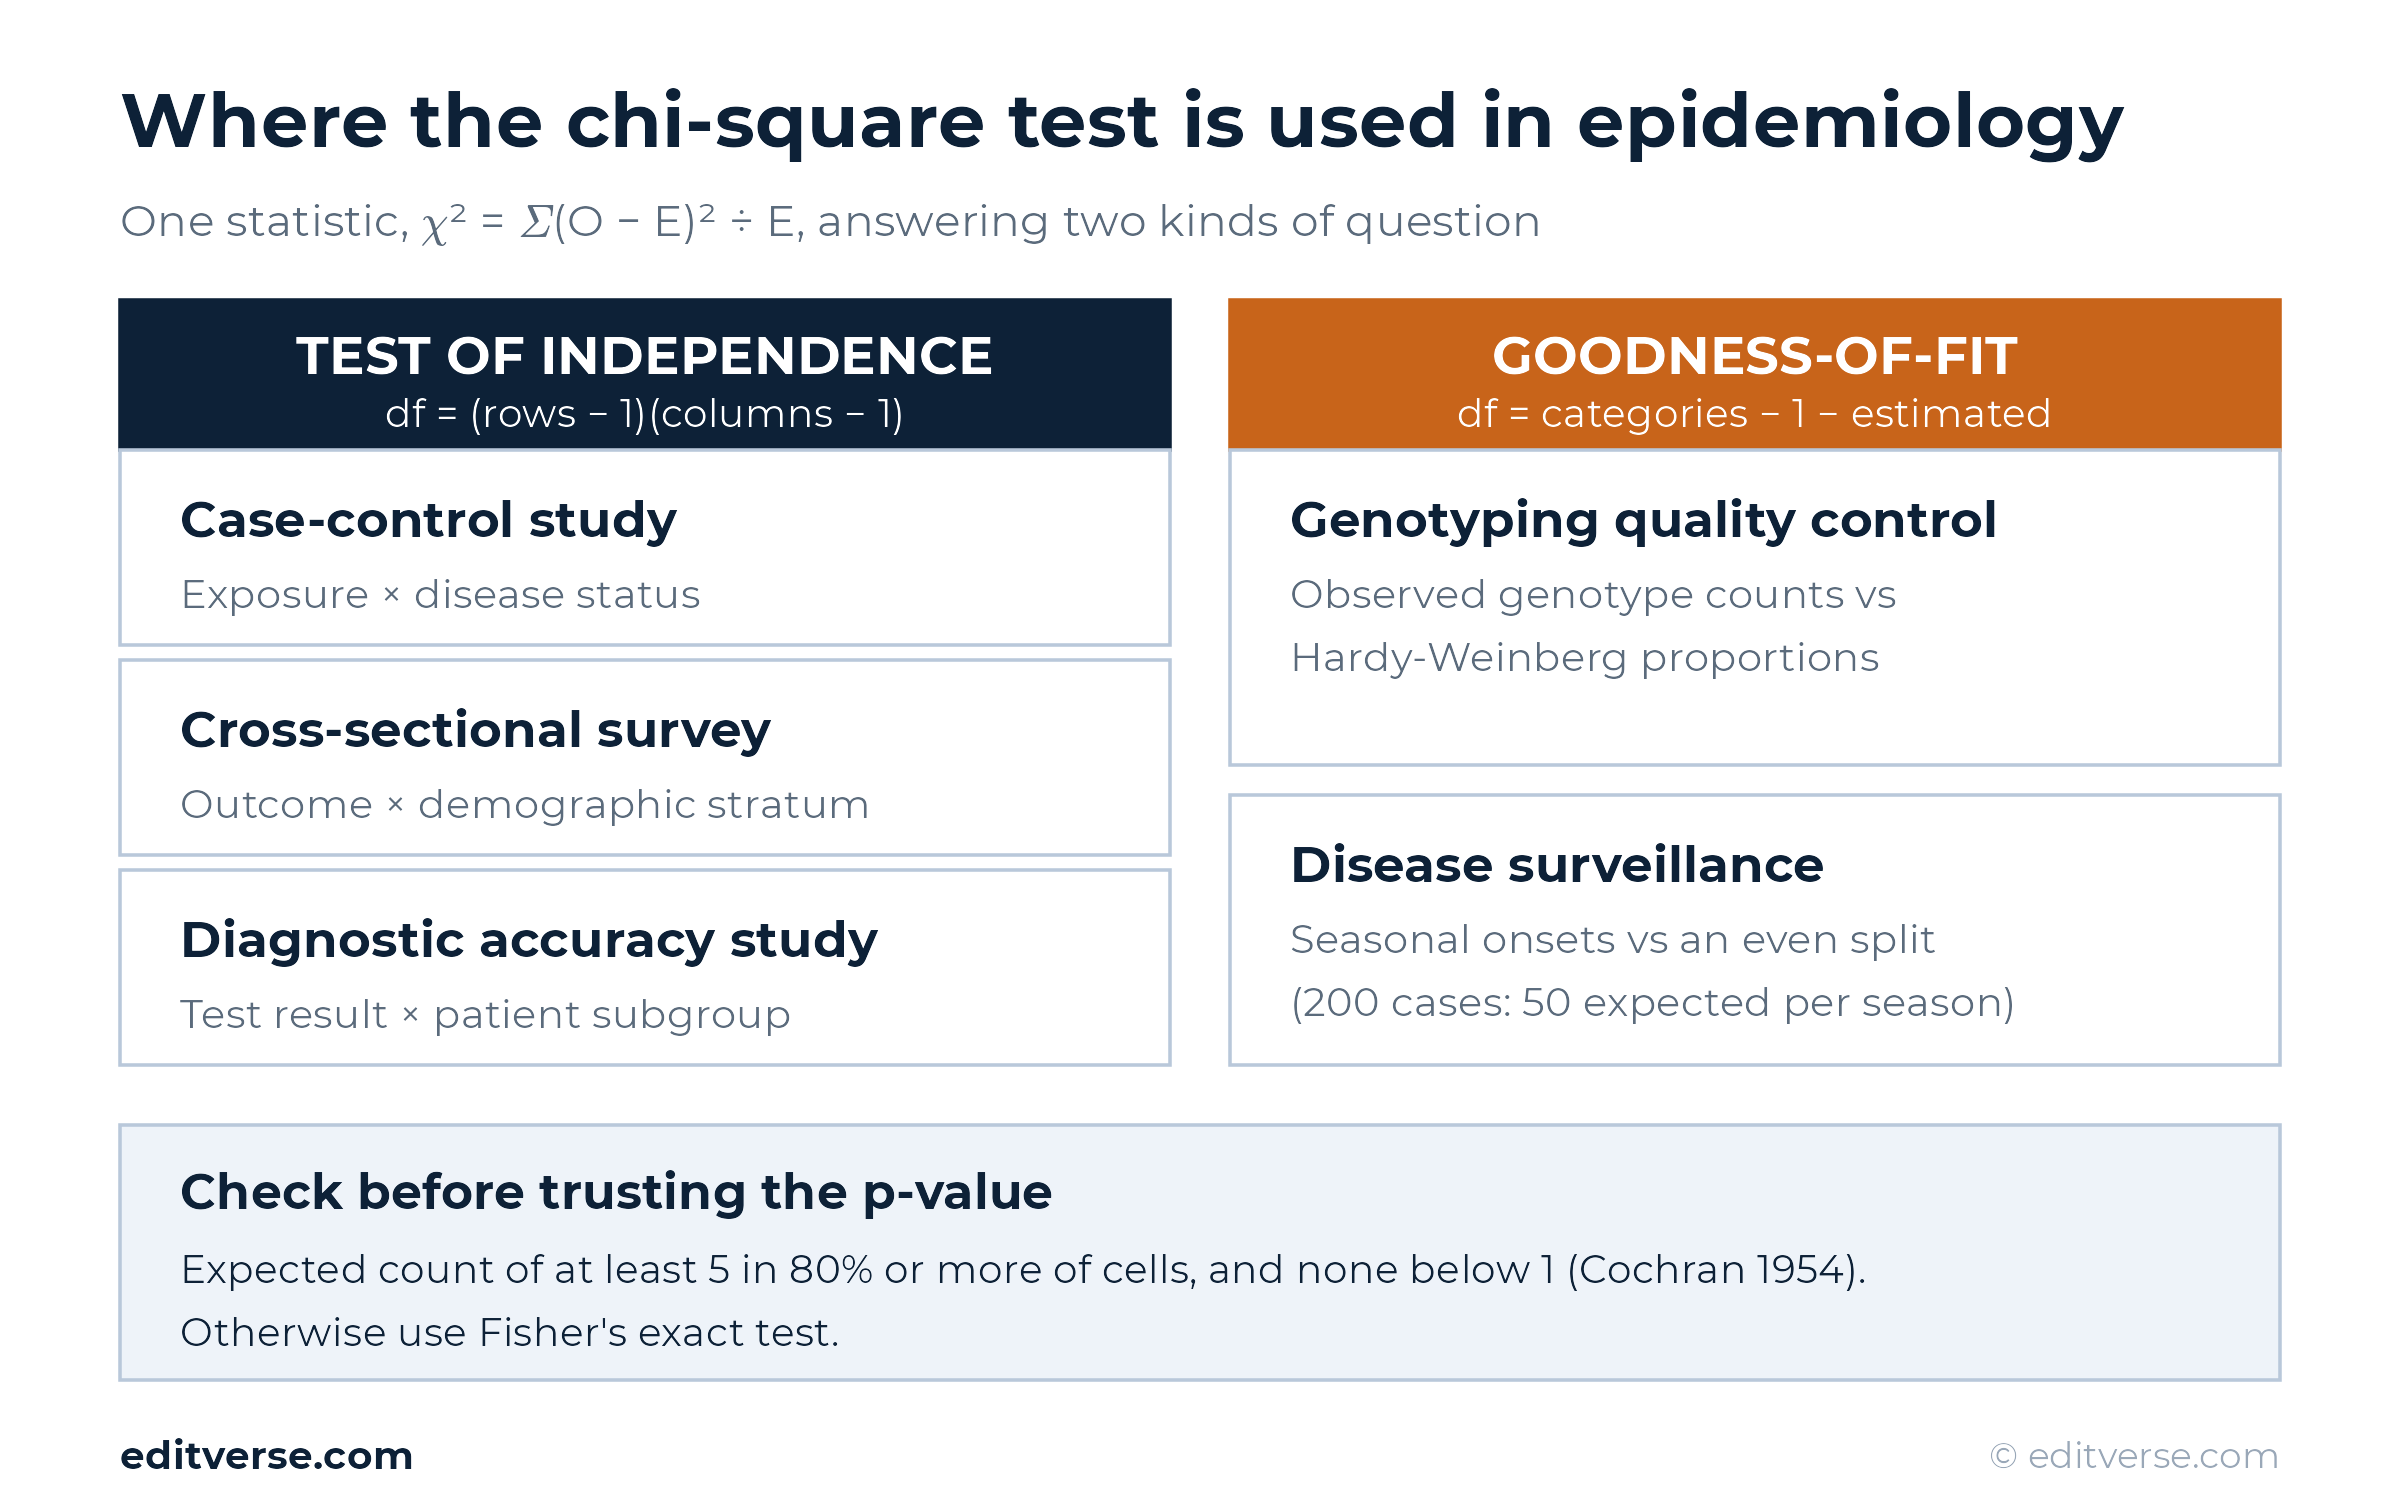
卡方检验报告中的常见错误
少数错误在提交的稿件和已发表的论文中反复出现。
- 输入百分比而不是原始计数。 卡方公式是基于频率而不是比例进行的,因此在进行检验之前,必须将百分比转换回实际计数,而不是可选的。
- 忽略预期计数阈值。 在没有意识到该表存在局限性或改用 Fisher 精确检验的情况下,就发布一个包含多个小于 5 的单元格的卡方 p 值,是该领域最容易避免的统计错误之一。
- 将独立性检验应用于配对数据。 对同一受试者进行前后测量或配对测量,完全违反了独立性假设。 麦克尼马尔检验 正是为了这种情况而存在的。
- 报告显著性但没有效应量。 p 值证实了关联性的存在。至于这种关联性是否足够强,具有临床意义,则是另一个问题,因此需要使用 Cramér's V、phi 或其他指标。 比值比 应位于每个卡方检验结果旁边。
- 自由度计算错误。 统计审核员很容易发现不匹配的值,这表明分析在提交之前没有经过仔细检查。
如何在论文中报告卡方检验
大多数健康科学期刊都遵循类似的报告模板。报告应按以下顺序呈现:检验名称、括号内的自由度、样本量、统计量和p值,例如“χ²(1, N = 100) = 9.09, p = .003”。紧接着是效应量,对于2×2列联表,还应包含比值比或相对风险及其置信区间。发表在《欧洲流行病学杂志》上的一篇广为流传的统计误读指南指出,仅凭p值而没有相应的置信区间估计,容易使读者将“显著”解读为“很大”或“重要”。
结果表格应显示每个单元格的观测计数,而不仅仅是百分比,以便细心的读者能够独立地重新计算检验结果。方法部分应说明所应用的校正方法(如有),例如未校正的Pearson校正、Yates校正或Fisher精确检验,并说明所使用的软件及其版本。对于仍在权衡卡方检验与其他统计方法以制定更广泛分析方案的研究人员,Editverse关于如何选择合适的统计检验的指南,对于论文中不属于分类数据的部分,也可能有所帮助。
需要统计分析方面的专家帮助吗?
Editverse 的生物统计学家能够构建列联表,准确选择卡方检验或 Fisher 精确检验,并提供可完全复现的 R 输出结果,确保结果达到发表标准。您可以先使用免费的卡方检验计算器进行计算,或者直接通过Just Data Service提交原始数据,以获得完整的分析、撰写和期刊投稿支持。
结语
正确运行卡方检验并非只是简单地将计数代入公式。预期频数必须来自明确陈述的零假设,自由度必须与表格的实际形状相匹配,并且普通卡方检验、Yates 校正卡方检验和 Fisher 精确检验之间的选择必须基于最小预期单元格的大小,而不是出于习惯。以上两个表格均经过独立统计软件的交叉验证,每一步都清晰地展示了预期计数较小时结果可能发生的显著变化,以及为什么未经核实就从软件输出中复制的 p 值无法提供完整的信息。
这类分类数据是病例对照研究、诊断准确性论文和遗传关联研究的核心,也正因如此,审稿人才会对这项测试格外仔细。如果一开始就假设正确,并在报告p值的同时报告效应量,就能在论文撰写之前避免修改要求。
免费分析工具
- GraphPro:可直接用于发表的图表,内置卡方检验p值。免费,无需注册。
- 统计数据:免费的统计计算器和分类结果的检验选择器。
- 流程图专业版在浏览器中查看 CONSORT、STROBE 和 PRISMA 流程图。
常见问题解答
卡方检验是用来做什么的?
卡方检验检查观察到的类别计数是否与零假设下预期的计数不同,原因可能是两个分类变量相关(独立性检验),也可能是一个变量的分布与既定模式不符(拟合优度检验)。
卡方检验公式是什么?
χ² = Σ (O − E)² / E,其中 O 是每个单元格的观测计数,E 是该单元格在零假设下的预期计数,求和遍及表格中的每个单元格。
卡方检验有多少个自由度?
列联表的自由度为(行数 - 1)×(列数 - 1),因此 2×2 列联表的自由度恰好为 1。拟合优度检验的自由度为类别数减 1,再减去从样本中估计的每个参数的自由度。
什么时候应该使用费舍尔精确检验而不是卡方检验?
根据 Cochran 1954 年的指导原则,当表格中超过 20% 的单元格的预期计数低于 5,或者任何单个单元格的预期计数低于 1 时,应改用 Fisher 精确检验。
我是否应该始终应用 Yates 连续性校正?
统计学家对此意见不一。一些证据表明,对于较大的 2×2 列联表,这种校正方法过于保守;而另一些近期研究则建议将其或等效的精确检验方法专门用于医学研究。报告所使用的校正版本比选择一个通用的默认值更为重要。
卡方独立性检验和拟合优度检验有什么区别?
独立性检验比较列联表中两个分类变量之间的差异。拟合优度检验比较单个变量的观测分布与预先指定的分布。
显著的卡方检验结果能告诉我这种关联的强度吗?
不。显著性仅表明在选定的显著性水平下,某种关联不太可能是偶然因素造成的。强度则需要单独的效应量,例如克莱默V系数、phi系数或优势比。
卡方检验可以用于连续数据吗?
不直接。连续测量需要先进行分类,这会丢失一些信息,因此,当结果变量确实是连续变量时,t 检验、方差分析或回归模型通常是更好的选择。
案例
- Pearson K. 关于相关变量系统中的给定偏差系统与概率的偏差的标准,可以合理地认为它是从随机抽样中产生的。 《哲学杂志》. 1900;50(302):157–175. doi.org/10.1080/14786440009463897
- Fisher RA. 关于列联表中 χ² 的解释和 P 的计算。 JR Stat Soc. 1922;85(1):87–94. doi.org/10.2307/2340521
- Yates F. 小数列联表和 χ² 检验。 增刊 JR Stat Soc. 1934;1(2):217–235. doi.org/10.2307/2983604
- Cochran WG. 加强常用 χ² 检验的一些方法。 生物识别技术. 1954;10(4):417–451. doi.org/10.2307/3001616
- Haviland MG. Yates 连续性校正和 2 x 2 列联表分析。 统计医学. 1990;9(4):363–367. PMID 2362976
- Prescott RJ. 2×2 列联表的双尾显著性检验。备择假设是什么? 统计医学. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. 关于涉及 2 x 2 列联表的流行病学数据分析,Fisher 精确检验和 Yates 连续性校正概述。 生物制药统计杂志. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. 生物统计学系列模块 4,比较组,分类变量。 印度皮肤病杂志. 2016;61(4):385–392. PMID 27512183
- 王杰,谢特·S.检验偏离哈迪-温伯格比例。 方法分子生物学2012;850:77–102. PMID 22307695
- Rigby AS. 流行病学中的统计方法。VII. 2 x 2 列联表分析的卡方检验概述。 残疾康复. 2002;23(16):693–697. PMID 11732558
- Greenland S、Senn SJ、Rothman KJ 等。统计检验、P 值、置信区间和功效,误解指南。 欧洲流行病学杂志. 2016;31(4):337–350. PMID 27209009
- RECOVERY 协作组。地塞米松在新冠肺炎住院患者中的应用。 新英格兰医学杂志. 2021;384(8):693–704. doi.org/10.1056/NEJMoa2021436
- Bewick V、Cheek L、Ball J.统计学评论8:定性数据、关联性检验。 暴击护理. 2004;8(1):46–53. PMID 14975045
- McHugh ML. 卡方独立性检验。 生物化学医学. 2013;23(2):143–149. PMID 23894860
- Gomes I、Collins A、Lonjou C 等。哈迪-温伯格质量控制。 人类遗传学年鉴. 1999;63(6):535–538. PMID 11246455