
简而言之:荟萃分析将多项研究的效应估计值合并为一个加权结果。其十二个步骤包括:从PICO问题出发,进行系统检索,使用PRISMA流程图进行双审阅者筛选,标准化数据提取,偏倚风险评估(RoB 2或ROBINS-I),效应指标选择,随机效应模型或固定效应模型,森林图合并,异质性检验(I²)和发表偏倚检验(Egger检验),GRADE质量评价,以及符合PRISMA 2020规范的报告。每个步骤均提供免费计算器链接。
荟萃分析将一系列独立的研究整合为一个可靠的数据,而这个数据的可靠性取决于其背后十二个步骤的严谨性。无论是为学位论文章节进行首次定量综合分析,还是对现有方案进行改进,以下步骤都将引导您从问题提出到最终形成可发表的报告,其中包含同行评审人员首先会检查的精确统计阈值、工具和报告标准。
什么是荟萃分析?
荟萃分析是一种统计技术,它将多个独立研究的定量结果合并成一个单一的效应估计值。由于它同时利用了所有纳入研究的统计效力,因此,高质量的荟萃分析能够产生比任何单一试验都更窄的置信区间,能够揭示单个研究难以可靠检测到的微小效应,并且能够让研究人员正式量化研究间存在差异的程度,而不仅仅是断言它们存在差异。
荟萃分析是一种统计方法,而非综述类型。它几乎总是在系统评价中进行,而系统评价提供了透明、可重复的检索和筛选过程,这使得数据合并成为可能。将这两个术语混为一谈是引发审稿人反对的最快方法之一。
简单来说:想象一下,有五项小型研究分别测试某种药物是否能降低血压。单独来看,每项研究的样本量都不足以得出完全令人信服的结论。荟萃分析会对这些研究的结果进行平均,并赋予样本量更大、更精确的研究更高的权重,因此综合起来的结果比任何单一研究都更可靠。
元分析路线图
下面的流程图将整个流程简化为十个检查点。接下来的章节将逐步展开每个检查点。
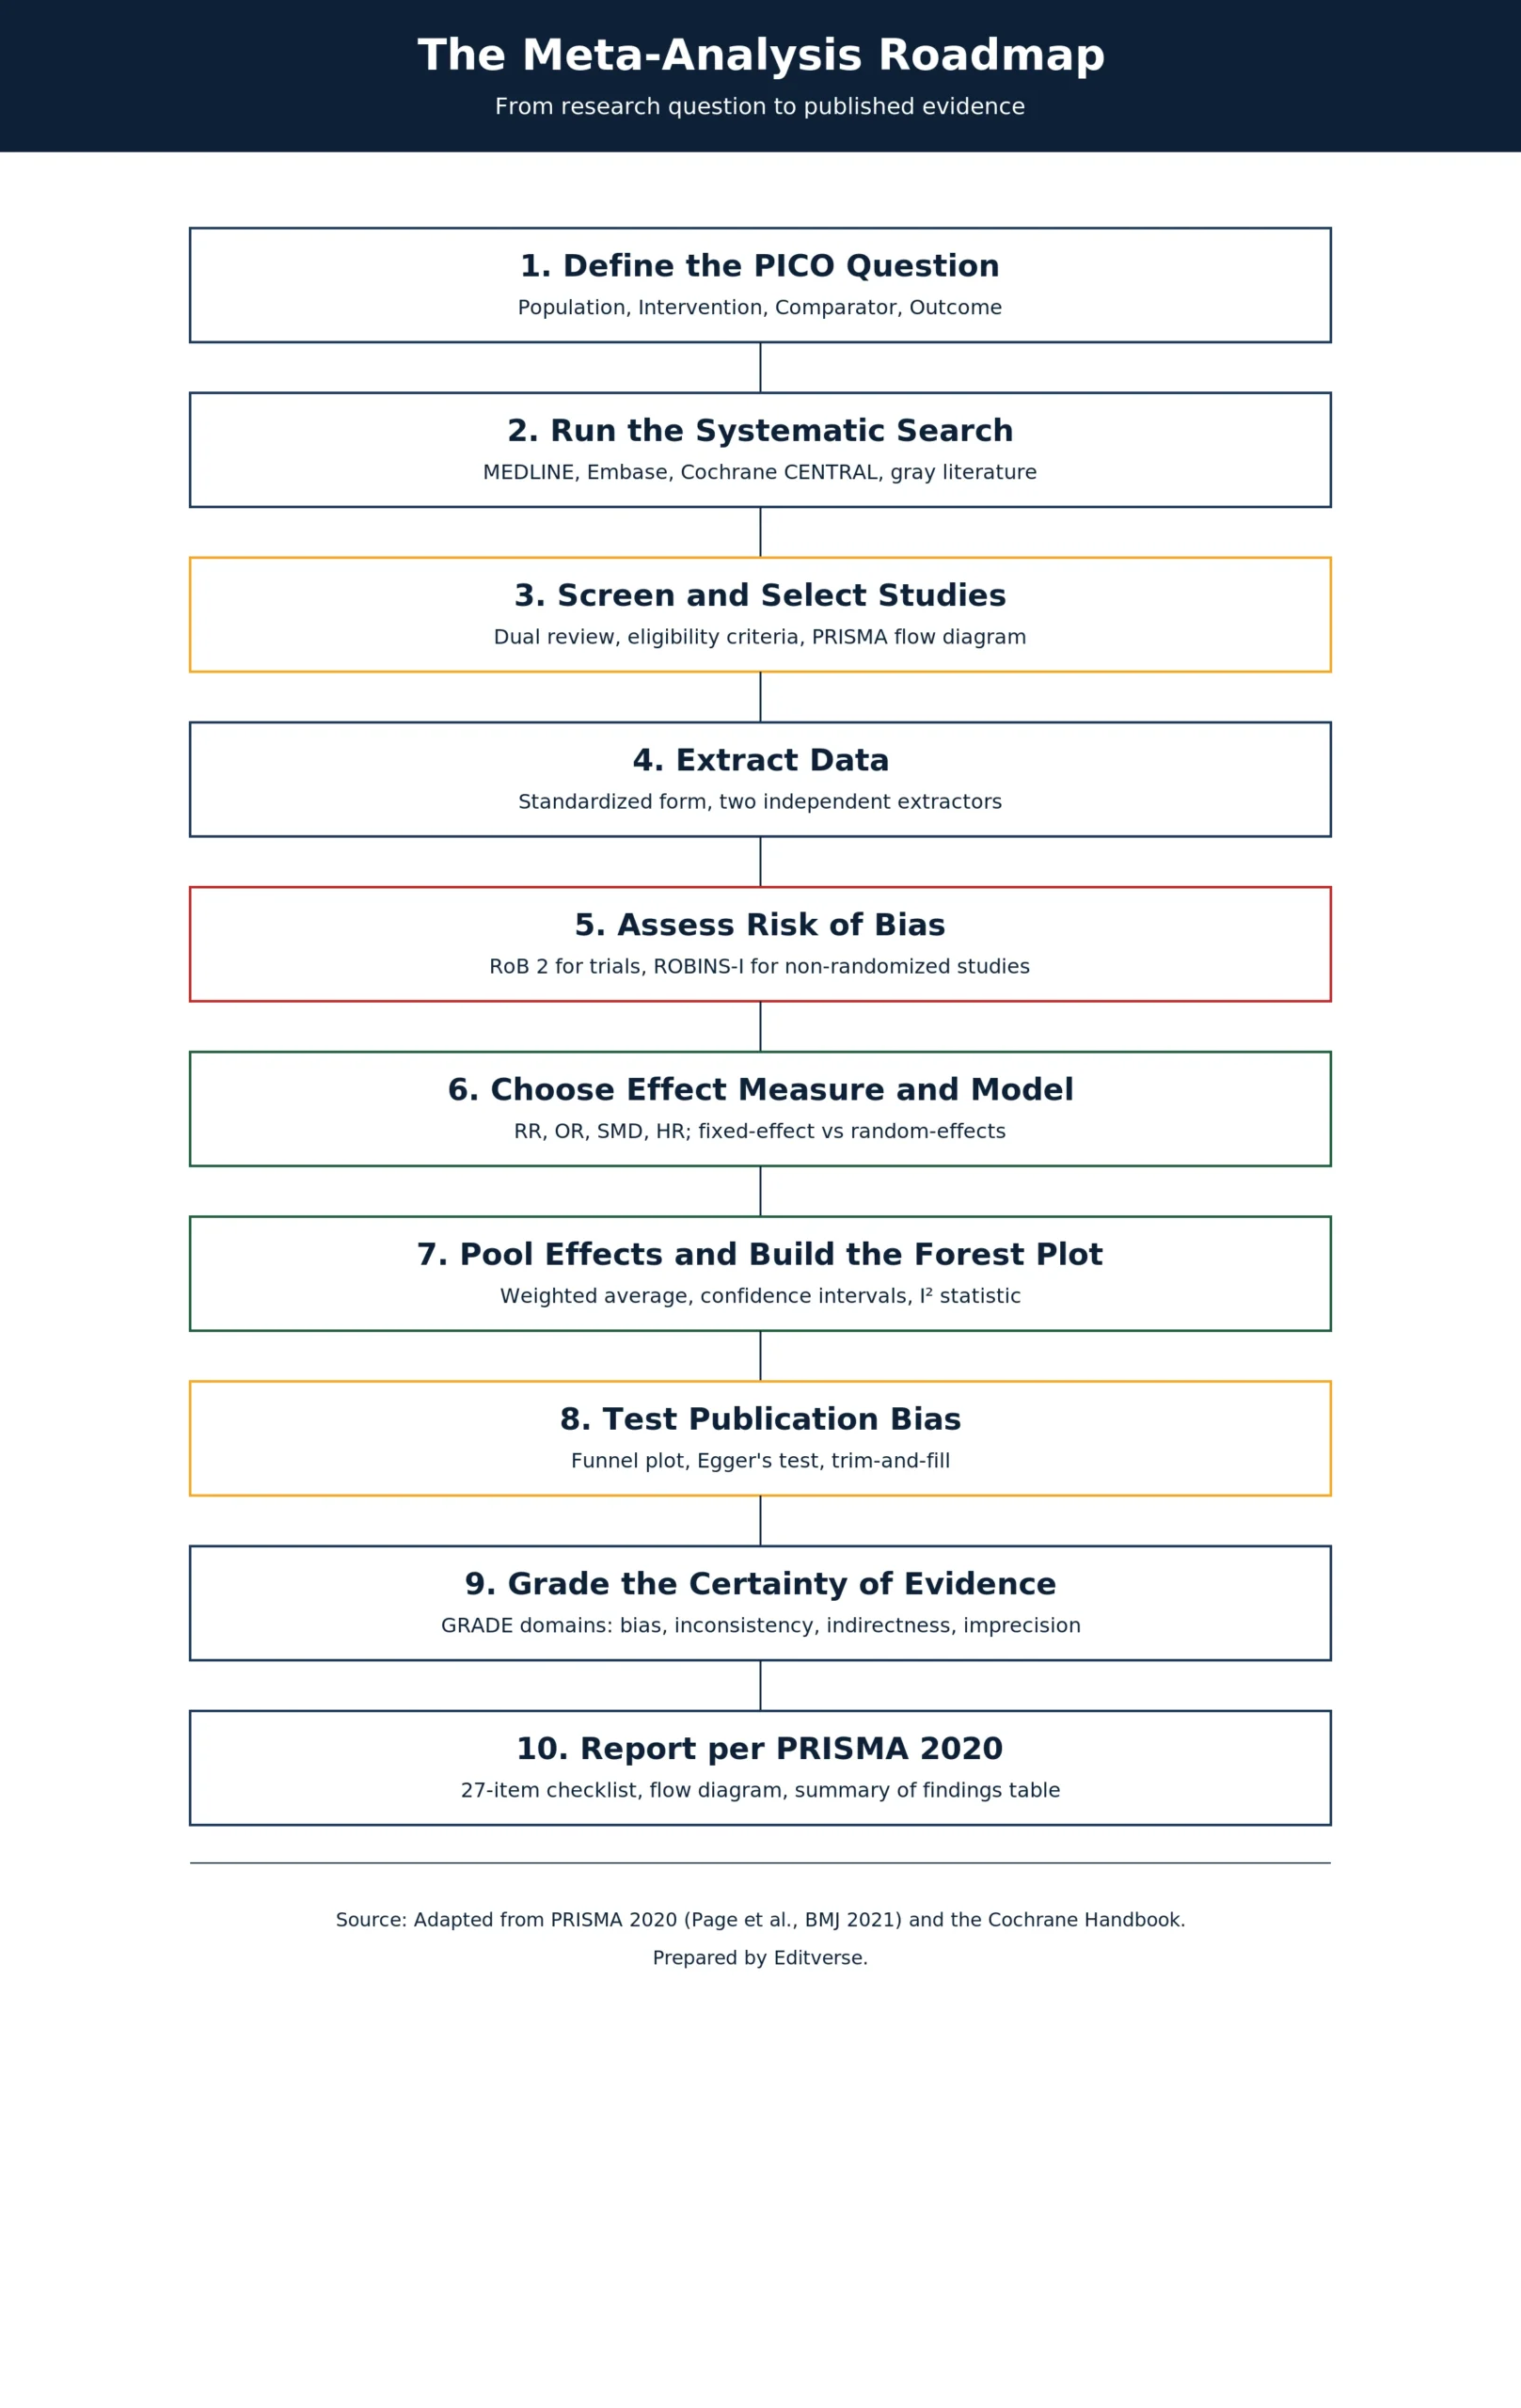
步骤 1:定义你的研究问题
任何站得住脚的荟萃分析,其初始范围都比研究人员预期的要窄。PICO框架正是促成这种范围缩小的关键。Population(人群)明确了研究对象,Intervention(干预)或Exposure(暴露)指明了所研究的治疗或因素,Comparator(对照)指明了对照组,而Outcome(结果)则精确地定义了所测量的指标。一个可行的例子是:“在2型糖尿病成人患者中,与安慰剂相比,二甲双胍是否能降低HbA1c水平?” 正是如此具体的问题,才使得后续的研究能够进行有意义的合并;而模糊的问题则必然导致异质性过高、难以解释。
在进行全面综合分析之前,值得对符合条件的研究数量及其典型样本量进行快速的统计功效分析。对三个统计功效不足的试验进行荟萃分析,通常仍然会存在统计功效不足的问题。
步骤二:进行系统搜索
荟萃分析的完整性取决于其检索范围。全面的检索通常涵盖生物医学领域的MEDLINE/PubMed和Embase数据库,临床试验领域的Cochrane CENTRAL数据库,以及相关领域的特定数据库,例如PsycINFO或CINAHL。灰色文献(学位论文、会议摘要)、ClinicalTrials.gov等临床试验注册库、纳入研究的参考文献列表以及与研究作者的直接联系,都能完善检索,弥补数据库索引的不足。
步骤 3:筛选和选择研究
此处应用的是方案注册期间定义的纳入标准,理想情况下由两位审阅者独立完成,首先筛选标题和摘要,然后阅读所有可能符合纳入标准的全文,并记录每项排除的理由,而不是直接丢弃。最终输出的是一份PRISMA 2020流程图,该流程图清晰地展示了识别、筛选、排除和最终纳入的记录数量,这现在是强制性报告要素,而非可选项。基于观察性研究而非随机对照试验证据的荟萃分析则遵循类似的MOOSE流程图规范。
第 4 步:提取数据
标准化的数据提取表记录研究特征(作者、年份、国家、设计、样本量、随访时间)、参与者特征(年龄、性别分布、疾病严重程度、基线值)、干预措施详情(剂量、频率、持续时间、联合干预措施)以及结局数据本身,包括二分类结局的事件数和总数,以及连续性结局的均值、标准差和样本量。由两位审阅者独立提取数据,并通过讨论而非单方面判断来解决分歧,可以发现那些会悄然扭曲汇总估计值的转录错误。
第五步:评估偏倚风险
该工具必须与研究设计相匹配。对于随机对照试验,目前的标准是 Cochrane RoB 2 工具,该工具由 Sterne 及其同事于 2019 年在《英国医学杂志》(BMJ)上提出,它从五个特定领域构建评估框架,即随机化过程、与预期干预措施的偏差、缺失的结局数据、结局的测量以及报告结果的选择。对于非随机干预研究,ROBINS-I(Sterne 等,BMJ,2016)将这一逻辑扩展到七个领域,增加了混杂因素和参与者选择偏倚,因为这两种偏倚都无法通过随机化进行控制。结果最好以交通灯图或汇总表的形式呈现,而不是隐藏在文本中,因为审稿人和读者都会首先搜索结果。
步骤六:选择效果衡量指标
结果类型决定了衡量指标。二分类结果在基线风险在不同研究间存在显著差异时,需要使用风险比;当研究设计为病例对照或采用逻辑回归分析时,需要使用优势比;当绝对值(具有临床意义)比相对值更重要时,需要使用风险差。连续性结果在纳入研究均采用相同尺度测量结果时,使用均值差;当不同研究采用不同尺度时,使用标准化均值差(Cohen's d、Hedges' g);免费的效应量转换器可以处理这些格式之间的转换。生存时间数据使用生存分析得出的风险比。诊断准确性荟萃分析则完全不同,需要使用双变量模型或HSROC模型,而不是单一的合并比值;专门的诊断荟萃分析计算器可以处理这种情况。当确实不清楚哪种检验或模型最合适时,统计检验选择器可以快速缩小选择范围。
步骤 7:选择分析模型
固定效应模型假设纳入的每项研究都估计了相同的单一真实效应,仅适用于研究人群、干预措施和研究环境完全相同的情况;由于它忽略了研究间任何真实的变异,因此会得出较窄的置信区间。而随机效应模型则假设真实效应由于合理的临床或方法学原因而在不同研究间存在差异,因此会得出相应更宽、更保守的置信区间,并且由于试验人群间的临床异质性是常态而非例外,因此随机效应模型是医学研究的默认选择。
步骤 8:汇总影响并构建森林图
软件选择不如模型正确重要。RevMan 仍然是 Cochrane 的免费标准软件,Comprehensive Meta-Analysis (CMA) 提供了一个更具指导性的商业界面,R 语言的…… meta 和 metafor 软件包提供完全免费的灵活性,Stata 用户通常会选择使用 metan or metaan无论使用哪种工具,其基本运算原理都相同。计算每项研究的效应量,根据其精度赋予权重,计算加权平均值,并生成相应的置信区间。 荟萃分析计算器 重现此汇聚过程并直接渲染森林图。
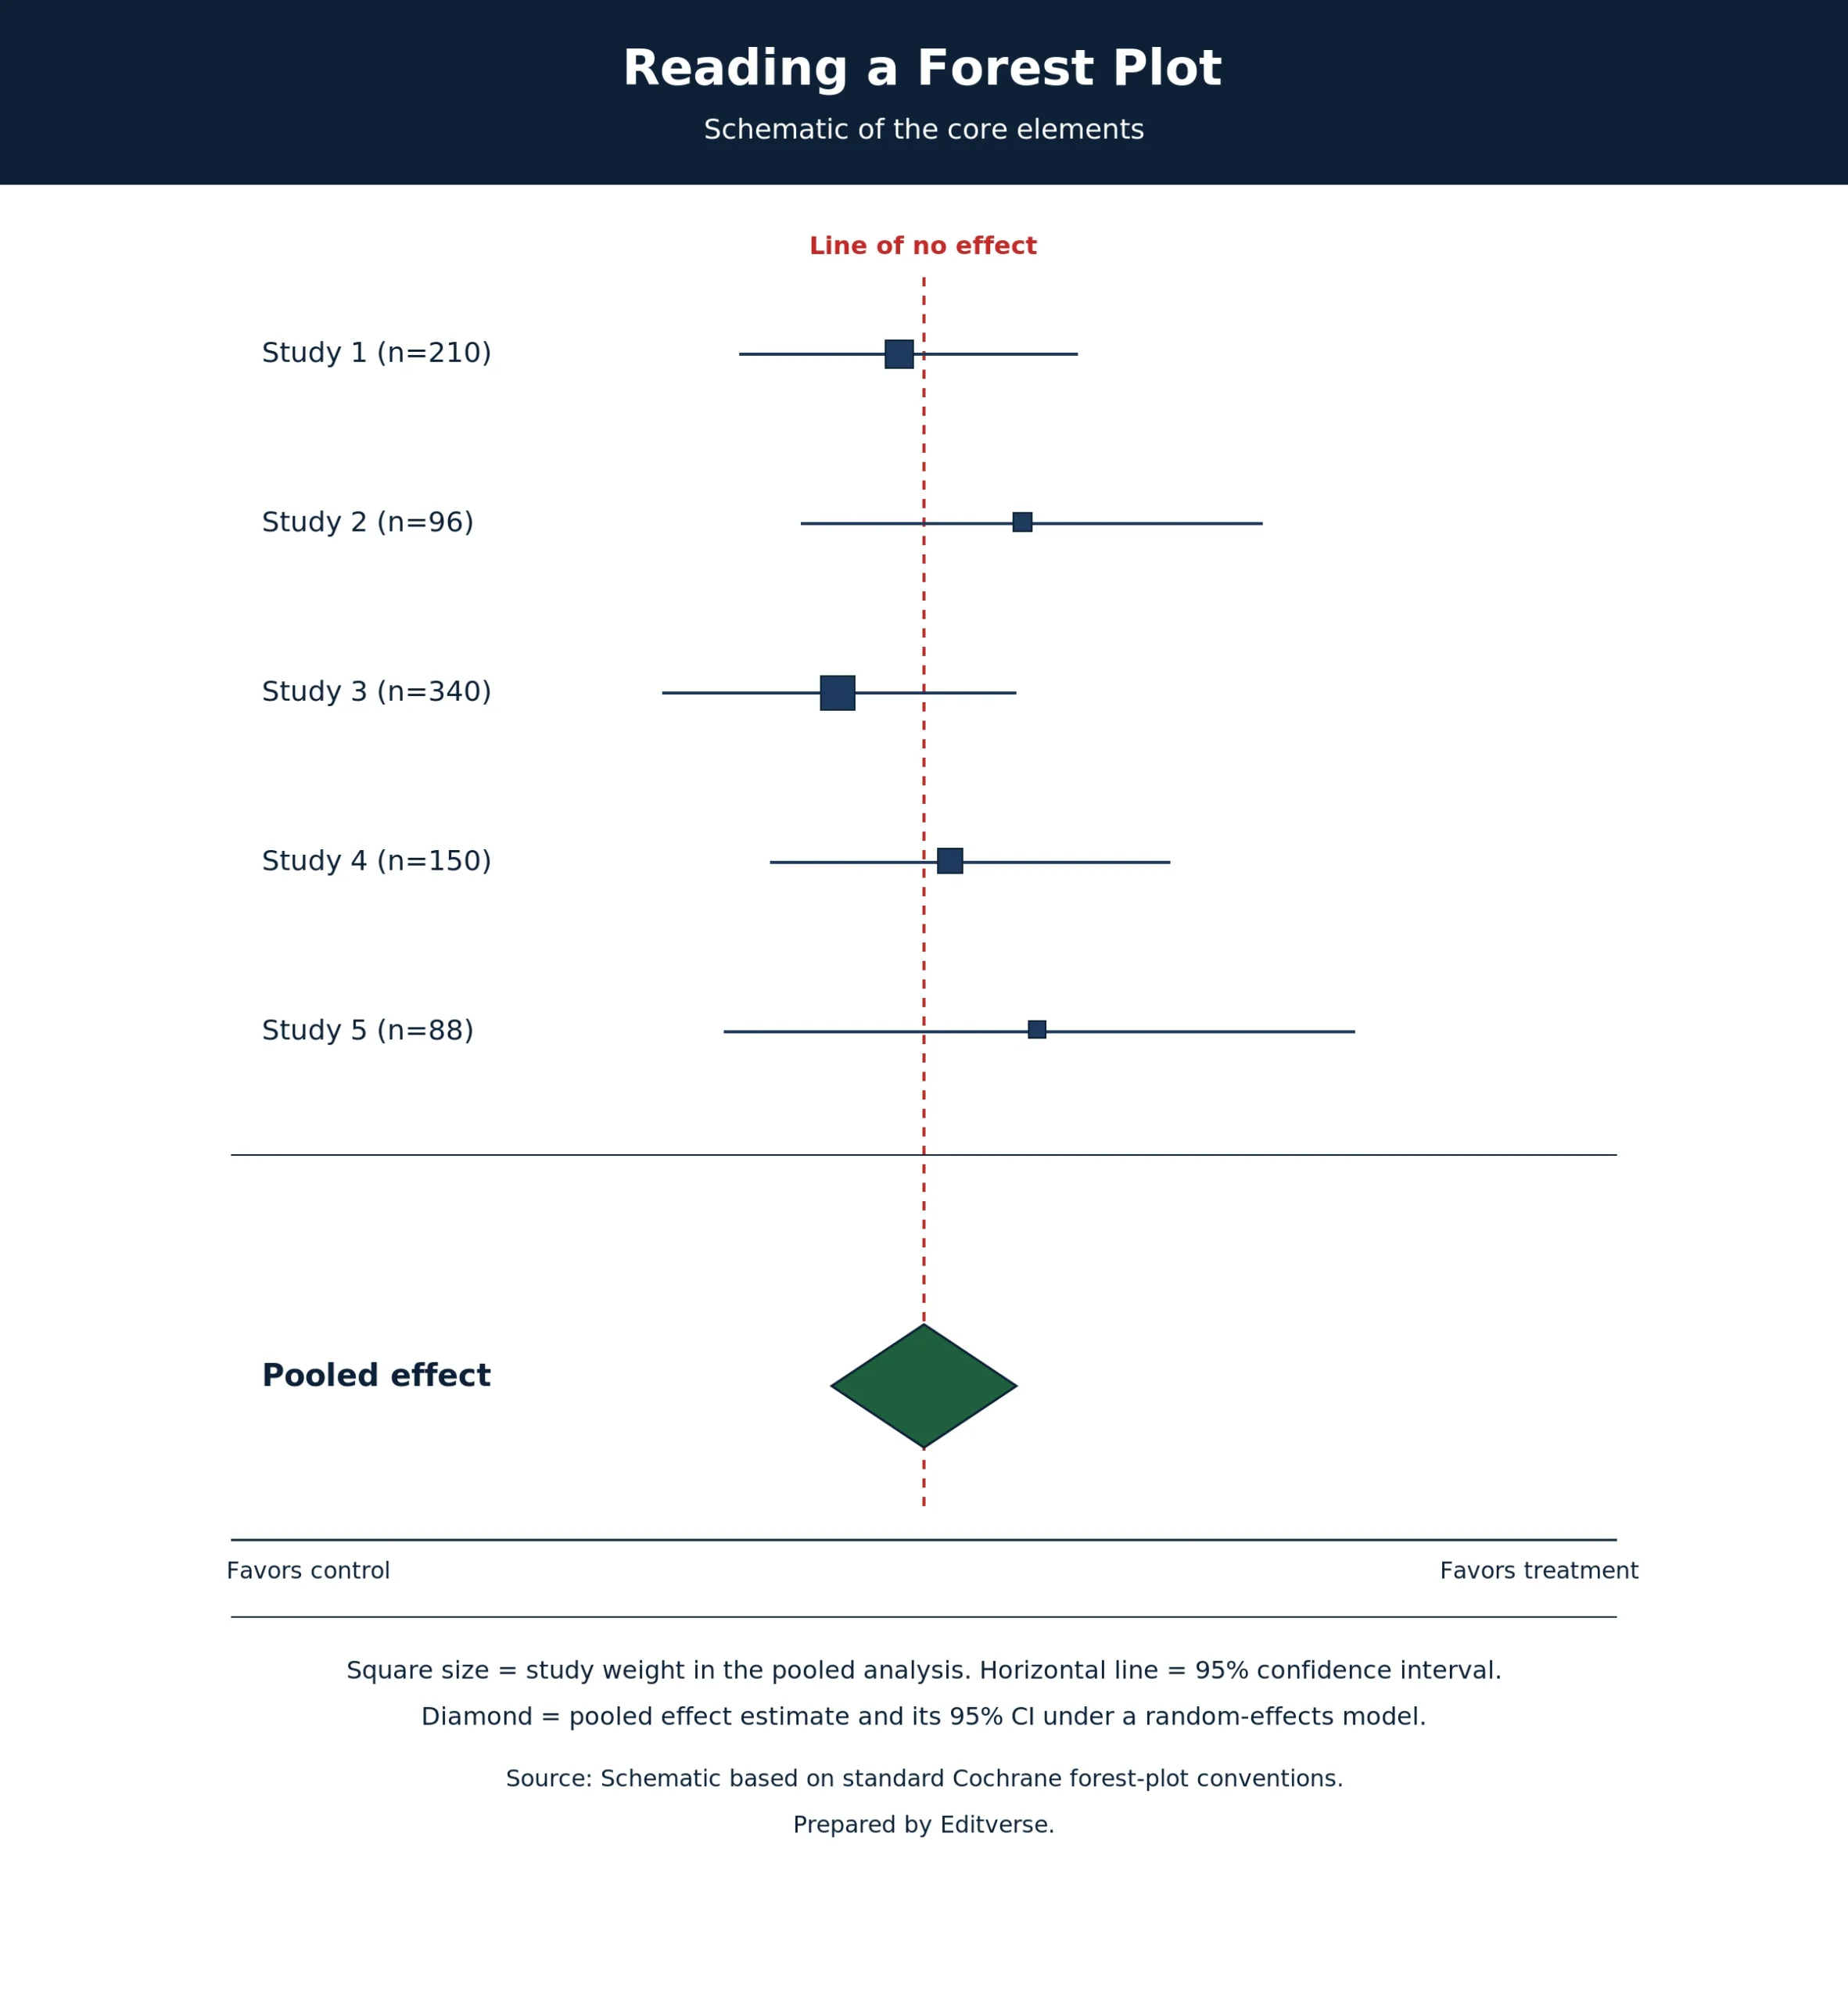
正确解读图表与绘制图表同样重要。每个研究的方格代表其点估计值,方格大小与其在汇总分析中的权重成正比;穿过方格的水平线代表 95% 置信区间;底部的菱形标记了在所选模型下的汇总效应及其自身的置信区间。
步骤 9:评估异质性
异质性是研究间差异的专业术语。Higgins、Thompson、Deeks 和 Altman 在 2003 年发表于《英国医学杂志》(BMJ) 的一篇论文中引入了 I² 统计量,为该领域提供了衡量异质性的标准。I² 统计量表示研究间总变异中由真实异质性而非偶然因素造成的百分比。通常,0% 至 25% 表示低异质性,25% 至 50% 表示中等异质性,50% 至 75% 表示高异质性,75% 以上表示显著异质性。Q 统计量(卡方检验)和 tau 平方值(估计的研究间方差)构成了标准的异质性报告三要素。专门的异质性计算器可以根据提取的研究数据计算这三个统计量。高度异质性提示需要进行调查,可以通过按临床或方法学因素分层的亚组分析、直接对潜在效应修饰因素进行荟萃回归建模,或者逐一排除每项研究的敏感性分析来检查是否某个异常值导致了合并结果。
步骤 10:检验发表偏倚
发表偏倚的产生是因为具有统计学意义的有利结果比无效或不利结果更容易发表,这会使仅基于已发表文献构建的合并估计值产生偏差。Egger、Davey Smith、Schneider 和 Minder 在 1997 年发表于《英国医学杂志》(BMJ) 的一篇论文中正式提出了标准的检测方法,即基于回归的漏斗图不对称性检验,这种不对称性正是发表偏倚造成的;Begg 秩相关检验提供了一种补充检验方法。如果检测到不对称性,则可以使用修剪填充法来填补缺失的研究,从而估计校正后的合并效应。一个免费的发表偏倚计算器可以同时运行漏斗图和 Egger 检验。值得注意的是,对于纳入研究少于 10 项的研究,这些检验的统计功效确实很低,因此,小型荟萃分析得出的无效结果并不能提供强有力的保证。
步骤 11:评估证据的确定性
汇总点估计值无法说明其置信度,而 GRADE 方法(由 Guyatt 及其同事于 2008 年在《英国医学杂志》(BMJ)上提出)正是为了规范化这一问题而构建的。GRADE 从五个方面评估总体确定性,分别是:纳入研究的偏倚风险、不一致性(无法解释的异质性)、间接性(证据与目标人群和研究问题的契合程度)、不精确性(置信区间是否宽泛到足以涵盖临床上不同的结论)以及发表偏倚的证据。最终的评级(高、中、低或极低)清晰地告诉读者,进一步的研究是否有可能改变该估计值。
第 12 步:根据 PRISMA 2020 报告您的发现
Page及其同事于2021年在《英国医学杂志》(BMJ)上发表了最新的报告标准PRISMA 2020,作为对2009年原始声明的更新。其包含27个项目的清单现已成为期刊编辑和同行评审员在进行任何其他操作之前检查投稿稿件的基准。一份符合标准的报告应包含步骤3的流程图、纳入研究的完整特征表、步骤5的偏倚风险评估、每个主要结局的森林图、评估发表偏倚的漏斗图,以及包含步骤11的GRADE评级的“结果汇总”表。除了清单本身之外,还需明确说明效应估计值的95%置信区间,在不方便的情况下报告异质性统计数据而非省略,坦诚地讨论局限性,并将临床解释与统计解释分开。对于达到此阶段但仍需进行格式调整、期刊目标匹配或投稿前全面修改的稿件,我们的稿件撰写服务正是为此而设。
我们在稿件审阅中常见的错误
在Editverse提交的用于荟萃分析的稿件中,少数几个错误反复出现,其频率之高足以值得一提。最常见的错误是将临床或方法学上不相容的研究合并到一个汇总估计值下,其次是报告异质性统计数据却从未探究其成因。效应指标不匹配(例如,在风险比更易于解释的情况下使用比值比)的出现频率之高,表明这种选择并非基于结果类型,而是软件默认设置。亚组分析结果通常被当作验证性结果而非其实际的假设生成信号来呈现,GRADE评估的省略频率也远超期刊指南允许的范围。以上任何一项都足以构成要求大幅修改的理由;多项错误同时出现则往往会导致直接拒稿。
常見問題解答
进行荟萃分析需要多少项研究?
没有固定的最低要求,理论上可以将两项研究合并,但异质性和发表偏倚检验在研究数量少于十项时都会失去统计效力,因此来自非常小样本组的结果应谨慎解释并如实报告。
系统评价和荟萃分析有什么区别?
系统评价是指对某一问题的所有相关研究进行识别、筛选和评价的可重复过程。荟萃分析是该系统评价过程中使用的一种统计技术,它将各项研究的定量结果汇总成一个估计值。并非所有系统评价都包含荟萃分析;脱离系统检索过程的荟萃分析是不合理的。
我应该使用固定效应模型还是随机效应模型?
随机效应模型是医学和健康研究的默认模型,因为研究间在临床和方法学上的差异是常态。只有当纳入的研究在功能上几乎完全相同时,固定效应模型才是合理的。
I² 为 60% 意味着什么?
这意味着,在汇总研究的效果估计值中,60% 的总变异是由研究间真正的异质性而非偶然因素造成的,这属于相当大的范围,因此在将汇总估计值作为主要发现报告之前,应该进行亚组或敏感性分析。
我应该使用哪种软件来进行荟萃分析?
RevMan是免费的,也是Cochrane自己的标准;R的 meta 和 metafor 这些软件包免费且高度灵活;Comprehensive Meta-Analysis (CMA) 和 Stata 是付费选项,因其引导式界面而备受青睐。这四款软件均支持固定效应和随机效应合并、森林图绘制以及标准异质性统计分析。
获取专家支持,助您进行荟萃分析
严谨的荟萃分析需要在上述十二个步骤中运用统计学专业知识和方法论规范,并且高影响力期刊的审稿人会对每个步骤进行审核。我们的团队提供方案和研究设计、数据提取表开发、使用 R、Stata 或 RevMan 进行统计分析、生成森林图和漏斗图、GRADE 评估以及撰写和修改稿件直至投稿等服务。欢迎了解我们的系统评价和荟萃分析撰写服务,或联系我们进行免费咨询。
案例
- Page MJ、McKenzie JE、Bossuyt PM 等。PRISMA 2020 声明:系统评价报告的更新指南。 英国医学杂志。 2021;372:n71。 https://doi.org/10.1136/bmj.n71
- Sterne JAC、Savović J、Page MJ 等。RoB 2:一种用于评估随机试验中偏倚风险的修订工具。 英国医学杂志。 2019;366:l4898。 https://doi.org/10.1136/bmj.l4898
- Sterne JA、Hernán MA、Reeves BC 等。ROBINS-I:一种评估非随机干预研究中偏倚风险的工具。 英国医学杂志。 2016;355:i4919。 https://doi.org/10.1136/bmj.i4919
- Higgins JPT、Thompson SG、Deeks JJ、Altman DG。测量荟萃分析中的不一致性。 英国医学杂志。 2003; 327:557-560。 https://doi.org/10.1136/bmj.327.7414.557
- Egger M、Davey Smith G、Schneider M、Minder C. 通过简单的图形测试检测荟萃分析中的偏倚。 英国医学杂志。 1997; 315:629-634。 https://doi.org/10.1136/bmj.315.7109.629
- Guyatt GH、Oxman AD、Vist GE 等。GRADE:对证据质量和推荐强度进行评级的新兴共识。 英国医学杂志。 2008; 336:924-926。 https://doi.org/10.1136/bmj.39489.470347.AD
- Cochrane系统评价干预措施手册。 https://training.cochrane.org/handbook
由 Editverse 研究支持团队审阅,该团队拥有丰富的系统评价和荟萃分析稿件支持经验,涵盖生物医学和临床学科。最后更新于 2026 年 7 月。