Paano Pumili ng Tamang Pagsusulit na Pang-estadistika
Ang pagpili ng tamang istatistikal na pagsubok ay hindi usapin ng panlasa — ito ay natutukoy ng tatlong bagay: ang uri ng kinalabasan na iyong sinukat, ang bilang ng mga grupo o sukat na iyong pinaghahambing, at kung ang iyong mga obserbasyon ay independiyente o ipinares . Kung tama ang tatlong iyon, halos palaging susunod ang pagsubok. Ang interactive selector sa itaas ay gagabay sa iyo sa eksaktong mga desisyong iyon; ipinapaliwanag ng seksyong ito ang lohika sa likod nito upang mabigyan mo ng katwiran ang iyong pagpili sa isang tagasuri.
Hakbang 1 — Tukuyin ang uri ng iyong kinalabasan (dependent variable)
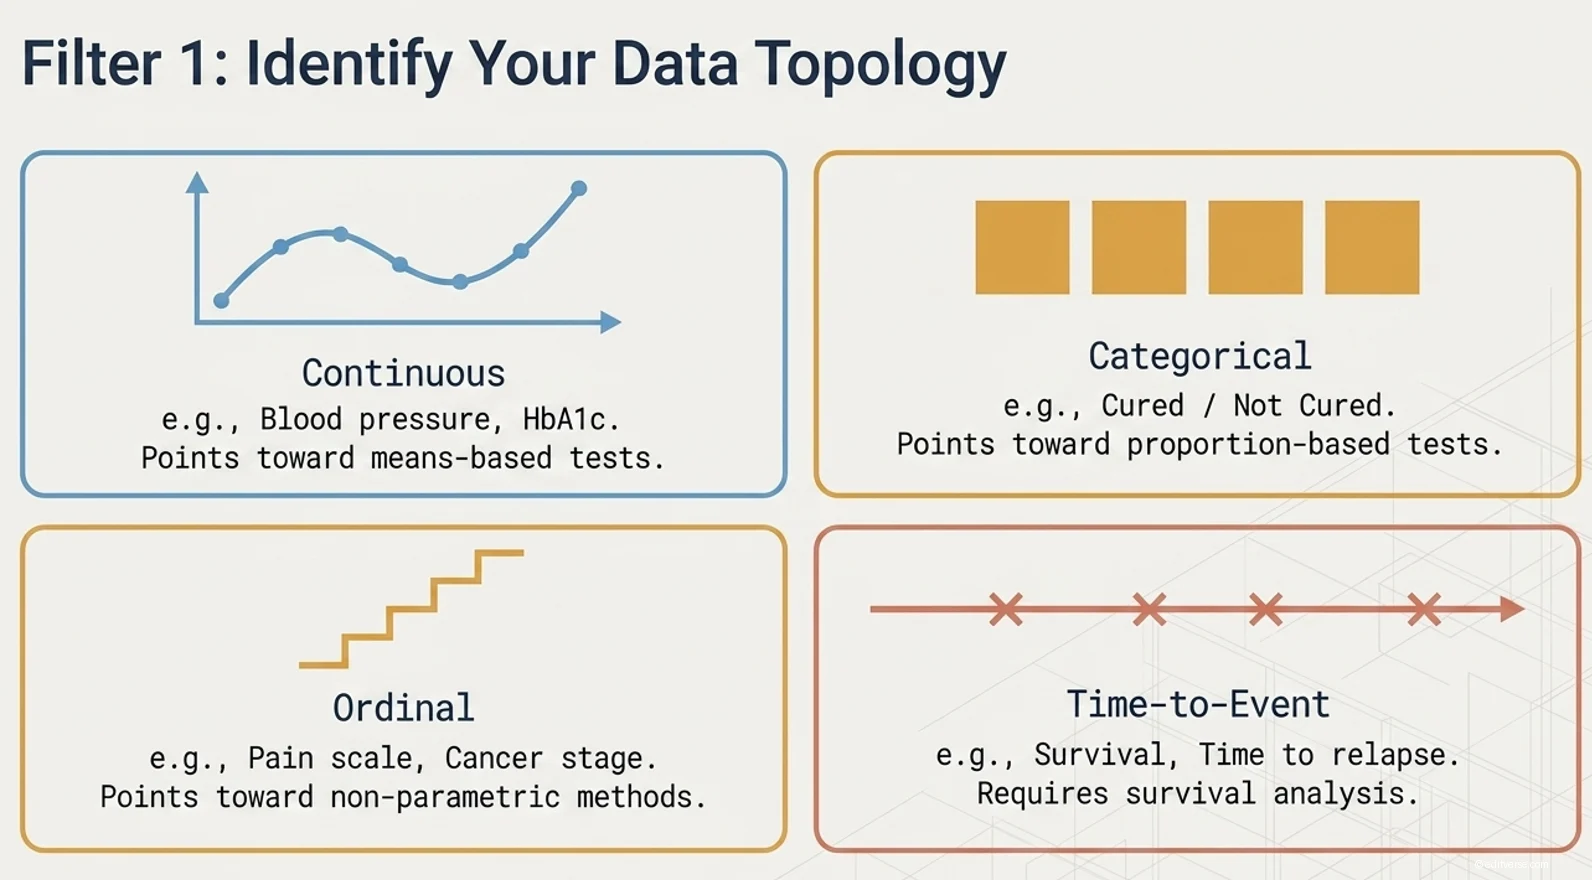
Dito nagsisimula ang lahat. Ang isang tuluy-tuloy na resulta (presyon ng dugo, HbA1c, isang iskor) ay tumutukoy sa mga pagsusuring nakabatay sa means tulad ng t-test o ANOVA. Ang isang kategoryang resulta (nagamot/hindi nagamot, tumugon/hindi tumugon) ay tumutukoy sa mga pagsusuring nakabatay sa proporsyon tulad ng chi-square, Fisher's exact, o logistic regression. Ang isang ordinal na resulta (isang pain scale, isang yugto) ay karaniwang nangangailangan ng mga pamamaraang hindi parametric. Ang isang time-to-event outcome (kaligtasan, oras upang bumalik sa dati) ay nangangailangan ng pagsusuri sa kaligtasan, dahil dapat nitong isaalang-alang ang mga na-censor na obserbasyon na hindi kayang gawin ng isang simpleng paghahambing ng mga means.
Hakbang 2 — Bilangin ang iyong mga grupo at suriin kung may pagpapares
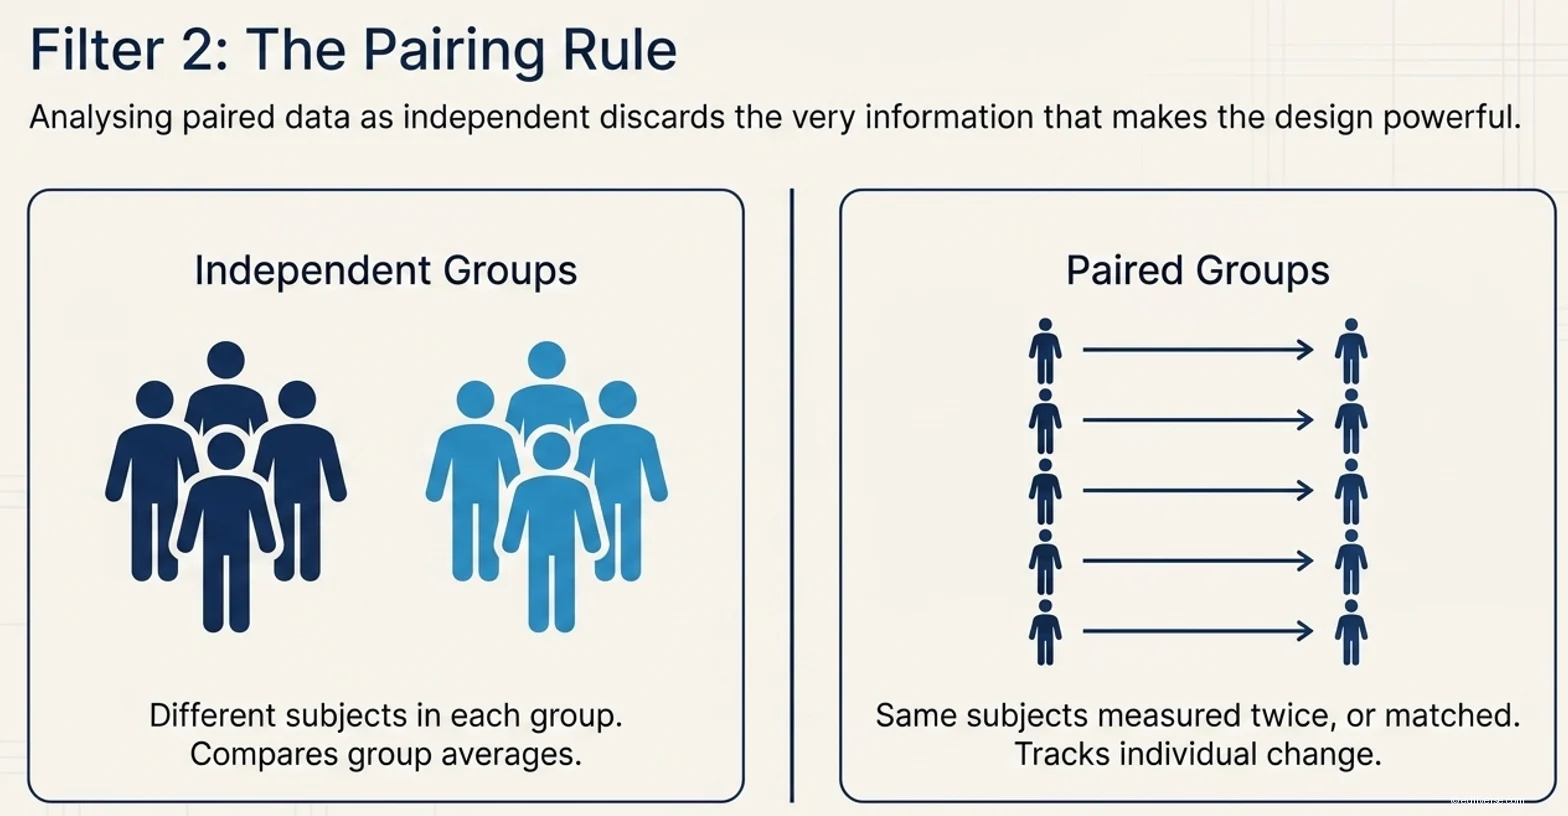
Inihahambing mo ba ang isang grupo sa isang kilalang halaga , dalawang grupo , o tatlo o higit pa ? At ang mga obserbasyon ba ay independiyente (magkakaibang paksa sa bawat grupo) o ipinares (ang parehong mga paksa ay sinukat nang dalawang beses, o pinagtugma)? Ang pagpapares ang pinakakaraniwang hindi napapansing pagkakaiba. Ang pagsukat ng parehong mga pasyente bago at pagkatapos ng isang paggamot ay ipinares na datos; ang pagsusuri nito na parang ang dalawang hanay ng mga sukat ay nagmula sa mga independiyenteng grupo ay nagtatapon ng mismong impormasyon na nagpapatibay sa disenyo, at isang kinikilalang pagkakamali sa literatura.
Hakbang 3 — Suriin ang mga pagpapalagay (parametric vs non-parametric)
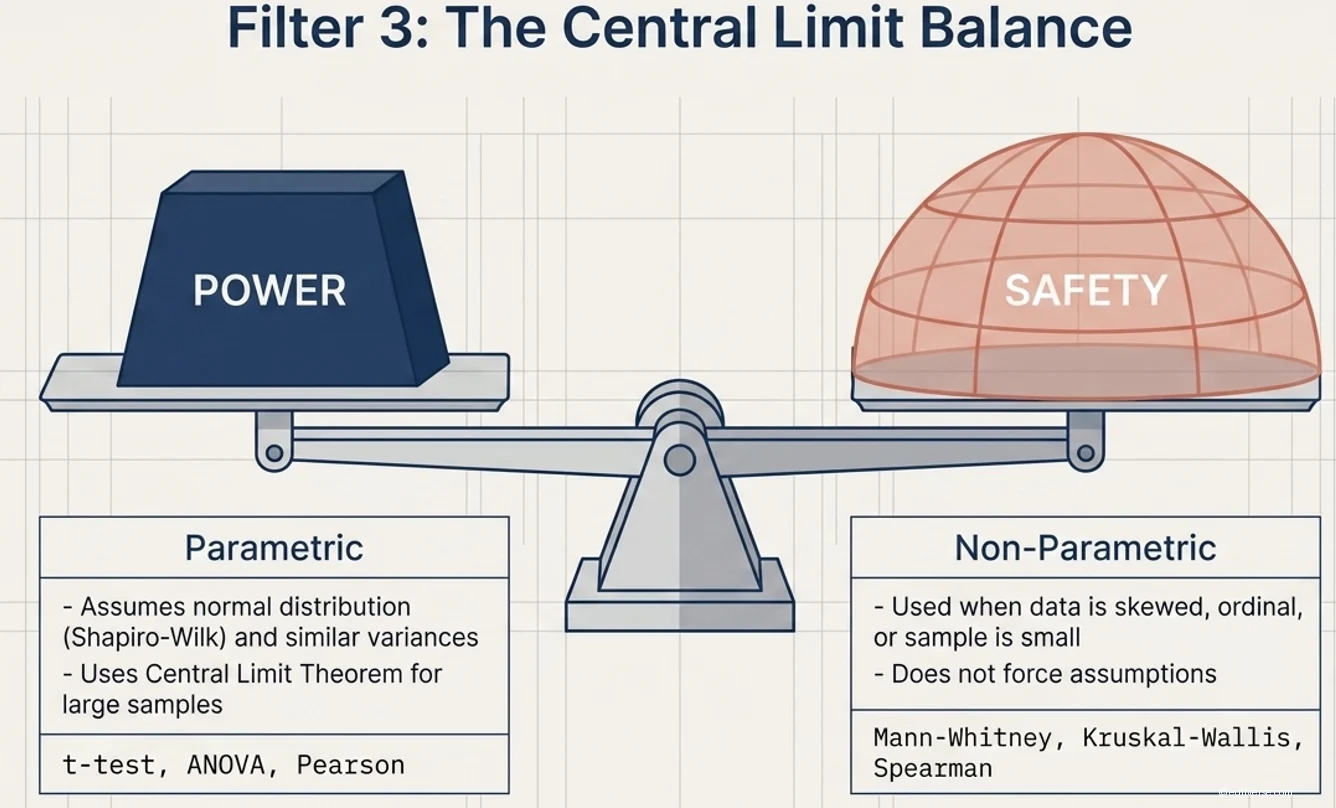
Ipinapalagay ng mga parametric test (t-test, ANOVA, Pearson correlation) na ang resulta ay humigit-kumulang normal na distributed at, para sa mga paghahambing ng grupo, ang mga variance ay magkatulad. Kapag ang mga pagpapalagay na iyon ay totoo — o ang sample ay sapat na malaki para mailapat ang central limit theorem — ang mga parametric test ay mas mabisa. Kapag ang data ay skewed, ordinal, o ang sample ay maliit, lumipat sa non-parametric equivalent: Mann-Whitney sa halip na independent t-test, Wilcoxon sa halip na paired t-test, Kruskal-Wallis sa halip na ANOVA, at Spearman sa halip na Pearson.
Hakbang 4 — Itugma sa pagsusulit, pagkatapos ay beripikahin gamit ang calculator
Kapag naayos na ang uri ng kinalabasan, istruktura ng grupo, at mga pagpapalagay, natukoy na ang pagsusulit. Gamitin ang talahanayan ng paghahambing sa ibaba bilang mabilis na sanggunian, buksan ang libreng calculator na tumutugma, at kumpirmahin ang iyong resulta laban sa ipinapakitang R code. Para sa pagpaplano ng pag-aaral, palaging magpatakbo ng sample size at power analysis bago mangolekta ng datos.
Gabay na Biswal: Ang Sistemang 3-Filter sa Pagkilos
Ang bawat slide ay direktang tumutugma sa isang hakbang sa interactive selector sa itaas — mula framework hanggang test.




Talahanayan ng Pagpili ng Pagsusulit na Pang-estadistika
Itugma ang disenyo ng iyong pag-aaral sa tamang pagsusulit, pagkatapos ay buksan ang libreng calculator.
| Layunin / disenyo | Uri ng resulta | Grupo | Inirerekomendang pagsubok | Kalkulator |
|---|---|---|---|---|
| Paghahambing ng mga pangkat | ||||
| Dalawang magkakahiwalay na grupo, normal na datos | Ang patuloy na | 2 (independyente) | Malayang t-Test | t-Test → |
| Dalawang magkakahiwalay na grupo, skewed/ordinal | Tuloy-tuloy / ordinal | 2 (independyente) | Mann-Whitney University | Mann-Whitney → |
| Bago/pagkatapos, parehong mga paksa, normal | Ang patuloy na | 2 (pares) | Ipinares na t-Test | t-Test → |
| Bago/pagkatapos, parehong mga paksa, may kinikilingan | Tuloy-tuloy / ordinal | 2 (pares) | Wilcoxon Signed-Rank | Wilcoxon → |
| Tatlo o higit pang grupo, normal | Ang patuloy na | 3+ (malayang) | One-Way ANOVA + Tukey | ANOVA → |
| Tatlo o higit pang grupo, hindi normal | Tuloy-tuloy / ordinal | 3+ (malayang) | Kruskal-Wallis | Sa app → |
| Mga kategoryang resulta | ||||
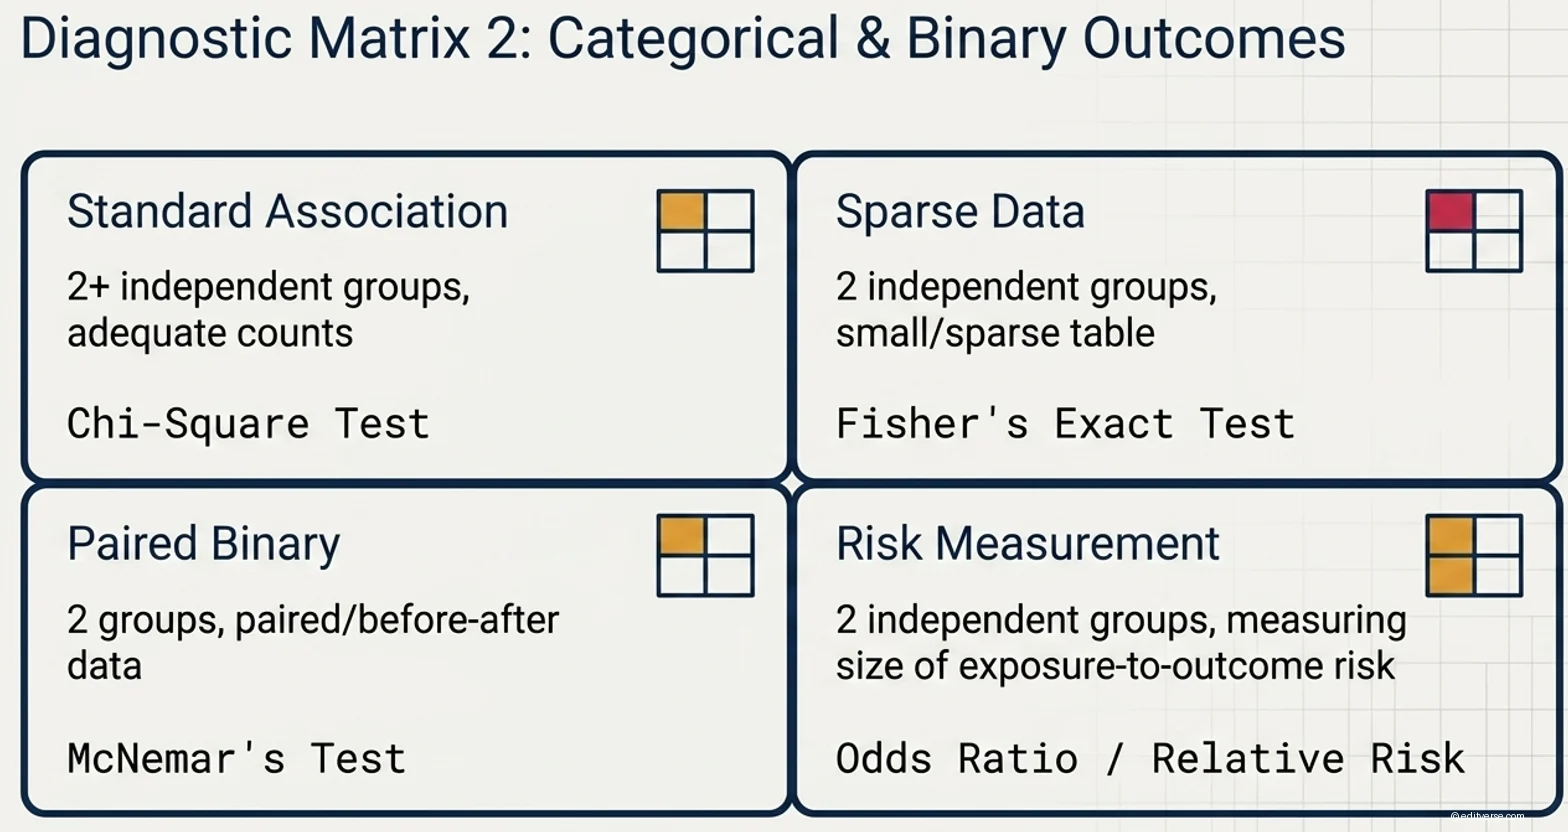
| Asosasyon, sapat na bilang | Nakakauri | 2+ (malayang) | Chi-Square | Chi-Square → |
| Asosasyon, maliit/kalat-kalat na mesa | Nakakauri | 2 (independyente) | Eksakto ni Fisher | Fisher's → |
| Pinagpares na binary (bago/pagkatapos) | binary | 2 (pares) | Pagsubok ni McNemar | McNemar → |
| Laki ng panganib (pagkakalantad → kinalabasan) | binary | 2 (independyente) | Ratio ng Logro / Relatibong Panganib | O / RR → |
| Mga Relasyon at Prediksyon | ||||
| Ugnayan sa pagitan ng dalawang baryabol | Ang patuloy na | - | Korelasyon ng Pearson / Spearman | Korelasyon → |
| Hulaan ang patuloy na resulta | Ang patuloy na | - | De-pagbabalik | Regresyon → |
| Hulaan ang kinalabasan ng binary | binary | - | Logistic Regression | Logistik → |
| Kasunduan, diagnosis at kaligtasan | ||||
| Kasunduan ng tagasuri, mga kategorya | Nakakauri | 2 tagasuri | Kappa ni Cohen | Kappa → |
| Paghahambing ng pagiging maaasahan / pamamaraan | Ang patuloy na | 2 tagasuri/pamamaraan | ICC / Bland-Altman | ICC → |
| Pagsusuring diagnostic vs. sanggunian | binary | - | Sensitibidad at Pagtitiyak | Sens/Spec → |
| Pagsubok sa pagganap sa kabila ng mga limitasyon | Tuloy-tuloy → binary | - | Kurba ng ROC at AUC | ROC → |
| Oras ng kaganapan na may censoring | Oras-sa-kaganapan | 1–2 grupo | Kaplan-Meier / Log-Rank | Kaligtasan → |
| Pagpaplano ng pag-aaral | ||||
| Ilang kalahok ang kailangan ko? | Anumang | - | Sukat ng Sample at Pagsusuri ng Lakas | Laki ng Sample → |
Mga Karaniwang Pagkakamali sa Pagpili ng Pagsusulit
Hindi pinapansin na ang data ay ipinares
Ang pagsusuri ng paulit-ulit o magkatugmang mga sukat na parang nagmula sa mga magkakahiwalay na grupo ay isa sa mga pinakakaraniwan at kinahinatnan na pagkakamali. Ang mga nakapares na disenyo ay nangangailangan ng mga nakapares na pagsubok (paired t-test, Wilcoxon signed-rank, o McNemar para sa binary data); ang pagbalewala sa dependency ay sumisira sa kahusayan ng disenyo at maaaring magdulot ng mapanlinlang na mga resulta.
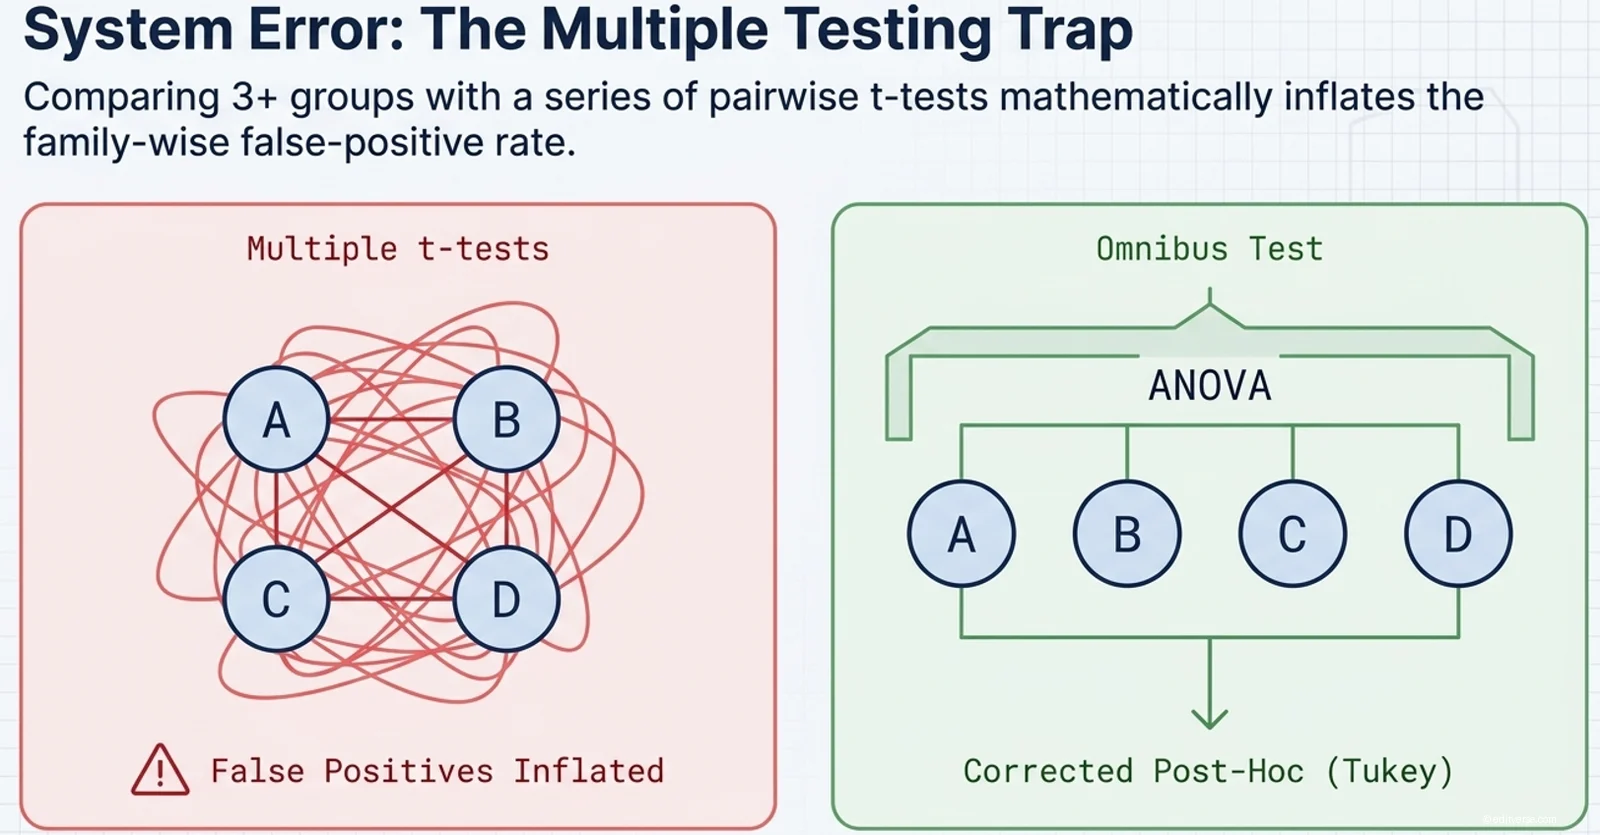
Pagpapatakbo ng maraming t-test sa halip na ANOVA
Ang paghahambing ng tatlo o higit pang grupo na may serye ng mga pairwise t-test ay nagpapataas ng family-wise false-positive rate. Gumamit ng single omnibus test (ANOVA o Kruskal-Wallis) na susundan ng isang naitama na post-hoc na paghahambing.
Paggamit ng parametric test sa skewed o ordinal data
Ang t-test at ANOVA ay may tinatayang normalidad. Sa mga sample na malinaw na skewed, ordinal, o napakaliit, lumipat sa non-parametric equivalent sa halip na pilitin ang isang parametric test.
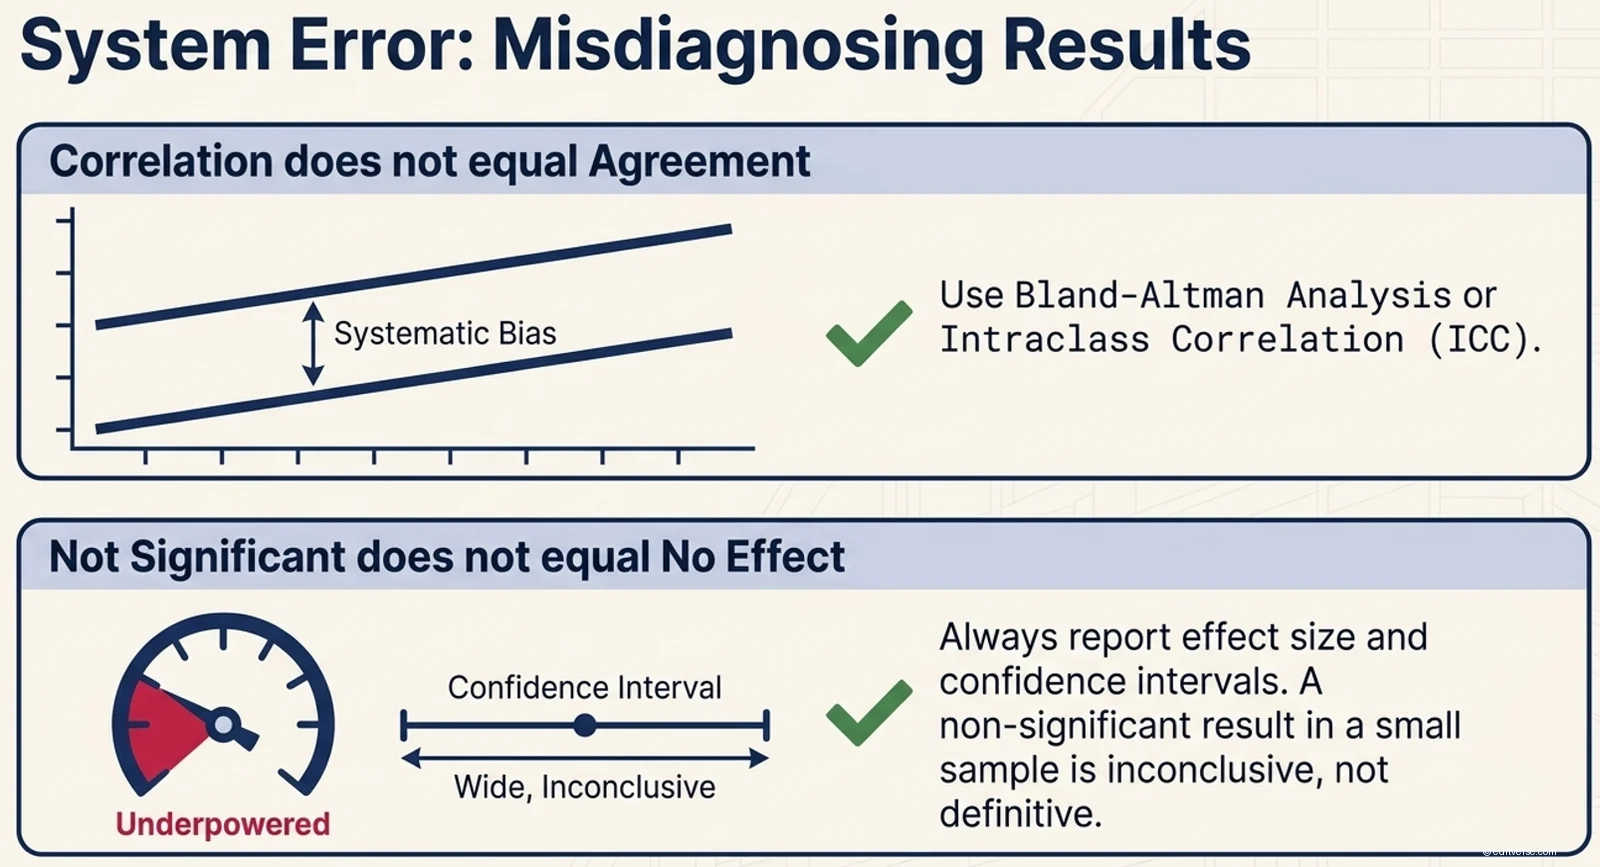
Nakalilitong ugnayan sa kasunduan
Ang mataas na Pearson correlation sa pagitan ng dalawang paraan ng pagsukat ay hindi nangangahulugang magkatugma ang mga ito — ang dalawang paraan ay maaaring perpektong magkaugnay ngunit sistematikong may kinikilingan. Gamitin ang intraclass correlation o isang Bland-Altman analysis upang masuri ang pagkakatugma.
Pagturing sa "hindi makabuluhan" bilang "walang epekto"
Ang isang hindi makabuluhang resulta sa isang pag-aaral na kulang sa kakayahan ay hindi ebidensya ng kawalan ng epekto. Iulat ang laki ng epekto at confidence interval, at planuhin nang maaga ang isang sapat na laki ng sample.
Hindi naitama na maraming pagsubok
Ang pagsubok sa maraming resulta o pag-aangkop ng maraming modelo nang hindi itinatama ang multiplicity ay nagpapalaki ng mga false positive at isang kinikilalang pinagmumulan ng mga natuklasang hindi na maaaring kopyahin.
Mga Madalas Itanong
Paano ko malalaman kung "normal" ang aking data?
Siyasatin ang isang histogram o QQ plot, at para sa pormal na pagsubok ay gumamit ng normality test (Shapiro-Wilk). Sa malalaking sample, ang banayad na non-normality ay hindi gaanong mahalaga dahil sa central limit theorem; sa maliliit na sample, mas gusto ang mga non-parametric test kapag may pag-aalinlangan.
Ano ang pagkakaiba sa pagitan ng ipinares at independiyenteng datos?
Ang mga magkakahiwalay na datos ay nagmumula sa iba't ibang at hindi magkakaugnay na mga paksa sa bawat grupo. Ang mga ipinares na datos ay nagmumula sa parehong mga paksa na sinukat nang dalawang beses (bago/pagkatapos) o mula sa mga magkatugmang pares. Binabago ng pagpapares ang pagsubok na iyong ginagamit, kaya tukuyin ito bago suriin.
Parametric o non-parametric — alin ang mas mainam?
Mas mabisa ang mga parametric test kapag totoo ang kanilang mga palagay. Mas ligtas ang mga non-parametric test para sa skewed, ordinal, o small-sample data. Itugma ang test sa iyong data, hindi ang kabaliktaran.
Kailangan ko bang kalkulahin ang laki ng sample bago pumili ng isang pagsubok?
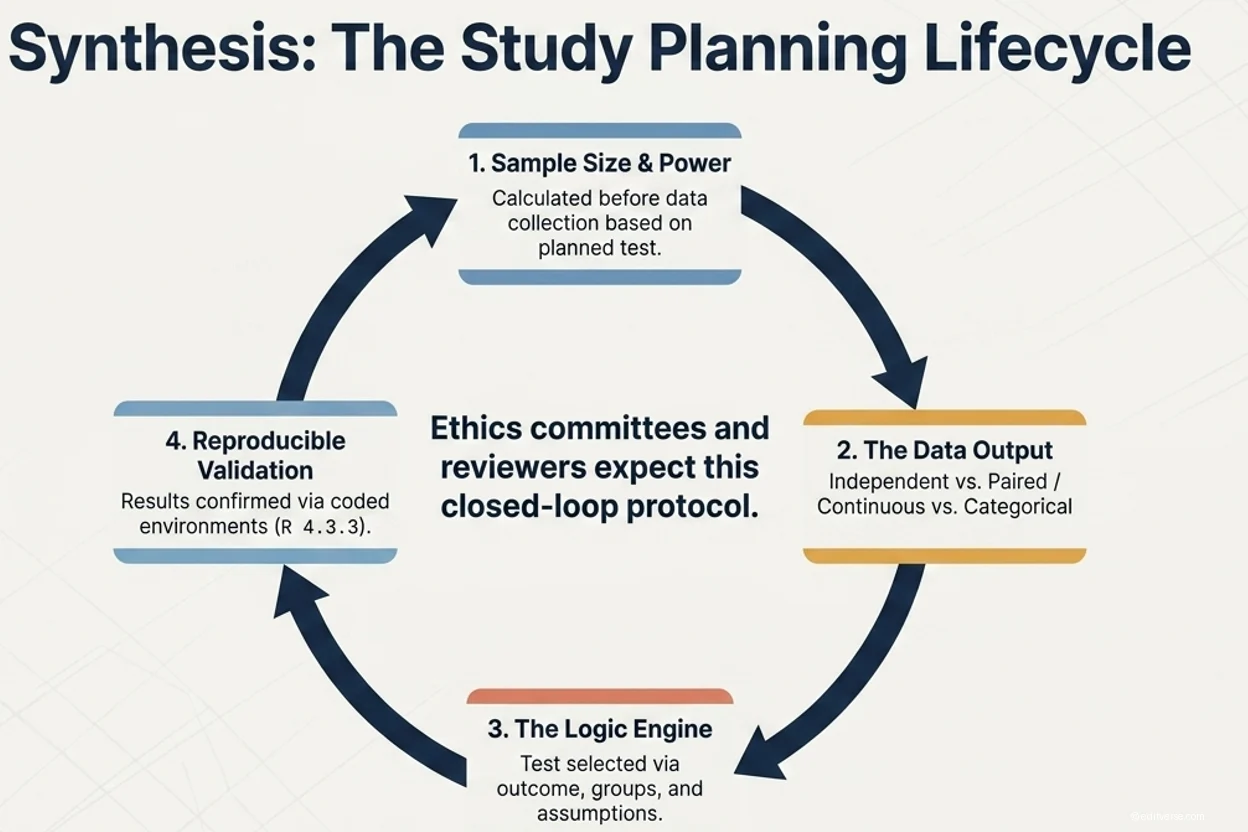
Oo. Ang pagsubok na plano mong gamitin ang siyang magtatakda ng kalkulasyon ng laki ng sample , at pareho itong dapat tukuyin sa iyong protocol bago ang pangongolekta ng datos — inaasahan ito ng mga komite sa etika at mga tagasuri.
Maaari bang suriin ng isang estadistiko ang aking napili?
Oo. Sinusuri ng aming mga biostatistician ang mga disenyo ng pag-aaral, kinukumpirma ang tamang pagsusuri, at isinasagawa ang buong pagsusuri gamit ang maaaring kopyahing output ng R bilang bahagi ng isang pakete ng pagsusuring pang-estadistika.
Mga Sanggunian at Karagdagang Pagbasa
Mga sanggunian na sinuri ng mga kapwa eksperto at na-index ng PubMed tungkol sa pagpili at pag-uulat ng mga istatistikal na pagsusuri.
Hindi Pa Rin Sigurado Kung Aling Pagsubok ang Aakma sa Iyong Datos?
Kinukumpirma ng aming mga biostatistician ang tamang pagsusuri, sinusuri ang mga pagpapalagay, at isinasagawa ang iyong buong pagsusuri gamit ang maaaring kopyahing R output.
Humingi ng Tulong sa Estadistika ng Eksperto