Ang mga tamang uri ng graph para sa pananaliksik ay nakasalalay sa isang bagay: ang tanong na sinasagot ng iyong data. Gumamit ng bar graph na may mga raw point upang ihambing ang mga grupo, isang box plot upang ihambing ang spread, isang histogram upang makita ang hugis ng isang sukat, isang scatter plot para sa dalawang sukat na magkasama, at isang line graph para sa pagbabago sa paglipas ng panahon. Sa ibaba, ang bawat uri ay ginawa sa isang tunay at maaaring sipiin na dataset, kung saan ang mga numerong dapat mong basahin mula rito at ang mga pagkakamaling madalas na minamarkahan ng mga tagasuri.
Sa Simpleng Salita
Piliin ang graph mula sa iyong tanong, hindi mula sa nakasanayan. Ipakita ang bawat data point kapag kakaunti ang iyong nakuha. Simulan ang mga bar axes sa zero. Sabihin ang n at ang ibig sabihin ng mga error bar sa caption.
Anong uri ng graph ang akma sa iyong tanong?
Magsimula sa talahanayan na ito. Ang bawat hilera ay nag-uugnay ng isang tanong sa pananaliksik sa graph na sumasagot dito at sa paraan kung paano kadalasang nanlilinlang ang graph na iyon. Ang bawat graph sa talahanayan ay buong ginawa sa ibaba, at ang mga dual-axis chart ay may kanya-kanyang seksyon. Para sa diagnostic-accuracy, trial at meta-analysis plots (ROC, Kaplan-Meier, forest, Bland-Altman) tingnan ang Clinical Research Graphs: 10 Plots for Trials, Diagnostic Tests and Meta-Analysis.
| Ang iyong katanungan | Graph na gagamitin | Kung saan ito nabigo |
|---|---|---|
| Paghambingin ang mga average ng grupo | Bar graph na may ipinapakitang mga hilaw na punto | Ang mga bar lamang ay nagtatago ng pagkalat at laki ng sample |
| Paghambingin ang pagkalat at mga outlier sa iba't ibang grupo | Box plot | Itinatago ang bimodality; ipinapakita ang mga punto kapag maliit ang n |
| Tingnan ang hugis ng isang sukat | Histogram | Binabago ng lapad ng lalagyan ang larawan; subukan ang dalawang lapad |
| Ipakita kung paano magkasamang gumagalaw ang dalawang sukat | Scatter plot | Ang isang magkatugmang linya ay nagpapahiwatig ng sanhi; ipinapakita lamang nito ang kaugnayan |
| Ipakita ang pagbabago sa paglipas ng panahon | Linya ng graph | Ang isang diretsong takbo ay maaaring magtago ng isang biglaang hakbang |
| Magpakita ng grid ng mga halaga o ugnayan | Init ng mapa | Nakakalito ang mga iskala ng kulay kung walang naka-label na susi |
| Ipakita ang mga bahagi ng isang kabuuan (2 hanggang 5 bahagi) | Pie o stacked bar | Hindi maihahambing ang higit sa 5 hiwa sa mata |
Ang bawat uri ng graph ay ginagawa nang dalawang beses. Una sa isang pampublikong dataset na kasama ng R, para makopya mo ang bawat numero (kinakalkula nang hiwalay sa R at Python at itinutugma sa huling digit). Pagkatapos ay sa isang pigura mula sa isang kamakailang open-access na papel sa JAMA Network Open o Nature Communications, na muling ginawa sa ilalim ng lisensyang CC BY 4.0 na may attribution, para makita mo kung paano pinangangasiwaan ng mga may-akda ang parehong mga desisyon sa print.
Bar graph: paghahambing ng mean ng grupo (ipakita ang mga tuldok)
Ang bar graph ay nagko-code ng isang halaga bilang haba, kaya sinasagot nito ang "aling grupo ang mas malaki?". Ang datos ay haba ng ngipin sa 60 guinea pig na binigyan ng bitamina C bilang orange juice (OJ) o ascorbic acid (VC) sa tatlong dosis (Crampton 1947, 10 hayop bawat bar).
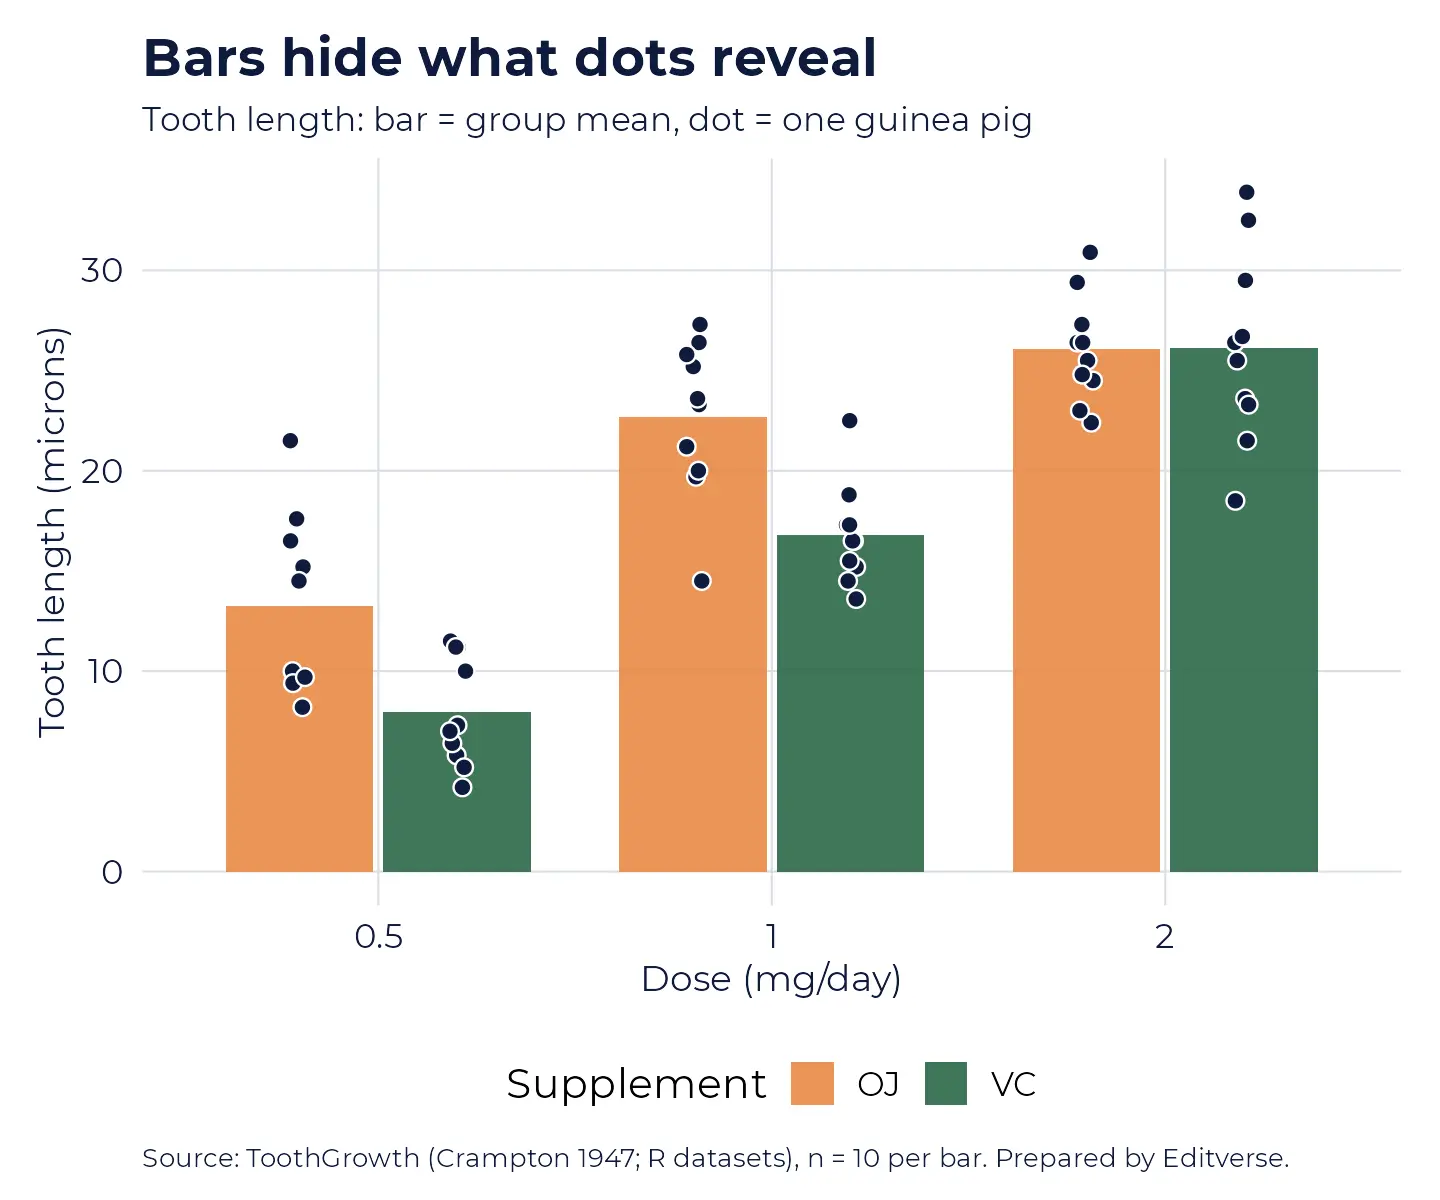
Paano ito basahin. Sa 0.5 mg/araw, ang OJ ay may average na 13.23 microns laban sa 7.98 para sa VC. Sa 1 mg/araw, ang agwat ay 22.70 laban sa 16.77. Sa 2 mg/araw, ang mga bar ay magkapareho ang hitsura: 26.06 laban sa 26.14. Ang mga tuldok ay nagdaragdag ng hindi kayang idagdag ng mga bar: sa 2 mg/araw, ang mga VC na hayop ay nakakalat sa mas malawak na saklaw.
Halimbawa ng nailathalang: isang bar bawat kalahok, na may mga confidence interval (JAMA Network Open, 2026)
Magagamit nang maayos ang mga bar kapag ang bawat bar ay isang tao. Sa isang double-blind N-of-1 na pagsubok ng tamsulosin deprescribing sa mga matatandang lalaki, tinantya nina Bauer at mga kasamahan ang epekto para sa bawat kalahok nang hiwalay at gumuhit ng isang bar bawat kalahok, na inayos mula sa pinakamalaki hanggang sa pinakamaliit na epekto ng paggamot.
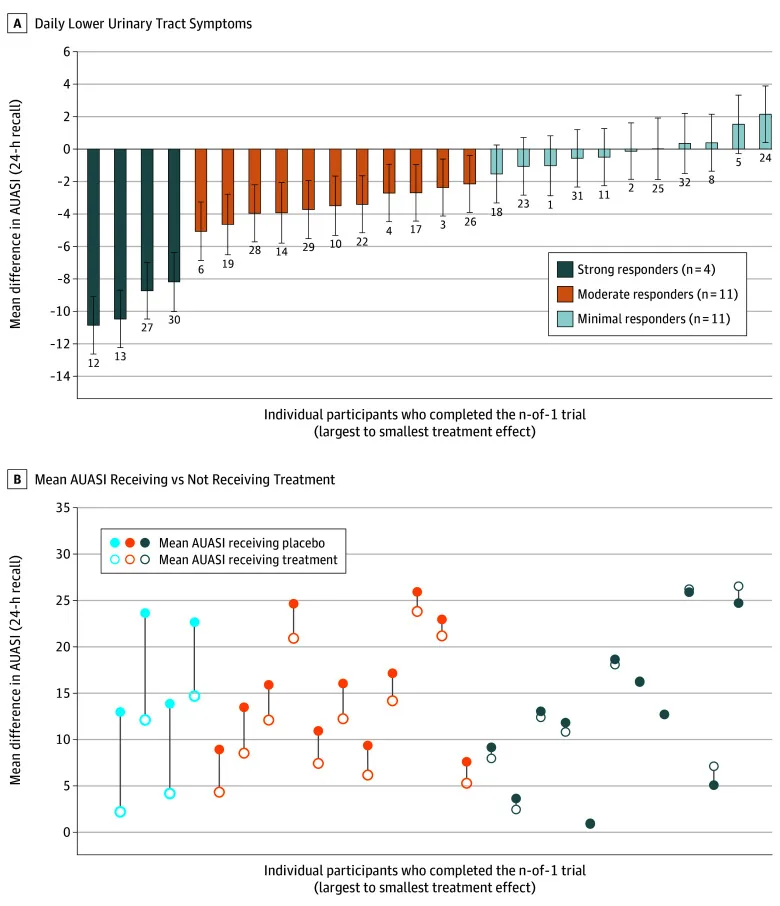
Ang iniulat ng papel. Sa 30 kalahok na sumubok sa buong protocol, 11 (36.7%) ang may minimal o walang epekto ng tamsulosin, 11 (36.7%) ang may katamtamang epekto at 4 (13.3%) ang may malakas na epekto; 4 ang hindi nakayanan ang placebo run-in. Ano ang dapat kopyahin. Minarkahan ng kulay ang kategorya ng epekto at ang legend ay nagbibigay ng n para sa bawat isa (4, 11, 11). Ang mga ID ng kalahok ay nasa ilalim ng bawat bar. Pinangalanan ng caption ang modelo sa likod ng mga pagtatantya (mga linear mixed model na inayos para sa panahon at oras) at kung ano ang mga error bar (95% CI). Ipinapakita ng Panel B ang placebo at treatment means ng bawat tao bilang isang linked pair, kaya nakikita ng mambabasa ang mga raw value sa likod ng epekto.
Box plot: paghahambing ng spread at outliers
Binubuod ng isang box plot ang bawat grupo ayon sa median, quartile, at range nito (Tukey 1977). Ito ang pinakamabilis na paraan upang ihambing ang pagkalat. Ang parehong 60 hayop, na iginuhit bilang mga kahon:
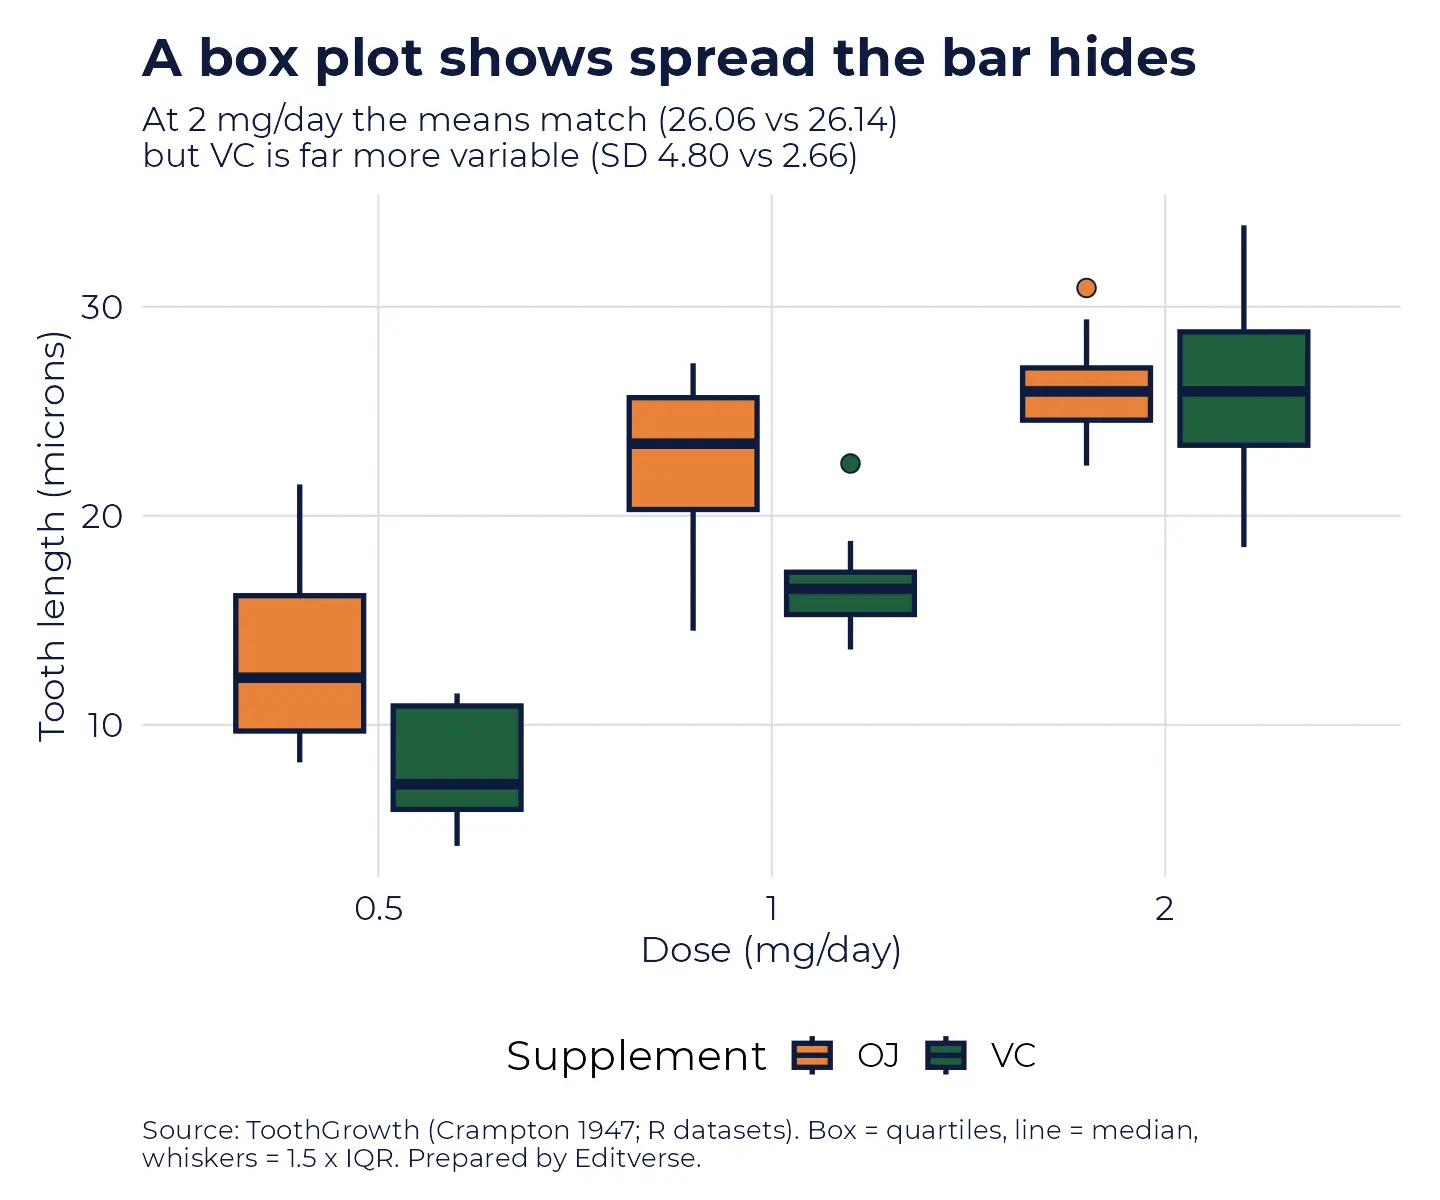
Paano ito basahin. Sa 2 mg/araw, ang parehong grupo ay may median na 25.95. Ang OJ ay mula 22.4 hanggang 30.9 (SD 2.66); VC mula 18.5 hanggang 33.9 (SD 4.80). Ang Welch t-test ng means ay nagbibigay ng t = -0.05, p = 0.96, 95% CI -3.80 hanggang 3.64: walang nakikitang mean difference, ngunit malinaw na magkaibang variability. Hindi ito makukuha sa isang talahanayan ng means lamang.
Halimbawa ng nailathalang: mga indibidwal na kaso na iginuhit sa bawat bar (JAMA Network Open, 2026)
Ganito rin ang prinsipyo sa isang klinikal na papel. Inihambing nina McNamara at mga kasamahan ang mga dosis ng radiation sa mga interventional echocardiographer na nakasuot ng suspended lead suit (95 kaso) o isang tradisyonal na lead apron (30 kaso). Ipinapakita ng Panel A ang bawat kaso bilang isang tuldok sa ibabaw ng kahon. Ang mga Panel B at C ay lumilipat sa mga bar upang ipakita ang porsyento ng mga kaso na may mga hindi matukoy na dosis at may mga dosis na hindi bababa sa 20 microsievert.
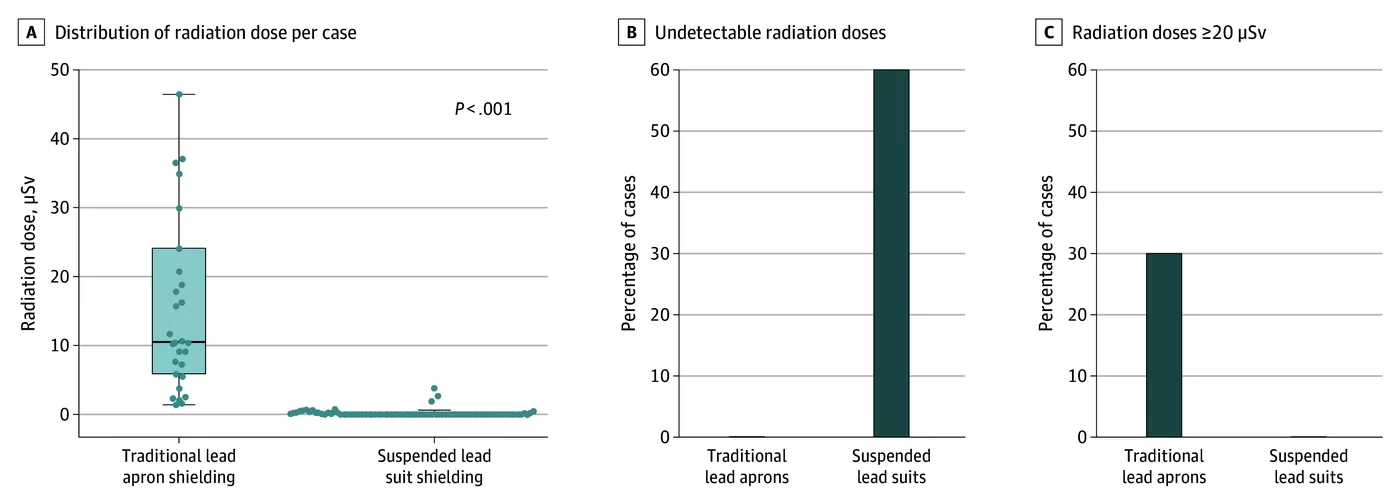
Ang iniuulat ng papel. Ang median na dosis ay 0.0 microsieverts (IQR 0.0 hanggang 0.3) na may mga suspendidong lead suit laban sa 10.6 (IQR 5.8 hanggang 24.1) na may mga tradisyonal na apron, P < .001. Ano ang dapat kopyahin. Una, ang mga tuldok: ang grupo ng suit ay isang kumpol na malapit sa zero na maaaring iguhit ng isang kahon lamang bilang isang patag na linya. Pangalawa, nakasaad sa caption na ang mga extreme outlier ay inalis mula sa panel A para sa mga layuning grapiko, at tinutukoy ang kahon (interquartile range), ang gitnang linya (median) at ang mga whisker (minimum at maximum na walang outlier). Pangatlo, ang mga bar ay ginagamit lamang para sa mga porsyento ng mga kaso, kung saan ang haba ng bar ang tamang encoding.
Histogram: ang hugis ng isang sukat
Hinahati ng isang histogram ang isang tuloy-tuloy na pagsukat sa mga bin at binibilang ang mga obserbasyon sa bawat isa. Sinasagot nito ang "ano ang hitsura ng baryabol na ito?". Ang datos ay 272 pagsabog ng Old Faithful geyser (Azzalini at Bowman 1990).
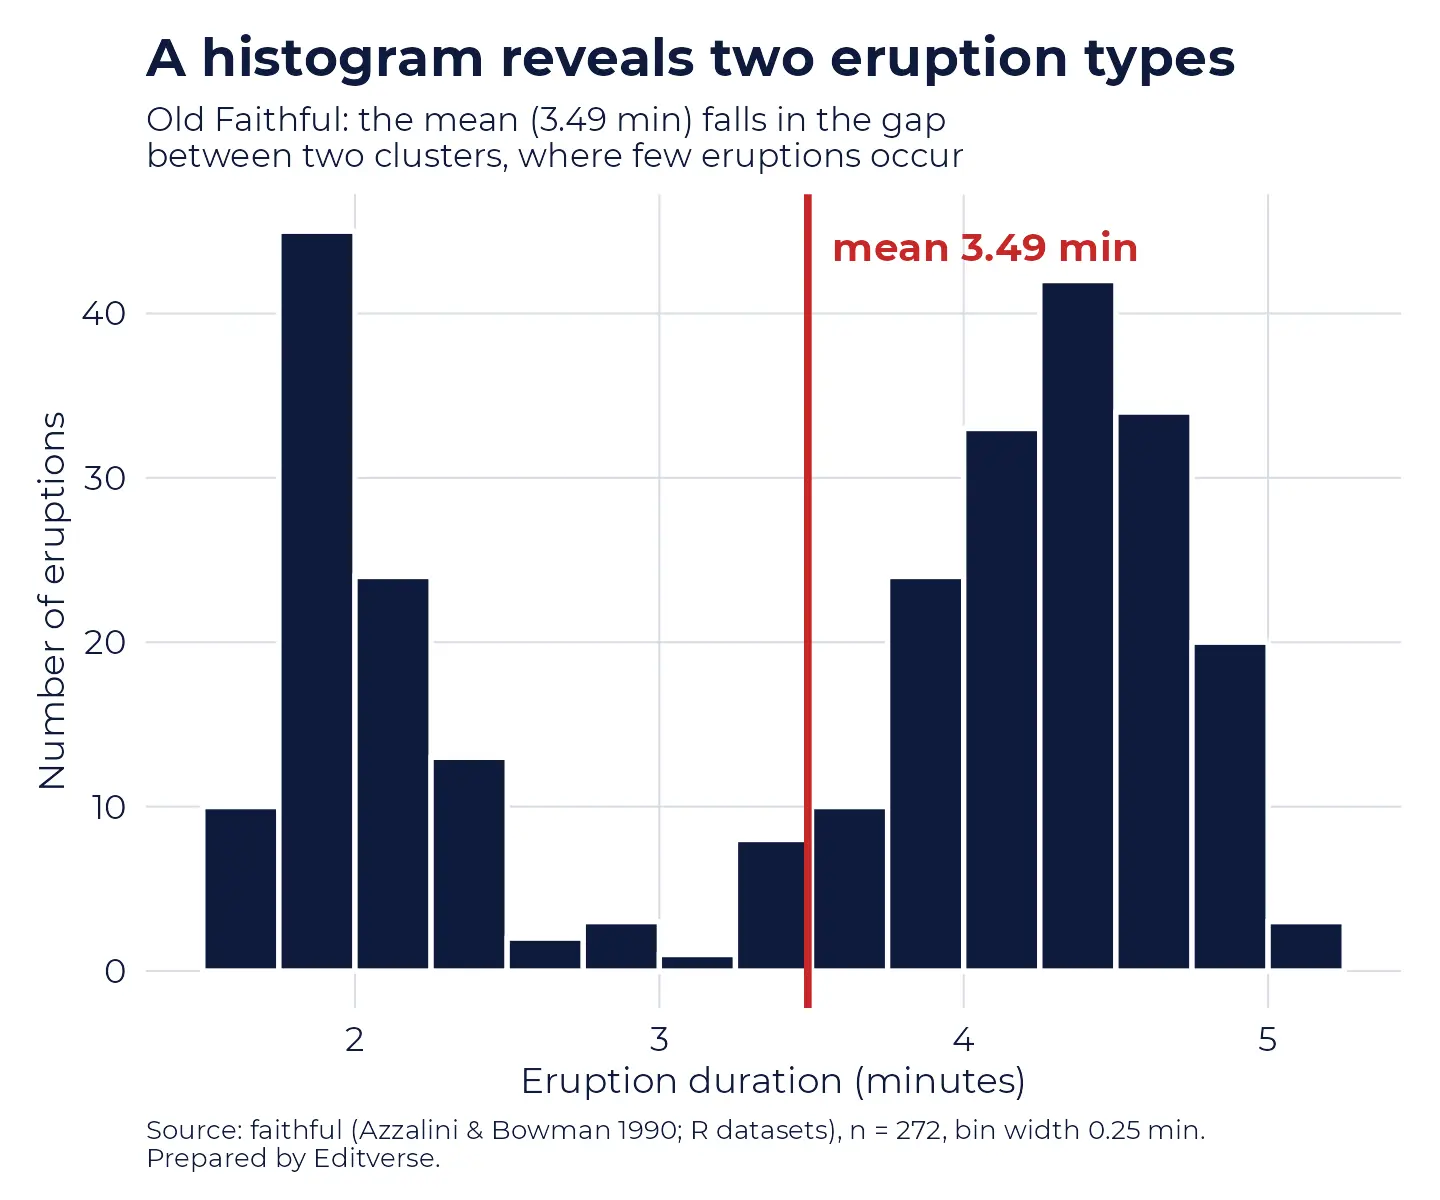
Paano ito basahin. Mayroong dalawang taluktok, malapit sa 2 at 4.4 minuto. Ang mean ay 3.49 minuto at ang median ay 4.0, ngunit 12 lamang sa 272 pagsabog (4.4%) ang tumatagal sa pagitan ng 2.5 at 3.5 minuto. Ang mean ay naglalarawan ng halos walang tunay na pagsabog. Ang pag-uulat ng "mean 3.49, SD 1.14" pa lamang ay magbibigay sa mga mambabasa ng maling larawan.
Halimbawa ng nailathalang: paghahambing ng mga hugis ng distribusyon sa mga plot ng biyolin (JAMA Network Open, 2026)
Kapag kailangan mong ihambing ang hugis ng isang distribusyon sa iba't ibang grupo, ang isang violin plot (Hintze at Nelson 1998) ay humuhubog ng isang mirrored histogram para sa bawat grupo. Ginamit ito nina Dias at mga kasamahan para sa taunang gastos sa pangangalagang pangkalusugan sa mga batang may genetic diagnosis (n = 86) at wala nito (n = 169) pagkatapos ng whole genome sequencing.
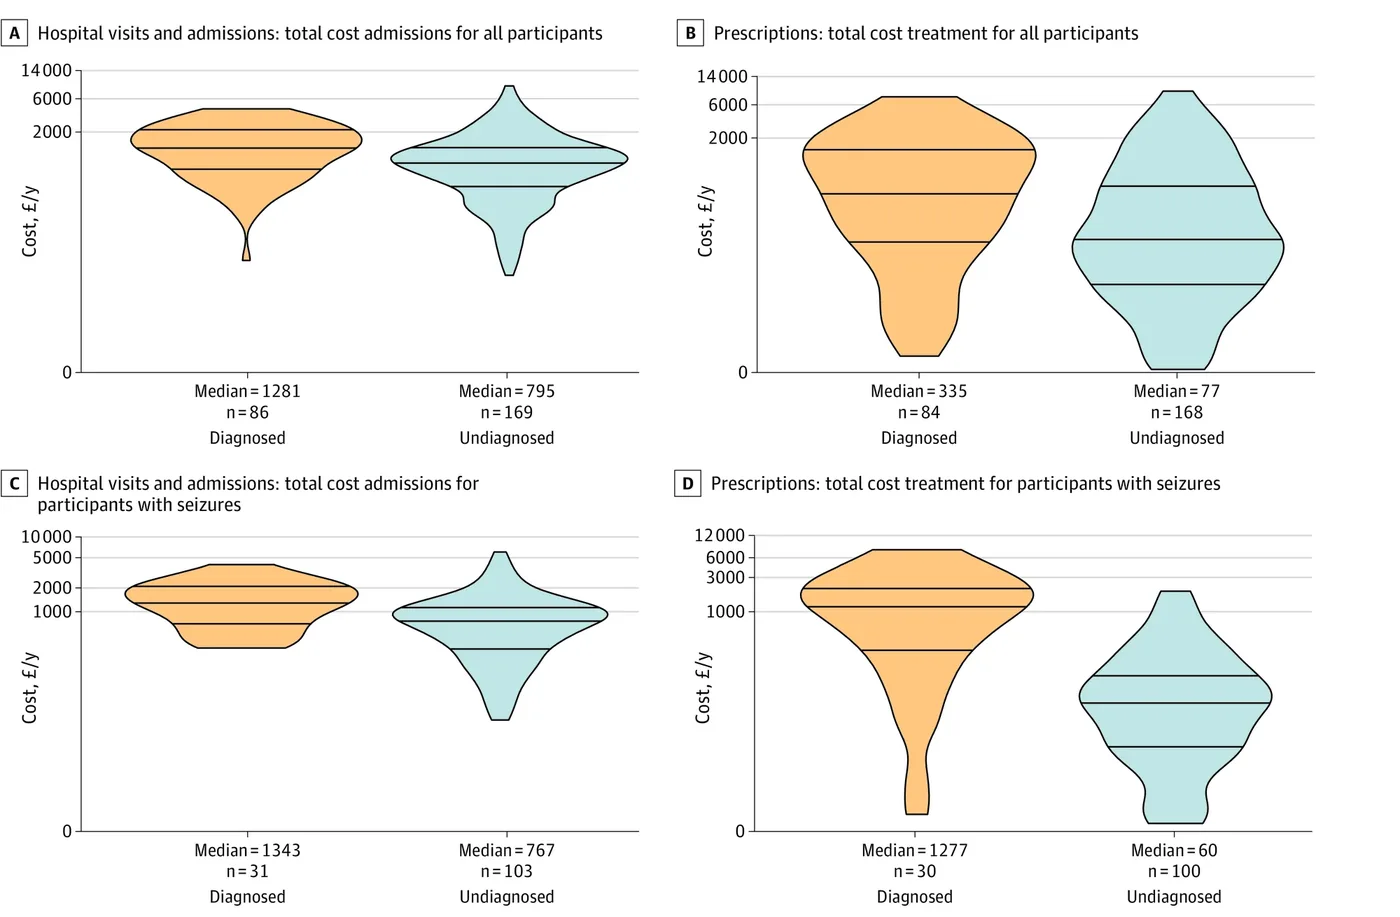
Ang ipinapakita ng pigura. Ang median na gastos sa pagpasok ay 1,281 pounds bawat taon sa grupong nasuri laban sa 795 sa grupong hindi nasuri (panel A). Ang median na gastos sa reseta ay 335 laban sa 77 (panel B, n = 84 at 168). Ano ang kokopyahin. Ang bawat biyolin ay may sukat ng sample at median sa ilalim nito, at ang mga pahalang na linya ay nagmamarka sa mga quartile, kaya nakukuha ng mambabasa ang buod at ang hugis nang magkasama. Nakasaad sa caption na isang pseudo-log y-axis ang ginamit para sa mga gastos na right-skewed habang pinapanatili ang mga halagang zero. Dahil ang axis ay hindi linear, basahin ang mga halaga mula sa mga may label na ticks at mga naka-print na median, hindi sa pamamagitan ng mata.
Scatter plot: dalawang sukat na magkasama
Inilalagay ng scatter plot ang bawat obserbasyon sa mga halagang x at y nito. Sinasagot nito ang "magkasabay ba ang dalawang sukat na ito?". Ang datos ay timbang at fuel economy para sa 32 modelo ng kotse (Henderson at Velleman 1981).
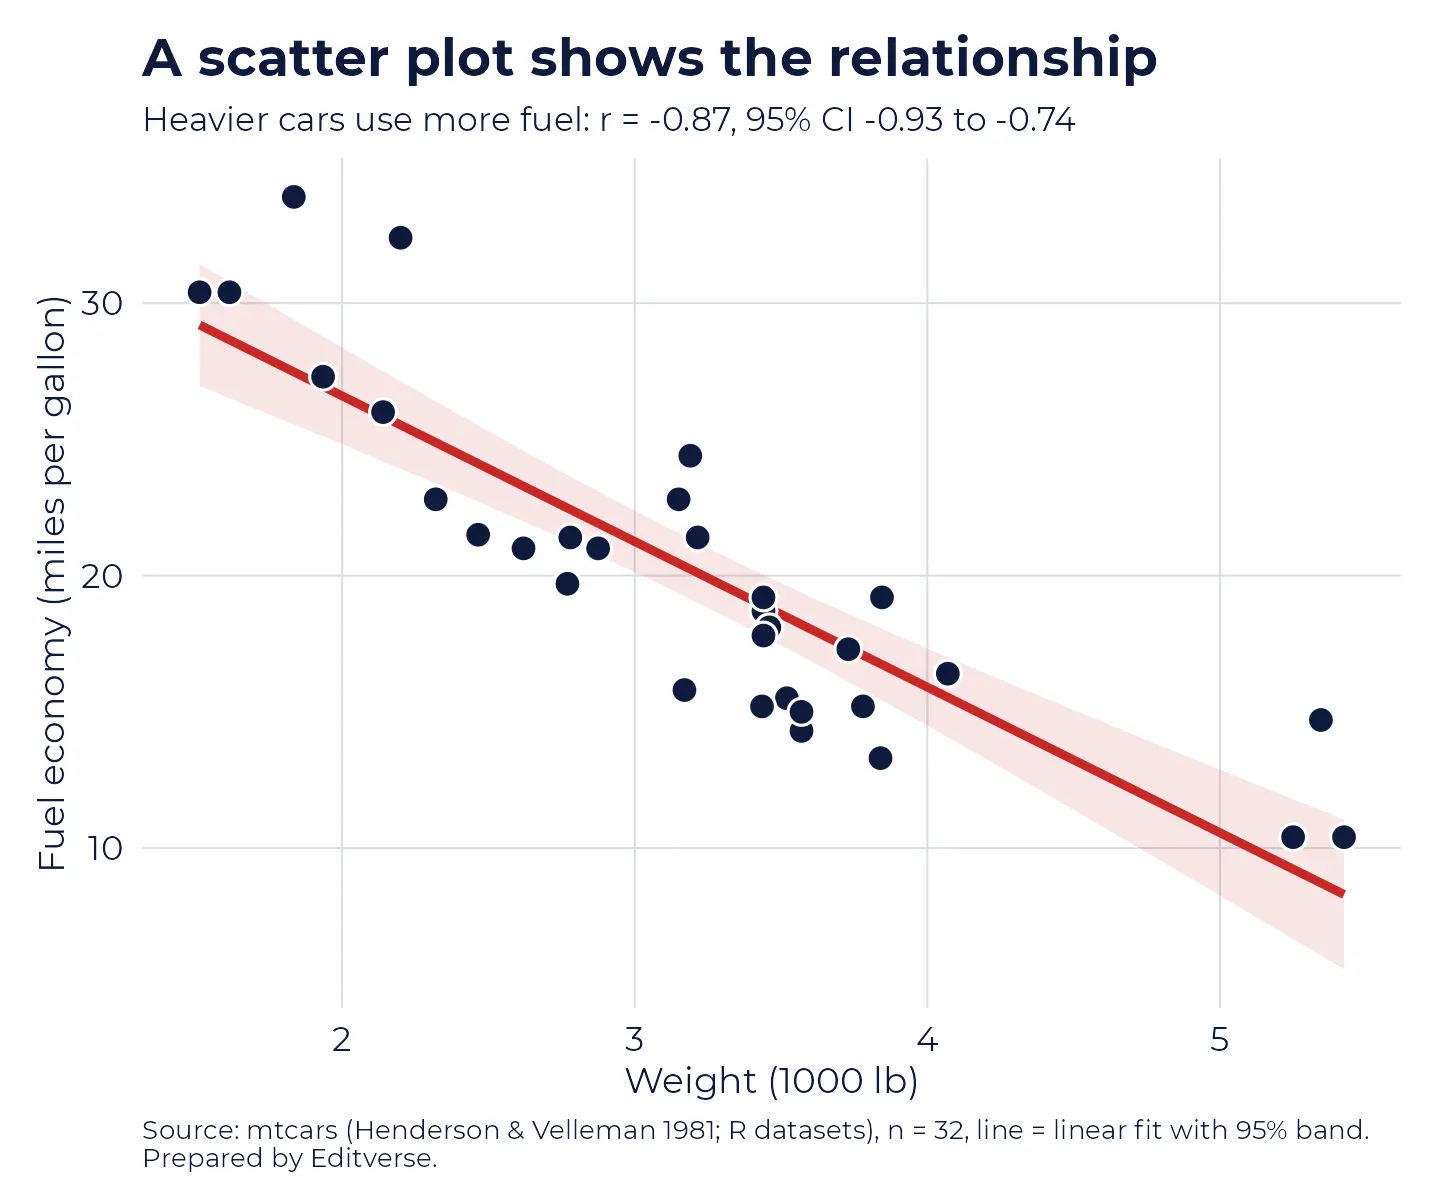
Paano ito basahin. Pearson r = -0.87 (95% CI -0.93 hanggang -0.74, p = 1.3e-10). Ang fitted slope ay -5.34 mpg bawat 1,000 lb, at ang bigat ang nagpapaliwanag ng 75% ng pagkakaiba-iba sa fuel economy (R-squared = 0.75). Iulat ang interval, hindi lamang ang r: ang isang correlation na walang confidence interval nito ay nagtatago kung gaano kalaki ang maaaring igalaw ng tantiya.
Halimbawa ng nailathalang: scatter plot kasama ang isang agreement plot (Nature Communications, 2026)
Ang isang scatter plot na may correlation coefficient ay sumasagot ng "magkasabay ba ang mga ito?". Hindi nito sinasagot ang "magkatugma ba ang dalawang pamamaraan?". Sinubukan nina Butkow at mga kasamahan ang isang earbud-based na pagtatantya ng stroke volume laban sa isang clinical reference device sa 23 malulusog na kalahok, at ipinakita ang parehong pananaw sa isang pigura.
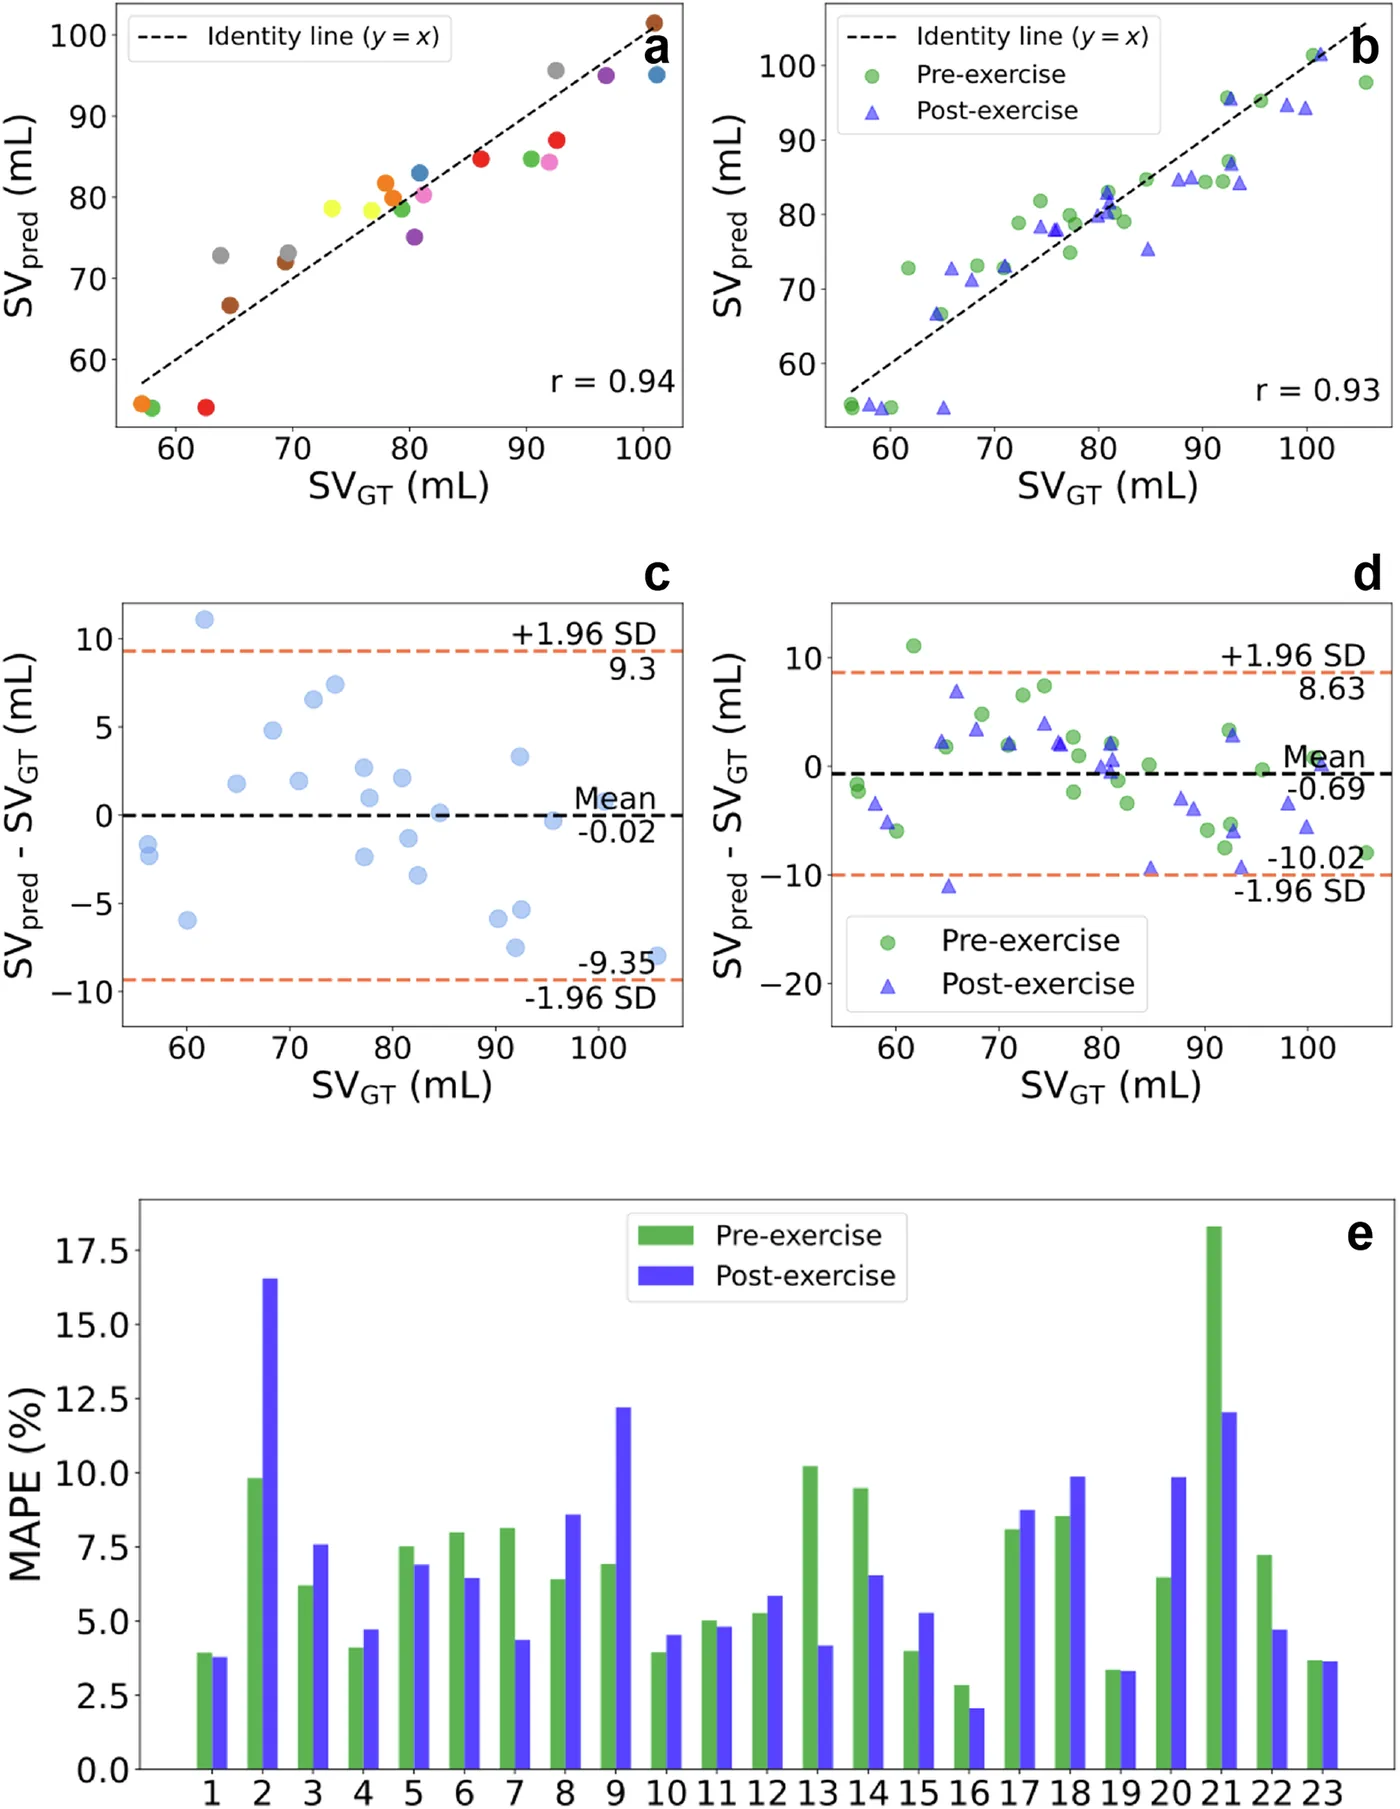
Ang iniuulat ng papel. Pearson r = 0.94 sa pagitan ng average na hinulaang at reference stroke volume, isang mean absolute error na 5.24 mL at isang porsyentong error na 11.05% sa mga limitasyon ng kasunduan. Sa panel c, ang mean difference ay -0.02 mL na may 95% na mga limitasyon ng kasunduan mula -9.35 hanggang 9.3 mL. Ano ang kokopyahin. Ang panel a ay nagdaragdag ng identity line (y = x), kaya nakikita ng mambabasa ang paglihis mula sa perpektong kasunduan, hindi lamang isang trend. Ang mga panel c at d ay nagdaragdag ng pananaw ni Bland-Altman (Bland at Altman 1986), na siyang nagpapakita ng laki ng hindi pagkakasundo. Tingnan ang aming gabay sa mga limitasyon ng kasunduan at ang bias-difference plot.
Line graph: pagbabago sa paglipas ng panahon
Ang isang line graph ay nag-uugnay ng magkakasunod na obserbasyon, kaya sinusundan ng mata ang trend. Ang datos ay taunang daloy ng Nile sa Aswan mula 1871 hanggang 1970 (Cobb 1978).
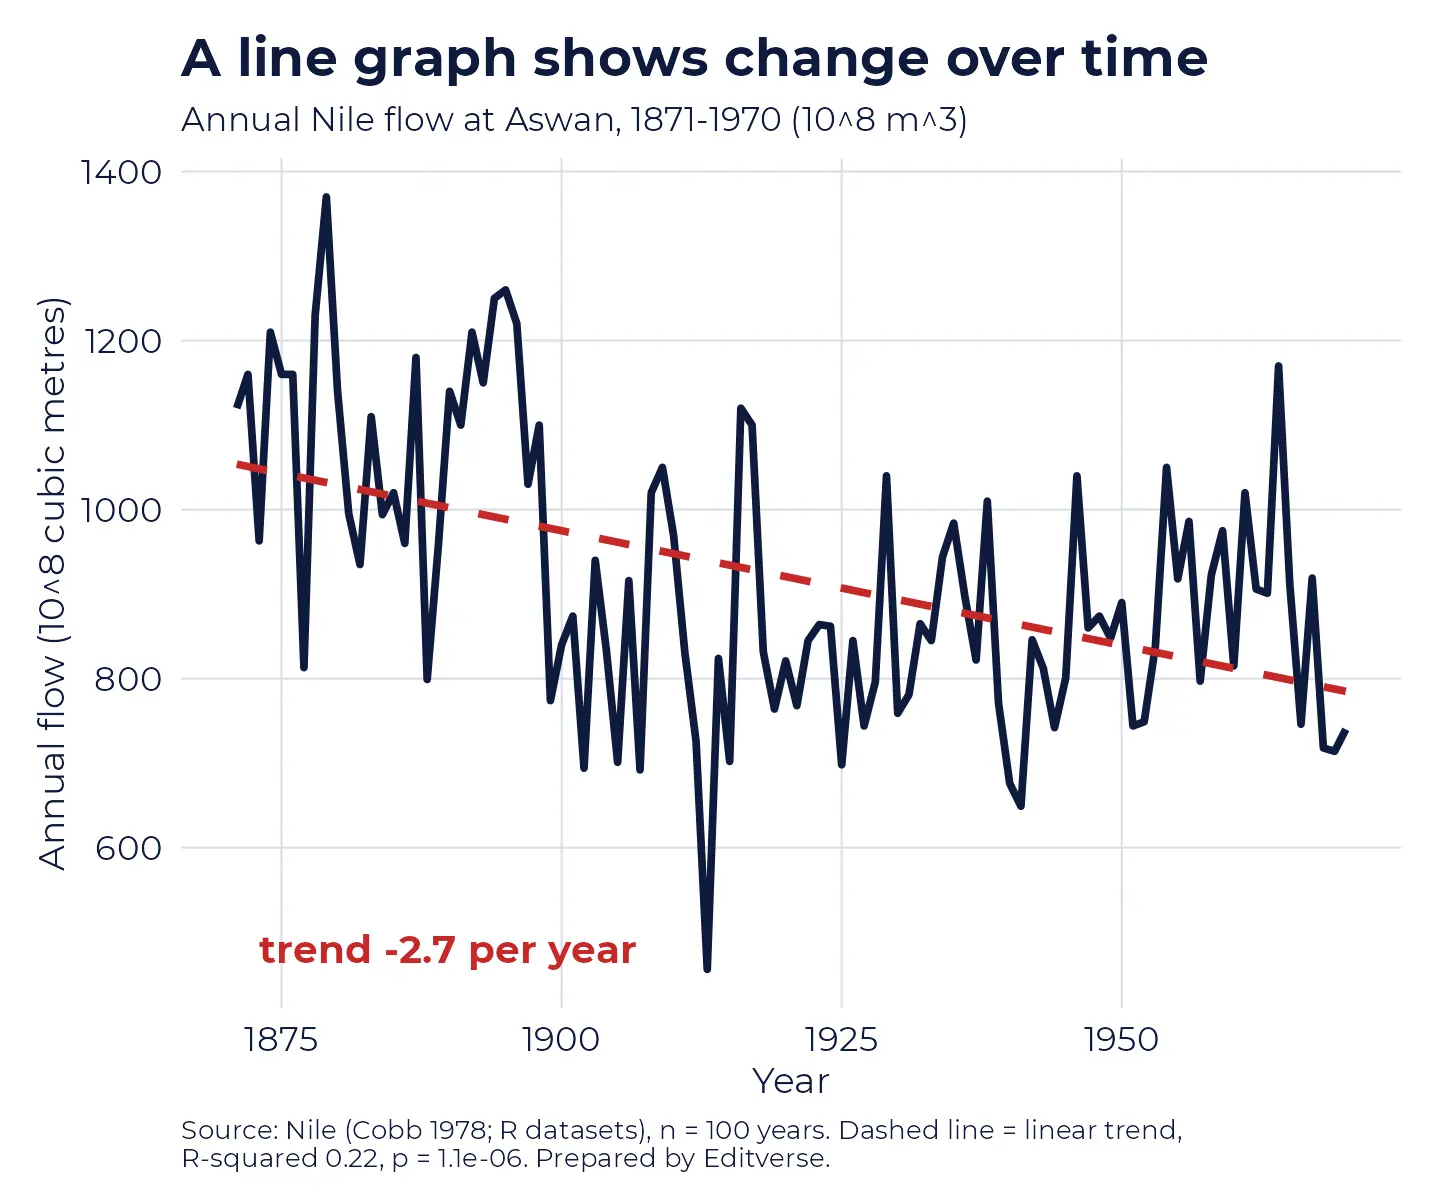
Paano ito basahin. Ang fitted trend ay -2.7 units kada taon (R-squared 0.22, p = 1.1e-06), ngunit minamaliit nito ang nangyari. Natuklasan ni Cobb (1978) ang isang pagbabago noong 1898. Ang mean flow ay 1,098 para sa 1871 hanggang 1898 (n = 28) at 850 pagkatapos (n = 72): isang hakbang na humigit-kumulang 248 units (Welch p = 7.3e-11). Inilalarawan ng datos ang isang biglaang pagbabago, hindi isang mabagal na pagbaba.
Halimbawa ng nailathalang: isang serye ng oras na may mga agwat ng kumpiyansa (JAMA Network Open, 2026)
Ipinlano nina Matta at mga kasamahan ang mga rate ng pagbisita sa emergency department sa Ontario, Canada, para sa bawat taon mula 2007 hanggang 2022: lahat ng pagbisita (n = 29,461,281) sa panel A at mga pagbisita na may diagnosis sa urologic (n = 2,192,213) sa panel B.

Ang iniuulat ng papel. Ang mga rate ng pagbisita sa urologic na nakabatay sa edad at kasarian ay tumaas mula 0.91 bawat 100 katao noong 2007 patungong 1.0 noong 2015, pagkatapos ay bumaba hanggang 2020. Ano ang dapat kopyahin. Isang punto bawat taon na may 95% confidence interval, isang y-axis range na pinili upang ipakita ang paggalaw sa halip na isang zero baseline (katanggap-tanggap para sa isang line graph, hindi para sa mga bar), at dalawang panel sa halip na isang pangalawang axis. Ang pagbaba sa paligid ng 2020 ay makikita sa isang sulyap. Tulad ng halimbawa sa Nile, ang isang tuwid na linya ng trend na iginuhit sa mga taong ito ay magtatago nito.

Gusto mo bang ihanda ang mga pigurang ito para sa iyong journal? Magpadala ng hilaw na datos, isang magaspang na sketch o isang umiiral na pigura. Naghahatid kami ng hanggang 10 pigura na naka-format ayon sa mga detalye ng iyong target na journal.
Mga heat map, pie chart at dual-axis chart: kung kailan nila nakuha ang kanilang lugar
Ang tatlong graph na ito ang nakakakuha ng pinakamaraming komento mula sa mga tagasuri, dahil ang bawat isa ay maaaring makapanlinlang kapag ginamit ito sa labas ng niche nito. Ang bawat isa ay ginawa sa ibaba batay sa totoong datos, kasama ang mga numerong babasahin at ang tuntunin na nagpapasya kung nararapat ba itong gamitin.
Mapa ng init: isang grid na masyadong malaki para mabasa bilang mga numero
Kinukulayan ng heat map ang bawat cell ng isang grid ayon sa halaga nito. Gamitin ito kapag ang isang talahanayan ng mga numero ay masyadong malaki para i-scan, tulad ng isang correlation matrix sa maraming baryabol o ekspresyon sa maraming sample. Ang halimbawa ay ang correlation matrix ng limang sukat sa 32 modelo ng kotse (Henderson at Velleman 1981). Ang limang baryabol ay nagbibigay lamang ng 10 pares, kaya sapat na ang isang talahanayan dito; ang parehong disenyo ay sumasaklaw sa dose-dosenang mga baryabol, kung saan hindi kaya ng isang talahanayan.
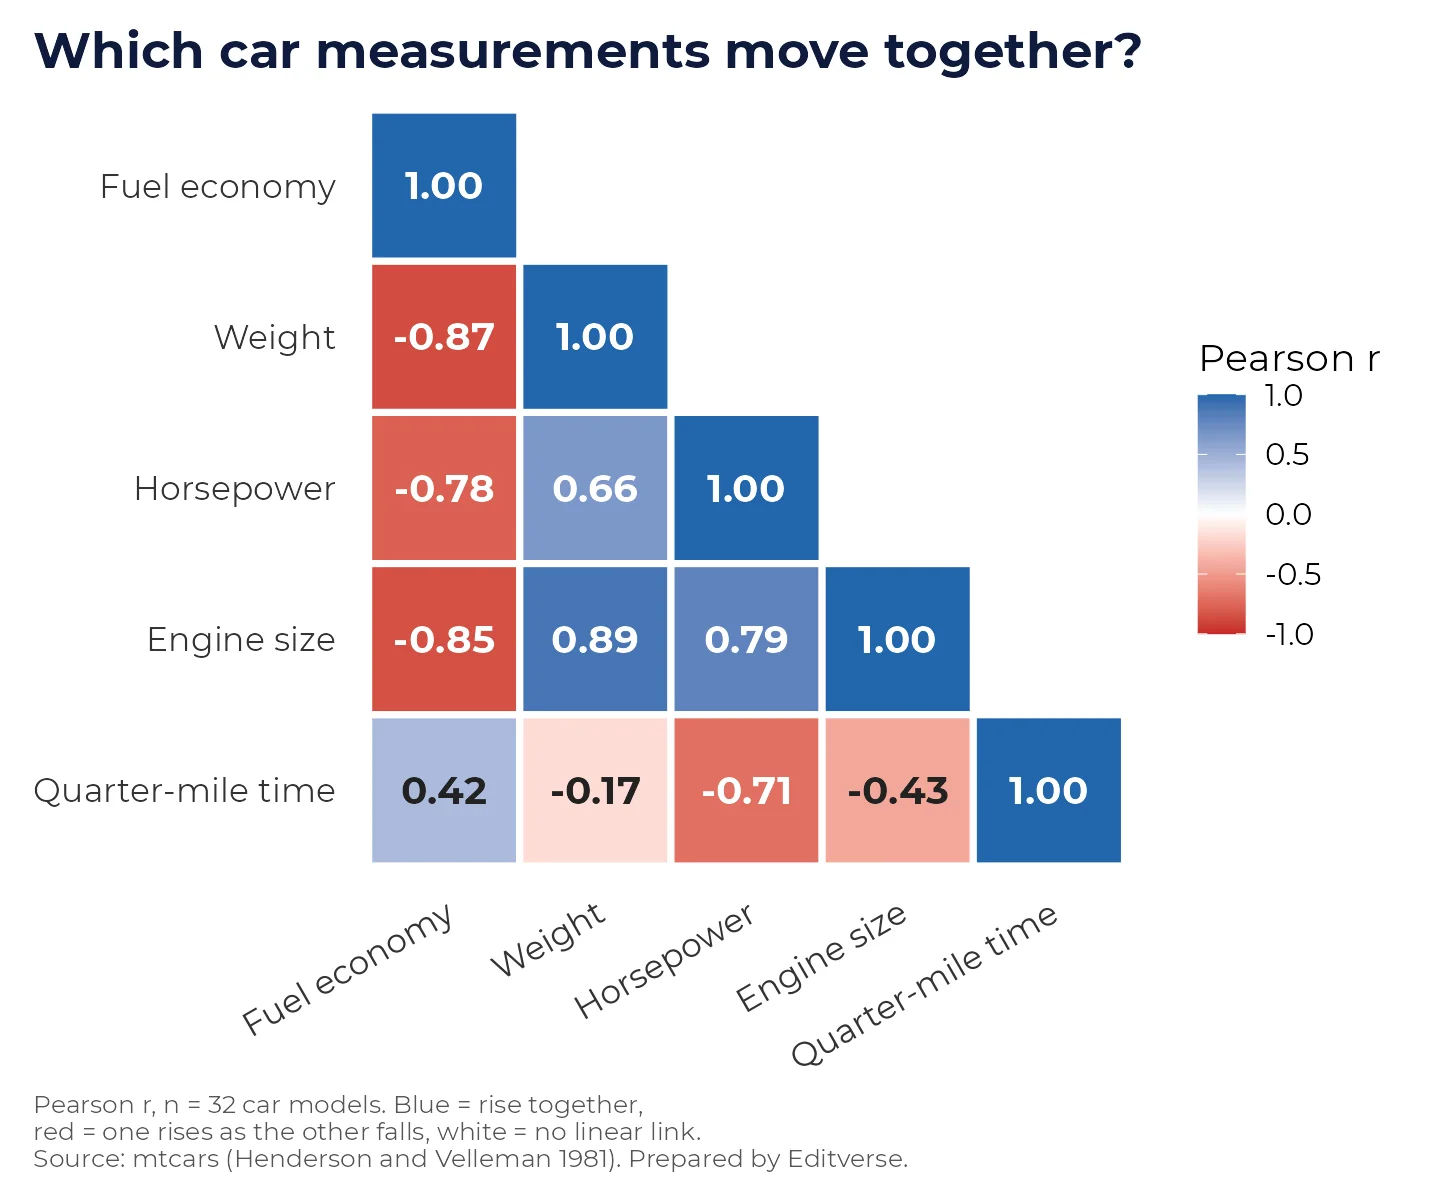
Paano ito basahin. Ang mga asul na selula ay sabay na tumataas; ang mga pulang selula ay gumagalaw sa magkabilang direksyon. Ang bigat at laki ng makina ay may malakas na kaugnayan (r = 0.89), at parehong may mas mababang fuel economy (r = -0.87 at -0.85). Ang oras ng isang-kapat na milya ay mahina lamang na nakatali sa bigat (r = -0.17). Dahil ang halaga ay nakalimbag sa bawat selula, hindi na kailangang hulaan ng mambabasa ang isang numero mula sa isang kulay.
Apat na pagpipilian ang dahilan kung bakit ito mapagkakatiwalaan. Isang diverging scale na nakasentro sa zero na may mga takdang limitasyon na -1 hanggang 1. Ang halagang nakalimbag sa bawat cell. Tanging ang ibabang tatsulok lamang, dahil inuulit ito ng itaas na kalahati. Mga pangalan ng variable sa mga salita, na may mga unit sa caption. Iwasan ang mga rainbow color scale: Ipinakita nina Crameri, Shephard at Heron (2020) na maaari nilang maling ilarawan ang datos at ibukod ang mga mambabasang may kakulangan sa color-vision.
Pie chart: mga bahagi ng isang kabuuan, kapag ang ilang hiwa ay malinaw na nagkakaiba
Ipinapakita ng pie chart kung paano nahahati ang isang buo sa mga bahagi. Mas tumpak na hinuhusgahan ng mga mambabasa ang posisyon gamit ang isang karaniwang iskala kaysa sa anggulo o lawak (Cleveland at McGill 1984), kaya gumagana lamang ang isang pie kapag malinaw na nagkakaiba ang ilang hiwa. Narito ang parehong bilang ng mga sisiw sa anim na grupo ng pagkain na iginuhit sa magkabilang direksyon (chickwts, n = 71).
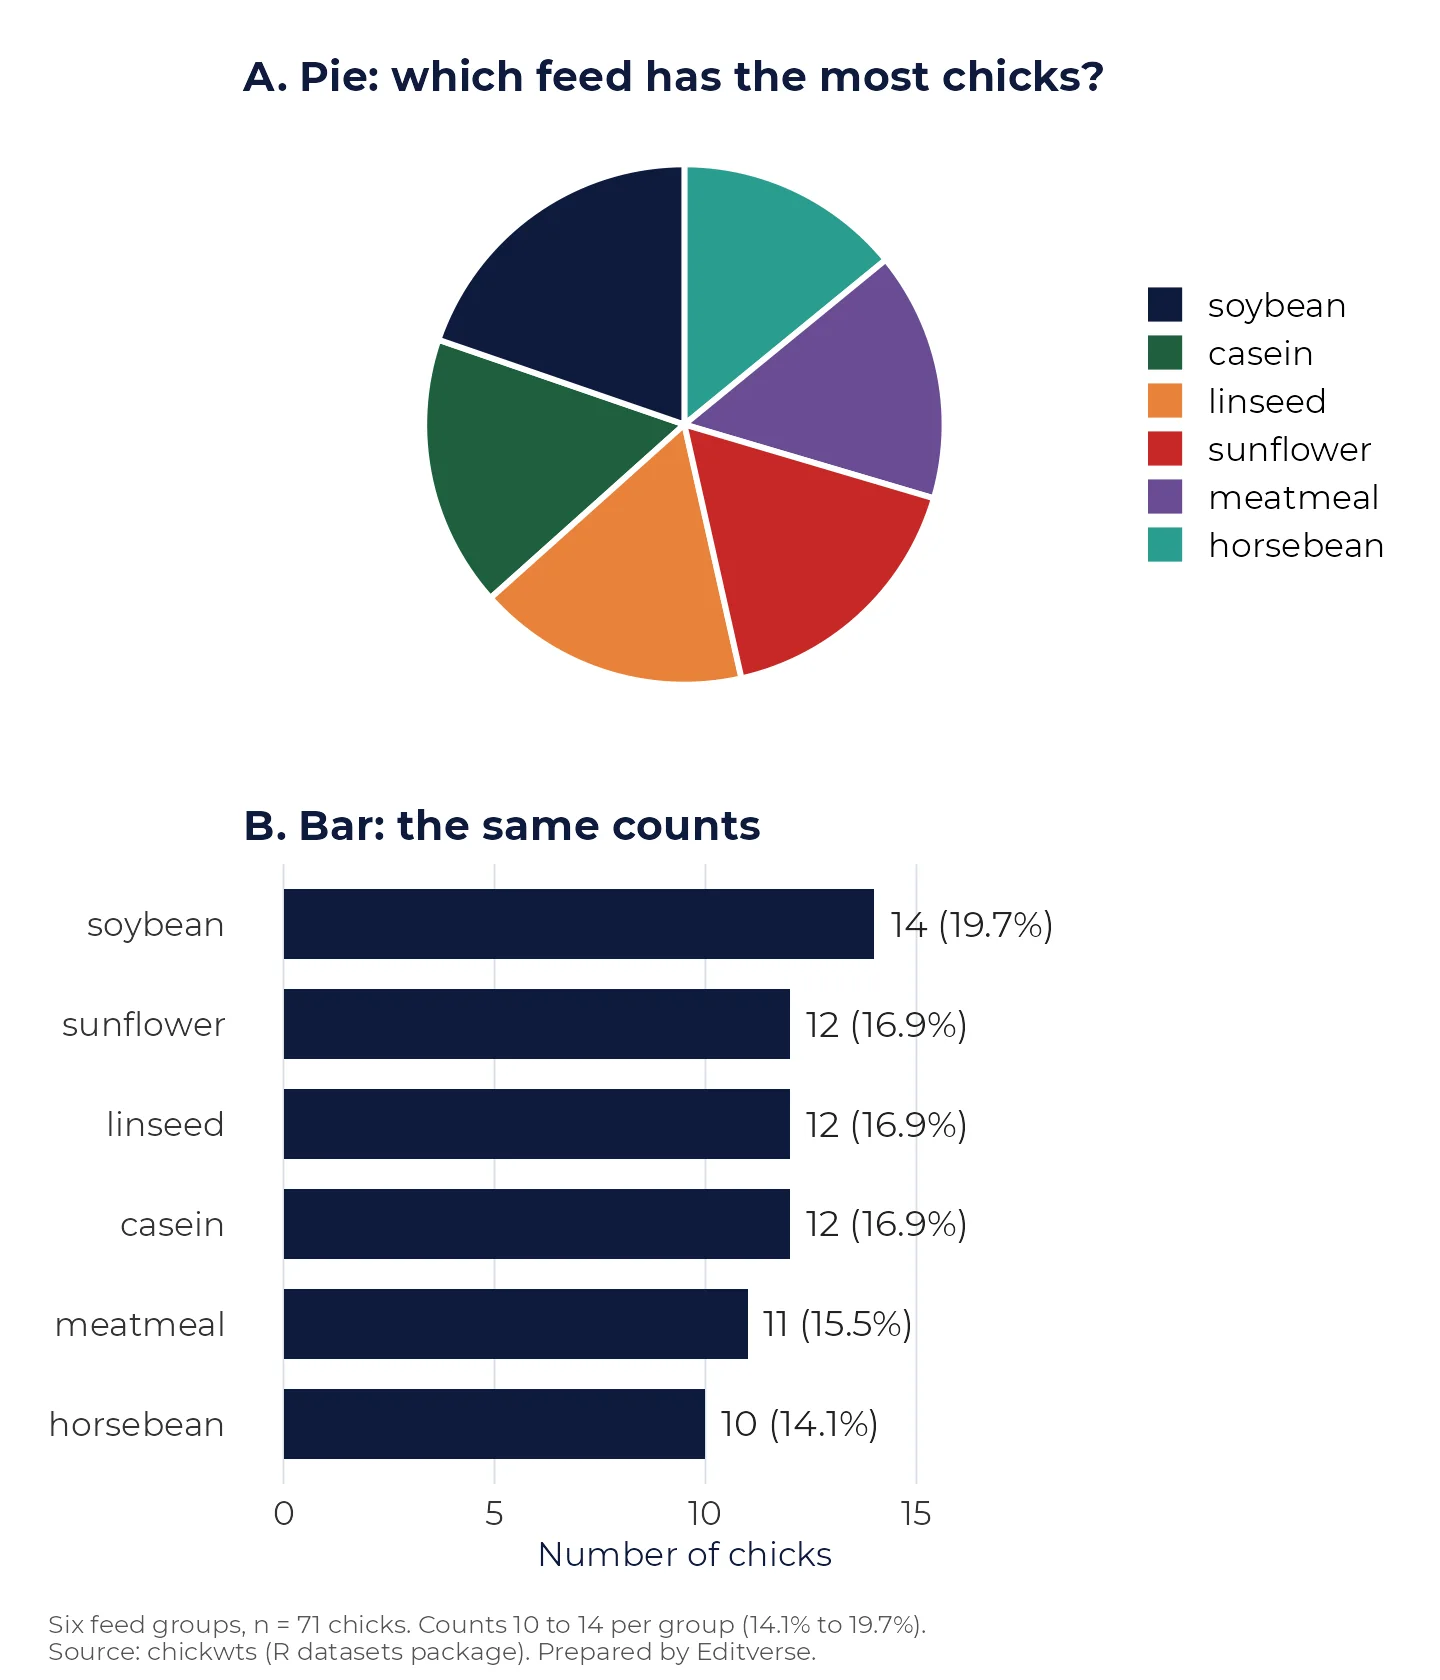
Paano ito basahin. Sa pie, sunflower, linseed at casein (12 sisiw bawat isa), meatmeal (11) at horsebean (10) ay halos magkapareho ang hitsura, at hindi mababasa ang ranggo. Sa nakaayos na bar chart, ang mga leads ng soybean (14 na sisiw, 19.7%) at horsebean (10, 14.1%) ay makikita sa isang sulyap, kung saan ang mga bilang ay nakalimbag sa tabi ng bawat bar. Gumamit lamang ng pie para sa 2 hanggang 5 hiwa na may malinaw na mga puwang sa pagitan ng mga ito, at i-print ang bawat porsyento. Kung hindi, ayusin ang mga kategorya at gumamit ng mga bar.
Tsart na may dalawahang aksis: dalawang iskala, isang kuwento ang pipiliin ng may-akda
Ang isang dual-axis chart ay naglalagay ng dalawang sukat sa isang plot, bawat isa ay may kanya-kanyang y-axis. Pinipili ng awtor ang bawat sukat, at maaaring baguhin ng pagpipilian ang kwento. Ang halimbawa ay ang pang-araw-araw na halaga ng pagsasara ng dalawang European stock indices, ang German DAX at ang British FTSE, mula 1991 hanggang 1998 (1,860 araw ng kalakalan).
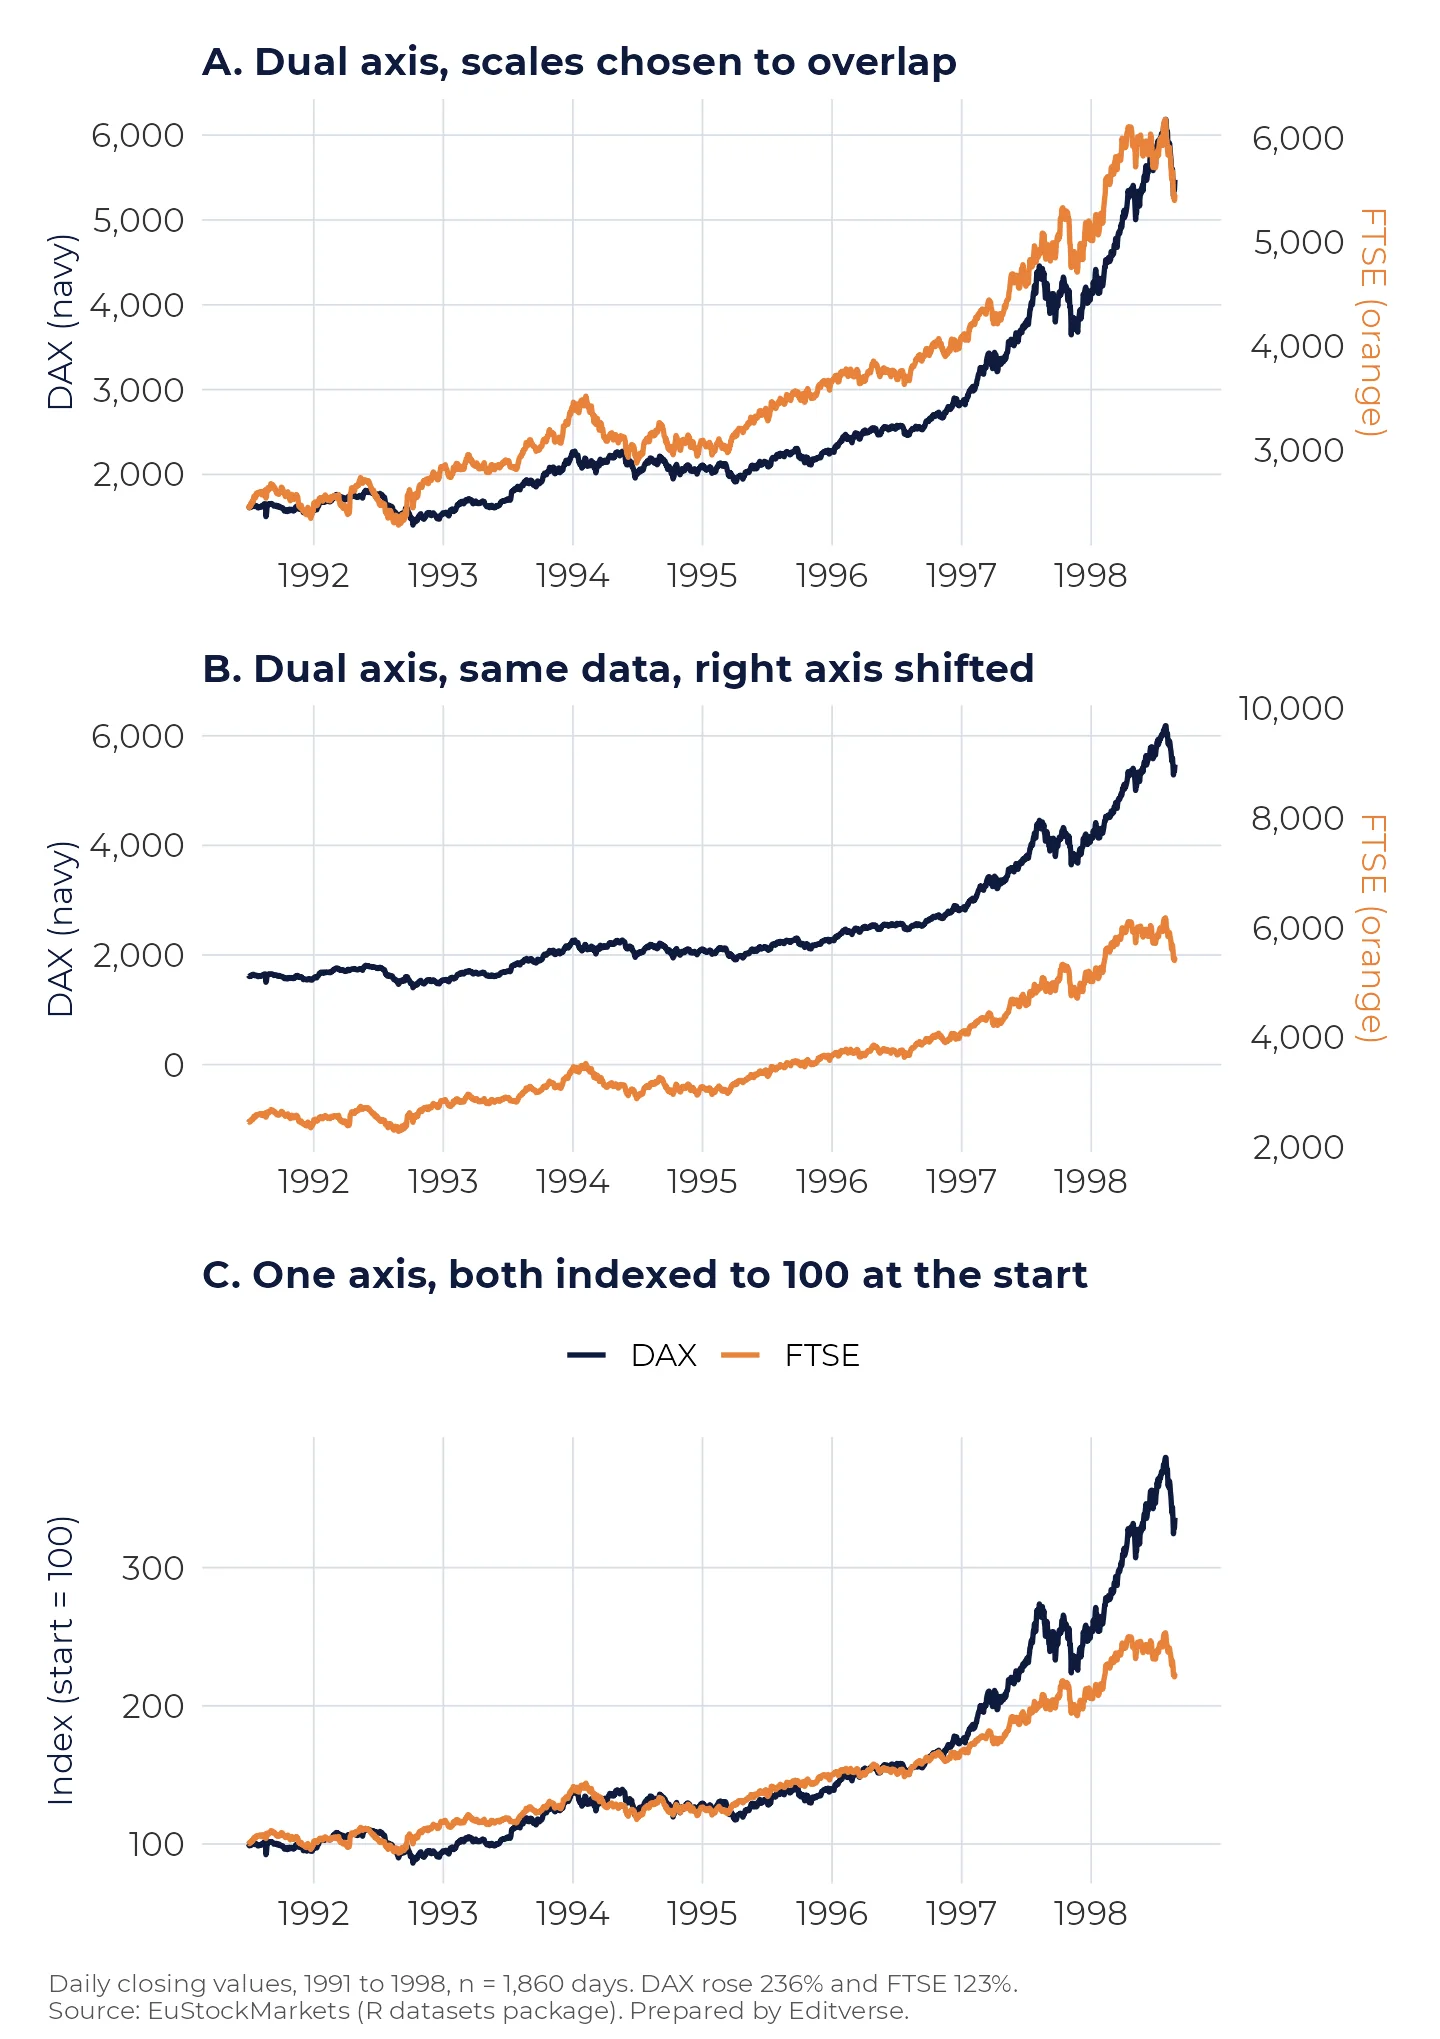
Paano ito basahin. Sa panel A, ang kanang aksis ay nakaunat kaya ang parehong linya ay sumasaklaw sa parehong taas, at ang FTSE ay tila nangunguna sa DAX hanggang sa maabutan ng DAX noong 1998. Sa panel B, ang parehong datos, habang inilipat ang kanang aksis, ay mukhang dalawang linya na hindi kailanman nagtatagpo. Inilalagay ng Panel C ang pareho sa isang aksis, na naka-index sa 100 sa simula: ang DAX ay nagtatapos sa humigit-kumulang 336 at ang FTSE sa humigit-kumulang 223, dahil ang DAX ay tumaas ng 236% at ang FTSE ay 123%. Walang dual-axis panel ang nagpapakita niyan.
Panoorin ang ugnayan ng mga trending series. Sa loob ng 1,860 araw, ang ugnayan ng dalawang antas ng index ay r = 0.975, ngunit kadalasan ay ipinapakita nito na parehong tumaas ang dalawa. Ang ugnayan ng mga daily log returns, na nag-aalis ng shared trend, ay r = 0.64 (n = 1,859). Ang parehong numero ay kinalkula nang hiwalay sa R at Python at magkatugma.
Mas ligtas na mga opsyon. I-index ang parehong serye sa isang karaniwang baseline sa isang axis (panel C), o magpatong-patong ng dalawang panel na may parehong x-axis. Kung kailangan mong gumamit ng dalawang axes, kulayan ang bawat axis upang tumugma sa linya nito, magbigay ng mga unit, at sabihin ang napiling scale sa caption. Pinag-aralan nina Isenberg at mga kasamahan (2011) kung paano binibigyang-kahulugan ng mga mambabasa ang mga dual-scale chart.
Checklist bago ka magsumite ng pigura
- Ang uri ng graph ay tumutugma sa tanong (tingnan ang talahanayan sa itaas).
- Ang mga axe ng bar graph ay nagsisimula sa sero; ang mga indibidwal na punto ay ipinapakita kapag ang n ay maliit.
- Nakasaad sa caption ang n, kung ano ang kinakatawan ng mga error bar o band, at ang pinagmulan ng data.
- Ang mga kulay ay nananatiling nakikilala sa greyscale at para sa mga mambabasang color-blind.
- Mababasa ang teksto sa lapad ng nakalimbag na kolum ng iyong target na journal.
- Ang mga axe ay may label na mga unit; walang chart junk (mga 3D effect, mga anino).
Karagdagang babasahin tungkol sa mga prinsipyo: Nagtakda sina Rougier, Droettboom at Bourne (2014) ng sampung tuntunin para sa mas mahusay na mga numero, at sinasaklaw naman ng Midway (2020) ang mga prinsipyo ng disenyo para sa epektibong paggunita ng datos. Parehong binanggit sa ibaba kasama ang mga DOI. Para sa mas malalim na pagkakaiba ng bar graph laban sa histogram, tingnan ang Bar Charts vs Histograms ; upang itugma ang isang graph sa isang statistical test, tingnan ang Choosing the Right Statistical Test.
Mga Libreng Kagamitan sa Pananaliksik para sa Paggawa ng mga Graph na Ito
Mga Libreng Kagamitan sa Pananaliksik mula sa Editverse
- GraphPro: bumuo ng mga tsart na handa nang ilathala, 25 uri, na may built-in na t-test, ANOVA, correlation, at chi-square p-values. Libre, walang pag-signup.
- StatPro: mga libreng statistical calculator at isang tool para sa pagpili ng pagsubok na sumasaklaw sa mga paghahambing ng grupo, mga resultang pangkategorya, pagsusuri batay sa oras ng pangyayari, at katumpakan ng pagsusuri.
- Flowchart Pro: bumuo ng mga flow diagram ng PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE, at ARRIVE nang direkta sa iyong browser.
Mga Propesyonal na Numero at Pagsusuring Pang-estadistika
Kung handa na ang iyong mga resulta at kailangan mo ng mga numerong hindi ipapadala pabalik ng isang tagasuri, ang mga subject-matter statistician at figure designer sa Editverse ay bubuuin ang mga ito ayon sa lapad ng column, mga font, at mga kinakailangan sa kulay ng iyong target na journal. Kung bukas pa rin ang pagsusuri mismo, ang mga statistical package sa ibaba ang unang magpapatakbo nito.
figure
$300
Hanggang 10 pigura na handa nang ilathala sa PDF (vector), PNG, EPS at TIFF, na naka-format ayon sa iyong target na journal. 3-5 araw ng negosyo.
Pagsusuri at pagsusuri
$475
Pagsusuri sa disenyo ng pag-aaral, pagsusuri na may kasamang mga pagsusuri sa palagay, mga talahanayan at pigura na may kalidad ng publikasyon, at isang nakasulat na seksyon ng mga pamamaraang pang-estadistika. 5-10 araw ng negosyo.
Advanced na pagsusuri
$750
Regresyon, magkahalong modelo, pagsusuri ng kaligtasan at mga marka ng propensidad para sa mga kumplikadong disenyo. 5-7 araw ng negosyo.
Sinusulat ang buong manuskrito sa paligid ng mga pigurang ito? Kita mo? mga serbisyo sa pagsulat ng manuskritoAng kasanayan sa Editverse ay naaayon sa COPE, ICMJE at GPP 2022.
Konklusyon
Piliin ang graph mula sa tanong, ipakita ang mga hilaw na punto kung kaya mo, at basahin ang mga numero bago mo isulat ang caption. Ang bawat isa sa limang graph sa itaas ay nagkuwento ng iba't ibang kwento mula sa parehong uri ng buod: magkaparehong mean na may iba't ibang spread, isang mean na naglalarawan ng walang tunay na pagsabog, isang trend na nagtago ng isang hakbang. Iyan ang hinahanap ng mga tagasuri.
Mga Madalas Itanong
Ano ang mga pangunahing uri ng graph na ginagamit sa pananaliksik?
Sakop ng mga bar graph, box plot, histogram, scatter plot, at line graph ang halos lahat ng seksyon ng resulta. Mas makitid ang mga trabahong ginagamit sa heat map, pie chart, at dual-axis chart. Piliin ang graph ayon sa tanong na iyong sinasagot, hindi ayon sa nakasanayan.
Aling graph ang dapat kong gamitin upang ihambing ang dalawang grupo?
Gumamit ng bar graph kung saan naka-overlay ang bawat data point, o isang box plot. Sa halimbawa ng guinea pig sa itaas, dalawang grupo ang may mean na humigit-kumulang 26 microns, ngunit halos doble ang pagkakaiba ng kanilang mga spread.
Kailan ko dapat gamitin ang histogram sa halip na bar graph?
Gumamit ng histogram para sa isang tuloy-tuloy na pagsukat, tulad ng oras ng pagsabog o presyon ng dugo, dahil ipinapakita nito ang distribusyon. Gumamit ng bar graph upang ihambing ang mga kategorya o mean ng grupo.
Pinapatunayan ba ng isang scatter plot na ang isang variable ay sanhi ng isa pa?
Hindi. Sa datos ng kotse, ang timbang at fuel economy ay may r = -0.87, ngunit ang plot ay nagpapakita lamang ng kaugnayan. Ang mga causal claim ay nangangailangan ng disenyo ng pag-aaral, hindi isang trend line.
Dapat ba laging nagsisimula sa zero ang y-axis ng bar graph?
Oo. Ang haba ng bar ay nagko-code ng halaga, kaya ang isang pinutol na axis ay nagpapalaki ng mga pagkakaiba. Ang mga line graph at scatter plot ay walang ganoong limitasyon.
Bakit humihingi ng mga indibidwal na punto ng datos ang mga journal?
Itinatago ng mga bar at mean ang laki at pagkalat ng sample. Ipinakita nina Weissgerber at mga kasamahan (2015, PLOS Biology) na maraming papel sa mga journal ng pisyolohiya ang nagpapakita ng maliliit na sample na tuloy-tuloy na datos bilang mga bar o line graph na hindi maaaring ipakita ang pinagbabatayang distribusyon.
Ilang bin ang dapat mayroon ang isang histogram?
Walang iisang tuntunin. Subukan ang kahit dalawang lapad at panatilihin ang isa na nagpapakita ng istruktura nang walang ingay. Ang Old Faithful histogram ay gumagamit ng 0.25-minute bins.
Aling graph ang pinakamahusay na nagpapakita ng pagbabago sa paglipas ng panahon?
Isang line graph. Suriin ito para sa pagbabago ng hakbang bago iangkop ang isang tuwid na trend: Ang daloy ng Nile ay bumaba ng humigit-kumulang 248 units pagkatapos ng 1898, na minamaliit ng isang trend line.
Ano ang isang dual-axis chart at kailan ito ligtas gamitin?
Pinagpapatong-patong nito ang dalawang sukat na may magkaibang iskala sa isang plot. Ligtas lamang ito kapag ang parehong axes ay may label at ang mga iskala ay hindi pinili upang pilitin ang isang visual na tugma; kung hindi man ay gumamit ng dalawang panel.
Kailan mas mainam ang heat map kaysa sa table?
Kapag ang grid ay masyadong malaki para mabasa bilang mga numero, tulad ng isang correlation matrix sa maraming baryabol. I-print ang halaga sa bawat cell, isentro ang isang diverging scale sa zero, at iwasan ang mga rainbow color scale.
Bakit hindi inirerekomenda ang paghahambing ng mga kategorya sa mga pie chart?
Mas tumpak na hinuhusgahan ng mga mambabasa ang posisyon gamit ang karaniwang iskala kaysa sa anggulo (Cleveland at McGill 1984). Sa halimbawa ng pagpapakain sa sisiw, anim na halos magkaparehong hiwa ang hindi maaaring i-ranggo mula sa pie, habang ang isang nakaayos na bar chart ay nagpapakita ng pagkakasunod-sunod nang sabay-sabay.
Maaari ko bang gamitin muli ang isang pigura mula sa isang nailathalang papel sa sarili kong manuskrito?
Kung pinahihintulutan lamang ito ng lisensya. Maaaring gamitin muli ang isang pigura na may CC BY 4.0 na may kredito sa mga may-akda, isang link sa lisensya at isang tala ng anumang mga pagbabago. Para sa iba pang mga lisensya, humingi ng pahintulot sa tagapaglathala o muling iguhit ang iyong sariling pigura mula sa iyong sariling data. Saklaw ng aming gabay sa pagkuha ng pag-apruba ng copyright para sa mga pigura ang mga hakbang.
Maaari ko bang gawin ang mga graph na ito nang walang coding?
Oo. Ang GraphPro ay bumubuo ng 25 uri ng tsart sa browser, na may built-in na t-test, ANOVA, correlation at chi-square p-values. Libre ito at hindi nangangailangan ng pag-signup.
Mga sanggunian
- Rougier NP, Droettboom M, Bourne PE. Sampung simpleng tuntunin para sa mas mahusay na mga numero. PLoS Comput Biol. 2014;10(9):e1003833. doi:10.1371/journal.pcbi.1003833
- Weissgerber TL, Milic NM, Winham SJ, Garovic VD. Higit pa sa mga bar at line graph: oras na para sa isang bagong paradigma ng presentasyon ng datos. PLoS Biol. 2015;13(4):e1002128. doi:10.1371/journal.pbio.1002128
- Midway SR. Mga Prinsipyo ng epektibong paggunita ng datos. Mga Pattern. 2020;1(9):100141. doi:10.1016/j.patter.2020.100141
- Crampton EW. Ang paglaki ng mga odontoblast ng ngiping incisor bilang isang pamantayan sa pagkonsumo ng bitamina C ng guinea pig. J Nutr. 1947;33(5):491-504. doi:10.1093/jn/33.5.491
- Azzalini A, Bowman AW. Isang pagtingin sa ilang datos tungkol sa Old Faithful geyser. Appl Stat. 1990;39(3):357-365. doi:10.2307/2347385
- Henderson HV, Velleman PF. Interaktibong pagbuo ng mga modelo ng multiple regression. Biometrics. 1981;37(2):391-411. doi:10.2307/2530428
- Cobb GW. Ang problema ng Nilo: kondisyonal na solusyon sa isang problema sa changepoint. Biometrika. 1978;65(2):243-251. doi:10.1093/biomet/65.2.243
- McNamara DA, Decker JM, McNamara MW, et al. Mga suspendidong suit na may tingga at pagkakalantad sa radyasyon sa mga interventional echocardiographer. JAMA Netw Open. 2026;9(3):e2558134. doi:10.1001 / panahonetworkopen.2025.58134
- Bauer SR, Kenfield SA, Oni-Orisan A, et al. Pag-iwas sa pagrereseta ng Tamsulosin para sa mga sintomas ng ibabang bahagi ng daanan ng ihi sa mga matatandang lalaki: isang randomized na klinikal na pagsubok. JAMA Netw Open. 2026;9(7):e2621639. doi:10.1001 / panahonetworkopen.2026.21639
- Dias JML, More RP, Butler D, et al. Pagsusuri sa pamamagitan ng whole genome sequencing at paggamit ng pangangalaga sa mga batang may malalang sakit. JAMA Netw Open. 2026;9(9):e2634372. doi:10.1001 / panahonetworkopen.2026.34372
- Butkow KJ, Jalaludeen N, Liu Y, et al. Pagsukat ng cardiac stroke volume sa pamamagitan ng in-ear audio sensing. Nat Commun. 2026;17(1):8755. doi:10.1038/s41467-026-75642-0
- Matta R, Shaw J, Mohamud H, et al. Mga pagbisita sa departamento ng emerhensiya, mga pagpasok sa ospital, at mga oras ng paghihintay para sa mga pasyenteng may mga kondisyong urologic. JAMA Netw Open. 2026;9(3):e2560058. doi:10.1001 / panahonetworkopen.2025.60058
- Bland JM, Altman DG. Mga pamamaraang pang-estadistika para sa pagtatasa ng pagkakatugma sa pagitan ng dalawang pamamaraan ng klinikal na pagsukat. Lancet. 1986;327(8476):307-310. doi:10.1016/S0140-6736(86)90837-8
- Hintze JL, Nelson RD. Mga plot ng biyolin: isang synergism ng bakas ng densidad ng kahon. Am Stat. 1998;52(2):181-184. doi:10.1080/00031305.1998.10480559
- Cleveland WS, McGill R. Persepsyon sa grapiko: teorya, eksperimento, at aplikasyon sa pagbuo ng mga pamamaraan sa grapiko. J Am Stat Assoc. 1984;79(387):531-554. doi:10.1080/01621459.1984.10478080
- Crameri F, Shephard GE, Heron PJ. Ang maling paggamit ng kulay sa komunikasyon sa agham. Nat Commun. 2020;11(1). doi:10.1038/s41467-020-19160-7
- Isenberg P, Bezerianos A, Dragicevic P, Fekete JD. Isang pag-aaral sa mga tsart ng datos na may dalawahang sukat. IEEE Trans Vis Comput Graph. 2011;17(12):2469-2478. doi:10.1109/TVCG.2011.160
- Tukey JW. Pagsusuri ng Datos na Eksploratoryo. Reading, MA: Addison-Wesley; 1977.
Ang mga nailathalang datos (Mga Larawan A hanggang E) ay kinopya sa ilalim ng CC BY 4.0 mula sa limang papel na nakalista sa huli sa mga sanggunian. Mga Dataset: ToothGrowth, faithful, mtcars, Nile, chickwts at EuStockMarkets mula sa pakete ng mga datos ng R. Lahat ng estadistika ay kinopya nang hiwalay sa R at Python.