
Diterbitkan | Kemas kini terakhir
Seorang penyelaras percubaan selesai memasukkan data pada 400 pesakit selepas pembedahan dan menghadapi soalan praktikal. Yang manakah antara lima belas pembolehubah yang direkodkan pada garis dasar benar-benar meramalkan siapa yang dimasukkan semula, siapa yang mengalami komplikasi, atau siapa yang terselamat lima tahun selepas diagnosis? Model regresi dalam penyelidikan perubatan menjawab soalan itu dengan tepat. Mereka menganggarkan bagaimana satu atau lebih peramal berkaitan dengan hasil sambil memastikan peramal lain stabil, memisahkan isyarat sebenar daripada hingar yang akan terlepas pandang sepenuhnya oleh perbandingan dua kumpulan yang mudah.
Empat keluarga model ini merangkumi sebahagian besar daripada apa yang muncul dalam jurnal klinikal hari ini, dan setiap satunya wujud kerana jenis hasil yang berbeza memerlukan matematiknya sendiri. Tekanan darah dan nombor berterusan yang lain memerlukan regresi linear. Peristiwa ya/tidak seperti kematian 30 hari memerlukan regresi logistik. Kiraan seperti bilangan jatuh di rumah jagaan memerlukan regresi Poisson atau binomial negatif, dan hasil masa-ke-peristiwa seperti survival bebas kambuh memerlukan regresi Cox. Panduan ini menerangkan keempat-empatnya, merangkumi berapa banyak peramal yang sebenarnya boleh disokong oleh set data, dan diakhiri dengan apa yang dijangkakan oleh pengulas yang dilaporkan bersama setiap model.
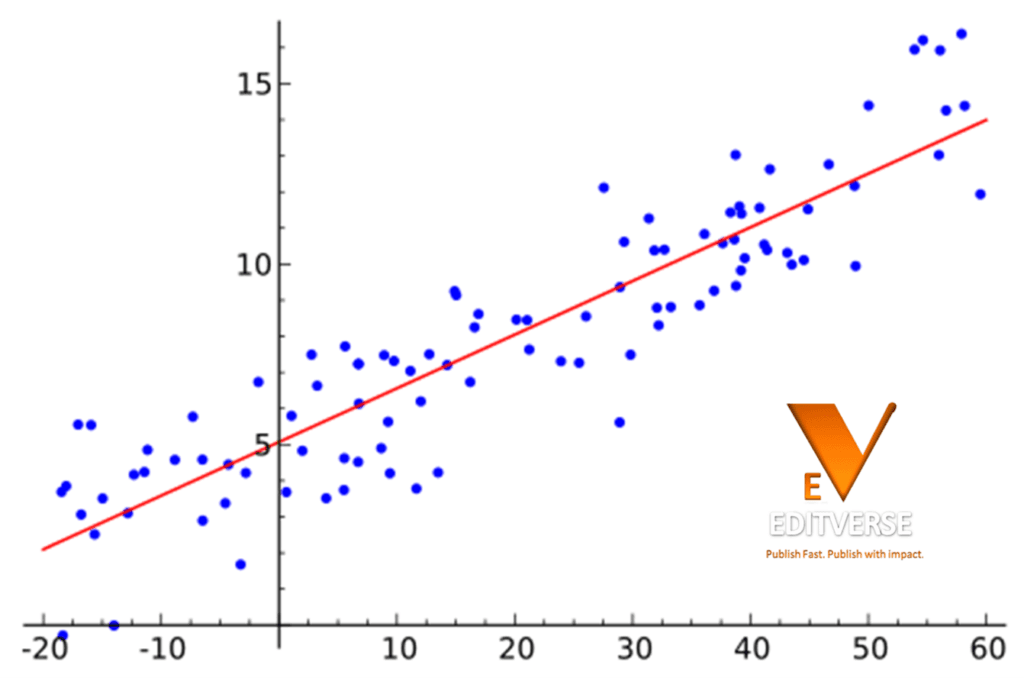
Dalam Perkataan Mudah
Model regresi ialah cara untuk bertanya "adakah faktor ini penting, dan sejauh mana, setelah saya mengambil kira semua yang saya ukur?" Setiap versi berfungsi dengan cara yang sama di bawah. Anda memilih hasil, anda menyenaraikan peramal yang anda fikir mungkin menjelaskannya, dan model menganggarkan nombor untuk setiap peramal yang menunjukkan hubungan bebasnya dengan hasil tersebut. Versi yang anda gunakan hanya bergantung pada jenis hasil yang anda miliki. Nombor mendapat regresi linear, peristiwa ya/tidak mendapat regresi logistik, kiraan mendapat regresi Poisson atau binomial negatif, dan masa sehingga peristiwa mendapat regresi Cox. Pilih yang salah dan pekali yang dicetak oleh perisian tidak akan bermaksud apa yang anda fikirkan maksudnya.
Apa yang Dilakukan oleh Model Regresi dalam Penyelidikan Perubatan
Setiap model regresi membahagikan pembolehubah kepada dua peranan, satu hasil dan satu set peramal. Penyelidik memanggil hasil tersebut sebagai pembolehubah bersandar, perkara yang ingin dijelaskan atau diramalkan oleh kajian, seperti kemasukan semula ke hospital atau tekanan darah sistolik. Umur, kumpulan rawatan dan kreatinin asas sebaliknya menjadi peramal, juga dipanggil pembolehubah bebas atau kovariat, faktor yang mungkin mempengaruhi hasil tersebut. Model menganggarkan pekali untuk setiap peramal yang menggambarkan hubungannya dengan hasil manakala peramal lain dalam persamaan dianggap tetap.
Bahagian terakhir itulah sebabnya penyelidik klinikal menggunakan regresi dan bukannya ujian-t mudah atau ujian khi-kuasa dua. Ujian-t boleh menunjukkan bahawa kumpulan rawatan dan kumpulan kawalan berbeza dari segi hasil. Ujian-t tidak dapat memberitahu anda sama ada perbezaan itu kekal setelah umur, jantina, keterukan penyakit dan kiraan komorbiditi diambil kira pada masa yang sama. Regresi boleh berlaku, itulah sebabnya ia berada di bawah kebanyakan analisis terlaras, kalkulator risiko dan model prognostik yang diterbitkan dalam jurnal perubatan. Memilih antara ujian statistik yang tersedia untuk soalan penyelidikan tertentu bermula dengan mengenal pasti jenis hasil dan klasifikasi yang sama menentukan keluarga regresi yang terpakai.
Sekilas Pandang Enam Model Regresi yang Digunakan dalam Penyelidikan Perubatan
Enam model di bawah merangkumi sebahagian besar analisis regresi yang diterbitkan dalam jurnal klinikal dan epidemiologi, setiap satunya dipasangkan dengan jenis hasil yang dikendalikannya dan andaian yang paling mungkin dilanggar dalam amalan.
| model | Jenis Hasil | Pekali Ditafsirkan Sebagai | Andaian Paling Sering Dilanggar |
|---|---|---|---|
| Regresi linear | Berterusan (tekanan darah, nilai makmal, skor) | Perubahan unit dalam hasil per perubahan unit dalam peramal | Varians malar bagi baki merentasi nilai yang dipadankan (homoskedastisitas) |
| Regresi logistik | Perduaan (peristiwa berlaku atau tidak) | Nisbah kemungkinan per unit perubahan dalam peramal | Peristiwa yang mencukupi bagi setiap pembolehubah berbanding saiz sampel |
| Regresi Poisson | Kiraan (jatuh, jangkitan, kemasukan ke hospital setiap tempoh) | Nisbah kadar insiden per unit perubahan dalam peramal | Ekuidispersi, bermakna varians sama dengan min |
| Regresi binomial negatif | Data kiraan berlebihan | Nisbah kadar insiden, dengan parameter penyebaran tambahan | Masih menganggap struktur kadar yang sama merentasi semua subjek |
| Regresi bahaya berkadar Cox | Masa untuk peristiwa (kehidupan, kambuh semula, masa untuk keluar dari hospital) | Nisbah bahaya per unit perubahan dalam peramal | Bahaya berkadar kekal malar sepanjang keseluruhan susulan |
| Regresi logistik ordinal / multinomial | Kategori tertib atau tidak tertib (tiga atau lebih) | Nisbah kemungkinan setiap ambang kategori atau setiap kategori berbanding rujukan | Kemungkinan berkadar merentasi ambang (versi ordinal sahaja) |
Regresi Linear untuk Hasil Berterusan
Regresi linear memadankan hubungan garis lurus antara satu atau lebih peramal dan hasil yang berterusan. Setiap pekali mewakili perubahan yang dijangkakan dalam hasil untuk peningkatan satu unit dalam peramal tersebut, dengan mengekalkan model yang selebihnya malar. Pekali 2.3 untuk umur dalam model yang meramalkan tekanan darah sistolik bermakna model menjangkakan bacaan 2.3 mm Hg lebih tinggi untuk setiap tahun tambahan umur, dengan semua pembolehubah lain yang disertakan adalah sama.
Empat andaian menyatukan kaedah ini, dan plot sisa boleh menyemak kesemuanya secara langsung. Peramal dan hasil memerlukan hubungan linear dan bukannya melengkung, pemerhatian memerlukan kebebasan antara satu sama lain, sisa memerlukan sesuatu yang hampir dengan taburan normal, dan penyebarannya perlu kekal hampir malar merentasi julat nilai yang dipadankan. Analisis Laporan Saintifik 2020 yang dibina berdasarkan kohort Inisiatif Osteoarthritis NIH menggambarkan bagaimana regresi linear dan logistik sering digunakan bersebelahan dalam kajian yang sama. Penyelidik menguji 19 calon biomarker terhadap ciri radiografi dan klinikal osteoartritis lutut dan mendapati bahawa hanya empat, serum Coll2-1 NO2, CS846, COMP, dan CTXII kencing, kekal sebagai peramal bebas sebaik sahaja model diselaraskan untuk faktor risiko yang telah ditetapkan, daripada penyakit yang menjejaskan lebih daripada 500 juta orang di seluruh dunia.
Regresi Logistik untuk Hasil Perduaan
Regresi logistik mengendalikan hasil dengan dua keadaan yang mungkin, iaitu komplikasi yang sama ada berlaku atau tidak, ujian yang memberikan hasil positif atau negatif, pesakit yang terselamat untuk dibenarkan keluar atau tidak. Daripada memodelkan hasilnya secara langsung, ia memodelkan log-odds peristiwa tersebut sebagai fungsi linear peramal, yang memastikan kebarangkalian yang diramalkan berada di antara 0 dan 1 tidak kira betapa ekstremnya nilai peramal. Mengeksponenkan pekali menukarkannya kepada nisbah odds, cara standard kertas klinikal melaporkan keputusan regresi logistik.
Kebanyakan kertas kerja yang diterbitkan menganggap model logistik sebagai rutin sebaik sahaja ia berjalan tanpa ralat, tetapi untuk melakukannya dengan betul memerlukan lebih banyak perhatian daripada itu. Audit pada tahun 2017 dalam jurnal Medicine telah menyemak 316 artikel yang diterbitkan merentasi lima jurnal klinikal Cina berimpak tinggi antara tahun 2010 dan 2015 yang menggunakan regresi logistik berbilang pembolehubah, dengan setiap satu mendapat skor berbanding 12 kriteria pelaporan dan metodologi yang ditetapkan. Pemarkahan didapati rendah secara keseluruhan, median 5 daripada 12, dan 85.1% daripada artikel di bawah 6, bermakna kebanyakan model yang diterbitkan kurang memenuhi asas seperti melaporkan bagaimana pembolehubah dipilih atau menyemak sama ada model itu benar-benar sesuai dengan data. Kajian kes regresi logistik yang merangkumi tafsiran nisbah kemungkinan dan penilaian lengkung ROC membicarakan lebih mendalam tentang cara membaca dan mengesahkan output ini sebaik sahaja model dipasang, dan memasangkan model logistik dengan sensitiviti, kekhususan dan pengiraan nilai ramalan yang betul adalah apa yang mengubah satu set nisbah kemungkinan menjadi alat diagnostik atau prognostik yang boleh digunakan.
Regresi Poisson dan Binomial Negatif untuk Hasil Kiraan
Kiraan hasil, bilangan jatuh yang dialami pesakit dalam setahun, bilangan jangkitan yang diperoleh di hospital di wad, bilangan lawatan kecemasan selepas keluar, tidak sesuai dengan regresi linear atau logistik. Regresi Poisson ialah titik permulaan standard, memodelkan log kiraan yang dijangkakan sebagai fungsi peramal dan melaporkan keputusan sebagai nisbah kadar insiden. Regresi Poisson membawa satu andaian yang sentiasa gagal dalam data klinikal sebenar, iaitu varians kiraan sama dengan min, satu sifat yang dipanggil equidispersi.
Data perubatan sebenar hampir selalunya terlebih serak, dengan lebih banyak serakan daripada yang dijangkakan oleh model Poisson, dan berpura-pura sebaliknya menghasilkan ralat standard yang terlalu kecil dan nilai-p kelihatan lebih mengagumkan daripada yang sepatutnya. Perbandingan 2022 yang diterbitkan dalam BMC Medical Research Methodology menguji versi Poisson, binomial negatif dan versi sifar-inflasi kedua-duanya terhadap data tempoh penginapan hospital yang diambil daripada pangkalan data rawatan rapi MIMIC. Model Poisson biasa dan Poisson sifar-inflasi kurang sesuai dengan data tempoh penginapan terlebih serak, manakala model binomial negatif memberikan padanan keseluruhan yang terbaik dan mengelakkan kepentingan yang melambung yang datang daripada memaksa andaian ekuidispersi ke atas data yang tidak memenuhinya. Apabila pemboleh ubah kiraan adalah hasilnya, menyemak varians terhadap min sebelum memilih antara Poisson dan binomial negatif bukanlah pilihan.
Regresi Bahaya Berkadaran Cox untuk Hasil Masa-ke-Peristiwa
Hasil masa-ke-peristiwa memerlukan keluarga keempat sepenuhnya, kerana ia melibatkan dua maklumat sekaligus, sama ada sesuatu peristiwa berlaku dan berapa lama masa yang diambil, ditambah dengan komplikasi yang menyebabkan sesetengah pesakit meninggalkan kajian sebelum peristiwa berlaku atau sebelum susulan tamat (penapisan). Regresi bahaya berkadar Cox memodelkan bahaya, risiko serta-merta peristiwa pada masa tertentu, sebagai fungsi peramal, tanpa memerlukan andaian tentang bentuk asas lengkung kemandirian itu sendiri. Pekali dilaporkan sebagai nisbah bahaya, dan andaian teras model ialah nisbah bahaya antara mana-mana dua kumpulan kekal malar sepanjang tempoh susulan.
Percubaan fasa 3 di 33 hospital di Jepun menunjukkan bagaimana nisbah bahaya yang diperoleh daripada Cox dalam praktiknya. Percubaan JASPAC-01 telah merawakkan 385 pesakit kanser pankreas yang telah dibedah kepada gemcitabine adjuvan atau S-1, dan model Cox menganggarkan nisbah bahaya kematian untuk S-1 berbanding gemcitabine pada 0.57, dengan selang keyakinan 95% sebanyak 0.44 hingga 0.72. Ini bermakna bahaya kematian kira-kira 43% lebih rendah pada mana-mana titik tertentu semasa susulan untuk pesakit yang menggunakan S-1, selaras dengan kelangsungan hidup keseluruhan 5 tahun sebanyak 44.1% dalam kumpulan S-1 berbanding 24.4% dengan gemcitabine. Pemodelan bahaya berkadar Cox diliputi sepenuhnya, termasuk bagaimana fungsi bahaya dan kovariat berinteraksi , dan asas analisis kelangsungan hidup untuk penyelidikan klinikal kedua-duanya dibina secara langsung pada mekanik yang diringkaskan di sini.
Regresi Ordinal dan Multinomial untuk Hasil Dengan Lebih Daripada Dua Kategori
Sesetengah hasil tidak berkurangan dengan bersih kepada pembahagian ya/tidak. Keterukan kesakitan yang dijaringkan sebagai tiada, ringan, sederhana atau teruk adalah ordinal, bermakna kategori mempunyai susunan semula jadi. Respons rawatan yang dikelaskan sebagai respons lengkap, separa atau tiada tanpa skala berangka juga ordinal. Respons terhadap salah satu daripada tiga pilihan rawatan yang tidak berkaitan tanpa kedudukan yang wujud adalah nominal, yang memerlukan regresi logistik multinomial dan bukannya ordinal.
Regresi logistik ordinal, yang paling kerap dipasang sebagai model kemungkinan berkadar, mengandaikan hubungan antara setiap peramal dan kemungkinan untuk naik ke atas kategori adalah sama tanpa mengira ambang mana yang dilanggar, satu andaian yang patut diuji dan bukannya diterima secara lalai. Regresi logistik multinomial menggugurkan keperluan tersebut dan sebaliknya menganggarkan satu set nisbah kemungkinan yang berasingan untuk setiap kategori berbanding kategori rujukan, dengan kos memerlukan sampel yang lebih besar untuk menganggarkan semua parameter tersebut dengan ketepatan yang tinggi. Melipat hasil ordinal kepada hasil binari untuk mengelakkan pilihan, sederhana atau lebih teruk berbanding ringan atau tiada, adalah perkara biasa dalam amalan tetapi membuang maklumat yang direka bentuk untuk ditangkap oleh skala asal.
Berapa Banyak Peramal yang Boleh Disokong oleh Model Regresi Anda
Set data tidak menyokong bilangan peramal yang tidak terhad tidak kira betapa besarnya sampel tersebut. Bagi model logistik dan Cox, peraturan praktikal yang telah lama wujud memerlukan sekurang-kurangnya 10 peristiwa, bukan 10 subjek, bagi setiap pembolehubah peramal, yang mana sesuatu peristiwa bermaksud kematian, komplikasi, atau apa sahaja hasilnya. Peraturan ini kembali kepada simulasi Monte Carlo 1996 yang dibina berdasarkan percubaan jantung sebenar yang melibatkan 673 pesakit dengan 252 kematian dan tujuh calon peramal, nisbah peristiwa-setiap-pembolehubah sebanyak 36 untuk sampel penuh. Dengan mengambil semula set data tersebut kepada nisbah serendah 2 peristiwa setiap pembolehubah, para penyelidik mendapati bahawa di bawah EPV kira-kira 10, pekali menjadi berat sebelah dalam kedua-dua arah, selang keyakinan berhenti meliputi nilai sebenar pada kadar yang dinyatakan, dan perkaitan yang signifikan secara statistik yang menunjukkan arah yang salah muncul lebih kerap daripada yang sepatutnya.
Panduan moden telah beralih sepenuhnya daripada nisbah tunggal. Satu kertas kaedah pada tahun 2019 dalam Statistik dalam Perubatan mencadangkan empat sasaran berangka yang perlu dibersihkan bersama oleh saiz sampel untuk model ramalan hasil berterusan, mengehadkan pengecutan kesan peramal kepada tidak lebih buruk daripada faktor 0.9, mengekalkan jurang antara R-kuasa dua yang ketara dan diselaraskan optimisme model di bawah 0.05, dan mengekalkan margin ralat di bawah 10% untuk sisihan piawai baki dan hasil min yang diramalkan. Dalam contoh yang berjaya, meramalkan fungsi paru-paru dalam kalangan wanita Afrika-Amerika daripada 25 parameter peramal, memenuhi keempat-empat kriteria memerlukan sekurang-kurangnya 918 subjek, menghasilkan kira-kira 37 subjek setiap parameter peramal, jauh melebihi apa yang dicadangkan oleh mana-mana pintasan EPV mudah. Lanjutan logik empat kriteria yang sama kini merangkumi hasil binari, masa ke peristiwa dan multinomial juga. Menjalankan analisis kuasa a priori dan pengiraan saiz sampel sebelum pengumpulan data bermula adalah satu-satunya cara untuk mengetahui bahagian ambang mana kajian yang dirancang akan mendarat.
Memeriksa Sama ada Andaian Model Regresi Anda Berlaku
Memasang model regresi dan membaca pekali tanpa menyemak andaian di sebaliknya adalah salah satu cara yang lebih biasa menyebabkan analisis yang diterbitkan menjadi salah. Multikolineariti, di mana dua atau lebih peramal membawa maklumat yang bertindih, meningkatkan ralat piawai dan menjadikan pekali individu tidak stabil walaupun model secara keseluruhannya sesuai dengan baik. Faktor inflasi varians melebihi 5 atau 10 untuk mana-mana peramal adalah pencetus biasa untuk mempertimbangkan semula senarai pembolehubah. Pendekatan regresi multipembolehubah untuk mengawal pembaur dalam kajian klinikal bergantung pada kerja diagnostik jenis ini yang dilakukan sebelum keputusan dipercayai, bukan selepasnya.
Setiap keluarga model membawa semakan khusus tersendiri di atas yang umum. Regresi linear memerlukan plot nilai-sisa-lawan-nilai-yang-dipasang untuk menangkap ketaklinearan dan varians yang tidak sama rata, serta plot QQ untuk andaian normaliti. Regresi logistik mendapat manfaat daripada ujian Hosmer-Lemeshow atau plot penentukuran yang membandingkan kebarangkalian yang diramalkan dengan yang diperhatikan merentasi desil risiko. Regresi Cox mempunyai semakan khusus dan bukan pilihan, menguji sisa Schoenfeld terhadap masa untuk mengesahkan andaian bahaya berkadar sebenarnya berlaku dan bukannya menganggapnya berlaku, kerana nisbah bahaya yang dilaporkan untuk kovariat yang melanggar perkadaran bukanlah nombor tunggal sama sekali. Mengendalikan cara set data menangani data yang hilang sebelum ia mencapai model regresi sama pentingnya, kerana pemadaman kes mana-mana subjek dengan peramal yang hilang boleh secara senyap-senyap memiringkan setiap pekali dalam model, bukan hanya yang untuk pembolehubah yang tidak lengkap. Kajian dengan struktur berkelompok atau bersarang, pesakit dalam hospital atau lawatan berulang dalam pesakit, memerlukan langkah selanjutnya ke dalam pemodelan berbilang peringkat atau kesan campuran , kerana regresi standard menganggap setiap pemerhatian adalah bebas daripada setiap yang lain.
Melaporkan Model Regresi Supaya Pengulas dan Pembaca Boleh Mempercayainya
Pekali regresi tidak bermakna banyak kepada pembaca yang tidak dapat melihat bagaimana model di sebaliknya dibina. Kenyataan TRIPOD, yang diterbitkan serentak pada tahun 2015 merentasi sebelas jurnal termasuk The BMJ , Annals of Internal Medicine dan Circulation , membentangkan senarai semak 22 item yang merangkumi cara peramal dipilih, cara data yang hilang dikendalikan, cara model disahkan dan cara prestasinya diukur, dibangunkan melalui mesyuarat ahli metodologi selama tiga hari dan diperhalusi selama beberapa tahun berikutnya oleh kumpulan pemandu TRIPOD yang lebih luas. Kemas kini 2024, TRIPOD+AI, melanjutkan senarai semak yang sama kepada model ramalan yang dibina dengan kaedah pembelajaran mesin di samping regresi tradisional.
Nombor kualiti pelaporan daripada audit regresi logistik Cina yang disebut sebelum ini bukanlah penemuan terpencil. Kajian yang membangunkan atau mengesahkan model ramalan secara rutin mengecualikan cara senarai peramal calon disempitkan, melangkau pelaporan bilangan peristiwa berbanding bilangan pembolehubah atau membentangkan nisbah bahaya tanpa menyebut sama ada andaian bahaya berkadar telah diuji. Tiada satu pun daripada itu yang merupakan wilayah statistik eksotik. Jurang itu adalah tabiat dokumentasi dan senarai semak TRIPOD wujud khusus untuk menjadikannya kelihatan kepada pengulas sebelum penerbitan dan bukannya kepada pembaca yang cuba menghasilkan semula hasilnya selepas itu. Kepentingan statistik dan pelaporan nilai-p berhak mendapat ketelusan yang sama, kerana nilai-p pekali regresi bermaksud sesuatu yang berbeza bergantung pada berapa banyak pembolehubah dan perbandingan lain yang diuji di sepanjang jalan ke model akhir itu.
Kesilapan Biasa Yang Melemahkan Model Regresi dalam Penyelidikan Perubatan
- Pemilihan pembolehubah langkah demi langkah automatik. Membiarkan perisian menambah dan menggugurkan peramal berdasarkan ambang nilai-p meningkatkan kepentingan ketara apa sahaja yang terselamat dan menghasilkan selang keyakinan yang tidak lagi bermaksud apa yang didakwanya. Peramal tergolong dalam model kerana penaakulan klinikal atau literatur terdahulu meletakkannya di sana, bukan kerana algoritma langkah demi langkah mengekalkannya.
- Mengabaikan peristiwa setiap pembolehubah sehingga pengulas bertanya. Memadankan model logistik 12-peramal terhadap 40 peristiwa menghasilkan pekali yang tidak lebih dipercayai daripada lambungan syiling untuk beberapa peramal tersebut, tanpa mengira betapa besarnya saiz sampel keseluruhan pada halaman tajuk.
- Melaporkan nisbah kemungkinan seolah-olah ia adalah nisbah risiko. Nisbah kemungkinan dan nisbah risiko hanya bertemu apabila hasilnya jarang berlaku, biasanya di bawah 10%. Di atas itu, nisbah kemungkinan secara sistematik melebih-lebihkan risiko yang berkaitan, dan pembaca yang menukarnya terus kepada nisbah risiko di kepala mereka akan melebih-lebihkan kesannya.
- Melayan kesudahan ordinal sebagai berterusan. Menjalankan regresi linear pada skala simptom 5 mata mengandaikan jarak antara "tiada" dan "ringan" sama dengan jarak antara "sederhana" dan "teruk", andaian regresi ordinal tidak memerlukannya dan jarang berlaku.
- Tidak pernah menguji andaian bahaya berkadar. Nisbah bahaya yang dilaporkan tanpa pemeriksaan sisa Schoenfeld, atau ujian yang setara, mungkin membuat purata ke atas kesan yang berubah dengan ketara merentasi tempoh susulan, yang mana nombor tunggal yang dilaporkan tidak akan didedahkan dengan sendirinya.
- Mengekstrapolasi model yang dipadankan melangkaui julat data yang digunakan untuk membinanya. Persamaan regresi yang dibina ke atas pesakit berumur 40 hingga 75 tahun tidak menjanjikan sebarang hasil tentang pesakit berusia 25 tahun atau 90 tahun, tidak kira betapa linearnya hubungan itu dalam julat yang dikaji.
Mendapatkan Sokongan Statistik untuk Model Regresi dalam Penyelidikan Perubatan
Sesetengah analisis regresi adalah rutin, model logistik tunggal dengan lima peramal yang dipilih dengan baik dan kiraan peristiwa yang mencukupi. Analisis regresi yang lain melibatkan risiko yang bersaing, kovariat yang berubah-ubah mengikut masa, data berkelompok atau senarai peramal yang perlu dipotong sebelum model dapat dipasang secara bertanggungjawab. Ahli statistik Editverse mengendalikan julat penuh, daripada menyemak sama ada analisis yang dirancang mempunyai peristiwa yang mencukupi bagi setiap pembolehubah hinggalah menulis naratif hasil yang akan dibaca oleh jawatankuasa disertasi atau pengulas jurnal.
Analisis Statistik Disertasi & Manuskrip
$600
Ahli statistik PhD mengendalikan pemilihan model regresi, pengujian andaian dan penulisan analisis penuh dalam SPSS, R atau STATA.
Perkhidmatan Penulisan Manuskrip
Petikan Tersuai
Tukarkan analisis regresi yang telah lengkap kepada bahagian kaedah dan hasil yang sedia untuk dihantar dan ditulis mengikut piawaian jurnal.
Soalan Lazim Mengenai Model Regresi dalam Penyelidikan Perubatan
Bagaimanakah saya boleh memilih antara regresi linear, logistik, Poisson dan Cox?
Pilihan bergantung sepenuhnya pada pembolehubah hasil. Nombor berterusan seperti nilai makmal atau skor memerlukan regresi linear. Hasil binari ya/tidak memerlukan regresi logistik. Kiraan, seperti bilangan jatuh atau jangkitan dalam tempoh tetap, memerlukan regresi Poisson atau binomial negatif. Hasil masa-ke-peristiwa yang merangkumi pesakit yang meninggalkan kajian sebelum peristiwa berlaku memerlukan regresi bahaya berkadar Cox. Mendapatkan klasifikasi yang betul ini adalah lebih penting daripada sebarang keputusan pemodelan lain.
Apakah sebenarnya maksud nisbah kemungkinan 2.0?
Nisbah kemungkinan 2.0 untuk peramal bermaksud kemungkinan hasil berganda bagi setiap peningkatan satu unit dalam peramal tersebut, dengan mengekalkan pembolehubah lain dalam pemalar model. Ini tidak sama dengan mengatakan hasilnya adalah dua kali lebih mungkin dalam erti kata mutlak. Kemungkinan dan kebarangkalian hanya bertemu apabila hasilnya jarang berlaku, jadi nisbah kemungkinan 2.0 untuk hasil yang sama sepadan dengan peningkatan risiko sebenar yang lebih kecil daripada yang dicadangkan oleh nombor pada pandangan pertama.
Berapa banyak peristiwa bagi setiap pembolehubah yang diperlukan oleh model regresi?
Sepuluh peristiwa bagi setiap pembolehubah peramal merupakan penanda aras tradisional untuk regresi logistik dan Cox, berdasarkan simulasi 1996 yang menunjukkan bahawa pekali menjadi berat sebelah dan selang keyakinan kehilangan liputan tepat di bawah nisbah tersebut. Kajian yang lebih baru menunjukkan bahawa minimum sebenar bergantung pada jumlah saiz sampel dan sejauh mana peramal memisahkan hasilnya, bukan pada nisbah EPV secara berasingan, jadi anggap 10 EPV sebagai aras untuk diperiksa dan bukannya sasaran untuk disasarkan dengan tepat.
Apakah perbezaan antara regresi multivariabel dan multivariat?
Regresi berbilang pembolehubah merujuk kepada model dengan berbilang pembolehubah peramal dan satu hasil, yang menggambarkan sebahagian besar model regresi yang digunakan dalam penyelidikan perubatan. Regresi berbilang pembolehubah, dalam erti kata statistik yang ketat, merujuk kepada model dengan berbilang pembolehubah hasil yang dianalisis secara serentak. Kedua-dua istilah digunakan secara bergantian dalam kebanyakan kesusasteraan perubatan gunaan, tetapi pengulas di jurnal yang ketat secara metodologi semakin mengharapkan istilah yang tepat.
Mengapakah model Cox saya memerlukan pemeriksaan bahaya berkadar?
Regresi Cox mengandaikan nisbah bahaya antara mana-mana dua kumpulan kekal malar sepanjang tempoh susulan. Jika kesan sebenar peramal berubah dari semasa ke semasa, contohnya rawatan pembedahan yang mengurangkan risiko lebih awal tetapi tidak kemudian, nisbah bahaya tunggal akan menjadi purata ke atas perubahan tersebut dan boleh memberi gambaran yang salah tentang kesannya pada mana-mana titik masa tertentu. Ujian sisa Schoenfeld menyemak andaian ini secara langsung dan bukannya membiarkannya diandaikan.
Bolehkah saya menggunakan regresi dengan saiz sampel yang kecil?
Regresi secara teknikalnya boleh dijalankan pada hampir semua saiz sampel, tetapi keputusan menjadi tidak stabil sebaik sahaja bilangan peramal menghampiri bilangan peristiwa (untuk hasil binari atau masa-ke-peristiwa) atau bilangan subjek (untuk hasil berterusan). Pembetulan praktikal mengurangkan senarai peramal kepada pembolehubah dengan justifikasi klinikal yang kukuh, menggunakan kaedah regresi penalti yang direka bentuk untuk sampel yang lebih kecil atau menjalankan pengiraan saiz sampel a priori sebelum menggunakan model dengan bilangan peramal yang diberikan.
Apakah TRIPOD dan perlukah saya mengikutinya?
TRIPOD, singkatan untuk Pelaporan Telus model ramalan berbilang pembolehubah untuk Prognosis Atau Diagnosis Individu, ialah senarai semak pelaporan 22 item untuk kajian yang membangunkan atau mengesahkan model ramalan. Kebanyakan jurnal klinikal dan metodologi utama kini menjangkakan senarai semak TRIPOD yang lengkap bersama-sama mana-mana manuskrip yang melaporkan model ramalan berasaskan regresi, dan pengulas semakin menyemak penyerahan terhadapnya secara langsung.
Patutkah saya menggabungkan beberapa model regresi dalam satu kajian?
Menggabungkan model adalah perkara biasa dan selalunya sesuai. Satu kajian mungkin menggunakan regresi logistik untuk mengenal pasti peramal komplikasi dan regresi Cox untuk memodelkan masa pemulihan secara berasingan dalam kohort pesakit yang sama. Apa yang penting ialah setiap model sepadan dengan jenis hasil sendiri dan kertas tersebut melaporkan andaian, saiz sampel dan peristiwa setiap model setiap pembolehubah secara bebas dan bukannya menganggap satu kuasa atau justifikasi saiz sampel sebagai meliputi setiap model dalam kertas tersebut.
Poin-poin utama
- ✓ Jenis hasil, berterusan, binari, kiraan atau masa-ke-peristiwa, menentukan keluarga regresi yang terpakai sebelum sebarang keputusan lain dibuat
- ✓ Sepuluh peristiwa bagi setiap pembolehubah peramal ialah had asas yang patut disemak untuk model logistik dan Cox, bukan jaminan model yang stabil dengan sendirinya
- ✓ Data kiraan terlampau serakan memerlukan regresi binomial negatif; memaksa model Poisson ke atasnya melebih-lebihkan kepentingan
- ✓ Nisbah bahaya model Cox hanya bermakna setelah andaian bahaya berkadar benar-benar diuji, bukan diandaikan
- ✓ Pemilihan langkah demi langkah automatik meningkatkan kepentingan dan harus memberi laluan kepada peramal yang dipilih berdasarkan alasan klinikal
- ✓ Senarai semak TRIPOD, yang kini diperluaskan oleh TRIPOD+AI, ialah perkara yang semakin kerap disemak oleh pengulas terhadap model ramalan berasaskan regresi
- ✓ Multikolineariti, pengendalian data yang hilang dan struktur data berkelompok semuanya memerlukan pemeriksaan diagnostik tersendiri yang berasingan daripada keputusan model utama
Perlukan Bantuan Memilih atau Menjalankan Model Regresi yang Tepat?
Ahli statistik PhD Editverse mengendalikan pemilihan model, pengujian andaian dan pelaporan keputusan untuk disertasi, manuskrip dan permohonan geran merentasi setiap disiplin klinikal.
Sumber Editverse Berkaitan
→ Regresi Logistik dalam Diagnostik Perubatan: Kajian Kes dan Tafsiran
→ Model Bahaya Berkadar Cox: Panduan Bergambar untuk Penyelidikan Penyakit Kronik
→ Regresi Berbilang Pembolehubah dalam Kajian Klinikal
→ Memahami Analisis Survival dalam Penyelidikan Klinikal
→ Analisis Kuasa Dipermudahkan: Pengiraan Saiz Sampel dengan Contoh
→ Panduan Ujian Statistik: Membuat Pilihan Yang Tepat
→ Menangani Data yang Hilang: Strategi & Petua
→ Percubaan Rawak Kluster Induk & Pemodelan Pelbagai peringkat
Rujukan
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Pelaporan telus bagi model ramalan berbilang pembolehubah untuk prognosis atau diagnosis individu (TRIPOD): pernyataan TRIPOD. BMJ. 2015;350:g7594. https://pubmed.ncbi.nlm.nih.gov/25569120/
- Peduzzi P, Concato J, Kemper E, Holford TR, Feinstein AR. Satu kajian simulasi bilangan peristiwa setiap pembolehubah dalam analisis regresi logistik. J Clin Epidemiol. 1996;49(12):1373-1379. https://pubmed.ncbi.nlm.nih.gov/8970487/
- van Smeden M, de Groot JAH, Moons KGM, Collins GS, Altman DG, Eijkemans MJC, Reitsma JB. Tiada rasional untuk kriteria 1 pembolehubah bagi setiap 10 peristiwa untuk analisis regresi logistik binari. BMC Med Res Methodol. 2016, 16 (1): 163. https://pubmed.ncbi.nlm.nih.gov/27881078/
- Riley RD, Snell KIE, Ensor J, Burke DL, Harrell FE Jr, Moons KGM, Collins GS. Saiz sampel minimum untuk membangunkan model ramalan berbilang pembolehubah: Bahagian I – Hasil berterusan. Stat Med. 2019;38(7):1262-1275. https://pubmed.ncbi.nlm.nih.gov/30347470/
- Liem Y, Judge A, Kirwan J, Ourradi K, Li Y, Sharif M. Model regresi logistik dan linear berbilang pembolehubah untuk pengenalpastian penanda biologi yang berguna secara klinikal untuk osteoartritis. Rep Rep 2020, 10 (1): 11328. https://pubmed.ncbi.nlm.nih.gov/32647218/
- Zhang YY, Zhou XB, Wang QZ, Zhu XY. Kualiti pelaporan model regresi logistik berbilang pembolehubah dalam jurnal perubatan klinikal Cina. Perubatan (Baltimore). 2017; 96 (21): e6972. https://pubmed.ncbi.nlm.nih.gov/28538397/
- Fernandez GA, Vatcheva KP. Perbandingan kaedah statistik untuk memodelkan data kiraan dengan aplikasi kepada tempoh penginapan di hospital. BMC Med Res Methodol. 2022, 22 (1): 211. https://pubmed.ncbi.nlm.nih.gov/35927612/
- Uesaka K, Boku N, Fukutomi A, Okamura Y, Konishi M, et al. Kemoterapi adjuvant S-1 berbanding gemcitabine untuk kanser pankreas yang direseksi: percubaan fasa 3, label terbuka, rawak, bukan rendah diri (JASPAC 01). Lancet. 2016;388(10041):248-257. https://pubmed.ncbi.nlm.nih.gov/27265347/