
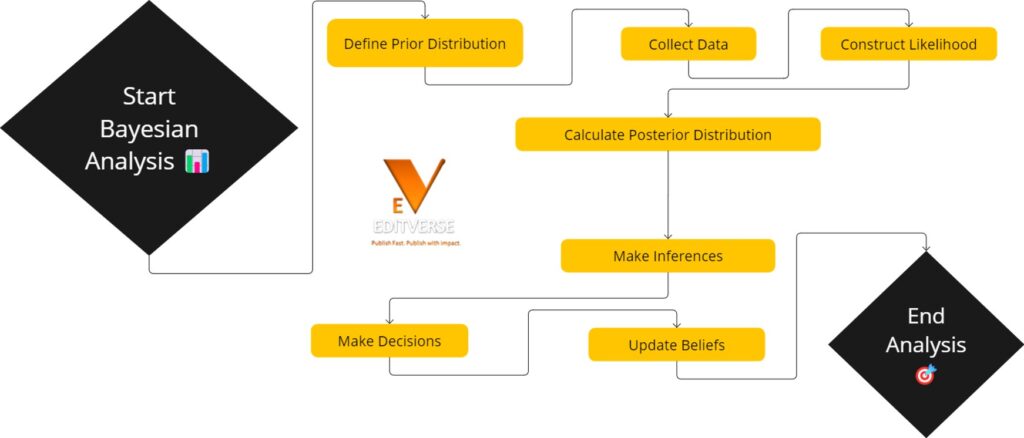
Ahli epidemiologi semakin beralih kepada kaedah Bayesian dalam epidemiologi apabila sesuatu kajian mempunyai terlalu sedikit kes untuk alat frequentist standard berfungsi dengan baik, apabila kajian terdahulu sudah menunjukkan julat yang munasabah untuk sesuatu parameter, atau apabila risiko penyakit memerlukan pemetaan merentasi ratusan kawasan kecil sekaligus. Daripada menghasilkan anggaran titik tunggal dan nilai-p, analisis Bayesian menggabungkan apa yang telah diketahui tentang parameter dengan data kajian baharu, kemudian melaporkan taburan kebarangkalian penuh untuk parameter tersebut dan bukannya satu nombor. Berikutnya berfungsi melalui mekanik proses tersebut, masalah epidemiologi khusus di mana kerumitan tambahan membuahkan hasil, penyelidik perisian menjalankannya, dan kajian pengawasan kanser yang diterbitkan yang menunjukkan pendekatan yang digunakan merentasi 218 komuniti sebenar.
Apa yang Dibawa oleh Kaedah Bayesian kepada Epidemiologi
Statistik frequentist mendominasi penyelidikan perubatan untuk sebahagian besar abad kedua puluh, dibina berdasarkan nilai-p, selang keyakinan dan peraturan ketat terhadap penggunaan apa-apa kecuali set data semasa. Statistik Bayesian untuk penyelidikan klinikal, yang diterangkan dalam ulasan kaedah Lancet 2024 oleh Goligher, Heath dan Harhay , menganggap kebarangkalian sebagai ukuran kekuatan kepercayaan dan bukannya frekuensi jangka panjang, yang membolehkan kajian menggabungkan maklumat terdahulu secara formal dengan data baharu untuk menghasilkan taburan kebarangkalian terkini atau posterior untuk setiap kuantiti minat. Pengkomputeran moden telah menghapuskan halangan praktikal utama kepada pendekatan ini. Anggaran berasaskan simulasi yang pernah menggunakan perkakasan khusus kini berjalan pada komputer riba, yang merupakan sebahagian besar sebab kaedah Bayesian beralih daripada falsafah statistik minoriti kepada penggunaan rutin merentasi pengawasan kanser, farmakovigilans dan pemodelan wabak sejak dua dekad yang lalu.
Teorem Bayes dan Logik Mengemaskini Kepercayaan
Setiap model Bayesian bergantung pada persamaan yang sama. Teorem Bayes menyatakan bahawa kebarangkalian posterior bagi parameter yang diberikan data adalah berkadar terus dengan kemungkinan data yang diberikan parameter tersebut, didarabkan dengan kebarangkalian prior bagi parameter itu sendiri. Ditulis untuk parameter θ dan data yang diperhatikan X, hubungannya ialah P(θ|X) ∝ P(X|θ) × P(θ). Tiga bahagian melakukan semua kerja di sini. Prior, P(θ), menangkap apa yang telah diketahui atau diandaikan secara munasabah tentang parameter sebelum kajian semasa dijalankan. Kebarangkalian, P(X|θ), menerangkan betapa mungkinnya data yang diperhatikan berada di bawah nilai calon parameter yang berbeza. Posterior, P(θ|X), ialah taburan terkini yang terhasil daripada menggabungkan kedua-duanya, dan ia menjadi objek yang sebenarnya dilaporkan dan ditafsirkan oleh ahli epidemiologi Bayesian.
Teorem itu sendiri mendahului epidemiologi moden selama dua abad. Teorem Bayes mengambil namanya daripada Thomas Bayes, seorang menteri yang tidak pernah menerbitkan hasilnya sendiri, dan esei yang mengandunginya dibacakan kepada Royal Society selepas kematian ahli falsafah Richard Price pada tahun 1763, satu peristiwa penting dalam tinjauan sejarah 2014 dalam Cadernos de Saúde Pública oleh Martinez dan Achcar yang ditandakan pada ulang tahunnya yang ke-250 pada tahun 2013. Kaedah frequentist mendorong pendekatan Bayesian ke margin statistik gunaan untuk sebahagian besar dua abad berikutnya, dan hanya kembali kepada penggunaan epidemiologi rutin setelah pengiraan rantaian Markov Monte Carlo menjadikan posterior kompleks dapat diatasi.
Praktik Sebelumnya, Kemungkinan, dan Posterior
Satu contoh ilustrasi menunjukkan mekanik tanpa memerlukan set data penuh. Katakan sebuah jabatan kesihatan ingin menganggarkan kelaziman patogen yang baru dikenal pasti di sesebuah daerah sebelum sebarang ujian tempatan dijalankan. Pengawasan kebangsaan mencadangkan kelaziman sekitar 4 peratus, tetapi dengan ketidakpastian sebenar, jadi pasukan tersebut mengekod kepercayaan tersebut sebagai taburan terdahulu Beta(4, 96), yang berpusat pada 4 peratus sambil masih membenarkan nilai daripada kurang daripada 1 peratus hingga lebih 10 peratus. Satu tinjauan terhadap 200 penduduk tempatan kemudian mendapati 14 kes positif. Oleh kerana taburan beta ialah kelaziman konjugat untuk kemungkinan binomial, posterior hanyalah satu lagi taburan beta, Beta(4 + 14, 96 + 186), yang berfungsi untuk Beta(18, 282) dan berpusat pada anggaran kelaziman posterior kira-kira 6 peratus, ditarik antara data kelaziman kebangsaan dan tempatan mengikut kadar maklumat yang dibawa oleh setiap satu. Angka-angka tersebut adalah ilustrasi dan tidak diambil daripada wabak tertentu yang diterbitkan, dipilih hanya untuk menunjukkan bagaimana kelaziman dan kemungkinan bergabung secara aritmetik menjadi posterior.
| Term | Apa yang diwakilinya | Contoh epidemiologi |
|---|---|---|
| Pengedaran terdahulu | Kepercayaan tentang parameter sebelum melihat data kajian semasa | Anggaran kelaziman serantau daripada tinjauan kebangsaan sebelumnya |
| Fungsi kemungkinan | Kebarangkalian data yang diperhatikan di bawah nilai parameter yang berbeza | Peluang untuk memerhatikan 14 ujian positif daripada 200 memandangkan prevalens sebenar |
| Taburan posterior | Kepercayaan yang dikemas kini selepas menggabungkan kemungkinan dan kemungkinan terdahulu | Anggaran kelaziman daerah yang disemak semula selepas tinjauan tempatan |
| Selang masa yang boleh dipercayai | Julat yang mengandungi parameter dengan kebarangkalian posterior yang dinyatakan | Selang masa yang boleh dipercayai sebanyak 95 peratus untuk prevalens sebenar daerah |
| Konjugasi prior | Prior yang, digabungkan dengan kemungkinan tertentu, menghasilkan posterior daripada keluarga yang sama | Beta prior digandingkan dengan kemungkinan binomial untuk suatu perkadaran |
| rantai Markov Monte Carlo | Kaedah simulasi untuk persampelan daripada posterior tanpa penyelesaian bentuk tertutup | Menganggarkan model pemetaan penyakit ruang dengan ratusan parameter |
Selang Boleh Dipercayai Berbanding Selang Keyakinan
Penyelidik kerap kali salah menyatakan maksud selang keyakinan 95 peratus, menganggapnya sebagai peluang 95 peratus nilai sebenar berada dalam julat pengiraan tertentu. Selang keyakinan hanya menjanjikan bahawa, merentasi banyak kajian berulang, 95 peratus daripada selang yang dibina dengan cara ini akan mengandungi parameter sebenar, iaitu pernyataan tentang prosedur, bukan tentang selang tertentu yang sedang dijalankan. Selang kredibel Bayesian menyatakan dengan tepat apa yang orang inginkan daripada selang keyakinan, bahawa berdasarkan data yang diperhatikan dan prior yang dipilih, terdapat kebarangkalian posterior 95 peratus bahawa parameter tersebut berada dalam julat yang dinyatakan. Ulasan Lancet 2024 Goligher, Heath dan Harhay menerangkan perbezaan ini sebagai salah satu perbezaan yang lebih penting secara praktikal antara kedua-dua rangka kerja tersebut, kerana ia mengubah cara selang yang kredibel boleh diterangkan secara sah kepada doktor, editor jurnal dan pembuat dasar.
Mengapa Ahli Epidemiologi Memilih Kaedah Bayesian
Sampel kecil mencipta kes paling jelas untuk pendekatan Bayesian. Analisis 2025 dalam Journal of Data Science oleh Xie, Rolka dan Barker memodelkan kelaziman penyakit jarang berlaku peringkat daerah menggunakan model sifar-inflasi berwajaran persampelan hierarki Bayesian khususnya kerana banyak daerah mempunyai terlalu sedikit kes yang diperhatikan untuk anggaran berasaskan tinjauan standard bagi menghasilkan keputusan yang stabil. Percubaan pediatrik dan penyakit yatim piatu menghadapi masalah yang berkaitan, dan kertas kaedah 2022 dalam Metodologi Penyelidikan Perubatan BMC oleh Turner dan rakan sekerja menerangkan peminjaman maklumat merentasi subkumpulan pesakit dalam percubaan HIV pediatrik, menggunakan model hierarki Bayesian supaya anggaran subkumpulan kecil boleh mendapatkan kekuatan statistik daripada subkumpulan berkaitan dan bukannya berdiri sendiri pada segelintir peserta. Model Bayesian mengendalikan pengumpulan separa jenis ini secara semula jadi, kerana setiap parameter peringkat kumpulan itu sendiri diambil daripada taburan peringkat populasi yang dikongsi dan bukannya dianggarkan secara berasingan.
Menggabungkan bukti terdahulu yang tulen adalah sama pentingnya dengan pengendalian sampel kecil. Apabila kajian sistematik, percubaan terdahulu atau garis dasar serantau yang mantap sudah mengehadkan di mana parameter mungkin jatuh, analisis Bayesian membolehkan kajian menggunakan maklumat tersebut secara formal dan bukannya membuangnya dan menganggarkan semula segala-galanya daripada papan kosong, yang lebih hampir dengan cara ahli epidemiologi membuat penaakulan secara tidak formal dalam apa jua keadaan.
Model Hierarki dan Berbilang Aras untuk Data Populasi Bersarang
Data kesihatan awam jarang sekali berada pada satu tahap. Pesakit berkelompok dalam klinik, klinik berkelompok dalam daerah, dan daerah berkelompok dalam negara, dan setiap tahap struktur tersebut membawa sumber variasinya sendiri. Model Bayesian berhierarki, atau berbilang tahap, mewakili setiap tahap secara eksplisit, membiarkan parameter untuk klinik atau daerah individu berbeza-beza di sekitar taburan tahap tinggi yang dikongsi dan bukannya memaksa satu kesan tetap pada setiap kumpulan atau, pada tahap yang lain, menganggarkan setiap kumpulan secara berasingan sepenuhnya. Anggaran untuk kumpulan kecil atau luar biasa ditarik, atau dikecilkan, ke arah purata keseluruhan berkadaran dengan betapa sedikit data tempatan yang menyokongnya, manakala kumpulan dengan data yang banyak dibiarkan bercakap untuk diri mereka sendiri. Pengecutan itulah yang membolehkan Turner dan rakan sekerja menghasilkan anggaran kesan rawatan khusus subkumpulan yang boleh digunakan daripada percubaan pediatrik yang terlalu kecil untuk menganalisis mana-mana subkumpulan tunggal sendiri menggunakan kaedah konvensional. Panduan pendamping tentang pemodelan berbilang tahap untuk data perubatan bersarang merangkumi mekanik kesan tetap dan kesan rawak di sebalik pendekatan ini dengan lebih mendalam.
Pemetaan Penyakit Bayesian dan Anggaran Kawasan Kecil
Pemetaan risiko penyakit merentasi banyak kawasan geografi kecil merupakan salah satu tetapan di mana kaedah Bayesian dalam epidemiologi secara konsisten mengatasi alternatif yang lebih mudah. Kadar penyakit mentah di kawasan kecil terkenal tidak stabil, kerana sebuah perbandaran yang mempunyai 3,000 penduduk boleh melihat kadarnya berubah secara liar berdasarkan dua atau tiga kes tambahan dalam satu tahun. Model Besag-York-Mollié, atau BYM, menangani perkara ini dengan menggabungkan kesan rawak tidak berstruktur dengan kesan berstruktur ruang yang meminjam kekuatan daripada kawasan yang bersebelahan secara geografi, melicinkan hingar sambil mengekalkan kluster ruang sebenar bagi risiko yang tinggi atau rendah. Ahli statistik Andrew Gelman dan penulis bersama menerbitkan pelaksanaan penuh model BYM dalam bahasa pengaturcaraan probabilistik Stan dalam kertas kerja 2020 dalam Spatial and Spatio-temporal Epidemiology , menjadikan kaedah ini jauh lebih mudah diakses oleh ahli epidemiologi gunaan berbanding perisian khusus yang diperlukannya pada asalnya. Satu aplikasi terdahulu oleh Catelan, Lagazio dan Biggeri telah membina model Bayesian hierarki tiga peringkat untuk mengkaji kematian kanser paru-paru merentasi 287 majlis perbandaran di Tuscany, Itali, sepanjang tempoh 1995 hingga 1999, menggunakan kebarangkalian pengelasan posterior untuk menandakan kawasan yang berisiko tinggi sambil mengawal masalah ujian berganda yang timbul apabila beratus-ratus kawasan kecil dibandingkan secara serentak. Faktor risiko ruang dan persekitaran berinteraksi dengan pemodelan jenis ini dengan cara yang dibincangkan lebih lanjut dalam artikel berkaitan statistik alam sekitar dan ruang dalam kesihatan awam.
Contoh yang Berkesan: Pemetaan Kanser Kawasan Kecil di British Columbia
Satu kajian pada tahun 2022 dalam Frontiers in Oncology oleh Simkin dan rakan sekerja di BC Cancer menunjukkan aliran kerja penuh yang digunakan pada data pengawasan sebenar dan bukannya simulasi. Pasukan itu menarik kes-kes kanser paru-paru, payudara wanita, serviks dan kolorektal yang didiagnosis dalam kalangan penduduk British Columbia antara tahun 2011 dan 2018 daripada Daftar Kanser BC, kemudian memetakan risiko merentasi 218 Kawasan Perkhidmatan Kesihatan Komuniti menggunakan model BYM2 yang diubah suai. Penyeragaman umur tidak langsung menghasilkan kiraan kes yang dijangkakan dan nisbah insiden yang diseragamkan untuk setiap kawasan berbanding kadar wilayah, Moran's I mengukur sejauh mana kawasan bersebelahan berkongsi tahap risiko yang serupa, dan model BYM2 itu sendiri menjana risiko relatif median posterior dengan selang masa yang boleh dipercayai sepenuhnya untuk setiap kawasan, melicinkan kiraan kawasan kecil yang tidak stabil sambil masih menandakan kluster tempatan sebenar.
| Jenis kanser | Kes insiden, 2011-2018 | Unit geografi |
|---|---|---|
| Lung | 26,448 | 218 Kawasan Perkhidmatan Kesihatan Komuniti |
| Payudara wanita | 28,466 | |
| Serviks | 1,478 | |
| Colorectal | 25,457 |
Manfaat praktikal kajian ini adalah kebolehcapaian dan juga ketepatan. Simkin dan rakan sekerja telah menggabungkan aliran kerja pemodelan dan pemetaan penuh ke dalam pakej R smallareamapp sumber terbuka khususnya kerana, seperti yang mereka nyatakan, kapasiti teknikal untuk kaedah ini masih terhad merentasi daftar kanser, dan alat yang boleh dihasilkan semula mengurangkan halangan untuk daftar wilayah dan negeri lain untuk menjalankan analisis yang sama pada data mereka sendiri.
Kaedah Bayesian dalam Pengawasan Penyakit dan Pengesanan Isyarat
Farmakovigilans merupakan pengguna awal pengesanan isyarat Bayesian, lama sebelum "Bayesian" menjadi perkataan umum dalam epidemiologi umum. Satu kajian semula kaedah pada tahun 2009 dalam Farmakoepidemiologi dan Keselamatan Ubat oleh Bate dan Evans menerangkan bagaimana pengawal selia menapis laporan tindak balas ubat buruk spontan menggunakan kaedah Bayes empirikal seperti min geometri Bayes empirikal, yang mengecilkan nisbah pelaporan mentah yang bising ke arah anggaran yang lebih konservatif untuk pasangan ubat-peristiwa dengan sedikit laporan, mengurangkan penggera palsu tanpa memerlukan penganalisis mengabaikan isyarat keselamatan yang jarang berlaku tetapi tulen. Pengawasan kanser menunjukkan trend selari pada peringkat populasi. Satu kajian semula sistematik dalam Jurnal Kesihatan Awam Antarabangsa oleh Wah, Ahern dan Earnest mengenal pasti 38 kajian yang diterbitkan antara 2014 dan 2018 yang menggunakan model spatial-temporal Bayesian sepenuhnya kepada data kejadian dan kematian kanser, bukti bahawa logik pengecutan yang sama di sebalik pengesanan isyarat farmakovigilans kini menyokong bagaimana pendaftaran menjejaki perubahan risiko kanser di tempat dan masa.
Perisian untuk Epidemiologi Bayesian
Empat platform merangkumi kebanyakan kerja epidemiologi Bayesian yang digunakan hari ini. Stan menjalankan persampelan Hamiltonian Monte Carlo dan mendasari pelaksanaan pemetaan penyakit BYM yang diterbitkan oleh Gelman dan penulis bersama, mengendalikan model hierarki dan ruang yang besar dengan cekap untuk kerja skala pendaftaran rutin. JAGS, enjin yang lebih lama tetapi masih diajar secara meluas, menggunakan persampelan Gibbs dan kekal biasa dalam kursus epidemiologi dan kod analisis legasi. WinBUGS mempelopori perisian MCMC yang boleh diakses untuk ahli epidemiologi pada tahun 1990-an dan masih kadangkala ditemui dalam kaedah yang diterbitkan lebih lama, walaupun kebanyakan projek aktif telah berhijrah ke Stan atau JAGS. Pakej R brms, yang dibangunkan oleh Paul-Christian Bürkner dan ditunjukkan untuk model regresi ordinal dalam kertas kerja 2021 dalam British Journal of Mathematical and Statistical Psychology , membolehkan penyelidik menentukan model Stan menggunakan sintaks formula regresi R yang biasa, yang telah menjadikan pemodelan hierarki Bayesian penuh boleh diakses oleh ahli epidemiologi tanpa latar belakang dalam pengaturcaraan kebarangkalian. Perbandingan pendekatan regresi, termasuk di mana pelarasan Bayesian mengubah jawapannya, dibincangkan dalam artikel berkaitan tentang model regresi dalam penyelidikan perubatan.
Pemeriksaan Monte Carlo dan Konvergensi Rantaian Markov
Posterior bentuk tertutup hanya wujud untuk satu set kecil model mudah, jadi kebanyakan epidemiologi Bayesian yang digunakan bergantung pada rantai Markov Monte Carlo, sebuah keluarga algoritma yang menarik sampel berkorelasi daripada rantai Markov yang dibina untuk menumpu pada taburan posterior sasaran. Menjalankan beberapa rantai bebas, biasanya sekurang-kurangnya tiga atau empat, daripada nilai permulaan yang berbeza adalah amalan standard, kerana rantai yang mendarat pada jawapan yang serupa daripada titik permulaan yang berbeza memberikan bukti langsung penumpuan, manakala perselisihan faham antara rantai menandakan masalah yang perlu diselesaikan oleh penganalisis sebelum mempercayai sebarang anggaran yang dilaporkan. Penganalisis biasanya membuang fasa pemanasan awal, kemudian memeriksa plot surih, statistik pengurangan skala berpotensi yang kadangkala dipanggil R-hat, dan saiz sampel berkesan untuk menilai sama ada rantai tersebut meneroka posterior dengan secukupnya dan sama ada anggaran yang terhasil cukup tepat untuk dilaporkan. Model hierarki dan ruang yang kompleks, yang sama seperti yang digunakan dalam pemetaan penyakit, lebih terdedah kepada masalah pencampuran dan penumpuan yang perlahan daripada model regresi mudah, jadi diagnostik penumpuan sekurang-kurangnya memerlukan perhatian yang sama dalam bahagian kaedah manuskrip seperti spesifikasi model itu sendiri.
Perangkap Biasa dalam Pelaporan Epidemiologi Bayesian
Penerimaan telah mengatasi pelaporan yang ketat dalam beberapa bahagian kesusasteraan Bayesian. Satu tinjauan sistematik pada tahun 2026 dalam Metodologi Penyelidikan Perubatan BMC oleh Marks dan rakan sekerja mengkaji penentuan saiz sampel merentasi percubaan klinikal rawak Bayesian yang diterbitkan dan mendapati bahawa kaedah Bayesian sepenuhnya, walaupun populariti teorinya, jarang digunakan dengan betul dalam amalan, dengan banyak percubaan meminjam bahasa Bayesian untuk reka bentuk yang kekal kerap berlaku. Tiga kegagalan praktikal muncul berulang kali dalam manuskrip yang dihantar. Analisis sensitiviti merentasi priori alternatif yang munasabah sering tidak dilaporkan, menyebabkan pembaca tidak dapat menilai sejauh mana priori yang dipilih sebenarnya mendorong kesimpulan. Diagnostik penumpuan untuk rantai MCMC sering diabaikan sepenuhnya, walaupun rantai yang kurang bercampur boleh menghasilkan posterior yang kelihatan yakin tetapi salah. Priori yang samar-samar dan tidak bermaklumat kadangkala dilabel semula sebagai "objektif" tanpa mengakui bahawa priori yang benar-benar rata masih boleh membentuk keputusan secara bermakna dalam tetapan sampel kecil, yang merupakan tetapan di mana penyelidik mencapai kaedah Bayesian pada mulanya. Seorang pengulas statistik jurnal akan mencari ketiga-tiganya sebelum menerima analisis Bayesian, dan manuskrip yang menanganinya terlebih dahulu akan melalui semakan rakan sebaya dengan permintaan semakan utama yang jauh lebih sedikit.
Bagaimana Ahli Statistik Editverse Menyokong Projek Epidemiologi Bayesian
Menentukan prior yang sesuai, membina model hierarki atau spatial yang sepadan dengan struktur data sebenar kajian dan mendiagnosis masalah penumpuan MCMC, semuanya memerlukan pengalaman pemodelan Bayesian secara langsung yang tidak dapat dilalui oleh banyak manuskrip melalui semakan rakan sebaya. Pasukan biostatistik Editverse bekerjasama secara langsung dengan penyelidik epidemiologi mengenai spesifikasi terdahulu, kod model Stan dan brms, diagnostik penumpuan dan bahasa bahagian kaedah yang memuaskan hati pengulas statistik di jurnal yang semakin mengharapkan ketelitian Bayesian dan bukannya tabiat kerapian yang dipinjam. Perkhidmatan manuskrip dan analisis statistik Editverse merangkumi kerja ini daripada spesifikasi model awal hingga manuskrip akhir yang diserahkan dan pemilih ujian statistik percuma merupakan titik permulaan yang berguna untuk mengesahkan sama ada pendekatan Bayesian atau ujian kerapian konvensional lebih sesuai dengan set data tertentu sebelum membuat komitmen kepada mana-mana satu.

Bacaan Berkaitan tentang Kaedah Bayesian dan Epidemiologi
- Statistik Bayesian Memperkasakan Penyelidikan Perubatan Sebagai Permulaan untuk langkah pertama yang lebih lembut pada idea teras yang sama.
- Analisis Bayesian dalam Amalan: Kajian Kes daripada Ujian Klinikal Adaptif tentang bagaimana alat yang sama ini mengubah reka bentuk percubaan dan bukannya pengawasan.
- Kesan Inferens Kausal terhadap Epidemiologi dan Kesihatan Awam tentang bagaimana rangka kerja Bayesian dan kausal bersilang.
- Model Lanjutan untuk Data Penyakit Berjangkit untuk model tak linear dan kompartmen yang sering digandingkan dengan anggaran Bayesian.
- Analisis Kuasa Dipermudahkan tentang perbezaan perancangan saiz sampel antara reka bentuk frequentist dan Bayesian.
- Analisis Kemandirian Kaplan-Meier untuk rakan sejawat kerap kepada pemodelan survival Bayesian dalam data onkologi.
Soalan Lazim
Apakah perbezaan praktikal utama antara epidemiologi Bayesian dan epidemiologi frequentist?
Analisis frequentist menghasilkan anggaran titik, nilai-p dan selang keyakinan yang dibina sepenuhnya daripada data kajian semasa. Analisis Bayesian menggabungkan data tersebut dengan taburan terdahulu yang mewakili pengetahuan sedia ada, kemudian melaporkan taburan posterior penuh dan selang yang boleh dipercayai yang boleh ditafsirkan secara langsung sebagai pernyataan kebarangkalian tentang parameter itu sendiri.
Bilakah pendekatan Bayesian membuat perbezaan terbesar dalam epidemiologi?
Sampel kecil atau penyakit yang jarang berlaku, pemetaan penyakit kawasan kecil merentasi banyak unit geografi dan data hierarki dengan klinik atau daerah yang bersarang di dalam kawasan yang lebih besar merupakan tetapan di mana model hierarki Bayesian paling jelas mengatasi pendekatan kesan tetap konvensional, sebahagian besarnya disebabkan oleh penggabungan separa yang digunakan merentasi kumpulan berkaitan.
Adakah selang masa 95 peratus yang boleh dipercayai adalah sama dengan selang masa keyakinan 95 peratus?
Tidak. Selang yang boleh dipercayai menyatakan bahawa, berdasarkan data dan prior yang dipilih, terdapat kebarangkalian posterior 95 peratus bahawa parameter sebenar terletak dalam selang tersebut. Selang keyakinan hanya menjamin bahawa 95 peratus selang yang dibina dengan cara yang sama merentasi kajian berulang akan mengandungi nilai sebenar, yang merupakan pernyataan tentang prosedur jangka panjang dan bukannya selang tertentu yang dikira.
Perisian apakah yang digunakan oleh ahli epidemiologi untuk menjalankan model Bayesian?
Stan dan pakej R brms mengendalikan kebanyakan kerja semasa, JAGS kekal biasa dalam pengajaran dan kod legasi, dan WinBUGS mempelopori bidang ini pada tahun 1990-an tetapi kebanyakannya telah digantikan dengan alatan yang lebih pantas dan fleksibel seperti Stan.
Adakah analisis Bayesian memerlukan sejumlah besar data terdahulu untuk menjadi berguna?
Tidak. Sesebuah kajian boleh menggunakan prior yang sengaja lemah dan bermaklumat minimum dan membiarkan data yang diperhatikan menguasai posterior, yang merupakan amalan biasa apabila bukti prior yang kukuh tidak wujud. Pendekatan ini masih memberikan taburan posterior penuh dan selang masa yang sah dan boleh dipercayai walaupun di bawah prior yang lemah.
Bagaimanakah pengulas menilai analisis Bayesian dalam manuskrip yang diserahkan?
Pengulas statistik biasanya menyemak sama ada priori yang dipilih adalah wajar dan pengaruhnya diuji melalui analisis sensitiviti, bahawa diagnostik penumpuan MCMC seperti R-hat dan saiz sampel berkesan dilaporkan, dan bahawa kertas kerja mentafsir selang yang boleh dipercayai dengan betul dan bukannya menerangkannya dengan bahasa kerap yang dipinjam daripada selang keyakinan.