Publié | Dernière mise à jour
L' indice de Youden est la méthode la plus courante pour déterminer le seuil de positivité d'un test diagnostique continu ou d'un biomarqueur. Utilisez les deux calculateurs ci-dessous pour le calculer, puis poursuivez votre lecture pour découvrir la formule, un exemple d'application, la méthode de choix du seuil et les limites de cette méthode.
Sur cette page : Calculatrices · Formule · Exemple détaillé · Seuil optimal · Interprétation · Études de cas avec des données réelles · Comparaison des critères de Youden et autres critères · Limitations · Code R · FAQ
Calculateur d'indice de Youden
Saisissez la sensibilité et la spécificité si vous les connaissez déjà. Si vous disposez des valeurs brutes, utilisez le tableau 2×2 ci-dessous.
Taux de vrais positifs
Taux véritablement négatif
| Indice Youden (J) | 0.7500 |
| Lecture (règle empirique) | Haute |
| Taux de faux positifs (1 − Sp) | 10.00 % |
| Taux de faux négatifs (1 − Se) | 15.00 % |
J = Se + Sp − 1. Essayez Se 0.92 et Sp 0.88 pour reproduire l'exemple résolu ci-dessous (J = 0.80).
Saisissez les effectifs entiers. Vous devez inclure au moins un cas malade et un cas non malade.
Maladie présente, test positif
Absence de maladie, test positif
Maladie présente, test négatif
Absence de maladie, test négatif
Les deux calculateurs fonctionnent dans votre navigateur et n'envoient aucune donnée. Nous avons comparé la version 2×2 avec le package R pROC dans des cas limites tels que des cellules vides et une séparation parfaite.
Formule de l'indice de Youden
Youden a proposé cet indice en 1950 comme une évaluation unique pour un test diagnostique [1]. Trois propriétés méritent d'être connues :
- Gamme Pour un test donné et un seuil de décision donné, −1 ≤ J ≤ 1. J = 0 signifie que le test n'est pas plus performant qu'un tirage à pile ou face, et J < 0 signifie que le test indique une mauvaise réponse. La valeur maximale de J, quel que soit le seuil de décision, n'est jamais inférieure à 0.
- Géométrie. J représente l'écart vertical entre la courbe ROC et la ligne diagonale de probabilité. Le seuil où cet écart est maximal correspond au seuil de Youden (figure 1).
- Prévalence. J ne change pas en fonction de la prévalence de la maladie, car Se et Sp sont mesurés séparément au sein des groupes malades et sains.

Exemples résolus
Exemple 1 : à partir de Se et Sp
Un test a une sensibilité de 0.92 et une spécificité de 0.88. J = 0.92 + 0.88 − 1 = 0.80 . Il manque 8 % des patients malades et signale à tort 12 % des personnes saines.
Exemple 2 : à partir d’un tableau 2×2
Supposons que 200 patients soient testés par rapport à une norme de référence. Le tableau ci-dessous est donné à titre indicatif et ne provient pas d'une étude publiée.
| Maladie présente | Maladie absente | |
|---|---|---|
| Test positif | TP = 85 | PF = 10 |
| Test négatif | FN = 15 | TN = 90 |
- Sensibilité = 85 / (85 + 15) = 0.85
- Spécificité = 90 / (90 + 10) = 0.90
- J = 0.85 + 0.90 − 1 = 0.75
Les mêmes calculs donnent PPV 85/95 = 89.5 %, NPV 90/105 = 85.7 %, LR+ = 0.85 / 0.10 = 8.5 et LR− = 0.15 / 0.90 = 0.17. Saisissez-les dans la deuxième calculatrice pour confirmer.
Comment trouver le seuil optimal
Avec un marqueur continu, chaque coupure possible donne sa propre valeur Se et Sp. Les étapes sont les suivantes :
- Énumérer les seuils candidats, généralement chaque valeur observée ou une grille cliniquement pertinente.
- À chaque seuil, classer les patients comme positifs lorsque le marqueur est égal ou supérieur à ce seuil, et calculer la sensibilité et la spécificité par rapport à la norme de référence.
- Calculer J = Se + Sp − 1 à chaque coupure.
- Prenez la valeur de coupure avec le J le plus élevé, puis ajoutez un intervalle de confiance bootstrap pour la valeur de coupure et pour J.
Le tableau ci-dessous utilise des valeurs fictives pour un biomarqueur mesuré chez 100 personnes malades et 100 personnes saines. La valeur J atteint un maximum de 0.70 pour un seuil de 25 ; 25 représente donc le seuil optimal de Youden dans ce cas.
| Couper | Sensibilité | Spécificité | J |
|---|---|---|---|
| 10 | 0.98 | 0.40 | 0.38 |
| 15 | 0.95 | 0.62 | 0.57 |
| 20 | 0.90 | 0.78 | 0.68 |
| 25 | 0.82 | 0.88 | 0.70 |
| 30 | 0.70 | 0.94 | 0.64 |
| 35 | 0.52 | 0.98 | 0.50 |
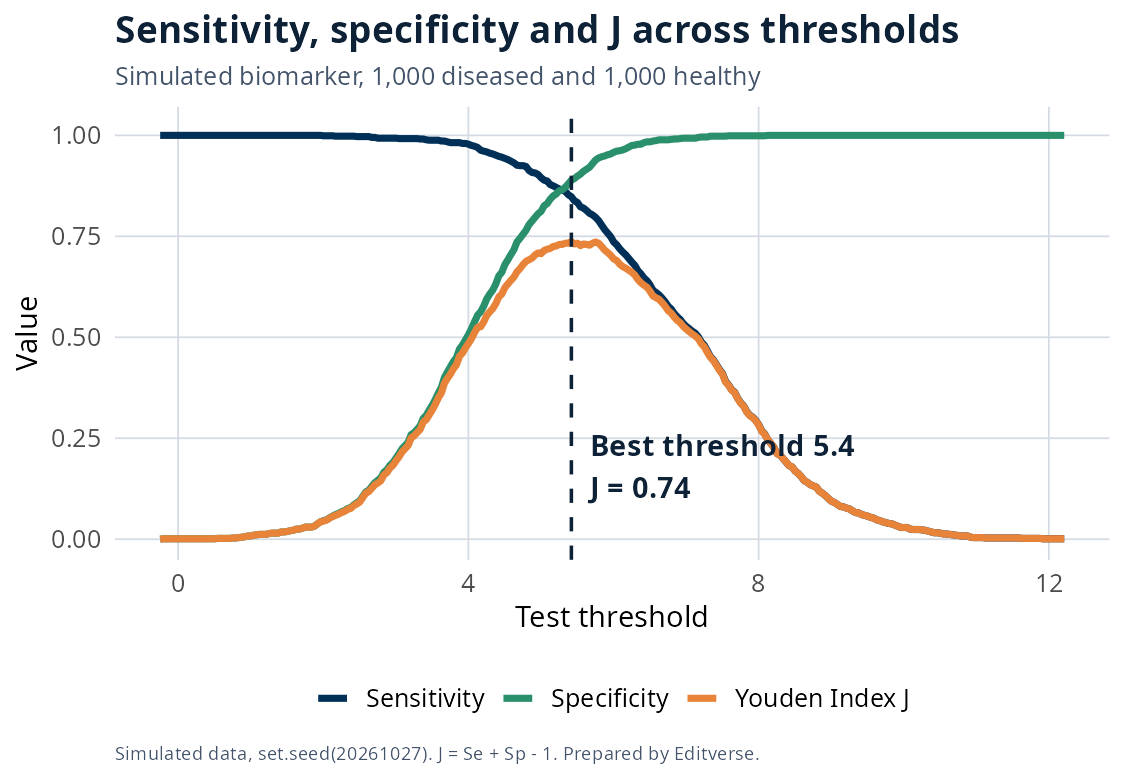
Observez ce qui se passe de part et d'autre du pic. Des seuils plus bas augmentent la sensibilité au détriment de la spécificité, et des seuils plus élevés produisent l'effet inverse. La figure 2 illustre ce phénomène sur des données simulées : la courbe J forme une colline dont le sommet se situe à proximité du point d'intersection des courbes de sensibilité et de spécificité.
Comment interpréter l'indice de Youden
Il n'existe pas d'échelle standardisée. Les intervalles ci-dessous constituent des règles empiriques courantes, utilisées par les calculateurs ci-dessus. Considérez-les comme un point de départ et évaluez J en fonction des enjeux cliniques.
| J | Lecture | Ce que cela signifie en pratique |
|---|---|---|
| 0.75 à 1.00 ans, qui | Haute | Peu d'erreurs de l'un ou de l'autre type |
| 0.50 à 0.74 ans, qui | Bon | Utile, mais attendez-vous à un taux d'erreur visible. |
| 0.25 à 0.49 ans, qui | Modérée | Faible seul, il peut être utile au sein d'un groupe. |
| 0 à 0.24 ans, qui | Low | Proche du hasard |
| Ci-dessous 0 | Pire que le hasard | Vérifiez que le sens du test n'est pas inversé. |
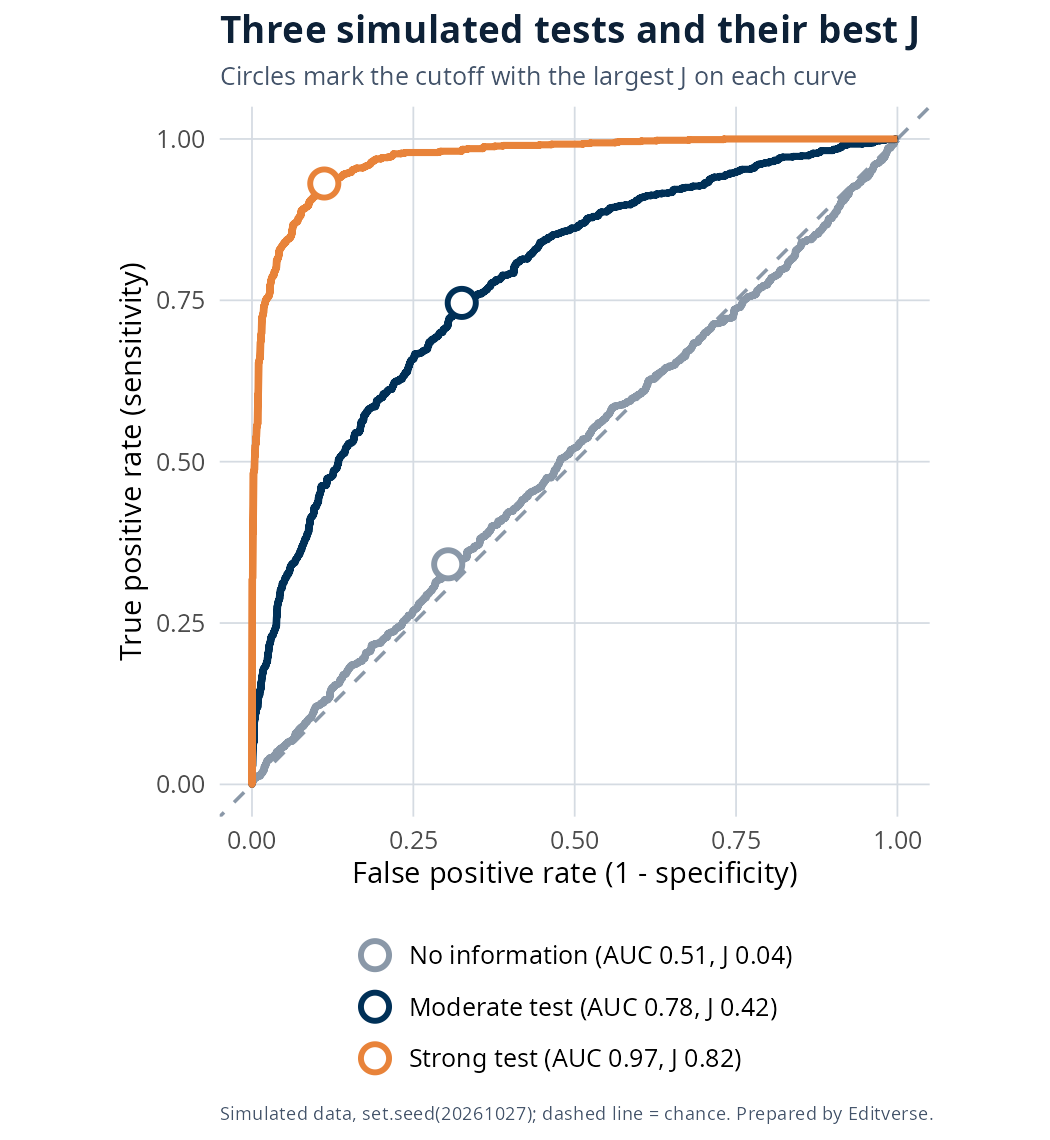
La figure 3 compare trois courbes ROC simulées : un test sans information (J = 0.04), un test modéré (J = 0.42) et un test puissant (J = 0.82). Même un test puissant n’atteint pas J = 1, ce qui nécessiterait une séparation parfaite des deux groupes.
Études de cas avec des données réelles : deux études en libre accès publiées dans PLOS ONE
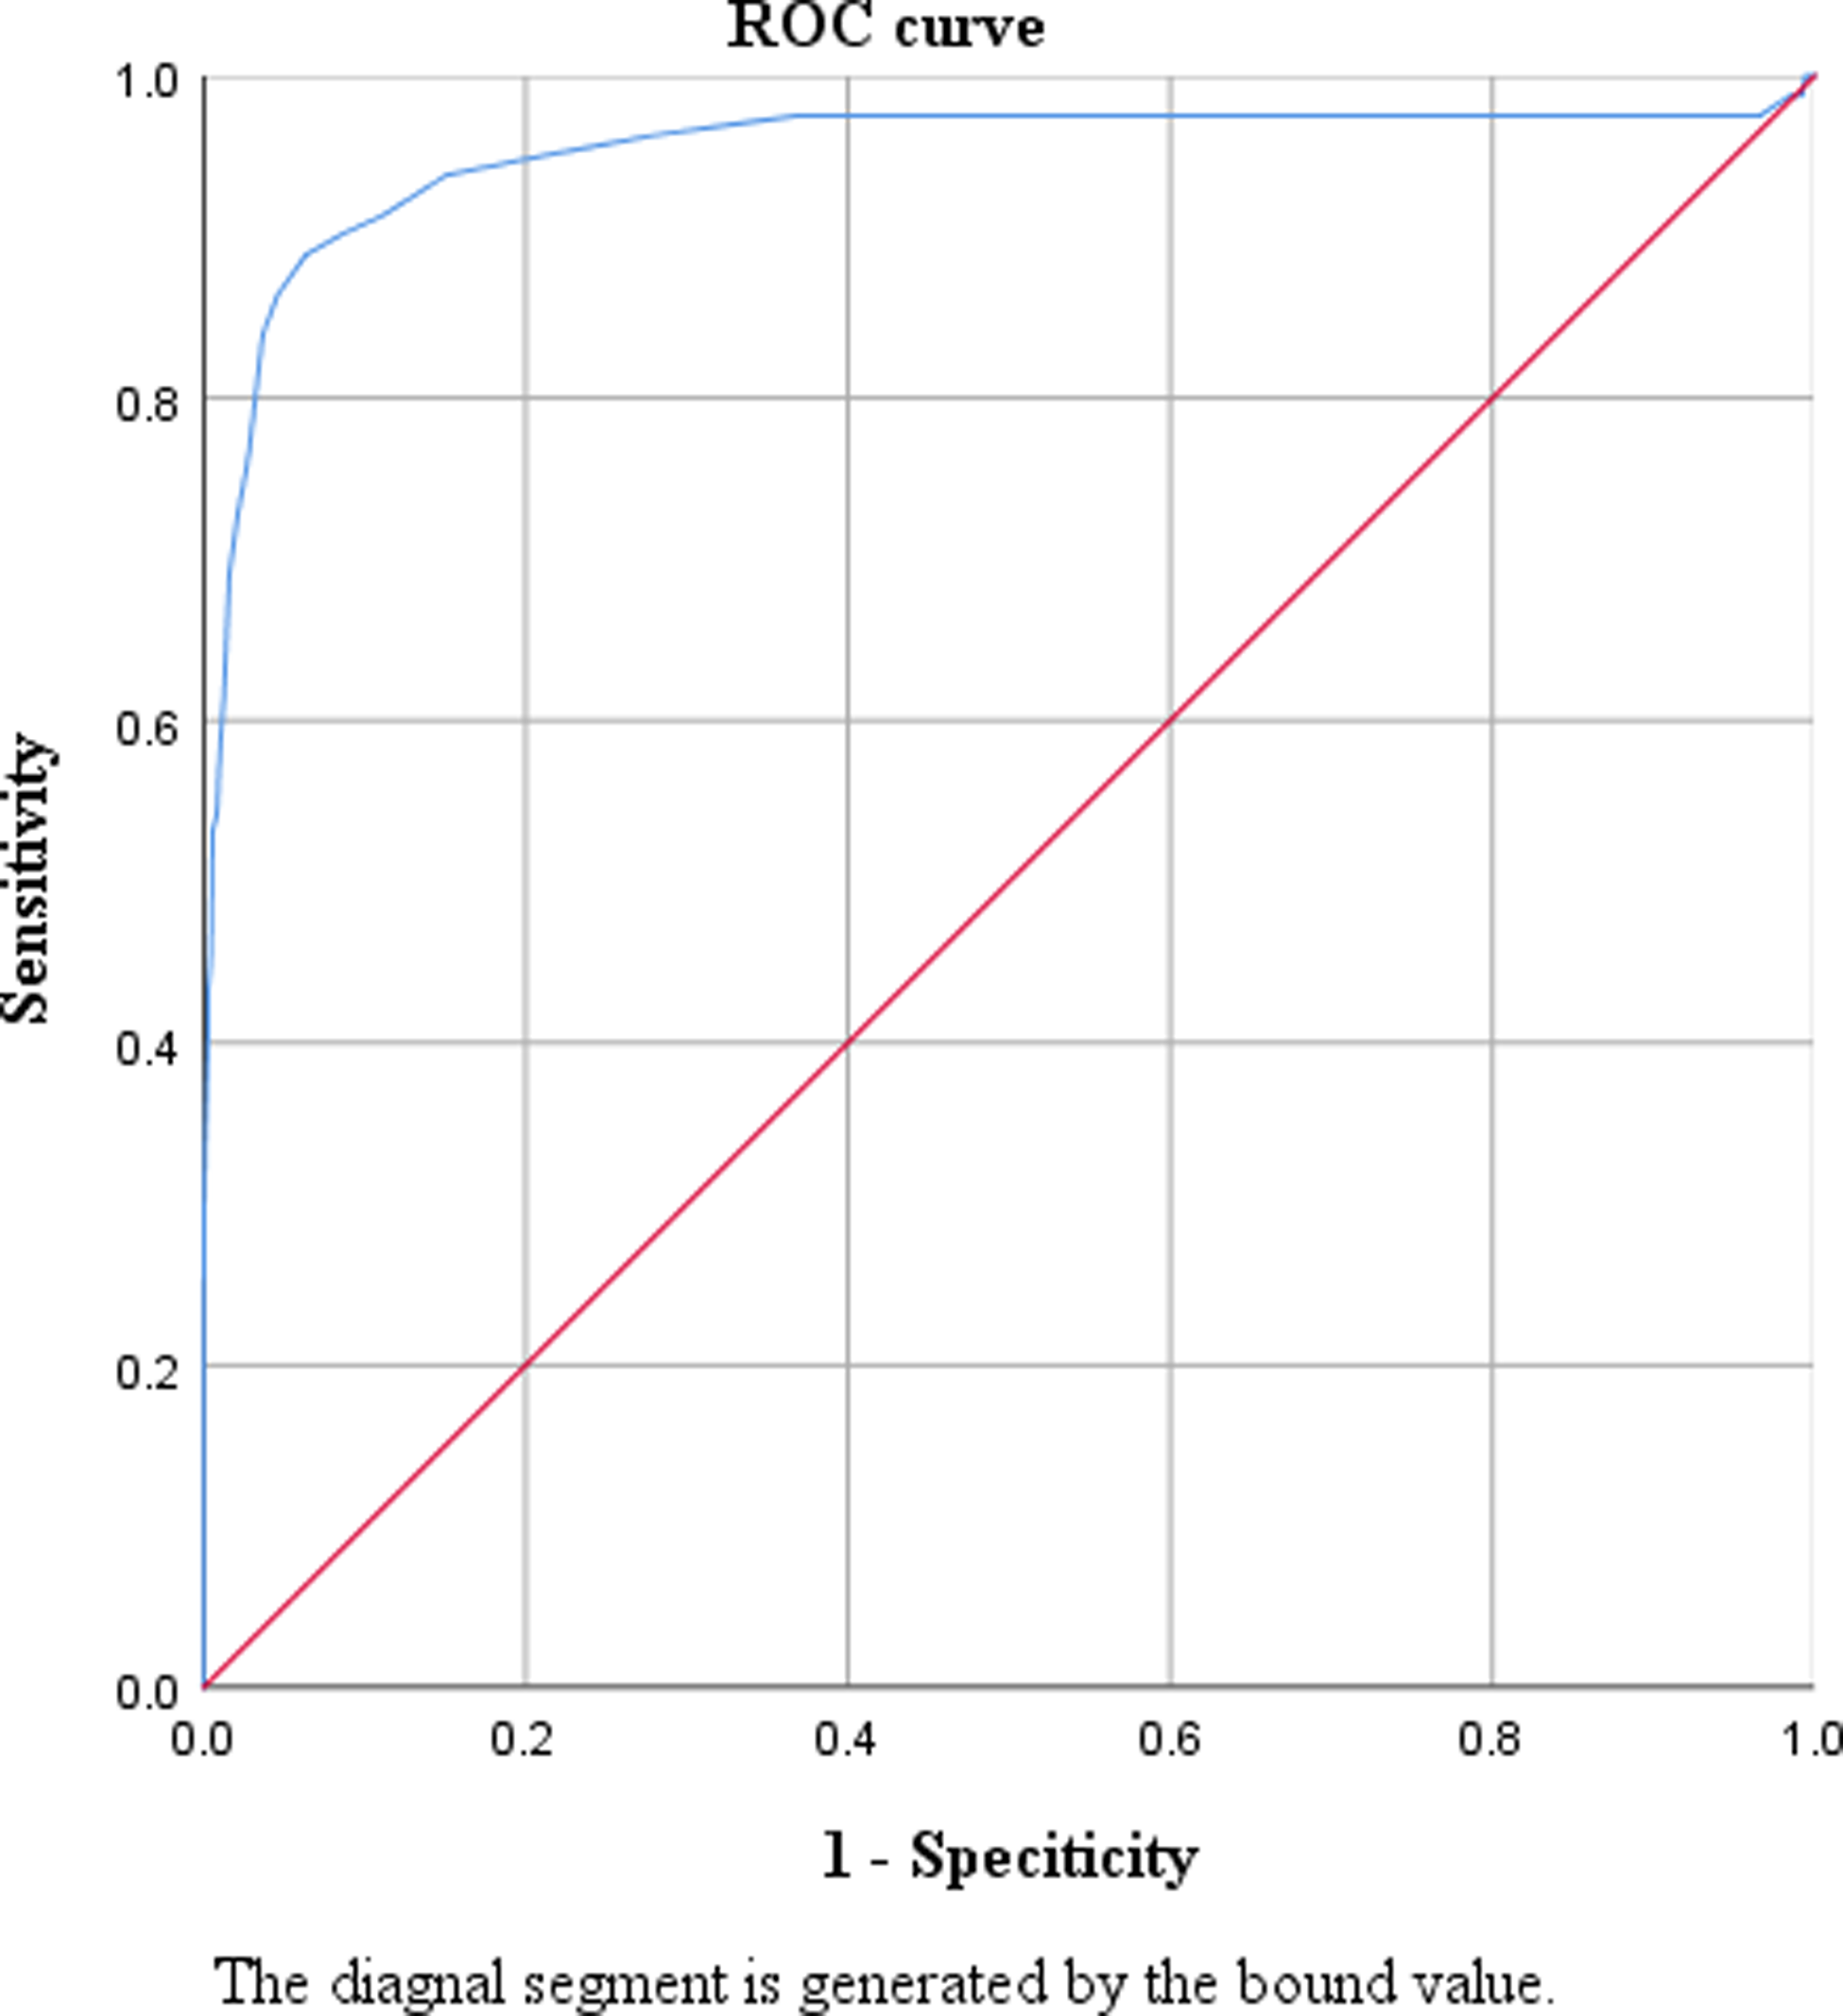
Deux études récentes publiées dans PLOS ONE présentent l'indice de Youden dans son intégralité et sont sous licence CC BY 4.0, ce qui nous permet de reproduire leurs courbes ROC ci-dessous. Nous avons reconstitué les tableaux à partir des données publiées et effectué de nouveaux calculs. Toute analyse présentée comme étant la nôtre correspond à nos propres calculs à partir de ces tableaux et non à un résultat publié par les auteurs.
Cas 1 : le seuil d’HbA1c pour le diabète en Chine rurale
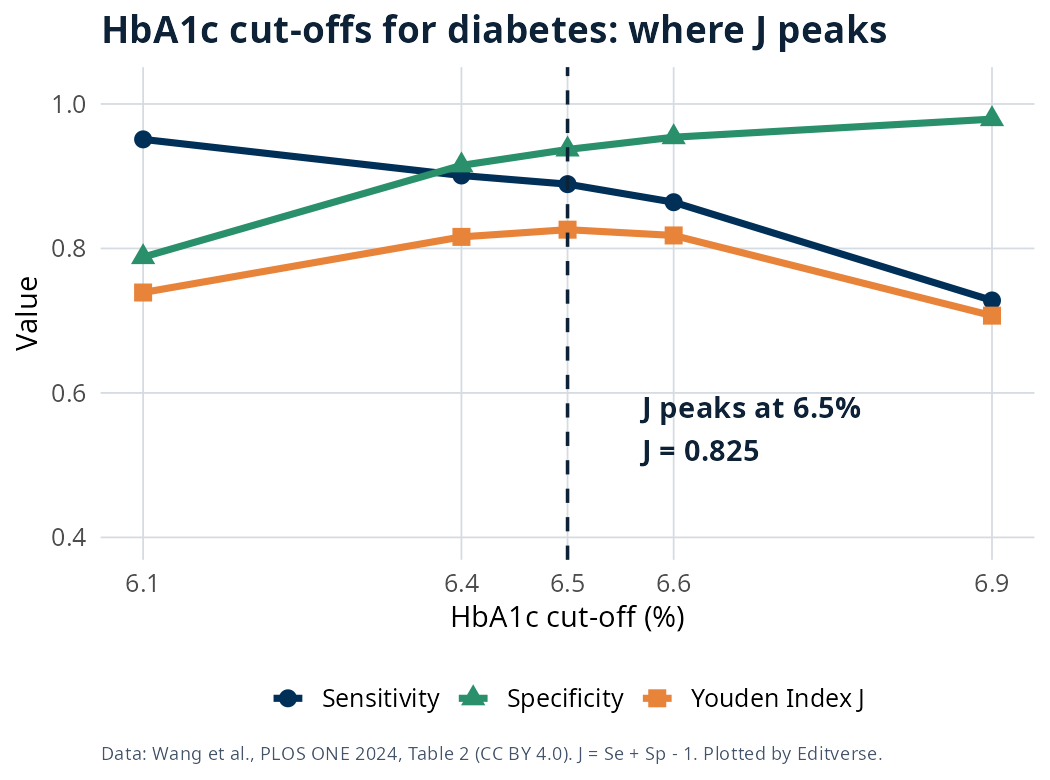
Wang et ses collègues ont mesuré la glycémie à jeun (GAJ) et l'hémoglobine glyquée (HbA1c) chez 3 547 adultes âgés de 61 ans et plus en Chine rurale. Parmi les 3 122 personnes sans antécédent de diabète, ils ont utilisé une GAJ de 7.0 mmol/L ou plus comme référence et ont cherché à déterminer le seuil d'HbA1c qui maximisait J. La réponse était de 6.5 % (48 mmol/mol), avec une sensibilité de 88.9 %, une spécificité de 93.7 % et J = 0.825 [12].
| Seuil de HbA1c | Sensibilité | Spécificité | J (Se + Sp − 1) | PPV |
|---|---|---|---|---|
| 6.1 % | 95.1 % | 78.8 % | 0.739 | 10.7 % |
| 6.4 % | 90.1 % | 91.5 % | 0.816 | 22.0 % |
| 6.5 % | 88.9 % | 93.7 % | 0.826 | 27.2 % |
| 6.6 % | 86.4 % | 95.4 % | 0.818 | 33.3 % |
| 6.9 % | 72.8 % | 97.9 % | 0.707 | 47.6 % |
Source : Wang et al. 2024, tableau 2 [12]. Nous avons recalculé J à partir des valeurs arrondies de Se et Sp, ce qui donne 0.826 à 6.5 % ; l’article rapporte 0.825 à partir des valeurs non arrondies.
Ce que cette affaire démontre
- Un pic net. La valeur de J passe de 0.738 à 6.1 % à 0.825 à 6.5 %, puis retombe à 0.707 à 6.9 %. Compte tenu de ce pic marqué, de faibles variations dans l'échantillon ont peu de chances d'influencer significativement le seuil de coupure.
- Deux critères, même réponse ici. Dans nos calculs, le point le plus proche du coin supérieur gauche se situe également à 6.5 % (distance de 0.128, contre 0.131 à 6.4 %). Ils concordent sur cet ensemble de données, mais rien ne le garantit [4].
- Un taux de J élevé ne signifie pas un taux de PPV élevé. Avec une prévalence de 6.5 %, la valeur prédictive positive (VPP) n'est que de 27.2 %, malgré une spécificité de 93.7 %. En nous basant sur les valeurs publiées de sensibilité (Se), de spécificité (Sp) et de VPP, nous estimons qu'environ 2.6 % de l'échantillon dépisté présentaient un diabète diagnostiqué par la glycémie à jeun (GAJ). Lorsque la maladie est rare, même un test performant peut générer de nombreux faux positifs. Il convient d'indiquer la VPP en précisant la prévalence dont elle est issue.
Cas 2 : l’échelle de Morse dans les services d’obstétrique et de gynécologie
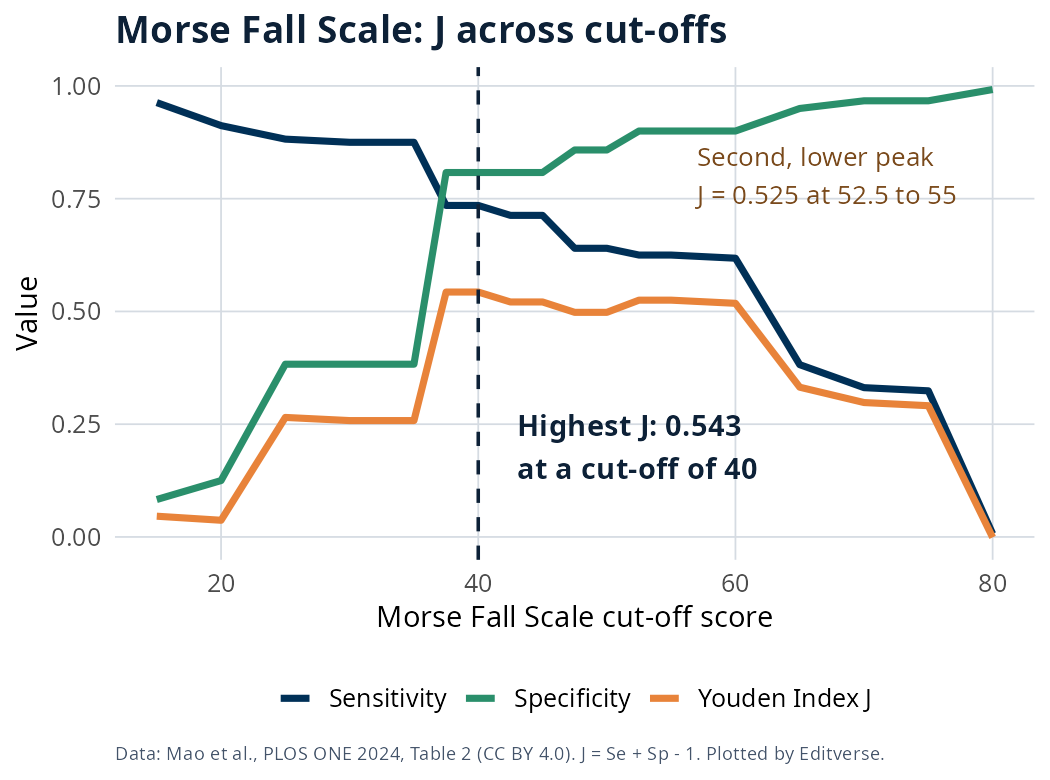
Mao et ses collègues ont comparé 136 patientes hospitalisées ayant chuté à 120 patientes n'ayant pas chuté, dans un service d'obstétrique-gynécologie et un hôpital général, et ont évalué chaque groupe à l'aide de l'échelle de Morse. La courbe ROC présentait une aire sous la courbe (AUC) de 0.791, et les auteurs ont choisi un seuil de 40, avec une sensibilité de 0.735, une spécificité de 0.808 et un coefficient J de 0.543 [13].

| Couper | Sensibilité | Spécificité | J (Se + Sp − 1) | Perte pondérée (chute manquée = 3 × fausse alarme) |
|---|---|---|---|---|
| 25 | 0.882 | 0.383 | 0.265 | 0.971 |
| 35 | 0.875 | 0.383 | 0.258 | 0.992 |
| 40 | 0.735 | 0.808 | 0.543 | 0.987 |
| 45 | 0.713 | 0.808 | 0.521 | 1.053 |
| 50 | 0.640 | 0.858 | 0.498 | 1.222 |
| 55 | 0.625 | 0.900 | 0.525 | 1.225 |
| 60 | 0.618 | 0.900 | 0.518 | 1.246 |
Source : Mao et al. 2024, tableau 2 [13]. J et la dernière colonne correspondent à nos calculs à partir des valeurs de sensibilité et de spécificité publiées. Une perte pondérée plus faible est préférable.
Ce que cette affaire démontre
- Des égalités et un second sommet. La valeur de J est identique (0.543) pour tous les scores compris entre 37.5 et 40, ce qui explique l'égalité de plusieurs scores. Après une baisse à 0.498 entre 47.5 et 50, elle remonte à 0.525 entre 52.5 et 55. Un seul maximum peut masquer un second choix pertinent.
- L'égalité des poids est un choix. Supposons qu'une chute non détectée compte trois fois plus qu'une fausse alarme. Dans notre calcul illustratif, la perte pondérée la plus faible passe alors de 40 à 25 (0.971 contre 0.987), la sensibilité étant de 0.882. J, à lui seul, ne suggérerait jamais cela.
- La prévalence est déterminée par le modèle. Avec 136 patients ayant fait une chute et 120 n'en ayant pas fait, l'échantillon est approximativement équilibré par construction ; ses valeurs prédictives positives et négatives ne correspondent donc pas à la réalité d'un service hospitalier. Le modèle J ne présente pas ce problème.
- Recalculez avant de copier. Dans le tableau publié, J à un seuil de 20 est indiqué comme étant de 0.162, mais 0.912 + 0.125 − 1 = 0.037. Vérifiez chaque valeur de J que vous prenez dans un tableau.
La même vérification fonctionne sur vos propres données : listez Se et Sp à chaque seuil, recalculez J, puis recherchez les égalités, les seconds pics et le coût de chaque erreur avant de choisir un nombre.
Indice de Youden comparé à d'autres critères de seuil
| Critère | Ce qu'il optimise | À utiliser de préférence quand | Attention à |
|---|---|---|---|
| Youden J | Se + Sp − 1 | Les cas non détectés et les fausses alertes coûtent à peu près la même chose. | Ignore les coûts inégaux |
| Le plus proche du coin supérieur gauche | Distance à (FPR 0, TPR 1) | Vous souhaitez une classification quasi parfaite. | Peut choisir une coupure différente de J [4] |
| ASC | Discrimination sur l'ensemble de la courbe | Comparer les tests, et non choisir un seuil | Ne donne pas de seuil |
| Rapports de vraisemblance | Dans quelle mesure un résultat modifie-t-il la probabilité ? | Raisonnement au chevet du patient avec probabilité pré-test | Nécessite une probabilité a priori |
| Coût pondéré / bénéfice net | Préjudice ou avantage attendu | Les coûts des deux erreurs diffèrent clairement. | Nécessite des données d'entrée de coût ou de probabilité de seuil |
Le critère de Youden et le critère du plus proche du coin supérieur gauche concordent souvent, mais pas toujours. Perkins et Schisterman ont montré qu'ils peuvent indiquer des seuils différents et que le seuil de Youden est celui qui maximise la classification correcte lorsque les groupes de sujets sains et malades sont pondérés de manière égale [4]. Choisissez le critère à l'avance et mentionnez-le dans votre méthodologie.
Limitations et correctifs
| Limitation | Pourquoi cela compte | Que faire |
|---|---|---|
| Les deux erreurs ont le même poids. | Un cancer non diagnostiqué et une fausse alerte sont rarement des préjudices équivalents. | Utilisez une règle pondérée par les coûts ou une analyse de courbe de décision |
| Optimisme dans le même échantillon | La meilleure valeur de J dans vos données est biaisée vers le haut. | Bootstrap ou validation croisée [2,9] |
| Erreur de mesure du marqueur | Le bruit aplatit la courbe ROC et diminue J | Utiliser des estimateurs corrigés d'erreur [3] |
| Valeurs inférieures à la limite de détection | En supprimant ces biais J et la coupure | Utiliser des méthodes conçues pour une limite de détection inférieure [5] |
| Plus de deux classes | Le groupe J à deux dimensions ne s'étend pas directement | Utilisez la généralisation à trois classes [6,7] |
| Prévalence en PPV et NPV | Les valeurs prédictives varient en fonction de la prévalence | Indiquez la sensibilité (Se) et la spécificité (Sp), puis recalculez la VPP et la VPN pour la population cible. |
Pour des revues plus larges des méthodes de seuillage, voir l'introduction de Hajian-Tilaki à l'analyse ROC [8] et la mise à jour de 2024 par Hassanzad et Hajian-Tilaki [9].
Calculer l'indice de Youden dans R
Le package pROC renvoie directement le seuil de Youden [10].
library(pROC) roc_obj <- roc(response = d$disease, predictor = d$marker) coords(roc_obj, x = "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity")) ci.coords(roc_obj, x = "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"), boot.n = 2000)Lorsque vous rédigez ceci, suivez STARD 2015 afin que le seuil, la manière dont il a été choisi et son incertitude soient tous rapportés [11].
Calculatrices gratuites pour le travail de précision diagnostique
Ces outils gratuits couvrent les étapes relatives à l'indice de Youden.
Faites vérifier votre analyse de précision diagnostique
Une méthode de seuillage inappropriée peut compromettre la validité d'un article diagnostique en cours d'évaluation. Si vous souhaitez qu'un biostatisticien réalise ou vérifie l'analyse ROC, le choix du seuil et la section « Méthodes », ce service est fait pour vous.

Besoin de faire réaliser ou vérifier cette analyse ? Un biostatisticien titulaire d’un doctorat examine votre protocole d’étude, effectue l’analyse et rédige la section consacrée aux méthodes statistiques de votre manuscrit.
FAQ sur l'indice Youden
Qu'est-ce que l'indice de Youden en termes simples ?
Il s'agit d'un nombre unique qui combine la capacité d'un test à détecter les personnes atteintes de la maladie (sensibilité) et sa capacité à identifier les personnes non atteintes (spécificité). J = sensibilité + spécificité − 1. Un test inutile obtient un score de 0 et un test parfait, un score de 1.
Quelle est la formule de l'indice de Youden ?
J = Se + Sp − 1, soit Se − (1 − Sp), ou encore le taux de vrais positifs moins le taux de faux positifs. Sur une courbe ROC, il s'agit de la distance verticale entre la diagonale de la courbe et le point correspondant à un seuil donné.
Quelle est la plage de valeurs maximale de l'indice de Youden ?
Pour un test unique, J varie de −1 à 1. Zéro signifie que le test n'est pas plus performant que le hasard, et les valeurs négatives indiquent une inversion des étiquettes du test. La valeur maximale de J sur l'ensemble des seuils d'une courbe ROC ne peut être inférieure à 0, car le point d'intersection (0, 0) correspond déjà à J = 0.
Quelle est une bonne valeur pour l'indice de Youden ?
Il n'existe pas de seuil officiel. De nombreuses études considèrent un J supérieur ou égal à 0.5 comme bon et supérieur ou égal à 0.75 comme élevé, mais il s'agit de conventions et non de normes. Il convient d'évaluer le J au regard du coût clinique des cas manqués et des fausses alertes, et de présenter un intervalle de confiance.
Comment trouver le seuil optimal avec l'indice de Youden ?
Calculez la sensibilité et la spécificité pour chaque seuil candidat, calculez J pour chacun et choisissez le seuil avec le J le plus élevé. Dans R, pROC effectue cette opération avec coords(roc_obj, “best”, best.method = “youden”).
La limite de Youden est-elle la même que le point le plus proche du coin supérieur gauche ?
En règle générale, non. Les deux critères peuvent sélectionner des seuils différents, et l'écart se creuse lorsque la courbe ROC est asymétrique (Perkins et Schisterman, 2006). Choisissez le critère avant d'analyser les données et indiquez-le dans votre méthodologie.
Quand ne dois-je pas utiliser l'indice de Youden ?
Il convient d'éviter de l'utiliser comme seul critère lorsqu'un cas manqué coûte beaucoup plus cher qu'une fausse alerte, comme dans le cadre du dépistage d'une maladie grave et traitable, ou inversement. J attribue la même importance aux deux types d'erreurs. Les approches pondérées par les coûts ou par le bénéfice net sont plus adaptées à ces situations.
La prévalence modifie-t-elle l'indice de Youden ?
Non. La sensibilité et la spécificité sont estimées au sein des groupes de personnes malades et non malades ; J ne dépend donc pas de la prévalence. La VPP et la VPN, en revanche, en dépendent, ce qui explique les différences importantes qu’elles peuvent présenter entre une consultation spécialisée et un programme de dépistage.
Comment dois-je indiquer un seuil basé sur l'indice de Youden dans un article ?
Indiquez le seuil de décision, la valeur J, la sensibilité et la spécificité avec leurs intervalles de confiance à 95 % (les intervalles bootstrap sont courants), la taille de l'échantillon dans chaque groupe et la méthode de détermination du seuil. Validez-le sur un échantillon distinct lorsque cela est possible. La norme STARD 2015 répertorie les éléments attendus par les évaluateurs.
Références
- Youden WJ. Indice d'évaluation des tests diagnostiques. Cancer. 1950;3(1):32-35. 10.1002/1097-0142(1950)3:1<32::AID-CNCR2820030106>3.0.CO;2-3
- Fluss R, Faraggi D, Reiser B. Estimation de l'indice de Youden et de son point de coupure associé. Biom J. 2005;47(4):458-472. 10.1002/bimj.200410135
- Perkins NJ, Schisterman EF. L'indice de Youden et le point de coupure optimal corrigé de l'erreur de mesure. Biom J. 2005;47(4):428-441. 10.1002/bimj.200410133
- Perkins NJ, Schisterman EF. L'incohérence des seuils « optimaux » obtenus à l'aide de deux critères basés sur la courbe caractéristique de fonctionnement du récepteur. Am J Epidemiol. 2006;163(7):670-675. 10.1093/aje/kwj063
- Ruopp MD, Perkins NJ, Whitcomb BW, Schisterman EF. Indice de Youden et seuil optimal estimés à partir d'observations affectées par une limite inférieure de détection. Biom J. 2008;50(3):419-430. 10.1002/bimj.200710415
- Nakas CT, Alonzo TA, Yiannoutsos CT. Précision et sélection du point de coupure dans les problèmes de classification à trois classes à l'aide d'une généralisation de l'indice de Youden. Stat Med. 2010;29(28):2946-2955. 10.1002/sim.4044
- Luo J, Xiong C. Indice de Youden et seuils associés pour trois groupes de diagnostic ordinaux. Calculs de simulation statistique commune. 2013;42(6):1213-1234. 10.1080/03610918.2012.661906
- Hajian-Tilaki K. Analyse de la courbe ROC (Receiver Operating Characteristic) pour l'évaluation des tests de diagnostic médical. Caspian J Intern Med. 2013;4(2):627-635. PMID 24009950
- Hassanzad M, Hajian-Tilaki K. Méthodes de détermination du seuil optimal des biomarqueurs diagnostiques avec application de données cliniques dans l'analyse ROC : une revue actualisée. BMC Med Res Methodol. 2024; 24. 10.1186/s12874-024-02198-2
- Robin X, Turck N, Hainard A, et al. pROC : un package open-source pour R et S+ permettant d'analyser et de comparer les courbes ROC. Bioinformatique BMC. 2011; 12: 77. 10.1186/1471-2105-12-77
- Bossuyt PM, Reitsma JB, Bruns DE, et al. STARD 2015 : une liste mise à jour des éléments essentiels pour la publication d'études sur la précision diagnostique. BMJ. 2015;351:h5527. 10.1136/bmj.h5527
- Wang P, Li Y, Wang M, et al. Comparaison des caractéristiques glycémiques dans la définition du diabète chez les personnes âgées chinoises rurales. PLoS ONE. 2024; 19 (1): e0296694. 10.1371 / journal.pone.0296694
- Mao B, Jiang H, Chen Y, et al. Réévaluation de l'échelle de chute de Morse dans les services d'obstétrique et de gynécologie et détermination des scores seuils optimaux pour une évaluation des risques améliorée : une étude rétrospective. PLoS ONE. 2024; 19 (9): e0305735. 10.1371 / journal.pone.0305735