
La statistique F est le premier chiffre qu'un relecteur recherche dans un article sur la randomisation mendélienne, et la règle qui y est associée, selon laquelle un instrument est adéquat dès que F dépasse 10, est citée dans presque toutes les sections méthodes rédigées depuis 2011. Editverse a soutenu plus de 1 100 manuscrits, et dans le cadre des travaux de registre et d'épidémiologie génétique que nos statisticiens gèrent, la statistique F est également le chiffre que les auteurs sont le plus souvent incapables d'expliquer lorsqu'un relecteur leur demande ce qu'elle leur apporte.
Nous l'avons donc mesuré. Nous avons simulé 135 000 études de randomisation mendélienne avec différents niveaux de précision des instruments et conditions de chevauchement des échantillons, exécuté l'ensemble du processus deux fois avec deux programmes développés indépendamment, puis comparé les résultats. Le résultat est différent de celui présenté dans la plupart des tutoriels. Un instrument faible ne donne généralement pas une réponse erronée. Il donne un intervalle tellement large qu'aucune réponse n'est possible, et ce, bien avant que l'estimation elle-même ne commence à dériver.
En mots simples
Imaginez un instrument génétique comme une légère incitation. Si cette incitation est forte, tous les porteurs de la variante y seront effectivement davantage exposés, et vous pourrez observer l'impact sur leur risque de développer la maladie. Si l'incitation est faible, la différence entre porteurs et non-porteurs est à peine perceptible, et tout effet sur la maladie sera masqué par le bruit de fond. La statistique F mesure l'intensité de cette incitation. Lorsqu'elle est faible, le résultat honnête de votre analyse se présente sous la forme d'une fourchette si large qu'elle englobe simultanément un effet néfaste important, une absence totale d'effet et un effet protecteur important. L'étude ne vous a pas menti ; elle n'a simplement rien mesuré.
D'où vient la règle F > 10 ?
Le seuil est emprunté à la génétique, et non dérivé de celle-ci. Il trouve son origine en économétrie, où Staiger et Stock (1997) ont étudié la méthode des doubles moindres carrés lorsque les instruments expliquent très peu l'exposition et ont proposé un F de première étape de 10 comme règle empirique pour déterminer le seuil de tolérance du biais résultant. Cette règle a ensuite été appliquée à l'épidémiologie génétique par Burgess et Thompson (2011) , qui ont examiné le biais lié à la faiblesse des instruments, notamment dans le cadre de la randomisation mendélienne. Ils ont montré que l'estimation est orientée dans le sens de l'association observationnelle biaisée, l'ampleur de cette orientation étant déterminée par la statistique F.
Deux points importants concernant cette lignée sont généralement omis. Premièrement, le résultat initial porte sur une méthode des moindres carrés à deux étapes avec plusieurs instruments, et le biais qu'il décrit augmente avec le nombre d'instruments inclus. Deuxièmement, le seuil était proposé comme une indication approximative, et non comme une valeur limite. Pierce, Ahsan et VanderWeele (2011) ont souligné que la force de l'instrument et la puissance statistique sont deux choses distinctes, et qu'un instrument peut largement dépasser le seuil de F = 10 tout en rendant une étude beaucoup trop imprécise pour répondre à la question pour laquelle elle a été conçue. Nos simulations montrent précisément l'écart possible entre ces deux notions. Si vous découvrez cette méthode, notre guide sur la randomisation mendélienne et sa mise en œuvre aborde les trois hypothèses relatives aux variables instrumentales que cet article suppose connues, et notre explication sur les variables instrumentales et la méthode des moindres carrés à deux étapes détaille l'estimateur lui-même.
Ce que nous avons simulé et comment vous pouvez le vérifier
Le dispositif expérimental est volontairement simple, car une conception simple permet de mettre en évidence le mode de défaillance plutôt que de le dissimuler dans un modèle complexe. Chaque étude simulée comprend 5 000 individus par échantillon. Une seule variante génétique, dont la fréquence allélique mineure est de 0.3, sert d'instrument. Un facteur de confusion non mesuré influence à la fois l'exposition et le résultat, ce qui explique pourquoi l'association observée est trompeuse. L'effet causal réel de l'exposition sur le résultat est de 0.20. En raison du facteur de confusion, une régression linéaire simple du résultat sur l'exposition donne environ 0.40 ; l'estimation observationnelle surestime donc la réalité d'un facteur deux.
Nous avons ensuite fait varier la puissance de l'instrument afin que la statistique F de première étape se situe aux alentours de 3, 5, 10, 20, 50 et 100. À chaque niveau, nous avons réalisé 5 000 réplications dans deux conditions : l'une où les associations entre l'exposition et le résultat sont estimées chez les mêmes participants, et l'autre où elles proviennent de deux échantillons totalement distincts. Pour chaque réplication, nous avons enregistré l'estimation causale, son erreur standard calculée par la méthode delta, l'intervalle de confiance à 95 % obtenu et indiqué si cet intervalle contenait l'effet réel de 0.20.
Chaque figure ci-dessous a été produite deux fois. Une première implémentation, réalisée en R, utilise des opérations matricielles sur des blocs de réplicats. La seconde, en Python, calcule les mêmes quantités à partir de statistiques suffisantes, avec un générateur de nombres aléatoires différent et sans code partagé. Les deux implémentations ont été comparées avant toute programmation. Elles concordent pour chaque quantité stable à l'erreur de Monte Carlo près, et lorsqu'elles divergent, cette divergence constitue le résultat en soi. Toutes les figures que nous publions sont conformes à cette norme de comparaison entre les deux implémentations, comme dans notre analyse détaillée de l'impact des pondérations de l'enquête NHANES.
Ce que les instruments faibles font réellement à l'estimation
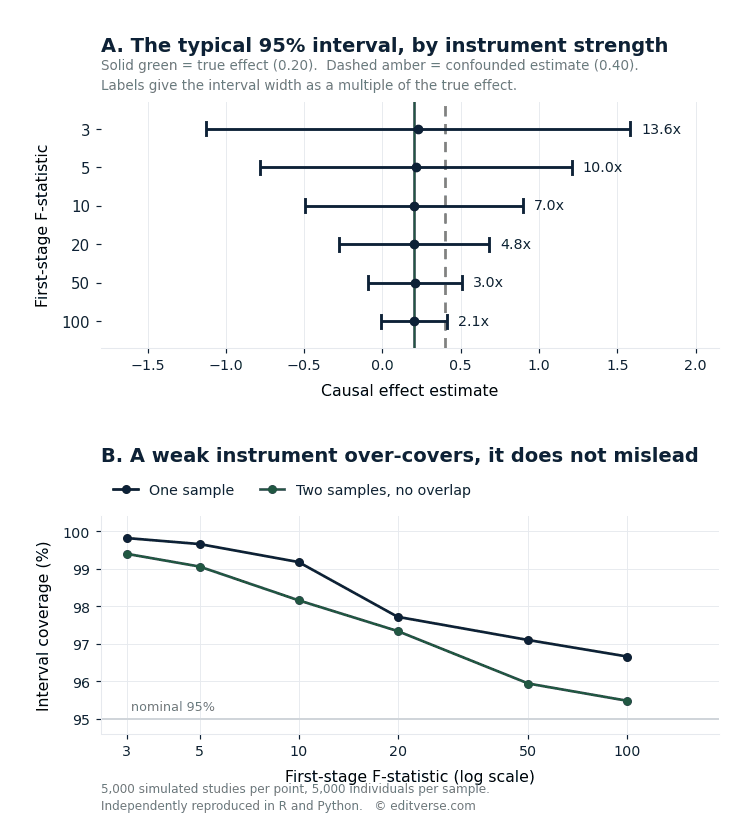
L'intervalle se réduit bien avant l'estimation ponctuelle.
Le graphique A résume l'argument dans son ensemble. Pour chaque niveau de puissance de l'instrument testé, l'estimation médiane se situe près de l'effet réel de 0.20 et très loin de la valeur observationnelle biaisée de 0.40. Ce qui change radicalement, c'est l'amplitude de l'intervalle de confiance.
| Premier stade F | Estimation médiane | largeur médiane de l'IC à 95 % | La largeur en tant que multiple de l'effet réel | Territoire desservi |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8 % |
| 5 | 0.213 | 1.99 | 10.0x | 99.7 % |
| 10 | 0.200 | 1.39 | 7.0x | 99.2 % |
| 20 | 0.202 | 0.96 | 4.8x | 97.7 % |
| 50 | 0.205 | 0.60 | 3.0x | 97.1 % |
| 100 | 0.199 | 0.42 | 2.1x | 96.7 % |
Lisez la quatrième colonne et la signification pratique deviendra claire. Pour un F de 3, l'intervalle de confiance typique est 13.6 fois plus large que l'effet que l'étude cherche à détecter. Cet intervalle s'étend approximativement de -1.1 à +1.6. Il contient un effet protecteur important, une absence d'effet et un effet néfaste important. Rien dans les données ne permet de les distinguer. Pour un F de 100, l'intervalle est encore environ deux fois plus large que l'effet réel, ce qui suffit à établir une direction, mais guère plus.
La largeur de l'intervalle se réduit presque à l'inverse de la racine carrée de F. En multipliant chaque largeur par la racine carrée de son F, on obtient respectivement 4.63, 4.51, 4.37, 4.30, 4.25 et 4.24 pour les six niveaux. Ces valeurs sont quasi constantes et n'augmentent que pour les instruments les moins performants, là où l'erreur standard de la méthode delta commence à se dégrader. Concrètement, doubler la précision exige de quadrupler approximativement la puissance des instruments, ce qui, dans le cadre d'un plan d'expérience à deux échantillons, implique une étude d'association pangénomique (GWAS) d'exposition beaucoup plus vaste, plutôt qu'un seuil de p-valeur légèrement moins strict.
L'intervalle se chevauche, ce qui n'est pas la même chose qu'être faux.
Le graphique B présente la couverture : la proportion d’études répliquées dont l’intervalle à 95 % contenait l’effet réel. Si la méthode fonctionnait exactement comme annoncé, cette proportion serait de 95 % partout. Or, ce n’est pas le cas. Pour un F de 3, l’intervalle à un échantillon couvrait la valeur réelle dans 99.8 % des cas, ce pourcentage tombant à 96.7 % pour un F de 100. Les intervalles à deux échantillons sont légèrement inférieurs à ceux à un échantillon et atteignent 95.5 % pour le F le plus élevé.
La sur-couverture est le signe d'une erreur standard trop importante par rapport aux informations disponibles. Cela signifie qu'un instrument peu performant produit des intervalles conservateurs plutôt que trompeurs. Cette distinction est cruciale pour quiconque interprète un résultat nul publié. Un article sur la randomisation mendélienne concluant à l'absence d'effet sur la base d'un instrument peu performant n'a pas démontré l'absence d'effet, mais simplement que son protocole n'aurait pas permis d'en détecter un. Ce sont deux affirmations différentes, et les relecteurs demandent de plus en plus aux auteurs de préciser laquelle ils avancent.
La moyenne n'existe pas, et deux moteurs l'ont prouvé.
Une quantité a donné des résultats différents entre nos deux implémentations, et cette divergence est instructive. Pour un F de 3, le moteur R a fourni une estimation moyenne de 0.64 dans la condition à un échantillon. Le moteur Python, exécutant le même modèle, a fourni 0.24. Dans la condition à deux échantillons, les deux moteurs ont fourni respectivement 0.77 et 1.01. Toutes les autres quantités présentées dans cet article concordaient à l'erreur de Monte Carlo près, contrairement à celle-ci.
Il ne s'agit pas d'un bug dans l'un ou l'autre programme. L'estimation causale est ici un rapport de deux coefficients de régression, et lorsque le dénominateur peut être arbitrairement proche de zéro, ce rapport n'a pas d'espérance finie. La moyenne d'un tel échantillon ne converge pas, quel que soit le nombre de réplications effectuées ; par conséquent, deux programmes honnêtes divergeront indéfiniment à son sujet. La médiane, l'amplitude de l'intervalle et la couverture convergent normalement, ce qui explique pourquoi le tableau ci-dessus les présente et non la moyenne. Tout résultat de randomisation mendélienne qui s'appuie sur une moyenne des variantes sans tenir compte des queues de distribution épaisses repose sur le même principe d'instabilité, ce qui explique notamment pourquoi les estimateurs robustes à la pléiotropie présentés dans notre guide principal sur la randomisation mendélienne utilisent les médianes et les modes plutôt que les moyennes simples. Notre simulation complémentaire, qui illustre les limites de protection de chacun de ces quatre estimateurs, les teste dans six régimes de pléiotropie et identifie un régime où les quatre estimateurs concordent et un autre où les quatre estimateurs sont erronés.
Le chevauchement des échantillons ne se produit que lorsque l'instrument est faible.
La randomisation mendélienne à deux échantillons suppose que les études d'association pangénomique (GWAS) portant sur l'exposition et sur le résultat ont été réalisées chez des individus différents. En pratique, cette hypothèse est constamment violée, car une poignée de très grandes biobanques contribuent à une part importante des GWAS publiées, et les mêmes participants apparaissent dans les deux groupes d'analyse sans que les auteurs ne s'en rendent nécessairement compte. Burgess, Davies et Thompson (2016) ont établi que ce chevauchement tend à ramener l'estimation à deux échantillons vers le comportement observé pour un seul échantillon, c'est-à-dire vers une association observationnelle biaisée.
Nous avons testé directement l'ampleur de cet effet, en faisant varier le chevauchement de 0 % à 100 % pour trois niveaux d'intensité d'instrument.
| Chevauchement des participants | Biais médian à F = 3 | Biais médian à F = 5 | Biais médian à F = 10 |
|---|---|---|---|
| 0% | - 0.004 | - 0.011 | - 0.003 |
| 25 % | - 0.016 | - 0.008 | - 0.010 |
| 50 % | - 0.003 | - 0.012 | 0.000 |
| 75 % | +0.015 | - 0.005 | +0.011 |
| 100 % | +0.026 | +0.005 | +0.005 |
Pour un F de 3 avec un chevauchement complet, l'estimation médiane est tirée vers le haut d'environ 0.026 sur un effet réel de 0.20, soit un décalage d'environ 13 % vers la valeur biaisée, et les deux moteurs l'ont reproduit indépendamment. Pour un F de 10, il ne reste plus aucun schéma ordonné. Les deux problèmes se multiplient plutôt qu'ils ne s'additionnent : le chevauchement transforme un instrument faible en un instrument biaisé, mais sur un instrument fort, il est à peine perceptible.
L'implication en matière de compte rendu est directe : affirmer que deux études d'association pangénomique (GWAS) se chevauchent est insuffisant, tout comme affirmer le contraire. Un examinateur a besoin du taux de chevauchement ainsi que de la puissance de l'instrument, car le premier n'est interprétable qu'à la lumière du second. Lorsque les deux sont défavorables, la réponse honnête n'est pas une simple réserve dans la discussion, mais la mention d'une autre source de données.
Pourquoi la règle F > 10 reste plus importante que nos résultats ne le laissent penser.
Nos simulations utilisent un seul instrument, et il serait erroné d'en conclure que les instruments faibles sont inoffensifs. Le cas que nous avons testé est le plus favorable qui soit. Le biais décrit par Burgess et Thompson (2011) croît avec le nombre d'instruments ; ainsi, un dispositif comportant 200 variants marginalement significatifs est exposé à un phénomène que notre configuration à un seul variant ne peut pas mettre en évidence. C'est précisément la situation créée par l'abaissement du seuil de signification à l'échelle du génome de 5 × 10⁻⁸ à 1 × 10⁻⁵ afin d'obtenir davantage d'instruments, une pratique désormais courante pour les expositions avec une architecture génétique clairsemée.
Deux points supplémentaires méritent une attention particulière. Dans le cadre d'une randomisation mendélienne multivariée, la quantité pertinente n'est pas la statistique F classique, mais la statistique F conditionnelle introduite par Sanderson et ses collègues (2019) . Cette dernière mesure si les instruments permettent de distinguer les expositions les unes des autres, plutôt que de simplement prédire chacune isolément. Or, les articles rapportent fréquemment la mauvaise statistique à ce sujet. Par ailleurs, lorsque les instruments sont mesurés avec une marge d'erreur, l'estimation MR-Egger devient peu fiable ; le diagnostic de cette situation repose alors sur la statistique I²-GX de Bowden et ses collègues (2016) . Une faible valeur signifie que l'analyse de sensibilité sur laquelle vous vous appuyiez pour vous prémunir contre la pléiotropie n'est elle-même pas fiable.
Ce que les évaluateurs trouvent réellement dans les articles de RM publiés
L'écart entre la norme décrite ci-dessus et la norme appliquée en pratique a été mesuré. Rosas-Chavez et Merriman (2025) ont évalué systématiquement 86 études de randomisation mendélienne à deux échantillons portant sur l'hyperuricémie et la goutte, publiées entre 2016 et 2024, en attribuant à chacune un score selon une grille d'évaluation structurée. Voici leurs résultats :
- 66 % L'hypothèse de pertinence était satisfaite, c'est-à-dire une signification à l'échelle du génome ou une statistique F rapportée supérieure à 10. Un article sur trois ne l'était pas.
- 51 % ils ont utilisé des ensembles de données sans chevauchement de participants, ce qui, de leur propre aveu, expose environ la moitié de la littérature à l'interaction décrite ci-dessus.
- 59 % a abordé la question de la puissance statistique.
- 17 % satisfait aux trois hypothèses fondamentales relatives aux variables instrumentales.
- 14 % ont effectué une analyse de réplication.
- 11 % des articles publiés après 2021 étaient conformes aux Guide de rédaction de rapports STROBE-MR.
Les scores de qualité globale de cette revue variaient de 0 à 19 sur une échelle de 21, avec une moyenne de 9.1. Bien que cela concerne un seul domaine pathologique et que d'autres domaines puissent différer, il s'agit de l'audit le plus systématique de la qualité des rapports d'études randomisées contrôlées actuellement disponible, et ses conclusions correspondent à celles que nos statisticiens observent dans les manuscrits soumis. Lorsque cinq articles sur six ne satisfont pas aux hypothèses sur lesquelles reposent leurs conclusions, les éditeurs réagissent en relevant les exigences pour tous, ce qui explique pourquoi l'exhaustivité méthodologique est devenue un critère de sélection plutôt qu'une simple question de style. Notre guide de rédaction STROBE pour les études observationnelles reprend les recommandations initiales que STROBE-MR développe.
Comment signaler la force de l'instrument pour qu'un examinateur puisse la vérifier ?
Le fait de ne communiquer qu'un seul chiffre et de passer à autre chose génère la requête. Voici ce que nos statisticiens incluent dans la section « Méthodes », et ce qu'un examinateur méthodologique recherche lorsqu'il ouvre une telle section.
- Statistiques F par instrument et combinées. Signalez les deux. Un F combiné de 40, construit à partir de trente variantes ayant chacune un F proche de 1.3, est un objet différent d'un F combiné de 40, construit à partir de trois variantes robustes ; seul le tableau par variante permet de déterminer lequel vous possédez.
- La proportion de variance d'exposition expliquée. Indiquez le coefficient de détermination R² pour l'instrumentation. Il détermine la précision et permet au lecteur de juger si l'intervalle de confiance était suffisamment étroit pour être exploitable.
- Le seuil de sélection, indiqué avant les résultats. Si vous avez relâché les critères en dessous du seuil de signification à l'échelle du génome, indiquez-le, expliquez pourquoi et présentez l'analyse aux deux seuils afin que le lecteur puisse voir si le résultat dépend du relâchement des critères.
- Paramètres d'agglomération et panneau de référence. Le seuil de déséquilibre de liaison, la taille de la fenêtre et le panel utilisé sont des facteurs importants. Les instruments non indépendants amplifient la force apparente.
- La fraction de chevauchement, avec sa source. Indiquez les cohortes ayant contribué à chaque GWAS et estimez la proportion commune. Si vous ne pouvez pas l'estimer, précisez-le et considérez l'analyse comme une étude à un seul échantillon pour l'interprétation.
- Une déclaration de précision, et pas seulement une déclaration de signification. Indiquez la taille d'effet minimale que votre plan d'étude aurait pu détecter. Un résultat nul sans cette information est ininterprétable, comme le montrent les résultats de couverture ci-dessus.
- La statistique F conditionnelle pour toute analyse multivariée. Le F ordinaire ne répond pas à la question posée par la randomisation mendélienne multivariable.
Trois erreurs à l'origine de cet échec
On considère un F supérieur à 10 comme un seuil de réussite plutôt que comme un seuil minimal. Dépasser 10 ne garantit pas la validité d'une étude. Dans notre cas, un F de 10 laisse un intervalle sept fois plus large que l'effet mesuré. Le seuil marque la limite en dessous de laquelle un biais devient problématique, et non la limite au-dessus de laquelle la précision est suffisante.
Assouplir le seuil de valeur p pour obtenir davantage d'instruments est la méthode la plus courante pour se retrouver avec des instruments peu significatifs, et elle produit l'effet inverse de celui recherché. Elle ajoute des variants peu significatifs tout en augmentant le nombre d'instruments, ce qui correspond à la combinaison contre laquelle le résultat classique sur le biais met en garde. Si une exposition présente trop peu de variants significatifs à l'échelle du génome, cela indique s'il convient de poursuivre l'étude, et non un obstacle à contourner.
Un résultat nul est interprété comme une preuve d'absence d'effet. Avec un instrument faible, l'intervalle de confiance englobe la vérité dans 99.8 % des cas, précisément parce qu'il couvre la quasi-totalité des valeurs possibles. Un résultat nul issu d'une étude sous-dimensionnée est une observation relative à la conception même de l'étude, et les évaluateurs qui en sont conscients le mentionneront. Notre guide des niveaux de preuve en recherche clinique explique comment un résultat de randomisation mendélienne bien menée se situe par rapport aux données probantes issues d'essais cliniques, et notre aperçu de l'inférence causale en épidémiologie aborde la famille plus large de conceptions auxquelles celle-ci appartient. Un résultat nul issu d'une étude avec un instrument faible est également ininterprétable en soi, sujet traité dans notre article complémentaire expliquant pourquoi les articles sur la randomisation mendélienne sont rejetés d'emblée.
Soutien professionnel pour une étude de randomisation mendélienne
La robustesse des instruments est la première chose que nos statisticiens vérifient, et ce, avant toute analyse, et non après coup. Si une exposition présente trop peu de variants significatifs à l'échelle du génome, ou si la seule étude d'association pangénomique (GWAS) disponible sur le résultat partage un échantillon important avec la GWAS sur l'exposition, nous le signalons d'emblée. L'alternative serait de produire une analyse techniquement correcte, mais qu'aucun relecteur n'accepterait et qu'aucun lecteur ne pourrait utiliser.
Vérification de faisabilité
$450
Nombre d'instruments, statistiques F, chevauchement des échantillons et littérature existante vérifiés avant votre engagement. Vous pouvez poursuivre, modifier ou annuler le projet par écrit. Votre contribution sera intégralement déductible de toute étude que vous commanderez ultérieurement. Délai : 5 jours ouvrables.
MR à deux échantillons
$2,900
Étude complète à partir des statistiques sommaires publiques des GWAS : quatre estimateurs, MR-PRESSO, filtrage de Steiger, PheWAS instrumental, validation croisée leave-one-out, ainsi qu’une liste de contrôle STROBE-MR complétée et un code R exécutable. Délai : 15 jours ouvrables.
Conceptions étendues
À partir de $ 3,500
Analyse de randomisation mendélienne multivariée avec statistiques F conditionnelles, analyse de randomisation mendélienne de médiation, colocalisation, analyse de randomisation mendélienne médicament-cible et analyse de randomisation mendélienne non linéaire. Devis fixe et définition du périmètre du projet avant tout début de travaux.
Si vous hésitez encore entre une étude génétique et une analyse d'enquête, de registre du cancer ou de registre des traumatismes, notre guide sur la base de données de santé à utiliser pour votre étude précise ce que chaque source peut et ne peut pas répondre.
Outils de recherche gratuits d'Editverse
- GraphProCréez des graphiques prêts à être publiés (25 types disponibles) avec tests t, ANOVA, corrélation et valeurs p du chi carré intégrés. Gratuit, sans inscription.
- StatPro: des calculateurs statistiques gratuits et un outil de sélection de tests couvrant les comparaisons de groupes, les résultats catégoriels, l'analyse du temps jusqu'à l'événement et la précision diagnostique.
- Flowchart Pro: générez directement dans votre navigateur les diagrammes de flux PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE et ARRIVE.
Questions fréquemment posées sur la force des instruments dans la randomisation mendélienne
Un score F supérieur à 10 est-il suffisant pour la publication ?
C'est nécessaire, mais non suffisant. Nos simulations montrent qu'avec un F de 10, l'intervalle de confiance à 95 % reste sept fois plus large que l'effet estimé, ce qui suffit à établir que le plan d'étude n'est pas fortement biaisé, mais pas à répondre à la plupart des questions de recherche. Les évaluateurs exigent de plus en plus une indication de la précision, en plus de la statistique F, précisant le plus petit effet que l'étude aurait pu détecter.
Comment calculer la statistique F pour plusieurs instruments ?
Pour un ensemble de variables indépendantes, le F combiné peut être calculé à partir de la proportion totale de variance d'exposition expliquée et de la taille de l'échantillon, selon la formule F = (R²) × (n - k - 1) / (1 - R²) × k, où k représente le nombre d'instruments. Il est important de présenter également les statistiques F par variable, car une valeur combinée élevée peut être due soit à un petit nombre d'instruments forts, soit à un grand nombre d'instruments faibles ; seule la première hypothèse est rassurante.
Le biais lié à la faiblesse des instruments tend-il à favoriser l'hypothèse nulle ou l'estimation biaisée ?
Cela dépend du plan d'étude. Dans une analyse à un seul échantillon, le biais est en faveur de l'association observationnelle confondue. Dans une véritable analyse à deux échantillons sans chevauchement de participants, il est en faveur de l'hypothèse nulle. Un chevauchement partiel se situe entre les deux, c'est pourquoi la fraction de chevauchement doit être rapportée en même temps que la puissance de l'instrument et non à sa place.
Puis-je assouplir le seuil de valeur p pour obtenir davantage d'instruments ?
C'est possible, mais cela aggrave généralement le problème. Les variantes sélectionnées avec un seuil moins strict contribuent peu à la proportion de variance d'exposition expliquée tout en augmentant le nombre d'instruments, et le biais lié aux instruments faibles, dans le cas d'une suridentification, s'accroît avec le nombre d'instruments. Si vous assouplissez le seuil, présentez l'analyse pour les deux seuils afin que le lecteur puisse vérifier la validité du résultat.
Que se passe-t-il si mon exposition ne comporte qu'une poignée de variants significatifs à l'échelle du génome ?
Dans ce cas, la réponse honnête est peut-être qu'une étude de randomisation mendélienne n'est pas encore adaptée à cette exposition. L'intervalle sera suffisamment large pour inclure presque n'importe quelle valeur, et ni l'estimation ni un résultat nul ne seront interprétables. Il est préférable de trancher cette question avant l'analyse plutôt qu'après, ce à quoi sert une étude de faisabilité.
Comment savoir si deux études d'association pangénomique (GWAS) partagent des participants ?
Consultez la liste des cohortes contributrices dans chaque publication et ses annexes. Les biobanques de grande taille sont fréquemment utilisées dans les études d'association pangénomique (GWAS) publiées ; par conséquent, il convient de supposer par défaut l'existence d'un certain chevauchement entre deux études importantes portant sur un caractère commun, jusqu'à vérification. Lorsque ce chevauchement ne peut être quantifié, interprétez l'analyse comme une étude à un seul échantillon.
Conclusion
Sur 135 000 études de randomisation mendélienne simulées, reproduites indépendamment dans deux programmes, la statistique F s'est avérée régir un phénomène différent de celui pour lequel elle est habituellement utilisée. L'estimation médiane est restée proche de la valeur réelle pour chaque force d'instrument testée. Ce qui a varié d'un facteur six, c'est la largeur de l'intervalle autour de cette valeur, passant de 2.1 fois l'effet réel pour une valeur de F de 100 à 13.6 fois pour une valeur de F de 3. Le chevauchement des échantillons n'a produit un décalage détectable que lorsque l'instrument était déjà faible, et même dans ce cas, le décalage était minime compte tenu de l'imprécision environnante.
En pratique, la robustesse d'un instrument de mesure détermine si une étude peut répondre à une question, et seulement secondairement si elle présente un biais. Ce changement de perspective modifie le moment opportun pour effectuer la vérification. Une statistique F présentée dans un tableau de résultats décrit une étude déjà réalisée. Une statistique F calculée lors de la conception de l'étude détermine s'il convient de la mener. Étant donné que seulement 17 % des articles de l'audit publié le plus systématique satisfaisaient aux trois hypothèses fondamentales, et que seulement 14 % tentaient une réplication, ce sont les vérifications effectuées avant l'analyse qui permettent de distinguer un manuscrit accepté par l'évaluation bibliographique d'un manuscrit refusé.
Références
- Staiger D, Stock JH. Régression par variables instrumentales avec instruments faibles. Econometrica. 1997;65(3):557-586. doi: 10.2307 / 2171753
- Burgess S, Thompson SG. Éviter les biais liés à la faiblesse des instruments dans les études de randomisation mendélienne. International Journal of Epidemiology. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL, Ahsan H, VanderWeele TJ. Exigences de puissance et de force instrumentale pour les études de randomisation mendélienne utilisant de multiples variants génétiques. International Journal of Epidemiology. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S, Davies NM, Thompson SG. Biais dû au chevauchement des participants dans la randomisation mendélienne à deux échantillons. Épidémiologie génétique. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J, Del Greco MF, Minelli C, Davey Smith G, Sheehan NA, Thompson JR. Évaluation de la pertinence des données de synthèse pour les analyses de randomisation mendélienne à deux échantillons à l'aide de la régression MR-Egger : le rôle de la statistique I². International Journal of Epidemiology. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E, Davey Smith G, Windmeijer F, Bowden J. Un examen de la randomisation mendélienne multivariable dans les contextes de données de synthèse à un seul échantillon et à deux échantillons. International Journal of Epidemiology. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F, Merriman TR. Études de randomisation mendélienne : une mesure pour l'évaluation de la qualité. Goutte, urate et maladie de dépôt cristallin. 2025; 3 (2): 8. doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW, Richmond RC, Woolf BAR, et al. Renforcer la communication des études observationnelles en épidémiologie à l'aide de la randomisation mendélienne : la déclaration STROBE-MR. JAMA. 2021;326(16):1614-1621. doi: 10.1001/jama.2021.18236
Détails de la simulation : 5 000 individus par échantillon, un seul instrument biallélique à une fréquence allélique mineure de 0.3, un facteur de confusion non mesuré de 0.5 sur l’exposition et le résultat, un effet causal réel de 0.20 et une association observationnelle biaisée de 0.40. La force de l’instrument a été calibrée pour atteindre des valeurs F cibles de 3, 5, 10, 20, 50 et 100 au premier stade. 5 000 réplicats par cellule. Implémentation indépendante sous R 4.3.3 et Python 3 avec NumPy ; toutes les quantités rapportées concordent entre les moteurs à l’erreur de Monte Carlo près, à l’exception de la moyenne de l’estimateur du ratio, qui n’a pas d’espérance finie et est discutée précédemment.