
El estadístico F es el número que un revisor busca primero en un artículo sobre aleatorización mendeliana, y la regla asociada, que establece que un instrumento es adecuado una vez que F supera 10, se cita en casi todas las secciones de métodos escritas desde 2011. Editverse ha respaldado más de 1,100 manuscritos, y en el trabajo de registro y epidemiología genética que manejan nuestros estadísticos, el estadístico F es también el número que los autores con mayor frecuencia no pueden explicar cuando un revisor les pregunta qué beneficios les aporta.
Así que lo medimos. Simulamos 135 000 estudios de aleatorización mendeliana con diferentes niveles de robustez de los instrumentos y condiciones de solapamiento de muestras, ejecutamos el proceso completo dos veces en dos programas escritos de forma independiente y comparamos los resultados. El resultado no es el que sugieren la mayoría de los tutoriales. Un instrumento débil no suele dar una respuesta incorrecta. Da un intervalo tan amplio que ninguna respuesta es posible, y lo hace mucho antes de que la estimación misma empiece a desviarse.
En palabras simples
Piensa en un instrumento genético como un pequeño empujón. Si el empujón es fuerte, todos los portadores de la variante realmente terminan con una mayor exposición, y puedes ver qué sucede con su riesgo de enfermedad. Si el empujón es débil, la diferencia entre portadores y no portadores es mínima, por lo que cualquier efecto sobre la enfermedad queda enmascarado por el ruido. El estadístico F mide la fuerza del empujón. Cuando es pequeño, la respuesta honesta que arroja tu análisis es un rango tan amplio que incluye un gran efecto perjudicial, ningún efecto en absoluto y un gran efecto protector, todo a la vez. El estudio no te ha mentido. Simplemente no ha medido nada.
De dónde surgió la regla de F mayor que 10
El umbral es un concepto tomado prestado, no derivado de la genética. Su origen se encuentra en la econometría, donde Staiger y Stock (1997) estudiaron los mínimos cuadrados en dos etapas cuando los instrumentos explican muy poco de la exposición y propusieron un valor F de 10 en la primera etapa como regla general para determinar cuándo el sesgo resultante es tolerable. Esta regla se incorporó a la epidemiología genética a través de Burgess y Thompson (2011) , quienes examinaron el sesgo de instrumentos débiles específicamente en la aleatorización mendeliana y demostraron que la estimación se ve afectada en la dirección de la asociación observacional confusa, y que la magnitud de esta desviación está determinada por el estadístico F.
Dos aspectos de ese linaje son importantes y suelen pasarse por alto. Primero, el resultado original se refiere a mínimos cuadrados en dos etapas con varios instrumentos, y el sesgo que describe aumenta con el número de instrumentos incluidos. Segundo, el umbral se ofreció como una guía aproximada, no como un criterio de aprobación. Pierce, Ahsan y VanderWeele (2011) señalaron que la fuerza del instrumento y la potencia estadística son cuestiones distintas, y que un instrumento puede superar fácilmente F igual a 10, pero dejar un estudio demasiado impreciso para responder a la pregunta para la que fue diseñado. Nuestras simulaciones muestran con precisión cuán distantes pueden estar estas dos cosas. Si no está familiarizado con el diseño en sí, nuestra guía sobre qué es la aleatorización mendeliana y cómo llevarla a cabo abarca los tres supuestos de variables instrumentales que este artículo presupone que usted ya conoce, y nuestra explicación sobre variables instrumentales y mínimos cuadrados en dos etapas aborda el estimador en sí.
Qué simulamos y cómo puedes comprobarlo.
La configuración es deliberadamente simple, ya que un diseño sencillo permite visualizar el modo de fallo en lugar de ocultarlo en un modelo complejo. Cada estudio simulado cuenta con 5,000 individuos por muestra. Una única variante genética con una frecuencia alélica menor de 0.3 actúa como variable instrumental. Un factor de confusión no medido influye tanto en la exposición como en el resultado, lo que provoca que la asociación observacional sea engañosa. El verdadero efecto causal de la exposición sobre el resultado es de 0.20. Debido al factor de confusión, una regresión ordinaria del resultado sobre la exposición arroja aproximadamente 0.40, por lo que la estimación observacional sobreestima la realidad en un factor de dos.
A continuación, variamos la fuerza del instrumento de modo que el estadístico F de la primera etapa se situara cerca de 3, 5, 10, 20, 50 y 100, y en cada nivel realizamos 5,000 estudios replicados bajo dos condiciones: una en la que las asociaciones de exposición y resultado se estiman en los mismos participantes, y otra en la que provienen de dos muestras completamente separadas. Para cada réplica, registramos la estimación causal, su error estándar mediante el método delta, el intervalo de confianza del 95 % resultante y si dicho intervalo contenía el verdadero efecto de 0.20.
Cada figura que aparece a continuación se generó dos veces. Una implementación está en R y utiliza operaciones matriciales sobre bloques de réplicas. La segunda está en Python y calcula las mismas cantidades a partir de estadísticas suficientes con un generador de números aleatorios diferente y sin código compartido. Los dos motores se compararon antes de escribir nada. Coinciden en todas las cantidades estables dentro del error de Monte Carlo, y cuando discrepan, la discrepancia en sí misma constituye el hallazgo. Sometemos cada figura de datos que publicamos a este estándar de dos motores, como en nuestro análisis de lo que los ponderadores de la encuesta NHANES corrigen y no corrigen.
Qué efectos tienen realmente los instrumentos débiles en la estimación
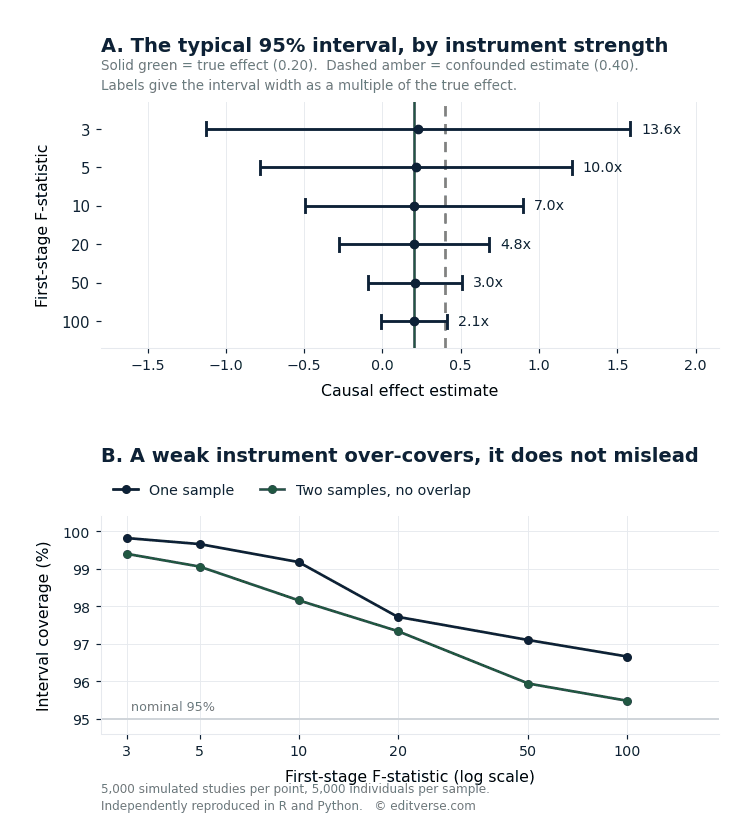
El intervalo se colapsa mucho antes que la estimación puntual.
El panel A resume todo el argumento en una sola imagen. En cada nivel de potencia del instrumento que probamos, la estimación mediana se sitúa cerca del efecto real de 0.20 y muy lejos del valor observacional sesgado de 0.40. Lo que cambia drásticamente es la amplitud del intervalo a su alrededor.
| Primera etapa F | Estimación mediana | Ancho del intervalo de confianza del 95% (mediana) | Ancho como múltiplo del efecto real | Global |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8% |
| 5 | 0.213 | 1.99 | 10.0x | 99.7% |
| 10 | 0.200 | 1.39 | 7.0x | 99.2% |
| 20 | 0.202 | 0.96 | 4.8x | 97.7% |
| 50 | 0.205 | 0.60 | 3.0x | 97.1% |
| 100 | 0.199 | 0.42 | 2.1x | 96.7% |
Lea la cuarta columna y el significado práctico quedará claro. Con un valor F de 3, el intervalo de confianza típico es 13.6 veces más amplio que el efecto que el estudio intenta detectar. Dicho intervalo se extiende aproximadamente desde -1.1 hasta +1.6. Contiene un gran efecto protector, ningún efecto y un gran efecto perjudicial. Nada en los datos permite distinguirlos. Con un valor F de 100, el intervalo sigue siendo aproximadamente el doble del tamaño del efecto real, lo cual es suficiente para establecer una dirección, pero no mucho más.
El ancho del intervalo se reduce a un valor cercano a la raíz cuadrada inversa de F. Al multiplicar cada ancho por la raíz cuadrada de su F, se obtienen 4.63, 4.51, 4.37, 4.30, 4.25 y 4.24 en los seis niveles, valores que son prácticamente constantes y que solo aumentan en los instrumentos más débiles, donde el error estándar del método delta comienza a degradarse. En la práctica, esto implica que duplicar la precisión requiere aproximadamente cuadruplicar la potencia del instrumento, lo que en un diseño de dos muestras significa una exposición GWAS mucho mayor en lugar de un umbral de valor p ligeramente más relajado.
El intervalo cubre en exceso, lo cual no es lo mismo que estar equivocado.
El panel B muestra la cobertura: la proporción de estudios replicados cuyo intervalo del 95 % contenía el efecto real. Si el método funcionara exactamente como se anuncia, este valor sería del 95 % en todos los casos. Sin embargo, no es así. Con un F de 3, el intervalo de una muestra cubrió la verdad el 99.8 % de las veces, disminuyendo al 96.7 % con un F de 100. Los intervalos de dos muestras se sitúan ligeramente por debajo de los de una muestra y alcanzan el 95.5 % en el nivel de significancia más alto.
La sobrecobertura es característica de un error estándar demasiado grande para la información disponible. Significa que un instrumento débil produce intervalos conservadores en lugar de engañosos. Esta es una distinción realmente importante para cualquiera que interprete un resultado nulo publicado. Un artículo sobre aleatorización mendeliana que informa que no existe efecto basándose en un instrumento débil no ha demostrado que no exista ningún efecto. Ha demostrado que su diseño no podría haberlo detectado. Son afirmaciones diferentes, y los revisores piden cada vez más a los autores que aclaren cuál de ellas están planteando.
La media no existe, y dos motores lo demostraron.
Una magnitud no coincidió entre nuestras dos implementaciones, y esta discrepancia resulta instructiva. Con un F de 3, el motor R arrojó una estimación media de 0.64 en la condición de una muestra. El motor Python, ejecutando el mismo diseño, arrojó 0.24. En la condición de dos muestras, ambos motores arrojaron 0.77 y 1.01. Todas las demás magnitudes mencionadas en este artículo coincidieron dentro del margen de error de Monte Carlo, mientras que estas no.
Eso no es un error en ninguno de los programas. La estimación causal aquí es una razón de dos coeficientes de regresión, y cuando el denominador puede caer arbitrariamente cerca de cero, la razón no tiene una esperanza finita. La media muestral de dicha cantidad no converge independientemente de cuántas réplicas se ejecuten, por lo que dos programas honestos discreparán sobre ella indefinidamente. La mediana, la amplitud del intervalo y la cobertura convergen normalmente, razón por la cual la tabla anterior informa esos valores y no la media. Cualquier resultado de aleatorización mendeliana que se base en un promedio entre variantes sin reconocer las colas pesadas se encuentra en el mismo terreno inestable, razón por la cual los estimadores robustos a la pleiotropía que se discuten en nuestra guía principal de aleatorización mendeliana usan medianas y modas en lugar de medias simples. Nuestra simulación complementaria sobre de qué protege realmente cada uno de esos cuatro estimadores los prueba en seis regímenes de pleiotropía y encuentra uno donde los cuatro coinciden y los cuatro se equivocan.
La superposición de muestras solo se produce cuando el instrumento es débil.
La aleatorización mendeliana de dos muestras presupone que los estudios de asociación del genoma completo (GWAS) de exposición y de resultado se realizaron en personas diferentes. En la práctica, esta suposición se incumple constantemente, ya que un pequeño número de biobancos muy grandes contribuyen a una gran parte de los GWAS publicados, y los mismos participantes aparecen en ambos lados de un análisis sin que los autores necesariamente se den cuenta. Burgess, Davies y Thompson (2016) demostraron que la superposición desplaza la estimación de dos muestras hacia el comportamiento de una sola muestra, es decir, hacia la asociación observacional confusa.
Evaluamos directamente la magnitud de ese efecto, variando la superposición del 0% al 100% en tres niveles de intensidad del instrumento.
| Superposición de participantes | Sesgo mediano en F = 3 | Sesgo mediano en F = 5 | Sesgo mediano en F = 10 |
|---|---|---|---|
| 0% | -0.004 | -0.011 | -0.003 |
| 25% | -0.016 | -0.008 | -0.010 |
| 50% | -0.003 | -0.012 | 0.000 |
| 75% | +0.015 | -0.005 | +0.011 |
| 100% | +0.026 | +0.005 | +0.005 |
Con un F de 3 y una superposición completa, la estimación mediana se desplaza hacia arriba en aproximadamente 0.026 sobre un efecto real de 0.20, lo que representa un cambio de aproximadamente el 13 % hacia el valor sesgado, y ambos motores lo reprodujeron de forma independiente. Con un F de 10, no queda ningún patrón ordenado. Los dos problemas se multiplican en lugar de sumarse: la superposición convierte un instrumento débil en uno sesgado, pero en un instrumento fuerte apenas se nota.
La implicación en la presentación de informes es directa. No basta con afirmar que dos estudios GWAS se superponen, ni tampoco con negarlo. Lo que necesita un revisor es la fracción de superposición junto con la solidez del instrumento, ya que la primera solo puede interpretarse a la luz de la segunda. Cuando ambas son desfavorables, la respuesta honesta no es una advertencia en la discusión, sino una fuente de datos diferente.
Por qué la regla de F mayor que 10 sigue siendo más importante de lo que sugieren nuestros resultados.
Nuestras simulaciones utilizan un único instrumento, y sería un grave error concluir que los instrumentos débiles son inofensivos. El caso que acabamos de identificar y que analizamos es el más favorable. El sesgo descrito por Burgess y Thompson (2011) aumenta con el número de instrumentos, por lo que un diseño con 200 variantes marginalmente significativas se ve expuesto a un problema que nuestra configuración de una sola variante no puede detectar. Esta es precisamente la situación que se genera al reducir el umbral de significación genómica de 5 x 10⁻⁸ a 1 x 10⁻⁵ para obtener más instrumentos, una práctica común en estudios con arquitectura genética dispersa.
Dos puntos adicionales son esenciales en cualquier análisis honesto. En la aleatorización mendeliana multivariable, la magnitud relevante no es el estadístico F ordinario, sino el estadístico F condicional introducido por Sanderson y colaboradores (2019) , que mide si los instrumentos pueden distinguir las exposiciones entre sí en lugar de simplemente predecirlas de forma aislada. Los artículos suelen reportar un estadístico erróneo en este caso. Por otra parte, cuando los instrumentos se miden con error, la estimación MR-Egger se vuelve poco fiable, y el diagnóstico para ello es el estadístico I-cuadrado-GX de Bowden y colaboradores (2016) . Un valor bajo significa que el análisis de sensibilidad en el que se basaba para evitar la pleiotropía no es fiable.
Lo que los revisores realmente encuentran en los artículos de investigación de mercado publicados
La brecha entre el estándar descrito anteriormente y el estándar aplicado en la práctica ya se ha medido. Rosas-Chavez y Merriman (2025) evaluaron sistemáticamente 86 estudios de aleatorización mendeliana de dos muestras sobre hiperuricemia y gota publicados entre 2016 y 2024, puntuando cada uno según una métrica de calidad estructurada. Sus hallazgos, en sus propias cifras:
- 66% Se cumplió el supuesto de relevancia, es decir, significancia a nivel genómico o un estadístico F informado superior a 10. Uno de cada tres artículos no lo hizo.
- 51% utilizaron conjuntos de datos sin superposición de participantes, lo que, según sus propios informes, deja aproximadamente la mitad de la literatura expuesta a la interacción descrita anteriormente.
- 59% Abordó en absoluto el poder estadístico.
- 17% Cumplía con los tres supuestos básicos de las variables instrumentales.
- 14% no realizó ningún análisis de replicación.
- 11% de los artículos publicados después de 2021 cumplieron con la Guía de informes STROBE-MR.
En esa revisión, las puntuaciones de calidad generales oscilaron entre 0 y 19 en una escala de 21, con una media de 9.1. Si bien se trata de un área de enfermedad específica y otros campos pueden diferir, se trata de la auditoría más sistemática disponible actualmente sobre la calidad de los informes de RM, y la dirección que apunta coincide con lo que nuestros propios estadísticos observan en los manuscritos enviados. Cuando cinco de cada seis artículos no cumplen con los supuestos en los que se basan sus conclusiones, los editores responden elevando el nivel de exigencia para todos, razón por la cual la exhaustividad metodológica se ha convertido en un criterio de selección más que en una cuestión de estilo. Nuestra guía para la presentación de informes STROBE para estudios observacionales abarca la guía principal que STROBE-MR amplía.
Cómo informar sobre la potencia del instrumento para que un revisor pueda comprobarla.
Informar un solo dato y seguir adelante es lo que genera la consulta. A continuación, se muestra lo que nuestros estadísticos incluyen en la sección de métodos, y lo que un revisor metodológico busca al abrir un documento de este tipo.
- Estadísticas F por instrumento y combinadas. Informe ambos. Un F combinado de 40 construido a partir de treinta variantes, cada una con un F cercano a 1.3, es un objeto diferente de un F combinado de 40 construido a partir de tres variantes fuertes, y solo la tabla por variante muestra cuál tiene.
- La proporción de la varianza de la exposición explicada. Indique el coeficiente de determinación (R²) del conjunto de instrumentos. Este valor determina la precisión y es la cantidad que un lector necesita para juzgar si el intervalo podría haber sido lo suficientemente estrecho como para resultar útil.
- El umbral de selección, indicado antes de los resultados. Si se ha relajado el umbral por debajo de la significación a nivel genómico, indíquelo, explique el motivo e informe del análisis en ambos umbrales para que el lector pueda comprobar si el resultado depende de la relajación.
- Los parámetros de agrupamiento y el panel de referencia. Umbral de desequilibrio de ligamiento, tamaño de la ventana y panel utilizado. Los instrumentos que no son independientes inflan la fuerza aparente.
- La fracción de solapamiento, con su origen. Identifique las cohortes que contribuyen a cada estudio de asociación del genoma completo (GWAS) y estime la proporción compartida. Si no puede estimarla, indíquelo y trate el análisis como un diseño de una sola muestra para su interpretación.
- Una declaración precisa, no solo una declaración de importancia. Informe el tamaño mínimo del efecto que su diseño podría haber detectado. Un resultado nulo sin este dato es imposible de interpretar, como demuestran los resultados de cobertura anteriores.
- El estadístico F condicional para cualquier análisis multivariable. La función F ordinaria no responde a la pregunta que plantea la aleatorización mendeliana multivariable.
Tres errores que producen este fracaso
Considerar un valor F mayor que 10 como un aprobado, no como un mínimo. Superar el 10 no garantiza la idoneidad del estudio. Según nuestros datos, un valor F de 10 aún deja un intervalo siete veces mayor que el efecto que se está midiendo. El umbral marca el punto por debajo del cual el sesgo se convierte en un problema, no el punto por encima del cual la precisión es suficiente.
Relajarse en el umbral del valor p para obtener más instrumentos. Esta es la vía más común para caer en la debilidad de los instrumentos, y produce el efecto contrario al que pretende el autor. Añade variantes que aportan poca información al tiempo que aumenta el número de instrumentos, que es la combinación sobre la que advierte el resultado clásico de sesgo. Si una exposición tiene muy pocas variantes significativas a nivel genómico, esa información indica si el estudio debe continuar, no que sea un obstáculo que deba sortearse.
Informar un resultado nulo como evidencia de ausencia de efecto. Con un instrumento débil, el intervalo abarca la verdad el 99.8% de las veces precisamente porque abarca casi todo. Un resultado nulo de un diseño con potencia insuficiente es una afirmación sobre el diseño, y los revisores que entienden esto lo dirán. Nuestra guía sobre los niveles de evidencia en la investigación clínica cubre dónde se sitúa un resultado de MR bien ejecutado en relación con la evidencia de los ensayos, y nuestra descripción general de la inferencia causal en epidemiología cubre la familia más amplia de diseños a la que pertenece este. Un resultado nulo de un diseño con instrumento débil también es ininterpretable por sí solo, que es el tema de nuestro artículo complementario sobre por qué los artículos de aleatorización mendeliana son rechazados directamente.
Apoyo profesional para un estudio de aleatorización mendeliana.
La robustez del instrumento es lo primero que verifican nuestros estadísticos, y se comprueba antes de encargar cualquier análisis, en lugar de informarlo posteriormente. Si una exposición tiene muy pocas variantes genómicas significativas independientes, o si el único estudio de asociación de genoma completo (GWAS) de resultados disponible comparte una muestra sustancial con el GWAS de exposición, lo indicamos desde el principio. La alternativa es producir un análisis técnicamente correcto que ningún revisor aceptará y ningún lector podrá utilizar.
Comprobación de viabilidad
$450
Se revisarán el número de instrumentos, las estadísticas F, la superposición de muestras y la bibliografía existente antes de comprometerse. Puede proceder, modificar o cancelar el proyecto por escrito. El importe se descontará íntegramente de cualquier estudio que encargue posteriormente. Plazo: 5 días hábiles.
RM de dos muestras
$2,900
Estudio completo a partir de estadísticas resumidas de GWAS públicas: cuatro estimadores, MR-PRESSO, filtrado de Steiger, instrumento PheWAS, validación cruzada dejando uno fuera, además de una lista de verificación STROBE-MR completa y código R ejecutable. 15 días hábiles.
Diseños ampliados
$3,500
Análisis de regresión multivariable con estadístico F condicional, análisis de regresión de mediación, colocalización, análisis de regresión fármaco-diana y análisis de regresión no lineal. Presupuesto fijo y alcance del proyecto por escrito antes de comenzar cualquier trabajo.
Si aún no se decide entre un diseño genético y un análisis de encuesta, registro de cáncer o registro de traumatismos, nuestra guía sobre qué base de datos de salud debe utilizar su estudio detalla qué puede y qué no puede responder cada fuente.
Herramientas de investigación gratuitas de Editverse
- GraphProCrea gráficos listos para publicar, de 25 tipos diferentes, con pruebas t, ANOVA, correlación y valores p de chi-cuadrado integrados. Gratis, sin necesidad de registrarse.
- EstatProCalculadoras estadísticas gratuitas y una herramienta de selección de pruebas que abarca comparaciones de grupos, resultados categóricos, análisis de tiempo hasta el evento y precisión diagnóstica.
- Diagrama de flujo Pro: genera diagramas de flujo PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE y ARRIVE directamente en tu navegador.
Preguntas frecuentes sobre la fuerza de los instrumentos en la aleatorización mendeliana
¿Un estadístico F superior a 10 es suficiente para la publicación?
Es necesario, pero no suficiente. Nuestras simulaciones muestran que, con un valor F de 10, el intervalo típico del 95 % sigue siendo siete veces mayor que el efecto estimado, lo cual basta para determinar que el diseño no está sesgado significativamente, pero no para responder a la mayoría de las preguntas de investigación. Los revisores esperan cada vez más una declaración de precisión junto con el estadístico F, que muestre el efecto mínimo que el estudio podría haber detectado.
¿Cómo calculo el estadístico F para múltiples instrumentos?
Para un conjunto de variantes independientes, el estadístico F combinado se puede calcular a partir de la proporción total de la varianza de exposición explicada y el tamaño de la muestra, utilizando la fórmula F igual a R cuadrado multiplicado por la cantidad n menos k menos 1, dividido por la cantidad 1 menos R cuadrado, multiplicado por k, donde k es el número de instrumentos. También se deben reportar los estadísticos F por variante, ya que un valor combinado alto puede deberse tanto a unos pocos instrumentos fuertes como a muchos débiles, y solo el primero resulta tranquilizador.
¿El sesgo por instrumentos débiles se inclina hacia la estimación nula o hacia la estimación confusa?
Depende del diseño. En un análisis de una sola muestra, el sesgo se inclina hacia la asociación observacional confusa. En un análisis genuino de dos muestras sin superposición de participantes, se inclina hacia el valor nulo. La superposición parcial se sitúa entre ambos extremos, por lo que la fracción de superposición debe informarse junto con la fuerza del instrumento, y no en lugar de ella.
¿Puedo relajar el umbral del valor p para obtener más instrumentos?
Es posible, pero generalmente empeora el problema en lugar de mejorarlo. Las variantes seleccionadas con un umbral menos estricto contribuyen poco a la proporción de la varianza de la exposición explicada, mientras que aumentan el número de instrumentos, y el sesgo por instrumentos débiles en el caso de sobreidentificación crece con el número de instrumentos. Si decide flexibilizar el umbral, presente el análisis con ambos umbrales para que el lector pueda comprobar si el resultado se mantiene.
¿Qué ocurre si mi exposición solo tiene un puñado de variantes significativas a nivel genómico?
Entonces, la respuesta honesta podría ser que un estudio de aleatorización mendeliana aún no es el diseño adecuado para esa exposición. El intervalo será lo suficientemente amplio como para incluir casi cualquier cosa, y ni la estimación ni un resultado nulo serán interpretables. Esta es una cuestión que conviene resolver antes del análisis, en lugar de después, que es para lo que sirve una evaluación de viabilidad.
¿Cómo puedo saber si dos estudios GWAS comparten participantes?
Lea las listas de cohortes participantes en cada publicación y su material complementario. Los biobancos de gran tamaño aparecen en una proporción considerable de los estudios de asociación del genoma completo (GWAS) publicados, por lo que, para cualquier par de estudios grandes sobre un rasgo común, se debe asumir que existe cierta superposición hasta que se verifique. Cuando no se pueda cuantificar la superposición, interprete el análisis como un diseño de una sola muestra.
Conclusión
En 135 000 estudios de aleatorización mendeliana simulados, reproducidos de forma independiente en dos programas, el estadístico F demostró tener un papel distinto al que se suele emplear. La estimación mediana se mantuvo cercana al valor real en todos los niveles de potencia del instrumento que probamos. Lo que cambió en un factor de seis fue la amplitud del intervalo a su alrededor, pasando de 2.1 veces el efecto real con un F de 100 a 13.6 veces con un F de 3. La superposición de muestras solo produjo un cambio detectable donde el instrumento ya era débil, e incluso entonces el cambio fue pequeño en comparación con la imprecisión que lo rodeaba.
En la práctica, la solidez de un instrumento se centra en si un estudio puede responder alguna pregunta, y solo secundariamente en el sesgo. Este replanteamiento cambia cuando se debe realizar la verificación. Un estadístico F que aparece en una tabla de resultados describe un estudio que ya se ha llevado a cabo. Un estadístico F calculado durante el diseño implica la decisión de realizarlo o no. Dado que solo el 17 % de los artículos en la auditoría publicada más sistemática cumplieron con los tres supuestos básicos, y solo el 14 % intentó la replicación, las verificaciones previas al análisis son las que distinguen un manuscrito que supera la revisión de uno que no.
Referencias
- Staiger D, Stock JH. Regresión con variables instrumentales con instrumentos débiles. Econometrica. 1997;65(3):557-586. doi: 10.2307 / 2171753
- Burgess S, Thompson SG. Cómo evitar el sesgo derivado de instrumentos débiles en estudios de aleatorización mendeliana. International Journal of Epidemiology. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL, Ahsan H, VanderWeele TJ. Requisitos de potencia y resistencia de los instrumentos para estudios de aleatorización mendeliana que utilizan múltiples variantes genéticas. International Journal of Epidemiology. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S, Davies NM, Thompson SG. Sesgo debido a la superposición de participantes en la aleatorización mendeliana de dos muestras. Epidemiología genética. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J, Del Greco MF, Minelli C, Davey Smith G, Sheehan NA, Thompson JR. Evaluación de la idoneidad de los datos resumidos para análisis de aleatorización mendeliana de dos muestras mediante regresión MR-Egger: el papel del estadístico I-cuadrado. International Journal of Epidemiology. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E, Davey Smith G, Windmeijer F, Bowden J. Un examen de la aleatorización mendeliana multivariable en entornos de datos resumidos de una sola muestra y de dos muestras. International Journal of Epidemiology. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F, Merriman TR. Estudios de aleatorización mendeliana: una métrica para la evaluación de la calidad. Gota, urato y enfermedad por depósito de cristales. 2025; 3 (2): 8. doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW, Richmond RC, Woolf BAR, et al. Fortalecimiento de la presentación de informes de estudios observacionales en epidemiología mediante aleatorización mendeliana: la declaración STROBE-MR. JAMA. 2021;326(16):1614-1621. doi: 10.1001 / pit.2021.18236
Detalles de la simulación: 5,000 individuos por muestra, instrumento bialélico único con una frecuencia alélica menor de 0.3, carga de factor de confusión no medida de 0.5 tanto en la exposición como en el resultado, efecto causal verdadero de 0.20, asociación observacional confundida de 0.40. La fuerza del instrumento se calibró para alcanzar valores F de primera etapa de 3, 5, 10, 20, 50 y 100. 5,000 réplicas por celda. Implementado independientemente en R 4.3.3 y Python 3 con NumPy; todas las cantidades reportadas coincidieron entre los motores dentro del error de Monte Carlo, excepto la media del estimador de razón, que no tiene una expectativa finita y se discute más arriba.