
Publicado
La lista de verificación STROBE-MR es el estándar de informes de 20 ítems para estudios que utilizan variantes genéticas como variables instrumentales para estimar efectos causales. Skrivankova y sus colegas la publicaron en 2021 como una declaración en JAMA y como un artículo de explicación y elaboración extenso en el BMJ [1] [2] . Los autores animan a las revistas a solicitar listas de verificación completas al momento de la presentación. Esta guía explica qué pregunta cada ítem, muestra dónde debe ir cada respuesta en un manuscrito y luego aplica cada ítem a un estudio real de aleatorización mendeliana de acceso abierto, fila por fila, con un puntero de sección y un veredicto para cada uno.
En palabras simples
STROBE-MR es una lista de 20 elementos de informe para artículos sobre aleatorización mendeliana. Solicita a los autores que indiquen cómo se seleccionaron las variantes genéticas, su fuerza, el origen de los dos conjuntos de datos, si las muestras se superponen, qué pruebas se utilizaron para verificar los supuestos y dónde se pueden encontrar los datos y el código. El lector debería poder evaluar el estudio sin tener que adivinar. Si algún elemento no aplica, indíquelo y explique el motivo.
Qué incluye la lista de verificación STROBE-MR
STROBE-MR es la contraparte de aleatorización mendeliana de la guía STROBE para estudios observacionales, que abordamos en nuestra guía STROBE . El documento explicativo repasa los 20 elementos con ejemplos publicados de informes transparentes, y los autores mantienen la lista de verificación como un documento vivo en un sitio web dedicado [1] . La escribieron porque existía poco consenso sobre cómo informar este diseño. El trabajo empírico que citan encontró que muchos informes no declaraban ni examinaban los supuestos de aleatorización mendeliana y proporcionaban muy pocos detalles sobre sus fuentes de datos [1].
Una auditoría de 2022 muestra la magnitud de la brecha. Woolf y sus colegas evaluaron 87 estudios de dos muestras que utilizaron la plataforma MR-Base y encontraron que la presentación de informes era generalmente deficiente, con un promedio del 53 % de los elementos informados por estudio. Solo el 44 % proporcionó suficiente detalle para juzgar el supuesto de relevancia, el 31 % para el supuesto de independencia y el 32 % para los supuestos de las pruebas de falsificación, mientras que el 89 % proporcionó suficiente para la restricción de exclusión [4] . Dicha auditoría utilizó su propia lista de verificación personalizada en lugar de STROBE-MR, por lo que los porcentajes muestran lo que tiende a faltar y no son una puntuación STROBE-MR.
El alcance es importante antes de abrir la lista de verificación. STROBE-MR es para informes de análisis de aleatorización mendeliana. Un ensayo aleatorizado sigue CONSORT, y CONSORT 2025 (30 ítems) reemplazó a CONSORT 2010, como explica nuestra guía CONSORT . Un estudio de cohorte o de casos y controles convencional sigue STROBE. Los autores de STROBE-MR también afirman que la lista de verificación no es una herramienta formal para evaluar la calidad del estudio, que no debe convertirse en una escala de calidad y que no es una guía para diseñar o realizar un estudio [1] . Tenemos esto en cuenta al calificar el ejemplo a continuación.
Elementos de la lista de verificación STROBE-MR por sección del manuscrito
La Tabla 1 parafrasea los 20 ítems de la lista de verificación STROBE-MR del documento explicativo [1] y los agrupa según la sección del manuscrito a la que corresponde la respuesta. Los subítems con letras se enumeran juntos. La columna de la derecha indica una forma común en que cada grupo puede presentar errores, según la redacción de los propios ítems.
| Artículo STROBE-MR | Secciones | Que reportar | Trampa común |
|---|---|---|---|
| 1 | Título y resumen | Mencione la aleatorización mendeliana como diseño cuando sea uno de los objetivos principales del estudio. | Un resumen que solo menciona el análisis genético, sin especificar el diseño. |
| 2 y 3 | Introducción | Explique la exposición, si es plausible un vínculo causal, por qué la aleatorización mendeliana se ajusta a la pregunta y exponga los objetivos con cualquier hipótesis causal preespecificada. | Una justificación que nunca explica por qué un ensayo o una cohorte no son suficientes. |
| 4 (a a e) | Métodos, fuentes de datos | Para cada fuente, indique el contexto, los participantes y el tamaño de la muestra, si se calculó la potencia estadística previamente, cómo se midieron y filtraron las variantes, cómo se evaluaron la exposición y el resultado, y la aprobación ética. Se recomienda incluir una tabla con las fuentes. | Un conjunto de datos denominado únicamente por su identificador, sin definición de población ni de caso. |
| 5 | Métodos, supuestos | Indique los tres supuestos básicos (relevancia, independencia, restricción de exclusión) para el análisis principal, además de cualquier supuesto adicional para los análisis de sensibilidad. | Enumerar las suposiciones sin indicar cómo se examinó cada una. |
| 6 (a a e) | Métodos, análisis principal | Describa las unidades y la escala, cómo se manejaron las variantes y los pesos, el estimador y las covariables, los datos faltantes y las pruebas múltiples. | Un efecto reportado por unidad de una escala no explicada. |
| 7 y 8 | Métodos, comprobaciones | Indique qué métodos o conocimientos previos respaldan las suposiciones y enumere todos los análisis de sensibilidad o adicionales. | Un estadístico F se considera prueba de que los instrumentos son válidos. |
| 9 (a y b) | Métodos, software y registro | Indique el nombre del software, los paquetes, las versiones y la configuración, y especifique si el protocolo se registró, cuándo y dónde. | Un paquete sin nombre de versión. |
| 10 (a a d) | Resultados, datos descriptivos | Informe el número de casos en cada etapa, las estadísticas descriptivas, la heterogeneidad en cualquier fuente meta-analizada y, para diseños de dos muestras, la similitud de las asociaciones entre variantes y exposición, así como la superposición entre las muestras. | Silencio sobre la superposición cuando ambos conjuntos de datos provienen de un mismo biobanco. |
| 11 (a a d) | Resultados y principales hallazgos | Presentar informes sobre las asociaciones entre variantes y exposición, así como entre variantes y resultados, estimaciones de aleatorización mendeliana en una escala interpretable, el riesgo absoluto cuando corresponda y gráficos. | Los logaritmos de las probabilidades no se convirtieron y no se incluyó un gráfico de los datos por variante. |
| 12 y 13 | Resultados, comprobación de supuestos y análisis de sensibilidad. | Informe sobre las comprobaciones de supuestos y las estadísticas de heterogeneidad, los análisis de sensibilidad, cualquier prueba de dirección causal, la comparación con estimaciones de aleatorización no mendeliana y gráficos adicionales como el de exclusión de un elemento. | Se informó sobre una prueba de pleiotropía sin ningún comentario sobre su potencia. |
| 14 y 15 | Discusión | Resuma los resultados clave en relación con los objetivos y, a continuación, analice las limitaciones, incluyendo los supuestos, otros sesgos e imprecisiones, así como la dirección y la magnitud de cualquier sesgo. | Limitaciones que enumeran problemas sin especificar en qué sentido afectan a la estimación. |
| 16 y 17 | Discusión | Interpretar con cautela, analizar el mecanismo y la equivalencia gen-ambiente, la relevancia clínica y la generalización a otras poblaciones, el momento de la exposición y los niveles de exposición. | Un lenguaje causal más contundente de lo que permiten las suposiciones. |
| 18 a 20 | Más información (opcional – piso, bloque edificio, puerta, etc.) | Describa la financiación y el papel de los financiadores, facilite el acceso a los datos y al código, y declare los conflictos de intereses. | El código descrito está disponible bajo petición. |
Los ítems 4, 6, 10 y 13 de la lista de verificación STROBE-MR contienen la mayor cantidad de subítems y concentran la mayor parte del esfuerzo de elaboración de informes. Los lectores interesados en las estadísticas que los respaldan pueden comenzar con nuestras publicaciones sobre instrumentos débiles y el estadístico F , la pleiotropía y los cuatro estimadores estándar , así como el cálculo de potencia que la mayoría de los artículos omiten . La explicación sobre la aleatorización mendeliana abarca el método de principio a fin.
El ejemplo de acceso abierto que utilizamos para la lista de verificación STROBE-MR
Elegimos un estudio de aleatorización mendeliana de dos muestras publicado en octubre de 2026 en Endocrinology, Diabetes & Metabolism por Zaka y colaboradores [3] . Este estudio investiga si la 25-hidroxivitamina D sérica, predicha genéticamente, está asociada con la diabetes tipo 2 en personas del sur de Asia. Los autores afirman que el trabajo se presenta de acuerdo con STROBE-MR, y el registro de PMC no incluye ningún archivo complementario, por lo que evaluamos el texto completo, las tablas y las figuras según la lista de verificación de STROBE-MR. El artículo tiene licencia CC BY 4.0. Crossref incluye la versión publicada bajo dicha licencia, y Europe PMC y el registro de acceso abierto de PMC mantienen la misma licencia.
- Diseño. Aleatorización mendeliana de dos muestras con estadísticas descriptivas de la base de datos OpenGWAS. OpenGWAS.
- Exposición. Niveles séricos de 25-hidroxivitamina D de un estudio GWAS del biobanco del Reino Unido del sur de Asia (n = 7,380), analizados mediante tres variantes.
- Salir. Diabetes tipo 2 según un metaanálisis de 16 cohortes del sur de Asia (n = 50,533, con 16,677 casos). [ 5 ].
- Resultado principal. Razón de probabilidades ponderada por varianza inversa de 1.06 (IC del 95%: 0.83 a 1.36) por cada desviación estándar de 25-hidroxivitamina D predicha genéticamente.
Cada veredicto a continuación es nuestra interpretación del artículo en relación con la paráfrasis. Utilizamos cuatro etiquetas. «Reportado» significa que el artículo responde a la pregunta con sus propias palabras. «Decisión subjetiva» significa que lectores razonables podrían discrepar, generalmente porque la respuesta es parcial o se encuentra en otra parte. « No encontrado en el artículo» significa que no encontramos ninguna declaración en el texto completo ni en el PDF. «No aplicable» significa que la pregunta depende de algo que los datos resumidos no pueden proporcionar, o de un análisis que el artículo no realizó ni explica. Las citas son textuales y breves.
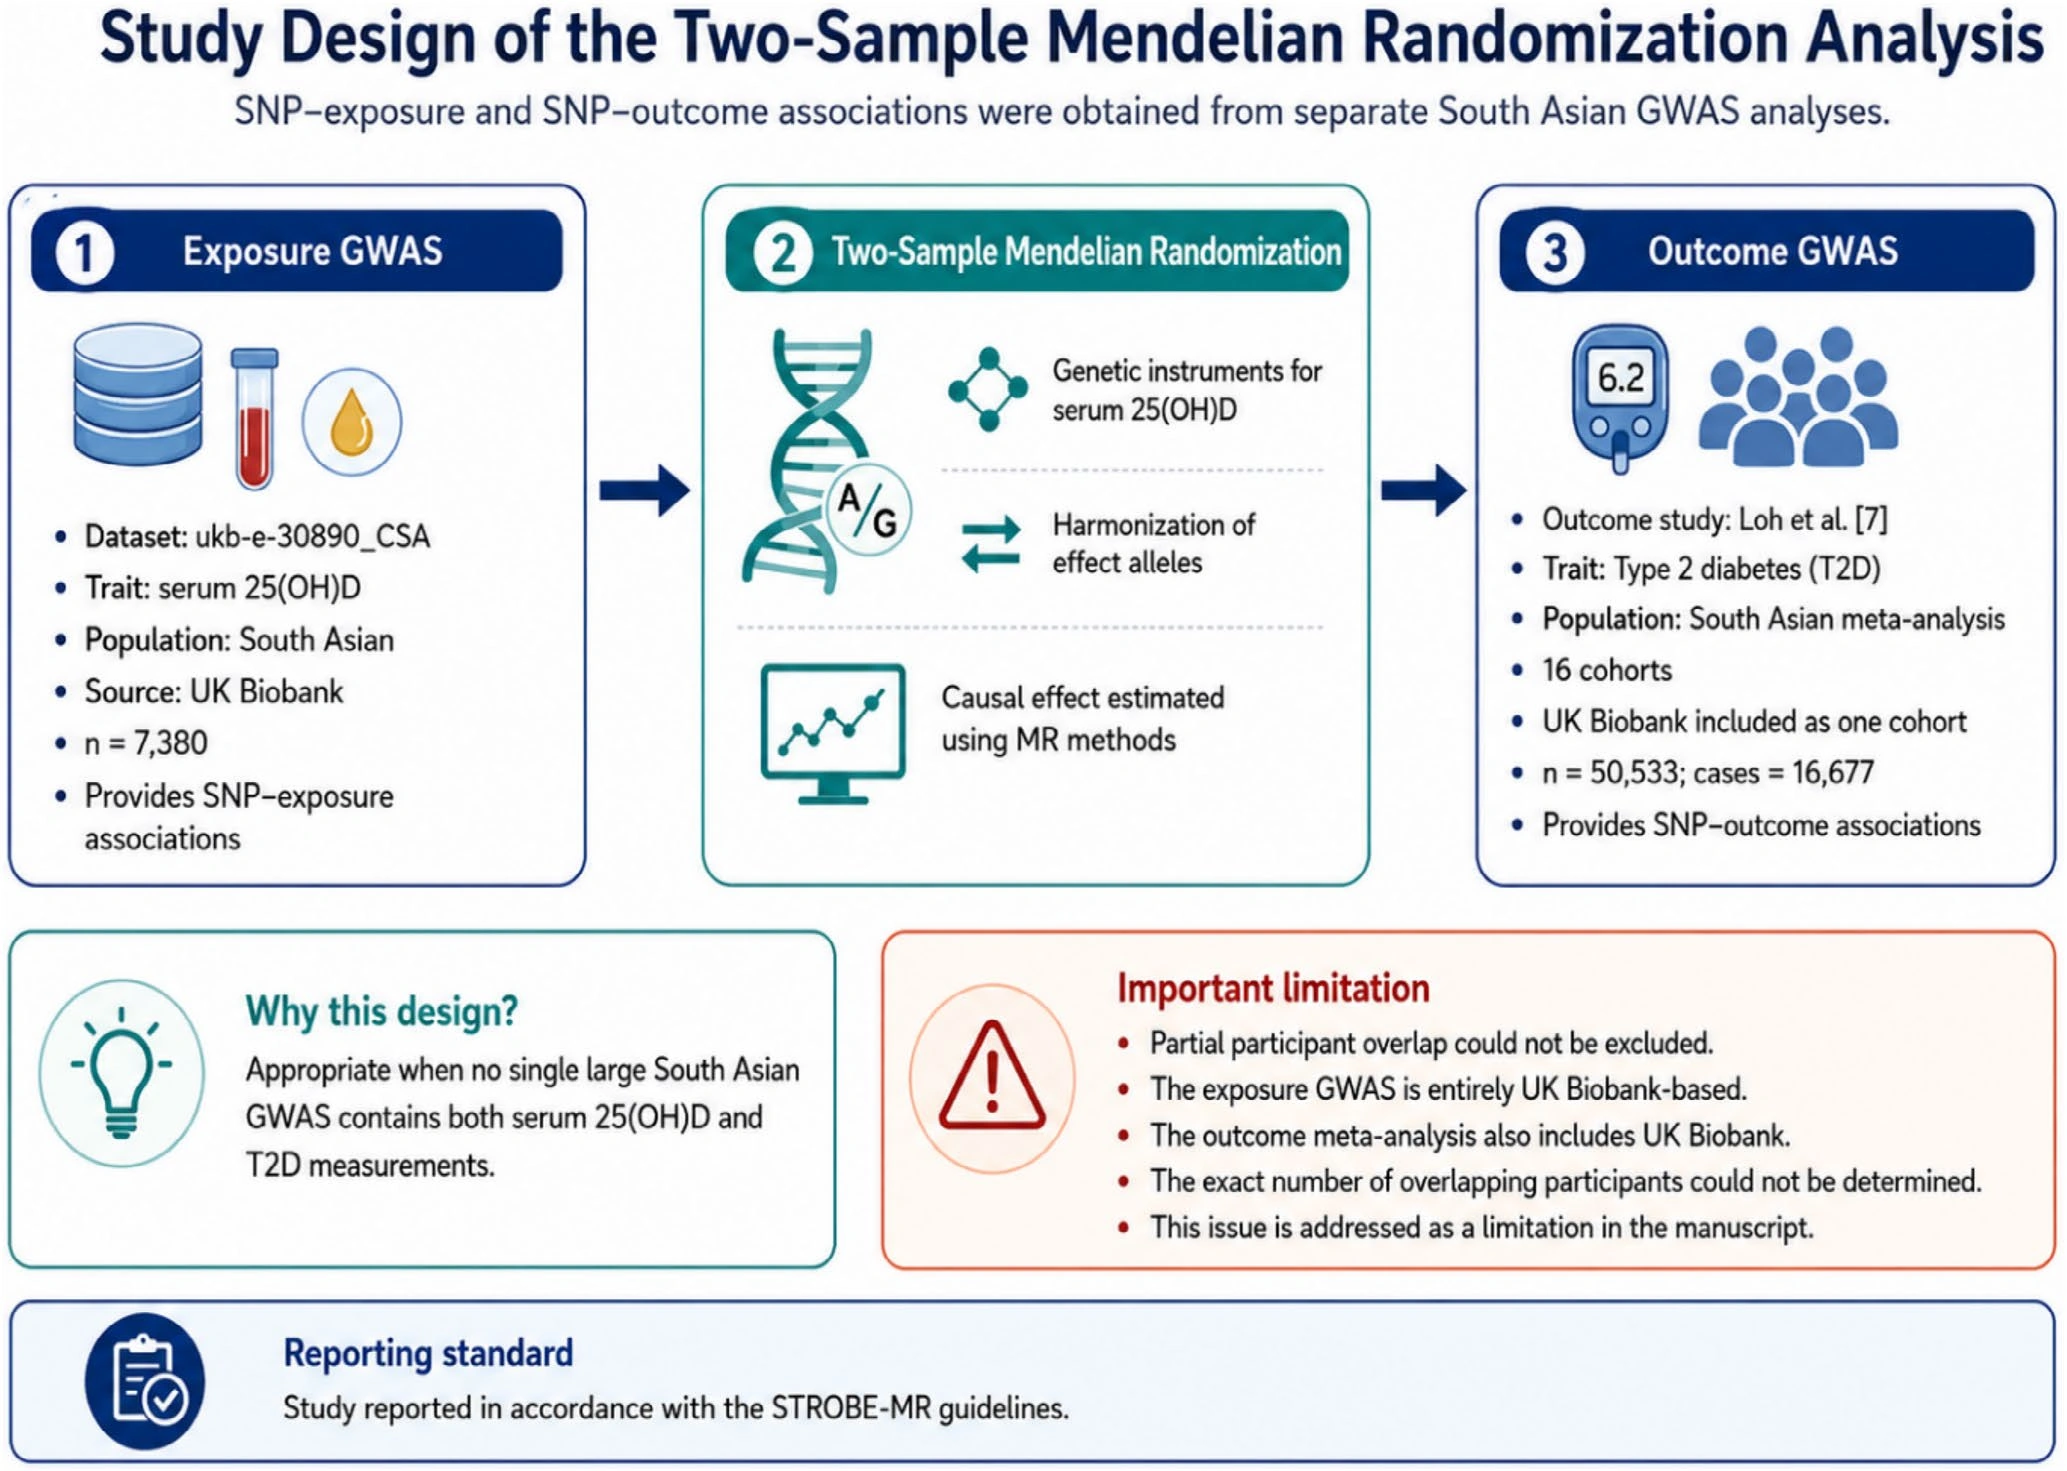
La figura 1 ya responde parcialmente al punto 4, puesto que muestra ambas fuentes de datos, sus tamaños de muestra y la posible superposición en una sola página. Se trata del tipo de resumen inicial del diseño que solicita el punto.
Lista de verificación STROBE-MR aplicada al ejemplo, elemento por elemento.
| Parámetro | ¿En qué parte del artículo? | Lo que hace el artículo | Veredicto |
|---|---|---|---|
| 1 | Título; Resumen | El título denomina al diseño como un "Estudio exploratorio de aleatorización mendeliana de dos muestras", y el resumen de Métodos comienza con un análisis de dos muestras utilizando estadísticas resumidas de OpenGWAS. | reportado |
| 2 | Introducción | Describe la carga que supone la deficiencia de vitamina D y la diabetes tipo 2 en el sur de Asia, un mecanismo a través de receptores en las células beta pancreáticas, el problema de la confusión y la causalidad inversa en los datos observacionales, y los argumentos a favor de la aleatorización mendeliana. | reportado |
| 3 | Fin de la introducción | El objetivo se define como “evaluar la asociación entre los niveles de vitamina D predichos genéticamente y el riesgo de diabetes tipo 2 en personas del sur de Asia”. El objetivo habla de asociación, y no se menciona ninguna hipótesis causal preespecificada. | Decisión de juicio |
| 4 | Sección 2.1; Tabla 1; Figura 2 del artículo | Presenta el diseño de forma temprana, con una tabla de identificadores de conjuntos de datos, rasgos, ascendencia y tamaño de la muestra, y un diagrama de diseño. | reportado |
| 4a | Secciones 2.1 y 2.2 | Se nombran el estudio GWAS de exposición (subconjunto del Biobanco del Reino Unido para el sur de Asia) y el metaanálisis de resultados de 16 cohortes. Los períodos de reclutamiento y los entornos de las cohortes participantes se detallan en los artículos originales. | Decisión de juicio |
| 4b | Sección 2.2; Tabla 1; Sección 2.6 | Se proporcionan los tamaños de muestra y la definición de caso de diabetes tipo 2. El cálculo de potencia se describe como un análisis post hoc, mientras que la pregunta plantea si se realizó antes del análisis principal. | Decisión de juicio |
| 4c | Sección 2.3 | Informa sobre el umbral de todo el genoma, el umbral relajado utilizado para dos variantes, la agrupación en r2 por debajo de 0.001 en una ventana de 10,000 kb frente a un panel de referencia del sur de Asia, el manejo de proxies y palindrómicos, y la construcción del genoma. | reportado |
| 4d | Sección 2.2 | Define la diabetes tipo 2 según los antecedentes o el tratamiento, la glucosa en ayunas, la glucosa a las 2 horas o la HbA1c, e indica la escala normalizada de 25-hidroxivitamina D. No se describe el método de laboratorio para medir la exposición. | Decisión de juicio |
| 4e | Sección 2.2; Declaración de ética | Afirma que el trabajo es un análisis secundario de datos públicos resumidos y que "no se requirió aprobación ética formal". | reportado |
| 5 | Sección 2.4 | Se enumeran la relevancia, la restricción de exclusión y la independencia como los tres supuestos principales. Los supuestos que sustentan los estimadores de sensibilidad aparecen solo como una nota en la Tabla 3 (al menos un 50 % de variantes válidas para la mediana ponderada). | Decisión de juicio |
| 6a | Secciones 2.3 y 2.5 | Informa los efectos por cada desviación estándar de la exposición normalizada por rango, expresados como logaritmos de las probabilidades convertidos a razones de probabilidades. | reportado |
| 6b | Secciones 2.3 y 2.5 | Trata la variante genómica única como un instrumento de razón de Wald y el conjunto de tres variantes con ponderaciones de varianza inversa. | reportado |
| 6c | Sección 2.5 | Menciona los estimadores. El artículo no especifica qué covariables se utilizaron en ninguno de los estudios GWAS. | Decisión de juicio |
| 6d | Sección 2.3 | Indica que las tres variantes estaban disponibles en los datos de resultados y que no se necesitaron datos sustitutivos. No incluye ninguna declaración más amplia sobre los datos faltantes. | Decisión de juicio |
| 6e | No se encontró ninguna declaración | El análisis se centra en una exposición y un resultado, por lo que el tema puede no ser relevante, pero el artículo no se pronuncia al respecto. | Decisión de juicio |
| 7 | Secciones 2.3 y 2.4 | Utiliza estadísticas F y varianza explicada por variante y afirma que "un valor F > 10 indica una fuerza instrumental convencional aceptable, pero no establece por sí solo los supuestos de independencia o exclusión-restricción". | reportado |
| 8 | Secciones 2.5 y 3.4 | Planes MR-Egger, mediana ponderada, moda simple y moda ponderada, luego agrega ejecuciones en dos umbrales relajados (68 y 18 variantes) y un resultado ajustado por IMC. | reportado |
| 9a | Sección 2.5 | Se mencionan R 4.3.1, el paquete TwoSampleMR versión 0.7.0 y el marco mRnd para el análisis de potencia. | reportado |
| 9b | No se encontró ninguna declaración | No aparece ninguna declaración de registro, aunque el análisis ajustado por IMC se denomina "preespecificado". | No se encuentra en el artículo. |
| 10a | Tabla 1 | Se utilizaron datos a nivel de resumen, por lo que no existe un flujo de participantes. La Tabla 1 muestra los tamaños. | No es aplicable |
| 10b | Sección 2.2; Tabla 1 | Se indican los tamaños de muestra y la fracción de casos (0.330). No se proporciona la media ni la desviación estándar de la exposición. | Decisión de juicio |
| 10c | Sección 2.1 | El resultado combina 16 cohortes y no se observa ninguna estadística de heterogeneidad entre ellas. El artículo original podría informar de alguna. | Decisión de juicio |
| 10d (i) | Sección 2.1 | Ambos conjuntos de datos son del sur de Asia, y el artículo explica por qué fue necesario un diseño de dos muestras. No compara las asociaciones entre variantes y exposición en ambas muestras. | Decisión de juicio |
| 10d (ii) | Sección 2.1; Sección 5 | El documento indica que “el número exacto de participantes superpuestos del Biobanco del Reino Unido no pudo determinarse a partir del informe publicado ni de sus datos complementarios”, y luego limita el posible sesgo con una proporción de superposición en el peor de los casos de 0.146. | Decisión de juicio |
| 11a | Tabla 2; Figura 3 del artículo | Los efectos de la exposición a las variantes, los errores estándar y los valores p se encuentran en la Tabla 2. Los efectos de la exposición a las variantes aparecen únicamente en el diagrama de dispersión. | Decisión de juicio |
| 11b | Sección 3.3; Tabla 3 | Informa una razón de probabilidades de 1.06 (IC del 95 %: 0.83 a 1.36) por cada desviación estándar, con p = 0.630, en una escala interpretable. | reportado |
| 11c | No se encontró ninguna declaración | No hay traducción al riesgo absoluto, lo cual conviene a una estimación primaria nula, pero el artículo no explica por qué. | Decisión de juicio |
| 11d | Figuras 3 y 4 del artículo | Se proporciona un diagrama de dispersión con líneas para cada estimador y un diagrama de embudo. No se muestra ningún diagrama de bosque con las estimaciones por variante. | reportado |
| 12a | Secciones 3.1 y 3.2 | Informa estadísticas F de 26.4 a 33.4, Q p = 0.403 y una intersección de Egger p = 0.462, y agrega que "una intersección no significativa no debe interpretarse como evidencia tranquilizadora de que la pleiotropía horizontal está ausente". | reportado |
| 12b | Sección 3.2; Tablas 3 y 4 | Proporciona el estadístico Q de Cochran para IVW y MR-Egger en el análisis principal y para IVW en los dos umbrales relajados. | reportado |
| 13a | Secciones 3.4 y 3.5; Tablas 3 y 4 | Se presentan cuatro estimadores alternativos, dos umbrales menos estrictos y el resultado ajustado por el IMC. | reportado |
| 13b | Secciones 3.5 y 3.6; Tabla 5 | Informa del análisis ajustado por IMC y una potencia de aproximadamente 18%, 51% y más del 99% para razones de probabilidad de 1.1, 1.2 y 1.5. | reportado |
| 13c | Sección 2.3 | No se realizó ninguna prueba de causalidad. El artículo indica que no se aplicó el filtrado de Steiger y explica el motivo: el conocimiento biológico previo de los instrumentos. | No es aplicable |
| 13d | Sección 4.1 | Compara el resultado con estudios previos de aleatorización mendeliana y ensayos de suplementación, expresado en palabras. No se calcula ninguna estimación de aleatorización no mendeliana. | Decisión de juicio |
| 13e | Sección 5 | No muestra un gráfico de validación cruzada dejando uno fuera y afirma que los análisis MR-PRESSO y de validación cruzada "no pudieron realizarse con la precisión adecuada". | Decisión de juicio |
| 14 | Sección 4, párrafo inicial | Reitera el resultado nulo en relación con el objetivo y señala que la estimación de MR-Egger fue demasiado imprecisa para corroborarlo. | reportado |
| 15 | Sección 5 | Enumera siete limitaciones y, para la superposición de muestras, estima la magnitud del posible sesgo utilizando un enfoque de acotación. | reportado |
| 16a | Secciones 3.3, 4.1 y 6 | Interpreta el valor nulo como “la ausencia de una asociación detectable dentro de la precisión que ofrecen los instrumentos actuales” y lo compara con trabajos anteriores. | reportado |
| 16b | Sección 4.2 | Ofrece tres explicaciones, incluyendo efectos no lineales. No se utiliza el término equivalencia gen-ambiente. | Decisión de juicio |
| 16c | Sección 4.3 | Afirma que la suplementación destinada a prevenir la diabetes tipo 2 no está respaldada por la evidencia causal actual y que no se excluyen otros beneficios. | reportado |
| 17 | Secciones 4.2 y 5 | Se señala que los participantes residentes en el Reino Unido pueden diferir de las personas en Pakistán, que la exposición genética a lo largo de la vida difiere de los ensayos con duración limitada y que los métodos lineales no pueden detectar efectos no lineales. | reportado |
| 18 | No se encontró ninguna declaración | En el texto completo y en el PDF no aparece ninguna declaración sobre la financiación del artículo, y Crossref no indica ningún financiador. | No se encuentra en el artículo. |
| 19 | Declaración de disponibilidad de datos | Proporciona los identificadores de OpenGWAS. En cuanto al código, indica que el script y el conjunto de datos “se depositarán en un repositorio público”, y se añadirá el enlace. | Decisión de juicio |
| 20 | Conflictos de Interés | Los autores declaran no tener conflictos de interés. | reportado |
De las 44 filas de la lista de verificación STROBE-MR, 22 son "Informado", 18 son "Decisiones de juicio", 2 no se encuentran en el artículo y 2 no son aplicables. El recuento describe la transparencia del artículo con respecto a los elementos parafraseados y no constituye una puntuación de calidad. Varias de las decisiones de juicio provienen de subelementos que la propia lista de verificación marca como condicionales.
Dos filas merecen una nota sobre el método. En el punto 4b, la explicación pregunta si se realizó un cálculo de potencia antes del análisis principal, y un cálculo post hoc responde a una pregunta diferente, por lo que lo marcamos como una decisión de juicio en lugar de una laguna. En el punto 19, el artículo proporciona identificadores de datos que cualquiera puede seguir, pero su instrucción de código es una promesa, y una promesa no se puede verificar.
Lo que muestran los números del ejemplo
Una lista de verificación para la presentación de informes resulta útil, en parte, porque permite al lector reconstruir las cifras. Recalculamos las cantidades principales de la Tabla 3 a partir de los valores impresos en el artículo. Cuando coinciden, la presentación de informes es internamente coherente, que es precisamente lo que la lista de verificación STROBE-MR pretende facilitar. Cuando difieren, el elemento que se debe verificar es el que solicita a los autores que indiquen sus métodos y configuraciones.
| Cantidad | Nuestra derivación a partir de valores impresos | Informes de artículos | Comentario |
|---|---|---|---|
| Estadístico F, variante rs3755967 | (0.099 / 0.017)2 = 33.9 | 33.4 | Dentro del margen de error estándar mostrado |
| Estadístico F, variante rs2459139 | (0.108 / 0.020)2 = 29.2 | 29.0 | Dentro del redondeo |
| Estadístico F, variante rs72744878 | (0.101 / 0.020)2 = 25.5 | 26.4 | Dentro del redondeo, dado que un error estándar de 0.0197 se imprime como 0.020 y da 26.4 |
| Estadístico F medio | (33.4 + 29.0 + 26.4) / 3 = 29.6 | 29.6 | Match |
| Varianza total explicada | 0.405 + 0.342 + 0.309 = 1.056% | 1.06% | Match |
| razón de probabilidades de IVW | exp(0.058) = 1.06 | 1.06 | Match |
| Valor p de IVW | z = 0.058 / 0.120 = 0.483, p = 0.629 | 0.630 | Match |
| Intervalo del 95% de IVW | exp(0.058 ± 1.96 × 0.120) = 0.84 a 1.34 | 0.83 a 1.36 | Decisión subjetiva. El artículo no especifica cómo se calculó el intervalo. |
| Otros intervalos de estimación | Mediana ponderada, moda simple, moda ponderada y MR-Egger | Tal como está impreso | Coincidencia al recalcularse a partir de cada beta y error estándar |
La única diferencia que merece una mención es el intervalo IVW. El valor reportado de 0.83 a 1.36 también coincide con la estimación IVW ajustada por IMC (beta 0.062, error estándar 0.125), mientras que la estimación primaria con un error estándar de 0.120 da 0.84 a 1.34. La diferencia es pequeña, pero el redondeo de los valores impresos no puede explicarla, ya que un intervalo de 0.83 a 1.36 requiere un error estándar cercano a 0.126. Un método de intervalo diferente, como uno que aumenta el error estándar cuando hay heterogeneidad, es una posible razón. El punto 6 pide a los autores que describan el estimador y las estadísticas relacionadas, y una cláusula que nombre el método de intervalo eliminaría la pregunta. En las limitaciones, el pasaje de superposición también indica que el sesgo es de aproximadamente 0.32 % y de aproximadamente 5.6 % de la estimación IVW, por lo que el lector debe inferir qué denominador utiliza cada cifra.
Cuatro lecciones para la elaboración de informes a partir del ejemplo de la lista de verificación STROBE-MR
Este ejemplo contiene cuatro lecciones que se aplican a cualquier lista de verificación STROBE-MR que complete.
Diga lo que no pudo obtener y calcule el peor escenario.
La superposición de muestras es el aspecto que con mayor frecuencia recibe una frase vaga. En este caso, el estudio GWAS de exposición se basa completamente en el Biobanco del Reino Unido, y el metaanálisis de resultados también lo incluye. Los autores escriben que «el número exacto de participantes del Biobanco del Reino Unido que se superponen no pudo determinarse a partir del informe publicado ni de sus datos complementarios». A continuación, informan que la herramienta MRlap falló porque el paso de covarianza devolvió valores indefinidos, y sustituyen un cálculo de límites con una proporción de superposición supuesta de 0.146 y una correlación fenotípica de -0.12. Este es el patrón que solicita el punto 10d: un número cuando existe y un límite cuando no.
Separe la fuerza del instrumento de la validez del instrumento.
El artículo afirma que «un valor F > 10 indica una fuerza instrumental convencional aceptable, pero no establece por sí solo los supuestos de independencia o exclusión-restricción». El documento explicativo plantea un punto relacionado: que un estadístico F superior a 10 no descarta el sesgo por instrumentos débiles, y compara la regla general con un umbral para los valores p [1] . Escribir ambas partes de la oración protege al artículo de un revisor que interprete el estadístico F como un veredicto.
Por ejemplo, cuando un diagnóstico no tiene energía.
Con tres variantes, el intercepto de MR-Egger tiene un grado de libertad residual. Los autores escriben que «un intercepto no significativo no debe interpretarse como evidencia tranquilizadora de la ausencia de pleiotropía horizontal». Una prueba de pleiotropía que no incluya esta frase sugiere que el estudio es imparcial. Nuestra publicación sobre las limitaciones de cada estimador de pleiotropía explica por qué el número de variantes restringe cada método.
Cierre el círculo entre Métodos, Limitaciones y la lista de referencias.
Cuatro detalles del artículo publicado suscitarían dudas en el corrector de estilo. La sección 2.3 indica que no se aplicó el filtrado de direccionalidad de Steiger, pero la sección 5 señala que sus detalles «deberían confirmarse e informarse en la sección final de Métodos», lo que parece una nota de redacción. La Declaración de Disponibilidad de Datos promete un enlace a un repositorio que aún no figura en el texto. La figura de diseño (nuestra Figura 1) cita el estudio de resultados como referencia 7, mientras que la lista de referencias lo sitúa como referencia 9, y la referencia 7 es una revisión de Davey Smith y Hemani. El enfoque de delimitación por superposición se atribuye a Burgess y colaboradores como referencia 11, y la lista muestra la referencia 11 como el artículo de interpretación MR-Egger de Burgess y Thompson. Nada de esto altera los resultados. Todo se puede corregir en una revisión final de las pruebas, por lo que recomendamos comprobar cada marcador de posición y número de cita con la lista de verificación antes de la presentación.
Cómo completar su propia lista de verificación STROBE-MR
La lista de verificación STROBE-MR funciona mejor si se completa mientras se escribe el manuscrito, no después de que un revisor lo solicite. Los pasos que se describen a continuación siguen el orden en que generalmente se obtienen las respuestas.
- Descargue la lista de verificación desde Sitio web de STROBE-MR o del documento explicativo [ 1 ]y agregue una columna para la página o sección donde se encuentra cada respuesta.
- Cree una tabla de fuentes de datos al principio de la sección Métodos, con identificadores de conjuntos de datos, rasgo, ascendencia, tamaño de la muestra, números de casos y compilación del genoma, como se muestra en el ejemplo de su Tabla 1.
- Escribe la oración de superposición incluso cuando la superposición sea cero. Si no puedes contarla, indica un límite.
- Informe las estadísticas F y la varianza explicada por variante, y luego agregue una declaración de potencia para el tamaño del efecto que sea relevante.
- Indique el estado de registro, incluyendo una declaración clara de que no hay registro cuando ese sea el caso, ya que el punto 9b solicita una declaración en ambos sentidos.
- Deposita el código y el conjunto de datos armonizado antes de enviarlo, y reemplaza cada marcador de posición con un enlace.
- Para las filas que no correspondan, escriba una breve explicación en una sola línea en lugar de dejar la fila en blanco.
- En la sección de Métodos, indique que el estudio siguió el protocolo STROBE-MR y adjunte la lista de verificación completa si la revista lo solicita. lista de verificación de envío de manuscritos Enumera los demás archivos que esperan los editores.
Errores comunes al informar sobre un estudio de aleatorización mendeliana
Estos son los errores que esperamos ver con mayor frecuencia cuando se completa tarde una lista de verificación STROBE-MR, y cada uno corresponde a un elemento específico.
- Nombrar conjuntos de datos sin describirlos. El punto 4 solicita la población, las fechas, el tamaño de la muestra y la definición de caso para cada fuente.
- Informando únicamente sobre el estimador principal. Los puntos 8 y 13 requieren todos los análisis de sensibilidad, incluidos aquellos que no coinciden.
- Sin incluir el estado de registro. El punto 9b solicita una declaración en cualquier sentido.
- Utilizando un lenguaje causal, las suposiciones no pueden sostenerse. El punto 16 pide a los autores que indiquen que las estimaciones son causales solo bajo supuestos establecidos.
- Código prometedor. El elemento 19 requiere el código o su ubicación, y un enlace futuro no es una ubicación.
Preguntas frecuentes sobre la lista de verificación STROBE-MR
¿Cuántos elementos tiene la lista de verificación STROBE-MR?
La lista de verificación STROBE-MR tiene 20 elementos, y varios de ellos tienen subelementos con letras, por lo que un formulario completo tiene más de 20 filas [1].
¿STROBE-MR reemplaza la lista de verificación STROBE?
Para un informe de aleatorización mendeliana, la guía STROBE-MR es la que se debe seguir. Para un estudio observacional convencional, utilice STROBE, que se explica en nuestro tutorial de STROBE.
¿Debería utilizarse STROBE-MR para evaluar la calidad de un estudio publicado?
No. Los autores afirman que la lista de verificación STROBE-MR no debe convertirse en una escala de calidad, y que existe para hacer posible la evaluación en lugar de realizarla [1].
¿Es necesario realizar un cálculo de potencia para satisfacer el punto 4b?
El punto 4b de la lista de verificación STROBE-MR solicita a los autores que informen sobre el tamaño de la muestra y si se realizó algún cálculo de potencia o tamaño de muestra antes del análisis principal. Una respuesta válida es que no se realizó ningún cálculo, y un cálculo posterior debe indicarse como tal, tal como se muestra en el ejemplo.
Herramientas de investigación gratuitas de Editverse
- GraphProCrea gráficos listos para publicar, de 25 tipos diferentes, con pruebas t, ANOVA, correlación y valores p de chi-cuadrado integrados. Gratis, sin necesidad de registrarse.
- EstatProCalculadoras estadísticas gratuitas y una herramienta de selección de pruebas que abarca comparaciones de grupos, resultados categóricos, análisis de tiempo hasta el evento y precisión diagnóstica.
- Diagrama de flujo Pro: genera diagramas de flujo PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE y ARRIVE directamente en tu navegador.
Apoyo profesional para un manuscrito sobre aleatorización mendeliana.
Una lista de verificación solo puede registrar la información que ya contiene el análisis. Tanto si está planificando el análisis como si se está preparando para completar la lista de verificación STROBE-MR, Editverse ofrece asistencia a los autores en ambas etapas. Nuestro trabajo sigue las directrices de COPE, ICMJE y GPP 2022, y se respetan los requisitos éticos institucionales y específicos de cada país. El paquete de estudio completo que se muestra a continuación incluye una lista de verificación STROBE-MR completa.
Antes de comprometerte
$450
Un analista sénior verifica si su pregunta ya ha sido respondida, si los datos la respaldan y si cuenta con la potencia estadística necesaria, incluyendo la solidez del instrumento, para un diseño de aleatorización mendeliana. El importe se descuenta íntegramente de cualquier estudio que usted encargue. Plazo de entrega: 5 días hábiles.
estudio completo
$2,900
Aleatorización mendeliana de dos muestras a partir de estadísticas resumidas de estudios de asociación de genoma completo (GWAS) públicos, con análisis de fuerza instrumental, filtrado de Steiger, cuatro estimadores que exploran la pleiotropía, MR-PRESSO, manuscrito, gráficos, código ejecutable TwoSampleMR y una lista de verificación STROBE-MR. 15 días hábiles.
Envíanos tu borrador y la revista a la que te diriges, y te diremos cuál de las dos se ajusta mejor a tu situación.
Conclusión
La lista de verificación STROBE-MR transforma un artículo sobre aleatorización mendeliana, pasando de ser un conjunto de resultados a una herramienta auditable para el lector. Aplicada a un estudio real de acceso abierto, muestra cómo debe ser una buena presentación de informes, con cuantificación de los peores escenarios, notas honestas sobre pruebas con baja potencia estadística y un diagrama de diseño en la primera página de Métodos. Además, revela las deficiencias incluso en un artículo meticuloso, como el registro, la financiación, las covariables y el código. Complete la lista de verificación antes de la presentación, indique el motivo de cada fila que no corresponda y revise cada marcador de posición y número de cita en las pruebas finales.
Referencias
- Skrivankova VW, Richmond RC, Woolf BAR, Davies NM, Swanson SA, VanderWeele TJ, et al. Fortalecimiento de la presentación de informes de estudios observacionales en epidemiología mediante aleatorización mendeliana (STROBE-MR): explicación y elaboración. BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233. PMID 34702754. PMC8546498.
- Skrivankova VW, Richmond RC, Woolf BAR, Yarmolinsky J, Davies NM, Swanson SA, et al. Fortalecimiento de la presentación de informes de estudios observacionales en epidemiología mediante aleatorización mendeliana. La declaración STROBE-MR. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID 34698778.
- Zaka A, Khan S, Shah A, Khalid AA, Khalil I, Kamrul-Hasan ABM. Asociación entre la 25-hidroxivitamina D predicha genéticamente y el riesgo de diabetes tipo 2 en personas del sur de Asia. Un estudio exploratorio de aleatorización mendeliana de dos muestras. Metabolismo de la diabetes endocrinol. 2026;9(6):e70359. doi:10.1002/edm2.70359. PMID 42912852. PMCID PMC13690357Licencia CC BY 4.0.
- Woolf B, Di Cara N, Moreno-Stokoe C, Skrivankova V, Drax K, Higgins JPT, et al. Investigación de la transparencia de la presentación de informes en estudios de aleatorización mendeliana con datos resumidos de dos muestras utilizando la plataforma MR-Base. Int J Epidemiol. 2022;51(6):1943-1956. doi:10.1093/ije/dyac074. PMID 35383846. PMC9749715.
- Loh M, Zhang W, Ng HK, Schmid K, Lamri A, Tong L, et al. Identificación de los efectos genéticos subyacentes a la diabetes tipo 2 en poblaciones del sur de Asia y Europa. Biol comun. 2022, 5: 329. doi:10.1038/s42003-022-03248-5PMID 35393509.
La redacción de las directrices es una paráfrasis del documento explicativo STROBE-MR, publicado bajo la licencia CC BY 4.0. Las recomendaciones del ICMJE están disponibles en icmje.org.