
F 统计量是审稿人在孟德尔随机化论文中首先关注的数值,而与之相关的规则——当 F 值超过 10 时,工具变量就足够好——几乎在 2011 年以来撰写的每一篇方法论章节中都会被引用。Editverse 已支持超过 1,100 篇稿件,在我们统计学家处理的注册登记和遗传流行病学工作中,当审稿人询问 F 统计量的作用时,作者也最常无法解释这个数值。
因此我们进行了测量。我们模拟了135,000次孟德尔随机化研究,涵盖了各种工具变量强度和样本重叠情况,并在两个独立编写的程序中分别运行了两次,然后比较了结果。结果与大多数教程所暗示的并不相同。弱工具变量通常不会直接给出错误答案,而是会给出一个非常宽的区间,以至于无法得出任何正确答案,而且这种情况会在估计值本身开始漂移之前很久就出现。
用简单的话
把基因工具想象成一个非常微小的推动力。如果这种推动力很强,那么所有携带该变异的人最终都会获得更多的致病因素,你就能观察到他们的患病风险变化。如果这种推动力很弱,携带者和非携带者之间的差异几乎可以忽略不计,因此任何对疾病的影响都会被噪声掩盖。F 统计量衡量的就是这种推动力的强度。当 F 统计量很小时,你的分析结果会呈现出一个非常宽泛的范围,其中既包含显著的有害影响,也包含完全没有影响,甚至还包含显著的保护作用。这项研究并没有欺骗你,它只是没有测量到任何东西。
F 值大于 10 规则的由来
该阈值并非源自遗传学,而是借鉴而来。它起源于计量经济学,Staiger 和 Stock (1997)研究了工具变量对暴露解释力极低时的两阶段最小二乘法,并提出第一阶段 F 值小于 10 作为判断偏差是否可接受的经验法则。Burgess和 Thompson (2011)将该法则引入遗传流行病学领域,他们专门研究了孟德尔随机化中的弱工具变量偏差,并指出估计值会向混杂的观察关联方向偏移,偏移程度取决于 F 统计量。
关于该谱系,有两点至关重要却常被忽略。首先,原始结果涉及使用多个工具变量的两阶段最小二乘法,其描述的偏差会随着工具变量数量的增加而增大。其次,该阈值仅作为粗略参考,而非及格标准。Pierce 、Ahsan 和 VanderWeele (2011)也提出了类似的观点,即工具变量的强度和统计功效是两个不同的问题,一个工具变量可能轻松达到 F 值等于 10,但却导致研究结果远不够精确,无法回答其最初设计的问题。我们的模拟结果清晰地展示了这两者之间的巨大差异。如果您对这种设计本身还不熟悉,我们关于孟德尔随机化及其操作方法的指南涵盖了本文假设您已了解的三个工具变量假设,而我们关于工具变量和两阶段最小二乘法的解释则涵盖了估计器本身。
我们模拟了什么,以及您可以如何检查它
该设置刻意保持简洁,因为简单的设计能够使失效模式清晰可见,而不是将其隐藏在复杂的模型中。每个模拟研究的样本包含 5,000 名个体。一个次要等位基因频率为 0.3 的单一遗传变异作为工具变量。一个未测量的混杂因素同时影响暴露和结果,这正是导致观察性关联产生误导的根本原因。暴露对结果的真实因果效应为 0.20。由于混杂因素的存在,对暴露进行结果的普通回归分析得到的值约为 0.40,因此观察性估计值高估了真实值两倍。
然后,我们调整工具变量的强度,使第一阶段的F统计量分别接近3、5、10、20、50和100,并在每个强度水平下进行5,000次重复研究,分别在两种条件下进行:一种条件是暴露因素和结局指标的关联性估计来自同一批参与者,另一种条件是暴露因素和结局指标来自两个完全独立的样本。对于每次重复研究,我们记录了因果估计值、采用delta方法计算的标准误差、由此得到的95%置信区间,以及该区间是否包含真实效应值0.20。
以下所有图表均生成两次。一次是用 R 语言实现,对重复样本块进行矩阵运算。另一次是用 Python 实现,使用不同的随机数生成器,并结合充分统计量计算相同的量,且不共享任何代码。在编写任何内容之前,我们对这两个引擎进行了比较。它们在所有稳定量上的计算结果均在蒙特卡罗误差范围内一致,而对于存在分歧的部分,分歧本身即为研究结果。我们发布的每个数据图表都遵循这一双引擎标准,正如我们在NHANES 调查权重的作用和局限性分析中所展示的那样。
弱工具变量对估计的实际影响
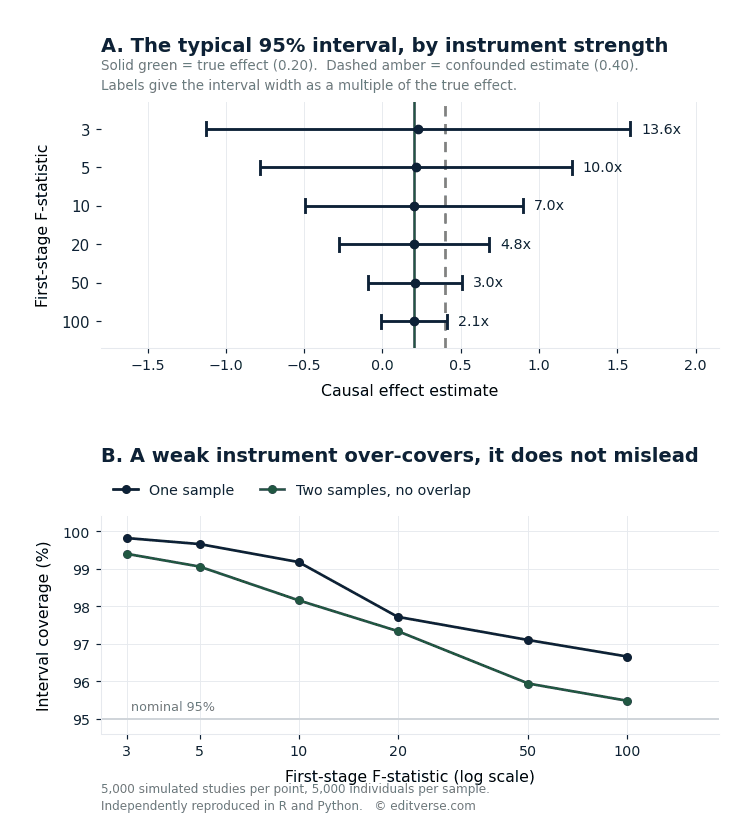
区间在点估计值坍塌之前很久就坍塌了。
图A以一张图的形式完整地展示了所有论点。在我们测试的每种仪器强度下,中位数估计值都接近真实效应值0.20,而远低于受混淆因素影响的观测值0.40。真正发生显著变化的是围绕该值区间的宽度。
| 第一阶段 F | 中位数估计 | 中位数 95% 置信区间宽度 | 宽度是实际效果的倍数 | 保障范围 |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8% |
| 5 | 0.213 | 1.99 | 10.0x | 99.7% |
| 10 | 0.200 | 1.39 | 7.0x | 99.2% |
| 20 | 0.202 | 0.96 | 4.8x | 97.7% |
| 50 | 0.205 | 0.60 | 3.0x | 97.1% |
| 100 | 0.199 | 0.42 | 2.1x | 96.7% |
阅读第四列,其实际意义便显而易见。当 F 值为 3 时,典型的置信区间比研究试图检测的效应值宽 13.6 倍。该区间大致从 -1.1 延伸到 +1.6。它包含了显著的保护性效应、无效应以及显著的有害效应。数据本身无法区分这三种效应。当 F 值为 100 时,该区间仍然约为真实效应值的两倍,这足以确定效应的方向,但仅此而已。
区间宽度接近 F 值的平方根倒数。将每个区间宽度乘以其对应的 F 值的平方根,得到六个水平的区间宽度分别为 4.63、4.51、4.37、4.30、4.25 和 4.24,该值几乎恒定,仅在仪器性能最弱时略有上升,此时 delta 方法的标准误差本身也开始下降。实际结果是,要将精度提高一倍,仪器性能大约需要提高四倍,在双样本设计中,这意味着需要进行更大剂量的 GWAS 分析,而不是略微放宽 p 值阈值。
时间间隔过长,但这并不意味着错误
图表 B 显示的是覆盖率:即 95% 置信区间包含真实效应的重复研究比例。如果该方法完全如宣传的那样有效,那么在所有情况下该值都应该是 95%。但事实并非如此。当 F 值为 3 时,单样本置信区间在 99.8% 的情况下覆盖了真实值,而当 F 值为 100 时,覆盖率下降至 96.7%。双样本置信区间略低于单样本置信区间,在最高 F 值下达到 95.5%。
过度覆盖是指标准误差过大,超出可用信息范围的标志。这意味着弱工具变量产生的区间是保守的,而非误导性的。对于任何解读已发表的零假设结果的人来说,这都是一个至关重要的区别。一篇基于弱工具变量报告无效应的孟德尔随机化论文,并非表明效应不存在,而是表明其设计无法检测到效应。这是不同的结论,审稿人也越来越倾向于要求作者明确指出他们究竟提出了哪一种结论。
平均值并不存在,两台发动机就证明了这一点。
在我们的两种实现方式中,有一个量的结果始终不一致,而这种差异颇具启发意义。在 F 值为 3 时,R 引擎在单样本条件下返回的平均估计值为 0.64。运行相同设计的 Python 引擎返回的值为 0.24。在双样本条件下,两个引擎分别返回了 0.77 和 1.01。本文中所有其他量的结果均在蒙特卡罗误差范围内一致,唯独这两个量的结果不一致。
这并非两个程序中的错误。此处的因果估计是两个回归系数的比值,当分母可以任意接近于零时,该比值的期望值没有上限。无论运行多少次重复实验,此类量的样本均值都不会收敛,因此两个诚实的程序会对此得出无限期的分歧。中位数、区间宽度和覆盖率均呈正态收敛,因此上表报告的是这些值而非均值。任何依赖于跨变异平均值而不考虑重尾分布的孟德尔随机化结果都建立在同样的不稳定性之上,这也是我们在孟德尔随机化主要指南中讨论的多效性稳健估计量使用中位数和众数而非普通均值的原因之一。我们针对这四个估计量各自实际保护您免受哪些影响的模拟,在六种多效性条件下对它们进行了测试,结果发现有一种情况下所有四个估计量都一致,而另一种情况下所有四个估计量都错误。
采样重叠仅在仪器信号弱时才会发生
双样本孟德尔随机化假设暴露GWAS和结局GWAS是在不同人群中测量的。然而,在实践中,这一假设经常被打破,因为少数几个大型生物样本库贡献了大部分已发表的GWAS数据,而且同一批参与者会在分析的前后两部分都出现,而作者未必意识到这一点。Burgess 、Davies和Thompson(2016)的研究表明,样本重叠会使双样本估计值向单样本行为靠拢,也就是向混杂的观察性关联靠拢。
我们直接测试了这种效应的大小,在三种仪器强度下,将重叠度从 0% 变化到 100%。
| 参与者重叠 | F = 3 处的中位数偏差 | F = 5 处的中位数偏差 | F = 10 处的中位数偏差 |
|---|---|---|---|
| 0% | -0.004 | -0.011 | -0.003 |
| 25% | -0.016 | -0.008 | -0.010 |
| 50% | -0.003 | -0.012 | 0.000 |
| 75% | +0.015 | -0.005 | +0.011 |
| 100% | +0.026 | +0.005 | +0.005 |
当F值为3且完全重叠时,中位数估计值在真实效应为0.20的情况下被拉高了约0.026,相当于向混淆值偏移了约13%,并且两个模型都独立地重现了这一结果。当F值为10时,有序模式已不复存在。这两个问题不是相加而是相乘:重叠将一个弱工具变量变成了一个有偏工具变量,但对于一个强工具变量来说,重叠的影响几乎可以忽略不计。
报告的意义显而易见。仅仅指出两个全基因组关联研究(GWAS)结果重叠是不够的,断言它们完全不重叠也是不够的。审稿人需要的是重叠比例以及工具变量强度,因为只有结合工具变量强度才能解释前者。如果两者都不利于结果,那么诚实的回应不是在讨论中添加保留意见,而是提供不同的数据来源。
为什么F值大于10的规则仍然比我们的结果所显示的更重要
我们的模拟仅使用单一工具变量,因此如果据此得出弱工具变量无害的结论,那就大错特错了。我们刚刚测试的案例已经是其中最温和的了。Burgess和 Thompson (2011)描述的偏差会随着工具变量数量的增加而增大,因此,包含 200 个边缘显著性变异的设计会暴露出一些我们单变异设置无法展现的问题。为了获得更多工具变量,将全基因组显著性阈值从 5 × 10⁻⁸ 放宽至 1 × 10⁻⁵ 正是造成这种情况的原因,而这种做法目前已成为遗传结构稀疏的暴露研究的常用方法。
任何公正的论述都应包含以下两点。在多变量孟德尔随机化中,相关的量并非普通的F统计量,而是Sanderson等人(2019)提出的条件F统计量。该统计量衡量的是工具变量能否区分不同的暴露因素,而不仅仅是孤立地预测每个暴露因素。论文中经常会报告错误的统计量。此外,当工具变量的测量存在误差时,MR-Egger估计值会变得不可靠,而Bowden等人(2016)提出的I²-GX统计量可用于诊断这种情况。较低的I²-GX值意味着你用来对抗多效性的敏感性分析本身就不可信。
审稿人在已发表的MR论文中实际发现了什么
上述标准与实际应用标准之间的差距现已得到衡量。Rosas -Chavez 和 Merriman (2025)系统地评估了 2016 年至 2024 年间发表的 86 项关于高尿酸血症和痛风的双样本孟德尔随机化研究,并根据结构化的质量指标对每项研究进行评分。他们的研究结果如下:
- 66% 满足相关性假设,即全基因组显著性或报告的 F 统计量大于 10。三分之一的论文不符合这一假设。
- 51% 他们使用的数据集没有参与者重叠,据他们自己报告,这使得大约一半的文献暴露于上述互动中。
- 59% 完全没有讨论统计功效。
- 17% 满足了所有三个核心工具变量假设。
- 14% 进行了任何重复性分析。
- 11% 2021年以后发表的论文符合以下规定: STROBE-MR 报告指南.
该综述的总体质量评分范围为0至19分(满分21分),平均分为9.1分。这只是一个疾病领域,其他领域的情况可能有所不同,但它是目前最系统的磁共振成像(MR)报告质量审核,其结果与我们统计学家在投稿中观察到的情况一致。当六篇论文中有五篇未能满足其结论所依赖的假设时,编辑会提高所有论文的标准,因此方法学的完整性已成为一个把关问题,而非风格问题。我们的STROBE观察性研究报告指南涵盖了STROBE-MR所扩展的母指南。
如何报告仪器强度以便审核人员检查
仅仅报告一个数字就草草了事,这会引发质疑。以下内容是我们统计人员在方法部分编写的内容,也是方法论审阅者打开方法部分时会寻找的内容。
- 每个仪器和组合的 F 统计量。 两者都需要上报。由30个F值接近1.3的变体组合而成的F值为40的物体,与由3个高F值变体组合而成的F值为40的物体是不同的,只有按变体划分的表格才能显示你拥有的是哪一种。
- 解释的暴露方差比例。 请提供仪器组的R平方值。R平方值决定了精度,也是读者判断您的测量区间是否可能窄到足以用于实际测量的必要参数。
- 筛选阈值在结果公布前已明确说明。 如果你在全基因组显著性水平以下放松了限制,请说明原因,并报告两种阈值下的分析结果,以便读者能够看出该发现是否取决于限制程度。
- 聚集参数和参考面板。 连锁不平衡阈值、窗口大小以及所使用的面板。非独立工具会夸大表观强度。
- 重叠部分及其来源。 请列出每项全基因组关联研究(GWAS)中包含的队列,并估算其共享比例。如果无法估算,请说明,并将该分析视为单样本设计进行解释。
- 这是一份精确的声明,而不仅仅是一份重要性声明。 请报告您的设计能够检测到的最小效应量。如上文覆盖率结果所示,如果没有此信息,则无效结果将无法解释。
- 任何多变量分析的条件F统计量。 普通的F值并不能回答多变量孟德尔随机化提出的问题。
导致这种失败的三个错误
将F值大于10视为及格线而非底线。F值超过10并不意味着研究就足够充分。根据我们的数据,即使F值为10,其置信区间仍然比所测量的效应宽七倍。该阈值标志着偏差开始成为问题,而不是精度足够高的临界点。
放宽p值阈值以获取更多工具变量。这是导致工具变量效力不足的最常见途径,而且与作者的初衷背道而驰。它增加了工具变量的数量,却引入了对统计效力贡献甚微的变异,而这正是经典偏差结果所警告的。如果某个暴露因素的全基因组显著性变异过少,这恰恰是判断研究是否应该继续进行的信息,而不是需要克服的障碍。
将无效结果报告为无效应的证据。对于弱工具变量而言,置信区间99.8%的时间都涵盖了真实值,正是因为它几乎涵盖了所有情况。来自统计功效不足设计的无效结果实际上是对设计本身的一种陈述,理解这一点的审稿人会指出这一点。我们的临床研究证据等级指南阐述了执行良好的孟德尔随机化结果相对于试验证据的地位,而我们的流行病学因果推断概述则涵盖了此类设计所属的更广泛的范畴。来自弱工具变量设计的无效结果本身也无法解释,这正是我们另一篇文章“孟德尔随机化论文为何会被直接拒稿”的主题。
孟德尔随机化研究的专业支持
统计人员首先检查的是工具变量的强度,而且这项检查会在委托任何分析之前进行,而不是事后报告。如果某个暴露因素的独立全基因组显著性变异过少,或者唯一可用的结局全基因组关联研究(GWAS)与暴露因素全基因组关联研究(GWAS)的样本量高度重合,我们会在一开始就说明。否则,我们可能会得出技术上正确但审稿人不会接受、读者也无法使用的分析结果。
可行性检查
$450
在您决定委托研究之前,我们会核实仪器数量、F统计量、样本重叠情况以及现有文献。您可以书面通知我们继续、修改或终止研究。您之后委托的任何研究都将获得全额抵扣。5个工作日内完成。
双样本MR
$2,900
基于公开的 GWAS 汇总统计数据的完整研究:四种估计方法、MR-PRESSO、Steiger 滤波、仪器 PheWAS、留一法交叉验证,以及完整的 STROBE-MR 清单和可运行的 R 代码。15 个工作日。
扩展设计
从澳元3,500
多变量孟德尔随机化(MR),包括条件F统计量、中介孟德尔随机化、共定位孟德尔随机化、药物靶点孟德尔随机化和非线性孟德尔随机化。所有报价和工作范围均在开始前以书面形式确定。
如果您仍在基因设计与调查、癌症登记或创伤登记分析之间进行选择,我们的指南将指导您了解您的研究应该使用哪个健康数据库,并列出每个来源可以回答和不能回答的问题。
Editverse提供的免费研究工具
关于孟德尔随机化中工具变量强度的常见问题
F 统计量大于 10 是否足以发表?
这是必要条件,但并非充分条件。我们的模拟结果表明,当F值为10时,典型的95%置信区间仍然是所估计效应值的七倍,这足以证明该设计没有严重的偏差,但不足以回答大多数研究问题。审稿人越来越希望在F统计量旁边附上精确度声明,以表明该研究能够检测到的最小效应值。
如何计算多个仪器的F统计量?
对于一组独立的变异,可以通过解释的总暴露方差比例和样本量计算合并F值,公式为:F = R² × (n - k - 1) / (1 - R²) × k,其中k为工具变量的数量。同时报告每个变异的F统计量,因为较高的合并值可能是由少数强工具变量或许多弱工具变量造成的,只有前者才更可靠。
弱工具变量偏差会使结果趋向于零假设还是趋向于混淆估计值?
这取决于研究设计。在单样本分析中,偏差倾向于混杂的观察关联。在真正的双样本分析中(参与者之间没有重叠),偏差则倾向于零假设。部分重叠介于两者之间,因此重叠比例必须与工具变量强度一起报告,而不是代替工具变量强度。
我可以放宽 p 值阈值以获得更多仪器吗?
可以这样做,但通常会使问题恶化而不是改善。在放宽阈值下选择的变异对解释暴露方差的比例贡献甚微,同时工具变量的数量却在增加,而且在过度识别的情况下,弱工具变量偏差会随着工具变量数量的增加而增大。如果您确实放宽了阈值,请报告两种阈值下的分析结果,以便读者能够判断结果是否仍然成立。
如果我暴露的基因中只有少数几个具有全基因组显著性的变异呢?
那么,诚实的答案可能是,孟德尔随机化研究目前还不适合用于该暴露因素。置信区间会非常宽泛,几乎可以涵盖所有情况,因此无论是估计值还是零结果都难以解释。这个问题应该在分析之前解决,而不是之后,而可行性评估的目的就在于此。
如何判断两个全基因组关联研究(GWAS)是否共享参与者?
请阅读每篇文献及其补充材料中的参与队列列表。已发表的全基因组关联研究(GWAS)中,相当一部分都使用了非常大型的生物样本库,因此,对于任何两项针对同一性状的大型研究,在进行核查之前,默认假设它们之间存在一定的重叠。如果重叠部分无法量化,则应将分析结果解释为单样本设计。
结语
在两个独立程序中重复进行的 135,000 次模拟孟德尔随机化研究中,F 统计量所反映的情况与通常的用途有所不同。在我们测试的每个工具变量强度下,中位数估计值都与真实值非常接近。变化幅度最大的是其周围区间的宽度,从 F 值为 100 时的 2.1 倍真实效应值增加到 F 值为 3 时的 13.6 倍,变化幅度高达六倍。样本重叠仅在工具变量本身较弱的情况下才会产生可检测到的偏移,而且即使如此,这种偏移相对于其周围的误差范围而言也微乎其微。
从实际角度来看,工具强度的问题在于一项研究能否回答任何问题,而偏倚问题只是次要的。这种重新定义改变了检验的时机。结果表中报告的F统计量是对一项已完成研究的描述。而设计阶段计算的F统计量则决定了是否要开展这项研究。鉴于在已发表的最系统的审计中,只有17%的论文满足所有三个核心假设,且只有14%的论文尝试了重复验证,因此,分析之前的检验才是区分一篇稿件能否通过审查的关键所在。
案例
- Staiger D, Stock JH. 弱工具变量回归。 计量经济学. 1997;65(3):557-586. DOI:10.2307 / 2171753
- Burgess S, Thompson SG.避免孟德尔随机化研究中弱工具变量的偏倚。 国际流行病学杂志. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL、Ahsan H、VanderWeele TJ。使用多个遗传变异进行孟德尔随机化研究的功效和仪器强度要求。 国际流行病学杂志. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S、Davies NM、Thompson SG。双样本孟德尔随机化中由于参与者重叠而产生的偏差。 遗传流行病学. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J、Del Greco MF、Minelli C、Davey Smith G、Sheehan NA、Thompson JR。使用 MR-Egger 回归评估汇总数据对双样本孟德尔随机化分析的适用性:I² 统计量的作用。 国际流行病学杂志. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E、Davey Smith G、Windmeijer F、Bowden J. 在单样本和双样本汇总数据设置中检验多变量孟德尔随机化。 国际流行病学杂志. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F, Merriman TR.孟德尔随机化研究:质量评价指标。 痛风、尿酸盐和晶体沉积病。 2025; 3(2):8。 doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW、Richmond RC、Woolf BAR 等。加强使用孟德尔随机化流行病学观察性研究的报告:STROBE-MR 声明。 JAMA. 2021;326(16):1614-1621. doi: 10.1001 / pit.2021.18236
模拟详情:每个样本包含 5,000 个个体,单等位基因工具变量,次要等位基因频率为 0.3,未测量的混杂因素在暴露和结局上的载荷均为 0.5,真实因果效应为 0.20,混杂的观察关联为 0.40。工具变量强度经过校准,目标第一阶段 F 值分别为 3、5、10、20、50 和 100。每个单元格重复 5,000 次。分别使用 R 4.3.3 和 Python 3(含 NumPy)独立实现;除比率估计量的均值外,所有报告的量在两种引擎之间均在蒙特卡罗误差范围内一致。比率估计量的均值没有有限期望值,已在上文讨论。