
在孟德尔随机化论文中,运行四种估计方法并验证其结果是否一致已成为防止多效性的标准方法。标题采用逆方差加权法,其次是MR-Egger法,然后是加权中位数和加权众数,并在结果部分说明估计结果在不同方法中保持一致。Editverse已支持超过1,100篇稿件,而这已成为我们统计学家在提交的孟德尔随机化论文中最常见的敏感性分析方法。
这也是作者们最难以解释的部分。当被问及这四种估计量分别放宽了哪些具体假设,以及它们之间的一致性能证明什么、不能证明什么时,大多数作者都答不上来。所以我们进行了测试。我们模拟了18,000个双样本孟德尔随机化研究,涵盖六种不同的多效性机制,并在两个独立编写的程序中分别运行了两次,观察每种估计量的表现。结果发现,这四种估计量都恰好存在一种自身能够应对的失效情况,而其他失效情况则无法应对。而且,有一种机制同时打破了所有四种估计量的有效性,所有诊断结果都显示一切正常。
用简单的话
基因变异本应只通过改变你正在研究的那一个因素来影响疾病。而多效性则是指它还会通过不同的途径产生其他影响,而这第二条途径会悄无声息地干扰你的结果。人们使用的四种统计方法并非对同一问题的四种不同意见。每一种方法都是对这种干扰模式的一种猜测:它会相互抵消,它会朝着某个方向发展,大多数变异是纯净的,或者最常见的答案才是正确的。如果你的数据与这种猜测相符,那么该方法就有效。如果不符,该方法就失效了,而且这种失效是悄无声息的。四种方法都得到相同的结果固然令人欣慰,但这仅仅意味着这四种猜测恰好都以相同的方式失效了。
四位预测者究竟押注的是什么?
水平多效性是指排除性限制失效,这是工具变量法的第三个假设,也是无法直接检验的假设。某个变异体通过一条不经过你暴露组的路径影响结果,因此基于该变异体的比率估计是错误的。之所以存在三种稳健估计量,是因为不同的研究者对这些错误比率的分布方式做出了不同的假设。
- 逆方差加权 它假定所有工具都是有效的。它是目前最精确的估计方法,但它完全无法抵御多效性。
- 艾格先生从 Bowden、Davey Smith 和 Burgess (2015)该方法允许在变异-结果对变异-暴露效应的回归分析中加入截距项。它仅假设多效性效应与工具变量的强度无关,即InSIDE假设。在InSIDE假设下,即使所有工具变量都无效,该方法仍然成立。
- 加权中位数从 Bowden 及其同事 (2016)该方法假设分析中至少一半的权重来自有效工具变量。低于此阈值,该方法具有一致性。高于此阈值,则无法保证其有效性。
- 加权模式从 Hartwig、Davey Smith 和 Bowden (2017)假设最大的相似比率估计值集群来自有效的工具变量。这就是零模态多效性假设,即使大多数工具变量无效,只要无效的工具变量彼此不一致,该假设仍然成立。
这是四种不同的条件,而不是同一种条件的四种强度。关于设计本身的背景信息,请参阅我们关于孟德尔随机化及其操作方法的指南;而其背后的估计机制,请参阅我们关于工具变量和两阶段最小二乘法的解释性文章。
我们模拟了什么,以及如何检查它
每项模拟研究均包含 30 个独立工具变量,这对于一项经过充分研究的暴露因素而言是一个合理的数量。真实的变异-暴露效应均匀分布在 0.03 到 0.10 之间,标准误差为 0.005,因此每个工具变量都具有很强的效力,工具变量的效力不足并非此处检验的重点。变异-结局效应的标准误差为 0.003。真实的因果效应始终为 0.20。
多效性是指对结果产生的额外影响,这种影响并非直接通过暴露因素传递。我们进行了六种实验方案:
- 无多效性。 所有仪器均有效。控制条件。
- 平衡多效性。 多效性效应服从以零为中心的正态分布。它们平均而言会相互抵消,因此 InSIDE 成立。
- 方向性多效性。 多效性效应都朝着同一个方向发展,以正值为中心。InSIDE 仍然成立。
- 30%的票据无效。 十个变体中有七个是干净的,十个变体中有三个具有很大的多效性。
- 60%的票据无效。 同样的情况也发生在加权中位数规定的崩溃点之后。
- InSIDE 系统遭到破坏。 多效性效应与仪器的强度成正比,因此强度更高的仪器携带的污染物比例也更高。
每个方案进行 3000 次重复研究,每个引擎进行 18,000 次研究,四种方法共计 72,000 个因果估计值。以下所有数据均计算两次:一次使用 R 语言,通过加权回归计算。 lm() 以及R自己的 density() 对于模式,我们先在 Python 中使用不同的随机数生成器,并利用充分统计量,在不共享任何代码的情况下,计算了相同的量。在编写任何代码之前,我们比较了这两种结果。我们对每个数据都采用这一标准,正如我们在演练中所展示的那样。 NHANES调查权重能解决和不能解决哪些问题 以及我们的模拟 F统计量究竟告诉了你什么.
平衡多效性不会影响 IVW,但它会破坏其间隔。
首先,我们来看大多数作者认为良性的情况。当多效性效应围绕零对称分布时,通常的建议是逆方差加权法仍然是无偏的。这个建议是正确的,但它也存在严重的缺陷。
在3,000项具有平衡多效性的研究中,IVW估计值的中位数为0.200,与真实效应值0.200相符。完美。在同样的3,000项研究中,95%置信区间包含真实效应值的比例从无多效性情况下的94.5%下降到42.8%。近六成论文报告的置信区间不包含正确答案。
点估计值是正确的,但置信区间是错误的。平衡多效性增加了固定效应标准误差无法捕捉到的方差,因此置信区间对于实际存在的信息而言过窄。同时,MR-Egger截距检验仅在5.5%的研究中触发,这是其假阳性率。它的表现是正常的,因为不存在需要检测的方向性成分。标准敏感性分析模块中没有任何指标会对此发出警告。四个估计值一致,多效性检验结果为零,置信区间出错的次数多于正确的次数。
这与我们反向的弱工具变量模拟得出的结论相同。在弱工具变量模拟中,工具变量强度低导致区间过宽;而在这里,未建模的异质性导致区间过窄。在这两种情况下,点估计值看起来都不错,问题出在不确定性声明上。Cochran's Q 检验和随机效应 IVW 模型是标准的响应方法,而这正是它们的用途所在。
每个估计器都能从不同的故障中幸存下来

| 政权 | IVW | 艾格先生 | 加权中位数 | 加权模式 | 埃格尔拦截火 |
|---|---|---|---|---|---|
| 无多效性 | 0.199 | 0.190 | 0.199 | 0.198 | 7.0% |
| 平衡,InSIDE 持有 | 0.200 | 0.194 | 0.201 | 0.201 | 5.5% |
| 定向,InSIDE 持有 | 0.283 | 0.188 | 0.276 | 0.271 | 68.2% |
| 30%的无效仪器 | 0.283 | 0.188 | 0.222 | 0.201 | 17.1% |
| 60%的无效仪器 | 0.367 | 0.190 | 0.374 | 0.352 | 41.7% |
| InSIDE 违规 | 0.298 | 0.283 | 0.297 | 0.296 | 8.3% |
方向性多效性是MR-Egger的机制,而且只有MR-Egger的
当所有仪器的污染方向相同时,IVW 的估计值为 0.283,而真实值为 0.200,高估了约 42%。加权中位数估计值为 0.276,加权众数估计值为 0.271。这三种方法都严重错误,而且它们同时错误,这恰恰是作者会解读为令人安心的一致性模式。MR-Egger 估计值为 0.188。它是唯一针对这种情况设计的估计器,因为方向性多效性正是 Egger 截距所吸收的。
截距检验在 68.2% 的研究中检测到了问题。这意味着大约三分之一的研究中存在方向性多效性,导致主要估计值偏差达 42%,而旨在检测这种多效性的检验却未能发现问题。MR-Egger 检验的低效能已得到充分证实,而这正是其在实践中需要付出的代价。
少数无效工具是中位数和众数。
由于30%的仪器无效,情况发生了逆转。IVW的误差仍然为0.283。加权中位数恢复了0.222,加权众数恢复了0.201,两者基本一致。两者都发挥了其设计用途。Egger截距仅在17.1%的研究中触发,略高于其假阳性率,因为受污染变异株的集中聚集并不会表现为仪器集上的方向性偏移。之前能够识别出这种模式的测试,在此次测试中几乎是盲目的。
超过 50% 后,加权中位数不仅失效,而且比 IVW 失效得更厉害。
当60%的工具变量无效时(超过了该方法作者明确指出的失效点),加权中位数返回0.374,IVW返回0.367。稳健估计量与真实值的偏差比它本应防范的简单估计量还要大。这并非该方法的缺陷,而是超出其既定条件使用该方法的必然结果。值得一提的是,读者在结果表中看到加权中位数时,无法判断该研究的结果是否处于该阈值的哪一侧。
加权模式不会平滑降级,而是会突然翻转。
我们的结果中有一个数值无法重现。在 60% 无效样本的情况下,R 引擎报告的中位数加权众数为 0.352,而 Python 引擎报告的中位数加权众数为 0.336。本文中所有其他数值在两种引擎之间均吻合,精确到小数点后三到四位。这一差异促使我们重新审视估计器的完整抽样分布,而不是其汇总分布。
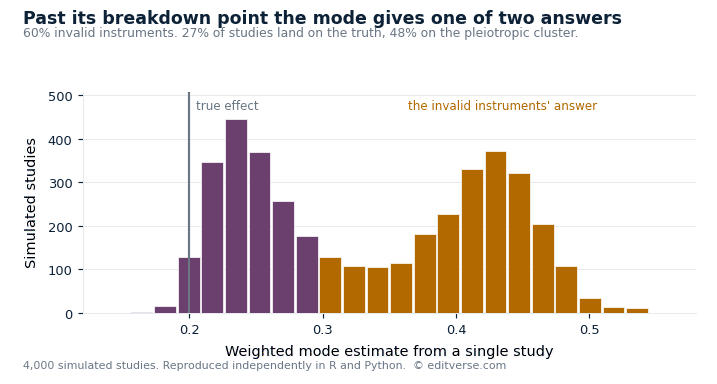
分布范围不宽,呈双峰分布。在27%的研究中,众数与真实效应值相差在0.05以内;在48%的研究中,众数高于0.35,落在由无效工具变量构成的聚类中。随着条件恶化,估计量并非趋向错误答案,而是在两个答案之间进行选择,最终返回哪个答案取决于抽样结果。
重复测量的四分位距在数值上也印证了这一点。当无效样本比例为30%时,四分位距为0.016;当无效样本比例为60%时,四分位距为0.177,跃升了11倍;而其他所有比例下众数的四分位距均介于0.016和0.030之间。两个运行正常的程序对该分布的中位数存在分歧,这并非需要调和的矛盾。这是对一个没有稳定中心值的量的正确解读,也与我们在弱工具变量工作中记录的比率估计量均值无法收敛的现象相同。
实际后果显而易见。在这种模式下,单项研究只能得出一个众数估计值,却无法指出该估计值来自哪个峰值。研究人员在报告该估计值时,大约有四分之一的概率报告了真实情况,而有二分之一的概率报告了污染情况,而且该数值本身也无法表明究竟是哪种情况。
估算器无法发现的失误
迄今为止,所有模型都有一个共同点:多效性效应与工具变量的强度无关。这是InSIDE模型的假设,MR-Egger模型完全依赖于此假设。因此,我们打破了这一假设。在最终模型中,每个变异体的多效性效应与其对暴露的影响成正比,这正是工具变量通过共同的上游生物学通路而非无关通路发挥作用时的结果。
假设真实效应为 0.200,四种估计方法得出的结果分别为0.298、0.283、0.297 和 0.296。每种估计方法都高估了效应约 50%。它们彼此之间的一致性在 0.015 以内。MR-Egger 截距检验在 8.3% 的研究中呈阳性,与完全不存在多效性时 7.0% 的假阳性率在统计学上没有显著差异。Cochran's Q 检验也未发现任何异常,因为比率估计值不存在异质性。它们一致且一致地错误。
对于孟德尔随机化(MR)论文的撰写而言,这个结果至关重要。标准的敏感性分析模块会报告四个估计值,指出它们的一致性,并报告一个零多效性检验结果。在这种情况下,它会产生完全相同的输出结果,而因果估计值则被放大了一半。四个估计值之间的一致性并不能证明工具变量有效。它只能证明这四个估计值的假设同时失效,或者它们都成立。无论哪种情况,输出结果看起来都一样。
区分这两种可能性的关键不在于估计器的数量,而在于工具变量本身的生物学论证:它们位于哪些基因中,这些基因还有哪些其他功能,以及是否存在共同的上游通路。这正是工具变量PheWAS的意义所在,也是Verbanck及其同事(2018)在他们检验的显著因果关系中,超过48%的基因存在可检测的水平多效性的原因。同样,Slob和Burgess(2020)在广泛的模拟网格中比较了九种稳健的方法后得出结论:没有哪一种方法占绝对优势,选择哪种方法取决于特定暴露情况下哪种违规行为是合理的。
稳健性并非免费。
MR-Egger 在我们六个试验阶段中的五个阶段都存活了下来,这似乎表明它应该成为主要的分析方法。但精确度数据却表明并非如此。
| 政权 | IVW 扩散 | MR-Egger 扩散 | 埃格尔罚球 |
|---|---|---|---|
| 无多效性 | 0.012 | 0.040 | 宽度增加 3.5 倍 |
| 平衡,InSIDE 持有 | 0.038 | 0.131 | 宽度增加 3.5 倍 |
| 30%的无效仪器 | 0.019 | 0.127 | 宽度增加 6.5 倍 |
3,000 项重复研究的估计值四分位距。MR-Egger 的稳健性使其估计值分布范围比 IVW 宽三到六倍,即使完全不存在多效性,它也存在轻微的向下偏差,在对照条件下,其估计值为 0.190,而真实值为 0.200。以 MR-Egger 为主导的分析实际上是用一个偏差问题换取了一个统计功效问题,这是一种实实在在的权衡,而非免费的升级。其可靠性还取决于测量工具的测量精度,而Bowden 等人 (2016)提出的 I²-GX 统计量正是衡量这一精度的指标。较低的 I²-GX 值意味着你所依赖的 Egger 估计值本身就不可靠。
应该如何报告才能替代“各种方法得出的估计结果一致”这种说法?
这句话本身没错,只是信息量不足,因为我们最终的结论是,答案被夸大了一半。方法论审查员关注的重点则不同。
- 指出每种方法所依赖的假设。 每个方法各设一个条款。IVW 假设所有工具变量均有效,MR-Egger 假设 InSIDE 有效,加权中位数假设无效权重不超过一半,众数假设最大聚类有效。这能让读者了解你的稳健性评估工具实际涵盖哪些内容。
- 请说明您认为可能导致您面临风险的违规行为是什么,并说明原因。 这是一个生物学论点,而不是统计学论点,正是这一点将深思熟虑的分析与模板式的分析区分开来。
- 报告异质性,并采取行动。 Cochran's Q 检验采用随机效应 IVW 模型,其中 Q 值显著。我们的平衡多效性结果显示,固定效应区间有 42.8% 的概率覆盖真实值,而每个点估计值看起来都正确。
- 报告 I²-GX 统计量以及任何 MR-Egger 估计值。 如果没有它,就无法解释埃格尔检验结果。
- 运行仪器 PheWAS 分析并报告分析结果。 这是解决 InSIDE 违规机制的步骤,也是大多数提交的 MR 论文都会跳过的步骤。
- 与其掩盖分歧,不如坦诚地表达出来。 IVW 值较高,而中位数和众数彼此接近,这表明存在少数无效工具变量。如果所有四个变量都同步变化,而 Egger 截距保持为零,则表明要么存在有效的工具变量,要么存在共同的路径,而只有生物学因素才能区分这两种情况。
- 国家机器的强度也同样重要。 以上所有内容都假设仪器性能良好。我们的配套模拟…… F统计量究竟告诉了你什么 涵盖了当它们不在那里时会发生什么。
STROBE -MR声明已经要求做到大部分这些。差距在于实际执行情况,而非记录内容。Rosas -Chavez和Merriman(2025)评估了2016年至2024年间发表的86项关于高尿酸血症和痛风的双样本孟德尔随机化研究,发现其中17%满足了所有三个核心工具变量假设,14%尝试了任何形式的重复验证,而2021年后发表的论文中只有11%符合STROBE-MR规范。我们的STROBE观察性研究报告指南涵盖了该指南,而我们对流行病学因果推断的概述则将这种研究设计列为备选方案之一。
孟德尔随机化研究的专业支持
上述电池是我们标准运行的组件,其中最重要的部分是那些能够解决所有估计器都无法捕捉到的缺陷的部分:使用表型组资源进行工具变量PheWAS分析、Steiger过滤以及在独立结果GWAS中进行重复验证。如果工具变量共享一个合理的上游通路,我们会在论文中明确指出,而不是直接报告四个一致的数值,让读者误以为问题已经解决。
可行性检查
$450
在您决定委托研究之前,我们会核实仪器数量、F统计量、样本重叠情况以及现有文献。您可以书面通知我们继续、修改或终止研究。您之后委托的任何研究都将获得全额抵扣。5个工作日内完成。
双样本MR
$2,900
基于公开的 GWAS 汇总统计数据的完整研究:四种估计方法、MR-PRESSO、Steiger 滤波、仪器 PheWAS、留一法交叉验证,以及完整的 STROBE-MR 清单和可运行的 R 代码。15 个工作日。
扩展设计
从澳元3,500
多变量孟德尔随机化(MR),包括条件F统计量、中介孟德尔随机化、共定位孟德尔随机化、药物靶点孟德尔随机化和非线性孟德尔随机化。所有报价和工作范围均在开始前以书面形式确定。
如果您仍在纠结于基因设计还是调查、癌症登记或创伤登记分析,我们的《研究应使用哪个健康数据库》指南详细列出了每种数据源能够回答和不能回答的问题。即使所有四种估计方法的结果都一致,稳健性检验也无法说明研究本身是否有足够的统计效力来检测出效应,而这正是我们另一篇文章《为什么孟德尔随机化论文会被直接拒稿》的主题。
Editverse提供的免费研究工具
关于孟德尔随机化中多效性的常见问题
如果四位评估者意见一致,我的结果是否安全?
不。一致性是必要的,但并非充分条件。在我们的 InSIDE 违规机制下,所有四个估计器返回的值彼此相差不到 0.015,并且所有四个估计器都高估了真实效应约 50%,而 MR-Egger 截距检验的假阳性率则处于其背景水平。一致性排除了一些失效模式,但对其他失效模式却无能为力。
哪种估计方法应该作为主要分析手段?
几乎所有情况下都采用逆方差加权法,并将稳健方法作为敏感性分析。逆方差加权法的精确度远高于其他方法,而MR-Egger方法的误差范围是其三到六倍。只有当您有明确理由预期存在方向性多效性时,才应优先使用MR-Egger方法,并且需要说明具体理由。
当 IVW 值较高但加权中位数和众数较低时,这意味着什么?
这种模式与少数强无效工具变量的情况相符,而这正是中位数和众数所针对的情况。建议使用 MR-PRESSO 来识别异常值,并进行留一法交叉验证以确认没有单个变异导致结果异常。请分别报告包含和不包含标记变异的分析结果。
平衡多效性真的无害吗?
不适用于您的置信区间。在我们的模拟中,IVW 点估计在平衡多效性下是无偏的,但区间覆盖率从 94.5% 下降到 42.8%。使用 Cochran's Q 检验异质性,并在异质性显著时使用随机效应模型,否则所报告的精度是虚构的。
实践中哪些因素会打破 InSIDE 假设?
工具变量通过共享的上游生物通路发挥作用,因此,对暴露影响较大的变异体也会通过该通路产生相应比例的更强影响。当工具变量聚集在功能相关的基因中时,这种可能性最大;而当它们分散在不相关的生物学通路中时,这种可能性最小。这是一个关于您具体工具变量的问题,任何统计检验都不能替代对它们的直接观察。
加权中位数可以容忍多少个无效仪器?
权重最多占一半,而非数量减半。权重取决于工具变量的强度,因此少量强度较高的无效工具变量可能占据超过一半的权重,尽管它们在变异表中看起来只是少数。在我们 60% 无效工具变量的条件下,加权中位数为 0.374,而真实值为 0.200,这比 IVW 的 0.367 与真实值偏差更大。
结语
在两个独立程序中重复进行的 72,000 次模拟孟德尔随机化估计中,四种估计方法的敏感性测试结果与其说是稳健性阶梯,不如说是四次独立的赌博。MR-Egger 是唯一能够克服方向性多效性的方法。加权中位数和众数是仅有的能够克服少数无效工具变量的方法,但一旦无效工具变量变为多数,中位数的表现就比 IVW 更差。众数与其说是在其失效点之后性能下降,不如说是在两个答案之间摇摆不定,这就是为什么两个诚实的程序在众数的计算结果上存在分歧,而在其他所有方面都一致的原因。
值得写入论文的发现是最后一个。当InSIDE假设不成立时,所有四个估计器的结果都一致,多效性检验没有结果,因果估计值被高估了一半。此时的输出结果与干净的分析结果并无二致。没有其他估计器可以解决这个问题,因为问题并非统计学上的。问题在于工具变量是否可能通过共同的通路最终导致结果,而回答这个问题需要考察基因的实际功能。仅仅描述不同方法的估计结果一致,是对软件输出的描述。审稿人真正想要的是其背后的论证。
案例
- Bowden J、Davey Smith G、Burgess S. 孟德尔随机化与无效工具:通过 Egger 回归进行效应估计和偏差检测。 国际流行病学杂志. 2015;44(2):512-525. doi:10.1093/ije/dyv080
- Bowden J、Davey Smith G、Haycock PC、Burgess S. 使用加权中位数估计器对孟德尔随机化中的一些无效工具进行一致估计。 遗传流行病学. 2016;40(4):304-314. doi:10.1002/gepi.21965
- Hartwig FP、Davey Smith G、Bowden J. 通过零模态多效性假设对汇总数据进行稳健推断孟德尔随机化。 国际流行病学杂志. 2017;46(6):1985-1998. doi:10.1093/ije/dyx102
- Bowden J、Del Greco MF、Minelli C、Davey Smith G、Sheehan NA、Thompson JR。使用 MR-Egger 回归评估汇总数据对双样本孟德尔随机化分析的适用性:I² 统计量的作用。 国际流行病学杂志. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Verbanck M、Chen CY、Neale B、Do R. 从孟德尔随机化推断的复杂性状和疾病之间的因果关系中检测广泛的水平多效性。 “自然遗传学. 2018;50(5):693-698. doi:10.1038/s41588-018-0099-7 (PMID 29686387)
- Slob EAW,Burgess S. 使用汇总数据对稳健孟德尔随机化方法进行比较。 遗传流行病学. 2020;44(4):313-329. doi:10.1002/gepi.22295 (PMID 32249995)
- Skrivankova VW、Richmond RC、Woolf BAR 等。加强使用孟德尔随机化流行病学观察性研究的报告:STROBE-MR 声明。 JAMA. 2021;326(16):1614-1621. doi: 10.1001 / pit.2021.18236
- Rosas-Chavez F, Merriman TR.孟德尔随机化研究:质量评价指标。 痛风、尿酸盐和晶体沉积病。 2025; 3(2):8。 doi:10.3390/gucdd3020008 (PMID 42487900)
模拟详情:每项研究使用 30 个独立工具变量;真实变异-暴露效应均匀分布在 0.03 至 0.10 之间,标准误差为 0.005;变异-结局效应的标准误差为 0.003;真实因果效应为 0.20;每个处理组进行 3,000 次重复研究。平衡多效性分布取自 N(0, 0.010);方向性多效性分布取自 N(0.006, 0.003);无效工具变量处理组取自 N(0.020, 0.005),并随机应用于 30% 或 60% 的变异;InSIDE 违规将多效性效应设置为每个变异暴露效应的 0.10 倍。加权众数采用 Hartwig 等人的核密度方法计算,带宽参数为 1。分别在 R 4.3.3 和 Python 3(使用 NumPy)中独立实现。除了 60% 无效状态下的中值加权模式外,所有报告的数量在发动机之间均在蒙特卡罗误差范围内一致,其抽样分布是双峰的,如上所述。