发布日期:|最后更新日期
一致性界限法,也称为 Bland-Altman 分析,是判断两种测量方法是否可以互换使用的标准方法。Bland 和 Altman 的原始论文于 1986 年发表在《柳叶刀》杂志上,已被引用数万次:截至 2026 年 10 月 28 日,OpenAlex 记录了 47,910 次引用,Crossref 记录了 38,854 次引用 [1]。本指南展示了基于原始峰值流量数据的计算过程,并将每个数值与 Bland 的原文进行比对,并解释了结果的意义和局限性。
本页内容:相关性分析失败的原因·计算方法·示例·如何解读·报告生成·相关方法·常见错误·常见问题解答
为什么相关性和回归分析不足以进行方法比较
Bland 和 Altman 列举了相关系数测量错误事物的几个原因。相关性反映的是关系的强度,而非一致性。显著性检验与一致性无关,因为如果两种旨在测量同一量的方法彼此无关,那才令人惊讶。而且,即使数据一致性很差,也可能产生很高的相关性[1,2]。
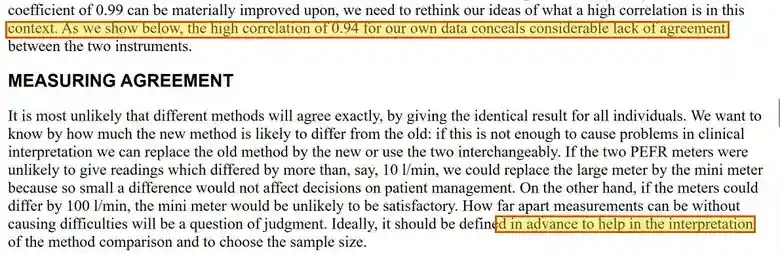
他们的例子值得了解。两种测量胎龄的方法相关性为0.85,尽管一种方法测得的35周胎儿,用另一种方法测得的胎龄范围却在34周到39.5周之间。另一组研究人员测试了两个Wright峰值流量计,它们的相关性分别为0.992和0.996(当两个流量计串联起来测量相同的流量时)。而在他们自己的数据中,0.94的相关性掩盖了相当大的不一致性(图1)[2]。
如何计算协议界限
对于每个科目,用一种方法的结果减去另一种方法的结果,然后取两次结果的平均值。接着处理这些差值。
- 区别: d = 方法 A 减去方法 B,适用于所有科目。明确方向并保持不变。
- 这对样本的平均值: 横轴为 (A + B) / 2。Bland 和 Altman 建议将差值与两种方法的均值作图,因为单独与其中一种方法作图会引入统计假象 [2]。
- 偏压: 差值的平均值,记为 d-bar。
- 差: 差值的标准差 s。
- 协议范围: d-bar − 1.96 秒和 d-bar + 1.96 秒。
- 精确: d-bar 的标准误差为 s 除以 n 的平方根。每个限值的标准误差都较大:Bland 和 Altman 在 1986 年给出了约 3s²/n 的平方根,并在 1999 年给出了更精确的形式,即 s²(1/n + 1.96²/(2(n−1))) 的平方根 [2,3]。置信区间使用自由度为 n−1 的 t 分布。
一个常被忽略的细节:1986 年的论文将乘数四舍五入为 2,但其文本中也给出了 1.96。1999 年的论文使用了 1.96 [2,3]。两种方法都可行;请说明您使用的是哪一种。
该方法假设差异值大致服从正态分布,且其分布范围不随测量值的大小而变化。可通过直方图和图表[1,3]进行验证。如果分布范围随数值增大而扩大,通常采用对数变换(将限值转换为比率)来解决这个问题。
实例:两台峰值流量计,17 名受试者
Bland 和 Altman 对 17 名受试者进行了研究,比较了大型 Wright 峰值流量计和小型 Wright 流量计的使用情况,每位受试者均使用两种流量计测量两次。方法比较仅采用每种流量计的第一次读数;第二次读数用于研究重复性 [2]。下表列出了每位受试者的第一次读数、差值和平均值。
| 咨询内容 | 赖特(升/分钟) | 迷你 Wright(升/分钟) | 差值(Wright − mini) | 两者的平均值 |
|---|---|---|---|---|
| 1 | 494 | 512 | - 18 | 503 |
| 2 | 395 | 430 | - 35 | 412.5 |
| 3 | 516 | 520 | - 4 | 518 |
| 4 | 434 | 428 | 6 | 431 |
| 5 | 476 | 500 | - 24 | 488 |
| 6 | 557 | 600 | - 43 | 578.5 |
| 7 | 413 | 364 | 49 | 388.5 |
| 8 | 442 | 380 | 62 | 411 |
| 9 | 650 | 658 | - 8 | 654 |
| 10 | 433 | 445 | - 12 | 439 |
| 11 | 417 | 432 | - 15 | 424.5 |
| 12 | 656 | 626 | 30 | 641 |
| 13 | 267 | 260 | 7 | 263.5 |
| 14 | 478 | 477 | 1 | 477.5 |
| 15 | 178 | 259 | - 81 | 218.5 |
| 16 | 423 | 350 | 73 | 386.5 |
| 17 | 427 | 451 | - 24 | 439 |
这 17 对数据与 Bland 页面上的表格相符,该表格于 2026 年 10 月 28 日捕获 [2]。从中可以看出:平均差值为 −2.1 L/min,差值的标准差为 38.8 L/min,两个仪表的相关性为 0.94 [2]。
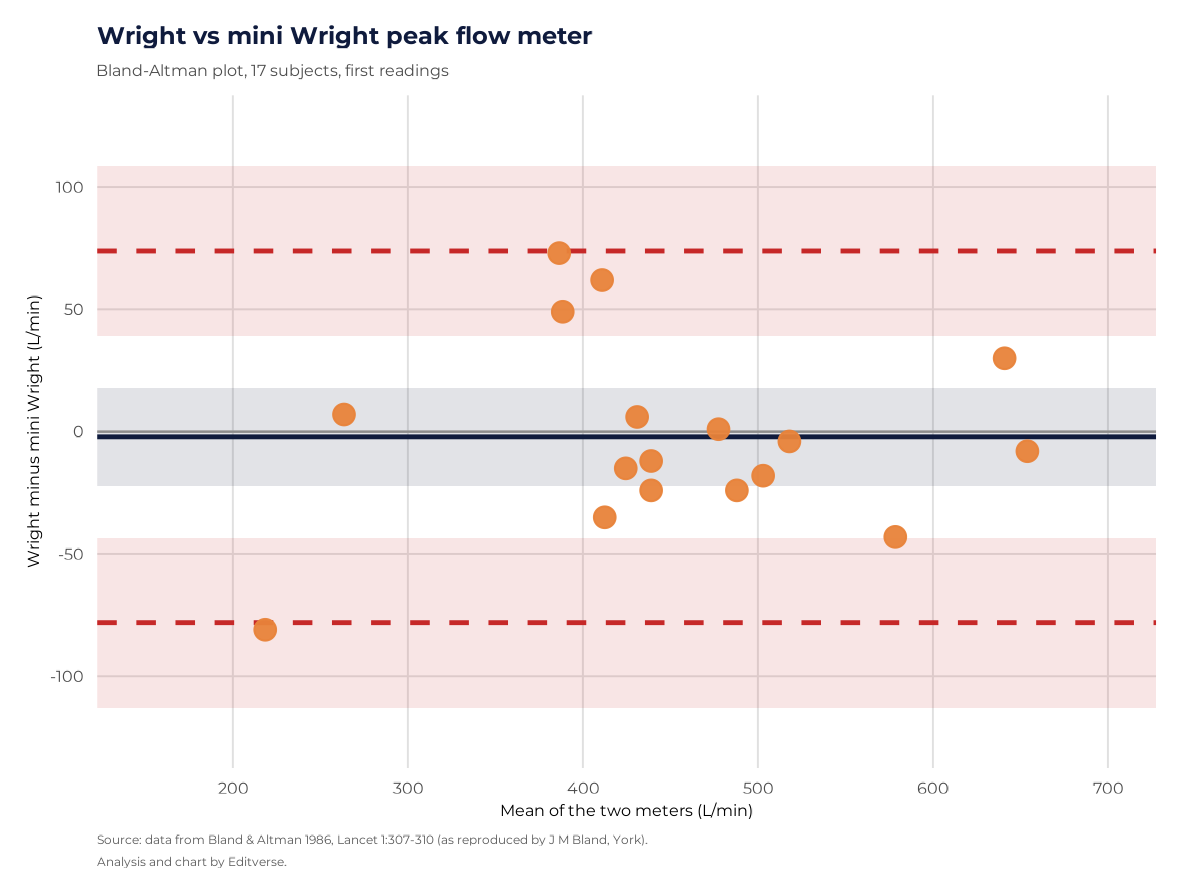
使用 1.96 倍的乘数时,一致性界限为 -78.1 至 73.9 L/min。图 2 绘制了每个受试者的数据,包括偏差线、界限以及每个受试者的 95% 置信区间(阴影部分)。
现在将这些数据与 Bland 和 Altman 发表的数据(图 3)进行比对。偏差和标准差完全一致,偏差的置信区间也完全一致。界限的差异仅在于 1986 年的文献使用了 2 个标准差,得到 -79.7 至 75.5 L/min,而我们使用了 1.96 个标准差 [2]。
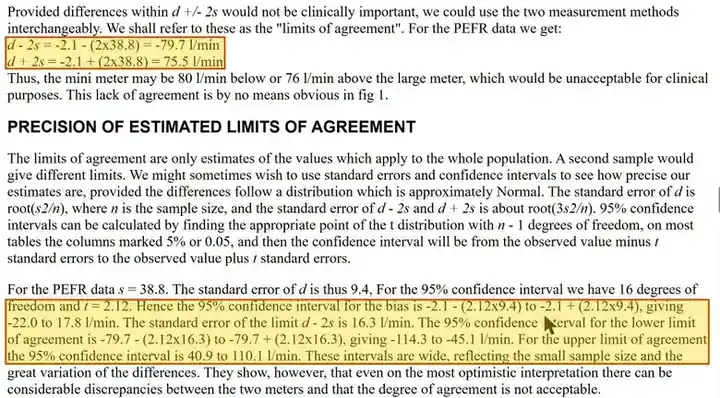
| 流量(升/分钟) | 我们的计算 | 由 Bland(约克郡版)出版 | 它们为何不同 |
|---|---|---|---|
| 平均差异(偏差) | - 2.1 | - 2.1 | 同 |
| 差异的标准差 | 38.8 | 38.8 | 同 |
| 协议的界限 | −78.1 至 73.9(1.96 个标准差) | −79.7 至 75.5(2 个标准差) | 乘数:此处为 1.96,1986 年的论文中为 2 |
| 偏差的 95% 置信区间 | -22.0 至 17.8 | -22.0 至 17.8 | 同 |
| 95% 置信区间下限 | -112.9 至 -43.3 | -114.3 至 -45.1 | 不同的乘数和标准误差公式 |
| 95% 置信区间,上限 | 39.1到108.6 | 40.9到110.1 | 不同的乘数和标准误差公式 |
我们采用 1999 年的标准误差公式和 1.96 个标准差 [3] 来计算极限的置信区间;已发表的置信区间则采用 1986 年的近似值和 2 个标准差 [2]。结论相同。
如何解读结果
偏差。平均差异为−2.1 L/min,其置信区间为−22.0至17.8,包含零。没有证据表明各仪表之间存在系统性差异[2]。
范围。限值约为-78至74升/分钟。Bland和Altman得出结论,小型血糖仪的读数可能比大型血糖仪低80升/分钟或高76升/分钟,这对于临床应用来说是不可接受的,而且这种差异从两台血糖仪的对比图中很难看出[2]。一名受试者(编号15,Wright血糖仪读数为178升/分钟,小型血糖仪读数为259升/分钟,差值为-81升/分钟)的读数略微超出下限,这与涵盖95%差异的限值预期基本一致。
精确度。由于只有 17 个受试者,置信区间较宽:每个限值在其区间两端的误差约为 70 L/min。Bland 和 Altman 指出,即使在最乐观的解释下,不同测量仪之间也可能存在相当大的差异 [2]。这就是样本量至关重要的原因,这一点在关于一致性研究的新近研究中得到了详细阐述 [5,6]。
这项决定。大约 75 L/min 的读数差异是否可以接受,是一个临床判断,而非统计学判断。Bland 和 Altman 给出了一个简单的例子:如果两个血糖仪的读数差异不太可能超过 10 L/min,那么可以用小型血糖仪替换大型血糖仪;如果它们的读数差异可能达到 100 L/min,那么小型血糖仪就不太可能令人满意。测量值之间的差异在多大程度上不会造成问题,这是一个临床判断的问题,理想情况下应该事先确定 [2]。
同样的逻辑也适用于实验室。Fang及其同事使用80份患者血清构建免疫测定标准化算法,并使用40份血清进行验证,对算法进行了比较。基于Bland-Altman的算法得到的一致性界限为-23.3%至23.2%,而ISO 21151:2020标准[8]中采用的加权Deming回归方法得到的一致性界限为-64.6%至74.6%。Bland-Altman分析能够更清晰地展现剩余的差异,而仅使用斜率和截距则无法做到这一点。
报纸上应该报道什么
对已发表研究的综述不断发现同样的不足。Abu-Arafeh及其同事提出了13项关键报告特征,并检查了2013年和2014年发表在五种麻醉学期刊上的文章。他们发现,数据结构、偏差图和一致性界限几乎总是被报告,但对可接受界限的预先设定以及对界限精度的估计却常常缺失[4]。Gerke随后比较了七项已发表的报告规范,发现了相同的共识要点,并向研究人员、编辑和审稿人推荐了Abu-Arafeh的清单[5]。
根据这两篇评论,一份明确的协议文件报告如下[4,5]:
- 在收集数据之前,根据临床原因确定可接受的一致性限度;
- 数据结构:受试者数量、每个受试者的测量次数以及测量范围;
- 偏差及其 95% 置信区间;
- 两者的一致性界限及其 95% 置信区间;
- 图表显示了两种方法的差异与均值的关系;
- 你是如何检验正态性的,以及分布范围是否恒定的?
- 所使用的任何转换以及软件。
关于样本量,Gerke 及其同事在一篇社论中总结了最近的建议,包括方法比较和观察者变异性研究之间的区别[6]。早期的经验法则是每种方法至少需要 50 名受试者,并进行三次重复试验,或者至少需要 100 名受试者[5]。
当另一种方法更合适时
Bland-Altman 分析是多种一致性和可靠性评估工具之一。CLSI EP09 指南用于比较测量程序与患者样本,其中描述了用于检查数据的散点图和差值图,以及用于表征偏差的 Deming 回归和 Passing-Bablok 回归 [9]。对于重复测量,Taffé 扩展了关于临床耐受限度和一致性概率的研究;他的方法需要使用两种方法中的至少一种进行重复测量 [7]。
| EventXtra XNUMX大解决方案 | 付款方式 | 它告诉你什么 |
|---|---|---|
| 两种连续测量方法,每个受试者一对。 | Bland-Altman 一致性界限 | 偏差和个体分歧范围(以测量单位表示) |
| 两种方法,每个主题需多次阅读 | Bland-Altman 扩展用于重复试验,或容差限 | 考虑受试者内部差异的限度 |
| 你还想知道偏差是否会随着测量水平的变化而变化。 | Deming 或 Passing-Bablok 回归,以及差异图 | 恒定和比例偏差 |
| 两位评分者的序数评级 | 加权 kappa | 类别之间的协议 |
| 重复相同方法 | 重复性和可靠性指标,例如组内相关系数 | 一种方法的一致性如何? |
| 线性关系的强度 | 皮尔逊或斯皮尔曼相关性 | 关联,而非协议 |
要更全面地了解何时使用相关性或回归,请参阅我们的临床研究中回归与相关性指南。
免费工具,助您进行协议分析
Editverse的这些工具都是免费的,无需注册。
- Bland-Altman图计算器粘贴您的配对测量值,即可获得偏差、一致性界限和图表。
- GraphPro:创建可用于出版的图表,共 25 种类型,内置 t 检验、方差分析、相关性分析和卡方检验 p 值。免费,无需注册。
- 统计数据:免费的统计计算器和测试选择工具,涵盖组比较、分类结果、事件发生时间分析和诊断准确性。
- 流程图专业版:直接在浏览器中生成 PRISMA 2020、PRISMA-ScR、CONSORT、STROBE、STARD、MOOSE 和 ARRIVE 流程图。
Editverse 相关指南
请完成并撰写您的分析报告。
如果您需要为您的论文提供完整的协议分析、假设检验、表格和方法段落,那么这项服务正是为此而打造的。

需要对您的一致性研究进行检查或分析吗?一位拥有博士学位的生物统计学家将审查您的研究设计,进行假设检验分析,并为您的论文撰写统计方法部分,并提供 60 天的修改机会。
协议限制常见问题解答
协议的界限在哪里?
一致性界限是指两种测量方法之间的平均差异加上或减去1.96倍差异的标准差。如果差异大致服从正态分布,则未来两种方法之间的差异约有95%应落在该界限内[1,3]。
偏见和共识限度之间有什么区别?
偏差是指平均差异,即一种方法读数高于或低于另一种方法读数的平均量。一致性界限描述了围绕该平均值的离散程度,因此它显示了两种方法对同一患者结果的差异范围[1,3]。
为什么相关性不足以证明两种方法一致?
相关性衡量的是两组数值与一条直线的吻合程度,而不是它们彼此之间的接近程度。在最初的峰值流量示例中,相关性为 0.94,但对于同一个人,两个流量计的读数可能相差 80 升/分钟 [1,2]。
我应该使用 1.96 个标准差还是 2 个标准差?
两者都出现在文献中。1986 年的论文为了方便起见,使用了 2 个标准差作为四舍五入值,并指出 1.96 是更精确的乘数。1999 年的论文使用了 1.96 [1,2,3]。请说明你使用了哪一个。
Bland-Altman分析需要多大的样本量?
没有唯一的答案。置信区间的宽度取决于样本量,在包含 17 名受试者的示例中,每个限值的置信区间宽度约为 70 L/min。早期的经验法则建议至少需要 50 名受试者并进行三次重复实验,或者至少需要 100 名受试者,而较新的研究则基于预期的区间宽度来确定样本量 [5,6]。
我需要预先设定可接受的差异范围吗?
是的,如果你想声称双方达成一致的话。布兰德和奥特曼指出,测量值之间的最大间隔是多少才不会造成困难,这是一个临床判断,理想情况下应该事先定义[2]。对已发表研究的回顾发现,通常缺乏预先设定的界限[4,5]。
如果我的差异不服从正态分布,或者随着测量值的增大而增大,该怎么办?
检查直方图和差异与均值的关系图。常用的解决方法是对数变换,这样得到的限值是比率,或者基于差异百分位数的限值,但这需要更大的样本量[1,3,5]。
如果我对每个受试者进行重复测量呢?
标准公式假设每个受试者有一对样本。对于重复样本,可以使用专门构建的方法:Bland 和 Altman (1999) 提出了扩展方法,Taffé 描述了一种容差限值方法,该方法需要至少一种方法进行重复测量 [3,7]。
结语
一致性界限将“这两种方法是否一致”这个模糊的问题转化为一个以测量单位表示的范围。计算偏差和界限,给出它们的置信区间,绘制差异与两种方法均值的关系图,并将结果与您预先设定的临床阈值进行比较。正如原始峰值流量数据所示[2],高相关性无法完成这项工作。如需分析方面的帮助,请参阅我们的统计分析和审核服务。
案例
- Bland JM, Altman DG (1986). 评估两种临床测量方法一致性的统计方法。柳叶刀 1(8476):307-310。 10.1016/S0140-6736(86)90837-8
- Bland JM,Altman DG。评估两种临床测量方法一致性的统计方法:Lancet 论文在 Martin Bland 的页面上重现,约克大学,包括峰值呼气流量数据表(2026 年 10 月 28 日阅读和捕获)。 www-users.york.ac.uk/~mb55/meas/ba.htm
- Bland JM, Altman DG (1999). 方法比较研究中一致性的测量。统计方法医学研究 8(2):135-160。 10.1177/096228029900800204
- Abu-Arafeh A、Jordan H、Drummond G (2016)。方法比较研究的报告:建议回顾、当前实践评估以及对未来报告的具体建议。Br J Anaesth 117(5):569-575。 10.1093/bja/aew320
- Gerke O (2020). Bland-Altman一致性分析的报告标准:方法学评论综述。Diagnostics 10(5):334。 10.3390/diagnostics10050334
- Gerke O、Pedersen AK、Debrabant B、Halekoh U、Möller S (2022)。方法比较和观察者变异性研究中的样本量确定。J Clin Monit Comput 36(5):1241-1243。 10.1007 / s10877-022-00853-X
- Taffé P (2023). 使用临床耐受限度评估一致性。 Stat Methods Med Res 32(1):195-206。 10.1177/09622802221137743
- Fang H, Yang R, Guo J, et al. (2024). 使用基于 Bland-Altman 图的协调算法优化免疫测定的协调。临床化学与实验室医学 62(11):2205-2214。 10.1515/cclm-2024-0187
- 临床和实验室标准协会。EP09:使用患者样本进行测量程序比较和偏差估计,第3版(2018)。产品页面阅读日期:2026年10月28日。 clsi.org/shop/standards/ep09