
发布日期:|最后更新日期
当研究样本量过小,标准频率学派工具难以有效发挥作用;当早期研究已指出某个参数的合理范围;或者当需要同时绘制数百个小区域的疾病风险分布图时,流行病学家越来越多地转向贝叶斯方法。贝叶斯分析并非仅生成一个点估计值和一个p值,而是将已知的参数信息与新的研究数据相结合,并报告该参数的完整概率分布,而非单一数值。本文将详细介绍这一过程的机制,探讨贝叶斯方法在哪些具体的流行病学问题中能够发挥作用,介绍研究人员运行该方法的软件,并引用一项已发表的癌症监测研究,该研究展示了该方法在218个真实社区中的应用。
贝叶斯方法为流行病学带来了什么
在二十世纪的大部分时间里,频率统计学主导了医学研究,其核心是p值、置信区间以及严格禁止使用除当前数据集之外的任何数据。Goligher 、Heath和Harhay在2024年发表于《柳叶刀》的一篇方法综述中描述了贝叶斯统计学在临床研究中的应用。贝叶斯统计学将概率视为信念强度的度量,而非长期频率的度量,这使得研究能够正式地将先验信息与新数据相结合,从而为每个感兴趣的量生成更新的(或后验的)概率分布。现代计算技术消除了这种方法的主要实际障碍。曾经需要专用硬件才能完成的基于模拟的估计现在只需一台笔记本电脑即可运行,这正是贝叶斯方法在过去二十年中从一种少数派统计理念发展成为癌症监测、药物警戒和疫情建模等领域常规应用的重要原因之一。
贝叶斯定理与信念更新的逻辑
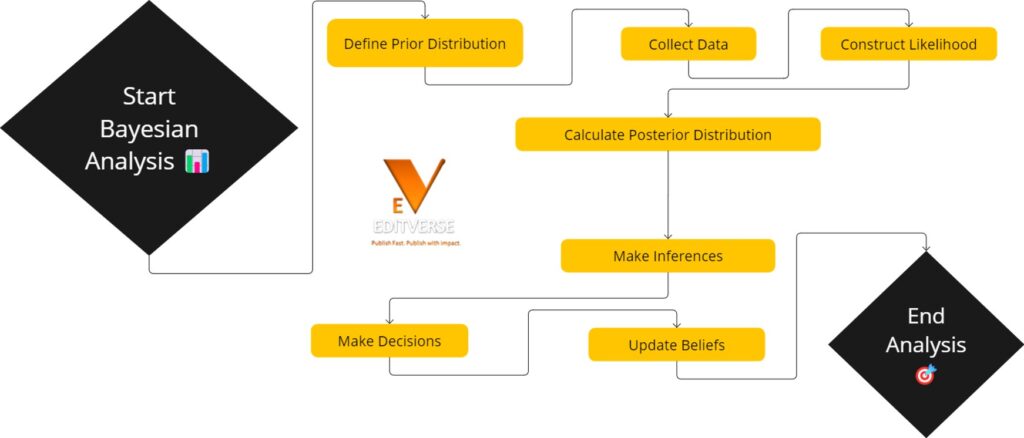
所有贝叶斯模型都基于同一个方程。贝叶斯定理指出,给定数据时参数的后验概率与给定该参数时数据的似然性成正比,再乘以该参数本身的先验概率。对于参数 θ 和观测数据 X,该关系式为 P(θ|X) ∝ P(X|θ) × P(θ)。这里主要由三个部分组成。先验概率 P(θ) 反映了在当前研究开始之前,关于该参数的已知信息或合理假设。似然性 P(X|θ) 描述了在参数的不同候选值下,观测数据出现的概率。后验概率 P(θ|X) 是结合前两者得到的更新分布,也是贝叶斯流行病学家实际报告和解释的对象。
贝叶斯定理本身比现代流行病学早了两个世纪。它以托马斯·贝叶斯的名字命名,这位牧师从未发表过该定理的成果。1763年,哲学家理查德·普莱斯在皇家学会宣读了包含该定理的论文,以纪念他去世。2014年,马丁内斯和阿奇卡尔在《公共卫生杂志》(Cadernos de Saúde Pública)上发表的一篇历史回顾文章指出, 2013年是该定理发表250周年,这标志着贝叶斯定理的诞生具有里程碑意义。在接下来的两个世纪里,频率学派的方法将贝叶斯方法推到了应用统计学的边缘,直到马尔可夫链蒙特卡罗计算使得复杂的后验概率变得可处理之后,贝叶斯方法才重新回到流行病学的常规应用。
实践中的先验概率、似然概率和后验概率
一个示例展示了无需完整数据集即可实现这一机制。假设卫生部门希望在进行任何本地检测之前,估算某个地区新发现的病原体的流行率。全国监测数据显示流行率约为 4%,但存在实际的不确定性,因此该团队将这一估计值编码为 Beta(4, 96) 先验分布,该分布以 4% 为中心,但允许的取值范围从远低于 1% 到超过 10%。随后,一项针对 200 名当地居民的调查发现了 14 例阳性病例。由于 Beta 分布是二项似然的共轭先验分布,因此后验分布也是另一个 Beta 分布,即 Beta(4 + 14, 96 + 186),计算结果为 Beta(18, 282),其中心值约为 6%,该值介于全国先验分布和本地数据之间,比例取决于两者各自包含的信息量。这些数字仅供参考,并非来自已发表的具体疫情,而是为了说明先验概率和似然概率如何通过算术运算组合成后验概率。
| 术语 | 它代表什么 | 流行病学示例 |
|---|---|---|
| 先前分布 | 在看到当前研究数据之前对某个参数的看法 | 根据之前一项全国性调查得出的区域患病率估计值 |
| 似然函数 | 不同参数值下观测数据的概率 | 在真实患病率的情况下,200 次检测中观察到 14 次阳性结果的概率 |
| 后验分布 | 结合先验概率和似然性后,更新了信念。 | 根据当地调查结果修订的地区患病率估计值 |
| 可信区间 | 包含具有给定后验概率的参数的范围 | 该地区真实患病率的95%可信区间 |
| 共轭先验 | 一个先验分布,与给定的似然函数结合,可以得到同一族的后验分布。 | 贝塔先验分布与二项似然函数配对,用于表示比例 |
| 马尔可夫链蒙特卡罗 | 一种从无闭式解的后验分布中采样的模拟方法 | 估计具有数百个参数的空间疾病分布模型 |
可信区间与置信区间
研究人员经常误解95%置信区间的含义,将其理解为真实值有95%的概率落入某个特定的计算范围内。实际上,置信区间仅保证在多次重复研究中,以此方法构建的区间中有95%会包含真实参数值,这描述的是整个过程,而非具体的区间本身。贝叶斯可信区间则准确地表达了人们希望置信区间表达的意思:在给定观测数据和先验分布的情况下,参数值有95%的后验概率落在所述范围内。Goligher、Heath和Harhay在2024年发表于《柳叶刀》的综述中详细阐述了这一区别,认为这是两种框架之间最重要的实际差异之一,因为它改变了如何向临床医生、期刊编辑和政策制定者合理地描述可信区间。
为什么流行病学家选择贝叶斯方法
小样本为贝叶斯方法提供了最清晰的例证。谢、罗尔卡和巴克在2025年发表于《数据科学杂志》的一项分析中,利用贝叶斯分层抽样加权零膨胀模型对县级罕见病患病率进行了建模,正是因为许多县的观察病例数太少,无法通过标准的基于调查的估计方法得出稳定的结果。儿科和罕见病试验也面临着类似的问题。特纳及其同事在2022年发表于《BMC医学研究方法》的一篇方法论文中,描述了如何在儿科HIV试验中利用贝叶斯分层模型来跨患者亚组借用信息,从而使小亚组的估计值能够从相关的亚组中获得统计效力,而不是仅仅依赖于少数参与者的数据。贝叶斯模型能够自然地处理这种部分合并的情况,因为每个组级参数本身都是从共享的总体分布中抽取的,而不是孤立估计的。
纳入真实的既往证据与处理小样本同样重要。当系统评价、早期试验或已确立的区域基线已经限定了某个参数的可能取值范围时,贝叶斯分析允许研究正式利用这些信息,而不是将其抛弃并从零开始重新估计所有参数——这更接近流行病学家在非正式情况下的推理方式。
嵌套人口数据的分层和多层模型
公共卫生数据很少局限于单一层级。患者聚集在诊所内,诊所聚集在地区内,地区聚集在国家内,而这种结构的每个层级都存在各自的变异来源。分层或多层贝叶斯模型能够明确地表示每个层级,允许各个诊所或地区的参数围绕一个共享的更高层级分布变化,而不是强制每个群体采用单一的固定效应,或者走向另一个极端,完全孤立地估计每个群体。对于规模较小或异常群体,其估计值会根据本地数据支持的多少而相应向总体平均值靠拢(或缩小),而数据丰富的群体则可以充分展现自身特征。正是这种缩小机制使得 Turner 及其同事能够从一项儿科试验中获得可用的亚组特异性治疗效果估计值,而该试验的规模太小,无法使用传统方法单独分析任何单个亚组。一本关于嵌套医疗数据多层建模的配套指南更深入地介绍了这种方法背后的固定效应和随机效应机制。
贝叶斯疾病地图绘制和小区域估计
在流行病学中,贝叶斯方法在绘制众多小区域疾病风险图谱方面始终优于其他更简单的替代方法。小区域的原始疾病发病率极不稳定,一个拥有3,000名居民的市镇,其发病率可能仅仅因为一年内新增两三例病例而出现剧烈波动。Besag-York-Mollié (BYM) 模型通过将非结构化随机效应与空间结构化效应相结合来解决这个问题,后者能够从地理相邻区域汲取能量,从而在保留真实高风险或低风险空间聚集区域的同时,平滑噪声。统计学家 Andrew Gelman 及其合作者在 2020 年发表于《空间与时空流行病学》(Spatial and Spatio-temporal Epidemiology)的一篇论文中,发布了 BYM 模型在 Stan 概率编程语言中的完整工作实现,使得该方法比最初所需的专用软件更容易被应用流行病学家所接受。Catelan、Lagazio 和 Biggeri 此前的一项研究构建了一个三级分层贝叶斯模型,用于研究 1995 年至 1999 年间意大利托斯卡纳 287 个市镇的肺癌死亡率。该模型利用后验分类概率来标记真正高风险的区域,同时控制了同时比较数百个小区域时出现的多重检验问题。空间和环境风险因素与此类建模的相互作用方式,将在另一篇关于公共卫生环境和空间统计的文章中进一步探讨。
一个实际案例:不列颠哥伦比亚省的小区域癌症地图绘制
2022年,卑诗省癌症中心的Simkin及其同事在《肿瘤学前沿》(Frontiers in Oncology)杂志上发表了一项研究,展示了将完整工作流程应用于真实监测数据而非模拟数据。该团队从卑诗省癌症登记处提取了2011年至2018年间卑诗省居民新发的肺癌、女性乳腺癌、宫颈癌和结直肠癌病例,然后使用改进的BYM2模型绘制了218个社区卫生服务区(CHSA)的风险分布图。间接年龄标准化方法计算了每个区域相对于全省平均水平的预期病例数和标准化发病率比值;Moran's I指数量化了相邻区域风险水平的相似程度;BYM2模型本身生成了每个区域的后验中位相对风险及其完整可信区间,在平滑不稳定的小区域病例数的同时,仍然能够识别出真实的局部聚集性病例。
| 癌症类型 | 2011-2018年事故案例 | 地理单元 |
|---|---|---|
| 肺 | 26,448 | 218个社区卫生服务区 |
| 女性乳房 | 28,466 | |
| 颈椎病 | 1,478 | |
| 大肠癌 | 25,457 |
这项研究的实际意义不仅在于其准确性,更在于其可及性。Simkin及其同事将完整的建模和绘图工作流程打包到开源的smallareamapp R包中,正是因为正如他们所指出的,各癌症登记处的技术能力仍然有限,而一个可复现的工具可以降低其他省级和州级登记处使用自身数据进行相同分析的门槛。
疾病监测和信号检测中的贝叶斯方法
药物警戒领域很早就采用了贝叶斯信号检测方法,远早于“贝叶斯”一词在流行病学领域普及。2009年,Bate 和 Evans在《药物流行病学与药物安全》杂志上发表的一篇方法综述描述了监管机构如何使用经验贝叶斯方法(例如经验贝叶斯几何均值)筛选自发性药物不良反应报告。该方法通过缩小噪声较大的原始报告比率,使其更保守地估计报告数量较少的药物-事件组合,从而减少误报,同时避免分析人员忽略罕见但真实的安全性信号。癌症监测在人群层面也呈现出类似的趋势。Wah、Ahern 和 Earnest 在《国际公共卫生杂志》上发表的一篇系统综述检索到 2014 年至 2018 年间发表的 38 项研究,这些研究将完全贝叶斯时空模型应用于癌症发病率和死亡率数据。这表明,药物警戒信号检测背后的相同缩小逻辑如今也应用于癌症登记系统,用于追踪癌症风险随时间和地点的变化。
贝叶斯流行病学软件
目前,大多数应用贝叶斯流行病学工作都依赖于四个平台。Stan 运行哈密顿蒙特卡罗抽样,是 Gelman 等人发表的 BYM 疾病地图实现的基础,能够高效地处理大型分层和空间模型,足以满足常规注册规模工作的需求。JAGS 是一个较早但仍被广泛使用的引擎,它采用吉布斯抽样,在流行病学课程和传统分析代码中仍然很常见。WinBUGS 在 20 世纪 90 年代率先推出了面向流行病学家的易于使用的 MCMC 软件,虽然大多数活跃项目已经迁移到 Stan 或 JAGS,但仍然偶尔会在一些较早发表的方法中出现。Paul-Christian Bürkner 开发的 R 包 brms 允许研究人员使用熟悉的 R 回归公式语法来指定 Stan 模型,这使得没有概率编程背景的流行病学家也能使用完整的贝叶斯分层建模。该包在 2021 年发表于《英国数学与统计心理学杂志》的一篇论文中被演示用于有序回归模型。一篇关于医学研究中回归模型的相关文章对回归方法进行了比较,包括贝叶斯调整如何改变答案。
马尔可夫链蒙特卡罗方法和收敛性检验
闭式后验分布仅适用于少数简单模型,因此大多数应用贝叶斯流行病学依赖于马尔可夫链蒙特卡罗方法(MCMC)。MCMC 是一类算法,它从一条旨在收敛于目标后验分布的马尔可夫链中抽取相关样本。从不同的起始值运行多条独立的链(通常至少三到四条)是标准做法,因为从不同起始点出发且结果相似的链可以直接证明收敛性,而链之间的差异则表明分析人员在信任任何报告的估计值之前需要解决一个问题。分析人员通常会舍弃初始的预热阶段,然后检查迹图、有时称为 R-hat 的潜在尺度缩减统计量以及有效样本量,以判断链是否充分探索了后验分布,以及所得估计值是否足够精确。复杂的层级和空间模型(例如疾病地图绘制中使用的模型)比简单的回归模型更容易出现混合缓慢和收敛问题,因此,在论文的方法部分,收敛性诊断至少应该与模型本身一样受到重视。
贝叶斯流行病学报告中的常见陷阱
在贝叶斯文献的某些领域,其应用速度已经超过了严谨的报告速度。Marks及其同事于2026年在BMC医学研究方法学上发表的一篇系统性综述,考察了已发表的贝叶斯随机临床试验中样本量的确定方法,发现尽管完全贝叶斯方法在理论上很受欢迎,但在实践中却很少被正确使用,许多试验只是借用了贝叶斯术语,其设计本质上仍然是频率学派的。在提交的稿件中,反复出现三个实际问题。首先,对不同合理先验分布的敏感性分析往往未被报告,导致读者无法判断所选先验分布对结论的实际影响程度。其次,MCMC链的收敛性诊断经常被完全省略,即使混合不良的链也可能产生看似可靠但实际错误的后验分布。最后,一些模糊不清、信息量不足的先验分布有时会被重新贴上“客观”的标签,却忽略了真正的平坦先验分布在小样本情况下仍然会对结果产生显著影响,而这恰恰是研究人员最初选择贝叶斯方法的场景。期刊统计审稿人会在接受贝叶斯分析之前检查这三点,而事先解决了这些问题的稿件在同行评审中遇到的重大修改要求要少得多。
Editverse 统计学家如何支持贝叶斯流行病学项目
指定合适的先验分布、构建与研究实际数据结构相匹配的层级或空间模型,以及诊断 MCMC 收敛问题,这些都需要丰富的贝叶斯建模实践经验,而许多论文在同行评审过程中却缺乏这些经验。Editverse 的生物统计团队直接与流行病学研究人员合作,共同完成先验分布的设定、Stan 和 brms 模型代码编写、收敛性诊断,以及方法部分语言的编写,以满足期刊统计审稿人的要求。这些期刊越来越重视贝叶斯方法的严谨性,而非照搬频率学派的惯例。Editverse的论文和统计分析服务涵盖从初始模型设定到最终提交论文的整个流程。此外,免费的统计检验选择器可以帮助读者在最终确定采用哪种方法之前,先确认贝叶斯方法或传统的频率学派检验更适合给定的数据集。

相关阅读:贝叶斯方法和流行病学方法
- 贝叶斯统计为初学者提供动力医学研究 以更温和的方式初步探讨相同的核心理念。
- 贝叶斯分析实践:自适应临床试验案例研究 这些工具改变的是试验设计,而不是监测。
- 因果推断对流行病学和公共卫生的影响 探讨贝叶斯框架和因果框架的交集。
- 传染病数据高级模型 适用于通常与贝叶斯估计相结合的非线性模型和隔室模型。
- 轻松进行功率分析 探讨频率学派和贝叶斯学派设计在样本量规划上的差异。
- Kaplan-Meier 生存分析 肿瘤学数据中贝叶斯生存模型的频率学派对应物。
常見問題解答
贝叶斯流行病学和频率学派流行病学的主要实际区别是什么?
频率学派分析仅基于当前研究的数据,得出点估计值、p 值和置信区间。贝叶斯分析则将这些数据与代表现有知识的先验分布相结合,然后报告完整的后验分布和可信区间,该可信区间可以直接解释为关于参数本身的概率陈述。
贝叶斯方法在流行病学中何时发挥最大作用?
对于小样本或罕见病样本、跨多个地理单元的小区域疾病地图以及诊所或地区嵌套在较大区域内的分层数据,贝叶斯分层模型在这些情况下明显优于传统的固定效应方法,这主要是因为它们对相关组应用了部分合并。
95%可信区间和95%置信区间是一回事吗?
不。可信区间表明,在给定数据和选定的先验分布的情况下,真实参数落在该区间内的后验概率为 95%。置信区间仅保证在重复研究中,以相同方式构建的区间中有 95% 包含真实值,这描述的是长期过程,而非所计算的特定区间。
流行病学家使用什么软件来运行贝叶斯模型?
Stan 和 R 包 brms 处理了当前大部分工作,JAGS 在教学和遗留代码中仍然很常见,而 WinBUGS 在 20 世纪 90 年代开创了该领域,但已被 Stan 等速度更快、更灵活的工具基本取代。
贝叶斯分析是否需要大量的先验数据才能发挥作用?
不。一项研究可以故意使用一个信息量极小的弱先验分布,让观测数据主导后验分布,这在缺乏强有力的先验证据时是一种常见的做法。即使在弱先验分布的情况下,这种方法仍然可以提供完整的后验分布和有效的置信区间。
审稿人如何评价投稿稿件中的贝叶斯分析?
统计审稿人通常会检查所选先验是否合理,并通过敏感性分析检验其影响,报告 MCMC 收敛性诊断(如 R-hat 和有效样本量),以及论文是否正确解释可信区间,而不是用从置信区间借用的频率学派语言来描述它们。