Yayınlanma tarihi: | Son güncelleme tarihi:
Ki -kare testi belirli bir soruyu yanıtlar: Bir dizi kategoride gözlemlenen sayılar, bağımsızlık veya belirtilen bir modelin öngördüğünden farklı mıdır? Karl Pearson bu testi 1900 yılında tanıttı ve epidemiyologlar hala her hafta gruplar arası maruz kalma oranlarını karşılaştırmak, genotip verilerindeki hataları taramak ve hastalık başlangıçlarının yıl boyunca eşit olarak yayılmak yerine mevsimlere göre kümelenip kümelenmediğini kontrol etmek için bu testi kullanıyorlar. Bu konudaki rakip kılavuzlar genellikle formülü tekrarlayıp orada duruyor. Burada, iki olasılık tablosu elle işleniyor, her sayı bağımsız istatistiksel yazılımlara karşı kontrol ediliyor ve kılavuz, ki-kare yaklaşımının ne zaman güvenilirliğini kaybettiğini ve bunun yerine Fisher'ın kesin testinin devreye girmesi gerektiğini tam olarak açıklıyor.
Önemli Noktalar
- A ki-kare testi Gözlemlenen kategori sayımlarını, sıfır model altında beklenen sayımlarla karşılaştırır ve χ² = Σ(O − E)² / E istatistiğini kullanır.
- MKS ki-kare bağımsızlık testi İki kategorik değişkenin birbiriyle ilişkili olup olmadığını kontrol eder; uyum iyiliği testi Bir değişkenin dağılımının varsayılan bir kalıpla eşleşip eşleşmediğini kontrol eder.
- Özgürlük derecesi Olasılık tablosu için (satır sayısı - 1) × (sütun sayısı - 1)'e eşittir; uyum iyiliği için ise kategori sayısından 1 çıkarılarak, verilerden tahmin edilen parametreler çıkarılır.
- Cochran'ın 1954 tarihli kılavuzuna göre, hücrelerin en fazla %20'sinin beklenen sayısı 5'in altında olmalı ve hiçbir hücrenin sayısı 1'in altına düşmemelidir. Bu çizgiyi aşarsanız ve Fisher'ın kesin testi Bu, daha güvenli bir seçenek haline gelir.
- Anlamlı bir ki-kare sonucu, bir ilişkinin var olduğunu gösterir. İlişkinin gücü ayrı bir sorudur ve yalnızca p-değeriyle değil, olasılık oranı, göreceli risk veya Cramér's V ile yanıtlanır.
Basit Sözlerle
İki hasta grubunu düşünün; biri tedavi görmüş, diğeri görmemiş ve iyileşme gibi evet veya hayır sonuçları var. Ki-kare testi, iyileşmenin her iki grupta da aynı mı yoksa gerçekten farklı mı olduğunu sorgular. Küçük bir sayım tablosu oluşturur, tedavinin hiçbir fark yaratmaması durumunda bu sayımların nasıl görüneceğini hesaplar ve gerçek sayımların bu fark yok tablosundan ne kadar uzaklaştığını ölçer. Gerçek ve beklenen sayımlar arasındaki geniş bir fark, küçük bir p-değeri üretir ve tedavi ile sonuç arasında gerçek bir bağlantıya işaret eder. Dar bir fark ise, tablodaki desenin muhtemelen sadece şans eseri olduğunu gösterir.
Sonuca güvenmeden önce iki önemli kural vardır. Her kategori gerçekten ayrı olmalıdır, çünkü aynı hasta iki kez sayım yapamaz ve çoğu hücredeki beklenen sayının en az 5'e ulaşması gerekir. Küçük örnekler için ise, bu kılavuzun ilerleyen bölümlerinde ele alınan Fisher'ın kesin testi kullanılmalıdır.
Ki-Kare Testi Nedir?
İstatistikçiler, ki-kare prosedürlerini ortak bir özelliği paylaşan bir aile olarak gruplandırırlar. Her test istatistiği, sıfır hipotezi doğru olduğunda ve örneklem boyutu yeterli olduğunda ki-kare dağılımını izler. Bu ailenin iki üyesi, bir araştırmacının pratikte karşılaştığı hemen hemen her kullanım durumunu kapsar. Bağımsızlık için ki-kare testi, tedavi grubu ve klinik sonuç gibi aynı denekler üzerinde ölçülen iki kategorik değişkeni alır ve birinin değerinin diğerinin değerini tahmin edip etmediğini sorar. Ki-kare uyum iyiliği testi, tek bir kategorik değişkeni alır ve gözlemlenen dağılımının, dört mevsim arasında eşit bir dağılım veya Mendel genetik oranı gibi önceden belirlenmiş bir dağılımla eşleşip eşleşmediğini sorar.
Bu iki test arasında ve ki-kare testi ile tamamen farklı bir test arasında seçim yapmak, verilerin nasıl toplandığına ve hangi sorunun sorulduğuna bağlıdır. Ki-kare testinin verileri için doğru test ailesi olup olmadığına henüz karar veremeyen okuyucular, devam etmeden önce Editverse'in etkileşimli test seçicisini veya istatistiksel test akış şemasını inceleyebilirler.
Ki-kare testinin her iki versiyonu da aynı istatistiğe dayanmaktadır.
χ² = Σ (O − E)² / E
O, bir kategori veya hücredeki gözlemlenen sayıyı, E ise sıfır hipotezi altında beklenen sayıyı temsil eder ve toplam, tablodaki her hücrede uygulanır. Farkın karesini almak işareti kaldırır, böylece hem fazla sayımlar hem de eksik sayımlar istatistiği yukarı doğru iter ve E'ye bölmek, her karesel farkı orada gerçekten beklenen sayıya göre ölçeklendirir. 200 gözlem tutması beklenen bir hücre, 10'luk bir boşluğu fazla sorun çıkarmadan absorbe edebilir. 5 tutması beklenen bir hücre bunu yapamaz ve E'ye bölme bunu doğrudan yansıtır.
Ki-kare test istatistiği nasıl hesaplanır?
Beklenen frekanslar, kolaylık olsun diye seçilen yuvarlak bir sayıdan değil, sıfır hipotezinden gelir. Bir olasılık tablosunda, herhangi bir hücre için beklenen sayı, satır toplamının sütun toplamıyla çarpımının, genel toplama bölünmesiyle elde edilir. Bu formül doğrudan bağımsızlık varsayımından kaynaklanır. Eğer iki değişken gerçekten birbirleriyle hiçbir ilgisi yoksa, bir sütunun belirli bir satıra düşen oranı, o satırın tüm tablodaki genel payıyla eşleşmelidir.
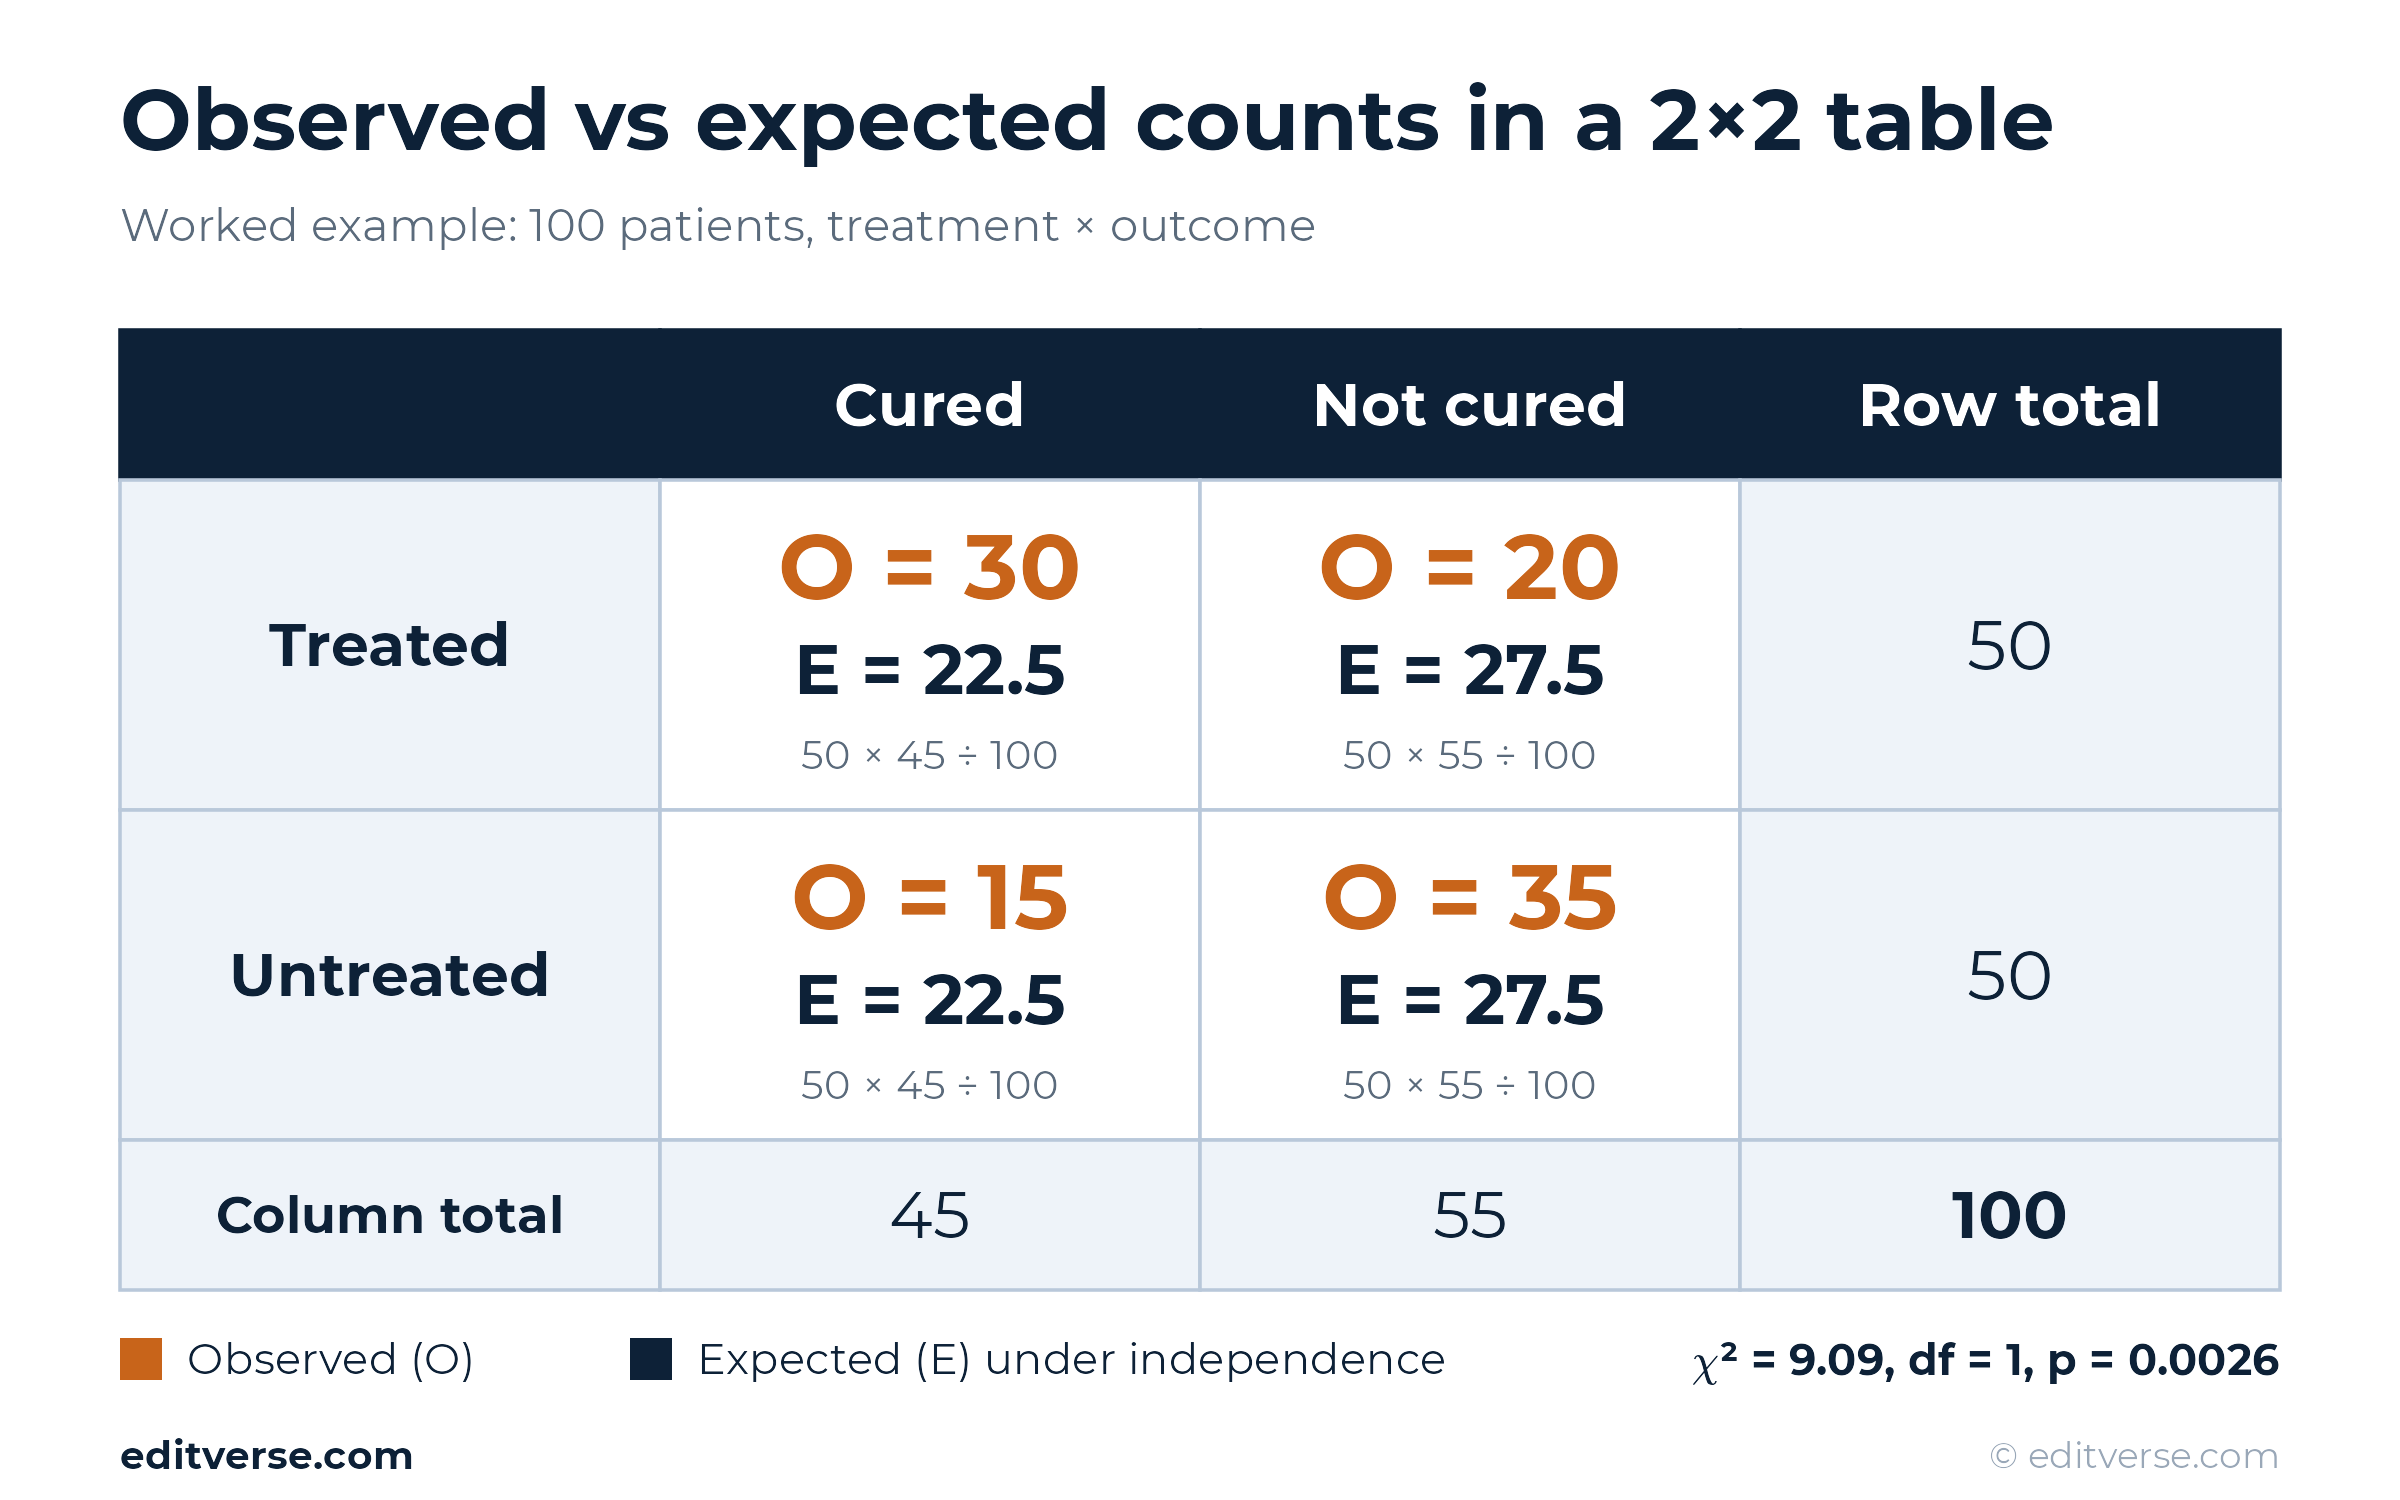
Bunu somutlaştırmak için küçük bir örnek verelim. Diyelim ki 100 hasta 50 tedavi gören ve 50 tedavi görmeyen olmak üzere ikiye ayrılıyor ve bu 100 hastanın 45'i iyileşmiş, 55'i ise iyileşmemiş olarak sınıflandırılıyor. Bağımsızlık varsayımı altında, tedavi gören grubun da tedavi görmeyen grupla aynı %45'lik iyileşme oranını göstermesi beklenir; dolayısıyla tedavi görenler arasında iyileşen hasta sayısının beklenen değeri 50 × 45 ÷ 100, yani 22.5 olur. Beklenen sayılar tam sayı olmak zorunda değildir. Sadece gözlemlenen sayılar tam sayı olmalıdır.
Uygunluk testi için beklenen sayılar aynı şekilde çalışır, ancak ikinci bir değişkenden ziyade varsayımsal bir orandan gelir. 200 hastalık başlangıcının dört mevsime eşit olarak dağılıp dağılmadığını test etmek, her mevsimin beklenen sayısını 200 × 0.25 veya 50 olarak belirler ve test daha sonra gerçek mevsimsel sayıların bu düz çizgiden ne kadar uzaklaştığını ölçer.
Ki-kare Testinde Serbestlik Dereceleri
Serbestlik dereceleri, ki-kare dağılımının hangi şekli alacağını belirler. Sonuç bölümünü hazırlarken uyumsuz bir serbestlik derecesi değeri kolayca gözden kaçabilir, ancak bu, istatistiğin karşılaştırıldığı kritik değeri değiştirir ve sınırda bir sonucu anlamlıdan anlamsıza veya tam tersine çevirebilir. r satır ve c sütunlu bir olasılık tablosu için serbestlik dereceleri (r − 1)(c − 1)'e eşittir. Bu nedenle standart bir 2×2 tablo tam olarak bir serbestlik derecesine sahiptir, çünkü satır ve sütun toplamları sabitlendikten sonra, geri kalanlar çıkarma yoluyla ortadan kalkmadan önce yalnızca bir hücre serbestçe değişebilir.
Uygunluk derecesi serbestlik dereceleri, ilgili ancak farklı bir kuralı izler. Bunlar, kategori sayısından 1 çıkarılarak bulunur ve önceden sabitlenmek yerine örneklemden tahmin edilen her parametre için bir serbestlik derecesi daha çıkarılır. Dört mevsimi düz %25 beklentiye karşı test etmek, verilerden hiçbir şey tahmin edilmediği için 4 − 1 = 3 serbestlik derecesi kullanır. Genotip sayımlarını Hardy-Weinberg oranlarına karşı test etmek daha karmaşıktır, çünkü beklenen genotip oranlarını oluşturmak için kullanılan alel frekansı da aynı örneklemden tahmin edilir ve bu tahmin adımı, basit sayım eksi bir kuralının ötesinde ek bir serbestlik derecesi maliyeti getirir.
Ki-kare Bağımsızlık Testi: Tam Bir Örnek
Tedavi gören 50 ve tedavi görmeyen 50 olmak üzere toplam 100 hastanın, iyileşmiş veya iyileşmemiş ikili sonucuna göre çapraz tablo halinde karşılaştırıldığı bir durumu ele alalım. Bu veri seti, Editverse'in ki-kare testi hesaplayıcısında da yüklenebilir örnek olarak kullanılmaktadır, bu nedenle aşağıdaki her adım anında tekrarlanabilir.
| kürlenmiş | Tedavi edilmedi | Satır toplamı | |
|---|---|---|---|
| İşlenmiş | 30 | 20 | 50 |
| İşlenmemiş | 15 | 35 | 50 |
| Sütun toplamı | 45 | 55 | 100 |
Beklenen sayılar, önceki bölümdeki satır toplamı çarpı sütun toplamı kuralını izler. Tedavi edilmiş ve iyileşmiş olanın beklenen değeri 50 × 45 ÷ 100 = 22.5'tir. Tedavi edilmiş ve iyileşmemiş olanın beklenen değeri 50 × 55 ÷ 100 = 27.5'tir. Tedavi edilmemiş ve iyileşmiş olanın beklenen değeri 50 × 45 ÷ 100 = 22.5'tir. Tedavi edilmemiş ve iyileşmemiş olanın beklenen değeri 50 × 55 ÷ 100 = 27.5'tir. Her beklenen sayı Cochran'ın 5 eşiğini aştığı için, olağan ki-kare yaklaşımı koşulsuz olarak uygulanabilir.
Her hücre daha sonra toplam değere (O − E)² ÷ E kadar katkıda bulunur. Tedavi edilmiş ve iyileşmiş hücre (30 − 22.5)² ÷ 22.5 = 2.500 katkıda bulunur. Tedavi edilmiş ve iyileşmemiş hücre (20 − 27.5)² ÷ 27.5 = 2.045 katkıda bulunur. Tedavi edilmemiş ve iyileşmiş hücre (15 − 22.5)² ÷ 22.5 = 2.500 katkıda bulunur. Tedavi edilmemiş ve iyileşmemiş hücre (35 − 27.5)² ÷ 27.5 = 2.045 katkıda bulunur. Bu dört katkının toplamı, 1 serbestlik derecesinde χ² = 9.091 değerini verir ve bu da p = 0.0026'ya karşılık gelir; bu değer, geleneksel 0.05 eşiğinin oldukça altındadır. Aşağıda ayrıntılı olarak ele alınan Yates'in süreklilik düzeltmesini uygulamak, istatistiği 7.919'a (p = 0.0049) düşürüyor; aynı tablo üzerinde bağımsız olarak yürütülen Fisher'ın kesin testi ise p = 0.0046 sonucunu veriyor. Her üç yöntem de tedavi ve sonuç arasında bir ilişki olduğu konusunda hemfikir; bu da bir makale hakeminin sonuç bölümünde görmek istediği türden bir üçgenleme.
Anlamlılık tek başına ilişkinin ne kadar güçlü olduğunu açıklamaz. Tedavi gören hastalarda iyileşme olasılığı 30'a 20 iken, tedavi görmeyen hastalarda bu oran 15'e 35'tir; bu da (30 × 35) ÷ (20 × 15) = 3.5'luk bir olasılık oranı verir . 2×2'lik bir tablo için 0 ile 1 arasında sınırlandırılmış ki-kare tabanlı bir etki büyüklüğü olan Cramér's V, (9.091 ÷ 100)'ün karekökü veya 0.30 olarak hesaplanır ve geleneksel ölçütlere göre küçük ve orta düzeyde bir ilişki arasında yer alır. Olasılık oranı ve Cramér's V'nin yanında p-değerini tek başına belirtmek yerine, p-değerini de belirtmek, yayınlanmaya hazır bir sonuç bölümünü, hakemlerin soru sormasına neden olabilecek bir bölümden ayırır. McHugh'un işyeri aşılama çalışmasına ilişkin incelemesi aynı sırayı izliyor: Aşılanmamış 92 çalışandan 23'ünde pnömokok pnömonisi gelişirken, aşılanmış 92 çalışandan sadece 5'inde bu durum görüldü; ki-kare testi farkın tesadüf olmadığını ortaya koyuyor ve Cramér'in V'si de bunun ne kadar güçlü olduğunu gösteriyor.
Olasılık Tablosu ve Beklenen Frekanslar: Gerçek Bir 2×2 Örneği
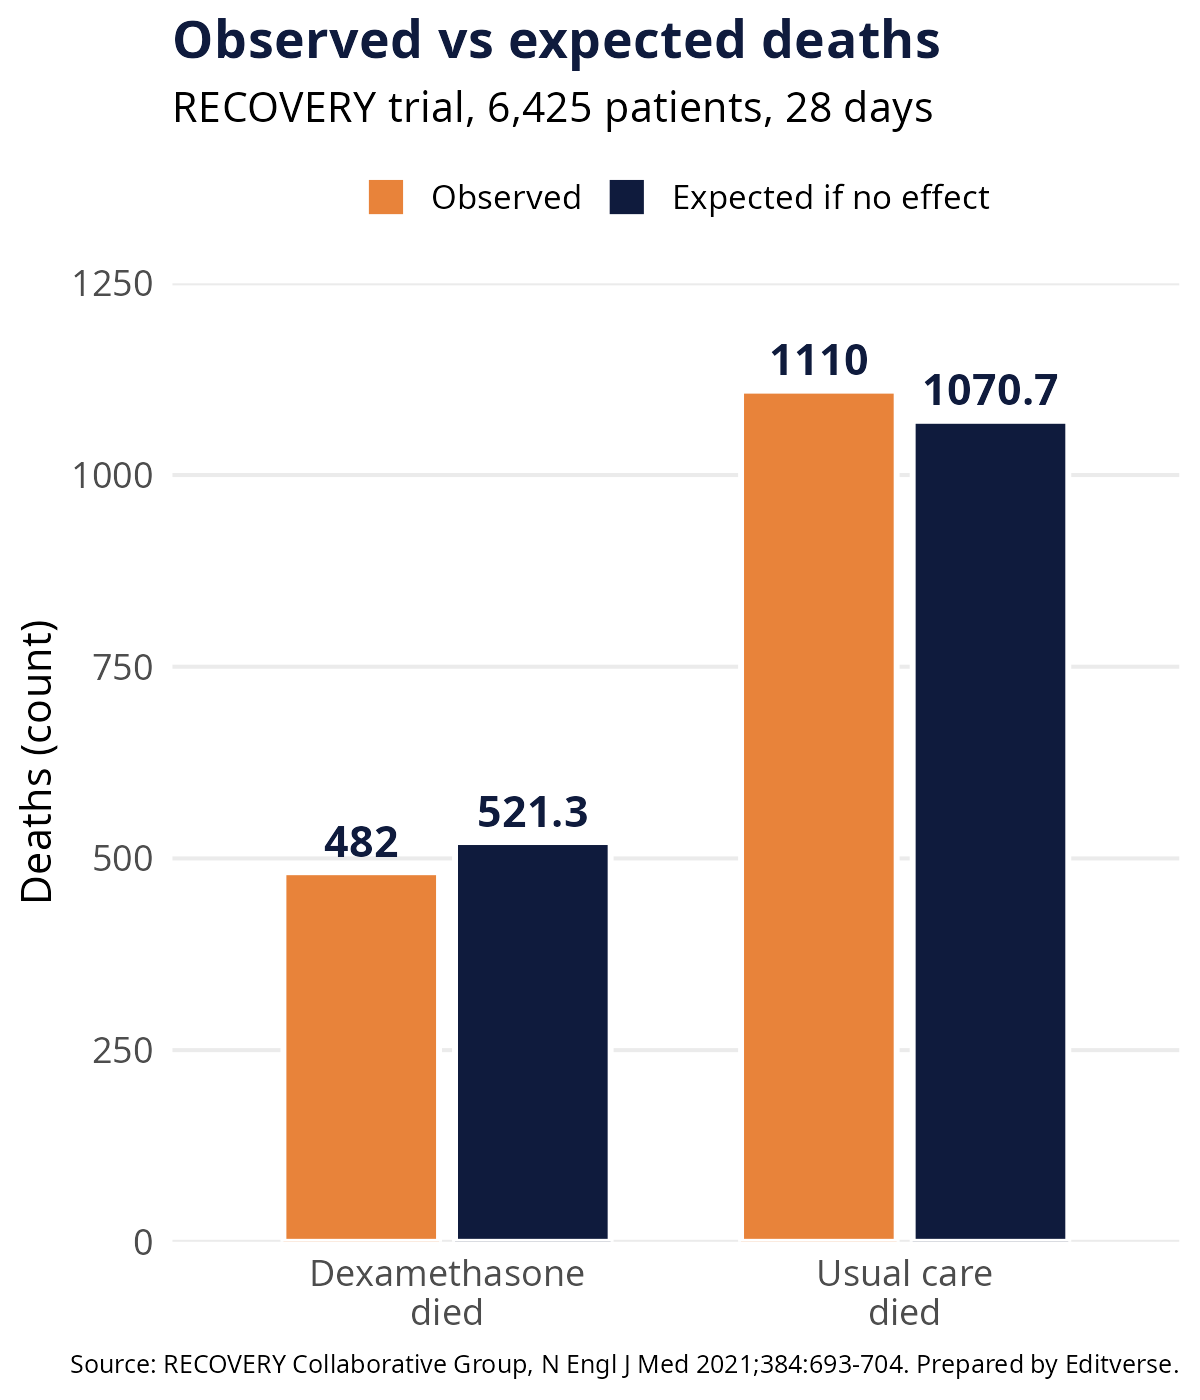
Bir olasılık tablosu , iki kategorik değişkeni çapraz tablo haline getirir ve ki-kare testi, her hücrenin gözlemlenen sayısını beklenen sıklığıyla karşılaştırır : satır toplamı × sütun toplamı ÷ genel toplam. RECOVERY deneyi, hastaneye yatırılan Covid-19 hastalarını günde 6 mg deksametazon veya olağan bakıma rastgele atadı ve 28 gün içinde ölümleri saydı. Nihai rapor PubMed Central'da ücretsiz olarak okunabilir ve özeti gerekli tüm sayıları vermektedir: deksametazon alan 2,104 hasta, olağan bakım alan 4,321 hasta, 482 hasta ve 1,110 ölüm.
| Grup | 28. günde öldü. | atlattı | Toplam |
|---|---|---|---|
| Deksametazon | 482 | 1,622 | 2,104 |
| Her zamanki bakım | 1,110 | 3,211 | 4,321 |
| Toplam | 1,592 | 4,833 | 6,425 |
Adım 1: Beklenen frekanslar
Deksametazonun hiçbir fark yaratmaması durumunda, ölümler grup büyüklüğüne orantılı olarak dağılırdı. Genel ölüm oranı 1,592 / 6,425'tir. Beklenen deksametazon kaynaklı ölüm sayısı = 1,592 × 2,104 / 6,425 = 521.33 ; beklenen standart bakım kaynaklı ölüm sayısı = 1,592 × 4,321 / 6,425 = 1,070.67 . Gözlemlenen ölüm sayıları 482 ve 1,110'dur, bu nedenle deksametazon beklentinin 39.3 altında, standart bakım ise 39.3 üzerinde yer almaktadır.
Adım 2: Test istatistiği
χ² = Σ (O − E)² / E = 5.87, 1 serbestlik derecesinde, p = 0.015. Yates düzeltmesiyle χ² = 5.72 (p = 0.017). Standartlaştırılmış artıklar −1.72 (deksametazon, öldü) ve +1.20 (olağan bakım, öldü); hiçbiri ±2'yi geçmiyor, bu nedenle tek bir hücre öne çıkmıyor. Beklenen her sayım 500'ün üzerinde, bu nedenle büyük örneklem yaklaşımı güvenli. R'nin chisq.test ve Python'ın scipy.stats.chi2_contingency Özdeş değerler döndürüldü.
Ki-kare Uyum Testi: İkinci Bir Uygulamalı Örnek
Gözlem ekipleri sıklıkla farklı bir soru sorarlar: İki değişkenin ilişkili olup olmadığı değil, bir değişkenin dağılımının beklenen bir örüntüye uyup uymadığı. Diyelim ki bir sağlık departmanı bir takvim yılı boyunca 200 doğrulanmış gastrointestinal hastalık vakası kaydetti ve vakaların başlangıçlarının mevsimlere göre kümelenip kümelenmediğini veya eşit olarak dağılıp dağılmadığını bilmek istiyor. Düz, mevsimsellik içermeyen bir sıfır hipotezi altında, dört mevsimin her birinde 200 × 0.25 = 50 vaka beklenir.
| sezon | gözlemlenen | Beklenen | (O − E)² ÷ E |
|---|---|---|---|
| Kış | 72 | 50 | 9.68 |
| bahar | 38 | 50 | 2.88 |
| Yaz | 33 | 50 | 5.78 |
| Düşmek | 57 | 50 | 0.98 |
Dört mevsimin tamamına toplanan katkılar, 4 − 1 = 3 serbestlik derecesinde χ² = 19.32 değerini verir ve bu da p = 0.00023 sonucunu doğurur. Bu sonuç, düz dağılım hipotezini kesin olarak reddeder. Kışın 9.68 ve yazın 5.78'lik katkıları toplam istatistiğin büyük bir kısmını oluşturarak sapmanın gerçekte nerede olduğunu doğrudan gösterir. Kış, beklenen payından oldukça yüksek, yaz ise oldukça düşük bir oranda seyreder; bu, her mevsimin aynı yönde hafifçe kayması anlamına gelmez ve bu ayrımı yakalamak için her hücrenin kendi katkısının incelenmesi gerekir.
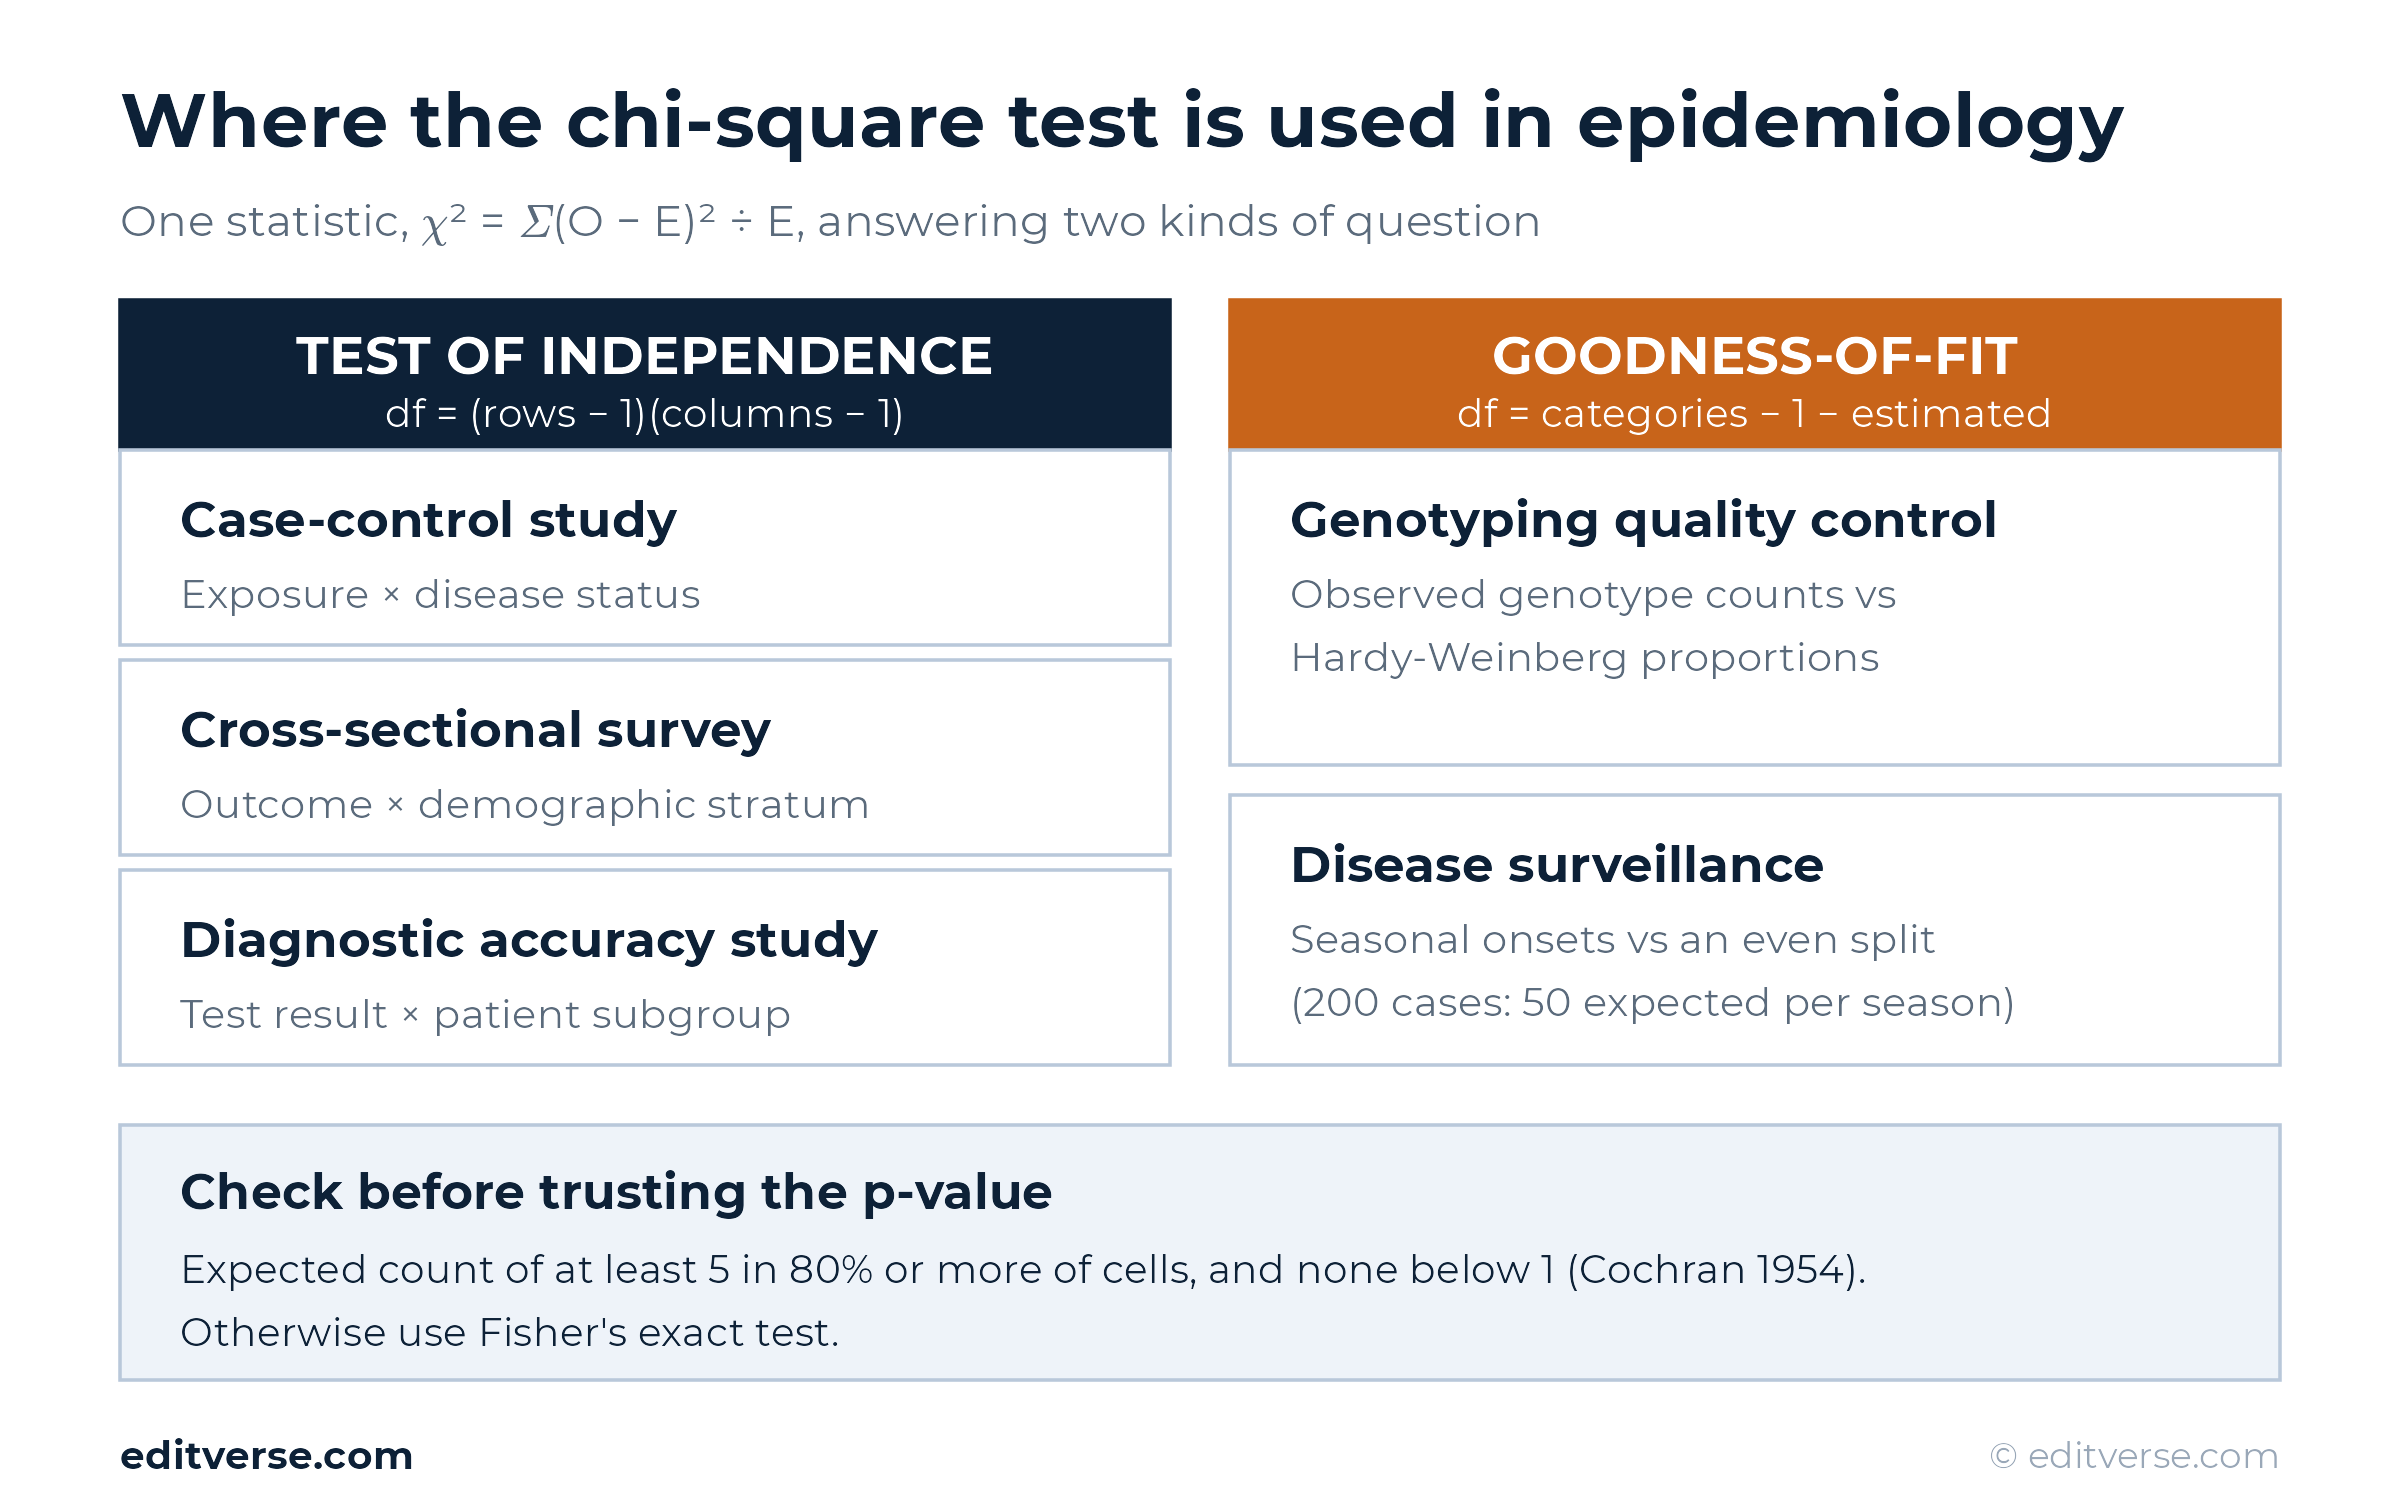
Bu yapı, epidemiyolojide sıklıkla karşımıza çıkar; en sık olarak genotip sayılarının Hardy-Weinberg dengesine uyup uymadığını kontrol etmede (genotipleme kalite kontrol adımı olarak) veya bir tanının referans popülasyondan alınan beklenen oranlarla eşleşip eşleşmediğini kontrol etmede kullanılır. Mekanizma asla değişmez. Sıfır oranlarını belirtin, beklenen sayıları elde etmek için toplam örneklem büyüklüğüyle çarpın, karelenmiş standartlaştırılmış boşlukları toplayın ve toplamı eşleşen serbestlik derecelerine sahip bir ki-kare dağılımıyla karşılaştırın.
Ki-kare Testi Başarısız Olduğunda: Beklenen Hücre Sayılarının Düşük Olması
Ki-kare istatistiği her zaman yalnızca bir yaklaşımdır. Referans dağılımı, hücre sayılarının, kare sapmaların ayrık toplamının düzgün bir ki-kare eğrisi çizebilmesi için yeterince sürekli, kabaca normal bir nicelik gibi davrandığını varsayar. Bu varsayım, her hücrenin makul derecede büyük bir beklenen sayıya sahip olmasına dayanır; tıpkı bir binom oranının normal yaklaşımının, uçlarda yanlış davranmayı bırakmadan önce yeterli sayıda denemeye ihtiyaç duyması gibi. Beklenen sayı 2 veya 3'e düştüğünde, gözlemlenen sayının alabileceği birkaç değer, yayılımlarına göre birbirinden çok uzaklaşır, istatistiğin gerçek örnekleme dağılımı düzgün olmaktan ziyade engebeli hale gelir ve ki-kare eğrisi buna kötü bir şekilde uyar.
William Cochran'ın 1954 yılında Biometrics dergisinde yayınlanan makalesi, bu teorik endişeyi günümüzde hala öğretilen bir çalışma kuralına dönüştürdü. Hücrelerin %20'sinden fazlasının beklenen sayısının 5'in altında olmaması ve hiçbir hücrenin 1'in altına düşmemesi gerekir; bu iki çizgiden herhangi biri aşılırsa, bildirilen p-değerine artık doğrudan güvenilemez. O dönemin simülasyon çalışmaları, kapalı formda bir kanıt yerine kuralı ortaya koydu ve daha sonraki çalışmalar, kesin eşik tartışılmaya devam ederken bile, altta yatan endişeyi doğrulamaya devam etti; buna, sıradan ki-kare uyum iyiliği testinin küçük örneklem boyutuna veya nadir alel frekansına çok duyarlı olduğunu açıklayan Hardy-Weinberg testi üzerine yöntem literatürü de dahildir.
Küçük bir örnek tablo, pratik riskleri açıkça göstermektedir. Her beklenen sayının 2.5'e eşit olduğu, Cochran'ın taban değerinin oldukça altında kalan 4, 1, 1 ve 4 sayımlı 2×2'lik bir tablo ele alalım. Düzeltilmemiş ki-kare istatistiği, 1 serbestlik derecesinde 3.6 olarak bulunur ve p = 0.058'dir; bu sonuç "anlamlılığa doğru eğilim gösteriyor" olarak adlandırılabilecek kadar caziptir. Yates'in süreklilik düzeltmesi aynı tabloyu χ² = 1.6'ya (p = 0.206) düşürür ve bağımsız olarak yürütülen Fisher'ın kesin testi de p = 0.206'ya ulaşır; bu da düzeltilmiş ki-kare ile neredeyse tamamen örtüşür ve düzeltilmemiş versiyonla açıkça çelişir. Burada düzeltilmemiş p-değerini bildirmek, kesin testin desteklemediği bir ilişki için kanıtı abartmak anlamına gelir.
Yates'in Süreklilik Düzeltmesi Açıklaması
Frank Yates, 1934 yılında Royal Statistical Society Dergisi'nde yayınlanan bir makalesinde küçük 2×2 tablolar için bir düzeltme önerdi . Ki-kare dağılımı sürekli iken hücre sayımları ayrık tamsayılar olduğundan, Yates, her (O − E) farkının mutlak değerinden 0.5 çıkararak karesini almayı önerdi; bu da istatistiği küçültür ve p-değerini düzeltilmemiş versiyona göre yukarı doğru iter. Yukarıdaki küçük 4-1-1-4 tablosunda, bu düzeltme istatistiği 3.6'dan 1.6'ya düşürdü; bu da tam olarak, düzeltilmemiş testin seyrek tablolarda aşırı anlamlılık iddiasında bulunmasını önlemek için tasarlanmış bir düzeltme türüdür.
Bu düzeltmenin varsayılan olarak uygulanıp uygulanmaması on yıllardır tartışılıyor ancak tam bir çözüme ulaşılmamış durumda ve bu kılavuz konunun çözüldüğünü iddia etmeyecektir. Haviland'ın 1990 yılında Statistics in Medicine dergisinde yayınlanan makalesi, Yates düzeltmeli istatistiğin aşırı muhafazakar olduğunu ve düz bir Pearson ki-kare testinin, araştırmacıların karşılaştığı çoğu 2x2 tablo için Tip I hatasını yeterince kontrol ettiğini savunmuştur. Daha yeni bir analiz ise tam tersi sonuca ulaşmıştır. Prescott'un 2021 yılında Statistics in Medicine dergisinde yayınlanan makalesi , özellikle tıbbi araştırma uygulamaları için, 2x2 tabloların Fisher testinden elde edilen tek yönlü kesin olasılığın iki katı veya bunun yaklaşık değeri olarak Yates düzeltmeli ki-kare testi kullanılarak test edilmesini önermektedir. Dikkatli istatistikçiler arasındaki bu canlı görüş ayrılığı göz önüne alındığında, en güvenli pratik yaklaşım, hangi sürümün kullanıldığını bildirmek ve tablo yeterince küçük olduğunda ki-kare varyantlarından herhangi biri yerine Fisher'ın kesin testine güvenmektir.
Yayınlanmış bir çalışma, versiyonların ne kadar sapabileceğini gösteriyor. Bewick, Cheek ve Ball'ın olasılık tablosu testlerini öğretmek için kullandığı intravenöz nitrat çalışmasında , tedavi edilen 50 hastadan 3'ü ve kontrol grubundaki 45 hastadan 8'i öldü. Düzeltilmemiş ki-kare, 1 serbestlik derecesinde χ² = 3.21 (p = 0.073) verirken, Yates düzeltmeli istatistik 2.16'ya (p = 0.141) düşüyor ve tek yönlü olasılığın iki katı olarak alınan Fisher'ın kesin testi p = 0.140 değerini veriyor. Düzeltilmemiş versiyon, diğer ikisine göre anlamlılığa gözle görülür şekilde daha yakın duruyor; bu da yöntemler bölümünde kullanılan versiyonun belirtilmesinin tam olarak nedenidir.

Bu analizin yapılmasına veya kontrol edilmesine mi ihtiyacınız var? Doktora derecesine sahip bir biyoistatistikçi, çalışma tasarımınızı inceler, analizi yapar ve makaleniz için istatistiksel yöntemler paragrafını yazar.
Fisher'ın Kesin Testi: Küçük Örneklemler İçin Alternatif Bir Yöntem
Ronald Fisher, 1922 yılında Royal Statistical Society Dergisi'nde yayınlanan bir makalesinde , Pearson'ın yirmi yıl önce tanıttığı aynı olasılık tablosu mantığına dayanarak kesin yaklaşımı tanımladı . Fisher'ın kesin testi, bir örneklem dağılımını düzgün bir eğriyle yaklaşık olarak hesaplamak yerine, satır ve sütun toplamlarını sabitler ve hipergeometrik dağılımı kullanarak, gözlemlenen tablo kadar veya ondan daha uç olan her olası tablonun kesin olasılığını hesaplar. Yaklaşım adımı olmaması, yukarıda açıklanan düzgün eğri uyumsuzluğu riskinin olmaması anlamına gelir; bu da tam olarak kesin testin sıradan ki-kare testinin geçerli olmadığı durumlarda geçerli olmasının nedenidir.
Sahai ve Khurshid'in 1995 yılında Biyofarmasötik İstatistik Dergisi'nde yayınlanan incelemesi, ödünleşmeleri ayrıntılı olarak ele alıyor ve kesin testin belirli tablo konfigürasyonları için muhafazakar olabileceğini, bu nedenle Fisher testine geçmenin otomatik olarak daha güçlü bir test üretmediğini, yalnızca örneklem büyüklükleri küçük olduğunda daha savunulabilir bir test ürettiğini belirtiyor. Pratik bir karar kuralı, yukarıdaki Cochran eşiğinden doğrudan çıkarılabilir. Her veya neredeyse her beklenen sayı 5 veya daha fazla olduğunda olağan ki-kare testini çalıştırın ve bu koşul sağlanmadığında, genel örneklem büyüklüğü ne olursa olsun, Fisher'ın kesin testine geçin , çünkü büyük bir toplam, dengesiz bir tabloda seyrek bir hücreyi gizleyebilir.
Epidemiyolojide Ki-Kare Testinin Gerçek Dünya Uygulamaları
Yayınlanmış epidemiyolojik araştırmalar sürekli olarak ki-kare prosedürlerine dayanmaktadır, neredeyse her zaman daha ayrıntılı modellemeden önce ilk eleme aşaması olarak kullanılırlar. Hazra ve Gogtay'ın Indian Journal of Dermatology'deki biyoistatistik eğitiminde, klinik araştırmacıların en sık karşılaştığı üç varyant olarak Pearson ki-kare testi, eşleştirilmiş ikili veriler için McNemar ki-kare testi ve tabakalı tablolar için Mantel-Haenszel ki-kare testi listelenmiştir; bunların her biri birbirinin yerine kullanılabilen seçenekler olmaktan ziyade farklı bir veri yapısına uygundur.
Genetik epidemiyoloji, rutin bir kalite kontrol adımı olarak uyum iyiliği versiyonuna dayanır. Genotipleme çalışmaları, belirli bir lokustaki gözlemlenen genotip sayılarının Hardy-Weinberg oranlarıyla eşleşip eşleşmediğini test eder ve önemli bir sapma genellikle genotipleme hatası, popülasyon tabakalaşması veya gerçek seçilim baskısı sinyali verir; bu, genetik yöntemler bölümünde Hardy-Weinberg testi hakkında ayrıntılı olarak ele alınan ve genetik ilişki çalışmaları geliştiren araştırmacılar için bir ayrımdır. Bir genom taramasında , 44 işaretleyici lokus boyunca yürütülen tek serbestlik dereceli Hardy-Weinberg testi, belirgin homozigot fazlalığı (χ² > 6) gösteren 7 lokus tespit etti; bu durum, tipleme hatasına işaret etmektedir. Engellilik ve Rehabilitasyon dergisinde yayınlanan ve yaygın olarak kullanılan 2×2 tablo üzerine bir eğitim kılavuzu, meme kanseri risk faktörü tablosunu baştan sona inceliyor ve dergi editörlerinin yayınlanan her tabloda yalnızca test istatistiğini değil, hem gözlemlenen hem de beklenen hücre sayımlarını da istemesi gerektiğini savunuyor; böylece okuyucular Cochran'ın eşiğinin karşılanıp karşılanmadığına kendileri karar verebilirler.
Genetik dışında, bağımsızlık testi, hastalık durumuna göre maruz kalma durumunun vaka-kontrol karşılaştırmalarında, demografik katmanlar arasında kategorik bir sonucu karşılaştıran kesitsel araştırmalarda ve hasta alt grupları arasında test sonuçlarını karşılaştıran tanı çalışmalarında ortaya çıkar. Gözlem verileri, yukarıda gösterildiği gibi, mevsimsel veya başka bir şekilde beklenen bir kalıpla karşılaştırılması gerektiğinde, uygunluk testi ile kontrol edilir.
Ki-kare Testi Raporlamasında Sık Yapılan Hatalar
Gönderilen makalelerde ve yayınlanan yazılarda tekrar eden birkaç hata bulunmaktadır.
- Ham sayılar yerine yüzdelik değerler giriliyor. Ki-kare formülleri oranlar yerine frekanslar üzerinden çalışır; bu nedenle testten önce yüzdelik değeri gerçek sayıya dönüştürmek zorunludur, isteğe bağlı değildir.
- Beklenen sayım eşiğini göz ardı ederek. Tabloda 5'in altında birden fazla hücre bulunan bir durumdan elde edilen ki-kare p-değerini, sınırlamayı belirtmeden veya Fisher'ın kesin testine geçmeden yayınlamak, bu alandaki en kaçınılabilir istatistiksel hatalar arasında yer almaktadır.
- Eşleştirilmiş verilere bağımsızlık testinin uygulanması. Aynı denekler üzerinde yapılan öncesi-sonrası ölçümler veya eşleştirilmiş çiftler, bağımsızlık varsayımını doğrudan ihlal eder. McNemar'ın testi Tam da bu durum için var.
- Etki büyüklüğü belirtilmeden anlamlılık bildirilmesi. Bir p değeri, bir ilişkinin varlığını doğrular. Bu ilişkinin klinik açıdan önemli olacak kadar büyük olup olmadığı ayrı bir sorudur; bu nedenle Cramér'in V'si, phi veya bir olasılık oranı Her ki-kare sonucunun yanında yer alır.
- Serbestlik derecelerini yanlış hesaplamak. Uyumsuz bir değer, istatistiksel bir inceleyici tarafından kolayca fark edilebilir ve analizin gönderilmeden önce dikkatlice kontrol edilmediğinin bir işaretidir.
Makalenizde Ki-Kare Testini Nasıl Rapor Edebilirsiniz?
Sağlık bilimlerindeki çoğu dergi aynı raporlama şablonunun bir versiyonunu izler. Test adını, parantez içinde serbestlik derecelerini, örneklem büyüklüğünü, istatistiği ve p-değerini sırasıyla belirtin; örneğin, “χ²(1, N = 100) = 9.09, p = 003.” Hemen ardından etki büyüklüğünü ve 2x2'lik bir tablo için olasılık oranını veya göreceli riski güven aralığıyla birlikte verin. Avrupa Epidemiyoloji Dergisi'nde yayınlanan, istatistiksel yanlış yorumlamaya ilişkin yaygın olarak kullanılan bir kılavuz, eşlik eden bir aralık tahmini olmadan yalnızca bir p-değerinin, okuyucuları anlamlı olanı büyük veya önemli olarak aşırı yorumlamaya davet ettiğini belirtmektedir.
Sonuç tablosunda, dikkatli bir okuyucunun testi bağımsız olarak yeniden hesaplayabilmesi için, yalnızca yüzdeler değil, her hücre için gözlemlenen sayılar da gösterilmelidir. Yöntemler bölümünde, uygulanan düzeltmenin (düzeltilmemiş Pearson, Yates düzeltmeli veya Fisher'ın kesin testi) belirtilmesi ve kullanılan yazılım ve sürümün belirtilmesi gerekir. Daha geniş bir analiz planı için ki-kare testini diğer seçeneklerle karşılaştıran araştırmacılar, Editverse'in makalenin kategorik verilerin dışında kalan bölümleri için doğru istatistiksel testi seçme kılavuzunu da yararlı bulabilirler.
İstatistiksel Analizinizde Uzman Yardımına mı İhtiyacınız Var?
Editverse biyoistatistikçileri, olasılık tabloları oluşturur, ki-kare ve Fisher'ın kesin testi arasında doğru seçim yapar ve tamamen tekrarlanabilir R çıktısıyla yayınlanmaya hazır sonuçlar sunar. Sayıları önce ücretsiz ki-kare testi hesaplayıcısıyla hesaplayın veya tam analiz, yazım ve dergiye gönderim desteği için ham verileri doğrudan Just Data Service aracılığıyla teslim edin .
Sonuç
Ki-kare testini doğru bir şekilde uygulamak, sayıları bir formüle yerleştirmekten daha fazlasını gerektirir. Beklenen frekanslar açıkça belirtilmiş bir sıfır hipotezinden gelmeli, serbestlik dereceleri tablonun gerçek şekliyle eşleşmeli ve sıradan ki-kare, Yates düzeltmeli versiyon ve Fisher'ın kesin testi arasındaki seçim, alışkanlıktan ziyade en küçük beklenen hücrenin boyutundan kaynaklanmalıdır. Yukarıdaki her iki tablo da, her adımda bağımsız istatistiksel yazılımlarla çapraz kontrol edilerek, beklenen sayılar küçüldüğünde sonucun ne kadar değişebileceğini ve bir p-değerinin önce kontrol edilmeden yazılım çıktısından kopyalanmasının neden eksik bir hikaye anlattığını göstermektedir.
Bu tür kategorik veriler, vaka-kontrol çalışmaları, tanısal doğruluk makaleleri ve genetik ilişki çalışmaları için temel teşkil eder; bu nedenle makale hakemleri bu özel testi bu kadar yakından inceler. Varsayımları ilk seferde doğru yapmak ve p-değeriyle birlikte etki büyüklüğünü bildirmek, makale yazılmadan önce revizyon talebini önler.
Analizleriniz İçin Ücretsiz Araçlar
- GraphProYayınlanmaya hazır, dahili ki-kare p-değerlerine sahip grafikler. Ücretsiz, kayıt gerekmez.
- StatPro: Kategorik sonuçlar için ücretsiz istatistiksel hesap makineleri ve test seçici.
- Akış Şeması ProTarayıcınızda CONSORT, STROBE ve PRISMA akış diyagramları.
SSS
Ki-kare testi ne için kullanılır?
Ki-kare testi, gözlemlenen kategori sayılarının, sıfır hipotezi altında beklenen sayılardan farklı olup olmadığını kontrol eder; bu farklılık, iki kategorik değişkenin ilişkili olmasından (bağımsızlık testi) veya bir değişkenin dağılımının belirtilen bir kalıpla uyuşmamasından (uygunluk testi) kaynaklanabilir.
Ki-kare testinin formülü nedir?
χ² = Σ (O − E)² / E, burada O her hücrenin gözlemlenen sayısı, E ise sıfır hipotezi altında o hücrenin beklenen sayısıdır ve toplam tablodaki her hücre için geçerlidir.
Ki-kare testinin kaç serbestlik derecesi vardır?
Bir olasılık tablosunun (satır sayısı - 1) × (sütun sayısı - 1) serbestlik derecesi vardır, dolayısıyla 2×2'lik bir tablonun tam olarak 1 serbestlik derecesi vardır. Uygunluk testi, kategori sayısından 1 çıkarılarak bulunur; örneklemden tahmin edilen her parametre için bir tane daha çıkarılır.
Ki-kare testi yerine Fisher'ın kesinlik testini ne zaman kullanmalıyım?
Cochran'ın 1954 tarihli kılavuzuna göre, tablonun hücrelerinin %20'sinden fazlasının beklenen sayısı 5'in altında olduğunda veya herhangi bir hücrenin beklenen sayısı 1'in altında olduğunda Fisher'ın kesinlik testine geçin.
Yates'in süreklilik düzeltmesini her zaman uygulamalı mıyım?
İstatistikçiler bu konuda hemfikir değil. Bazı kanıtlar, düzeltmenin daha büyük 2×2 tablolar için aşırı muhafazakar olduğunu öne sürerken, diğer yeni çalışmalar özellikle tıbbi araştırmalar için bunu veya eşdeğer bir kesin testi önermektedir. Hangi sürümün kullanıldığının bildirilmesi, evrensel bir varsayılan değer seçmekten daha önemlidir.
Bağımsızlık için ki-kare testi ile uyumluluk testi arasındaki fark nedir?
Bağımsızlık testi, iki kategorik değişkeni bir olasılık tablosu içinde birbirleriyle karşılaştırır. Uyum iyiliği testi ise tek bir değişkenin gözlemlenen dağılımını önceden belirlenmiş bir dağılımla karşılaştırır.
Anlamlı bir ki-kare sonucu, ilişkinin ne kadar güçlü olduğunu bana gösterir mi?
Hayır. Anlamlılık yalnızca, seçilen alfa düzeyinde bir ilişkinin tesadüf eseri olma olasılığının düşük olduğunu gösterir. Güçlülük, Cramér's V, phi veya olasılık oranı gibi ayrı bir etki büyüklüğü gerektirir.
Ki-kare testleri sürekli verilerde kullanılabilir mi?
Doğrudan değil. Sürekli ölçümlerin önce kategorilere ayrılması gerekir ki bu da bilgi kaybına yol açar; bu nedenle sonuç gerçekten sürekli olduğunda t-testi, ANOVA veya regresyon modeli genellikle daha iyi bir seçimdir.
Referanslar
- Pearson K., İlişkili değişkenler sisteminde olasılıktan sapmaların belirli bir sisteminin, rastgele örneklemeden kaynaklandığının makul bir şekilde varsayılabileceği kriteri üzerine. Felsefe Dergisi. 1900;50(302):157–175. doi.org/10.1080/14786440009463897
- Fisher RA. Olasılık tablolarından χ²'nin yorumlanması ve P'nin hesaplanması üzerine. JR İstatistik Topluluğu. 1922;85(1):87–94. doi.org/10.2307/2340521
- Yates F. Küçük sayılar içeren olasılık tabloları ve χ² testi. Ek JR İstatistik Topluluğu. 1934;1(2):217–235. doi.org/10.2307/2983604
- Cochran Çalışma Grubu. Yaygın χ² testlerini güçlendirmeye yönelik bazı yöntemler. Biyometri. 1954;10(4):417–451. doi.org/10.2307/3001616
- Haviland MG. Yates'in süreklilik düzeltmesi ve 2 x 2 olasılık tablolarının analizi. İstatistiksel Tıp. 1990;9(4):363–367. PMID 2362976
- Prescott RJ. 2 x 2 olasılık tabloları için iki yönlü anlamlılık testleri. Alternatif nedir? İstatistiksel Tıp. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. 2 x 2 olasılık tablosu içeren epidemiyolojik verilerin analizi üzerine, Fisher'ın kesin testi ve Yates'in süreklilik düzeltmesine genel bakış. J Biyofarmasötik İstatistik. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. Biyoistatistik serisi modül 4, grupların karşılaştırılması, kategorik değişkenler. Hint J Dermatol. 2016;61(4):385–392. PMID 27512183
- Wang J, Shete S. Hardy-Weinberg oranlarından sapmanın test edilmesi. Yöntemler Mol Biol. 2012;850:77–102. PMID 22307695
- Rigby AS. Epidemiyolojide istatistiksel yöntemler. VII. 2 x 2 olasılık tablosu analizi için ki-kare testine genel bakış. Engelli Rehabilitasyon. 2002;23(16):693–697. PMID 11732558
- Greenland S, Senn SJ, Rothman KJ ve diğerleri. İstatistiksel testler, P değerleri, güven aralıkları ve güç: Yanlış yorumlamalara yönelik bir kılavuz. Avrupa J Salgını. 2016;31(4):337–350. PMID 27209009
- RECOVERY İşbirliği Grubu. Covid-19 nedeniyle hastaneye yatırılan hastalarda deksametazon. N Eng J Med. 2021;384(8):693–704. doi.org/10.1056/NEJMoa2021436
- Bewick V, Cheek L, Ball J. İstatistik incelemesi 8: nitel veriler, ilişki testleri. Kritik Bakım. 2004;8(1):46–53. PMID 14975045
- McHugh ML. Bağımsızlık için ki-kare testi. Biyokimya Tıp. 2013;23(2):143–149. PMID 23894860
- Gomes I, Collins A, Lonjou C ve diğerleri. Hardy-Weinberg kalite kontrolü. Ann Hum Genet. 1999;63(6):535–538. PMID 11246455