
Nai-publish
Ang STROBE-MR checklist ay ang 20-item na pamantayan sa pag-uulat para sa mga pag-aaral na gumagamit ng mga genetic variant bilang instrumental na baryabol upang matantya ang mga epektong sanhi. Inilathala ito nina Skrivankova at mga kasamahan noong 2021 bilang isang pahayag sa JAMA at bilang isang mahabang papel ng paliwanag at pagpapaliwanag sa BMJ [1] [2] . Hinihikayat ng mga may-akda ang mga journal na humingi ng mga nakumpletong checklist sa pagsusumite. Ipinapaliwanag ng gabay na ito kung ano ang hinihingi ng bawat aytem, ipinapakita kung saan nabibilang ang bawat sagot sa isang manuskrito, at pagkatapos ay inilalapat ang bawat aytem sa isang tunay na open-access na pag-aaral ng Mendelian randomization, hilera por hilera, na may pointer ng seksyon at isang hatol para sa bawat isa.
Sa Simpleng Salita
Ang STROBE-MR ay isang listahan ng 20 aytem sa pag-uulat para sa mga papel ng Mendelian randomization. Hinihiling nito sa mga may-akda na sabihin kung paano napili ang mga genetic variant, gaano kalakas ang mga ito, saan nagmula ang dalawang dataset, kung ang mga sample ay nagsasapawan, kung aling mga pagsubok ang sumubok sa mga pagpapalagay, at kung saan matatagpuan ang datos at code. Dapat na mahusgahan ng isang mambabasa ang pag-aaral nang hindi nanghuhula. Kung ang isang aytem ay hindi naaangkop, sabihin ito at ibigay ang dahilan.
Ang Saklaw ng STROBE-MR Checklist
Ang STROBE-MR ay ang katumbas na Mendelian randomization ng STROBE guideline para sa mga observational studies, na aming tatalakayin sa aming STROBE guide . Tinatalakay ng paliwanag na papel ang 20 aytem na may mga nailathalang halimbawa ng transparent na pag-uulat, at itinatago ng mga may-akda ang checklist bilang isang buhay na dokumento sa isang nakalaang website [1] . Isinulat nila ito dahil kakaunti ang pinagkasunduan kung paano iuulat ang disenyong ito. Natuklasan sa empirical work na kanilang binanggit na maraming ulat ang hindi nagsasaad o sumuri sa mga pagpapalagay ng Mendelian randomization at nagbigay ng napakakaunting detalye sa kanilang mga pinagmumulan ng datos [1].
Isang audit noong 2022 ang nagpapakita kung gaano kalaki ang agwat. Sinuri nina Woolf at mga kasamahan ang 87 two-sample na pag-aaral na gumamit ng MR-Base platform at natuklasang sa pangkalahatan ay mahina ang pag-uulat, na may mean na 53% ng mga aytem na iniulat bawat pag-aaral. 44% lamang ang nagbigay ng sapat na detalye upang hatulan ang kaugnayan, 31% para sa kalayaan at 32% para sa mga pagpapalagay ng mga pagsubok sa palsipikasyon, habang 89% ang nagbigay ng sapat para sa paghihigpit sa pagbubukod [4] . Gumamit ang audit na iyon ng sarili nitong bespoke checklist sa halip na STROBE-MR, kaya ipinapakita ng mga porsyento kung ano ang kadalasang nawawala at hindi isang STROBE-MR score.
Mahalaga ang saklaw bago mo buksan ang checklist. Ang STROBE-MR ay para sa mga ulat ng mga pagsusuri ng Mendelian randomization. Ang isang randomized trial ay sumusunod sa CONSORT, at ang CONSORT 2025 (30 aytem) ay pumalit sa CONSORT 2010, gaya ng paliwanag ng aming gabay sa CONSORT . Ang isang conventional cohort o case-control study ay sumusunod sa STROBE. Sinasabi rin ng mga may-akda ng STROBE-MR na ang checklist ay hindi isang pormal na kasangkapan para sa pagtatasa ng kalidad ng pag-aaral, na hindi ito dapat gawing isang quality scale, at na hindi ito isang gabay para sa pagdidisenyo o pagsasagawa ng isang pag-aaral [1] . Isinasaisip namin iyon kapag binibigyan namin ng marka ang halimbawa sa ibaba.
Mga Aytem sa Checklist ng STROBE-MR ayon sa Seksyon ng Manuskrito
Isinasalarawan sa Talahanayan 1 ang 20 aytem ng checklist ng STROBE-MR mula sa papel ng paliwanag [1] at pinapangkat ang mga ito ayon sa seksyon ng manuskrito kung saan nabibilang ang sagot. Ang mga sub-aytem na may letra ay magkakasamang nakalista. Binabanggit sa kanang kolum ang karaniwang paraan kung paano nagkakamali ang bawat grupo, batay sa mismong pagkakasulat ng mga aytem.
| Item na STROBE-MR | seksyon | Ano ang iuulat | Karaniwang bitag |
|---|---|---|---|
| 1 | Pamagat at abstract | Pangalanan ang Mendelian randomization bilang disenyo kung ito ang pangunahing layunin ng pag-aaral. | Isang abstrak na nagsasabing pagsusuring henetiko lamang, nang hindi pinangalanan ang disenyo. |
| 2 3 at | pagpapakilala | Ipaliwanag ang paglalantad, kung ang isang ugnayang sanhi ay kapani-paniwala, kung bakit angkop ang Mendelian randomization sa tanong, at ilahad ang mga layunin kasama ang anumang paunang natukoy na mga hipotesis na sanhi. | Isang katwiran na hindi kailanman nagsasabi kung bakit hindi sapat ang isang pagsubok o isang pangkat. |
| 4 (a hanggang e) | Mga pamamaraan, mapagkukunan ng datos | Para sa bawat sanggunian, ibigay ang lugar, ang mga kalahok at laki ng sample, kung ang kapangyarihan ay nakalkula na nang maaga, paano sinukat at sinala ang mga variant, paano tinasa ang pagkakalantad at kinalabasan, at ang pag-apruba ng etika. Hinihikayat ang isang talaan ng mga sanggunian. | Isang dataset na pinangalanan lamang ayon sa identifier nito, na walang kahulugan ng populasyon o kaso. |
| 5 | Mga pamamaraan, pagpapalagay | Sabihin ang tatlong pangunahing pagpapalagay (kaugnayan, kalayaan, paghihigpit sa pagbubukod) para sa pangunahing pagsusuri, kasama ang anumang karagdagang pagpapalagay para sa mga pagsusuri ng sensitibidad. | Paglilista ng mga palagay nang hindi sinasabi kung paano sinuri ang bawat isa. |
| 6 (a hanggang e) | Mga pamamaraan, pangunahing pagsusuri | Ilarawan ang mga yunit at iskala, kung paano pinangasiwaan ang mga variant at timbang, ang estimator at mga covariate, ang nawawalang datos at multiple testing. | Isang epektong iniulat bawat yunit ng isang hindi maipaliwanag na iskala. |
| 7 8 at | Mga pamamaraan, pagsusuri | Sabihin kung aling mga pamamaraan o paunang kaalaman ang sumusuporta sa mga pagpapalagay, at ilista ang bawat sensitibidad o karagdagang pagsusuri. | Ang isang F-statistic ay itinuturing na patunay na ang mga instrumento ay balido. |
| 9 (a at b) | Mga pamamaraan, software at pagpaparehistro | Pangalanan ang software, mga pakete, mga bersyon at mga setting, at sabihin kung ang protocol ay nakarehistro, kailan at saan. | Isang pakete na pinangalanan nang walang bersyon. |
| 10 (a hanggang d) | Mga Resulta, Deskriptibong Datos | Iulat ang mga numero sa bawat yugto, mga buod ng istatistika, heterogeneity sa anumang meta-analyzed na mapagkukunan, at para sa mga disenyo ng dalawang-sample ang pagkakatulad ng mga kaugnayan ng variant-exposure at ang overlap sa pagitan ng mga sample. | Katahimikan kapag nagsasapawan kapag ang parehong dataset ay gumagamit ng iisang biobank. |
| 11 (a hanggang d) | Mga Resulta, Pangunahing Natuklasan | Iulat ang mga kaugnayan ng variant-exposure at variant-outcome, mga pagtatantya ng Mendelian randomization sa isang interpretable scale, absolute risk kung saan nauugnay, at mga plot. | Hindi na-convert ang mga log-odds at walang plot ng kada variant na datos. |
| 12 13 at | Mga resulta, pagsusuri sa palagay at sensitibidad | Iulat ang mga pagsusuri sa palagay at mga istatistika ng heterogeneity, ang mga pagsusuri sa sensitivity, anumang pagsubok sa direksyon ng sanhi, paghahambing sa mga pagtatantya na hindi ayon sa Mendelian-randomization, at mga karagdagang plot tulad ng leave-one-out. | Isang pleiotropy test ang iniulat nang walang anumang komento sa bisa nito. |
| 14 15 at | Pagtalakay | Ibuod ang mga pangunahing resulta laban sa mga layunin, pagkatapos ay talakayin ang mga limitasyon na sumasaklaw sa mga pagpapalagay, iba pang bias at kawalan ng katumpakan, kabilang ang direksyon at laki ng anumang bias. | Mga limitasyon na naglilista ng mga problema nang hindi sinasabi kung saang direksyon nila itinutulak ang pagtatantya. |
| 16 17 at | Pagtalakay | Maingat na bigyang-kahulugan, talakayin ang mekanismo at katumbas ng gene-environment, klinikal na kaugnayan, at paglalahat sa ibang populasyon, tiyempo ng pagkakalantad at mga antas ng pagkakalantad. | Mas malakas ang mga salitang sanhil kaysa sa pinahihintulutan ng mga pagpapalagay. |
| 18 sa 20 | Iba pang impormasyon | Ilarawan ang pagpopondo at ang papel ng mga tagapondo, magbigay ng access sa datos at kodigo, at magdeklara ng mga salungatan ng interes. | Ang code ay inilarawan bilang available kapag hiniling. |
Ang mga aytem 4, 6, 10 at 13 ng STROBE-MR checklist ang may pinakamaraming sub-aytem, at dito nakasalalay ang karamihan sa pagsisikap sa pag-uulat. Ang mga mambabasang nais malaman ang mga istatistika sa likod ng mga ito ay maaaring magsimula sa aming mga post tungkol sa mga mahihinang instrumento at ang F-statistic , pleiotropy at ang apat na karaniwang estimator at ang pagkalkula ng kapangyarihan na hindi isinasama ng karamihan sa mga papel , at ang paliwanag ng Mendelian randomization ay sumasaklaw sa pamamaraan mula simula hanggang katapusan.
Ang Halimbawa ng Open-Access na Ginamit Namin para sa STROBE-MR Checklist
Pumili kami ng isang two-sample na pag-aaral ng Mendelian randomization na inilathala noong Oktubre 2026 sa Endocrinology, Diabetes & Metabolism nina Zaka at mga kasamahan [3] . Tinatanong nito kung ang genetically predicated serum 25-hydroxyvitamin D ay nauugnay sa type 2 diabetes sa mga South Asian. Sinasabi ng mga may-akda na ang pag-aaral ay iniulat alinsunod sa STROBE-MR, at ang talaan ng PMC ay walang nakalistang supplementary file, kaya binigyan namin ng marka ang buong teksto, mga talahanayan, at mga pigura laban sa checklist ng STROBE-MR. Ang artikulo ay may lisensya sa CC BY 4.0. Inililista ng Crossref ang bersyon ng talaan sa ilalim ng lisensyang iyon, at ang Europe PMC at ang open-access record ng PMC ay may parehong lisensya.
- Disenyo. Dalawang-sample na Mendelian randomization na may mga buod na istatistika mula sa database ng OpenGWAS OpenGWAS.
- Paglalahad. Serum 25-hydroxyvitamin D mula sa isang South Asian UK Biobank GWAS (n = 7,380), na sinuri gamit ang tatlong variant.
- Kinalabasan. Type 2 diabetes mula sa isang meta-analysis ng 16 na cohort sa Timog Asya (n = 50,533, na may 16,677 na kaso) [5].
- Pangunahing resulta. Inverse-variance weighted odds ratio 1.06 (95% CI 0.83 hanggang 1.36) bawat 1 SD ng henetikong hinulaang 25-hydroxyvitamin D.
Ang bawat hatol sa ibaba ay ang aming pagbasa ng artikulo laban sa ipinaraphrase na aytem. Gumagamit kami ng apat na label. Ang "Iniulat" ay nangangahulugang sinasagot ng artikulo ang aytem sa sarili nitong mga salita. Ang "Hukom" ay nangangahulugang ang mga makatwirang mambabasa ay maaaring magkaiba, kadalasan dahil ang sagot ay bahagya o nasa ibang lugar. Ang " Hindi matatagpuan sa artikulo" ay nangangahulugang wala kaming nakitang pahayag sa buong teksto o sa PDF. Ang "Hindi naaangkop" ay nangangahulugang ang aytem ay nakasalalay sa isang bagay na hindi kayang ibigay ng datos sa antas ng buod, o sa isang pagsusuri na hindi isinagawa at ipinaliwanag ng artikulo. Ang mga sipi ay verbatim at maikli.
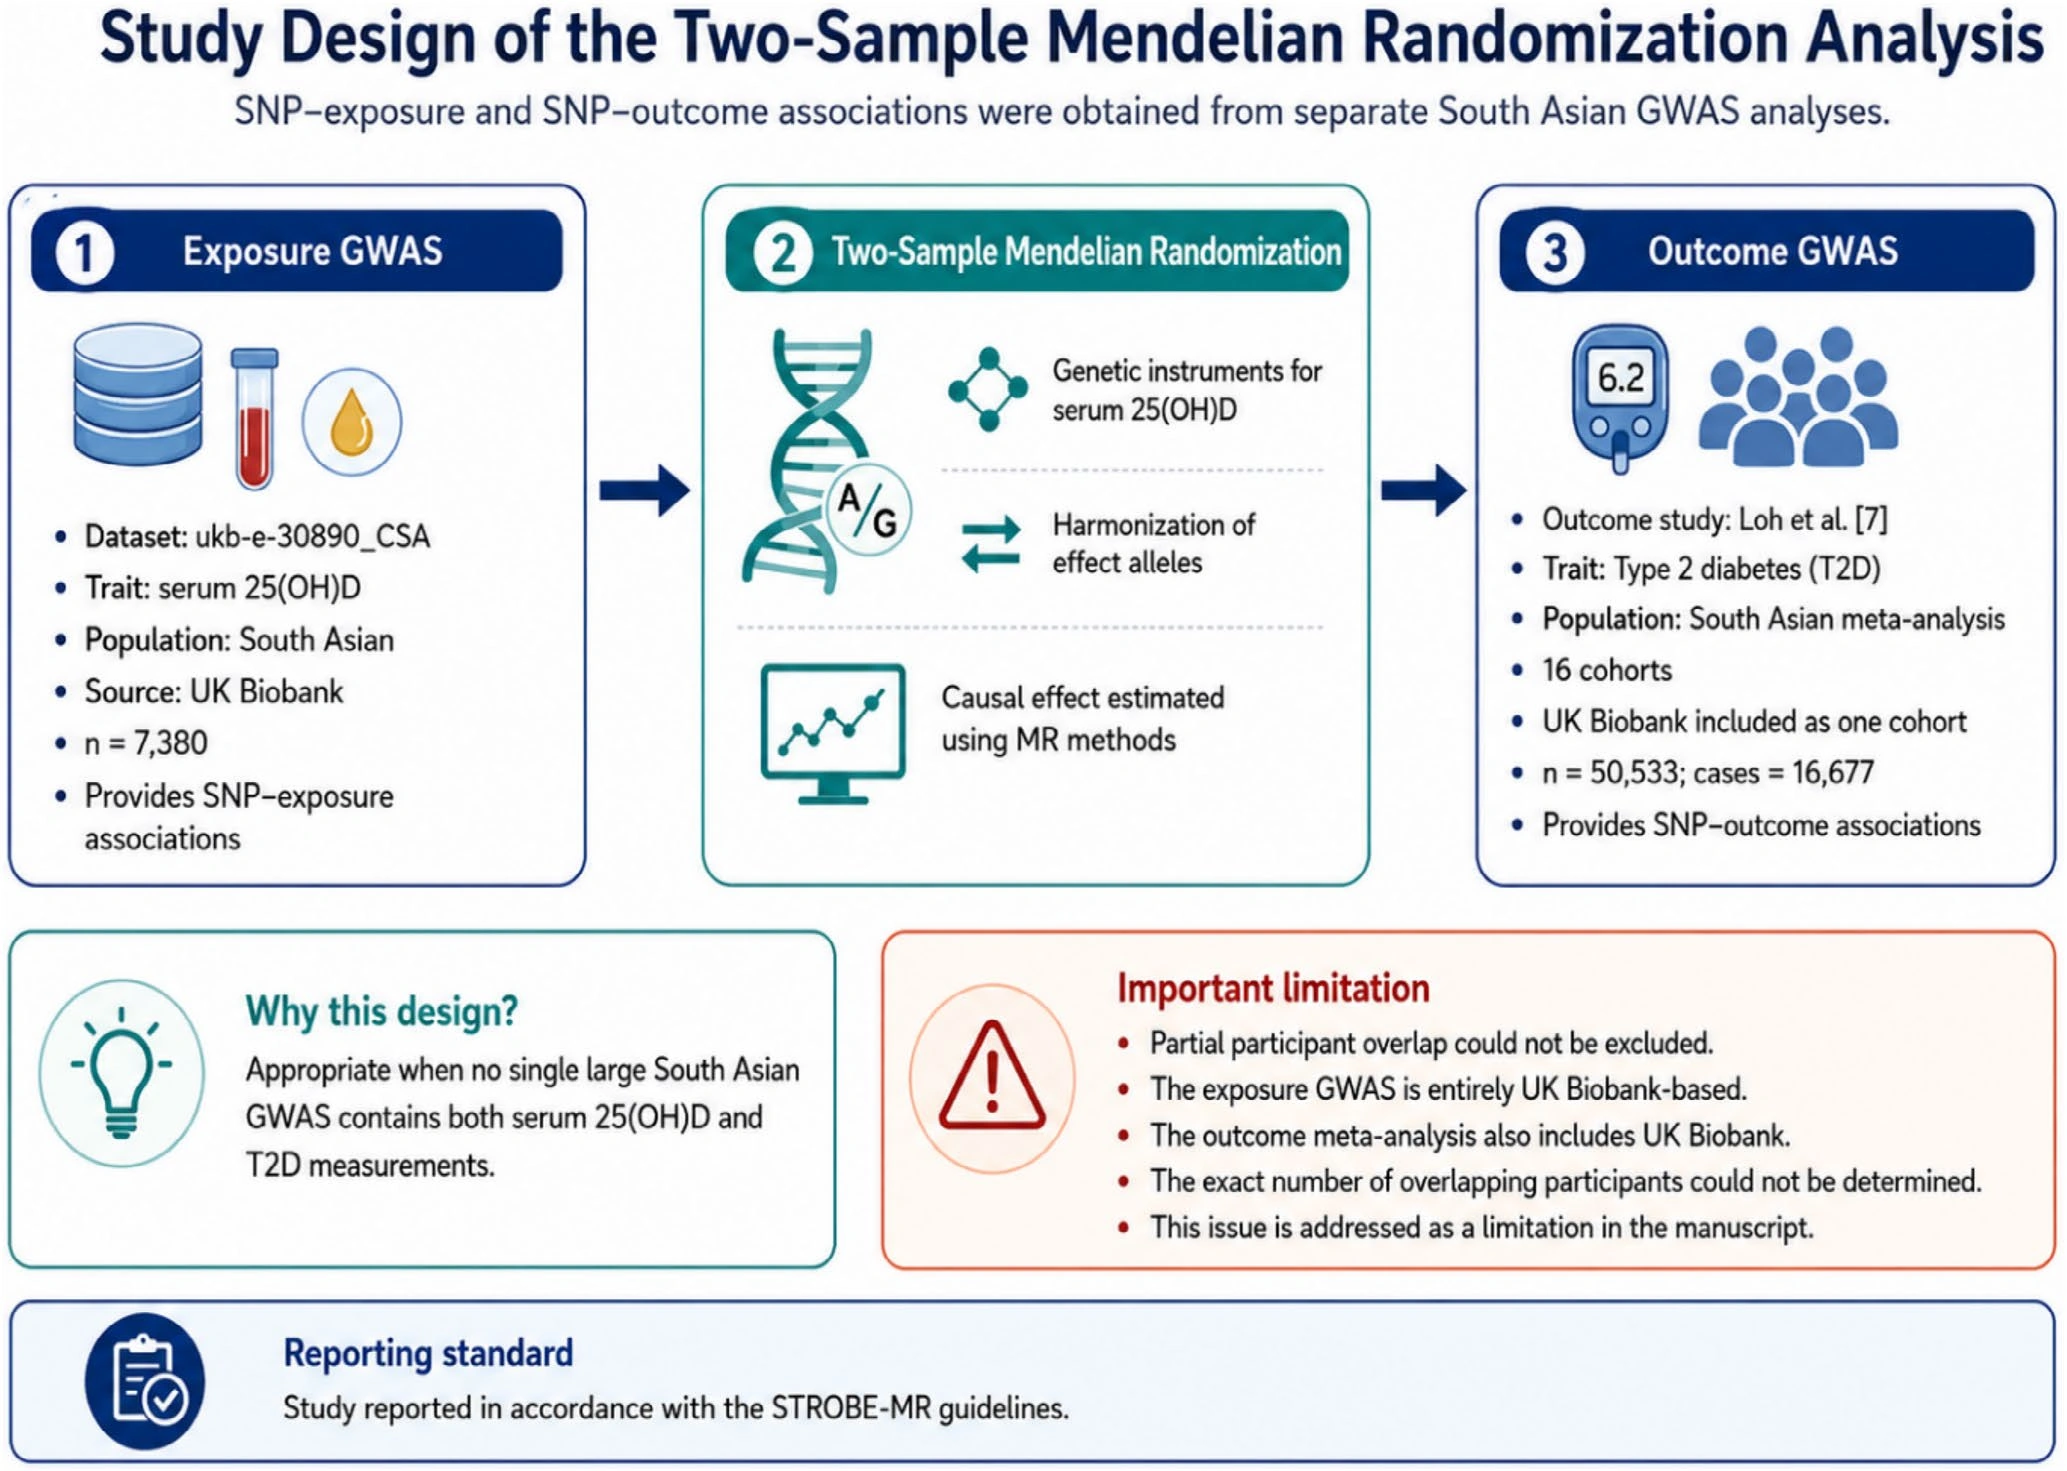
Sinasagot na ng Figure 1 ang bahagi ng item 4, dahil ipinapakita nito ang parehong data source, ang laki ng kanilang sample, at ang overlap concern sa iisang pahina. Ito ang uri ng maagang buod ng disenyo na hinihingi ng item.
Checklist ng STROBE-MR na Inilapat sa Halimbawa, Aytem por Aytem
| Bagay | Saan sa artikulo | Ano ang ginagawa ng artikulo | kuru-kuro |
|---|---|---|---|
| 1 | Pamagat; Abstrak | Tinatawag ng pamagat ang disenyo bilang isang “Exploratory Two-Sample Mendelian Randomization Study”, at ang abstrak na mga Paraan ay nagsisimula sa isang two-sample na pagsusuri gamit ang mga estadistika ng buod ng OpenGWAS. | Naiulat |
| 2 | pagpapakilala | Nagbibigay ng pasanin ng kakulangan sa bitamina D at type 2 diabetes sa Timog Asya, isang mekanismo sa pamamagitan ng mga receptor sa pancreatic beta cells, ang problema ng confounding at reverse causation sa observational data, at ang kaso para sa Mendelian randomization. | Naiulat |
| 3 | Katapusan ng Pagpapakilala | Nakasaad ang layunin na "suriin ang kaugnayan sa pagitan ng mga henetikong hinulaang antas ng Bitamina D at panganib ng T2D sa mga Timog Asyano". Ang layunin ay tumutukoy sa kaugnayan, at walang paunang natukoy na hipotesis ng sanhi na tinaguriang ganito. | Tawag ng paghatol |
| 4 | Seksyon 2.1; Talahanayan 1; Pigura 2 ng artikulo | Inilalahad nang maaga ang disenyo, kasama ang isang talahanayan ng mga pantukoy ng dataset, katangian, ninuno at laki ng sample, at isang diagram ng disenyo. | Naiulat |
| 4a | Mga Seksyon 2.1 at 2.2 | Binabanggit ang exposure GWAS (South Asian UK Biobank subset) at ang outcome meta-analysis ng 16 na cohort. Ang mga panahon ng recruitment at mga setting ng mga contributing cohort ay ipinauubaya sa mga source paper. | Tawag ng paghatol |
| 4b | Seksyon 2.2; Talahanayan 1; Seksyon 2.6 | Nagbibigay ng mga laki ng sample at kahulugan ng kaso ng type 2 diabetes. Ang pagkalkula ng power ay inilalarawan bilang post hoc, samantalang ang aytem ay nagtatanong kung ang isa ay nagawa bago ang pangunahing pagsusuri. | Tawag ng paghatol |
| 4c | Seksyon 2.3 | Iniuulat ang genome-wide threshold, ang relaxed threshold na ginamit para sa dalawang variant, na nagkukumpulan sa r2 sa ibaba ng 0.001 sa isang 10,000 kb window laban sa isang South Asian reference panel, proxy at palindromic handling, at ang genome build. | Naiulat |
| 4d | Seksyon 2.2 | Tinutukoy ang type 2 diabetes ayon sa kasaysayan o paggamot, fasting glucose, 2-hour glucose o HbA1c, at isinasaad ang rank-normalised scale ng 25-hydroxyvitamin D. Hindi pa inilalarawan ang paraan ng laboratoryo para sa pagsukat ng exposure. | Tawag ng paghatol |
| 4e | Seksyon 2.2; Pahayag ng Etika | Isinasaad na ang akda ay isang pangalawang pagsusuri lamang ng buod ng datos ng publiko at na "hindi kinakailangan ang pormal na etikal na pag-apruba". | Naiulat |
| 5 | Seksyon 2.4 | Inililista ang kaugnayan, paghihigpit sa pagbubukod, at kalayaan bilang tatlong pangunahing pagpapalagay. Ang mga pagpapalagay sa likod ng mga estimator ng sensitivity ay lilitaw lamang bilang isang tala sa Talahanayan 3 (hindi bababa sa 50% wastong mga variant para sa weighted median). | Tawag ng paghatol |
| 6a | Mga Seksyon 2.3 at 2.5 | Iniuulat ang mga epekto sa bawat 1 SD ng rank-normalized exposure, habang ang log-odds ay kino-convert sa odds ratios. | Naiulat |
| 6b | Mga Seksyon 2.3 at 2.5 | Tinatrato ang iisang genome-wide variant bilang isang instrumentong Wald-ratio at ang three-variant set na may mga inverse-variance weight. | Naiulat |
| 6c | Seksyon 2.5 | Pinangalanan ang mga estimator. Hindi sinasabi sa artikulo kung aling mga covariate ang ginamit sa alinmang GWAS. | Tawag ng paghatol |
| 6d | Seksyon 2.3 | Nakasaad na ang lahat ng tatlong variant ay magagamit sa datos ng kinalabasan at hindi na kailangan ng mga proxy. Wala itong mas malawak na pahayag tungkol sa nawawalang datos. | Tawag ng paghatol |
| 6e | Walang natagpuang pahayag | Ang pagsusuri ay nakasentro sa isang pagkakalantad at isang resulta, kaya maaaring hindi kumagat ang item, ngunit tahimik ang artikulo. | Tawag ng paghatol |
| 7 | Mga Seksyon 2.3 at 2.4 | Gumagamit ng F-statistics at variance na ipinaliwanag sa bawat variant at nagsasabing “Ang F > 10 ay nagpapahiwatig ng katanggap-tanggap na lakas ng kumbensyonal na instrumento ngunit hindi nito itinatatag ang mga pagpapalagay tungkol sa kalayaan o pagbubukod-paghihigpit”. | Naiulat |
| 8 | Mga Seksyon 2.5 at 3.4 | Pinaplano ang MR-Egger, weighted median, simple mode at weighted mode, pagkatapos ay idinaragdag ang mga pagtakbo sa dalawang nakakarelaks na threshold (68 at 18 na variant) at isang resultang naayos ayon sa BMI. | Naiulat |
| 9a | Seksyon 2.5 | Mga pangalang R 4.3.1, ang TwoSampleMR package na bersyon 0.7.0 at ang mRnd framework para sa power. | Naiulat |
| 9b | Walang natagpuang pahayag | Walang lumalabas na pahayag ng pagpaparehistro, bagama't ang pagsusuring inayos ayon sa BMI ay tinatawag na "paunang tinukoy". | Hindi matatagpuan sa artikulo |
| 10a | Table 1 | Ginamit ang datos sa antas ng buod, kaya walang umiiral na daloy ng kalahok. Ipinapakita sa Talahanayan 1 ang mga sukat. | Hindi naaangkop |
| 10b | Seksyon 2.2; Talahanayan 1 | Ibinibigay ang laki ng sample at ang case fraction (0.330). Walang ibinigay na mean o SD ng exposure. | Tawag ng paghatol |
| 10c | Seksyon 2.1 | Pinagsasama ng resulta ang 16 na cohort, at walang lumalabas na istatistika ng heterogeneity sa kanila. Maaaring mag-ulat ang source paper ng isa. | Tawag ng paghatol |
| 10d (i) | Seksyon 2.1 | Parehong dataset ay Timog Asyano, at ipinaliwanag ng artikulo kung bakit kinailangan ang disenyo na may dalawang sample. Hindi nito pinaghambing ang mga kaugnayan ng variant-exposure sa dalawang sample. | Tawag ng paghatol |
| 10d (ii) | Seksyon 2.1; Seksyon 5 | Nakasaad na “Ang eksaktong bilang ng mga magkakapatong na kalahok sa UK Biobank ay hindi matukoy mula sa nailathalang ulat o sa karagdagang datos nito”, pagkatapos ay nililimitahan ang posibleng bias na may proporsyon ng pinakamasamang kaso ng magkakapatong na 0.146. | Tawag ng paghatol |
| 11a | Talahanayan 2; Pigura 3 ng artikulo | Ang mga epekto ng variant-exposure, standard errors, at p-values ay nasa Table 2. Ang mga epekto ng variant-outcome ay lilitaw lamang sa scatter plot. | Tawag ng paghatol |
| 11b | Seksyon 3.3; Talahanayan 3 | Nag-uulat ng odds ratio na 1.06 (95% CI 0.83 hanggang 1.36) bawat 1 SD, na may p = 0.630, sa isang interpretable scale. | Naiulat |
| 11c | Walang natagpuang pahayag | Walang pagsasalin sa absolute risk, na angkop sa isang null primary estimate, ngunit hindi sinasabi ng artikulo kung bakit. | Tawag ng paghatol |
| 11d | Mga Larawan 3 at 4 ng artikulo | Nagbibigay ng scatter plot na may mga linya para sa bawat estimator at isang funnel plot. Walang ipinapakitang forest plot ng mga estima bawat variant. | Naiulat |
| 12a | Mga Seksyon 3.1 at 3.2 | Iniulat ang mga F-statistics mula 26.4 hanggang 33.4, Q p = 0.403 at isang Egger intercept p = 0.462, at idinagdag na "ang isang hindi makabuluhang intercept ay hindi dapat bigyang-kahulugan bilang nakapagpapatibay na ebidensya na wala ang horizontal pleiotropy". | Naiulat |
| 12b | Seksyon 3.2; Mga Talahanayan 3 at 4 | Ibinibigay ang Cochran Q para sa IVW at MR-Egger sa pangunahing pagsusuri at para sa IVW sa dalawang nakarelaks na threshold. | Naiulat |
| 13a | Mga Seksyon 3.4 at 3.5; Mga Talahanayan 3 at 4 | Nag-uulat ng apat na alternatibong estimator, dalawang luwag na threshold at ang kinalabasan na inayos ayon sa BMI. | Naiulat |
| 13b | Mga Seksyon 3.5 at 3.6; Talahanayan 5 | Iniuulat ang pagsusuring inayos ayon sa BMI at ang kapangyarihan nito ay humigit-kumulang 18%, 51% at higit sa 99% para sa mga odds ratio na 1.1, 1.2 at 1.5. | Naiulat |
| 13c | Seksyon 2.3 | Walang isinagawang pagsubok sa direksyon ng sanhi. Sinasabi ng artikulo na ang Steiger filtering ay hindi inilapat at ibinigay ang dahilan nito, na siyang dating kaalaman sa biyolohikal ng mga instrumento. | Hindi naaangkop |
| 13d | Seksyon 4.1 | Inihahambing ang resulta sa mga naunang pag-aaral ng randomisasyon ni Mendelian at mga pagsubok sa suplemento sa pamamagitan ng salita. Walang tinantyang hindi ayon sa randomisasyon ni Mendelian ang kinalkula. | Tawag ng paghatol |
| 13e | Seksyon 5 | Hindi nagpapakita ng leave-one-out plot at sinasabing ang MR-PRESSO at leave-one-out analyses ay "hindi maisagawa nang may sapat na katumpakan". | Tawag ng paghatol |
| 14 | Seksyon 4, pambungad na talata | Muling ipinahayag ang null na resulta laban sa layunin at binabanggit na ang pagtatantya ng MR-Egger ay masyadong hindi tumpak upang patunayan ito. | Naiulat |
| 15 | Seksyon 5 | Naglilista ng pitong limitasyon, at para sa sample overlap ay tinatantya ang laki ng posibleng bias gamit ang isang bounding approach. | Naiulat |
| 16a | Mga Seksyon 3.3, 4.1 at 6 | Binibigyang-kahulugan ang null bilang "kawalan ng isang natutukoy na kaugnayan sa loob ng katumpakan na ibinibigay ng mga kasalukuyang instrumento" at inihahambing ito sa mga naunang gawain. | Naiulat |
| 16b | Seksyon 4.2 | Nag-aalok ng tatlong paliwanag, kabilang ang mga di-linear na epekto. Hindi ginagamit ang terminong katumbas ng gene-environment. | Tawag ng paghatol |
| 16c | Seksyon 4.3 | Sinasabi na ang suplemento na naglalayong maiwasan ang type 2 diabetes ay hindi sinusuportahan ng kasalukuyang ebidensya ng sanhi at ang iba pang mga benepisyo ay hindi ibinukod. | Naiulat |
| 17 | Mga Seksyon 4.2 at 5 | Binabanggit na ang mga kalahok na residente ng UK ay maaaring naiiba sa mga tao sa Pakistan, na ang panghabambuhay na pagkakalantad sa henetiko ay naiiba sa mga pagsubok na may limitadong oras, at na ang mga linear na pamamaraan ay hindi makakatukoy ng mga di-linear na epekto. | Naiulat |
| 18 | Walang natagpuang pahayag | Walang pahayag ng pondo na lumalabas sa buong teksto o sa PDF, at walang nakalistang tagapondo para sa artikulo sa Crossref. | Hindi matatagpuan sa artikulo |
| 19 | Pahayag sa Pagiging Magagamit ng Data | Ibinibigay ang mga OpenGWAS identifier. Para sa code, sinasabi nito na ang script at dataset ay "idedeposito sa isang pampublikong repositoryo", kasama ang link na idadagdag. | Tawag ng paghatol |
| 20 | Salungatan ng Interes | Nakasaad na ang mga may-akda ay walang idinedeklarang anumang salungatan ng interes. | Naiulat |
Sa 44 na hanay ng STROBE-MR checklist, 22 ang Naiulat, 18 ang mga Judgement call, 2 ang Hindi matatagpuan sa artikulo at 2 ang Hindi naaangkop. Inilalarawan ng bilang kung gaano kalawak ang pagiging transparent ng artikulo laban sa mga ipinaraphrase na aytem, at hindi ito isang quality score. Maraming Judgement call ang nagmumula sa mga sub-aytem na minarkahan mismo ng checklist bilang kondisyonal.
Dalawang hanay ang nararapat tandaan tungkol sa pamamaraan. Para sa aytem 4b, tinatanong ng papel ng paliwanag kung ang isang pagkalkula ng kapangyarihan ay isinagawa bago ang pangunahing pagsusuri, at ang isang post hoc na pagkalkula ay sumasagot sa ibang tanong, kaya minarkahan namin ito ng isang Judgment call sa halip na isang puwang. Para sa aytem 19, nagbibigay ang artikulo ng mga pantukoy ng datos na maaaring sundin ng sinuman, ngunit ang pahayag ng code nito ay isang pangako, at ang isang pangako ay hindi maaaring suriin.
Ang Ipinapakita ng mga Numero sa Halimbawa
Ang isang checklist sa pag-uulat ay kapaki-pakinabang dahil sa bahagi ay nagbibigay-daan ito sa mambabasa na muling buuin ang mga numero. Binago namin ang mga dami ng headline sa Table 3 mula sa mga halagang nakalimbag sa artikulo. Kung saan kami tumutugma, ang pag-uulat ay panloob na pare-pareho, na siyang layunin ng STROBE-MR checklist na gawing posible. Kung saan kami nagkakaiba, ang aytem na susuriin ay ang humihiling sa mga may-akda na ipahayag ang kanilang mga pamamaraan at setting.
| dami | Ang aming muling paghalaw mula sa mga nakalimbag na halaga | Mga ulat ng artikulo | Komento |
|---|---|---|---|
| F-statistic, variant rs3755967 | (0.099 / 0.017)2 = 33.9 | 33.4 | Sa loob ng pag-round off ng ipinapakitang standard error |
| F-statistic, variant rs2459139 | (0.108 / 0.020)2 = 29.2 | 29.0 | Sa loob ng pag-round |
| F-statistic, variant rs72744878 | (0.101 / 0.020)2 = 25.5 | 26.4 | Sa loob ng rounding, dahil ang standard error na 0.0197 ay inililimbag bilang 0.020 at nagbibigay ng 26.4 |
| Mean F-statistic | (33.4 + 29.0 + 26.4) / 3 = 29.6 | 29.6 | Tumugma |
| Ipinaliwanag ang kabuuang pagkakaiba-iba | 0.405 + 0.342 + 0.309 = 1.056% | 1.06% | Tumugma |
| Ratio ng posibilidad ng IVW | exp(0.058) = 1.06 | 1.06 | Tumugma |
| IVW p-value | z = 0.058 / 0.120 = 0.483, p = 0.629 | 0.630 | Tumugma |
| IVW 95% na pagitan | exp(0.058 ± 1.96 × 0.120) = 0.84 hanggang 1.34 | 0.83 sa 1.36 | Hatol. Hindi nakasaad sa artikulo kung paano kinalkula ang pagitan |
| Iba pang mga agwat ng estimator | Tinimbang na median, simpleng mode, tinimbang na mode at MR-Egger | Gaya ng nakalimbag | Pagtugma kapag muling kinalkula mula sa bawat beta at standard error |
Ang isang pagkakaiba na sulit sa isang pangungusap ay ang IVW interval. Ang naiulat na 0.83 hanggang 1.36 ay tumutugma rin sa BMI-adjusted IVW estimate (beta 0.062, standard error 0.125), samantalang ang primary estimate na may standard error 0.120 ay nagbibigay ng 0.84 hanggang 1.34. Maliit ang agwat, ngunit ang pag-round off ng mga nakalimbag na halaga ay hindi ito maipaliwanag, dahil ang isang interval na 0.83 hanggang 1.36 ay nangangailangan ng standard error na malapit sa 0.126. Ang ibang interval method, tulad ng isa na nagpapalaki sa standard error kapag mayroong heterogeneity, ay isang posibleng dahilan. Hinihiling sa item 6 na ilarawan ng mga may-akda ang estimator at mga kaugnay na istatistika, at ang isang sugnay na nagpapangalan sa interval method ay mag-aalis ng tanong. Sa mga limitasyon, ang overlap passage ay nagbibigay din ng bias na humigit-kumulang 0.32% at humigit-kumulang 5.6% ng IVW estimate, kaya kailangang ipahiwatig ng mambabasa kung aling denominator ang ginagamit ng bawat pigura.
Apat na Aral sa Pag-uulat Mula sa Halimbawa ng STROBE-MR Checklist
Ang halimbawa ay may apat na aral na naaangkop sa anumang checklist ng STROBE-MR na iyong kukumpletuhin.
Sabihin ang hindi mo makuha, at sukatin ang pinakamasamang sitwasyon
Ang sample overlap ang aytem na kadalasang nakakakuha ng isang malabong pangungusap. Dito, ang exposure GWAS ay ganap na UK Biobank at ang outcome meta-analysis ay kinabibilangan ng UK Biobank, at isinulat ng mga may-akda na "Ang eksaktong bilang ng mga magkakapatong na kalahok sa UK Biobank ay hindi matukoy mula sa nailathalang ulat o sa karagdagang datos nito". Pagkatapos ay iniulat nila na nabigo ang MRlap tool dahil ang covariance step ay nagbalik ng mga hindi natukoy na halaga, at pinapalitan ang isang bounding calculation ng isang ipinapalagay na overlap proportion na 0.146 at phenotypic correlation na −0.12. Iyan ang pattern item na hinihingi ng 10d, katulad ng isang numero kung saan umiiral ang isa at isang bound kung saan wala ito.
Paghiwalayin ang lakas ng instrumento mula sa bisa ng instrumento
Nakasaad sa artikulo na “Ang F > 10 ay nagpapahiwatig ng katanggap-tanggap na lakas ng kumbensyonal na instrumento ngunit hindi nito itinatatag ang mga pagpapalagay tungkol sa kalayaan o pagbubukod-paghihigpit”. Ang papel ng paliwanag ay nagbibigay ng kaugnay na punto, na ang isang F-statistic na higit sa 10 ay hindi nag-aalis ng bias sa mahinang instrumento, at inihahambing nito ang tuntunin ng hinlalaki sa isang cut-off para sa mga p-value [1] . Ang pagsulat sa magkabilang kalahati ng pangungusap ay nagpoprotekta sa papel mula sa isang tagasuri na nagbabasa ng F-statistic bilang isang hatol.
Sabihin kapag walang kapangyarihan ang isang diagnostic
Sa tatlong variant, ang MR-Egger intercept ay may isang natitirang antas ng kalayaan. Isinulat ng mga may-akda na "ang isang hindi makabuluhang intercept ay hindi dapat bigyang-kahulugan bilang isang nakapagpapatibay na ebidensya na wala ang horizontal pleiotropy". Ang isang pleiotropy test na iniulat nang walang pangungusap na iyon ay nag-aanyaya sa pagbasa na ang pag-aaral ay malinis. Ang aming post tungkol sa kung ano ang pinoprotektahan ng bawat pleiotropy estimator ay nagpapaliwanag kung bakit nililimitahan ng bilang ng mga variant ang bawat pamamaraan.
Isara ang loop sa pagitan ng Mga Paraan, Mga Limitasyon at ang listahan ng sanggunian
Apat na detalye sa nailathalang artikulo ang maaaring magdulot ng query ng isang copy editor. Sinasabi sa Seksyon 2.3 na hindi inilapat ang Steiger directionality filtering, ngunit sinasabi sa Seksyon 5 na ang mga detalye nito ay "dapat kumpirmahin at iulat sa panghuling Paraan", na parang isang drafting note. Nangangako ang Data Availability Statement ng isang repository link na wala pa sa teksto. Binabanggit ng design figure (aming Figure 1) ang outcome study bilang reference 7, samantalang ang reference list ay nagbibigay nito bilang 9, at ang reference 7 ay isang pagsusuri nina Davey Smith at Hemani. Ang overlap-bounding approach ay kinikilala kay Burgess at mga kasamahan bilang reference 11, at ipinapakita ng listahan ang reference 11 bilang MR-Egger interpretation paper nina Burgess at Thompson. Wala sa mga ito ang nagbabago sa mga natuklasan. Ang lahat ng ito ay maaaring ayusin sa panghuling pagbasa ng mga patunay, kaya naman ipinapayo namin na suriin ang bawat placeholder at citation number laban sa checklist bago isumite.
Paano Kumpletuhin ang Iyong Sariling STROBE-MR Checklist
Ang STROBE-MR checklist ay pinakamahusay na gumagana kapag pinupunan ito habang isinusulat ang manuskrito, hindi pagkatapos magtanong ang tagasuri. Ang mga hakbang sa ibaba ay sumusunod sa pagkakasunud-sunod kung saan karaniwang makukuha ang mga sagot.
- I-download ang checklist mula sa Website ng STROBE-MR o mula sa papel ng paliwanag [1], at magdagdag ng column para sa pahina o seksyon kung saan nakalagay ang bawat sagot.
- Gumawa ng talahanayan ng pinagmulan ng datos sa simula ng Methods, kasama ang mga identifier ng dataset, katangian, ninuno, laki ng sample, bilang ng kaso at pagbuo ng genome, tulad ng ginagawa ng halimbawa sa Talahanayan 1 nito.
- Isulat ang pangungusap na "overlap" kahit na ang "overlap" ay sero. Kung hindi mo ito mabilang, maglagay ng hangganan.
- Iulat ang F-statistics at variance na ipinaliwanag sa bawat variant, pagkatapos ay magdagdag ng power statement para sa effect size na mahalaga.
- Sabihin ang katayuan ng rehistrasyon, kasama ang isang simpleng pahayag ng kawalan ng rehistrasyon kapag ganoon nga, dahil ang item 9b ay humihingi ng isang pahayag sa alinmang paraan.
- Ideposito ang code at ang pinagtugmang dataset bago isumite, at palitan ang bawat placeholder ng isang link.
- Para sa mga hilera na hindi naaangkop, magsulat ng isang linyang dahilan sa hilera sa halip na iwan itong blangko.
- Sabihin sa Mga Paraan na ang pag-aaral ay sumunod sa STROBE-MR, at ilakip ang nakumpletong checklist kung hihilingin ng journal. Ang aming checklist ng pagsusumite ng manuskrito Inililista nito ang iba pang mga file na inaasahan ng mga editor.
Mga Karaniwang Pagkakamali Kapag Nag-uulat ng Pag-aaral ng Mendelian Randomization
Ito ang mga pagkakamaling inaasahan nating pinakamadalas makita kapag ang isang STROBE-MR checklist ay nahuli sa pagkumpleto, at bawat isa ay tumutugma sa isang partikular na aytem.
- Pagpapangalan ng mga dataset nang hindi inilalarawan ang mga ito. Nais ng Aytem 4 na ilista ang populasyon, mga petsa, laki ng sample, at kahulugan ng kaso para sa bawat pinagmulan.
- Iniuulat lamang ang pangunahing estimator. Nais ng mga aytem 8 at 13 na maisama ang bawat pagsusuri ng sensitibidad, kabilang ang mga hindi magkatugma.
- Hindi isinama ang katayuan ng pagpaparehistro. Ang Aytem 9b ay humihingi ng pahayag sa alinmang paraan.
- Gamit ang wikang sanhil, hindi kayang ipatupad ang mga pagpapalagay. Hinihiling sa mga may-akda ng aytem 16 na sabihin na ang mga pagtatantya ay sanhi lamang sa ilalim ng mga nakasaad na pagpapalagay.
- Kodigo na nangangako. Gusto ng item 19 ang code o ang lokasyon nito, at ang isang link sa hinaharap ay hindi isang lokasyon.
Mga Madalas Itanong Tungkol sa Checklist ng STROBE-MR
Ilang aytem ang mayroon sa STROBE-MR checklist?
Ang STROBE-MR checklist ay may 20 aytem, at ilan sa mga ito ay may mga sub-aytem na may letra, kaya ang isang nakumpletong form ay may higit sa 20 hanay [1].
Papalitan ba ng STROBE-MR ang checklist ng STROBE?
Para sa isang ulat ng randomisasyon ni Mendelian, ang STROBE-MR ang gabay na dapat sundin. Para sa isang kumbensyonal na obserbasyonal na pag-aaral, gamitin ang STROBE, na siyang sakop ng aming tutorial sa STROBE.
Dapat bang gamitin ang STROBE-MR upang masuri ang kalidad ng isang nailathalang pag-aaral?
Hindi. Sinasabi ng mga may-akda na ang STROBE-MR checklist ay hindi dapat gawing isang sukatan ng kalidad, at umiiral ito upang gawing posible ang pagtatasa sa halip na isagawa ito [1].
Kailangan ba ng kalkulasyon ng kapangyarihan upang matugunan ang item 4b?
Hinihiling sa mga may-akda ng aytem 4b ng STROBE-MR checklist na iulat ang laki ng sample at kung may anumang pagkalkula ng lakas o laki ng sample na isinagawa bago ang pangunahing pagsusuri. Ang isang pahayag na walang ginawa ay isang wastong sagot, at ang isang post hoc na pagkalkula ay dapat lagyan ng label na ganito, tulad ng ginagawa sa halimbawa.
Mga Libreng Kagamitan sa Pananaliksik mula sa Editverse
- GraphPro: bumuo ng mga tsart na handa nang ilathala, 25 uri, na may built-in na t-test, ANOVA, correlation, at chi-square p-values. Libre, walang pag-signup.
- StatPro: mga libreng statistical calculator at isang tool para sa pagpili ng pagsubok na sumasaklaw sa mga paghahambing ng grupo, mga resultang pangkategorya, pagsusuri batay sa oras ng pangyayari, at katumpakan ng pagsusuri.
- Flowchart Pro: bumuo ng mga flow diagram ng PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE, at ARRIVE nang direkta sa iyong browser.
Propesyonal na Suporta para sa isang Mendelian Randomization Manuscript
Maaari lamang itala ng isang checklist kung ano ang nilalaman na ng pagsusuri. Nagpaplano ka man ng pagsusuri o naghahanda upang makumpleto ang checklist ng STROBE-MR, sinusuportahan ng Editverse ang mga may-akda sa parehong yugto, at ang aming trabaho ay sumusunod sa gabay ng COPE, ICMJE at GPP 2022, na may mga kinakailangan sa etika na sinusunod ng mga institusyon at bansa. Kasama sa kumpletong pakete ng pag-aaral sa ibaba ang isang nakumpletong checklist ng STROBE-MR.
Bago ka mangako
$450
Susuriin ng isang senior analyst kung nasagot na ang iyong tanong, kung masusuportahan ito ng datos, at kung mayroon kang kakayahang umangkop, kabilang ang lakas ng instrumento para sa isang disenyo ng randomisasyon ni Mendelian. Binibigyan ng buong kredito ang anumang pag-aaral na iyong gagawin. 5 araw ng negosyo.
Buong pag-aaral
$2,900
Two-sample Mendelian randomization mula sa mga pampublikong estadistika ng buod ng GWAS, kasama ang lakas ng instrumento, Steiger filtering, apat na estimator na sumusuri sa pleiotropy, MR-PRESSO, manuskrito, mga plot, runnable TwoSampleMR code at isang STROBE-MR checklist. 15 araw ng negosyo.
Ipadala sa amin ang iyong draft at ang journal na iyong tinatarget, at sasabihin namin kung alin sa dalawa ang akma sa iyong kinalalagyan.
Konklusyon
Ang STROBE-MR checklist ay ginagawang isang bagay na maaaring i-audit ng isang mambabasa ang isang papel ng Mendelian randomization mula sa isang hanay ng mga resulta. Kung ilalapat sa isang tunay na open-access na pag-aaral, ipinapakita nito kung ano ang hitsura ng isang mahusay na pag-uulat, na may mga quantified na pinakamasamang kaso, mga tapat na tala sa mga low-powered na pagsubok at isang design diagram sa unang pahina ng Methods, at ipinapakita nito kung saan kahit ang isang maingat na papel ay nag-iiwan ng mga puwang, katulad ng pagpaparehistro, pagpopondo, mga covariate at code. Kumpletuhin ang checklist bago isumite, magsulat ng dahilan sa bawat hilera na hindi naaangkop, at suriin ang bawat placeholder at numero ng citation sa mga huling patunay.
Mga sanggunian
- Skrivankova VW, Richmond RC, Woolf BAR, Davies NM, Swanson SA, VanderWeele TJ, et al. Pagpapalakas ng pag-uulat ng mga obserbasyonal na pag-aaral sa epidemiology gamit ang paliwanag at pagpapaliwanag ng mendelian randomisation (STROBE-MR). BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233. PMID 34702754. PMC8546498.
- Skrivankova VW, Richmond RC, Woolf BAR, Yarmolinsky J, Davies NM, Swanson SA, et al. Pagpapalakas ng pag-uulat ng mga obserbasyonal na pag-aaral sa epidemiology gamit ang Mendelian randomization. Ang pahayag ng STROBE-MR. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID 34698778.
- Zaka A, Khan S, Shah A, Khalid AA, Khalil I, Kamrul-Hasan ABM. Ugnayan sa pagitan ng henetikong hinulaang 25-hydroxyvitamin D at panganib ng type 2 diabetes sa mga Timog Asyano. Isang eksploratory two-sample na pag-aaral ng Mendelian randomization. Endocrinol Diabetes Metab. 2026;9(6):e70359. doi:10.1002/edm2.70359. PMID 42912852. PMCID PMC13690357Lisensya CC BY 4.0.
- Woolf B, Di Cara N, Moreno-Stokoe C, Skrivankova V, Drax K, Higgins JPT, et al. Pagsisiyasat sa transparency ng pag-uulat sa two-sample summary data na may mga pag-aaral ng Mendelian randomization gamit ang MR-Base platform. Int J Epidemiol. 2022;51(6):1943-1956. doi:10.1093/ije/dyac074. PMID 35383846. PMC9749715.
- Loh M, Zhang W, Ng HK, Schmid K, Lamri A, Tong L, et al. Pagtukoy sa mga epektong henetiko na saligan ng type 2 diabetes sa mga populasyon ng Timog Asya at Europa. Commun Biol. 2022; 5: 329. doi:10.1038/s42003-022-03248-5. PMID 35393509.
Ang mga salita sa gabay ay hinango mula sa papel ng paliwanag ng STROBE-MR, na inilathala sa ilalim ng CC BY 4.0. Ang mga rekomendasyon ng ICMJE ay makukuha sa icmje.org.