발행 | 최종 업데이트:
유덴 지수는 연속 진단 검사 또는 바이오마커의 임계값을 선택하는 가장 일반적인 방법입니다. 아래 두 계산기를 사용하여 유덴 지수를 계산한 다음, 공식, 예시, 임계값 선택 방법 및 이 방법의 한계에 대한 설명을 읽어보세요.
이 페이지 내용: 계산기 · 공식 · 예제 · 최적 임계값 · 해석 · 실제 데이터 사례 연구 · Youden 기준과 다른 기준 비교 · 한계점 · R 코드 · 자주 묻는 질문
유덴 인덱스 계산기
민감도와 특이도 값을 이미 알고 있다면 입력하십시오. 원시 데이터만 있는 경우 아래의 2×2 표 버전을 사용하십시오.
참양성율
참음성률
| 유덴지수(J) | 0.7500 |
| 읽기 (일반적인 규칙) | 높음 |
| 오탐률(1 − Sp) | 10.00% |
| 위음성률(1 − Se) | 15.00% |
J = Se + Sp − 1. 아래 예시(J = 0.80)를 재현하려면 Se 0.92와 Sp 0.88을 입력해 보세요.
정수로 입력하세요. 최소한 질병 환자 1명과 비질병 환자 1명이 필요합니다.
질병 존재, 검사 양성
질병 없음, 검사 양성
질병은 있으나 검사 결과는 음성입니다.
질병 없음, 검사 음성
두 계산기 모두 브라우저에서 실행되며 어떤 데이터도 전송하지 않습니다. 2×2 버전은 셀이 0이거나 완벽하게 분리된 경우와 같은 예외적인 상황에서 R 패키지의 pROC 곡선을 사용하여 검증했습니다.
유덴 지수 공식
Youden은 1950년에 진단 테스트에 대한 단일 등급으로 이 지수를 제안했습니다[1]. 알아두면 유용한 세 가지 속성이 있습니다.
- 범위. 하나의 검사에서 하나의 임계값에 대해 −1 ≤ J ≤ 1입니다. J = 0은 검사 결과가 동전 던지기보다 나을 것이 없음을 의미하고, J < 0은 검사 결과가 잘못되었음을 의미합니다. 모든 임계값에 걸쳐 J의 최댓값은 0보다 작을 수 없습니다.
- 기하학. J는 ROC 곡선과 대각선 확률선 사이의 수직 간격입니다. 이 간격이 가장 큰 지점이 유덴 임계값입니다(그림 1).
- 널리 퍼짐. J 값은 질병 유병률에 따라 변하지 않는데, 이는 민감도(Se)와 특이도(Sp)가 질병이 있는 그룹과 건강한 그룹에서 각각 따로 측정되기 때문이다.

풀이 예시
예시 1: Se와 Sp에서
검사의 민감도는 0.92이고 특이도는 0.88입니다. J = 0.92 + 0.88 − 1 = 0.80 . 이 검사는 질병이 있는 환자의 8%를 놓치고 건강한 환자의 12%를 잘못 진단합니다.
예시 2: 2×2 표에서
200명의 환자를 대상으로 기준치에 대한 검사를 실시한다고 가정해 보겠습니다. 아래 표는 예시일 뿐이며, 발표된 연구 결과를 바탕으로 작성된 것은 아닙니다.
| 질병이 있습니다 | 질병 없음 | |
|---|---|---|
| 검사 결과 양성 | TP = 85 | FP = 10 |
| 검사 결과 음성 | FN = 15 | 티엔티 = 90 |
- 감도 = 85 / (85 + 15) = 0.85
- 특이도 = 90 / (90 + 10) = 0.90
- J = 0.85 + 0.90 − 1 = 0.75
동일한 계산을 적용하면 PPV 85/95 = 89.5%, NPV 90/105 = 85.7%, 양성우도비(LR+) = 0.85 / 0.10 = 8.5, 음성우도비(LR−) = 0.15 / 0.90 = 0.17이 됩니다. 두 번째 계산기에 입력하여 확인해 보세요.
최적의 차단값을 찾는 방법
연속 마커를 사용하면 각 가능한 차단점마다 고유한 민감도(Se)와 특이도(Sp)가 결정됩니다. 단계는 다음과 같습니다.
- 후보 임계값 목록을 작성합니다. 일반적으로 모든 관측값 또는 임상적으로 타당한 격자 형태로 작성합니다.
- 각 임계값에서, 마커 값이 해당 임계값 이상일 경우 환자를 양성으로 분류하고, 기준 표준에 대한 민감도(Se)와 특이도(Sp)를 계산합니다.
- 각 차단점에서 J = Se + Sp − 1을 계산합니다.
- J 값이 가장 큰 임계값을 선택한 다음, 해당 임계값과 J 값에 대한 부트스트랩 신뢰 구간을 추가합니다.
아래 표는 질병이 있는 사람 100명과 질병이 없는 사람 100명을 대상으로 측정한 생체지표에 대해 임의로 설정한 수치를 사용합니다. J 값은 임계값 25에서 0.70으로 최고치를 나타내므로, 여기서 25가 유덴 최적 임계값입니다.
| 끊다 | 감도 | 특성 | J |
|---|---|---|---|
| 10 | 0.98 | 0.40 | 0.38 |
| 15 | 0.95 | 0.62 | 0.57 |
| 20 | 0.90 | 0.78 | 0.68 |
| 25 | 0.82 | 0.88 | 0.70 |
| 30 | 0.70 | 0.94 | 0.64 |
| 35 | 0.52 | 0.98 | 0.50 |
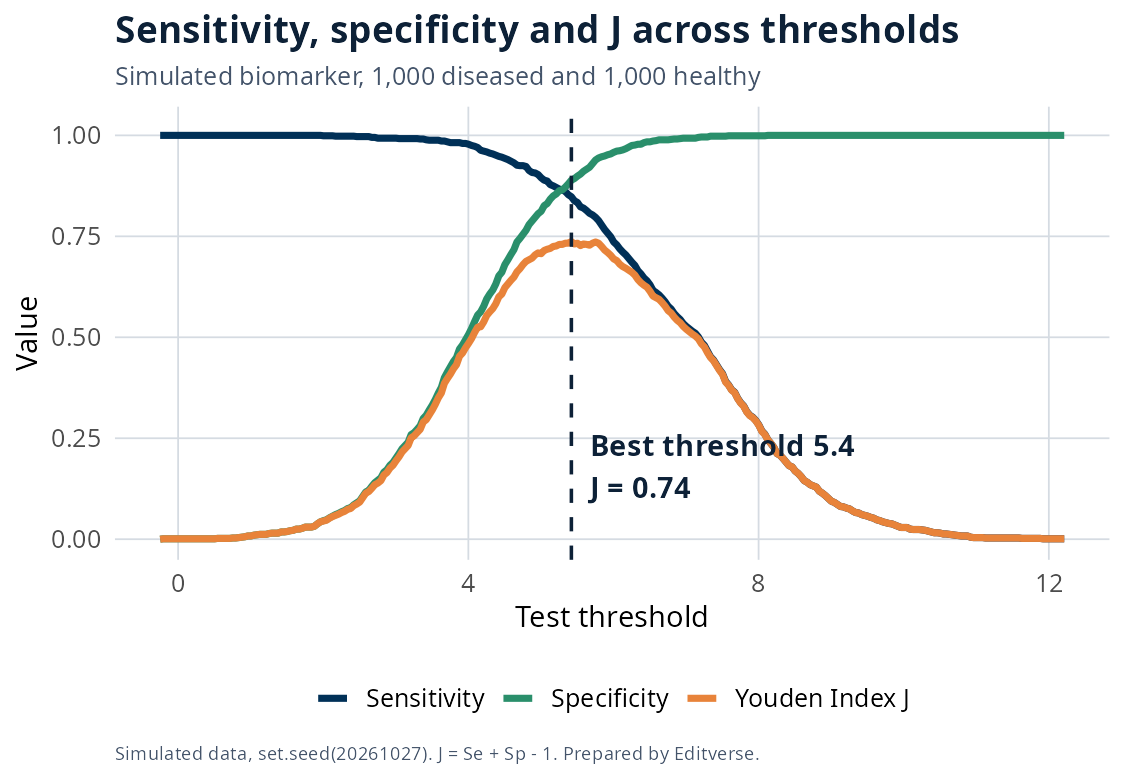
정점 양쪽에서 어떤 일이 발생하는지 주목하십시오. 임계값이 낮으면 특이도가 떨어지는 대신 민감도가 높아지고, 임계값이 높으면 그 반대가 됩니다. 그림 2는 시뮬레이션 데이터를 사용하여 이러한 상호 작용을 보여주는데, J는 민감도와 특이도 곡선이 교차하는 지점 근처에 정상부가 있는 언덕 모양을 형성합니다.
유덴 지수를 해석하는 방법
합의된 척도는 없습니다. 아래의 범위는 일반적인 경험 법칙이며, 위의 계산기는 이를 활용합니다. 이를 출발점으로 삼고 임상적 중요성을 고려하여 J 값을 판단하십시오.
| J | 읽기 | 실제로 의미하는 바 |
|---|---|---|
| 0.75 ~ 1.00 | 높음 | 두 가지 유형의 오류 모두 거의 없음 |
| 0.50 ~ 0.74 | 좋은 | 유용하지만, 눈에 띄는 오류율이 있을 것으로 예상됩니다. |
| 0.25 ~ 0.49 | 보통 | 혼자서는 약하지만, 패널의 일원으로 참여하면 도움이 될 수 있습니다. |
| 0 ~ 0.24 | 높음 | 우연에 가까움 |
| 0 아래 | 우연보다 더 나쁘다 | 테스트 방향이 반대로 되어 있지 않은지 확인하십시오. |
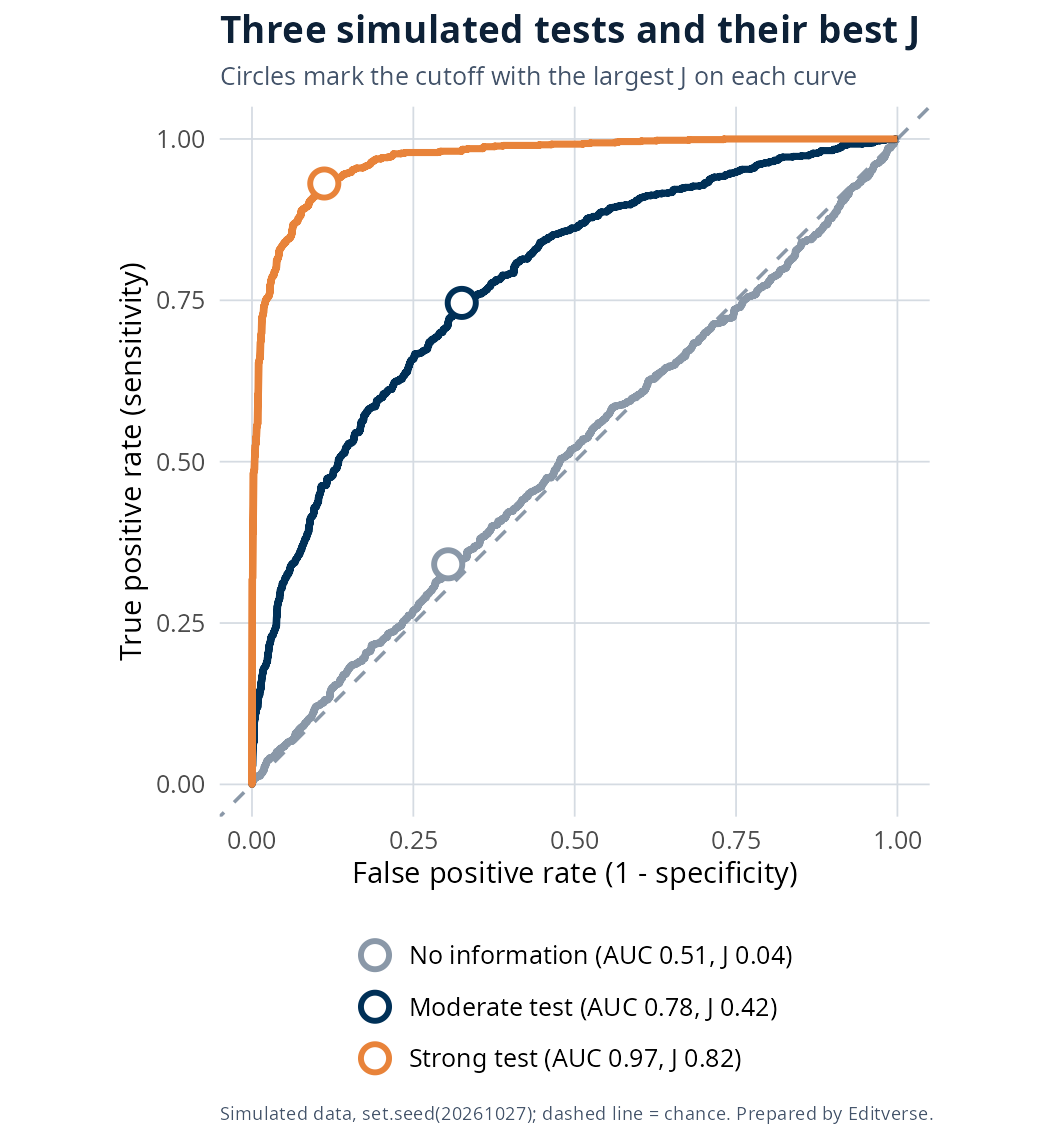
그림 3은 시뮬레이션된 세 가지 ROC 곡선을 비교합니다. 정보가 없는 검사(J = 0.04), 중간 정도의 검사(J = 0.42), 그리고 강력한 검사(J = 0.82)입니다. 강력한 검사조차도 두 그룹을 완벽하게 분리해야 하는 J = 1에 도달하지 못합니다.
실제 데이터 사례 연구: PLOS ONE에 공개된 두 편의 연구 논문
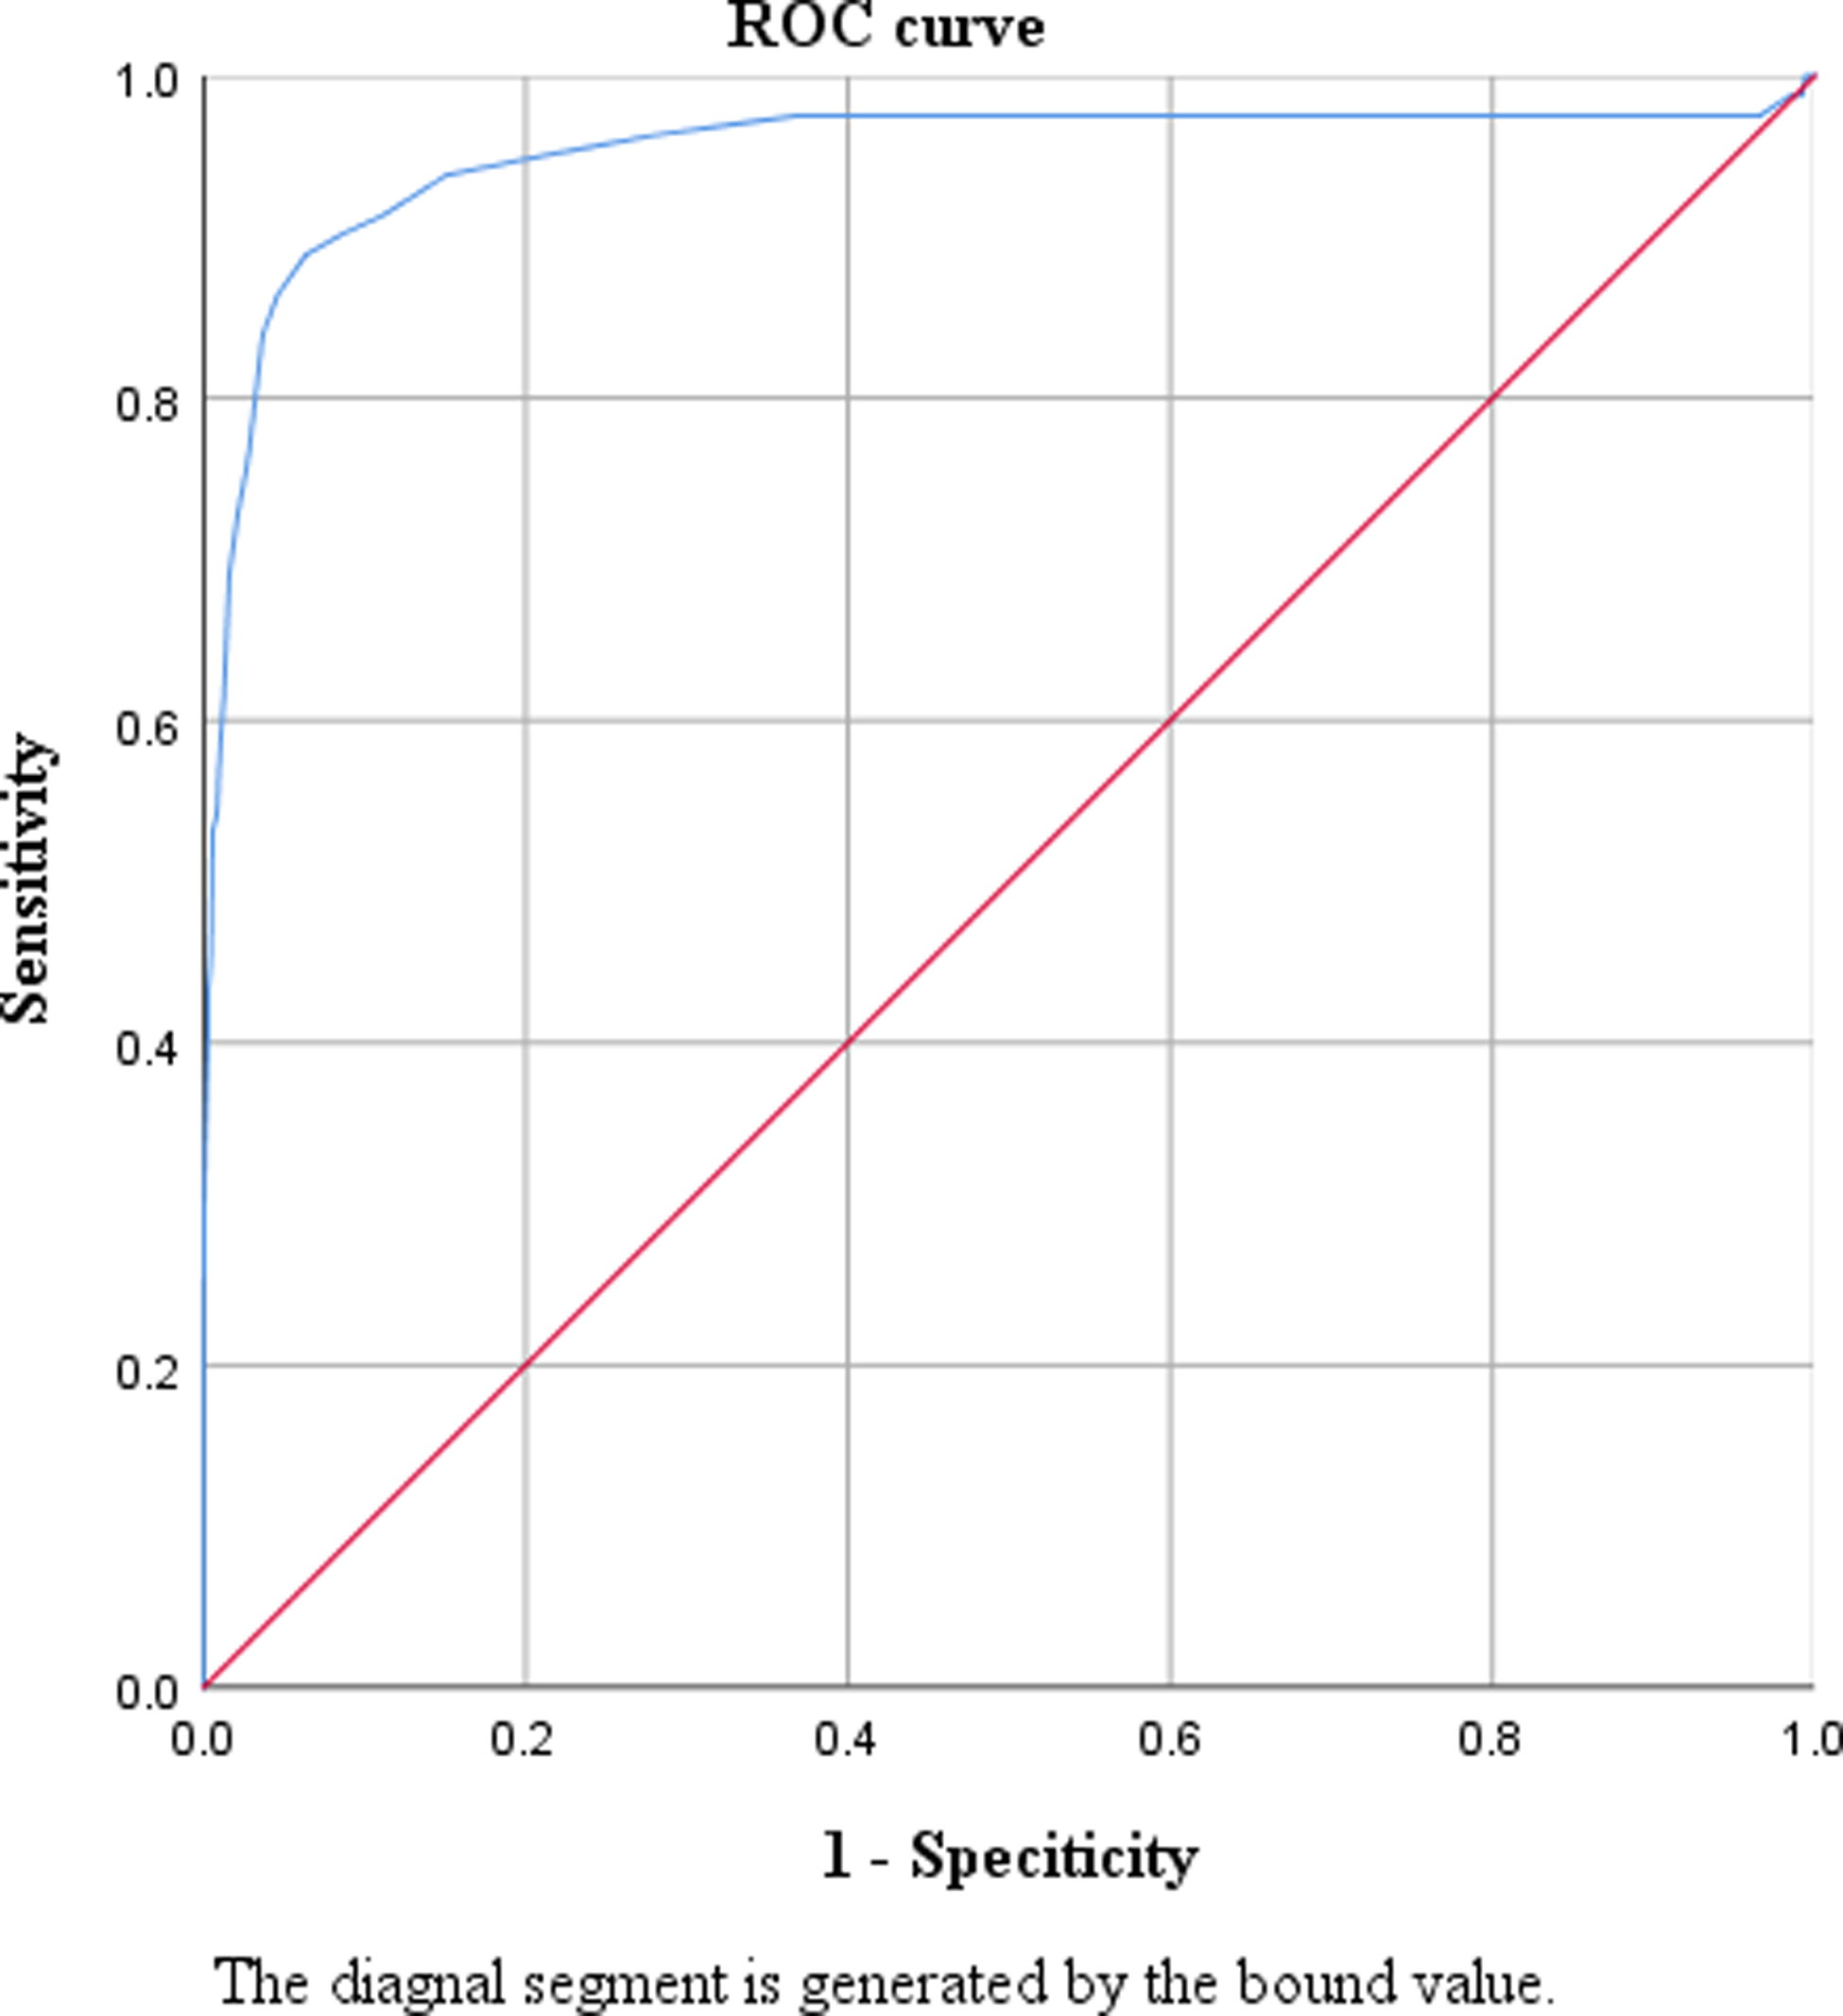
최근 PLOS ONE에 발표된 두 편의 연구에서 유덴 지수(Youden Index) 전체 내용이 보고되었으며, 두 연구 모두 CC BY 4.0 라이선스 하에 공개되었으므로 아래에 해당 ROC 곡선을 재현할 수 있습니다. 저희는 공개된 수치를 바탕으로 표를 재구성하고 계산을 다시 수행했습니다. '저희 분석'이라고 표시된 부분은 해당 표를 기반으로 저희가 직접 계산한 결과이며, 저자들이 보고한 결과가 아닙니다.
사례 1: 중국 농촌 지역의 당뇨병 진단을 위한 HbA1c 기준치
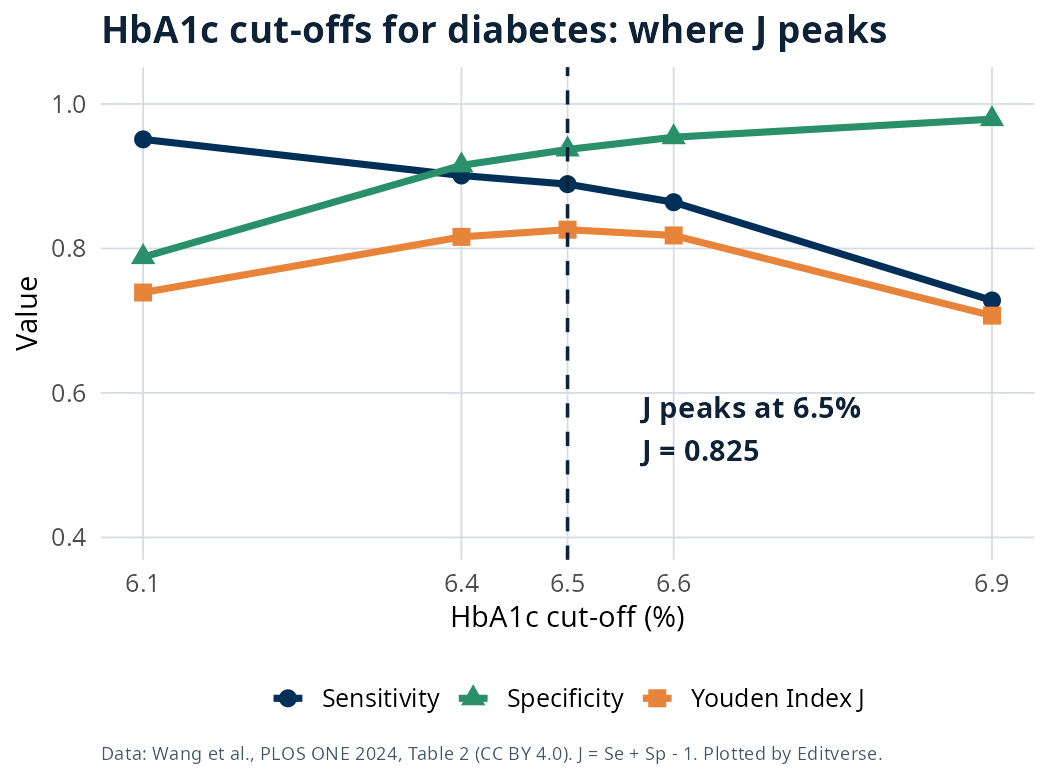
Wang과 동료들은 중국 농촌 지역의 61세 이상 성인 3,547명을 대상으로 공복 혈장 포도당(FPG)과 당화혈색소(HbA1c)를 측정했습니다. 이전에 당뇨병 진단을 받지 않은 3,122명 중에서 FPG 7.0mmol/L 이상을 기준 표준으로 사용하고 J를 최대화하는 HbA1c 임계값이 무엇인지 물었습니다. 그 답은 6.5%(48mmol/mol)였으며, 민감도는 88.9%, 특이도는 93.7%, J = 0.825였습니다 [12].
| HbA1c 차단점 | 감도 | 특성 | J (Se + Sp − 1) | PPV |
|---|---|---|---|---|
| 6.1% | 95.1% | 78.8% | 0.739 | 10.7% |
| 6.4% | 90.1% | 91.5% | 0.816 | 22.0% |
| 6.5% | 88.9% | 93.7% | 0.826 | 27.2% |
| 6.6% | 86.4% | 95.4% | 0.818 | 33.3% |
| 6.9% | 72.8% | 97.9% | 0.707 | 47.6% |
출처: Wang et al. 2024, Table 2 [12]. 우리는 반올림된 Se와 Sp로부터 J를 다시 계산했는데, 그 결과 6.5%에서 0.826이 나왔습니다. 논문에서는 반올림되지 않은 값으로부터 0.825를 보고합니다.
이 사례가 보여주는 것은
- 뚜렷한 봉우리. J 값은 6.1%에서 0.738에서 6.5%에서 0.825로 상승했다가 6.9%에서 0.707로 하락합니다. 급격한 최고점을 보이는 만큼, 표본의 작은 변화는 차단점의 변동폭을 크게 늘리지 않을 것으로 예상됩니다.
- 두 가지 기준 모두 같은 답을 제시합니다. 우리의 계산에서 가장 왼쪽 상단 모서리에 가까운 지점도 6.5%입니다(거리 0.128, 6.4%의 경우 0.131과 비교). 그들은 이 데이터 세트에 동의하지만 아무것도 이를 보장하지 않습니다[4].
- 높은 J 값이 높은 PPV를 의미하는 것은 아닙니다. 양성예측률(PPV)이 6.5%일 때 특이도가 93.7%임에도 불구하고 27.2%에 불과합니다. 발표된 민감도(Se), 특이도(Sp), PPV를 기준으로 추정하면, 이 검사 대상 표본 중 약 2.6%가 공복혈당(FPG) 검사에서 당뇨병을 앓고 있었을 것으로 예상됩니다. 당뇨병이 드문 경우, 아무리 정확한 검사라도 위양성이 많이 발생할 수 있습니다. PPV는 해당 유병률과 함께 보고해야 합니다.
사례 2: 산부인과 병동에서의 모스 낙상 척도
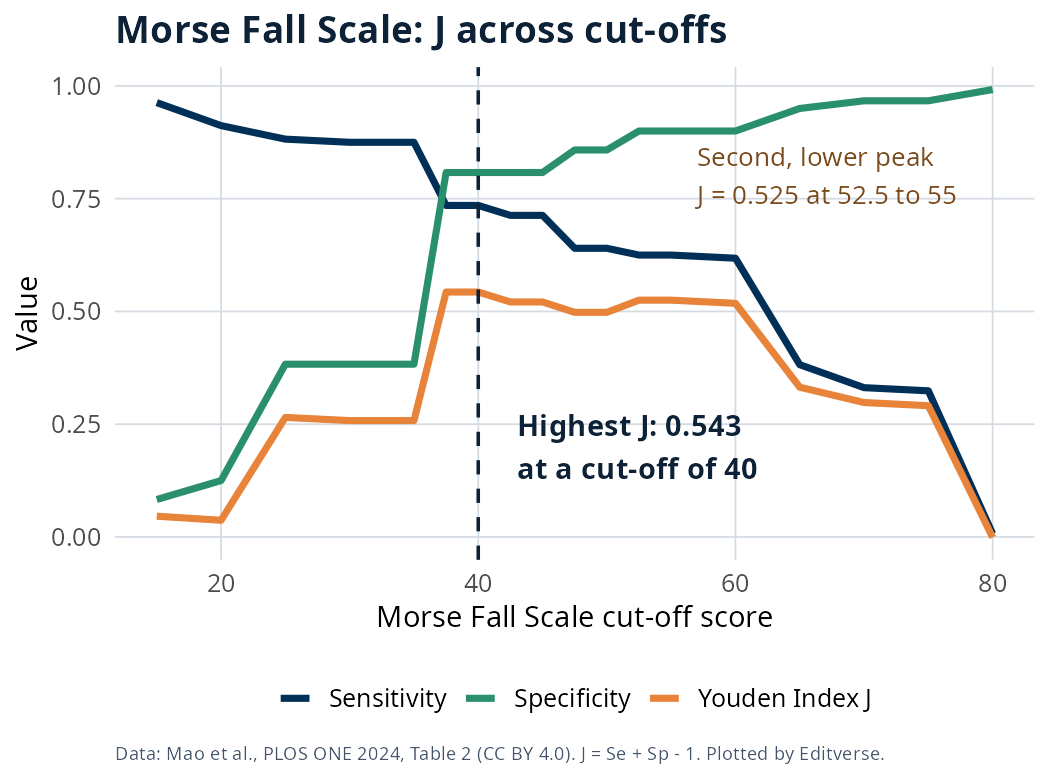
Mao와 동료들은 산부인과 병원과 일반 병원에서 낙상한 입원 환자 136명과 낙상하지 않은 입원 환자 120명을 비교하고 각각에 대해 Morse 낙상 척도를 평가했습니다. ROC 곡선의 AUC는 0.791이었고, 저자들은 민감도 0.735, 특이도 0.808, J = 0.543인 40을 절단점으로 선택했습니다 [13].
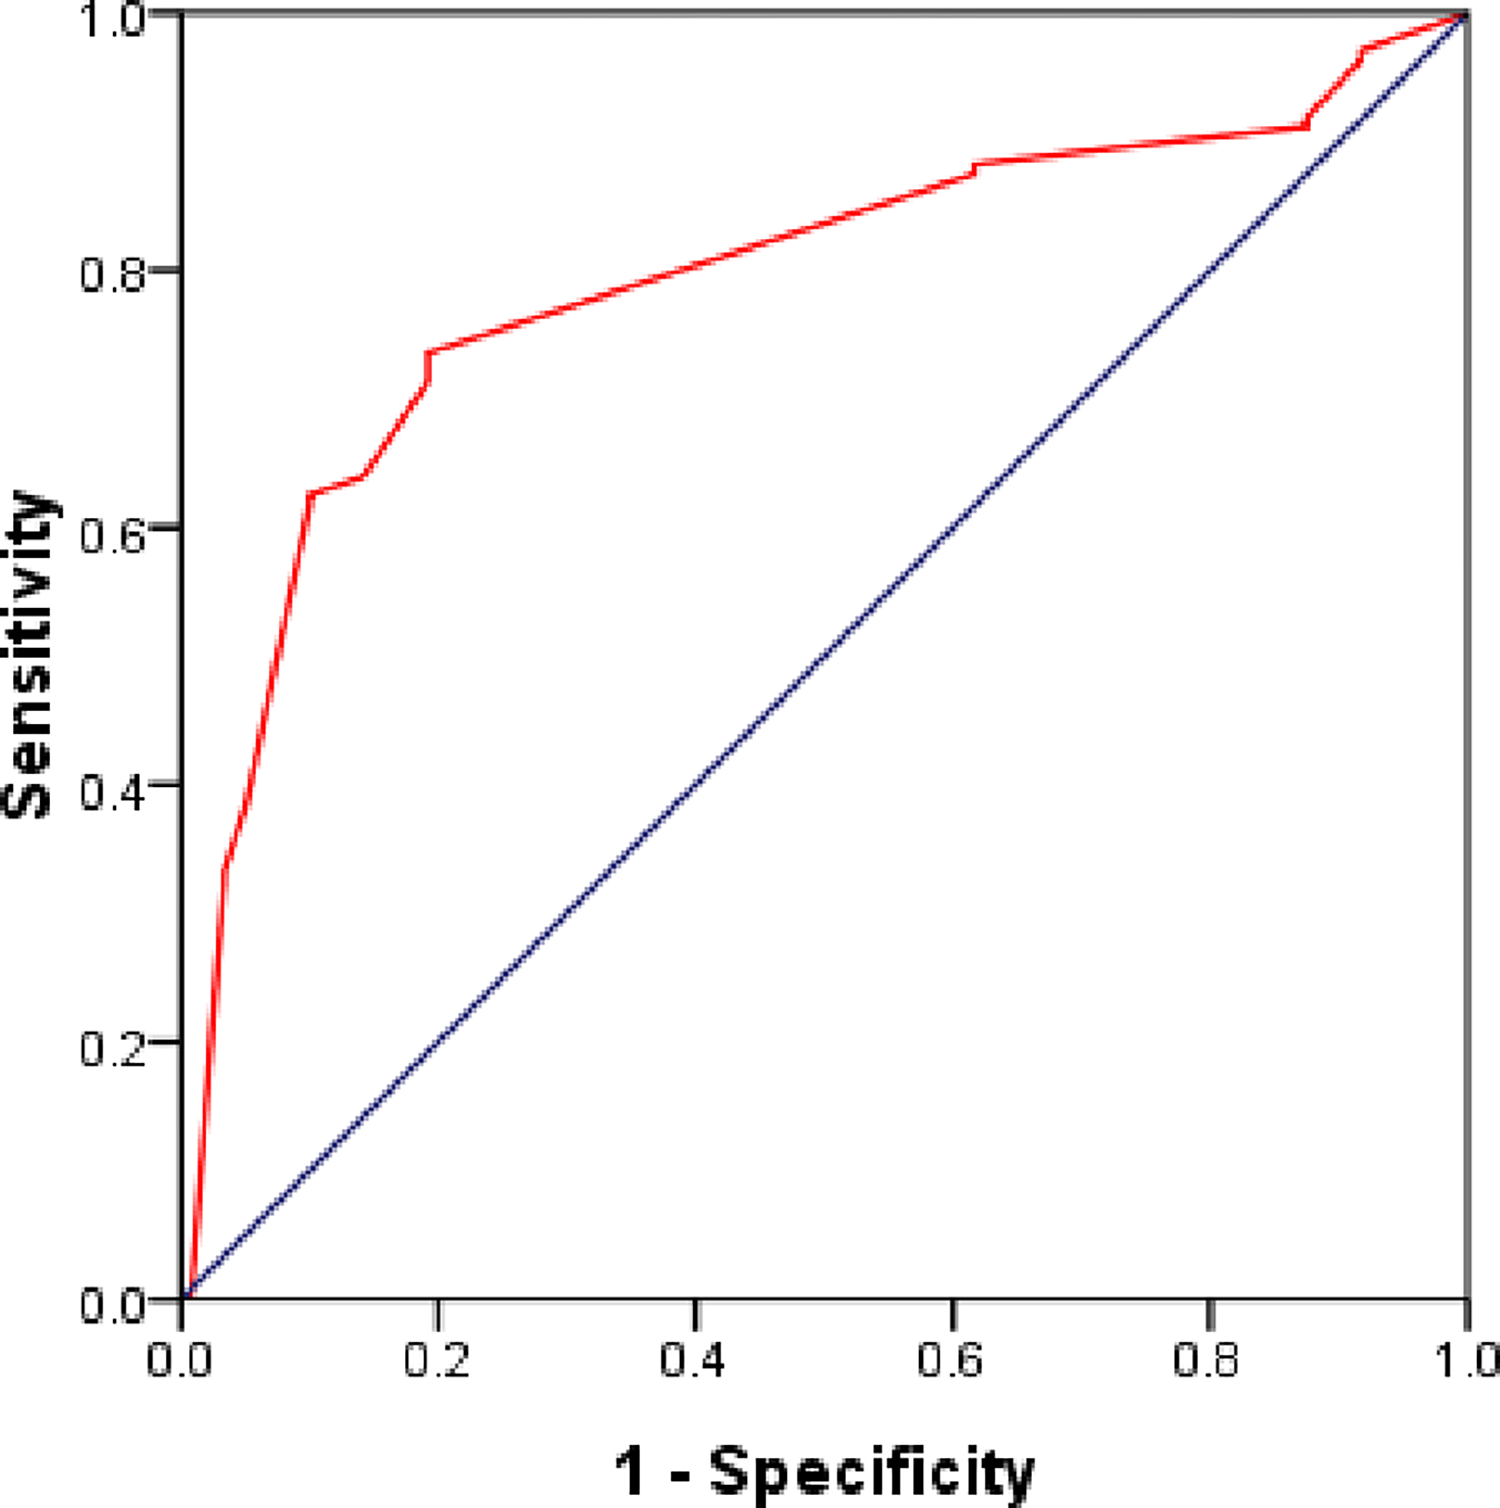
| 끊다 | 감도 | 특성 | J (Se + Sp − 1) | 가중 손실 (낙상 감지 실패 = 3배 오경보) |
|---|---|---|---|---|
| 25 | 0.882 | 0.383 | 0.265 | 0.971 |
| 35 | 0.875 | 0.383 | 0.258 | 0.992 |
| 40 | 0.735 | 0.808 | 0.543 | 0.987 |
| 45 | 0.713 | 0.808 | 0.521 | 1.053 |
| 50 | 0.640 | 0.858 | 0.498 | 1.222 |
| 55 | 0.625 | 0.900 | 0.525 | 1.225 |
| 60 | 0.618 | 0.900 | 0.518 | 1.246 |
출처: Mao et al. 2024, 표 2 [13]. J와 마지막 열은 발표된 민감도와 특이도에서 계산한 값입니다. 가중 손실이 낮을수록 좋습니다.
이 사례가 보여주는 것은
- 동점과 두 번째 봉우리. J 값은 37.5에서 40까지의 모든 점수에서 동일(0.543)하므로 여러 점수가 동점을 이룹니다. 47.5에서 50 사이에서는 0.498로 떨어졌다가 52.5에서 55 사이에서는 다시 0.525로 상승합니다. 하나의 최댓값이 두 번째 합리적인 선택지를 가릴 수 있습니다.
- 동일한 가중치는 선택 사항입니다. 낙상 감지 실패가 오경보보다 세 배 더 큰 영향을 미친다고 가정해 보겠습니다. 예시 계산에서, 가장 낮은 가중 손실은 40에서 25로 감소합니다(0.971 대 0.987). 이때 민감도는 0.882입니다. J 값만으로는 이러한 결과를 예측할 수 없습니다.
- 보급률은 설계에 의해 결정됩니다. 낙상 경험자 136명과 비경험자 120명으로 구성된 이 표본은 설계상 대략적으로 균형을 이루고 있지만, 그 결과 얻은 양성예측값(PPV)과 음성예측값(NPV)은 실제 병동을 제대로 반영하지 못합니다. J 병동은 이러한 문제가 없습니다.
- 복사하기 전에 다시 계산하세요. 공개된 표에서 임계값 20에서의 J 값은 0.162로 나와 있지만, 0.912 + 0.125 − 1 = 0.037입니다. 표에서 가져오는 모든 J 값을 확인하십시오.
자신의 데이터에도 동일한 검증 방법을 적용할 수 있습니다. 각 임계값에서 민감도(Se)와 특이도(Sp)를 나열하고, J 값을 다시 계산한 다음, 동점, 두 번째 피크, 각 오류의 비용을 확인한 후 적절한 값을 선택하세요.
유덴 지수와 다른 절단 기준 비교
| 표준 | 최적화하는 것 | 가장 좋은 때 | 조심해 |
|---|---|---|---|
| 유덴 J | Se + Sp − 1 | 놓친 사례와 오경보로 인한 비용은 거의 비슷합니다. | 불균등한 비용을 무시합니다 |
| 왼쪽 상단에 가장 가까운 | (FPR 0, TPR 1)까지의 거리 | 당신은 거의 완벽한 분류를 원합니다. | J[4]와 다른 차단점을 선택할 수 있습니다. |
| AUC | 전체 곡선 판별 | 검사 결과를 비교하는 것이지, 기준점을 정하는 것이 아닙니다. | 임계값을 제시하지 않습니다. |
| 우도비 | 결과가 확률에 미치는 영향은 얼마나 될까요? | 사전 확률을 활용한 임상적 추론 | 사전 확률이 필요합니다 |
| 비용가중치/순이익 | 예상되는 피해 또는 이익 | 두 오류로 인한 비용은 분명히 다릅니다. | 비용 또는 임계 확률 입력값이 필요합니다. |
Youden 기준과 가장 왼쪽 상단에 가까운 기준은 종종 일치하지만 항상 일치하는 것은 아닙니다. Perkins와 Schisterman은 서로 다른 임계값을 지정할 수 있으며 질병 그룹과 건강 그룹에 동일한 가중치를 부여할 때 Youden 임계값이 정확한 분류를 최대화한다는 것을 보여주었습니다[4]. 기준을 미리 선택하고 방법에서 이름을 지정하십시오.
제한 사항 및 해결 방법
| 한정 | 중요한 이유 | 무엇을 |
|---|---|---|
| 두 오류에 동일한 가중치를 부여합니다. | 암을 놓치는 것과 오진으로 인한 피해는 드물게 동일한 피해를 초래합니다. | 비용 가중 규칙 또는 의사결정 곡선 분석을 사용하십시오. |
| 동일 표본에서의 낙관주의 | 데이터에서 가장 좋은 J 값은 상향 편향되어 있습니다. | 부트스트랩 또는 교차 검증[2,9] |
| 마커의 측정 오차 | 잡음은 ROC 곡선을 평평하게 만들고 J 값을 낮춥니다. | 오류 수정 추정량을 사용합니다[3]. |
| 검출 한계 미만 값 | 그것들을 떨어뜨리면 편향 J와 차단점이 발생합니다. | 검출 한계가 낮은 경우에 사용되는 방법을 사용합니다[5]. |
| 두 개 이상의 수업 | 두 그룹 J는 직접 확장되지 않습니다. | 3개 클래스 일반화[6,7]를 사용합니다. |
| PPV와 NPV의 유병률 | 예측값은 유병률에 따라 변화합니다. | 민감도(Se)와 특이도(Sp)를 보고하고, 목표 모집단에 대한 양성예측값(PPV)과 음성예측값(NPV)을 다시 계산하십시오. |
절단 방법의 보다 광범위한 검토는 Hajian-Tilaki의 ROC 분석 소개[8]와 Hassanzad 및 Hajian-Tilaki의 2024년 업데이트[9]를 참조하십시오.
R에서 유덴 지수를 계산하세요
pROC 패키지는 Youden 차단값을 직접 반환합니다[10].
library(pROC) roc_obj <- roc(response = d$disease, predictor = d$marker) coords(roc_obj, x = "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity")) ci.coords(roc_obj, x = "best", best.method = "youden", ret = c("threshold", "sensitivity", "specificity"), boot.n = 2000)이 글을 작성할 때는 STARD 2015를 따라야 하며, 이를 통해 차단점, 선택 방법 및 불확실성이 모두 보고됩니다[11].
진단 정확도 작업을 위한 무료 계산기
이 무료 도구들은 유덴 지수(Youden Index) 관련 단계를 모두 다룹니다.
진단 정확도 분석 결과를 점검받으세요
잘못된 임계값 설정 방법은 진단 논문 심사를 무산시킬 수 있습니다. 생물통계학자에게 ROC 분석, 임계값 선택 및 방법론 검토를 의뢰하거나 검토받고 싶다면, 바로 이 서비스가 적합합니다.

이 분석을 실행하거나 검토받고 싶으신가요? 생물통계학 박사가 연구 설계를 검토하고 분석을 실행하며 논문의 통계 방법론 부분을 작성해 드립니다.
유덴 인덱스 FAQ
유덴 지수란 간단히 말해서 무엇인가요?
J는 검사가 질환이 있는 사람을 얼마나 잘 찾아내는지(민감도)와 질환이 없는 사람을 얼마나 잘 걸러내는지(특이도)를 결합한 하나의 수치입니다. J = 민감도 + 특이도 - 1. 쓸모없는 검사는 0점이고 완벽한 검사는 1점입니다.
유덴 지수의 공식은 무엇인가요?
J = Se + Sp − 1이며, 이는 Se − (1 − Sp)와 같거나, 참양성률에서 거짓양성률을 뺀 값입니다. ROC 곡선에서 J는 대각선상의 우연선에서 주어진 임계값에서의 곡선까지의 수직 거리입니다.
유덴 지수의 범위는 어떻게 되나요?
단일 테스트의 경우 J는 -1에서 1까지의 값을 갖습니다. 0은 테스트가 우연보다 나은 결과를 내지 못한다는 것을 의미하고, 음수 값은 테스트 레이블이 반전되었음을 의미합니다. ROC 곡선의 모든 절단점에 대한 최대 J 값은 0보다 작을 수 없습니다. 왜냐하면 모서리 (0, 0)에서 이미 J = 0이기 때문입니다.
적절한 유덴 지수 값은 얼마입니까?
공식적인 기준치는 없습니다. 많은 논문에서 J 값이 0.5 이상이면 양호하고 0.75 이상이면 우수하다고 간주하지만, 이는 관례일 뿐 표준은 아닙니다. J 값은 진단 누락 및 오경보로 인한 임상적 손실을 기준으로 판단하고 신뢰구간을 제시해야 합니다.
유덴 지수를 이용하여 최적의 임계값을 어떻게 찾을 수 있나요?
모든 후보 임계값에서 민감도와 특이도를 계산하고, 각 임계값에 대해 J 값을 계산한 다음, J 값이 가장 큰 임계값을 선택합니다. R에서는 pROC가 coords(roc_obj, “best”, best.method = “youden”)를 사용하여 이를 수행합니다.
유덴 차단점은 좌상단 모서리에 가장 가까운 지점과 동일한가요?
일반적으로는 그렇지 않습니다. 두 기준은 서로 다른 임계값을 선택할 수 있으며, ROC 곡선이 비대칭일 경우 그 차이가 커집니다(Perkins and Schisterman, 2006). 데이터를 분석하기 전에 기준을 선택하고 방법론에 명시하십시오.
유덴 지수를 사용하지 말아야 하는 경우는 언제인가요?
치료 가능한 심각한 질병을 선별하는 경우처럼, 진단을 놓쳤을 때 발생하는 비용이 오경보로 인한 비용보다 훨씬 큰 경우에는 이를 유일한 기준으로 삼지 않아야 합니다. 반대로, 진단을 놓쳤을 때 오경보로 인한 비용이 오경보로 인한 비용보다 훨씬 큰 경우에는 이를 유일한 기준으로 삼지 않아야 합니다. J는 두 가지 오류에 동일한 가중치를 부여합니다. 이러한 상황에는 비용 가중 방식이나 순이익 접근 방식이 더 적합합니다.
유병률이 유덴 지수에 영향을 미치나요?
아니요. 민감도와 특이도는 질병이 있는 그룹과 질병이 없는 그룹 내에서 추정되므로 J는 유병률에 의존하지 않습니다. 하지만 양성예측값(PPV)과 음성예측값(NPV)은 유병률에 의존하기 때문에 전문 클리닉과 선별 검사 프로그램에서 매우 다르게 나타날 수 있습니다.
논문에서 유덴 기반 임계값을 어떻게 보고해야 할까요?
절단점, J 값, 민감도 및 특이도를 95% 신뢰구간(부트스트랩 신뢰구간이 일반적임)과 함께 보고하고, 각 그룹의 표본 크기 및 절단점 선택 방법을 명시하십시오. 가능하면 별도의 표본을 사용하여 검증하십시오. STARD 2015는 검토자들이 기대하는 항목들을 나열합니다.
참고자료
- Youden WJ. 진단 테스트 평가 지표. 게자리. 1950;3(1):32-35. 10.1002/1097-0142(1950)3:1<32::AID-CNCR2820030106>3.0.CO;2-3
- Fluss R, Faraggi D, Reiser B. Youden 지수 및 관련 차단점의 추정. Biom J. 2005;47(4):458-472. 10.1002/bimj.200410135
- Perkins NJ, Schisterman EF. Youden 지수와 측정 오차를 보정한 최적 절단점. Biom J. 2005;47(4):428-441. 10.1002/bimj.200410133
- Perkins NJ, Schisterman EF. 수신자 작동 특성 곡선을 기반으로 두 가지 기준을 사용하여 얻은 "최적" 절단점의 불일치. Am J Epidemiol. 2006;163(7):670-675. 10.1093/aje/kwj063
- Ruopp MD, Perkins NJ, Whitcomb BW, Schisterman EF. 검출 하한의 영향을 받는 관찰로부터 추정된 Youden 지수 및 최적 절단점. Biom J. 2008;50(3):419-430. 10.1002/bimj.200710415
- Nakas CT, Alonzo TA, Yiannoutsos CT. Youden 지수의 일반화를 이용한 3개 클래스 분류 문제에서의 정확도 및 임계값 선택. 스탯 메드. 2010;29(28):2946-2955. 10.1002/심.4044
- Luo J, Xiong C. 세 가지 순서형 진단 그룹에 대한 Youden 지수 및 관련 절단점. Commun Stat Simul Comput. 2013;42(6):1213-1234. 10.1080/03610918.2012.661906
- Hajian-Tilaki K. 의료 진단 검사 평가를 위한 수신자 작동 특성(ROC) 곡선 분석. 카스피해 J 인턴 의학. 2013;4(2):627-635. PMID 24009950
- Hassanzad M, Hajian-Tilaki K. ROC 분석에서 임상 데이터를 적용하여 진단 바이오마커의 최적 절단점을 결정하는 방법: 최신 검토. BMC Med Res Methodol. 2024;24. 10.1186/s12874-024-02198-2
- Robin X, Turck N, Hainard A, et al. pROC: ROC 곡선을 분석하고 비교하기 위한 R 및 S+용 오픈 소스 패키지. BMC 생물정보학. 2011, 12 : 77. 10.1186/1471-2105-12-77
- Bossuyt PM, Reitsma JB, Bruns DE, et al. STARD 2015: 진단 정확도 연구 보고에 필요한 필수 항목의 업데이트된 목록. BMJ. 2015;351:h5527. 10.1136/비엠제이.h5527
- Wang P, Li Y, Wang M, et al. 중국 농촌 노인의 당뇨병 정의에 있어 혈당 특성 비교. PLoS ONE. 2024, 19 (1) : e0296694. 10.1371 / journal.pone.0296694
- Mao B, Jiang H, Chen Y, et al. 산부인과 병동에서 Morse 낙상 척도를 재평가하고 향상된 위험 평가를 위한 최적의 절단점 점수를 결정하기 위한 후향적 조사. PLoS ONE. 2024, 19 (9) : e0305735. 10.1371 / journal.pone.0305735