
발행 | 최종 업데이트:
멘델 무작위화 (MR)는 수정 시점에 유전되는 유전적 변이를 자연적인 도구로 활용하여, 코호트 데이터에서 단순히 함께 이동하는 것이 아니라, 수정 가능한 노출이 실제로 질병 결과를 유발하는지 여부를 검증하는 방법입니다. Editverse는 1,100편 이상의 논문을 지원해 왔으며, 통계학자들이 관찰 연구를 기반으로 한 인과 관계 주장에 대해 가장 자주 접하는 반론은 "저자들이 교란 변수나 역인과 관계의 가능성을 배제하지 않았다"는 것입니다. 멘델 무작위화는 이러한 반론에 가장 직접적으로 대응하는 연구 설계이며, 지난 10년 동안 유전 역학 분야의 전문 기법에서 심장학, 영양학, 정신의학, 신장학, 종양학 저널 전반에 걸쳐 일반적인 연구 방법으로 자리 잡았습니다.
다음에서는 해당 방법의 신뢰성을 뒷받침하는 유전학적 논리, 통계적 검토자가 가장 먼저 확인하는 세 가지 도구변수 가정, 현재 두 표본 및 다변수 설계에 사용되는 추정량, 실제 적용에서 가장 실패할 가능성이 높은 가정인 다면발현, 그리고 심혈관, 영양 및 행동 역학 분야에 걸친 세 가지 발표된 사례를 살펴봅니다. 아래에 참조된 모든 연구는 PubMed 식별자(DOI)를 포함하고 있으므로 요약본에 의존하지 않고 원문을 직접 확인할 수 있습니다.
간단한 단어로
어떤 유전적 변이를 물려받을지는 부모의 염색체가 재조합될 때 무작위로 결정되기 때문에, 이 변이는 마치 동전 던지기처럼 인구를 두 그룹으로 나눕니다. 한 그룹은 LDL 콜레스테롤이나 알코올 섭취와 같은 위험 요인에 평생 더 많이 노출될 가능성이 높고, 다른 그룹은 그렇지 않습니다. 어느 그룹도 자신의 유전자형을 선택한 것이 아니며, 식단, 소득 또는 후천적으로 형성된 습관에 의해 유전자형이 형성된 것도 아닙니다. 따라서 두 그룹 간 질병 발생률에 차이가 있고, 해당 변이가 특정 위험 요인 외에는 아무런 변화를 주지 않는다면, 그 차이는 단순히 두 가지 요인이 함께 작용하는 것이 아니라, 위험 요인 자체가 질병 위험을 변화시킨다는 증거입니다.
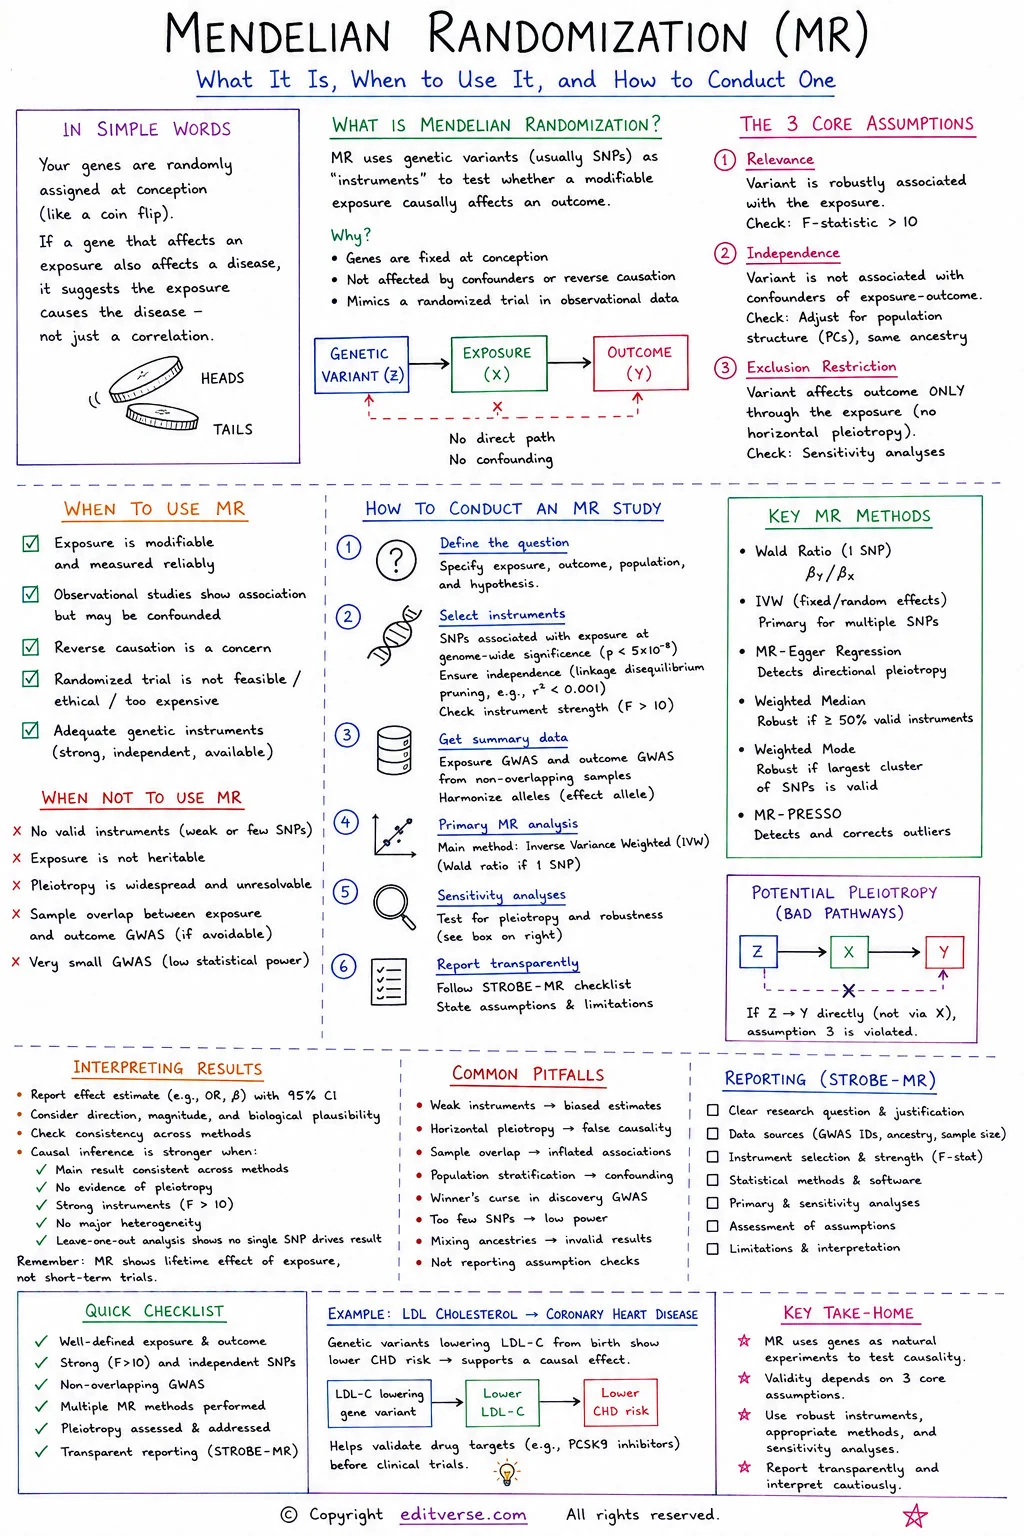
멘델 무작위화란 무엇인가?

유전자형은 수정 시점에 결정되므로, 일반적인 관찰 비교를 어렵게 하는 식습관, 행동, 사회적 환경과 같은 요인들보다 선행하는 위치에 있습니다. 이러한 시점적 특성 덕분에 유전적 변이는 무작위 배정을 대신할 수 있습니다(Sanderson et al., 2022). 조지 데이비 스미스와 샤 에브라힘은 2003년 논문에서 생식세포 유전적 변이를 모든 코호트 연구에서 이미 진행 중인 자연 실험으로 정의하며, 별도의 모집이나 추적 관찰이 필요 없다고 설명하여 이 용어를 대중화했습니다(Davey Smith and Ebrahim, 2003). 이후 20년간의 게놈 전체 연관성 연구를 통해 수천 가지의 노출 요인과 결과에 대한 요약 통계가 도출되었고, 이러한 연구는 이론적 제안에서 역학 분야에서 가장 빈번하게 적용되는 인과 추론 도구 중 하나로 자리매김했습니다.
멘델 무작위화는 유전적 변이(일반적으로 단일 염기 다형성 또는 여러 변이의 가중 조합)를 수정 가능한 노출 요인의 대리 변수로 사용하는 도구 변수 분석의 응용입니다. 이러한 논리는 멘델의 독립 분리 법칙에 근거합니다. 즉, 대립 유전자는 감수 분열 과정에서 자손에게 무작위로 분배되므로 특정 유전자 위치에서 개인의 유전자형은 출생 전에 결정되며, 기존 코호트 비교에서 문제가 되는 흡연, 사회경제적 지위 또는 질병 진행에 의해 변경될 수 없습니다(Sekula et al., 2016; Sanderson et al., 2022).
모든 분석은 서로 연결된 세 부분으로 구성됩니다.
- 악기. 노출과 강력하게 연관된 하나 이상의 유전적 변이.
- 노출. 연구 대상이 되는 수정 가능한 위험 요인은 LDL 콜레스테롤, 체질량 지수, C 반응성 단백질 또는 알코올 섭취량입니다.
- 결과. 관심 있는 질병 또는 특성(예: 관상동맥 질환, 제2형 당뇨병 또는 우울증).
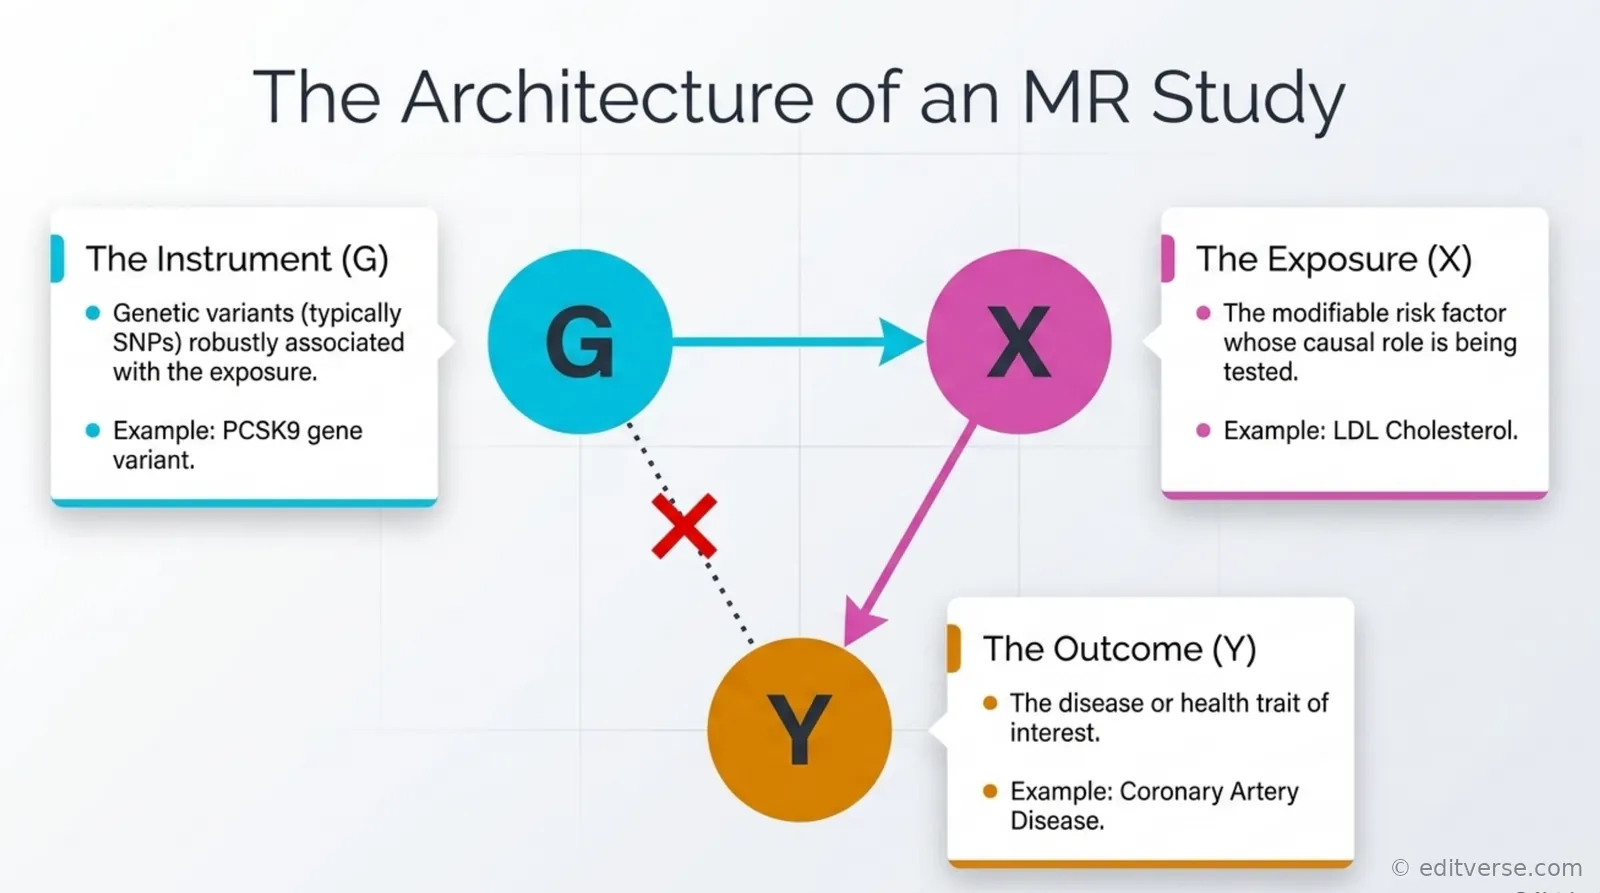
JAMA나 European Heart Journal과 같은 저널의 심사위원들은 이제 원고에서 세 가지 구성 요소를 각각 명시적으로 언급하고, 단순히 "유전적 변이가 도구로 사용되었다"라고 주장하는 것이 아니라, 출처 GWAS를 인용하여 도구 선택을 정당화할 것을 기대합니다.
모든 멘델 무작위화 연구의 근간이 되는 세 가지 핵심 가정
이 설계에서 얻은 인과적 추정치는 세 가지 도구 변수 가정이 충족될 때만 신뢰할 수 있으며, STROBE-MR 항목 5에서는 저자가 각 가정을 어떻게 평가했는지 명시적으로 밝히도록 요구합니다(Skrivankova et al., 2021).

관련성. 유효한 도구 변수는 대리 변수가 나타내는 노출과의 강력하고 충분한 검정력을 가진 연관성을 가져야 합니다. 실제 연구에서는 변인-노출 회귀 분석의 F 통계량을 통해 이를 검증합니다. 버제스와 톰슨은 F 통계량이 10 미만이면 인과 관계 추정치를 교란된 관찰적 연관성 쪽으로 편향시키는 약한 도구 변수임을 나타냈으며, 노출 데이터와 결과 데이터 간의 표본 중복이 증가할수록 이러한 편향이 심해진다는 것을 보여주었습니다(버제스와 톰슨, 2011).
독립성, 즉 교환 가능성이라는 개념은 노출-결과 관계에 영향을 미치는 교란 변수가 해당 변이와 연관되어서는 안 된다는 것을 의미합니다. 이 가정을 직접적으로 검증할 수는 없지만, 표본을 특정 인종 집단으로 제한하고 유전적 주성분 분석을 통해 인구 계층화(생물학적 요인과 무관하게 대립유전자 빈도와 질병 발생률이 인종 집단별로 다르게 나타나는 현상)를 배제함으로써 가정의 타당성을 높일 수 있습니다.
배제 제한. 유효한 변이는 연구 대상 노출을 통해서만 결과에 영향을 미치며, 독립적인 생물학적 경로를 통해서는 절대 영향을 미치지 않습니다. 이 제한 위반은 실제 연구에서 가장 흔한 오류 유형입니다. 식욕 조절을 통해 체중에 영향을 미치면서 동시에 염증에도 독립적으로 영향을 미치는 유전자는 체중과 심혈관 질환 분석에서 배제 제한을 위반합니다. 왜냐하면 결과에 대한 그 효과의 일부가 노출을 완전히 우회하기 때문입니다. 이러한 오류 유형인 수평적 다면발현은 매우 흔하기 때문에, 이를 탐지하기 위한 전용 민감도 분석 도구가 개발되었으며, 이 가이드 후반부에서 자세히 다룹니다.
일반적인 MR 연구 설계 및 추정 방법
두 가지 구조적 선택과 여러 통계적 추정 방법이 현재의 관행을 규정합니다. 이 중 하나라도 잘못 선택하면 심사위원으로부터 대대적인 수정 요청을 받는 가장 빠른 방법 중 하나입니다.
단일 표본 멘델 무작위화(One-sample MR) 는 동일한 코호트(일반적으로 영국 바이오뱅크)에서 유전자형, 노출 요인 및 결과 변수를 추출합니다. 단일 표본 설계는 비선형 용량-반응 모델링을 지원하고 목표 모집단에서 도구 변수의 강도를 직접 확인할 수 있게 해주지만, 개별 수준의 유전자형 데이터와 분석에 필요한 충분한 규모의 코호트가 필요합니다.
두 표본 멘델 무작위화(two-sample MR) 는 현재 가장 널리 사용되는 접근법으로, 서로 겹치지 않는 두 개의 게놈 전체 연관 연구(GWAS)에서 얻은 요약 통계를 결합합니다. 하나는 변이-노출 연관성을 추정하는 연구이고, 다른 하나는 변이-결과 연관성을 추정하는 연구입니다(Burgess, Butterworth, and Thompson, 2013). 두 표본 멘델 무작위화는 원시 유전자형 데이터가 아닌 공개된 요약 데이터만 필요로 하기 때문에, 자체적으로 유전자형 코호트를 보유하지 않은 연구자들도 이 방법을 활용할 수 있게 되었습니다. 이것이 바로 두 표본 멘델 무작위화가 전문 유전학 그룹을 넘어 빠르게 확산된 가장 큰 이유입니다. 하지만 두 GWAS 간의 표본 중복은 여전히 연구자들이 직면할 수 있는 위험 요소이며, 이는 아래의 일반적인 오류 항목에서 자세히 설명합니다.
설계가 확정되면 일반적으로 여러 견적 도구를 개별적으로 실행하는 대신 동시에 실행합니다.
- 역분산 가중(IVW) 회귀 이는 다중 도구를 사용하는 두 표본 MR에 대한 표준 기본 추정량입니다. 이는 SNP-결과 추정치를 SNP-노출 추정치에 회귀시키고, 각 변이에 분산의 역수를 가중치로 부여하며, 모든 도구가 유효하다고 가정합니다(Burgess, Butterworth, and Thompson, 2013).
- MR-에거 회귀 0과 다를 수 있는 절편항을 추가하여 방향성 다면발현을 감지하고 조정하지만, 신뢰구간이 넓어지고 통계적 검정력이 낮아지는 단점이 있습니다(Bowden, Davey Smith, and Burgess, 2015).
- 가중 중앙값 추정기 도구 가중치의 최대 절반이 유효하지 않은 변이에서 비롯되는 경우에도 일관성을 유지하므로 IVW 결과를 왜곡하는 단일 우세 다면발현 SNP에 대한 유용한 검사 도구가 됩니다(Bowden, Davey Smith, Haycock 및 Burgess, 2016).
- 다변수 MR 이 방법은 두 개 이상의 노출 요인을 동시에 고려하여 각 요인의 직접적인 영향을 추정하는 프레임워크를 확장합니다. 이는 노출 요인들이 유전적으로 상관관계가 있을 때, 예를 들어 LDL 콜레스테롤과 아포지단백 B의 경우에 적합한 도구이며, 매개 분석에 대한 멘델 무작위화 접근법으로도 활용되어 특정 중간 노출 요인을 통해 결과에 미치는 전체 유전적 효과가 얼마나 되는지 정량화합니다(Sanderson, 2021).
어떤 단일 추정치도 단독으로 보고하는 것은 안전하지 않습니다. 현재 지침에서는 여러 추정치를 삼각측량하고, 인과 관계 추정치의 방향과 대략적인 크기가 서로 다른 편향 구조를 가진 여러 방법에서 일관되게 나타나는지 확인할 것을 권장합니다(Burgess et al., 2023). 추정치 간의 일치는 필요조건이지만 충분조건은 아니며, 네 가지 추정치 각각이 실제로 어떤 가정을 완화하는지, 그리고 네 가지 추정치 모두 동일한 잘못된 결과를 도출하는 상황이 무엇인지에 대한 시뮬레이션을 통해 제시합니다.
다면발현, 타당성에 대한 핵심적인 위협
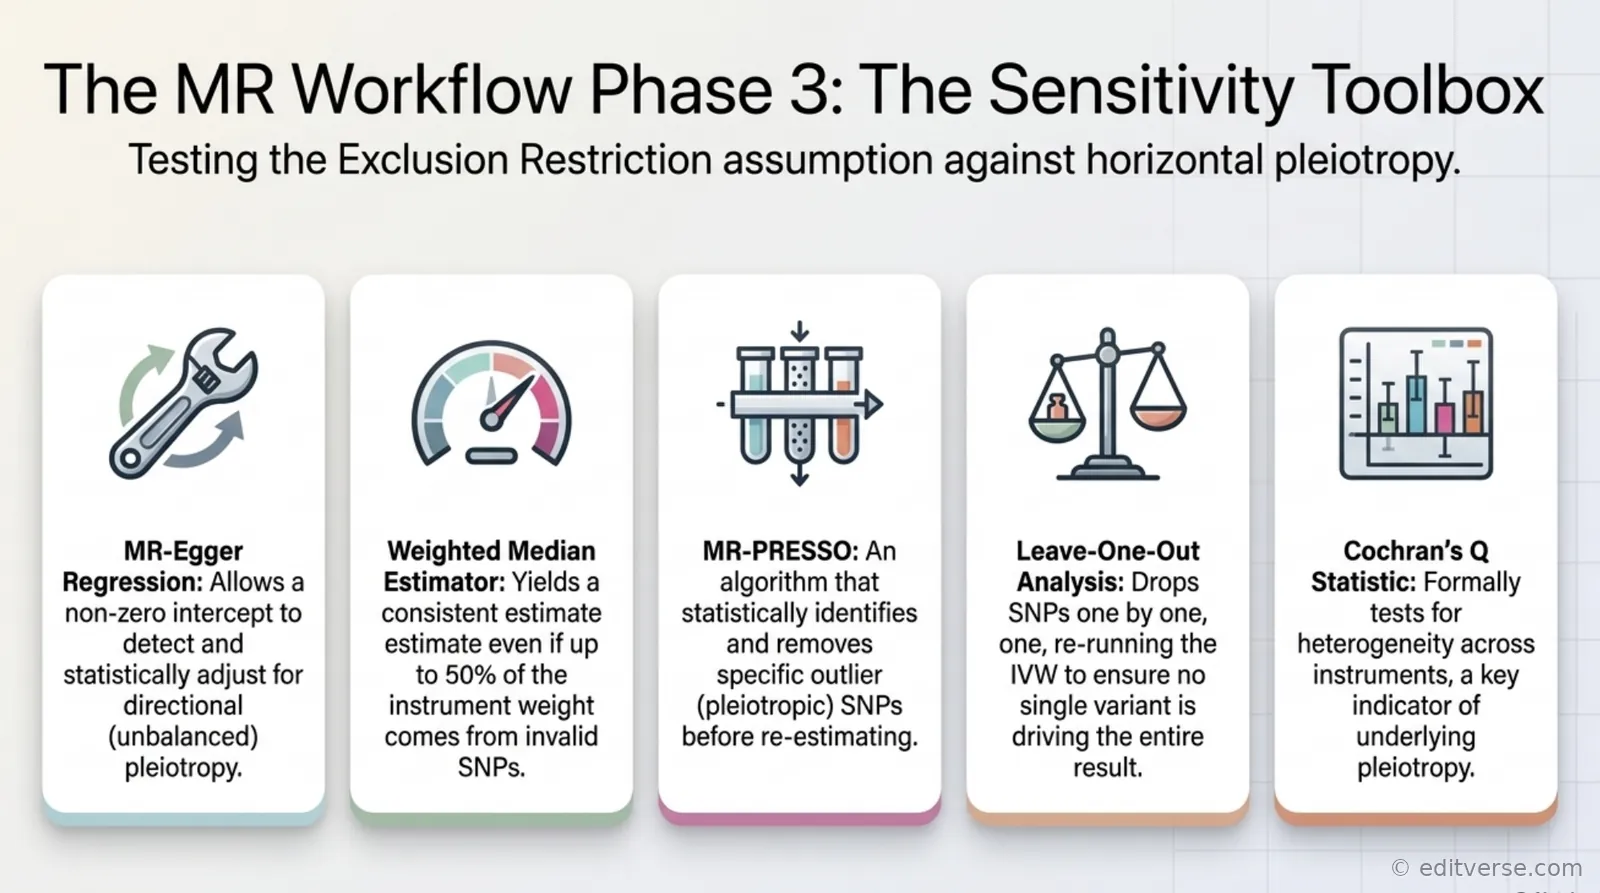
수직적 다면발현은 변이가 노출을 먼저 변화시킨 후에야 결과에 영향을 미치는 경우로, 무해하며 예상되는 현상입니다. 반면 수평적 다면발현은 변이가 노출을 거치지 않고 두 번째 경로를 통해 결과에 도달하는 경우로, 배제 제한을 무너뜨리고 인과 관계 추정치를 왜곡합니다. 버반크(Verbanck)와 그의 동료들은 다중 도구 요약 데이터 분석에서 수평적 다면발현 이상 변이를 식별하기 위해 특별히 MR-PRESSO 검정을 개발하고, 이를 광범위한 공개된 노출-결과 쌍에 적용했습니다. 그 결과는 놀라웠습니다. 수평적 다면발현은 유의미한 인과 관계의 48% 이상에서 감지되었으며, 인과 관계 추정치를 평균 -131%에서 201%까지 왜곡했고, 검정된 관계의 최대 10%에서 거짓 양성 인과 관계 주장을 초래했습니다(Verbanck et al., 2018). 바로 그 연구 하나 때문에, 다면발현 검증 없이 IVW 추정치만 보고하는 방법론 섹션은 이제 거의 자동적으로 심사위원의 이의 제기를 불러일으킵니다.
타당한 분석은 어느 한 가지 검증에만 의존하기보다는 여러 검증을 종합적으로 수행합니다.
- 미스터프레소 통계적으로 다면발현 가능성이 있는 이상치 SNP를 식별하고 제거한 다음, 이를 제외한 효과를 재추정합니다(Verbanck et al., 2018).
- 리브원아웃 분석 변이체를 하나씩 제거하면서 IVW 추정치를 다시 실행하여 단일 SNP가 전체 결과에 영향을 미치지 않음을 확인합니다.
- 코크란의 Q 통계량 도구 전반에 걸친 이질성을 공식적으로 테스트하는데, 이는 개별 변이체가 이상치처럼 보이지 않더라도 다면발현을 나타내는 경우가 많습니다.
- MR-Egger의 절편 테스트 이는 전체 기기 세트에 걸쳐 방향성 다면발현에 대한 직접적이지만 저전력 테스트를 제공합니다(Bowden, Davey Smith, and Burgess, 2015).
최근 멘델 무작위화 관련 문헌에서 발췌한 세 가지 예시
LDL 콜레스테롤과 관상동맥 심장 질환
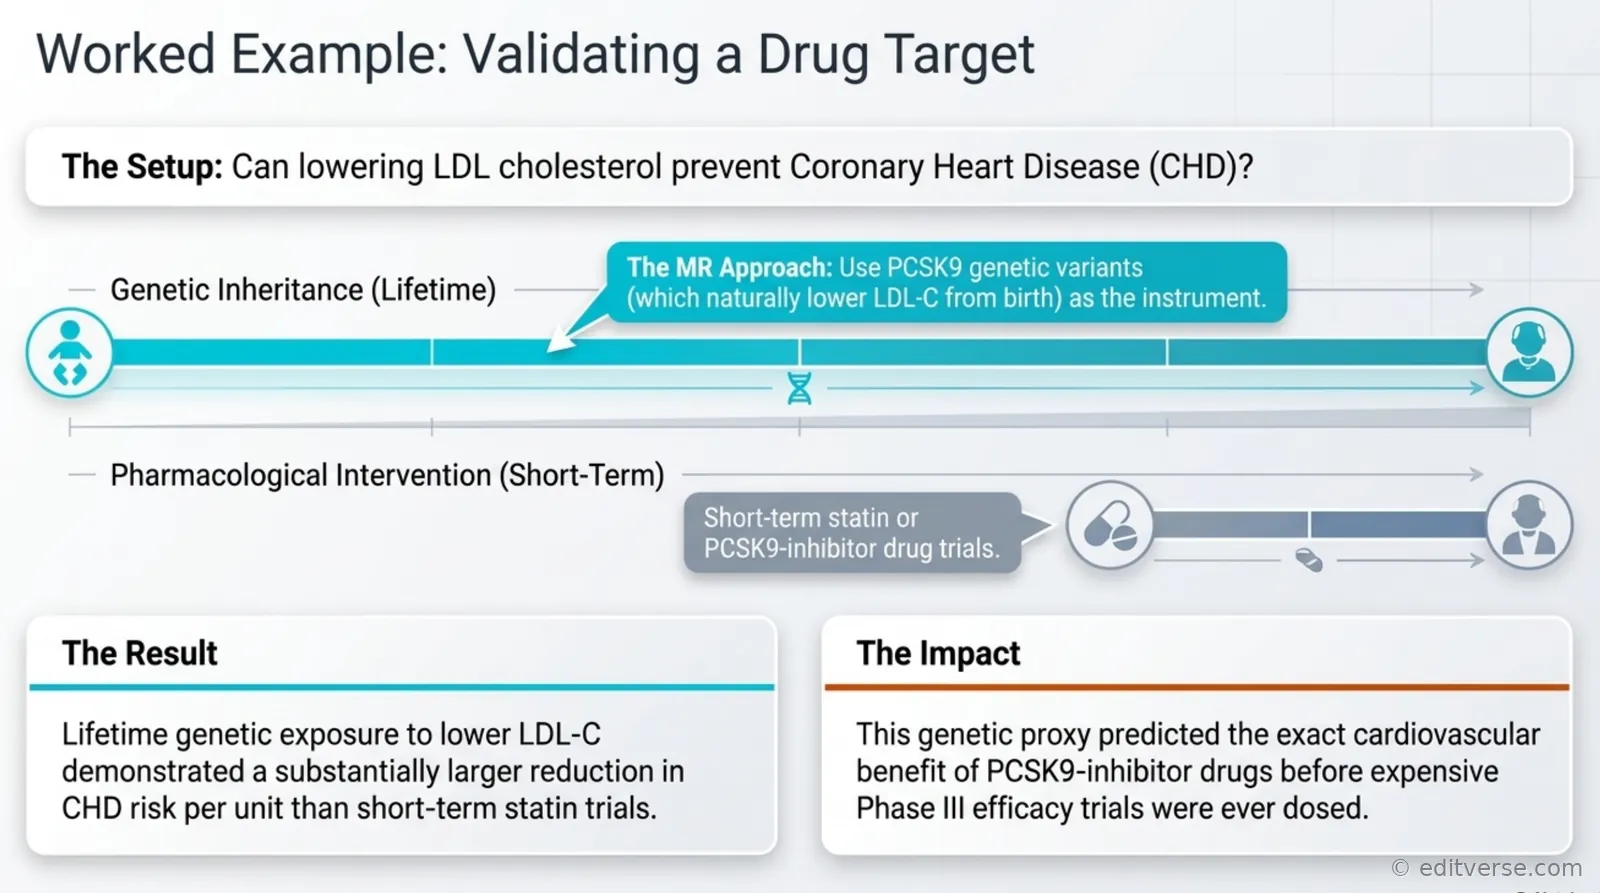
페렌스와 그의 동료들은 출생 시부터 LDL 콜레스테롤 수치를 낮추는 유전적 변이를 단기적인 노출이 아닌 평생 노출의 대리 변수로 사용하여, 장기적인 LDL 콜레스테롤 감소가 관상동맥 심장 질환 위험에 미치는 영향을 추정했습니다. 평생 동안 LDL 콜레스테롤 수치를 낮추는 유전적 노출은 스타틴 임상 시험에서 몇 년 동안 달성한 동일한 절대적 감소보다 LDL 콜레스테롤 수치 감소 단위당 관상동맥 심장 질환 위험 감소 효과가 훨씬 더 큰 것으로 나타났으며, 이는 단기 무작위 임상 시험으로는 포착할 수 없는 누적적이고 기간에 따라 달라지는 효과와 일치하는 양상입니다(Ference et al., 2012).
이제는 동일한 논리를 적용하여 3상 임상시험 자금 지원 전에 약물 표적을 검증하고 있습니다. Gagnon 연구팀은 504개의 인간 간 샘플에 대해 유전자형 분석 및 RNA 시퀀싱을 수행하여 두 가지 서로 다른 PCSK9 저하 약물 기전을 나타내는 두 가지 유전적 대리 변수를 구축했습니다 . 하나는 RNA 간섭 요법을 모방하기 위해 간 PCSK9 발현의 5.6%를 설명하는 변이체이고, 다른 하나는 항체 기반 억제 요법을 모방하는 PCSK9 R46L 기능적 변이체입니다. 아포지단백 B의 표준편차 감소량마다, 기전적으로 서로 다른 두 변이체는 관상동맥 질환 위험 감소 효과가 매우 유사한 것으로 나타났습니다. 이는 단일 직접 비교 임상시험 결과가 발표되기 전에 RNA 간섭 및 항체 기반 PCSK9 억제제가 지질 저하 단위당 유사한 심혈관 질환 개선 효과를 제공할 것으로 예측하게 합니다(Gagnon et al., 2025). 이러한 종류의 약물 표적 멘델 무작위 배정은 초기 단계 효능 임상시험보다 빠르고 저렴하면서도 무작위 유전자 할당 메커니즘을 기반으로 하기 때문에 여러 주요 제약 회사에서 표준 관행으로 자리 잡았습니다.
비타민 D와 다양한 건강 결과
비타민 D는 유용한 연구 사례입니다. 관찰 코호트 연구에서 낮은 비타민 D 수치가 믿기 어려울 정도로 많은 질환과 연관되어 있다는 사실이 밝혀졌는데, 이는 단일한 생물학적 기전보다는 야외 활동, 식단의 질, 체지방 등 다양한 요인이 복합적으로 작용한 결과라는 전형적인 패턴을 보여줍니다. 팡(Fang)과 동료들은 2022년 275월까지 발표된 비타민 D 관련 멘델 무작위 배정 연구 문헌을 체계적으로 검토하여 총 133편의 멘델 무작위 배정 연구 논문을 종합 분석했습니다. 그 결과, 유전적으로 예측된 25-하이드록시비타민 D는 다발성 경화증 발병 및 재발, 비감염성 포도막염 및 공막염, 건선, 대퇴골 및 다리 골절 위험 등 생물학적으로 일관된 특정 질환들에 대한 보호 효과를 나타내는 것으로 확인되었습니다(Fang et al., 2024). 자오와 그의 동료들은 영국 바이오뱅크(UK Biobank) 참가자 332,984명을 대상으로 자가면역 질환 및 자가염증성 질환에 대한 동일한 노출 요인을 구체적으로 조사했으며, 이 중 23,089명이 하나 이상의 해당 질환 진단을 받은 것을 확인한 결과, 자가염증성 질환 하위 그룹에서 유전적으로 예측된 비타민 D가 위험 감소와 관련이 있음을 발견했습니다(Zhao et al., 2023). 이 두 연구를 종합해 보면, 결과 전반에 걸친 유전자 스크리닝이 단일 코호트 상관관계 분석과 함께 중요한 위치를 차지하는 이유를 알 수 있습니다. 이러한 스크리닝은 타당한 생물학적 기전을 통해 특정 연관성을 유지하고, 관찰 데이터만으로는 설명할 수 없는 훨씬 더 많은 상관관계 목록을 배제할 수 있게 해줍니다.
알코올 섭취와 ALDH2를 통한 질병 위험
알코올 역학 연구에는 조정만으로는 해결하기 어려운 교란 요인이 존재합니다. 과음하는 사람들은 흡연량이 많고 운동량이 적으며 식습관도 다른 경향이 있는 반면, 소량 음주자는 건강상의 이유로 음주량을 줄인 과거 과음자일 수 있기 때문입니다. 동아시아 인구는 이러한 문제를 해결하기 위한 자연적인 유전적 도구를 제공합니다. ALDH2 유전자 의 흔한 변이 (rs671)는 아세트알데히드 대사를 저해하여, 이 변이 보유자는 음주 후 안면 홍조와 메스꺼움을 경험하고, 비보유자에 비해 평균적으로 알코올 섭취량이 현저히 적습니다. 이는 자가 보고된 음주량에 영향을 미치는 사회적, 행동적 요인과 거의 무관합니다. 밀우드와 동료 연구진은 이 변이와 관련된 ADH1B 다형성을 유전적 도구로 사용하여 중국 10개 지역의 남녀 50만 명을 대상으로 전향적 연구를 수행했습니다. 유전적 증거는 알코올이 뇌졸중 위험을 증가시킨다는 기존의 관찰 연구 결과와 일치함을 확인했을 뿐만 아니라, 적당한 음주가 심혈관계를 보호한다는 통념을 뒤집었습니다. 관찰 데이터에서 나타난 명백한 보호 효과는 유전적 도구를 사용한 분석에서는 입증되지 않았으며, 이는 적당한 알코올 섭취의 진정한 생물학적 효과라기보다는 교란 요인의 결과일 가능성이 매우 높다는 것을 시사합니다(Millwood et al., 2019).
멘델 무작위화는 언제 사용해야 할까요?

멘델 무작위화는 몇 가지 반복적인 조건이 충족될 때 연구 설계에서 그 자리를 차지하게 됩니다.
무작위 대조 시험은 실행 가능하지도 않고 윤리적으로도 문제가 있다.
누구도 사람들을 무작위로 선정하여 30년 동안 흡연, 체중 증가 또는 높은 LDL 콜레스테롤 수치를 유지하게 함으로써 심혈관계에 미치는 영향을 관찰할 수는 없습니다. 유전자 도구는 수정 시점에 이미 무작위화된 변이를 이용하여 이러한 불가능한 실험을 근사적으로 수행합니다(Larsson, Butterworth, and Burgess, 2023).
역인과관계는 그럴듯한 대안적 설명이다.
우울증과 염증, 또는 신장 기능과 혈압은 서로에게 영향을 미칠 수 있습니다. 유전자형은 태어날 때부터 결정되므로 수십 년 후에 발생하는 질병에 의해 유발될 수 없으며, 이는 횡단 연구 및 종단 코호트 연구 설계의 한계를 드러내는 역인과관계의 근거를 차단합니다.
잔존하는 측정되지 않은 교란 변수는 심각한 문제입니다.
다변량 회귀 분석은 실제로 측정된 교란 변수만 보정할 수 있는데, 식습관, 사회경제적 지위, 건강 추구 행태에 대한 데이터는 대부분의 코호트 연구에서 불완전한 것으로 악명 높습니다. 유전적 도구는 설계상 이러한 요인들과 독립적이며, 독립성 가정이 충족된다면, 동일한 관찰 데이터에 적용되는 성향 점수 매칭이나 다변량 조정보다 잔여 교란에 훨씬 덜 취약합니다. 이러한 차이는 실제 상황에서 중요합니다. 전국적으로 대표성을 갖는 설문조사 분석에서 가중치를 적용하고 조정을 정확하게 수행하더라도 노출-결과 연관성은 여전히 교란의 영향을 받을 수 있으며, NHANES 설문조사 가중치가 실제 데이터에서 어떤 문제를 해결하고 어떤 문제를 해결하지 못하는지 에 대한 분석에서 이를 확인할 수 있습니다. 성향 점수 매칭 에 대한 관련 가이드에서는 유전적 설계를 통해 교란 변수의 영향을 제거하는 대신 측정된 공변량의 균형을 맞추는 보완적인 접근 방식을 다룹니다.
약물 표적을 확인하려면 삼각측량 또는 검증이 필요합니다.
PCSK9 또는 IL-6R과 같은 바이오마커를 낮추는 변이체가 동일한 경로를 표적으로 하는 약물의 약리학적 작용을 모방하기 때문에, 약물-표적 멘델 무작위화는 이제 초기 개발 단계에서 화합물이 임상적 이점을 보일 가능성을 예측하고 비용이 많이 드는 3상 임상 시험이 시작되기 전에 표적 부작용을 식별하기 위해 일상적으로 사용됩니다(Larsson, Butterworth, and Burgess, 2023).
대규모 GWAS 요약 통계 자료는 이미 존재합니다.
두 표본 설계는 노출 요인과 결과 요인 모두에 대해 충분한 검정력을 갖춘 GWAS에 의존하며, 이상적으로는 수만 명에서 수십만 명의 참가자로 구성된 중복되지 않는 표본에서 추출되어야 합니다. 관심 있는 노출 요인에 대해 적절한 규모의 GWAS가 존재하지 않는 경우, 이 방법은 일반적으로 아직 실용적인 선택지가 아닙니다.
멘델 무작위 배정을 사용 하지 말아야 할 경우는 다음과 같습니다. 잘 수행된 무작위 대조 시험에서 이미 인과 관계에 대한 답을 얻었거나, 노출 요인에 대한 유전적 도구가 존재하지 않거나, 유전자형 분석이 가능한 표본 크기가 수천 명에 불과하거나, 노출 요인이 단일 유전적 대리 변수가 없는 정책 개입과 같이 명확하게 특성화된 이산적인 형질이 아닌 경우입니다.
멘델 무작위화 연구를 수행하는 방법

정확한 인과관계 질문을 сформули하고 타당성을 검토하십시오. 노출 요인과 결과 요인을 명확하게 명시하십시오. 예를 들어, "유전적으로 예측된 높은 체질량 지수가 무릎 골관절염을 유발하는가?"와 같이 질문할 수 있습니다. 해당 노출 요인에 대해 충분한 규모의 GWAS 연구가 존재하고 전체 요약 통계 자료를 제공하는지, 또는 IEU OpenGWAS, FinnGen 또는 GWAS Catalog와 같은 저장소를 통해 검색 가능한지 확인하십시오.
위에서 설명한 장단점을 고려하여 단일 표본 또는 이중 표본 설계를 선택한 다음, 노출 GWAS에서 게놈 전체 유의성(일반적으로 p < 5 × 10⁻⁸)에 도달하는 SNP를 추출하여 유전 적 도구를 선택합니다 . 연관 불균형(일반적으로 10,000kb 창 내에서 r² < 0.001)을 기준으로 변이체를 그룹화하여 독립적인 신호만 남도록 하고, 각 도구에 대한 F 통계량 또는 전체 세트에 대한 평균 F 통계량을 계산하여 10 미만인 항목은 표시합니다.
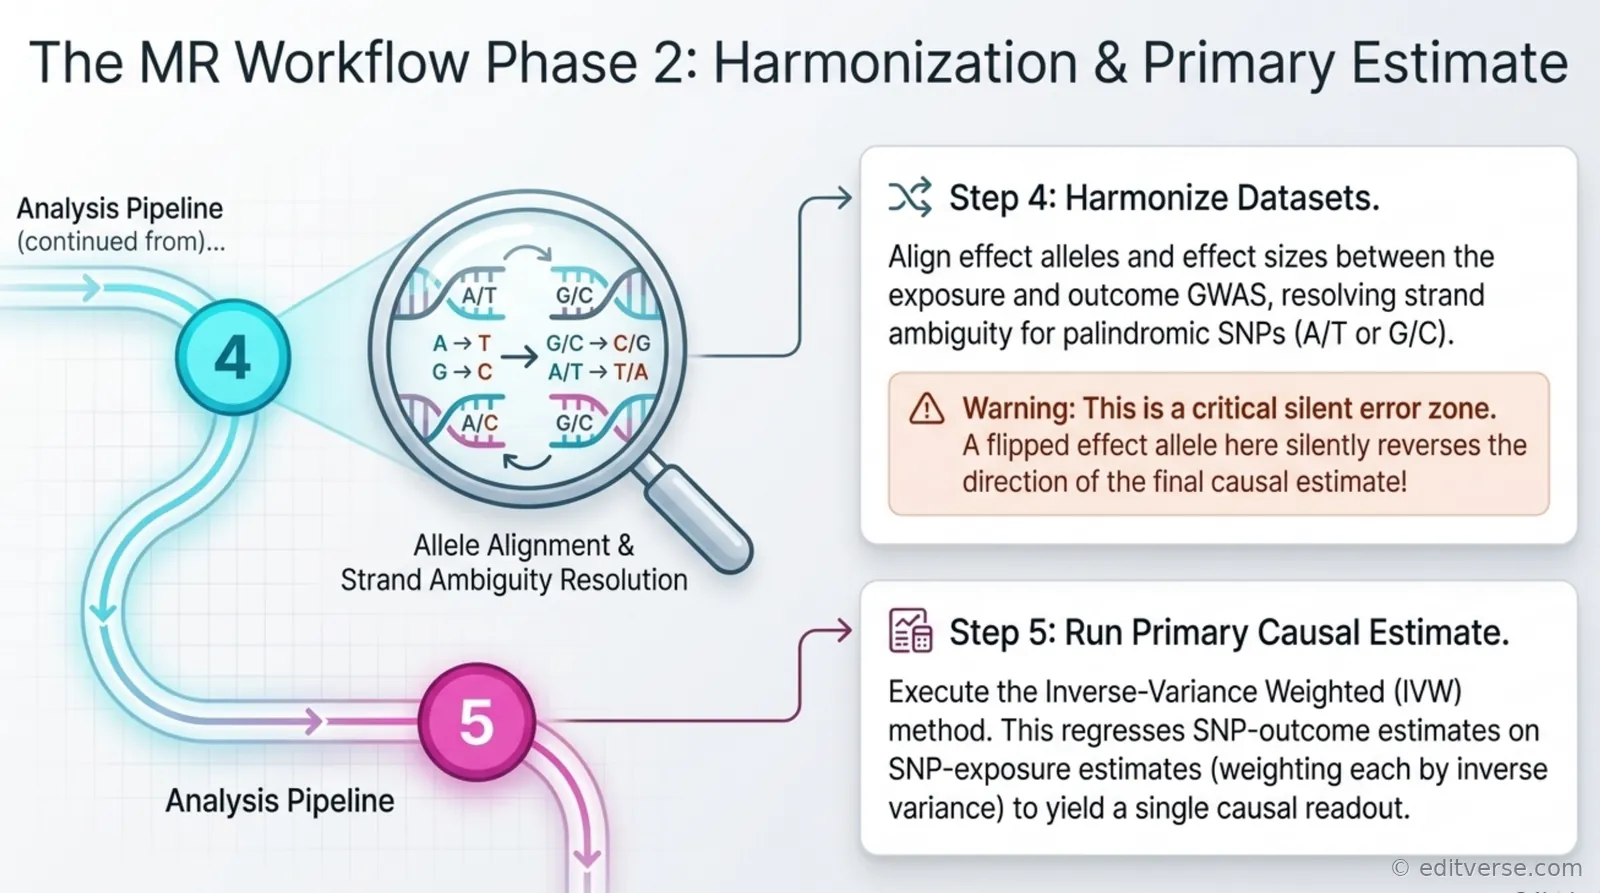
노출 및 결과 데이터 세트를 조화시키기 위해 효과 대립유전자와 효과 크기를 정렬하고, 대립유전자가 양쪽 가닥 모두에서 A/T 또는 G/C로 읽히는 회문형 SNP에 대한 가닥 모호성을 해결하고, 확실하게 일치시킬 수 없는 변이를 제거합니다. 이 단계는 기계적인 작업이며, 또한 가장 빈번하게 조용한 오류가 발생하는 부분이기도 합니다. 효과 대립유전자가 뒤집히면 오류 메시지 없이 인과 관계 추정의 방향이 조용히 반전됩니다.
역분산 가중치를 사용하여 주요 인과 추정치를 실행한 다음, 역분산 가중치만으로 중단하지 말고 위의 다면발현 섹션에서 설명한 민감도 분석을 실행하십시오 .

STROBE-MR에 따른 보고서 작성. STROBE-MR은 저자가 도구 선택의 타당성을 입증하고, F-통계량을 보고하며, 긍정적인 결과뿐 아니라 모든 민감도 분석 실행 결과를 공개하고, 세 가지 도구 변수 가정 중 어떤 것이 경험적으로 검증될 수 없었는지 명확하게 명시하도록 요구하는 20개 항목의 체크리스트를 제시합니다(Skrivankova et al., 2021). 이 체크리스트는 STROBE 가이드라인 튜토리얼 에서 다룬 일반적인 보고 논리를 확장한 것이며 , 현재 여러 저널에서 논문 제출 시 완성된 버전을 보충 파일로 요구하고 있습니다.
MR 분석을 위한 데이터 소스 및 소프트웨어
| 자원 | 타입 | 전형적인 사용 |
|---|---|---|
| IEU 오픈GWAS (MRC IEU, 브리스톨) | GWAS 요약 통계 데이터베이스 | 두 표본 설계에 대한 노출원 및 결과 GWAS |
| 핀젠 | 국립 생물은행 GWAS | 핀란드 창립자 집단에서의 질병 결과 GWAS |
| 영국 바이오 뱅크 | 개인 수준 코호트, 약 500,000만 명의 참가자 | 단일 표본 MR, 비선형 용량-반응 모델링 |
| NHGRI-EBI GWAS 카탈로그 | 선별된 변이-형질 연관성 | 기기 식별 및 교차 검증 |
TwoSampleMR (R 패키지) | 분석 소프트웨어 | 조화, IVW, MR-Egger, 가중 중앙값 |
MendelianRandomization (R 패키지) | 분석 소프트웨어 | 핵심 추정량의 대체 구현 |
MR-PRESSO (R 패키지) | 다형성 탐지 | 이상치 SNP 식별 및 수정 |
멘델 무작위화에서 피해야 할 일반적인 실수
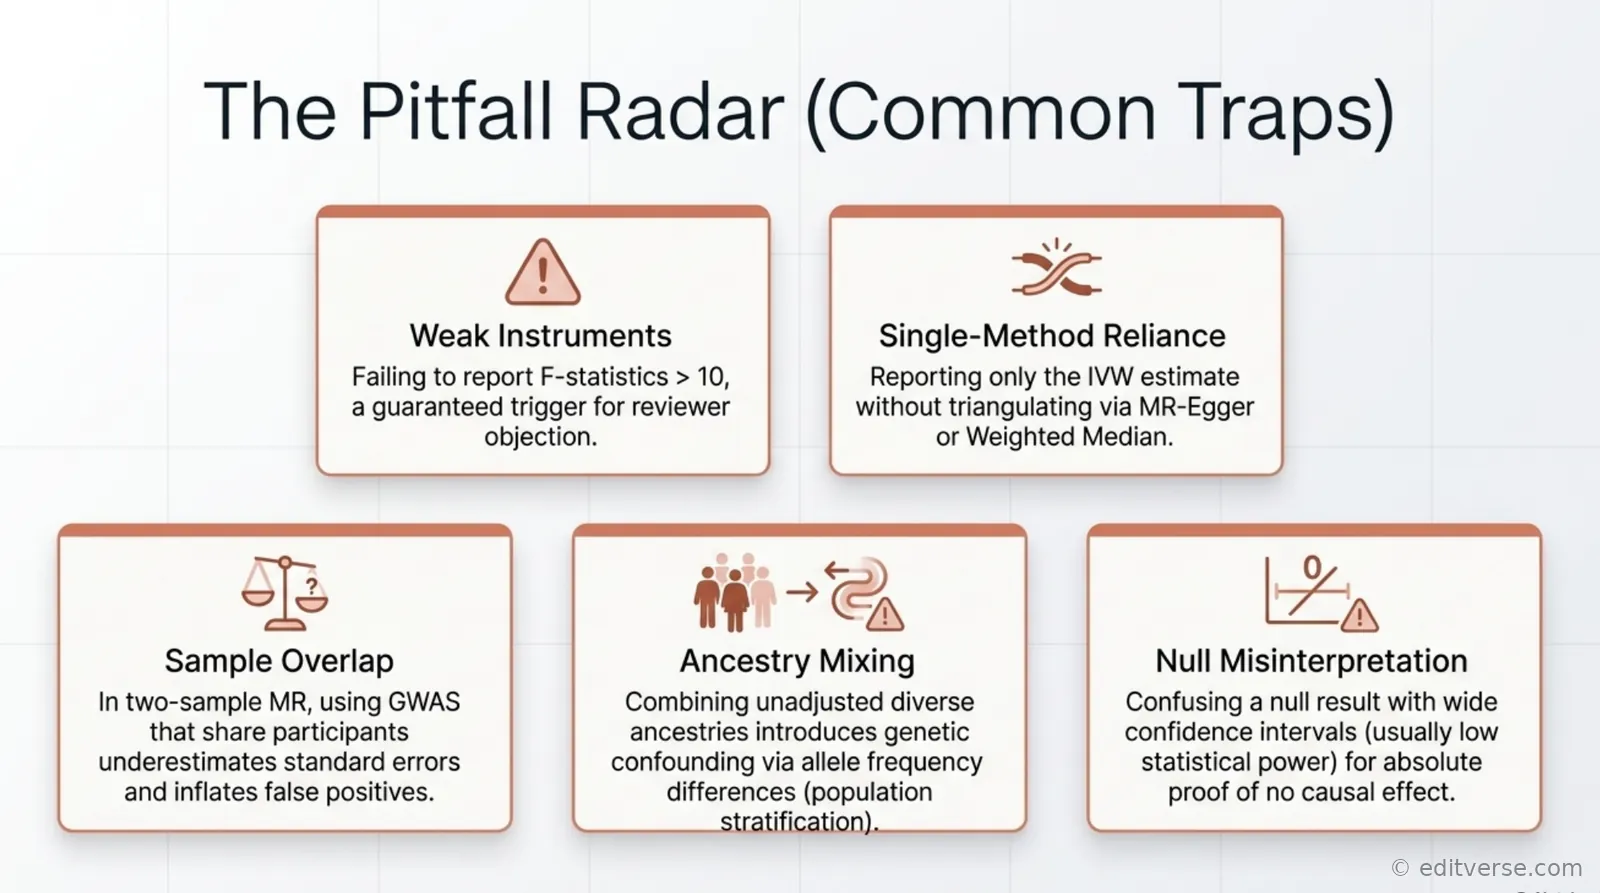
저희 통계학자들이 검토하는 원고 전반에 걸쳐, 소수의 오류가 이 방법과 관련된 수정 요청 및 반려의 대부분을 차지합니다.
- F-통계량을 보고하지 않고 약한 도구를 사용하는 경우. 심사위원들은 일반적으로 첫 번째 심사 단계에서 이를 요구하며, 이를 생략하는 것은 주요 수정으로 이어지는 가장 빠른 길 중 하나입니다(Burgess and Thompson, 2011).
- IVW 추정치만 보고합니다. 단일 방법으로는 진정한 인과 효과와 다면발현에 의한 효과를 구분할 수 없습니다. 편집자들은 최소한 MR-Egger와 가중 중앙값, 그리고 IVW를 함께 요구하고 있습니다.
- 두 표본 설계에서 표본 중복을 무시하는 경우. 노출 및 결과 GWAS가 참가자를 부분적으로 공유하는 경우 표준 오차가 과소평가되고 위양성이 발생할 가능성이 높아지는데, 이는 Burgess, Davies 및 Thompson이 시뮬레이션을 통해 직접 정량화한 효과입니다(Burgess, Davies 및 Thompson, 2016).
- 조상들을 조정 없이 섞는 것. 인구 계층화를 고려하지 않고 서로 다른 조상 집단의 GWAS 결과를 결합하면 생물학적 원인과는 전혀 무관하게 대립유전자 빈도 차이만으로도 혼란 변수가 발생할 수 있습니다.
- 무효 결과를 인과관계가 없다는 증거로 과대해석하는 것. 신뢰구간이 넓은 귀무가설 추정치는 실제로 효과가 없다는 것보다는 통계적 검정력이 낮다는 것을 더 자주 반영하며, 이러한 차이점은 암시적으로 표현하기보다는 명시적으로 언급해야 합니다.
- 제출 시 STROBE-MR 체크리스트를 생략합니다. 현재 여러 학술지에서 이를 보충 파일로 요구하고 있으며, 해당 파일이 없으면 논문이 동료 심사 단계에 도달하기 훨씬 전에 편집자의 완성도 검사 과정에서 쉽게 1차 거절 사유가 됩니다.
멘델 무작위화 vs. 다른 인과 추론 방법
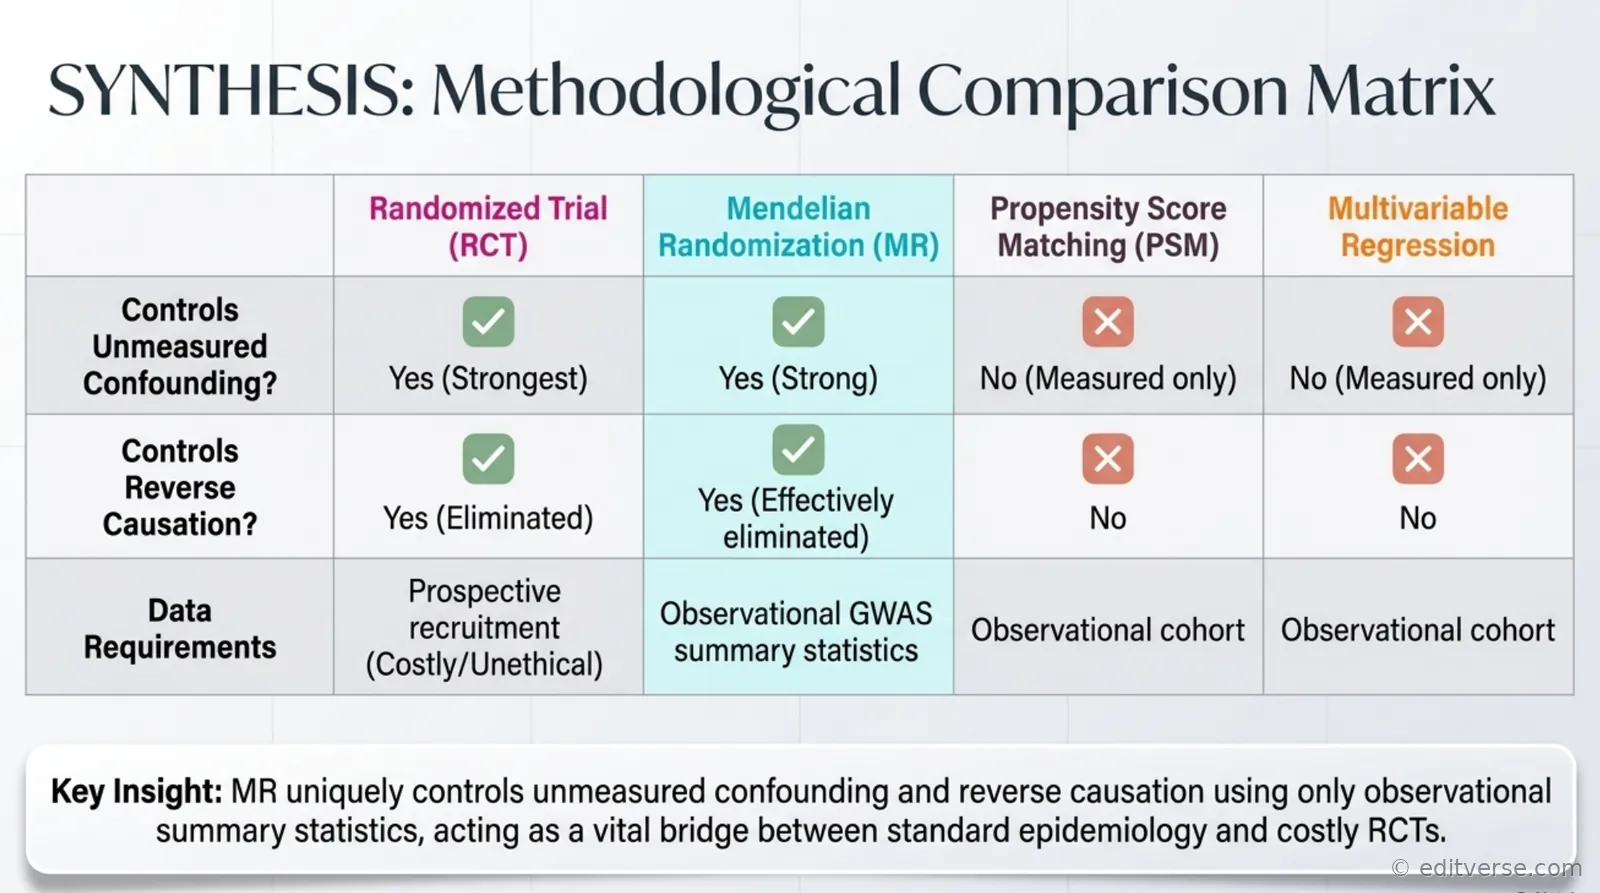
| 방법 | 혼란스러운 통제 | 역인과관계 | 데이터 요구 사항 |
|---|---|---|---|
| 무작위 대조 시험 | 가장 강력하게 설계됨 | 탈락 | 잠재적 채용은 종종 비용이 많이 들거나 비윤리적입니다. |
| 멘델의 무작위화 | 측정되지 않은 교란 요인에 대한 강력한 영향 | 사실상 제거됨 | 노출 및 결과에 대한 GWAS 요약 통계 |
| 성향 점수 매칭 | 측정된 교란변수에 대해서만 | 해결되지 않음 | 공변량을 포함한 관찰 코호트 |
| 다변수 회귀 분석 | 측정된 교란변수에 대해서만 | 해결되지 않음 | 공변량을 포함한 관찰 코호트 |
네 가지 설계 방식은 서로 경쟁하기보다는 상호 보완적입니다. 각 방식이 서로 다른 편향 구조를 가지고 있기 때문입니다. 유전적 도구, 매칭 비교, 조정 회귀 분석을 모두 활용하는 삼각측량 전략은 단일 방법만을 사용하는 것보다 훨씬 더 설득력이 있습니다(Lawlor, Tilling, and Davey Smith, 2016). 이러한 이유로 많은 우수한 논문에서 기존의 조정 분석 또는 매칭 분석과 유전적 민감도 검사를 함께 제시하고 있습니다. 유전학 외 분야에서의 도구 변수 방법 , 역학에서의 인과 추론 의 광범위한 논리 , 그리고 이 방법이 의존하는 GWAS 데이터 레이어에 대한 배경 지식은 GWAS 통계 방법 입문서를 참조하십시오 . 인과 관계가 단일 노출이 아닌 중간 단계를 포함하는 경우, 매개 분석 가이드에서는 다변수 MR이 유전적 도구를 사용하여 수행하는 것과 동일한 분해의 비유전적 버전을 다룹니다. 그리고 결과가 코호트 연구가 아닌 무작위 대조 시험에서 나온 경우, RCT 설계 및 분석 지침 과 의도 분석 대 프로토콜 준수 분석 지침은 해당 시험 추정치가 실제로 무엇을 의미하는지를 결정하는 모집단 정의 선택 사항을 다룹니다.
멘델 무작위화 연구에 대한 전문가 지원
위에서 설명한 방법론적 기준은 현재 편집 표준으로 자리 잡았으며, 제출된 많은 MR 논문이 심사 없이 반려되는 이유이기도 합니다. 핵심 추정치는 문제가 되는 경우가 드뭅니다. 문제는 분석의 절반이 누락된 데 있습니다. 즉, F-통계량, Steiger 필터링, 도구 변수 PheWAS가 없고, 다면발현 문제가 제기된 적이 없는 것처럼 단일 추정치만 보고되는 경우입니다. 저희 생물통계학자들은 R을 사용하여 모든 분석을 수행합니다. TwoSampleMR, MendelianRandomization MR-PRESSO또한 보고서 작성을 귀하에게 맡기는 대신, STROBE-MR 체크리스트를 작성하여 분석 결과를 제공해 드립니다.
타당성 검토
$450
연구 참여 전, 사용 도구 수, F-통계량, 표본 중복 및 기존 문헌을 검토합니다. 진행, 수정 또는 중단 여부는 서면으로 결정해 주십시오. 이후 의뢰하시는 모든 연구에 대해 해당 금액 전액을 공제해 드립니다. 소요 기간은 영업일 기준 5일입니다.
두 표본 MR
$2,900
공개된 GWAS 요약 통계 자료를 기반으로 한 전체 연구: 4가지 추정기, MR-PRESSO, Steiger 필터링, 도구 변수 PheWAS, leave-one-out 기법 적용, 그리고 STROBE-MR 체크리스트 및 실행 가능한 R 코드 포함. 15영업일 소요.
확장 디자인
$ 3,500부터
상관관계가 있는 노출, 매개 효과, 공동 위치 분석, 약물-표적 상호작용 및 비선형 상호작용을 고려한 다변량 MR 분석을 제공합니다. 모든 작업은 착수 전에 확정 견적 및 서면 작업 범위가 제공됩니다.
유전학적 연구 설계가 적합한지 아직 고민 중이거나, 설문 조사, 암 등록 자료 또는 외상 등록 자료 분석과 비교 검토 중이라면, 연구에 어떤 건강 데이터베이스를 사용해야 하는지 안내하는 가이드를 먼저 참조하십시오 . 이 범주에 속하지 않는 연구 설계에 대한 통계적 지원이 필요하시면, 저희 학위 논문 통계 분석 서비스를 통해 보다 광범위한 모델링 작업을 지원받으실 수 있습니다.
멘델 무작위화에 대한 자주 묻는 질문
멘델 무작위화는 무작위 대조 시험과 같은 것인가요?
아니요. 멘델 무작위화는 실제 개입이 아닌 유전적 변이를 이용하여 무작위 배정의 논리를 근사화하는 관찰 연구 설계입니다. 이는 보완적인 증거로 간주해야 하며, 교란된 관찰적 연관성을 반박할 만큼 충분히 강력하지만, 실행 가능하고 윤리적인 경우 충분한 검정력을 갖춘 무작위 대조 시험(RCT)을 대체해서는 안 됩니다.
유효한 도구는 몇 개의 유전자 변이체를 필요로 할까요?
정해진 최소값은 없습니다. 중요한 것은 F-통계량으로 측정되는 결합된 도구 변수 강도와 연관 불균형 클러스터링 후 변이체 간의 독립성입니다. LDL 콜레스테롤이나 BMI와 같이 잘 연구된 노출 요인은 수십에서 수백 개의 게놈 전체 유의미한 SNP를 이용할 수 있는 반면, 연구가 제한적인 노출 요인은 소수의 SNP만 이용할 수 있어 특정 방법의 가정에 대한 의존도가 높아지고 민감도 분석이 더욱 중요해집니다. F-통계량이 실제로 무엇을 의미하는지 에 대한 시뮬레이션 연구는 도구 변수 강도 수준별로 멘델 무작위화 설계의 정밀도가 얼마나 감소하는지를 정량화합니다.
적절한 통계적 검정력을 확보하려면 표본 크기는 얼마여야 할까요?
검정력은 도구 변수의 강도, 도구 변수가 설명하는 노출 변이의 비율, 그리고 결과 변수에 대한 GWAS 표본 크기에 따라 달라집니다. 실질적으로, 적절한 정확도로 중간 정도의 인과 효과를 탐지하려면 이진 결과 변수의 경우 수만 건, 연속 결과 변수의 경우 10만 명 이상의 참가자를 포함하는 결과 변수 GWAS를 사용하는 두 표본 설계가 일반적으로 필요합니다. 검정력이 부족한 분석은 위양성보다는 넓고 결론이 나지 않는 신뢰 구간을 생성하는 경향이 있습니다. 저희가 검증한 검정력 시뮬레이션인 " 멘델 무작위화 논문이 왜 심사에서 거절당하는가"는 6가지 현실적인 연구 설계를 통해 이를 수치로 보여주고, 최소 탐지 가능 효과를 귀무 결과와 함께 보고하는 방법을 제시합니다.
다변수 멘델 무작위화는 무엇에 사용되나요?
다변량 멘델 무작위화(MR)는 하나 이상의 유전적으로 상관관계가 있는 다른 노출 요인을 고정시킨 상태에서 특정 노출 요인이 결과에 미치는 직접적인 영향을 추정합니다. 이는 LDL 콜레스테롤과 아포지단백 B, 또는 BMI와 허리-엉덩이 비율처럼 두 노출 요인이 유전적 구조를 공유하는 경우에 필수적입니다. 동일한 분석 틀은 매개 분석 도구로도 활용될 수 있으며, 결과에 대한 유전적 영향 중 얼마나 많은 부분이 직접적인 작용이 아닌 특정 중간 노출 요인을 통해 전달되는지를 분석합니다(Sanderson, 2021).
이 방법만으로 인과관계를 증명할 수 있을까요?
멘델 무작위화는 세 가지 도구변수 가정이 모두 타당하게 성립하고 여러 민감도 분석 결과가 일치할 때 인과관계를 뒷받침하는 강력한 증거를 제공하지만, 그 자체만으로는 인과관계를 확정적으로 증명할 수 없습니다. 어떤 단일 관찰 방법도 마찬가지입니다. 현재 지침은 수렴하는 유전적 증거와 임상시험 증거를 상호 강화하는 것으로 간주하며, 저자들에게 임상시험 연구자가 잔여 교란변수에 적용하는 것과 동일한 주의를 기울여 잔여 다면발현 가능성을 보고하도록 요구합니다(Burgess et al., 2023).
이런 연구를 진행하려면 개인 수준의 유전자형 데이터가 필요한가요?
두 표본 설계에는 해당되지 않습니다. 두 표본 분석은 노출 및 결과에 대한 공개적으로 이용 가능한 GWAS 요약 통계만으로 수행할 수 있으므로, 자체 유전자형 코호트가 없는 연구자들도 두 표본 멘델 무작위화(MR)를 사용할 수 있게 되었으며, 전문 유전 역학 그룹 외에서도 빠르게 채택된 주요 이유입니다.
Editverse에서 제공하는 무료 리서치 도구
맺음말

멘델 무작위화는 연구자들이 관찰 유전 데이터로부터 무작위 실험을 근사적으로 구현할 수 있도록 해주는 방법이며, 이러한 이유로 역학, 심장학, 영양학, 정신의학 등 다양한 분야에서 교란변수와 역인과관계에 대한 심사자의 우려에 대한 기본 대응책으로 자리 잡았습니다. 타당한 도구, 도구의 강도에 대한 투명한 보고, 그리고 주요 IVW 추정치와 함께 보고되는 다면발현에 강건한 모든 민감도 분석을 통해 제대로 적용될 경우, 멘델 무작위화는 논문이 제시할 수 있는 가장 설득력 있는 관찰적 인과관계 증거를 제공합니다. 그러나 한 가지 방법만 검증되지 않고 STROBE-MR 체크리스트를 따르지 않는 등 부주의하게 적용될 경우, 회의적인 심사자의 주요 수정 요청을 받는 가장 빠른 길이 될 수도 있습니다. 위의 LDL-C, 비타민 D, 알코올 사례는 그 범위를 나란히 보여주는데, 이는 임상 시험 결과가 보고되기 전에 약물 표적을 확인한 유전자 도구, 복잡하고 혼란스러운 관찰 주장 목록을 특정하고 생물학적으로 일관된 하위 집합으로 분류한 도구, 그리고 헤드라인을 장식하는 연관성을 실제 위험과 거짓 위험으로 구분한 도구를 의미합니다.
참고자료
- Davey Smith G, Ebrahim S. '멘델 무작위화': 유전 역학이 질병의 환경적 결정 요인을 이해하는 데 기여할 수 있을까? Int J Epidemiol. 2003;32(1):1-22. doi: 10.1093/ije/dyg070. PMID: 12689998.
- Sanderson E, Glymour MM, Holmes MV, et al. 멘델 무작위화. Nature Reviews Methods Primers. 2022;2:6. doi: 10.1038/s43586-021-00092-5.
- Skrivankova VW, Richmond RC, Woolf BAR 외. 멘델 무작위화를 이용한 역학 분야 관찰 연구 보고 강화: STROBE-MR 성명서. JAMA. 2021;326(16):1614-1621. doi: 10.1001 / jama.2021.18236. PMID: 34698778.
- Burgess S, Butterworth A, Thompson SG. 요약된 데이터를 사용한 다중 유전 변이를 이용한 멘델 무작위화 분석. 유전 역학. 2013;37(7):658-665. doi: 10.1002/gepi.21758. PMID: 24114802.
- Burgess S, Thompson SG. 멘델 무작위화 연구에서 약한 도구로 인한 편향 방지. Int J Epidemiol. 2011;40(3):755-764. doi: 10.1093/ije/dyr036. PMID: 21414999.
- Bowden J, Davey Smith G, Burgess S. 유효하지 않은 도구를 사용한 멘델 무작위화: Egger 회귀를 통한 효과 추정 및 편향 감지. Int J Epidemiol. 2015;44(2):512-525. doi: 10.1093/ije/dyv080. PMID: 26050253.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. 가중 중앙값 추정기를 사용하여 일부 유효하지 않은 도구를 사용하는 멘델 무작위화에서 일관된 추정. 유전 역학. 2016;40(4):304-314. doi: 10.1002/gepi.21965. PMID: 27061298.
- Verbanck M, Chen CY, Neale B, Do R. 복잡한 형질과 질병 간의 멘델 무작위화를 통해 추론된 인과 관계에서 광범위한 수평적 다면발현의 탐지. 냇 지네. 2018;50(5):693-698. doi: 10.1038/s41588-018-0099-7. PMID: 29686387.
- Sekula P, Del Greco MF, Pattaro C, Köttgen A. 관찰 데이터를 사용하여 인과 관계를 평가하는 접근법으로서의 멘델 무작위화. J Am Soc 네프롤. 2016;27(11):3253-3265. doi: 10.1681/ASN.2016010098. PMID: 27486138.
- Larsson SC, Butterworth AS, Burgess S. 심혈관 질환에 대한 멘델 무작위화: 원리 및 응용. 유럽 심장 저널. 2023;44(47):4913-4924. doi: 10.1093/eurheartj/ehad736. PMID: 37935836.
- Lawlor DA, Tilling K, Davey Smith G. 병인 역학에서의 삼각측량. Int J Epidemiol. 2016;45(6):1866-1886. doi: 10.1093 / ije / dyw314. PMID: 28108528.
- Burgess S, Davies NM, Thompson SG. 두 표본 멘델 무작위화에서 참가자 중복으로 인한 편향. 유전 역학. 2016;40(7):597-608. doi: 10.1002/gepi.21998. PMID: 27625185.
- Burgess S, Davey Smith G, Davies NM, et al. 멘델 무작위화 조사 수행 지침: 2023년 여름 업데이트. 웰컴 오픈 리서치. doi : 10.12688/wellcomeopenres.15555.3.
- Ference BA, Yoo W, Alesh I, et al. 생애 초기에 낮은 저밀도 지질단백질 콜레스테롤에 장기간 노출되는 것이 관상동맥 심장 질환 위험에 미치는 영향: 멘델 무작위 분석. J Am Coll Cardiol. 2012;60(25):2631-2639. doi: 10.1016/j.jacc.2012.09.017.
- Pott J, Gådin JR, Theusch E, et al. PCSK9 수치에 대한 메타 GWAS에서 두 개의 새로운 유전자좌가 발견되었습니다. APOB TM6SF2. 험 몰 Genet. 2022;31(6):999-1011. doi: 10.1093/hmg/ddab279. PMID: 34590679.
- Gagnon E, Gill D, Bourgault J, et al. 심혈관 질환 예방을 위한 RNA 간섭 대 항체 기반 PCSK9 억제: 약물 표적 멘델 무작위 연구. 심혈관 해상도. 2025;121(7):1066-1075. doi: 10.1093/cvr/cvaf078. PMID: 40347490.
- 샌더슨 E. 다변수 멘델 무작위화 및 매개 분석. 차가운 봄 Harb Perspect Med. 2021;11(2):a038984. doi: 10.1101/cshperspect.a038984. PMID: 32341063.
- Fang A, Zhao Y, Yang P, Zhang X, Giovannucci EL. 비타민 D와 인간 건강: 멘델 무작위화 연구에서 얻은 증거. 유럽 역학 저널. 2024;39(5):467-490. doi: 10.1007/s10654-023-01075-4. PMID: 38214845.
- Zhao SS, Mason A, Gjekmarkaj E, Yanaoka H, Burgess S. 비타민 D와 자가면역 질환 간의 연관성: 멘델 무작위 분석. 정액 관절염 류마티스. 2023;62:152238. doi: 10.1016/j.semarthrit.2023.152238. PMID: 37437450.
- Millwood IY, Walters RG, Mei XW 등. 알코올과 혈관 질환의 병인에 대한 기존 및 유전적 증거: 중국 남녀 500,000만 명을 대상으로 한 전향적 연구. 랜싯. 2019;393(10183):1831-1842. doi: 10.1016/S0140-6736(18)31772-0. PMID: 30955975.