발행 | 최종 업데이트:
카이 제곱 검정은 한 가지 특정한 질문에 답합니다. 여러 범주에 걸쳐 관찰된 빈도수가 독립성 또는 명시된 모델이 예측하는 값과 다른가? 칼 피어슨은 1900년에 이 검정을 도입했으며 , 역학자들은 여전히 매주 이 검정을 사용하여 집단 간 노출률을 비교하고, 유전자형 데이터의 오류를 검사하고, 질병 발생이 연중 고르게 분포하는 것이 아니라 계절별로 집중되는지 확인합니다. 이 주제에 대한 기존 안내서들은 대개 공식만 제시하고 더 이상 설명하지 않습니다. 하지만 이 안내서에서는 두 개의 분할표를 직접 계산하고, 모든 수치를 독립적인 통계 소프트웨어로 검증하며, 카이제곱 근사치가 더 이상 신뢰할 수 없어지는 시점을 정확히 설명하여 피셔의 정확 검정을 사용해야 하는 경우를 제시합니다.
주요 요점
- A 카이 제곱 검정 관찰된 범주 개수를 귀무 가설 하에서 예상되는 개수와 비교하기 위해 통계량 χ² = Σ(O − E)² / E를 사용합니다.
- The 독립성에 대한 카이제곱 검정 두 범주형 변수 사이에 관련성이 있는지 확인합니다. 적합도 테스트 한 변수의 분포가 가설로 설정한 패턴과 일치하는지 확인합니다.
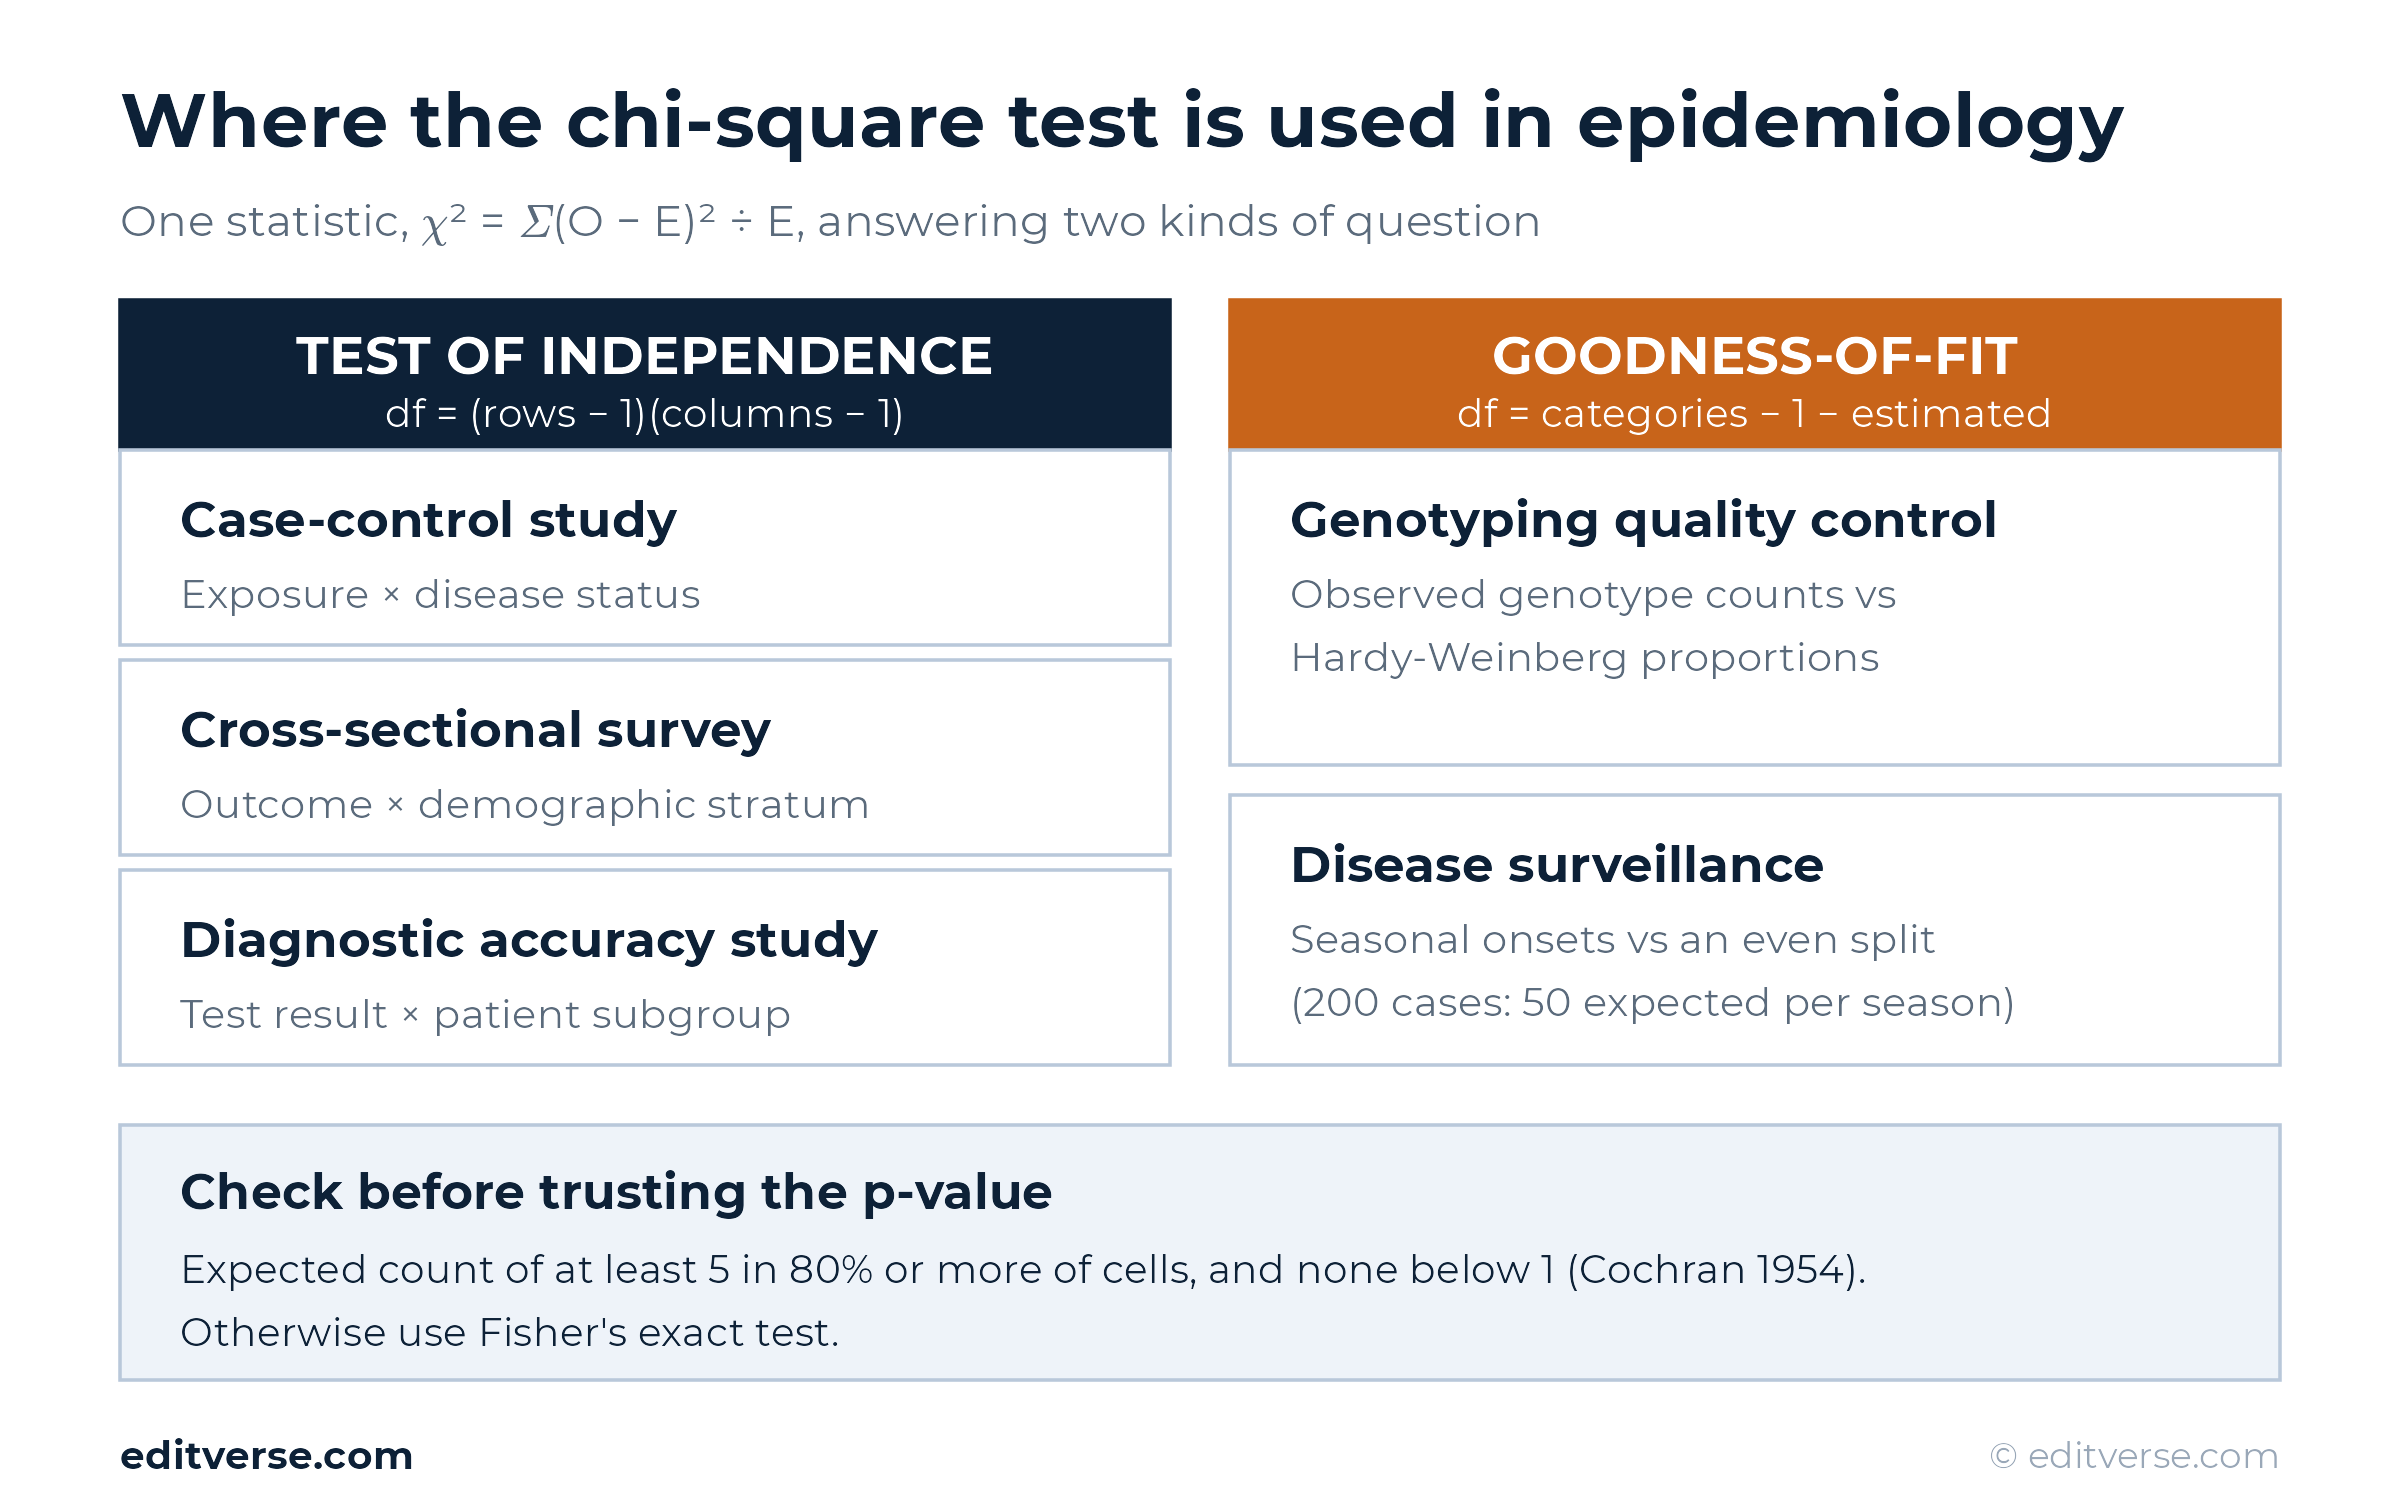
- 자유도 분할표의 경우 (행 - 1) × (열 - 1)과 같습니다. 적합도 검정의 경우 범주 수에서 1을 뺀 값에서 데이터로부터 추정된 매개변수 값을 뺀 것과 같습니다.
- 코크란의 1954년 지침에 따르면 예상 빈도수가 5 미만인 세포는 20%를 넘지 않아야 하며, 1 미만인 세포는 없어야 합니다. 이 기준을 넘어서면 문제가 됩니다. 피셔의 정확 검정 더 안전한 선택이 된다.
- 유의미한 카이제곱 검정 결과는 연관성이 존재함을 보여줍니다. 하지만 연관성의 강도는 별개의 문제이며, p값만으로 판단할 수 있는 것이 아니라 오즈비, 상대 위험도 또는 크래머의 V 계수를 통해 확인할 수 있습니다.
간단한 단어로
치료를 받은 환자 그룹과 치료를 받지 않은 환자 그룹, 이렇게 두 그룹을 생각해 보세요. 두 그룹 모두 회복 여부에 따라 결과가 '예' 또는 '아니오'로 나타납니다. 카이제곱 검정은 두 그룹의 회복 양상이 동일한지, 아니면 실제로 차이가 있는지를 판별하는 검정입니다. 이 검정은 각 그룹의 발생 빈도를 표로 정리하고, 치료가 결과에 아무런 영향을 미치지 않았을 경우의 발생 빈도를 계산한 다음, 실제 발생 빈도가 예상 발생 빈도와 얼마나 차이가 나는지를 측정합니다. 실제 발생 빈도와 예상 발생 빈도 사이의 차이가 크면 p값이 작아지고, 이는 치료와 결과 사이에 실제적인 연관성이 있음을 시사합니다. 반대로 차이가 작으면 표에 나타난 양상은 우연의 일치일 가능성이 높습니다.
결과를 신뢰하기 전에 두 가지 안전장치를 확인해야 합니다. 첫째, 동일한 환자가 두 번 계산될 수 없으므로 모든 범주가 완전히 분리되어야 합니다. 둘째, 대부분의 셀에서 예상 빈도가 최소 5 이상이어야 합니다. 표본 크기가 작은 경우 에는 피셔의 정확 검정을 사용해야 하며 , 이는 이 가이드의 뒷부분에서 다룹니다.
카이제곱 검정이란?
통계학자들은 카이제곱 검정들을 하나의 공통된 특징으로 묶습니다. 각 검정 통계량은 귀무가설이 참이고 표본 크기가 적절할 때 카이제곱 분포를 따릅니다. 이 범주에 속하는 두 가지 검정은 연구자가 실제로 접하는 거의 모든 사례를 포괄합니다. 카이 제곱 독립성 검정은 치료군과 임상 결과처럼 동일한 피험자를 대상으로 측정된 두 개의 범주형 변수에 대해 한 변수의 값이 다른 변수의 값을 예측하는지 여부를 묻습니다. 카이 제곱 적합도 검정은 단일 범주형 변수에 대해 관찰된 분포가 미리 지정된 분포(예: 사계절에 걸쳐 균등하게 분포된 분포 또는 멘델 유전 법칙에 따른 유전 비율)와 일치하는지 여부를 묻습니다.
이 두 가지 검정 방법 중 하나를 선택하거나, 카이제곱 검정과 완전히 다른 검정 방법 중 하나를 선택하는 것은 데이터 수집 방식과 질문의 의도에 따라 달라집니다. 카이제곱 검정이 자신의 데이터에 적합한 검정 방법인지 확신이 서지 않는 독자분들은 Editverse의 대화형 검정 선택 도구 나 통계 검정 흐름도를 참고하여 결정을 내리신 후 다음 단계로 진행하시기 바랍니다.
두 카이제곱 검정 모두 동일한 통계량을 사용합니다.
χ² = Σ (O − E)² / E
O는 특정 범주 또는 셀에서 관찰된 개수를 나타내고, E는 귀무 가설 하에서 예상되는 개수를 나타냅니다. 합계는 표의 모든 셀에 대해 계산됩니다. 차이를 제곱하면 부호가 사라지므로 과다 집계와 과소 집계 모두 통계량을 증가시키고, E로 나누면 제곱된 차이를 해당 셀에서 실제로 예상되는 개수에 비례하여 조정합니다. 200개의 관측값을 담을 것으로 예상되는 셀은 10개의 차이를 큰 문제 없이 수용할 수 있지만, 5개의 관측값을 담을 것으로 예상되는 셀은 그렇지 못하며, E로 나누는 것은 이러한 차이를 직접적으로 반영합니다.
카이제곱 검정 통계량은 어떻게 계산되는가?
기대 빈도는 편의상 선택한 정수가 아니라 귀무 가설에서 도출됩니다. 분할표에서 각 셀의 기대 빈도는 해당 행의 합계와 해당 열의 합계를 곱한 후 전체 합계로 나눈 값입니다. 이 공식은 독립성 가정에서 직접적으로 도출됩니다. 두 변수가 실제로 서로 아무런 관련이 없다면, 특정 행에 해당하는 열의 비율은 전체 표에서 해당 행이 차지하는 비율과 일치해야 합니다.
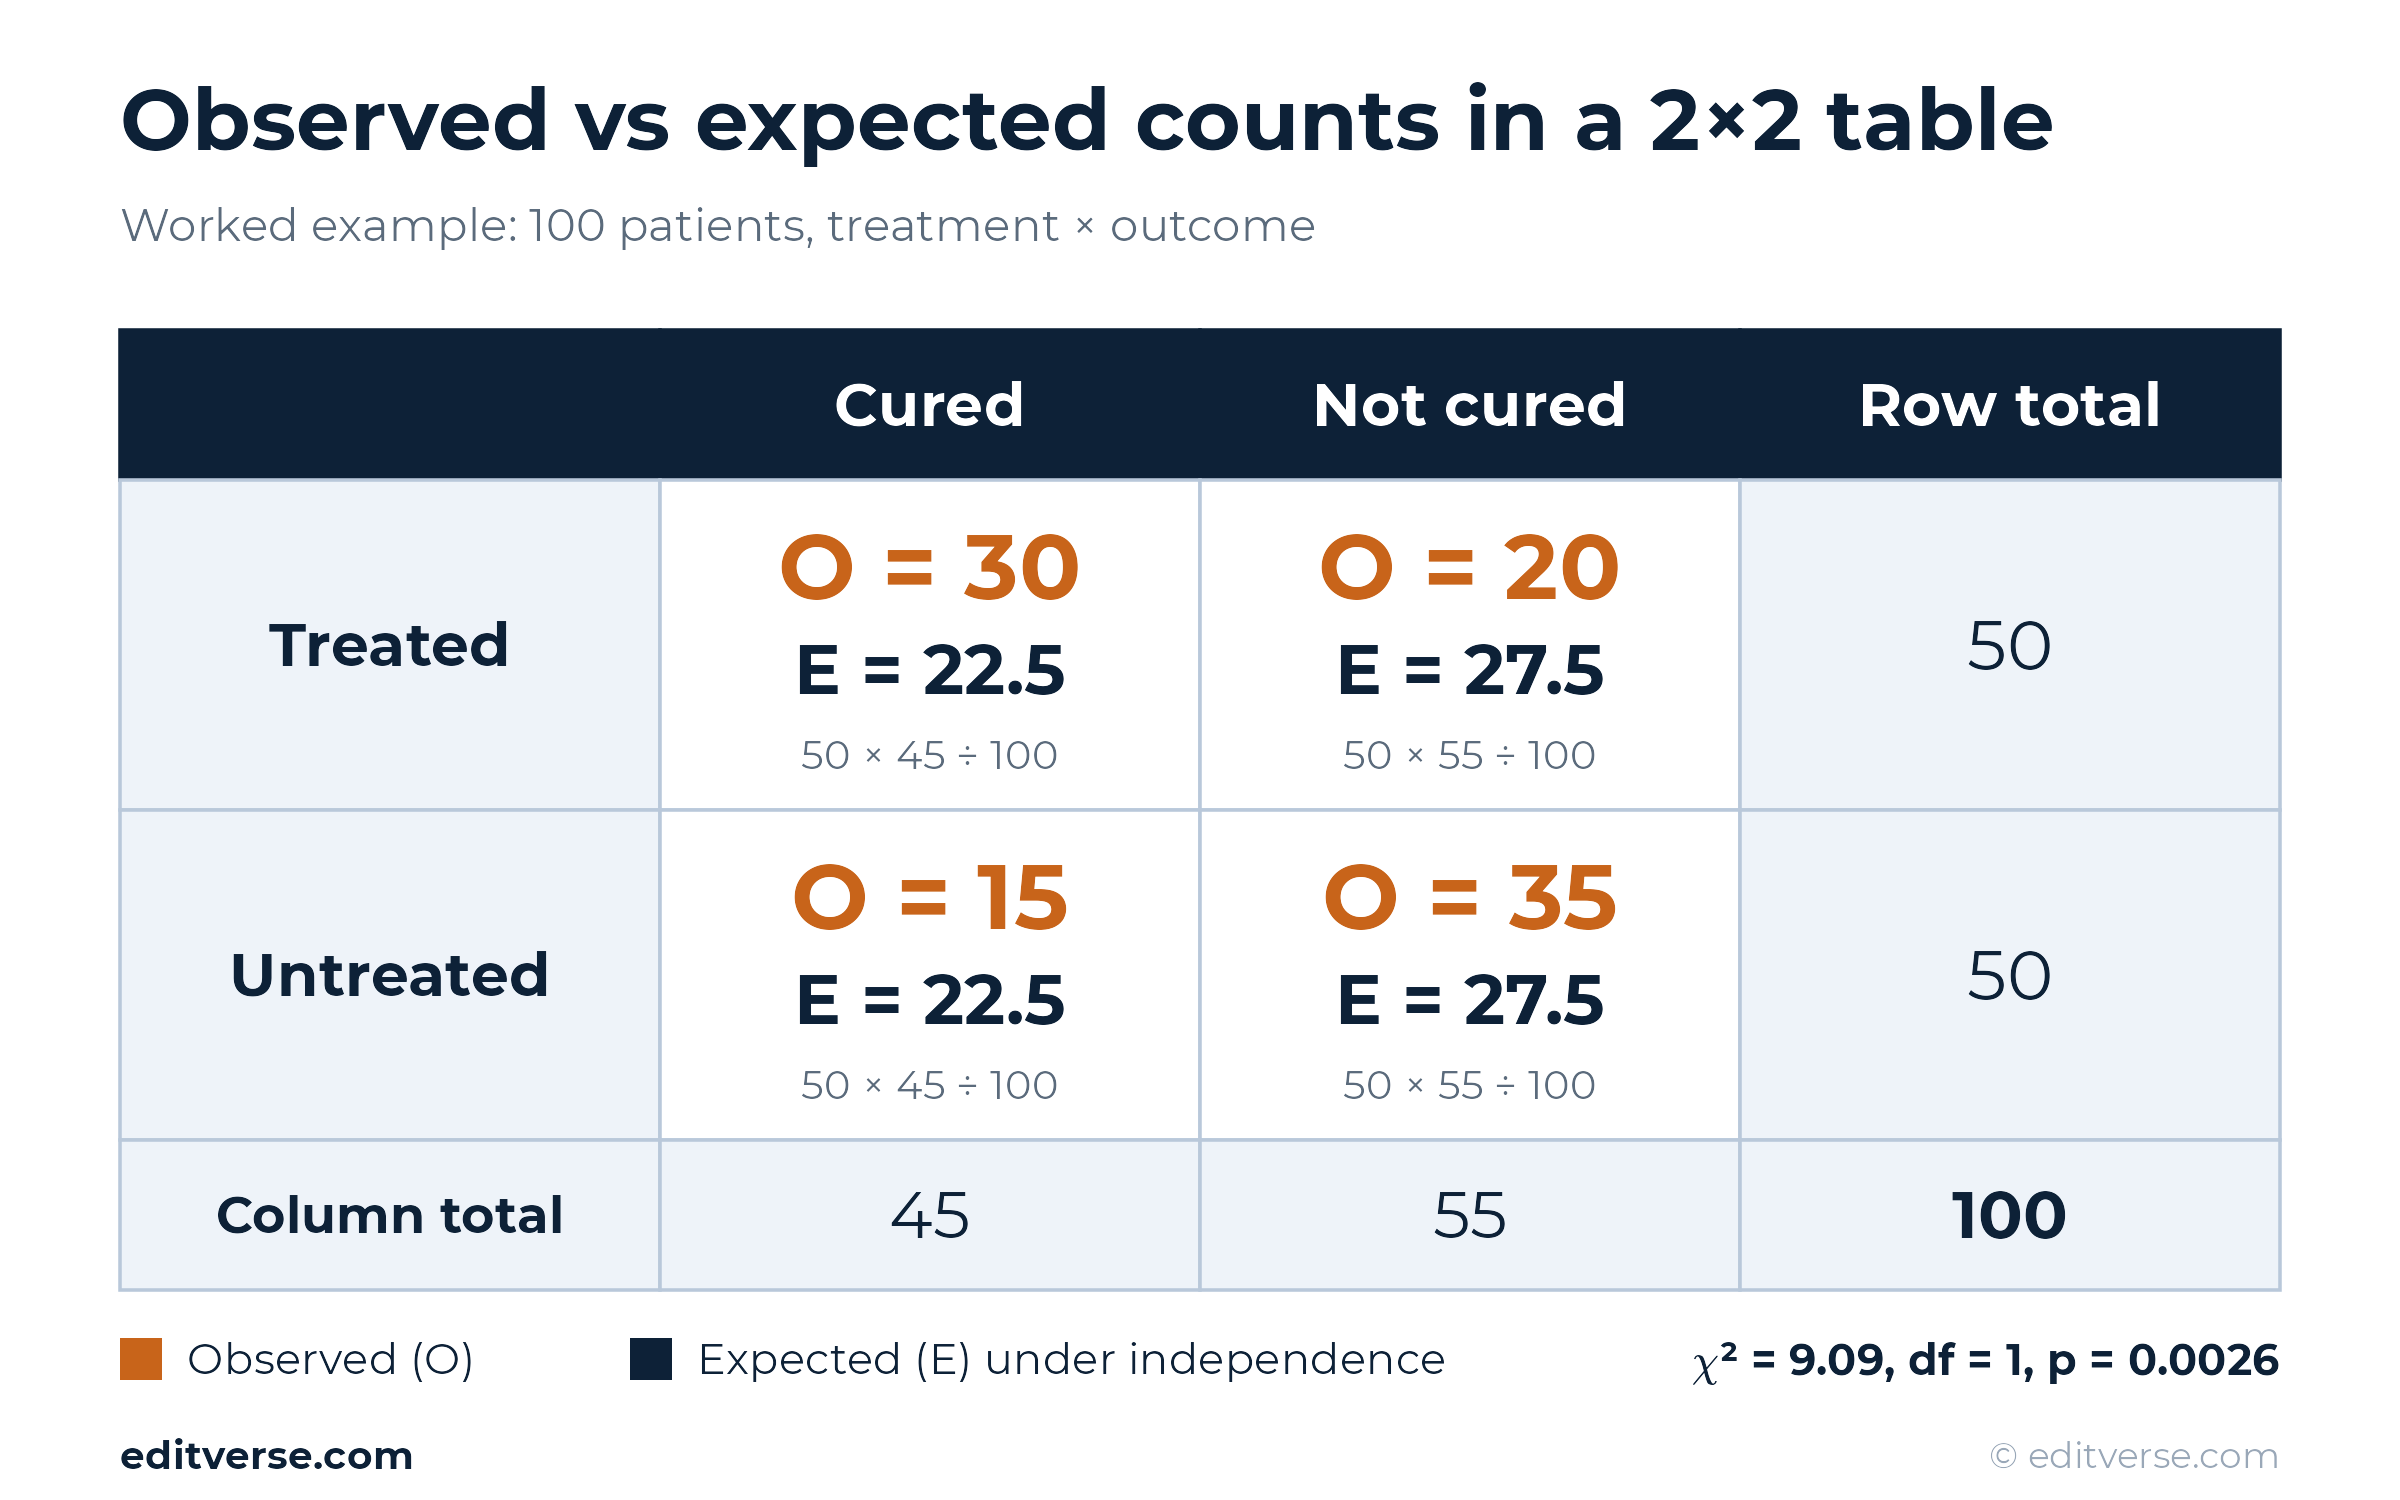
간단한 예시를 통해 이를 구체화해 보겠습니다. 100명의 환자를 치료군 50명과 비치료군 50명으로 나누었을 때, 각 군에서 45명이 완치되고 55명이 완치되지 않았다고 가정해 봅시다. 독립성에 따라 치료군의 완치율은 비치료군과 동일하게 45%여야 하므로, 치료군에서 완치된 환자의 예상 수는 50 × 45 ÷ 100, 즉 22.5명입니다. 예상 수는 정수일 필요가 없지만, 관찰된 수는 정수여야 합니다.
적합도 검정에서 기대 발생 횟수는 같은 방식으로 작동하지만, 두 번째 변수가 아닌 가설적인 비율에서 도출됩니다. 200건의 질병 발생이 4개 계절에 걸쳐 고르게 분포하는지 검정할 때, 각 계절의 기대 발생 횟수는 200 × 0.25, 즉 50으로 설정되며, 실제 계절별 발생 횟수가 이 평탄한 선에서 얼마나 벗어나는지를 측정합니다.
카이제곱 검정의 자유도
자유도는 카이제곱 분포의 형태를 결정합니다. 결과 섹션을 작성할 때 자유도 값이 일치하지 않으면 이를 간과하기 쉽지만, 이는 통계량 비교에 사용되는 임계값을 변경하여 경계선상의 결론을 유의미한 것에서 유의미하지 않은 것으로, 또는 그 반대로 바꿀 수 있습니다. 행이 r개, 열이 c개인 분할표의 경우 자유도는 (r − 1)(c − 1)입니다. 따라서 표준 2×2 분할표는 정확히 1의 자유도를 갖습니다. 행과 열의 합계가 고정되면 나머지 셀이 제외되기 전에 하나의 셀만 자유롭게 변할 수 있기 때문입니다.
적합도 검정의 자유도는 관련은 있지만 구별되는 규칙을 따릅니다. 자유도는 범주 수에서 1을 뺀 값에, 사전에 고정된 값이 아닌 표본에서 추정된 매개변수 하나당 자유도 1을 더한 값과 같습니다. 예를 들어, 4개 계절을 25%의 단일 기대값과 비교하는 경우, 데이터에서 추정된 값이 없으므로 4 - 1 = 3의 자유도가 사용됩니다. 유전자형 빈도를 하디-weinberg 평형과 비교하는 것은 좀 더 복잡한데, 기대 유전자형 빈도를 계산하는 데 사용되는 대립유전자 빈도 자체가 동일한 표본에서 추정되기 때문입니다. 이 추정 단계는 단순한 빈도-1 규칙 외에 추가적인 자유도를 필요로 합니다.
카이제곱 독립성 검정: 자세한 풀이 과정
치료를 받은 환자 50명과 치료를 받지 않은 환자 50명으로 구성된 총 100명의 두 그룹을 비교하는 경우를 생각해 보겠습니다. 이 비교는 치료 여부(완치 또는 미완치)를 이진 변수로 하여 교차 분석됩니다. 이 데이터 세트는 Editverse의 카이제곱 검정 계산기 에서 예시로 바로 사용할 수 있으므로 아래의 모든 단계를 즉시 따라 할 수 있습니다.
| 경화 | 치료되지 않음 | 행 합계 | |
|---|---|---|---|
| 치료 된 | 30 | 20 | 50 |
| 미처리 | 15 | 35 | 50 |
| 열 합계 | 45 | 55 | 100 |
기대 빈도는 이전 섹션의 행 합계 × 열 합계 규칙을 따릅니다. 치료 후 완치된 그룹의 기대 빈도는 50 × 45 ÷ 100 = 22.5입니다. 치료 후 완치되지 않은 그룹의 기대 빈도는 50 × 55 ÷ 100 = 27.5입니다. 치료받지 않았지만 완치된 그룹의 기대 빈도는 50 × 45 ÷ 100 = 22.5입니다. 치료받지 않았지만 완치되지 않은 그룹의 기대 빈도는 50 × 55 ÷ 100 = 27.5입니다. 모든 기대 빈도는 코크란의 임계값 5를 넘으므로 일반적인 카이제곱 근사치를 별도의 조건 없이 적용할 수 있습니다.
각 세포는 총합에 (O − E)² ÷ E만큼 기여합니다. 치료 후 완치된 세포는 (30 − 22.5)² ÷ 22.5 = 2.500을 기여합니다. 치료 후 완치되지 않은 세포는 (20 − 27.5)² ÷ 27.5 = 2.045를 기여합니다. 치료받지 않았지만 완치된 세포는 (15 − 22.5)² ÷ 22.5 = 2.500을 기여합니다. 치료받지 않았지만 완치되지 않은 세포는 (35 − 27.5)² ÷ 27.5 = 2.045를 기여합니다. 이 네 가지 기여도를 합하면 자유도 1에서 χ² = 9.091이 되며, 이는 p = 0.0026에 해당하여 일반적인 유의수준 0.05보다 훨씬 낮습니다. 아래에서 자세히 설명하는 Yates의 연속성 보정을 적용하면 통계치는 7.919(p = 0.0049)로 낮아집니다. 동일한 표에 대해 독립적으로 실행한 Fisher의 정확 검정 결과는 p = 0.0046입니다. 세 가지 방법 모두 치료와 결과가 연관되어 있음을 보여주며, 이는 논문 심사자가 결과 섹션에서 보고 싶어하는 바로 그러한 삼각 검증 결과입니다.
통계적 유의성만으로는 연관성의 강도를 설명할 수 없습니다. 치료받은 환자에서 완치될 확률은 30 대 20이고, 치료받지 않은 환자에서는 15 대 35이므로, 오즈비는 (30 × 35) ÷ (20 × 15) = 3.5입니다. 2×2 분할표에서 0과 1 사이의 값을 갖는 카이제곱 기반 효과 크기인 크래머의 V는 제곱근(9.091 ÷ 100), 즉 0.30으로 계산되며, 이는 일반적인 기준으로는 작은 연관성과 중간 연관성 사이에 해당합니다. p값만 단독으로 보고하는 대신 오즈비와 크래머의 V 옆에 p값을 함께 보고하는 것은 심사자의 질문을 유발하는 결과 섹션과 출판 준비가 완료된 결과 섹션을 구분하는 데 도움이 됩니다. 맥휴가 직장 내 백신 접종 연구를 설명하는 방식은 다음과 같습니다. 백신을 접종하지 않은 직원 92명 중 23명이 폐렴구균성 폐렴에 걸린 반면, 백신을 접종한 직원 92명 중에서는 5명만 걸렸습니다. 카이제곱 검정을 통해 이러한 차이가 우연이 아님을 확인하고, 크래머의 V 통계량을 통해 그 차이가 얼마나 큰지 보여줍니다.
분할표와 기대 빈도: 실제 2×2 예시
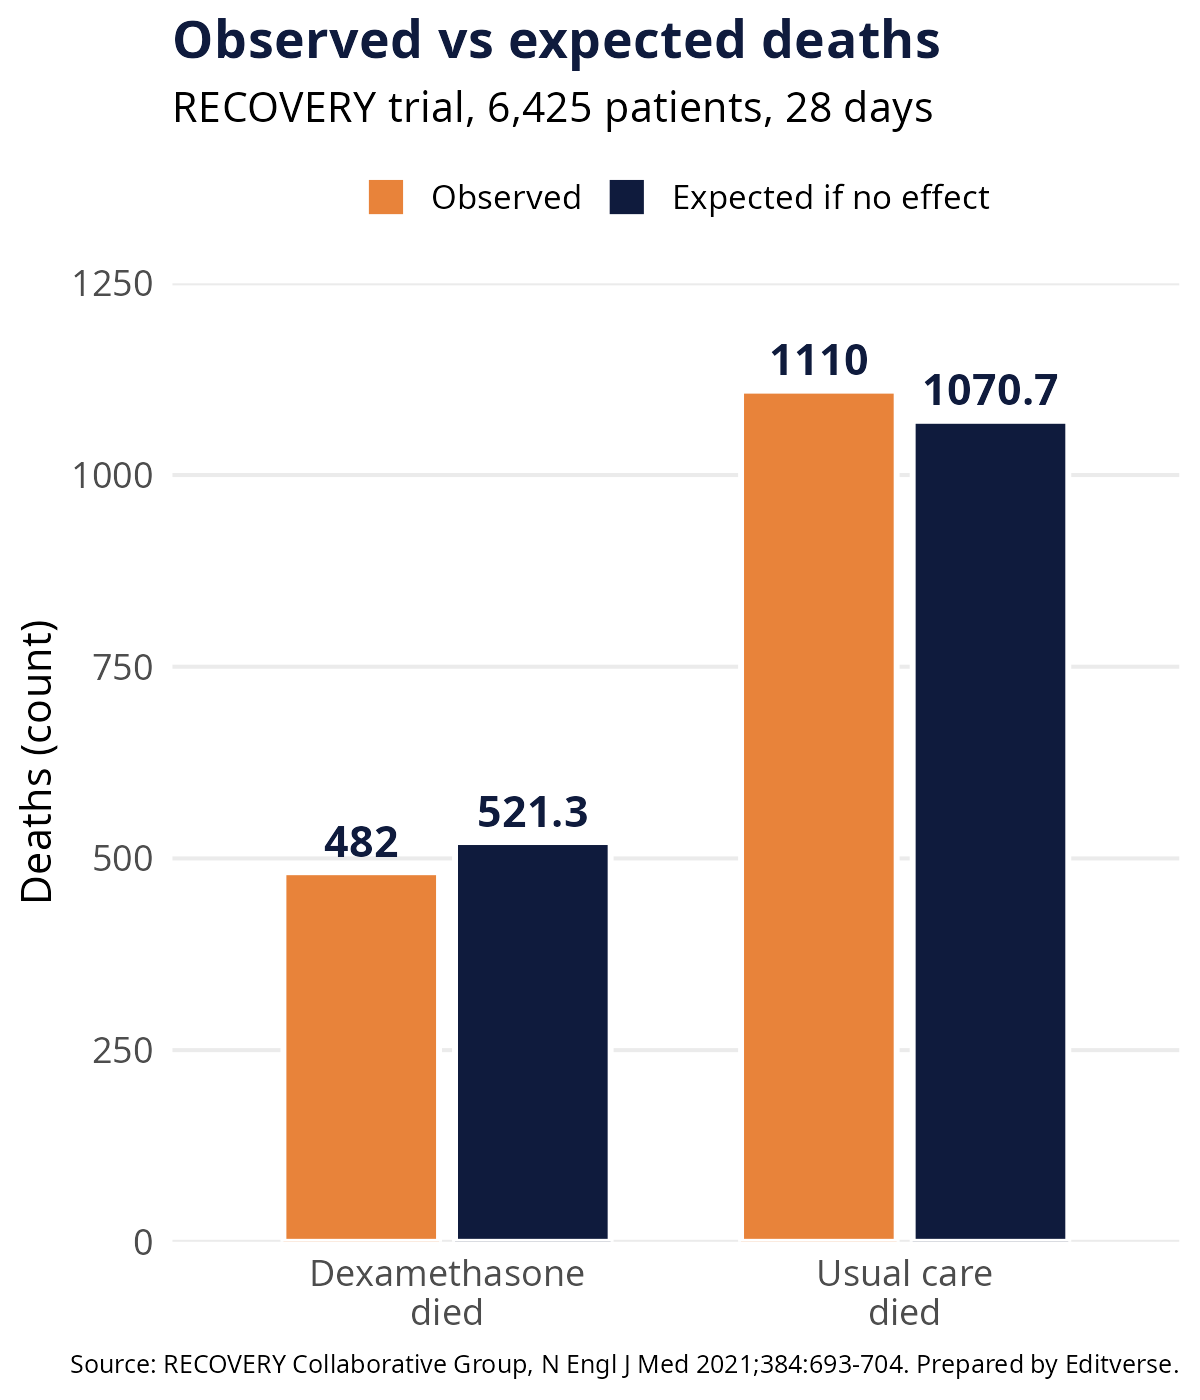
분할 표는 두 개의 범주형 변수를 교차표로 나타내고, 카이제곱 검정은 각 셀의 관찰된 빈도와 예상 빈도 를 비교합니다 (행 합계 × 열 합계 ÷ 총합). RECOVERY 임상시험에서는 입원한 코로나19 환자를 덱사메타손 6mg을 매일 투여하는 군과 일반적인 치료를 받는 군으로 무작위 배정하고 28일 이내 사망자 수를 집계했습니다. 최종 보고서는 PubMed Central 에서 무료로 열람할 수 있으며 , 초록에는 필요한 모든 수치가 나와 있습니다. 덱사메타손 투여군 2,104명, 일반 치료군 4,321명, 사망자 수 482명, 일반 치료군 1,110명입니다.
| 그룹 | 28일 만에 사망 | 생존 | 금액 |
|---|---|---|---|
| Dexamethasone | 482 | 1,622 | 2,104 |
| 일반적인 관리 | 1,110 | 3,211 | 4,321 |
| 금액 | 1,592 | 4,833 | 6,425 |
1단계: 예상 빈도
덱사메타손이 아무런 차이를 만들지 않는다면, 사망자 수는 집단 규모에 비례하여 분배될 것입니다. 전체 사망률은 1,592명/6,425명입니다. 덱사메타손 투여군의 예상 사망자 수는 1,592 × 2,104 / 6,425 = 521.33명 이고, 일반 치료군의 예상 사망자 수는 1,592 × 4,321 / 6,425 = 1,070.67명 입니다. 실제 사망자 수는 각각 482명과 1,110명이므로, 덱사메타손 투여군은 예상보다 39.3명 적고, 일반 치료군은 예상보다 39.3명 많습니다.
2단계: 검정 통계량
χ² = Σ (O − E)² / E = 5.87 (자유도 1, p = 0.015). Yates 보정을 적용하면 χ² = 5.72 (p = 0.017). 표준화 잔차는 -1.72(덱사메타손 투여군, 사망) 및 +1.20(일반 치료군, 사망)이며, 모두 ±2를 넘지 않으므로 특정 세포가 두드러지지 않습니다. 모든 기대 빈도가 500 이상이므로 대규모 표본 근사치는 안전합니다. R's chisq.test 그리고 파이썬의 scipy.stats.chi2_contingency 동일한 값을 반환했습니다.
카이제곱 적합도 검정: 두 번째 예제 풀이
감시팀은 두 변수 간의 관련성이 아니라 한 변수의 분포가 예상되는 패턴과 일치하는지 여부를 묻는 경우가 많습니다. 예를 들어, 보건부가 한 해 동안 200건의 위장 질환 확진 사례를 기록하고 발병이 계절별로 집중되는지 아니면 고르게 분포되는지 알고 싶어한다고 가정해 보겠습니다. 계절성이 없다는 귀무 가설 하에서는 각 계절마다 200 × 0.25 = 50건의 사례가 발생할 것으로 예상됩니다.
| 계절 | 관찰 | 기대하는 | (O − E)² ÷ E |
|---|---|---|---|
| 겨울 | 72 | 50 | 9.68 |
| 봄 | 38 | 50 | 2.88 |
| 여름 | 33 | 50 | 5.78 |
| 떨어지다 | 57 | 50 | 0.98 |
네 계절 전체를 합산한 결과, 기여도 합계는 χ² = 19.32이고 자유도는 4 − 1 = 3이며, p값은 0.00023입니다. 이 결과는 균일 분포라는 귀무 가설을 결정적으로 기각합니다. 겨울의 기여도 9.68과 여름의 기여도 5.78이 전체 통계량의 대부분을 차지하며, 이는 편차가 실제로 어디에 있는지를 명확하게 보여줍니다. 겨울은 예상 비율보다 훨씬 높고 여름은 예상 비율보다 훨씬 낮습니다. 모든 계절이 같은 방향으로 약간씩 이동하는 것이 아니라, 각 계절의 기여도가 모두 동일한 방향으로 이동하는 것입니다. 이러한 차이는 전체 p값만으로는 드러나지 않으며, 각 계절의 기여도를 개별적으로 검토해야만 확인할 수 있습니다.
이러한 구조는 역학 전반에 걸쳐 나타나는데, 가장 흔하게는 유전자형 분석의 품질 관리 단계에서 유전자형 분포가 하디-와인버그 평형을 따르는지 확인하거나, 진단 결과가 참조 집단에서 추출한 예상 비율과 일치하는지 확인하는 데 사용됩니다. 기본적인 방법은 변하지 않습니다. 귀무 가설의 비율을 구하고, 전체 표본 크기를 곱하여 예상 분포를 계산한 다음, 표준화된 차이의 제곱을 합산하고, 그 결과를 동일한 자유도를 가진 카이제곱 분포와 비교합니다.
카이제곱 검정이 제대로 작동하지 않는 경우: 예상 셀 빈도가 작을 때
카이제곱 통계량은 항상 근사치일 뿐입니다. 이 통계량의 기준 분포는 세포 빈도가 연속적이고 대략 정규 분포를 따르는 양처럼 행동하여 이산적인 제곱 편차 합이 매끄러운 카이제곱 곡선을 그릴 수 있다고 가정합니다. 이러한 가정은 각 세포가 상당히 큰 기대 빈도를 가진다는 전제에 기반하는데, 이는 이항 비율에 대한 정규 근사가 꼬리 부분에서 오차가 발생하지 않기까지 충분한 시행 횟수가 필요한 것과 유사합니다. 기대 빈도가 2 또는 3으로 떨어지면 관측 빈도가 실제로 가질 수 있는 몇 안 되는 값들이 분포의 산포에 비해 서로 멀리 떨어져 있게 되고, 통계량의 실제 표본 분포는 매끄럽지 않고 울퉁불퉁해지며, 카이제곱 곡선은 이를 제대로 나타내지 못하게 됩니다.
윌리엄 코크런이 1954년 생물통계학(Biometrics)에 발표한 논문은 이러한 이론적 우려를 오늘날까지 가르쳐지고 있는 실용적인 규칙으로 발전시켰습니다. 세포의 20% 이상이 기대 빈도가 5 미만이어야 하고, 어떤 세포도 1 미만이어서는 안 됩니다. 이 두 기준 중 하나라도 어긋나면 보고된 p값은 더 이상 액면 그대로 신뢰할 수 없습니다. 당시의 시뮬레이션 연구는 폐쇄형 증명이 아닌 규칙 자체를 도출해냈고, 이후 연구들은 정확한 임계값에 대한 논쟁에도 불구하고 근본적인 우려를 계속해서 확인시켜 왔습니다. 특히 하디-와인버그 평형 검정에 관한 방법론 문헌에서는 일반적인 카이제곱 적합도 검정이 작은 표본 크기나 드문 대립유전자 빈도에 매우 민감하다고 설명하고 있습니다.
간단한 표를 통해 실질적인 중요성을 명확히 보여줍니다. 빈도수가 각각 4, 1, 1, 4인 2×2 표를 생각해 보겠습니다. 모든 빈도수가 2.5로, 코크란의 최소 유의수준보다 훨씬 낮습니다. 보정되지 않은 카이제곱 통계량은 자유도 1에서 3.6, p값은 0.058로 나오는데, 이는 "유의미한 경향"이라고 말하기에 충분히 합리적인 결과입니다. 하지만 예이츠의 연속성 보정을 적용하면 동일한 표에서 카이제곱 통계량은 1.6(p값 0.206)으로 낮아지고, 독립적으로 수행된 피셔의 정확 검정 역시 p값 0.206으로 나와 보정된 카이제곱 통계량과 거의 일치하며, 보정되지 않은 카이제곱 통계량과는 완전히 상반됩니다. 따라서 보정되지 않은 p값을 그대로 제시하는 것은 정확 검정에서 지지되지 않는 연관성을 과장하는 결과를 초래할 수 있습니다.
예이츠의 연속성 수정 방법 설명
프랭크 예이츠는 1934년 왕립 통계 학회지(Journal of the Royal Statistical Society)에 발표한 논문 에서 작은 2×2 표에 대한 수정 방법을 제안했습니다 . 카이제곱 분포는 연속적인 반면 각 셀의 개수는 이산적인 정수이기 때문에, 예이츠는 제곱하기 전에 각 (O − E) 차이의 절댓값에서 0.5를 빼는 방법을 제안했습니다. 이 방법은 통계량을 축소시키고 수정되지 않은 버전보다 p값을 높입니다. 위의 작은 4-1-1-4 표에서 이 조정은 통계량을 3.6에서 1.6으로 낮추는데, 이는 데이터가 적은 표에서 수정되지 않은 검정이 과도하게 유의미하다고 주장하는 것을 방지하기 위한 정확한 수정 방법입니다.
해당 보정값을 기본적으로 적용해야 하는지에 대한 논쟁은 수십 년 동안 지속되었지만 완전히 해결되지 않았으며, 이 가이드에서도 이 문제가 해결되었다고 주장하지는 않을 것입니다. Haviland는 1990년 Statistics in Medicine에 발표한 논문에서 Yates 보정 통계량이 지나치게 보수적이며, 일반 Pearson 카이제곱 검정만으로도 연구자들이 실제로 접하는 대부분의 2×2 분할표에서 제1종 오류를 충분히 제어할 수 있다고 주장했습니다. 그러나 최근 분석에서는 정반대의 결론에 도달했습니다. Prescott는 2021년 Statistics in Medicine에 발표한 논문에서 특히 의학 연구 분야에서는 Fisher 검정의 단측 정확 확률의 두 배 또는 그 근사치인 Yates 보정 카이제곱 검정을 사용하여 2×2 분할표를 검정할 것을 권장합니다. 신중한 통계학자들 사이에서도 의견 차이가 존재하는 상황에서, 가장 안전한 실질적인 방침은 어떤 검정 방법을 사용했는지 명시하고, 분할표의 크기가 작아 검정 방법 선택이 중요할 경우에는 Fisher의 정확 검정을 사용하는 것입니다.
발표된 한 연구 사례는 버전 간 차이가 얼마나 큰지를 보여줍니다. Bewick, Cheek, Ball이 분할표 검정 교육에 사용한 정맥 내 질산염 투여 시험에서 치료군 50명 중 3명, 대조군 45명 중 8명이 사망했습니다. 보정되지 않은 카이제곱 검정은 자유도 1에서 χ² = 3.21(p = 0.073)을 나타냈고, Yates 보정을 적용한 통계량은 2.16(p = 0.141)으로 감소했으며, 단측 확률의 두 배로 계산한 Fisher의 정확 검정은 p = 0.140을 나타냈습니다. 보정되지 않은 버전이 다른 두 버전보다 유의성에 훨씬 더 가깝다는 점이 바로 연구 방법 섹션에서 사용된 버전을 명시해야 하는 이유입니다.

이 분석을 실행하거나 검토받고 싶으신가요? 생물통계학 박사가 연구 설계를 검토하고 분석을 실행하며 논문의 통계 방법론 부분을 작성해 드립니다.
피셔의 정확 검정: 소규모 표본에 대한 대안
로널드 피셔는 1922년 왕립 통계 학회지(Journal of the Royal Statistical Society)에 발표한 논문 에서 피어슨이 20년 전에 도입한 분할표 논리를 기반으로 정확한 접근 방식을 설명했습니다 . 피셔의 정확 검정은 표본 분포를 매끄러운 곡선으로 근사하는 대신, 행과 열의 합계를 고정하고 초하几何 분포를 사용하여 관찰된 표보다 적어도 극단적인 모든 가능한 표의 정확한 확률을 계산합니다. 근사 단계가 없으므로 위에서 설명한 매끄러운 곡선 불일치의 위험이 없으며, 바로 이 때문에 일반 카이제곱 검정이 성립하지 않는 경우에도 정확 검정이 성립하는 것입니다.
Sahai와 Khurshid가 1995년 생물약학 통계 저널(Journal of Biopharmaceutical Statistics)에 발표한 리뷰에서는 이러한 장단점을 자세히 분석하고, 특정 표 구성에서는 정확 검정 자체가 보수적일 수 있으므로 Fisher의 정확 검정으로 전환한다고 해서 자동으로 검정력이 높아지는 것은 아니며, 단지 표본 크기가 작을 때 더 타당한 결과를 얻을 수 있을 뿐이라고 지적합니다. 실용적인 결정 규칙은 위에서 언급한 Cochran의 임계값에서 직접 도출됩니다. 모든 기대 빈도가 5 이상이거나 거의 모든 기대 빈도가 5 이상일 때 일반 카이제곱 검정을 실행하고, 이 조건을 만족하지 못하면 전체 표본 크기가 아무리 커 보여도 Fisher의 정확 검정 으로 전환합니다 . 왜냐하면 전체 표본 크기가 크더라도 불균형 표 내의 희소한 셀 하나를 숨길 수 있기 때문입니다.
역학 분야에서 카이제곱 검정의 실제 적용 사례
발표된 역학 연구에서는 카이제곱 검정을 끊임없이 활용하며, 정교한 모델링을 수행하기 전에 거의 항상 1차 검증 단계로 사용합니다. Hazra와 Gogtay가 인도 피부과학 저널(Indian Journal of Dermatology)에 발표한 생물통계학 튜토리얼에서는 임상 연구자들이 가장 자주 접하는 세 가지 카이제곱 검정으로 Pearson 카이제곱, 쌍을 이루는 이진 데이터에 대한 McNemar 카이제곱, 그리고 층화 표에 대한 Mantel-Haenszel 카이제곱을 제시하고 있으며, 각각 다른 데이터 구조에 적합하고 서로 대체 가능한 옵션은 아니라고 설명합니다.
유전 역학에서는 적합도 검정을 일상적인 품질 관리 단계로 활용합니다. 유전자형 분석 연구는 특정 유전자좌에서 관찰된 유전자형 빈도가 하디-와인버그 평형을 따르는지 여부를 검정하며, 유의미한 편차는 유전자형 분석 오류, 인구 구조의 계층화 또는 실제 선택 압력을 나타내는 경우가 많습니다. 이는 유전학적 방법론에서 하디-와인버그 평형 검정에 대한 장에서 유전적 연관성 연구를 수행하는 연구자들을 위해 자세히 설명하는 부분입니다. 한 게놈 스캔 연구 에서 44개의 마커 유전자좌에 걸쳐 수행된 1자유도 하디-와인버그 평형 검정 결과, 7개의 유전자좌에서 동형접합체가 유의미하게 과잉된 것으로 나타났으며(χ² > 6), 이는 유전자형 분석 오류를 시사하는 패턴입니다. 장애 및 재활(Disability and Rehabilitation) 저널에 게재된 2×2 표에 대한 널리 사용되는 튜토리얼은 유방암 위험 요인 표를 처음부터 끝까지 분석하며, 저널 편집자는 모든 출판 표에 검정 통계량뿐만 아니라 관찰된 셀 개수와 예상된 셀 개수를 모두 요구해야 한다고 주장합니다. 그래야 독자들이 코크란의 임계값이 충족되었는지 스스로 판단할 수 있다는 것입니다.
유전학 분야 외에도 독립성 검정은 질병 상태에 따른 노출을 비교하는 환자-대조군 연구, 인구통계학적 계층에 걸쳐 범주형 결과를 비교하는 횡단면 조사, 환자 하위 그룹 간의 검사 결과를 비교하는 진단 연구 등에서 사용됩니다. 감시 데이터는 계절적 패턴이든 아니든 예상되는 패턴과 비교해야 할 때마다 위에서 설명한 것처럼 적합성 검정을 통해 검증됩니다.
카이제곱 검정 결과 보고 시 흔히 저지르는 실수
제출된 원고와 출판된 논문 모두에서 몇 가지 오류가 반복적으로 나타납니다.
- 개수 대신 백분율을 입력합니다. 카이제곱 공식은 비율이 아닌 빈도를 기반으로 하므로 검정 전에 백분율을 실제 개수로 변환하는 것이 필수적이며 선택 사항이 아닙니다.
- 예상 개수 임계값을 무시합니다. 표에서 5 미만의 값을 갖는 셀이 여러 개 있는 경우, 그 한계를 인지하지 않거나 피셔의 정확 검정으로 전환하지 않고 카이제곱 p값을 발표하는 것은 이 분야에서 가장 쉽게 피할 수 있는 통계적 오류 중 하나입니다.
- 쌍을 이루는 데이터에 독립성 검정을 적용하기. 동일 피험자에 대한 전후 측정 또는 짝지어진 쌍은 독립성 가정을 명백히 위반합니다. 맥네마의 검정 바로 그러한 상황을 위해 존재하는 것입니다.
- 효과 크기를 제시하지 않고 유의성을 보고하는 경우. p값은 연관성이 존재함을 확인시켜 줍니다. 하지만 그 연관성이 임상적으로 중요한 의미를 가질 만큼 충분히 큰지는 별개의 문제입니다. 따라서 크래머의 V, 파이(phi) 또는 다른 통계량을 사용할 수 있습니다. 교차비 모든 카이제곱 결과 옆에 있어야 합니다.
- 자유도를 잘못 이해한 경우. 값이 일치하지 않는 것은 통계 검토자가 쉽게 발견할 수 있으며, 이는 분석 결과가 제출 전에 꼼꼼하게 검토되지 않았음을 나타냅니다.
논문에 카이제곱 검정 결과를 보고하는 방법
보건과학 분야의 대부분 학술지는 동일한 보고 양식을 따릅니다. 검정 이름, 괄호 안에 자유도, 표본 크기, 통계량, p값을 순서대로 기재합니다. 예를 들어, “χ²(1, N = 100) = 9.09, p = .003”과 같이 표기합니다. 그 바로 뒤에 효과 크기를 제시하고, 2×2 분할표의 경우 오즈비 또는 상대 위험도와 신뢰구간을 함께 제시합니다. 유럽 역학 저널(European Journal of Epidemiology)에 발표된 통계적 오해에 대한 널리 알려진 지침서에서는 신뢰구간 추정치 없이 p값만 제시할 경우 독자들이 유의미한 결과를 크거나 중요한 결과로 과대해석할 수 있다고 지적합니다.
결과표에는 백분율뿐만 아니라 모든 셀에 대한 관측값 개수를 표시해야 합니다. 그래야 독자가 직접 검정을 재계산할 수 있습니다. 방법론 섹션에서는 적용된 보정 방법(보정되지 않은 피어슨 상관계수, 예이츠 보정, 피셔의 정확 검정 등)과 사용된 소프트웨어 및 버전을 명시해야 합니다. 카이제곱 검정을 다른 분석 방법과 비교하여 더 광범위한 분석 계획을 세우는 연구자들은 범주형 데이터에 해당하지 않는 원고 부분에 대해 Editverse의 적절한 통계 검정 선택 가이드를 참고하는 것도 도움이 될 수 있습니다.
통계 분석에 전문가의 도움이 필요하신가요?
Editverse의 생물통계학 전문가들은 분할표를 작성하고, 카이제곱 검정과 피셔의 정확 검정 중 적절한 검정 방법을 선택하며, 완벽하게 재현 가능한 R 출력 결과를 통해 논문 게재 준비가 완료된 결과를 제공합니다. 무료 카이제곱 검정 계산기를 사용하여 먼저 계산해 보거나, Just Data Service 를 통해 원시 데이터를 직접 제공하여 전체 분석, 논문 작성 및 학술지 투고 지원을 받으세요.
맺음말
카이제곱 검정을 정확하게 수행하려면 단순히 빈도수를 공식에 대입하는 것 이상의 과정이 필요합니다. 기대 빈도수는 명확하게 설정된 귀무 가설에서 도출되어야 하고, 자유도는 표의 실제 형태와 일치해야 하며, 일반 카이제곱 검정, 예이츠 보정 카이제곱 검정, 피셔의 정확 검정 중 어떤 검정을 선택할지는 습관이 아닌 가장 작은 기대 빈도수의 크기를 기준으로 결정해야 합니다. 위의 두 표는 모든 단계에서 독립적인 통계 소프트웨어와 상호 검증을 거쳤으며, 기대 빈도수가 작아질수록 결과가 얼마나 달라질 수 있는지, 그리고 소프트웨어 출력에서 p값을 복사하여 검증 없이 사용하는 것이 왜 불완전한 정보를 제공하는지 보여줍니다.
이러한 범주형 데이터는 사례-대조 연구, 진단 정확도 논문, 유전자 연관성 연구의 핵심이며, 바로 이러한 이유 때문에 논문 심사자들이 이 특정 검사를 매우 면밀히 검토하는 것입니다. 처음부터 가정을 제대로 세우고 p값과 함께 효과 크기를 보고하면 논문 작성 전에 수정 요청을 방지할 수 있습니다.
분석을 위한 무료 도구
- 그래프프로출판용 차트와 내장된 카이제곱 p값. 무료, 가입 필요 없음.
- 스탯프로범주형 결과에 대한 무료 통계 계산기 및 테스트 선택 도구.
- 플로우차트 프로CONSORT, STROBE 및 PRISMA 흐름도를 브라우저에서 확인하세요.
FAQ
카이제곱 검정은 무엇에 사용되나요?
카이제곱 검정은 관찰된 범주 빈도가 귀무 가설 하에서 예상되는 빈도와 다른지 여부를 확인합니다. 이는 두 범주형 변수 간의 관련성을 검정하는 독립성 검정이거나, 한 변수의 분포가 명시된 패턴과 일치하지 않는지 여부를 검정하는 적합도 검정입니다.
카이제곱 검정 공식은 무엇인가요?
χ² = Σ (O − E)² / E, 여기서 O는 각 셀의 관측값, E는 귀무가설 하에서 해당 셀의 예상값이며, 합계는 표의 모든 셀에 대해 계산됩니다.
카이제곱 검정은 자유도가 몇 개입니까?
분할표는 (행 - 1) × (열 - 1)의 자유도를 가지므로, 2×2 분할표는 정확히 1의 자유도를 가집니다. 적합도 검정은 범주 수에서 1을 뺀 값에 표본에서 추정된 각 매개변수에 대해 1을 더한 값을 자유도로 합니다.
카이제곱 검정 대신 피셔의 정확 검정을 사용해야 하는 경우는 언제일까요?
표의 셀 중 20% 이상이 예상 빈도가 5 미만이거나, 단 하나의 셀이라도 예상 빈도가 1 미만인 경우, 1954년 코크란의 지침에 따라 피셔의 정확 검정으로 전환하십시오.
예이츠 연속성 보정법을 항상 적용해야 할까요?
통계학자들의 의견은 분분합니다. 일부 연구에서는 2×2 분할표의 경우 해당 보정 방법이 지나치게 보수적이라고 지적하는 반면, 최근 연구에서는 특히 의학 연구에 대해 해당 방법이나 그와 동등한 정확도 검정을 권장하고 있습니다. 어떤 버전을 사용했는지 명시하는 것이 보편적인 기본값을 정하는 것보다 더 중요합니다.
카이제곱 독립성 검정과 적합도 검정의 차이점은 무엇인가요?
독립성 검정은 분할표 내에서 두 범주형 변수를 서로 비교하는 것입니다. 적합도 검정은 단일 변수의 관측 분포를 사전에 지정된 분포와 비교하는 것입니다.
카이제곱 검정 결과가 유의미하다는 것은 그 연관성이 얼마나 강한지를 알려주는 것인가요?
아니요. 유의성은 선택된 알파 수준에서 해당 연관성이 우연에 의한 것일 가능성이 낮다는 것을 나타낼 뿐입니다. 강도를 확인하려면 크래머의 V, 파이(phi) 또는 오즈비와 같은 별도의 효과 크기 지표가 필요합니다.
카이제곱 검정을 연속형 데이터에 사용할 수 있나요?
직접적인 방법은 아닙니다. 연속형 변수는 먼저 범주로 분류해야 하는데, 이 과정에서 일부 정보가 손실됩니다. 따라서 결과 변수가 실제로 연속형인 경우에는 t-검정, 분산 분석(ANOVA) 또는 회귀 모델이 일반적으로 더 나은 선택입니다.
참고자료
- Pearson K. 상관관계가 있는 변수 시스템의 경우, 확률에서 벗어난 특정 시스템이 무작위 표본 추출에서 발생했다고 합리적으로 가정할 수 있는 기준에 대하여. 필로스 매그. 1900;50(302):157–175. doi.org/10.1080/14786440009463897
- Fisher RA. 분할표에서 χ²의 해석 및 P의 계산에 관하여. JR 통계학회. 1922;85(1):87–94. doi.org/10.2307/2340521
- Yates F. 소수를 포함하는 분할표와 χ² 검정. Suppl JR Stat Soc. 1934;1(2):217–235. doi.org/10.2307/2983604
- Cochran WG. 일반적인 χ² 검정을 강화하기 위한 몇 가지 방법. 생체 인식. 1954;10(4):417–451. doi.org/10.2307/3001616
- Haviland MG. Yates의 연속성 수정 및 2x2 분할표 분석. 스탯 메드. 1990;9(4):363–367. PMID 2362976
- 프레스콧 RJ. 2x2 분할표에 대한 양측 유의성 검정. 대립 가설은 무엇입니까? 스탯 메드. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. 2x2 분할표를 이용한 역학 데이터 분석, Fisher의 정확 검정 및 연속성 보정을 위한 Yates의 수정에 대한 개요. J 바이오팜 통계. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. 생물통계학 시리즈 모듈 4, 그룹 비교, 범주형 변수. 인디언 J 더마톨. 2016;61(4):385–392. PMID 27512183
- Wang J, Shete S. 하디-와인버그 평형에서 벗어나는 현상 검증. Mol Biol 방법. 2012;850:77–102. PMID 22307695
- Rigby AS. 역학에서의 통계적 방법. VII. 2 x 2 분할표 분석을 위한 카이제곱 검정 개요. 장애인 재활. 2002;23(16):693–697. PMID 11732558
- Greenland S, Senn SJ, Rothman KJ 외. 통계 검정, P값, 신뢰구간 및 검정력: 오해를 방지하기 위한 안내서. 유럽 역학 저널. 2016;31(4):337–350. PMID 27209009
- 리커버리 협력 그룹. 코로나19로 입원한 환자에게 덱사메타손 투여. N Engl J 메드. 2021;384(8):693–704. doi.org/10.1056/NEJMoa2021436
- Bewick V, Cheek L, Ball J. 통계 검토 8: 질적 데이터, 연관성 검정. 중환자 치료. 2004;8(1):46–53. PMID 14975045
- 맥휴 ML. 카이제곱 독립성 검정. 바이오켐 메드. 2013;23(2):143–149. PMID 23894860
- Gomes I, Collins A, Lonjou C, et al. Hardy-Weinberg 품질 관리. 앤 험 제넷. 1999;63(6):535–538. PMID 11246455