
발행 | 최종 업데이트:
역학자들은 연구 사례 수가 너무 적어 표준 빈도 주의적 도구가 제대로 작동하지 않을 때, 이전 연구에서 이미 특정 매개변수에 대한 타당한 범위를 제시했을 때, 또는 수백 개의 작은 지역에 걸쳐 질병 위험을 한 번에 매핑해야 할 때 베이지안 방법을 점점 더 많이 활용합니다. 베이지안 분석은 단일 점 추정치와 p값을 산출하는 대신, 매개변수에 대해 이미 알려진 정보와 새로운 연구 데이터를 결합하여 해당 매개변수에 대한 완전한 확률 분포를 제시합니다. 이 글에서는 베이지안 분석의 작동 방식, 복잡성을 더함으로써 효과를 발휘하는 구체적인 역학적 문제, 연구자들이 이를 실행하는 데 사용하는 소프트웨어, 그리고 218개의 실제 지역사회에 이 접근 방식을 적용한 암 감시 연구 사례를 살펴봅니다.
베이지안 방법이 역학에 가져다주는 이점은 무엇일까요?
20세기 대부분 동안 의학 연구는 빈도주의 통계학에 의해 지배되었는데, 이는 p값, 신뢰구간, 그리고 현재 데이터셋 외에는 어떤 것도 사용하지 않는다는 엄격한 규칙을 중심으로 구축되었습니다. 2024년 란셋(Lancet) 에 발표된 골리거(Goligher), 히스(Heath), 하헤이(Harhay)의 방법론 리뷰 에서 설명된 임상 연구를 위한 베이지안 통계학은 확률을 장기적인 빈도가 아닌 믿음의 강도를 나타내는 척도로 취급합니다. 이를 통해 연구에서는 사전 정보와 새로운 데이터를 공식적으로 결합하여 관심 있는 모든 양에 대한 업데이트된, 즉 사후 확률 분포를 생성할 수 있습니다. 현대 컴퓨팅 기술은 이러한 접근 방식의 주요 실질적인 장벽을 제거했습니다. 한때 특수 하드웨어가 필요했던 시뮬레이션 기반 추정은 이제 노트북에서도 실행 가능하며, 이는 베이지안 방법이 지난 20년 동안 소수 통계 철학에서 암 감시, 약물 감시, 질병 발생 모델링 등 다양한 분야에서 일상적으로 사용되는 주요 이유 중 하나입니다.
베이즈 정리와 믿음 업데이트의 논리
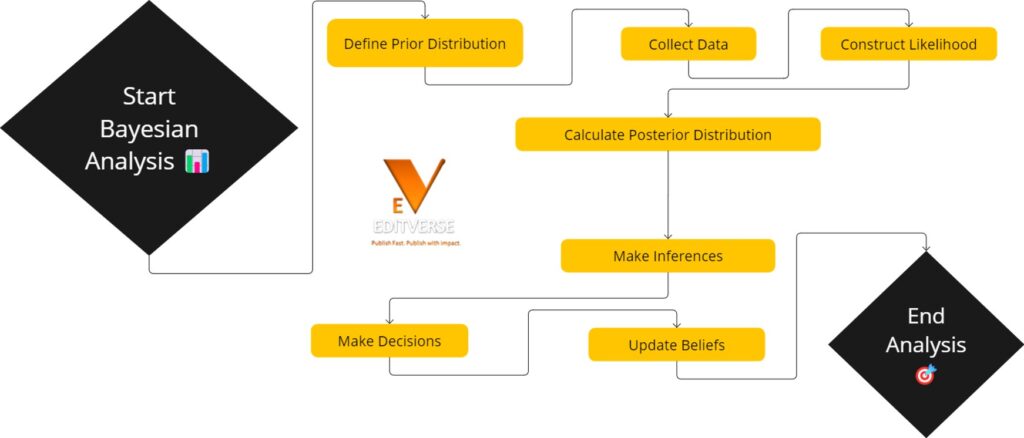
모든 베이지안 모델은 동일한 방정식에 기반합니다. 베이즈 정리는 데이터가 주어졌을 때 모수의 사후 확률이 해당 모수가 주어졌을 때 데이터의 가능도에 모수 자체의 사전 확률을 곱한 값에 비례한다는 것을 나타냅니다. 모수 θ와 관측 데이터 X에 대해 표현하면, 이 관계는 P(θ|X) ∝ P(X|θ) × P(θ)입니다. 여기에는 세 가지 요소가 핵심적인 역할을 합니다. 사전 확률 P(θ)는 현재 연구가 수행되기 전에 모수에 대해 이미 알려져 있거나 합리적으로 가정된 값을 나타냅니다. 가능도 P(X|θ)는 모수의 다양한 후보 값에서 관측 데이터가 나타날 확률을 나타냅니다. 사후 확률 P(θ|X)는 이 두 가지를 결합하여 얻은 업데이트된 분포이며, 베이지안 역학자가 실제로 보고하고 해석하는 대상이 됩니다.
베이즈 정리 자체는 현대 역학보다 250세기 앞서 존재했습니다. 베이즈 정리는 토머스 베이즈라는 목사의 이름을 따서 지어졌지만, 그는 이 결과를 직접 발표하지는 않았습니다. 이 정리가 담긴 논문은 철학자 리처드 프라이스가 1763년 사후에 왕립학회에서 낭독했는데, 이는 2014년 마르티네스와 아크카르가 《카데르노스 데 사우데 퍼블리카 》에 발표한 역사적 고찰에서 중요한 이정표 로 여겨졌습니다. 이후 2013세기 동안 빈도주의적 방법론은 베이즈 접근법을 응용 통계학의 변두리로 밀어냈고, 마르코프 체인 몬테카를로 계산법이 복잡한 사후 확률 분포를 다룰 수 있게 되면서 비로소 역학 연구에서 다시 일상적으로 사용되기 시작했습니다.
실제 적용에서의 사전확률, 가능성, 사후확률
전체 데이터셋 없이도 작동 원리를 보여주는 예시를 들어보겠습니다. 보건부가 지역 검사가 시작되기 전에 특정 지역에서 새로 확인된 병원체의 유병률을 추정하고 싶다고 가정해 봅시다. 국가 감시 결과에 따르면 유병률은 약 4% 정도이지만 불확실성이 크기 때문에, 보건부는 이 추정치를 베타(4, 96) 사전 분포로 인코딩합니다. 이 분포는 4%를 중심으로 하면서도 1% 미만부터 10% 이상까지의 값을 허용합니다. 그 후 지역 주민 200명을 대상으로 설문 조사를 실시한 결과 14명의 양성 사례가 확인되었습니다. 베타 분포는 이항 가능도에 대한 켤레 사전 분포이므로, 사후 분포는 또 다른 베타 분포인 베타(4 + 14, 96 + 186)이 됩니다. 이는 베타(18, 282) 분포로 계산되며, 국가 사전 분포와 지역 데이터가 각각 담고 있는 정보의 양에 비례하여 약 6%의 사후 유병률 추정치를 중심으로 합니다. 해당 수치는 예시적인 것이며, 특정 발병 사례에서 가져온 것이 아니라, 사전 확률과 가능도가 산술적으로 결합되어 사후 확률을 어떻게 생성하는지 보여주기 위해 선택된 것입니다.
| 기간 | 그것이 나타내는 것 | 역학적 사례 |
|---|---|---|
| 사전 배포 | 본 연구의 데이터를 보기 전 특정 변수에 대한 믿음 | 이전 전국 조사에서 얻은 지역별 유병률 추정치 |
| 가능성 함수 | 서로 다른 매개변수 값에서 관측 데이터의 확률 | 실제 유병률을 고려했을 때 200건의 검사 중 14건에서 양성 반응이 나타날 확률 |
| 후방 분포 | 사전 확률과 가능성을 결합한 후 업데이트된 믿음 | 지역 조사 후 수정된 지역별 유병률 추정치 |
| 신뢰 구간 | 명시된 사후 확률을 갖는 매개변수를 포함하는 범위 | 해당 지역의 실제 유병률에 대한 95% 신뢰 구간 |
| 켤레 전치 | 주어진 가능도와 결합했을 때 동일한 계열의 사후 확률을 생성하는 사전 확률 | 비율에 대한 이항 가능도와 결합된 베타 사전 확률 |
| 마르코프 체인 몬테카를로 | 폐쇄형 해법이 없는 사후확률로부터 샘플링하기 위한 시뮬레이션 방법 | 수백 개의 매개변수를 사용하여 공간 질병 지도 모델을 추정합니다. |
신뢰구간과 확신구간의 차이점
연구자들은 95% 신뢰구간의 의미를 잘못 해석하는 경우가 많은데, 이를 참값이 특정 계산된 범위 안에 포함될 확률이 95%라는 의미로 받아들이는 것입니다. 신뢰구간은 단지 여러 번 반복된 연구를 통해 이러한 방식으로 구성된 구간의 95%가 참값을 포함한다는 것을 보장할 뿐이며, 이는 특정 구간 자체가 아니라 절차에 대한 설명입니다. 베이지안 신뢰구간은 사람들이 신뢰구간에 바라는 바를 정확하게 표현합니다. 즉, 관측된 데이터와 선택된 사전확률을 고려할 때, 모수가 명시된 범위 안에 있을 사후확률이 95%라는 것을 의미합니다. Goligher, Heath, Harhay의 2024년 Lancet 논문은 이러한 차이점을 두 프레임워크 간의 실질적으로 중요한 차이점 중 하나로 지적하며, 이는 신뢰구간을 임상의, 학술지 편집자, 정책 입안자에게 설명하는 방식을 근본적으로 바꾸기 때문입니다.
역학자들이 베이지안 방법을 선택하는 이유
소규모 표본은 베이지안 접근 방식의 가장 명확한 적용 사례를 보여줍니다. Xie, Rolka, Barker는 2025년 Journal of Data Science 에 발표한 분석에서 베이지안 계층적 표본 추출 가중치를 적용한 영과잉 모델을 사용하여 카운티 수준의 희귀 질환 유병률을 모델링했습니다. 이는 많은 카운티에서 표준 설문 조사 기반 추정으로는 안정적인 결과를 얻기에 관찰 사례 수가 너무 적었기 때문입니다. 소아 질환 및 희귀 질환 임상 시험도 이와 유사한 문제에 직면해 있으며, Turner와 동료들은 2022년 BMC Medical Research Methodology 에 발표한 방법론 논문 에서 베이지안 계층적 모델을 사용하여 소아 HIV 임상 시험에서 환자 하위 그룹 간 정보를 활용하는 방법을 설명했습니다. 이를 통해 소규모 하위 그룹의 추정치가 소수의 참가자에만 의존하는 것이 아니라 관련 하위 그룹으로부터 통계적 강도를 확보할 수 있었습니다. 베이지안 모델은 모든 그룹 수준 매개변수가 개별적으로 추정되는 것이 아니라 공유된 모집단 수준 분포에서 추출되기 때문에 이러한 부분적 정보 통합을 자연스럽게 처리합니다.
진정한 사전 증거를 통합하는 것은 소규모 표본을 다루는 것만큼이나 중요합니다. 체계적 문헌 검토, 이전 연구 또는 잘 확립된 지역 기준선이 이미 매개변수의 예상 범위를 정해 놓은 경우, 베이지안 분석을 통해 해당 정보를 공식적으로 활용할 수 있습니다. 이는 기존 정보를 버리고 백지 상태에서 모든 것을 재추정하는 것보다 훨씬 효율적이며, 역학자들이 비공식적으로 추론하는 방식과도 유사합니다.
중첩된 인구 데이터에 대한 계층적 및 다단계 모델
공중 보건 데이터는 단일 수준에 머무르는 경우가 드뭅니다. 환자는 진료소에, 진료소는 지역에, 지역은 국가에 모여 있으며, 이러한 구조의 각 수준은 고유한 변동 요인을 가지고 있습니다. 계층적 또는 다단계 베이지안 모델은 모든 수준을 명시적으로 표현하여, 개별 진료소나 지역의 매개변수가 모든 그룹에 단일 고정 효과를 적용하거나, 반대로 모든 그룹을 완전히 독립적으로 추정하는 대신, 공유된 상위 수준 분포를 중심으로 변동하도록 합니다. 소규모 또는 특이한 그룹에 대한 추정치는 해당 지역 데이터의 부족 정도에 비례하여 전체 평균으로 수렴(축소)되는 반면, 데이터가 풍부한 그룹은 대부분 자체적인 특성을 나타냅니다. 바로 이러한 축소 덕분에 터너와 그의 동료들은 기존 방법으로는 개별 하위 그룹을 분석하기에는 너무 작은 규모의 소아 임상 시험에서 유용한 하위 그룹별 치료 효과 추정치를 도출할 수 있었습니다. 중첩된 의료 데이터에 대한 다단계 모델링 에 관한 관련 가이드에서는 이 접근 방식의 고정 효과 및 무작위 효과 메커니즘을 더 자세히 다룹니다.
베이지안 질병 지도 작성 및 소규모 지역 추정
수많은 소규모 지리적 영역에 걸쳐 질병 위험을 지도화하는 것은 역학에서 베이지안 방법이 더 간단한 대안보다 일관되게 우수한 성능을 보이는 분야 중 하나입니다. 소규모 지역의 원시 질병 발생률은 매우 불안정한 것으로 악명 높습니다. 예를 들어 인구 3,000명의 작은 마을에서는 한 해에 두세 건의 추가 사례만으로도 발생률이 크게 변동할 수 있습니다. 베사그-요크-몰리에(BYM) 모델은 이러한 문제를 해결하기 위해 비구조화된 무작위 효과와 지리적으로 인접한 지역의 영향을 받는 공간적으로 구조화된 효과를 결합합니다. 이를 통해 노이즈를 완화하면서도 위험도가 높거나 낮은 실제 공간적 클러스터를 유지합니다. 통계학자 앤드류 겔만과 공동 저자들은 2020년 Spatial and Spatio-temporal Epidemiology 저널에 Stan 확률 프로그래밍 언어로 구현된 BYM 모델의 완벽한 작동 버전을 발표하여 , 원래 이 방법을 구현하는 데 필요했던 특수 소프트웨어보다 응용 역학자들이 훨씬 더 쉽게 접근할 수 있도록 했습니다. Catelan, Lagazio, 그리고 Biggeri는 이전 연구에서 1995 년부터 1999년까지 이탈리아 토스카나 지방 287개 지자체의 폐암 사망률을 분석하기 위해 3단계 계층적 베이지안 모델을 구축했습니다. 이 모델은 사후 분류 확률을 사용하여 위험도가 실제로 높은 지역을 식별하는 동시에 수백 개의 작은 지역을 동시에 비교할 때 발생하는 다중 검정 문제를 해결했습니다. 공간적 및 환경적 위험 요인은 이러한 모델링과 상호 작용하며, 이는 공중 보건 분야의 환경 및 공간 통계 에 관한 관련 논문에서 더 자세히 다룹니다.
실제 사례: 브리티시컬럼비아주 소규모 지역 암 지도 작성
BC 암센터의 Simkin 연구팀이 2022년 Frontiers in Oncology 에 발표한 연구 는 시뮬레이션이 아닌 실제 감시 데이터에 전체 워크플로우를 적용한 사례를 보여줍니다. 연구팀은 BC 암 등록소에서 2011년부터 2018년까지 브리티시컬럼비아 주민들에게 진단된 폐암, 여성 유방암, 자궁경부암, 대장암 발생 사례를 추출한 후, 수정된 BYM2 모델을 사용하여 218개 지역 보건 서비스 구역(Community Health Service Area)에 걸쳐 위험도를 매핑했습니다. 간접 연령 표준화를 통해 각 지역의 예상 발생 건수와 표준화 발생률을 주 전체 발생률 대비 비율로 산출했으며, 모란의 I 지수는 인접 지역 간 위험 수준이 얼마나 유사한지를 정량화했습니다. 또한 BYM2 모델 자체는 모든 지역에 대해 전체 신뢰 구간을 포함하는 사후 중앙값 상대 위험도를 생성하여 불안정한 소규모 지역 발생 건수를 평활화하는 동시에 실제 지역적 집단 발생을 식별했습니다.
| 암 유형 | 사건 발생 건수, 2011-2018 | 지리적 단위 |
|---|---|---|
| 폐 | 26,448 | 218개 지역사회 보건 서비스 지역 |
| 여성의 가슴 | 28,466 | |
| 경부의 | 1,478 | |
| 대장 | 25,457 |
이 연구의 실질적인 성과는 정확성뿐만 아니라 접근성에도 있었습니다. 심킨과 동료들은 전체 모델링 및 매핑 워크플로를 오픈 소스 smallareamapp R 패키지로 만들었는데, 그 이유는 암 등록 기관 전반에 걸쳐 이러한 방법을 수행할 수 있는 기술적 역량이 여전히 제한적이기 때문이며, 재현 가능한 도구를 통해 다른 주 및 지방 등록 기관들이 자체 데이터에 대해 동일한 분석을 수행하는 데 대한 장벽을 낮출 수 있기 때문입니다.
질병 감시 및 신호 탐지에 있어서 베이지안 방법론
약물감시 분야는 '베이지안'이라는 용어가 일반 역학에서 널리 사용되기 훨씬 이전부터 베이지안 신호 탐지 기법을 도입해 왔습니다. 2009년 Bate와 Evans가 Pharmacoepidemiology and Drug Safety 에 발표한 방법론 검토 논문에서는 규제 기관이 자발적인 약물 부작용 보고를 검토할 때 경험적 베이즈 기하평균과 같은 경험적 베이즈 방법을 사용하는 방식을 설명했습니다. 이 방법은 보고 건수가 적은 약물-부작용 쌍에 대해 잡음이 많은 원시 보고 비율을 보다 보수적인 추정치로 축소하여, 분석가가 드물지만 실제 안전성 신호를 무시하지 않고도 오경보를 줄입니다. 암 감시 분야에서도 인구 수준에서 유사한 추세가 나타납니다. Wah, Ahern, Earnest가 International Journal of Public Health 에 발표한 체계적 문헌 검토에서는 2014년부터 2018년까지 발표된 38개의 연구에서 암 발생률 및 사망률 데이터에 완전 베이지안 시공간 모델을 적용한 것을 확인했습니다. 이는 약물감시 신호 탐지에 사용되는 것과 동일한 축소 논리가 이제 암 등록 기관에서 장소와 시간에 따른 암 위험 변화를 추적하는 데에도 적용되고 있음을 보여주는 증거입니다.
베이지안 역학 소프트웨어
오늘날 응용 베이지안 역학 연구에서 주로 사용되는 플랫폼은 네 가지입니다. Stan은 해밀턴 몬테카를로 샘플링을 실행하며, Gelman과 공저자들이 발표한 BYM 질병 지도 작성 구현의 기반이 됩니다. Stan은 대규모 계층적 및 공간적 모델을 효율적으로 처리하여 일상적인 레지스트리 규모 연구에 적합합니다. JAGS는 오래되었지만 여전히 널리 사용되는 엔진으로, 깁스 샘플링을 사용하며 역학 강의 및 기존 분석 코드에서 흔히 볼 수 있습니다. WinBUGS는 1990년대에 역학자를 위한 접근성 높은 MCMC 소프트웨어를 개척했으며, 대부분의 활발한 프로젝트가 Stan 또는 JAGS로 이전되었지만, 오래된 연구 논문에서 여전히 간혹 찾아볼 수 있습니다. Paul-Christian Bürkner가 개발하고 2021년 British Journal of Mathematical and Statistical Psychology 에 발표된 논문에서 순서형 회귀 모델에 대한 적용 사례가 제시된 R 패키지 brms는 연구자들이 익숙한 R 회귀 공식 구문을 사용하여 Stan 모델을 지정할 수 있도록 해줍니다. 이를 통해 확률 프로그래밍 배경 지식이 없는 역학자도 완전한 베이지안 계층적 모델링을 수행할 수 있게 되었습니다. 베이지안 조정이 결과에 어떤 영향을 미치는지 등 회귀 분석 접근 방식의 비교는 의학 연구의 회귀 모델 에 관한 관련 기사에서 다룹니다.
마르코프 체인 몬테카를로 및 수렴 검사
폐쇄형 사후 분포는 소수의 단순 모델에서만 존재하므로, 대부분의 응용 베이지안 역학은 마르코프 체인 몬테카를로(MCMC) 알고리즘에 의존합니다. MCMC는 목표 사후 분포로 수렴하도록 구성된 마르코프 체인에서 상관 관계가 있는 표본을 추출하는 알고리즘 계열입니다. 일반적으로 최소 3~4개의 독립적인 체인을 서로 다른 시작 값에서 실행하는 것이 일반적입니다. 서로 다른 시작점에서 유사한 결과를 도출하는 체인은 수렴의 직접적인 증거를 제공하는 반면, 체인 간의 불일치는 분석가가 보고된 추정치를 신뢰하기 전에 해결해야 할 문제를 나타냅니다. 분석가는 일반적으로 초기 웜업 단계를 제외하고, 추적 플롯, R-hat이라고도 하는 잠재적 규모 감소 통계량, 그리고 유효 표본 크기를 검토하여 체인이 사후 분포를 충분히 탐색했는지, 그리고 결과 추정치가 보고할 만큼 충분히 정확한지 판단합니다. 질병 지도 작성에 사용되는 것과 같은 복잡한 계층적 및 공간적 모델은 단순 회귀 모델보다 혼합 속도 저하 및 수렴 문제에 더 취약하므로, 수렴 진단은 논문의 방법론 섹션에서 모델 사양 자체만큼이나 중요한 비중을 차지해야 합니다.
베이지안 역학 보고의 일반적인 함정
베이지안 문헌의 일부 영역에서는 엄격한 보고보다 채택이 훨씬 빠르게 진행되고 있습니다. Marks와 동료들이 2026년 BMC Medical Research Methodology 에 발표한 체계적 문헌 고찰 에서는 발표된 베이지안 무작위 임상시험의 표본 크기 결정 방식을 분석한 결과, 이론적으로 인기가 높은 베이지안 방법론이 실제 적용에서는 제대로 활용되지 않는 경우가 많으며, 많은 시험에서 베이지안 용어를 차용하면서도 근본적으로는 빈도주의적 설계를 고수하고 있음을 발견했습니다. 제출된 논문에서 반복적으로 나타나는 세 가지 실질적인 문제점은 다음과 같습니다. 첫째, 대안적이고 합리적인 사전 확률에 대한 민감도 분석이 보고되지 않아 독자들이 선택된 사전 확률이 결론에 얼마나 영향을 미쳤는지 판단할 수 없습니다. 둘째, MCMC 체인의 수렴 진단이 완전히 생략되는 경우가 많은데, 제대로 혼합되지 않은 체인은 그럴듯해 보이지만 잘못된 사후 확률 분포를 생성할 수 있습니다. 셋째, 모호하고 정보가 부족한 사전 확률이 "객관적"이라고 재분류되는 경우가 있는데, 이는 진정으로 균일한 사전 확률 분포조차도 소규모 표본 환경에서 결과에 의미 있는 영향을 미칠 수 있다는 점을 간과하는 것입니다. 바로 이러한 소규모 표본 환경에서 연구자들은 베이지안 방법을 활용하고자 합니다. 학술지 통계 심사자는 베이지안 분석을 수락하기 전에 이 세 가지 사항을 모두 확인하며, 이러한 사항들을 사전에 다룬 원고는 주요 수정 요청이 훨씬 적게 나오는 상태로 동료 심사를 통과합니다.
Editverse 통계 전문가들이 베이지안 역학 프로젝트를 지원하는 방법
적절한 사전 확률을 지정하고, 연구의 실제 데이터 구조에 맞는 계층적 또는 공간적 모델을 구축하고, MCMC 수렴 문제를 진단하는 데에는 모두 실무적인 베이지안 모델링 경험이 필요하지만, 많은 논문들이 이러한 경험 없이 동료 심사를 통과합니다. Editverse의 생물통계학 팀은 역학 연구자들과 직접 협력하여 사전 확률 지정, Stan 및 brms 모델 코드 작성, 수렴 진단, 그리고 베이지안 통계학적 엄밀성을 요구하는 저널의 통계 심사위원들의 기준을 충족하는 방법론 작성을 지원합니다. Editverse의 원고 및 통계 분석 서비스는 초기 모델 지정부터 최종 제출 논문에 이르기까지 이러한 모든 과정을 지원하며, 무료 통계 검정 선택 도구 는 베이지안 접근 방식과 기존 빈도주의 검정 중 어느 것이 주어진 데이터 세트에 더 적합한지 결정하기 전에 확인할 수 있는 유용한 출발점입니다.

베이지안 및 역학 방법 관련 자료
- 초보자를 위한 의학 연구를 지원하는 베이지안 통계 핵심 아이디어들을 좀 더 부드럽게 처음 접해볼 수 있도록 하기 위해서입니다.
- 실제에서의 베이지안 분석: 적응형 임상 시험 사례 연구 이러한 도구들이 감시보다는 임상시험 설계를 어떻게 변화시키는지에 대해서만 살펴보겠습니다.
- 인과 추론이 역학 및 공중 보건에 미치는 영향 베이지안 프레임워크와 인과적 프레임워크가 어떻게 교차하는지에 대하여.
- 감염병 데이터 분석을 위한 고급 모델 비선형 및 구획 모델에 적용되며, 이러한 모델은 종종 베이지안 추정법과 함께 사용됩니다.
- 전력 분석을 쉽게 알아보세요 빈도주의적 설계와 베이지안 설계 간의 표본 크기 계획 차이점에 대하여.
- Kaplan-Meier 생존 분석 종양학 데이터에서 베이지안 생존 모델링에 대한 빈도주의적 대응 모델을 의미합니다.
자주 묻는 질문
베이지안 역학과 빈도주의 역학의 주요한 실질적인 차이점은 무엇인가요?
빈도주의적 분석은 현재 연구의 데이터만을 이용하여 점추정치, p값, 신뢰구간을 산출합니다. 베이지안 분석은 해당 데이터에 기존 지식을 반영한 사전분포를 결합하여, 모수 자체에 대한 확률적 진술로 직접 해석할 수 있는 완전한 사후분포와 신뢰구간을 제시합니다.
역학 연구에서 베이지안 접근법이 가장 큰 차이를 만들어내는 경우는 언제일까요?
소규모 또는 희귀 질환 샘플, 여러 지리적 단위에 걸친 소규모 지역 질병 지도 작성, 그리고 더 큰 지역 내에 진료소 또는 지역구가 포함된 계층적 데이터는 베이지안 계층적 모델이 기존의 고정 효과 접근 방식보다 가장 뚜렷하게 우수한 성능을 보이는 환경입니다. 이는 주로 베이지안 모델이 관련 그룹 간에 부분적으로 데이터를 통합하기 때문입니다.
95% 신뢰구간은 95% 확신구간과 같은 것인가요?
아니요. 신뢰구간은 주어진 데이터와 선택된 사전확률을 고려했을 때, 실제 모수가 해당 구간 내에 있을 사후 확률이 95%임을 나타냅니다. 반면 신뢰구간은 동일한 방식으로 반복 연구를 통해 구축된 구간 중 95%가 실제 값을 포함한다는 것을 보장할 뿐이며, 이는 특정 구간 자체에 대한 설명이 아니라 장기적인 연구 절차에 대한 설명입니다.
역학자들은 베이지안 모델을 실행하기 위해 어떤 소프트웨어를 사용하나요?
Stan과 R 패키지 brms는 현재 대부분의 작업을 처리하고, JAGS는 교육 및 기존 코드에서 여전히 널리 사용되며, WinBUGS는 1990년대에 이 분야를 개척했지만 Stan과 같은 더 빠르고 유연한 도구로 대부분 대체되었습니다.
베이지안 분석이 유용하려면 많은 양의 사전 데이터가 필요한가요?
아니요. 연구에서는 의도적으로 약하고 최소한의 정보만 제공하는 사전 확률을 사용하고 관측 데이터가 사후 확률 분포를 지배하도록 할 수 있습니다. 이는 강력한 사전 증거가 없을 때 흔히 사용되는 방법입니다. 이러한 접근 방식은 약한 사전 확률을 사용하더라도 완전한 사후 확률 분포와 유효한 신뢰 구간을 제공합니다.
심사위원들은 제출된 논문의 베이지안 분석을 어떻게 평가하나요?
통계적 검토자는 일반적으로 선택된 사전 분포가 타당한지, 민감도 분석을 통해 그 영향이 검증되었는지, R-hat 및 유효 표본 크기와 같은 MCMC 수렴 진단 결과가 보고되었는지, 그리고 논문에서 신뢰 구간을 빈도주의적 용어(신뢰 구간에서 차용한 용어)로 설명하는 대신 정확하게 해석했는지 등을 확인합니다.