Diterbitkan | Terakhir diperbarui
Uji chi -kuadrat menjawab satu pertanyaan spesifik. Apakah jumlah yang diamati di seluruh kategori berbeda dari apa yang diprediksi oleh independensi, atau model yang dinyatakan? Karl Pearson memperkenalkan uji ini pada tahun 1900 , dan para ahli epidemiologi masih menjalankannya setiap minggu untuk membandingkan tingkat paparan antar kelompok, menyaring data genotipe untuk kesalahan, dan memeriksa apakah kemunculan penyakit berkelompok berdasarkan musim daripada menyebar secara merata sepanjang tahun. Panduan yang bersaing tentang topik ini cenderung hanya menyatakan ulang rumus dan berhenti di situ. Di sini, dua tabel kontingensi dikerjakan secara manual, setiap angka diperiksa terhadap perangkat lunak statistik independen, dan panduan ini menjelaskan secara tepat kapan perkiraan chi-kuadrat berhenti dapat dipercaya sehingga uji eksak Fisher harus digunakan sebagai gantinya.
Ringkasan Utama
- A uji chi-square membandingkan jumlah kategori yang diamati dengan jumlah yang diharapkan berdasarkan model nol, menggunakan statistik χ² = Σ(O − E)² / E.
- The uji chi kuadrat independensi memeriksa apakah dua variabel kategorikal saling berhubungan; tes kesesuaian memeriksa apakah distribusi suatu variabel sesuai dengan pola yang dihipotesiskan.
- Derajat kebebasan Untuk tabel kontingensi, nilainya sama dengan (baris − 1) × (kolom − 1); untuk uji kecocokan, nilainya sama dengan jumlah kategori dikurangi 1, dikurangi parameter apa pun yang diestimasi dari data.
- Pedoman Cochran tahun 1954 menyatakan bahwa tidak lebih dari 20% sel seharusnya memiliki jumlah yang diharapkan di bawah 5, dan tidak ada sel yang seharusnya berada di bawah 1. Melanggar batasan itu dan Uji eksak Fisher menjadi pilihan yang lebih aman.
- Hasil chi-square yang signifikan menunjukkan adanya hubungan. Kekuatan hubungan adalah pertanyaan terpisah, yang dijawab dengan rasio odds, risiko relatif, atau Cramér's V, bukan hanya nilai p saja.
Dalam Kata Sederhana
Bayangkan dua kelompok pasien, satu diobati dan satu tidak, dengan hasil ya atau tidak, misalnya sembuh. Uji chi-square menanyakan apakah pemulihan tampak sama di kedua kelompok atau benar-benar berbeda. Uji ini membuat tabel kecil berisi jumlah, menghitung seperti apa jumlah tersebut jika pengobatan tidak memberikan perbedaan sama sekali, dan mengukur seberapa jauh jumlah sebenarnya menyimpang dari gambaran tanpa perbedaan tersebut. Kesenjangan yang lebar antara jumlah sebenarnya dan yang diharapkan menghasilkan nilai p yang kecil dan menunjukkan adanya hubungan nyata antara pengobatan dan hasil. Kesenjangan yang sempit berarti pola pada tabel tersebut kemungkinan besar hanya kebetulan.
Dua hal penting perlu diperhatikan sebelum mempercayai hasilnya. Setiap kategori harus benar-benar terpisah, karena pasien yang sama tidak dapat dihitung dua kali, dan jumlah yang diharapkan di sebagian besar sel harus mencapai setidaknya 5. Sampel kecil memerlukan uji eksak Fisher , yang akan dibahas lebih lanjut dalam panduan ini.
Apa itu Uji Chi-Square?
Para ahli statistik mengelompokkan prosedur chi-square ke dalam satu keluarga yang memiliki satu ciri yang sama. Setiap statistik uji mengikuti distribusi chi-square ketika hipotesis nol benar dan ukuran sampel memadai. Dua anggota keluarga tersebut mencakup hampir setiap kasus penggunaan yang ditemui peneliti dalam praktik. Uji chi-square independensi mengambil dua variabel kategorikal yang diukur pada subjek yang sama, seperti kelompok perlakuan dan hasil klinis, dan menanyakan apakah nilai salah satunya memprediksi nilai yang lain. Uji chi-square goodness-of-fit mengambil satu variabel kategorikal dan menanyakan apakah distribusi yang diamati sesuai dengan distribusi yang ditentukan sebelumnya, seperti pembagian yang merata di empat musim atau rasio genetik Mendel.
Memilih di antara kedua metode ini, dan antara uji chi-square dan uji yang sama sekali berbeda, bergantung pada bagaimana data dikumpulkan dan pertanyaan apa yang diajukan. Pembaca yang masih mempertimbangkan apakah uji chi-square merupakan jenis uji yang tepat untuk data mereka dapat menggunakan fitur pemilihan uji interaktif Editverse atau diagram alur uji statistik sebelum melanjutkan.
Kedua versi uji chi-square menggunakan statistik yang sama.
χ² = Σ (O − E)² / E
O mewakili jumlah yang diamati dalam suatu kategori atau sel, E mewakili jumlah yang diharapkan di bawah hipotesis nol, dan jumlahnya mencakup setiap sel dalam tabel. Mengkuadratkan selisih tersebut menghilangkan tanda sehingga jumlah yang melebihi dan kurang dari jumlah sebenarnya akan mendorong statistik ke atas, dan membagi dengan E akan menyesuaikan setiap selisih kuadrat terhadap jumlah yang sebenarnya diharapkan di sana. Sebuah sel yang diharapkan menampung 200 pengamatan dapat menyerap selisih 10 tanpa banyak masalah. Sebuah sel yang diharapkan menampung 5 tidak dapat, dan pembagian dengan E mencerminkan hal itu secara langsung.
Cara Menghitung Statistik Uji Chi-Kuadrat
Frekuensi yang diharapkan berasal dari hipotesis nol, bukan dari angka bulat yang dipilih untuk kemudahan. Dalam tabel kontingensi, jumlah yang diharapkan untuk setiap sel sama dengan total barisnya dikalikan dengan total kolomnya, dibagi dengan total keseluruhan. Rumus tersebut mengikuti langsung dari asumsi independensi. Jika dua variabel benar-benar tidak berhubungan satu sama lain, proporsi kolom yang berada di baris tertentu harus sesuai dengan bagian keseluruhan baris tersebut dalam seluruh tabel.
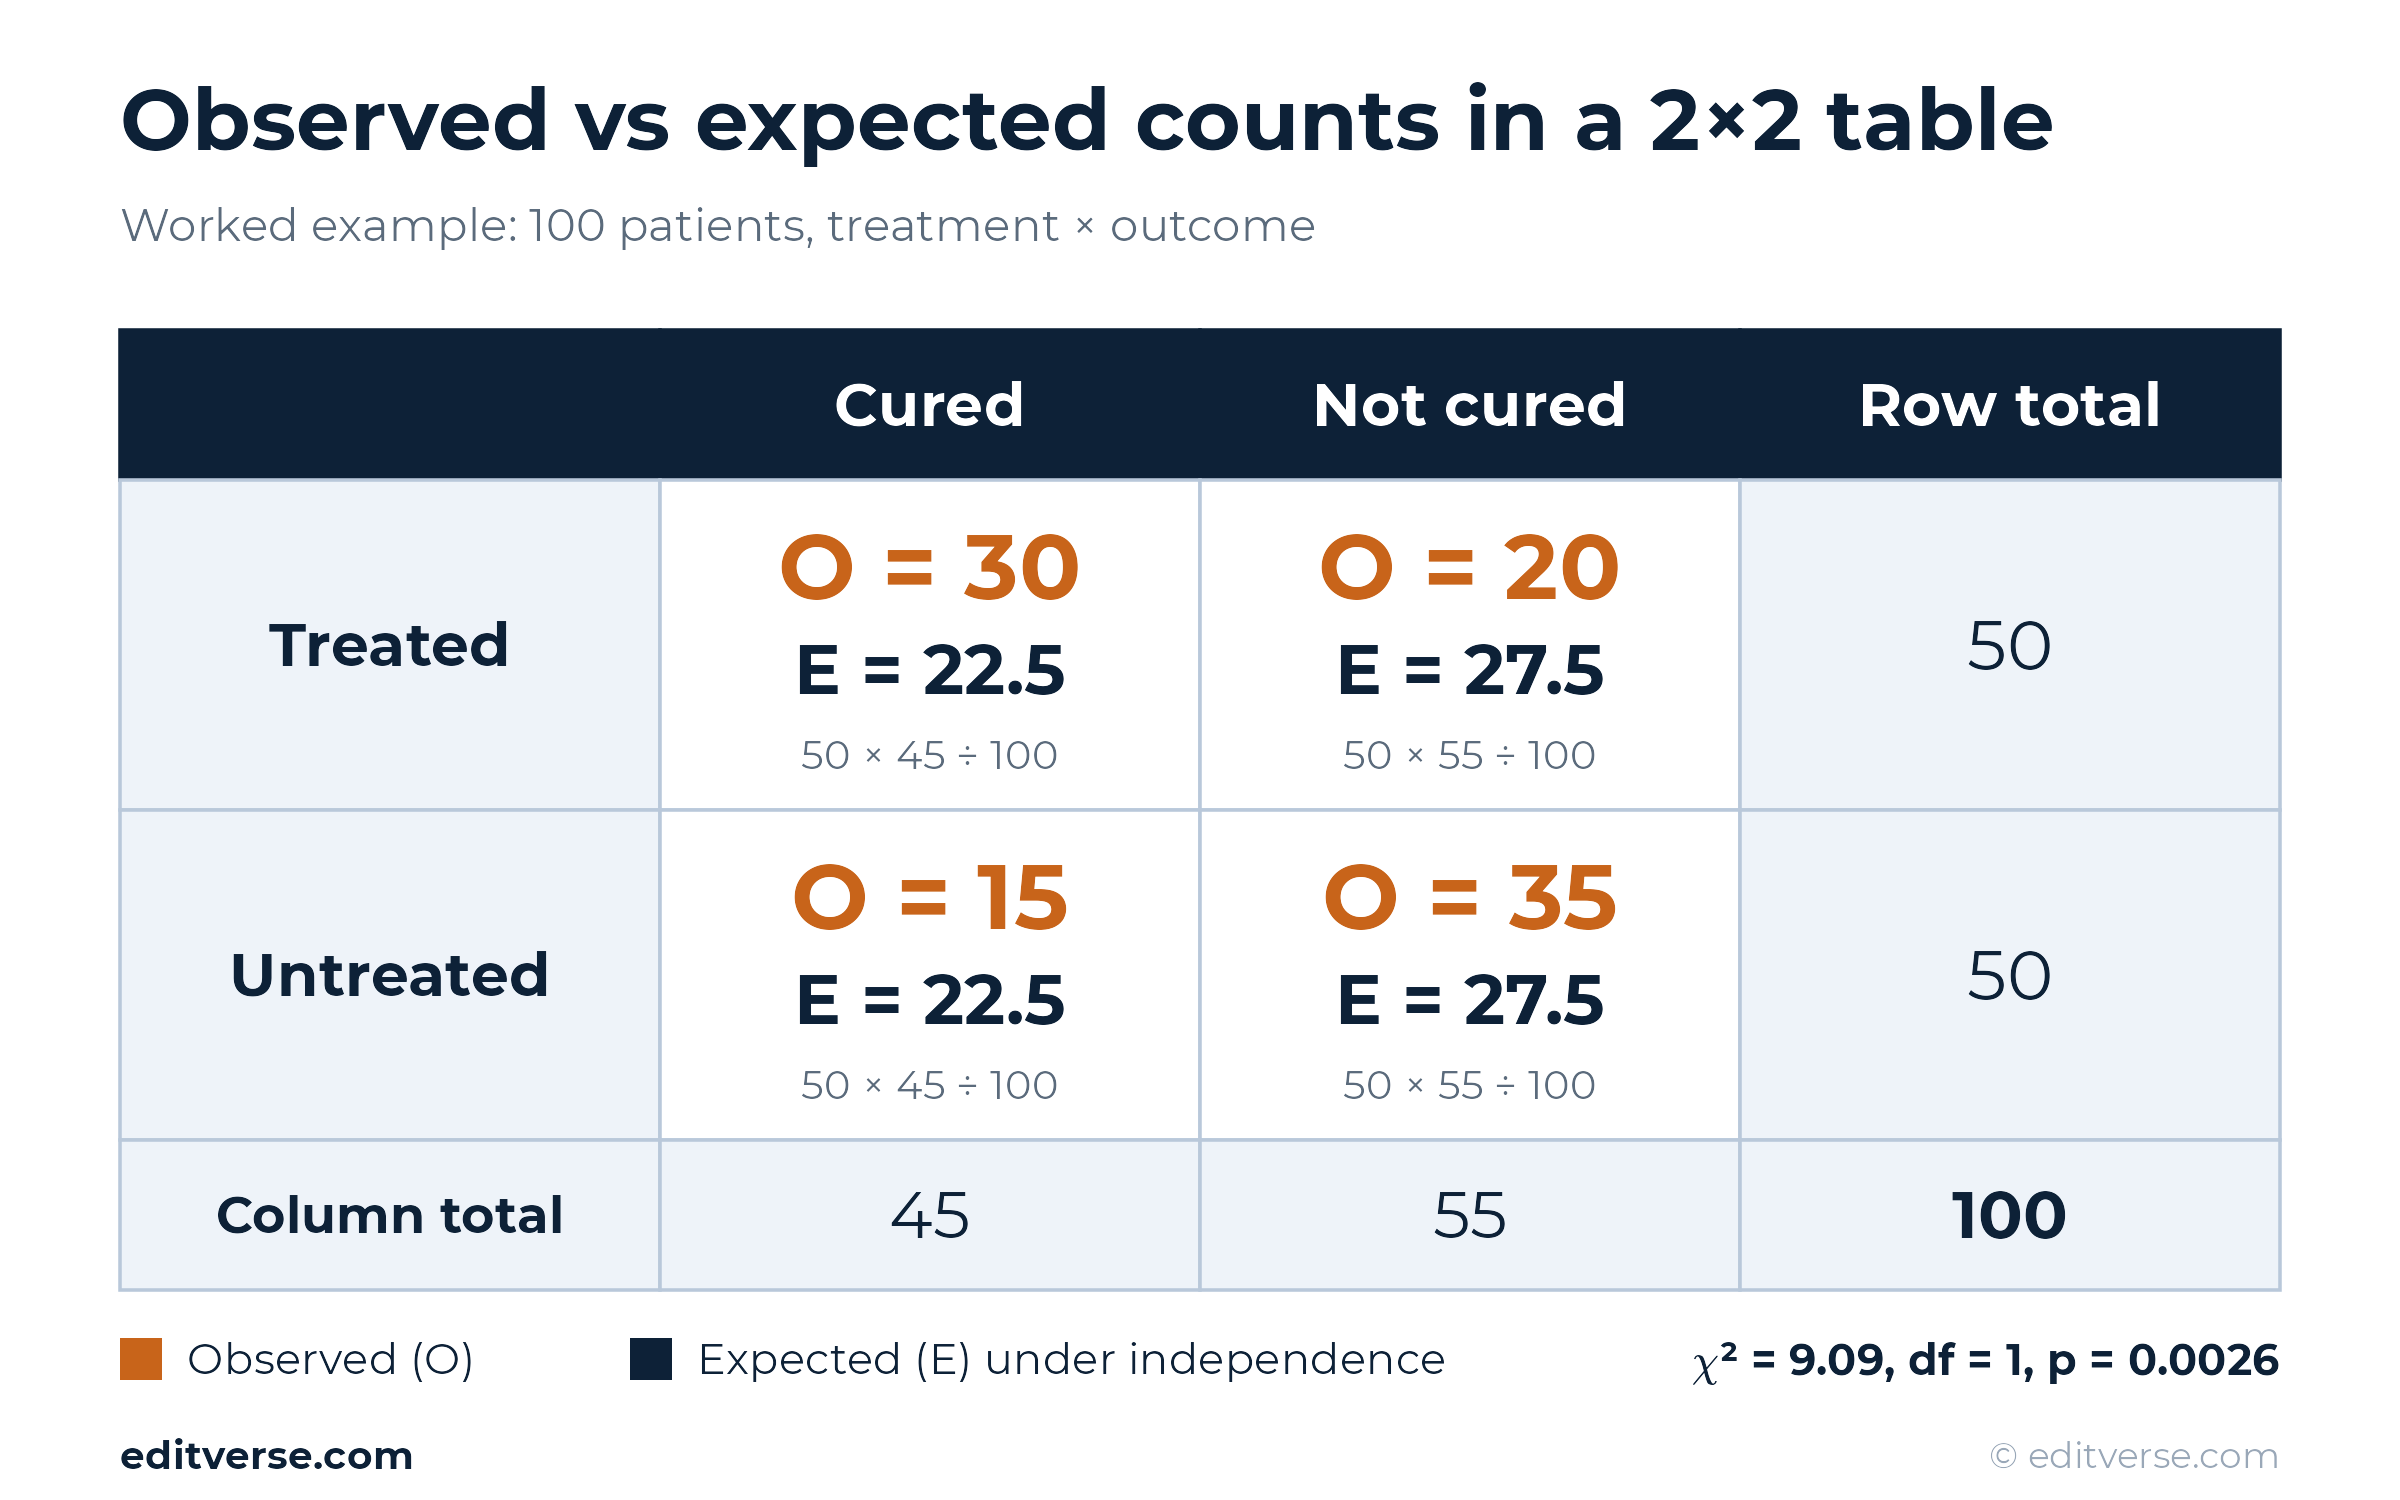
Sebuah ilustrasi sederhana akan memperjelas hal ini. Misalkan 100 pasien dibagi menjadi 50 yang diobati dan 50 yang tidak diobati, dan secara terpisah 45 dari 100 pasien tersebut diklasifikasikan sebagai sembuh dan 55 sebagai tidak sembuh. Dengan asumsi independensi, kelompok yang diobati seharusnya menunjukkan tingkat kesembuhan 45% yang sama dengan kelompok yang tidak diobati, sehingga jumlah pasien yang diharapkan sembuh di antara kelompok yang diobati adalah 50 × 45 ÷ 100, atau 22.5. Jumlah yang diharapkan tidak perlu berupa bilangan bulat. Hanya jumlah yang diamati yang harus berupa bilangan bulat.
Perhitungan kecocokan yang diharapkan bekerja dengan cara yang sama tetapi berasal dari proporsi yang dihipotesiskan daripada variabel kedua. Menguji apakah 200 kasus penyakit tersebar merata di empat musim menetapkan jumlah yang diharapkan setiap musim pada 200 × 0.25, atau 50, dan pengujian kemudian mengukur seberapa jauh jumlah musiman sebenarnya menyimpang dari garis lurus tersebut.
Derajat Kebebasan dalam Uji Chi-Kuadrat
Derajat kebebasan menentukan bentuk distribusi chi-kuadrat. Nilai derajat kebebasan yang tidak sesuai mudah terlewatkan saat menyusun bagian hasil, namun hal itu mengubah nilai kritis yang dibandingkan dengan statistik dan dapat mengubah kesimpulan yang hampir signifikan menjadi tidak signifikan atau sebaliknya. Untuk tabel kontingensi dengan r baris dan c kolom, derajat kebebasan sama dengan (r − 1)(c − 1). Oleh karena itu, tabel 2×2 standar memiliki tepat satu derajat kebebasan, karena setelah total baris dan kolom ditetapkan, hanya satu sel yang dapat bervariasi secara bebas sebelum sisanya hilang karena pengurangan.
Derajat kebebasan kesesuaian model mengikuti aturan yang terkait tetapi berbeda. Derajat kebebasan tersebut sama dengan jumlah kategori dikurangi 1, dikurangi satu derajat lagi untuk setiap parameter yang diestimasi dari sampel, bukan yang ditetapkan sebelumnya. Pengujian empat musim terhadap ekspektasi tetap 25% menggunakan 4 − 1 = 3 derajat kebebasan, karena tidak ada yang diestimasi dari data. Pengujian jumlah genotipe terhadap proporsi Hardy-Weinberg lebih rumit, karena frekuensi alel yang digunakan untuk membangun proporsi genotipe yang diharapkan itu sendiri diestimasi dari sampel yang sama, dan langkah estimasi tersebut membutuhkan derajat kebebasan tambahan di luar aturan sederhana jumlah dikurangi satu.
Uji Chi-Kuadrat Independensi: Contoh Lengkap yang Dikerjakan
Pertimbangkan perbandingan dua kelompok pada 100 pasien, 50 yang menerima pengobatan dan 50 yang tidak, yang ditabulasi silang terhadap hasil biner sembuh atau tidak sembuh. Kumpulan data persis ini juga berjalan di dalam kalkulator uji chi-square Editverse sebagai contoh yang dapat dimuat, sehingga setiap langkah di bawah ini dapat direproduksi secara instan.
| sembuh | Tidak sembuh | Jumlah baris | |
|---|---|---|---|
| Diobati | 30 | 20 | 50 |
| Tidak diobati | 15 | 35 | 50 |
| Jumlah kolom | 45 | 55 | 100 |
Jumlah yang diharapkan mengikuti aturan total baris dikalikan total kolom dari bagian sebelumnya. Pasien yang diobati dan sembuh diharapkan berjumlah 50 × 45 ÷ 100 = 22.5. Pasien yang diobati dan tidak sembuh diharapkan berjumlah 50 × 55 ÷ 100 = 27.5. Pasien yang tidak diobati dan sembuh diharapkan berjumlah 50 × 45 ÷ 100 = 22.5. Pasien yang tidak diobati dan tidak sembuh diharapkan berjumlah 50 × 55 ÷ 100 = 27.5. Setiap jumlah yang diharapkan melewati ambang batas Cochran sebesar 5, sehingga perkiraan chi-kuadrat biasa berlaku tanpa kualifikasi.
Setiap sel kemudian memberikan kontribusi (O − E)² ÷ E terhadap total. Sel yang diobati dan sembuh memberikan kontribusi (30 − 22.5)² ÷ 22.5 = 2.500. Sel yang diobati dan tidak sembuh memberikan kontribusi (20 − 27.5)² ÷ 27.5 = 2.045. Sel yang tidak diobati dan sembuh memberikan kontribusi (15 − 22.5)² ÷ 22.5 = 2.500. Sel yang tidak diobati dan tidak sembuh memberikan kontribusi (35 − 27.5)² ÷ 27.5 = 2.045. Jika dijumlahkan, keempat kontribusi tersebut memberikan χ² = 9.091 pada 1 derajat kebebasan, yang sesuai dengan p = 0.0026, jauh di bawah ambang batas konvensional 0.05. Penerapan koreksi kontinuitas Yates, yang akan dibahas secara lengkap di bawah, menurunkan statistik menjadi 7.919 (p = 0.0049); uji eksak Fisher yang dijalankan secara independen pada tabel yang sama menghasilkan p = 0.0046. Ketiga metode tersebut sepakat bahwa perlakuan dan hasil terkait, persis seperti triangulasi yang ingin dilihat oleh peninjau manuskrip di bagian hasil.
Signifikansi saja tidak menggambarkan seberapa kuat asosiasinya. Peluang sembuh berkisar antara 30 hingga 20 pada pasien yang diobati dibandingkan dengan 15 hingga 35 pada pasien yang tidak diobati, memberikan rasio peluang (30 × 35) ÷ (20 × 15) = 3.5. Cramér's V, ukuran efek berbasis chi-square yang dibatasi antara 0 dan 1 untuk tabel 2×2, menghasilkan akar kuadrat dari (9.091 ÷ 100), atau 0.30, yang berada di antara asosiasi kecil dan sedang menurut tolok ukur konvensional. Melaporkan nilai p di samping rasio peluang dan Cramér's V, daripada nilai p itu sendiri, memisahkan bagian hasil yang siap dipublikasikan dari bagian yang memicu pertanyaan dari peninjau. Penjelasan McHugh tentang studi vaksinasi di tempat kerja mengikuti urutan yang sama: 23 dari 92 karyawan yang tidak divaksinasi mengembangkan pneumonia pneumokokus dibandingkan dengan 5 dari 92 yang divaksinasi, uji chi-square menetapkan bahwa perbedaan tersebut bukan kebetulan, dan V Cramér kemudian menunjukkan seberapa kuat pengaruhnya.
Tabel Kontingensi dan Frekuensi Harapan: Contoh Nyata 2×2
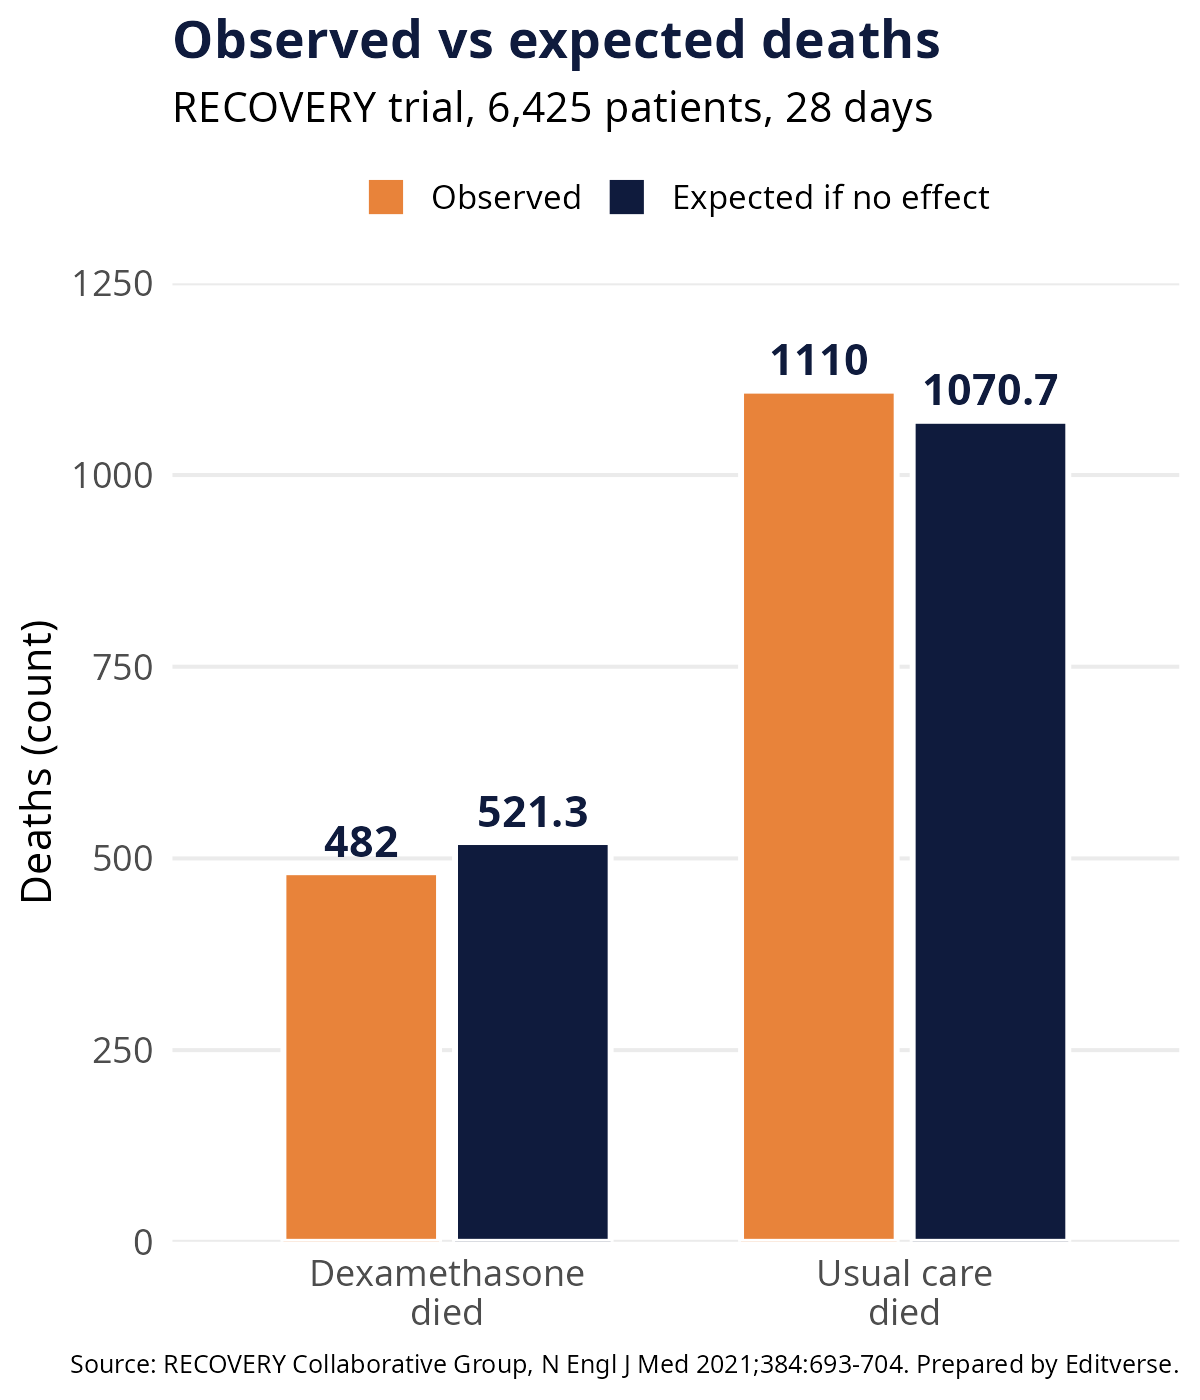
Tabel kontingensi menghubungkan dua variabel kategorikal, dan uji chi-square membandingkan jumlah yang diamati di setiap sel dengan frekuensi yang diharapkan : total baris × total kolom ÷ total keseluruhan. Uji coba RECOVERY secara acak membagi pasien Covid-19 yang dirawat di rumah sakit ke dalam kelompok yang menerima deksametason 6 mg setiap hari atau perawatan biasa dan menghitung kematian dalam waktu 28 hari. Laporan akhir dapat dibaca secara gratis di PubMed Central , dan abstraknya memberikan semua jumlah yang dibutuhkan: 2,104 pasien yang menerima deksametason, 4,321 pasien yang menerima perawatan biasa, dan 482 kematian.
| Kelompok | Meninggal pada hari ke-28 | selamat | Total |
|---|---|---|---|
| Dexamethasone | 482 | 1,622 | 2,104 |
| Perawatan biasa | 1,110 | 3,211 | 4,321 |
| Total | 1,592 | 4,833 | 6,425 |
Langkah 1: frekuensi yang diharapkan
Jika deksametason tidak memberikan perbedaan, angka kematian akan terbagi secara proporsional sesuai dengan ukuran kelompok. Angka kematian keseluruhan adalah 1,592 / 6,425. Kematian yang diharapkan akibat deksametason = 1,592 × 2,104 / 6,425 = 521.33 ; kematian yang diharapkan dengan perawatan biasa = 1,592 × 4,321 / 6,425 = 1,070.67 . Kematian yang diamati adalah 482 dan 1,110, sehingga deksametason berada 39.3 di bawah angka harapan dan perawatan biasa 39.3 di atas angka harapan.
Langkah 2: statistik uji
χ² = Σ (O − E)² / E = 5.87 pada 1 derajat kebebasan, p = 0.015. Dengan koreksi Yates, χ² = 5.72 (p = 0.017). Residu terstandarisasi adalah −1.72 (deksametason, meninggal) dan +1.20 (perawatan biasa, meninggal); tidak ada yang melewati ±2, sehingga tidak ada sel tunggal yang menonjol. Setiap jumlah yang diharapkan berada di atas 500, sehingga aproksimasi sampel besar aman. R's chisq.test dan Python scipy.stats.chi2_contingency Mengembalikan nilai yang identik.
Uji Kecocokan Chi-Square: Contoh Soal Kedua
Tim pengawasan sering mengajukan pertanyaan yang berbeda, bukan apakah dua variabel saling terkait, tetapi apakah distribusi salah satu variabel sesuai dengan pola yang diharapkan. Misalkan sebuah departemen kesehatan mencatat 200 kasus penyakit gastrointestinal yang terkonfirmasi selama satu tahun kalender dan ingin mengetahui apakah kemunculan penyakit tersebut berkelompok berdasarkan musim atau tersebar merata. Di bawah hipotesis nol yang datar dan tanpa musim, setiap dari empat musim diperkirakan akan memiliki 200 × 0.25 = 50 kasus.
| Musim | Diamati | Diharapkan | (O − E)² ÷ E |
|---|---|---|---|
| Musim dingin | 72 | 50 | 9.68 |
| Musim semi | 38 | 50 | 2.88 |
| Musim panas | 33 | 50 | 5.78 |
| Jatuh | 57 | 50 | 0.98 |
Jika dijumlahkan di keempat musim, kontribusi totalnya adalah χ² = 19.32 pada 4 − 1 = 3 derajat kebebasan, memberikan p = 0.00023. Hasil tersebut secara tegas menolak hipotesis nol distribusi datar. Kontribusi musim dingin sebesar 9.68 dan kontribusi musim panas sebesar 5.78 mencakup sebagian besar statistik total, yang secara langsung menunjukkan di mana penyimpangan sebenarnya berada. Kontribusi musim dingin jauh di atas bagian yang diharapkan dan musim panas jauh di bawahnya, alih-alih setiap musim sedikit bergeser ke arah yang sama, suatu perbedaan yang tidak pernah diungkapkan oleh nilai p omnibus saja dan yang perlu diperiksa kontribusi masing-masing sel untuk mengetahuinya.
Struktur persis ini muncul di seluruh bidang epidemiologi, paling sering dalam memeriksa apakah jumlah genotipe sesuai dengan kesetimbangan Hardy-Weinberg sebagai langkah kontrol kualitas genotipe, atau apakah diagnosis sesuai dengan proporsi yang diharapkan yang diambil dari populasi referensi. Mekanismenya tidak pernah berubah. Nyatakan proporsi nol, kalikan dengan ukuran sampel total untuk mendapatkan jumlah yang diharapkan, jumlahkan selisih standar kuadrat, dan bandingkan totalnya dengan distribusi chi-kuadrat dengan derajat kebebasan yang sesuai.
Ketika Uji Chi-Square Gagal: Jumlah Sel yang Diharapkan Kecil
Statistik chi-kuadrat hanyalah perkiraan. Distribusi referensinya mengasumsikan jumlah sel berperilaku cukup seperti kuantitas kontinu yang kira-kira normal sehingga jumlah diskrit dari deviasi kuadrat dapat membentuk kurva chi-kuadrat yang halus. Asumsi tersebut bergantung pada setiap sel yang memiliki jumlah yang diharapkan cukup besar, sama seperti perkiraan normal terhadap proporsi binomial membutuhkan cukup banyak percobaan sebelum berhenti berperilaku menyimpang di bagian ekornya. Begitu jumlah yang diharapkan turun menjadi 2 atau 3, beberapa nilai yang sebenarnya dapat diambil oleh jumlah yang diamati berada jauh terpisah relatif terhadap sebarannya, distribusi sampel sebenarnya dari statistik tersebut menjadi bergelombang daripada halus, dan kurva chi-kuadrat tidak sesuai dengan distribusi tersebut.
Makalah William Cochran tahun 1954 di jurnal Biometrics mengubah kekhawatiran teoretis tersebut menjadi aturan praktis yang masih diajarkan hingga saat ini. Tidak lebih dari 20% sel seharusnya memiliki jumlah yang diharapkan di bawah 5, dan tidak ada satu sel pun yang boleh berada di bawah 1; jika salah satu garis dilewati, nilai p yang dilaporkan tidak dapat lagi dipercaya begitu saja. Studi simulasi pada era tersebut menghasilkan aturan tersebut, bukan bukti yang pasti, dan penelitian selanjutnya terus mengkonfirmasi kekhawatiran yang mendasarinya meskipun ambang batas yang tepat masih diperdebatkan, termasuk literatur metode tentang pengujian Hardy-Weinberg yang menggambarkan uji kecocokan chi-kuadrat biasa sebagai sangat sensitif terhadap ukuran sampel kecil atau frekuensi alel yang jarang.
Sebuah tabel sederhana menunjukkan implikasi praktisnya dengan jelas. Ambil tabel 2×2 dengan jumlah 4, 1, 1, dan 4, di mana setiap jumlah yang diharapkan sama dengan 2.5, jauh di bawah batas bawah Cochran. Statistik chi-kuadrat yang tidak terkoreksi menghasilkan 3.6 pada 1 derajat kebebasan, untuk p = 0.058, hasil yang cukup menggoda untuk disebut "cenderung signifikan". Koreksi kontinuitas Yates menurunkan tabel yang sama menjadi χ² = 1.6 (p = 0.206), dan uji eksak Fisher yang dijalankan secara independen juga menghasilkan p = 0.206, hampir sama persis dengan chi-kuadrat yang terkoreksi dan secara tegas bertentangan dengan versi yang tidak terkoreksi. Melaporkan nilai p yang tidak terkoreksi di sini akan melebih-lebihkan bukti adanya asosiasi yang tidak didukung oleh uji eksak.
Penjelasan Koreksi Kontinuitas Yates
Frank Yates mengusulkan perbaikan untuk tabel 2×2 kecil dalam sebuah makalah tahun 1934 di Journal of the Royal Statistical Society . Karena distribusi chi-kuadrat bersifat kontinu sedangkan jumlah sel adalah bilangan bulat diskrit, Yates menyarankan untuk mengurangi 0.5 dari nilai absolut setiap perbedaan (O − E) sebelum dikuadratkan, yang mengecilkan statistik dan mendorong nilai p ke atas relatif terhadap versi yang tidak dikoreksi. Pada tabel 4-1-1-4 kecil di atas, penyesuaian tersebut menurunkan statistik dari 3.6 menjadi 1.6, tepatnya jenis koreksi yang dimaksudkan untuk mencegah uji yang tidak dikoreksi mengklaim signifikansi secara berlebihan pada tabel yang jarang datanya.
Apakah koreksi tersebut harus diterapkan secara default telah diperdebatkan selama beberapa dekade tanpa penyelesaian penuh, dan panduan ini tidak akan berpura-pura bahwa masalah ini telah selesai. Makalah Haviland tahun 1990 di Statistics in Medicine berpendapat bahwa statistik yang dikoreksi Yates terlalu konservatif dan bahwa chi-square Pearson biasa sudah cukup mengontrol kesalahan Tipe I untuk sebagian besar tabel 2×2 yang sebenarnya ditemui oleh para peneliti. Analisis yang lebih baru mencapai kesimpulan yang berlawanan. Makalah Prescott tahun 2021 di Statistics in Medicine merekomendasikan pengujian tabel 2×2 menggunakan dua kali lipat probabilitas eksak satu sisi dari uji Fisher, atau chi-square yang dikoreksi Yates sebagai perkiraannya, khususnya untuk aplikasi penelitian medis. Mengingat adanya perbedaan pendapat yang masih berlangsung di antara para ahli statistik yang cermat, sikap praktis yang paling aman adalah melaporkan versi mana yang digunakan dan mengandalkan uji eksak Fisher daripada salah satu varian chi-square setiap kali tabel cukup kecil sehingga pilihan tersebut penting.
Sebuah uji coba yang dipublikasikan menunjukkan seberapa jauh perbedaan antar versi dapat terjadi. Dalam uji coba nitrat intravena yang digunakan Bewick, Cheek, dan Ball untuk mengajarkan uji tabel kontingensi , 3 dari 50 pasien yang diobati dan 8 dari 45 kelompok kontrol meninggal. Chi-square yang tidak dikoreksi memberikan χ² = 3.21 pada 1 derajat kebebasan (p = 0.073), statistik yang dikoreksi Yates turun menjadi 2.16 (p = 0.141), dan uji eksak Fisher, yang diambil sebagai dua kali probabilitas satu sisi, menghasilkan p = 0.140. Versi yang tidak dikoreksi secara nyata lebih dekat ke signifikansi daripada dua versi lainnya, dan itulah sebabnya bagian metode harus menyebutkan versi yang digunakan.

Apakah Anda membutuhkan analisis ini untuk dijalankan atau diperiksa? Seorang ahli biostatistik bergelar PhD akan meninjau desain penelitian Anda, menjalankan analisis, dan menulis paragraf metode statistik untuk manuskrip Anda.
Uji Eksak Fisher: Alternatif untuk Sampel Kecil
Ronald Fisher menjelaskan pendekatan yang tepat dalam sebuah makalah tahun 1922 di Journal of the Royal Statistical Society , berdasarkan logika tabel kontingensi yang sama yang telah diperkenalkan Pearson dua dekade sebelumnya. Alih-alih mendekati distribusi sampel dengan kurva halus, uji eksak Fisher menetapkan total baris dan kolom dan menghitung probabilitas pasti dari setiap tabel yang mungkin setidaknya seekstrem tabel yang diamati, menggunakan distribusi hipergeometrik. Tidak adanya langkah pendekatan berarti tidak ada risiko ketidaksesuaian kurva halus yang dijelaskan di atas, dan itulah sebabnya uji eksak ini berlaku sedangkan uji chi-kuadrat biasa tidak.
Ulasan Sahai dan Khurshid tahun 1995 di Journal of Biopharmaceutical Statistics membahas secara detail pertimbangan-pertimbangan tersebut dan mencatat bahwa uji eksak itu sendiri dapat bersifat konservatif untuk konfigurasi tabel tertentu, sehingga beralih ke uji Fisher tidak secara otomatis menghasilkan uji yang lebih kuat, hanya uji yang lebih dapat dipertahankan ketika ukuran sampel kecil. Aturan pengambilan keputusan praktis mengikuti langsung dari ambang batas Cochran di atas. Jalankan uji chi-kuadrat biasa ketika setiap, atau hampir setiap, jumlah yang diharapkan mencapai 5 atau lebih, dan beralih ke uji eksak Fisher setelah kondisi tersebut gagal, terlepas dari seberapa besar sampel keseluruhan, karena total yang besar masih dapat menyembunyikan satu sel yang jarang di dalam tabel yang tidak seimbang.
Penerapan Uji Chi-Square dalam Dunia Nyata di Bidang Epidemiologi
Penelitian epidemiologi yang dipublikasikan selalu mengandalkan prosedur chi-square, hampir selalu sebagai penyaringan awal sebelum pemodelan yang lebih rumit. Tutorial biostatistik Hazra dan Gogtay di Indian Journal of Dermatology mencantumkan chi-square Pearson, chi-square McNemar untuk data biner berpasangan, dan chi-square Mantel-Haenszel untuk tabel berstratifikasi sebagai tiga varian yang paling sering ditemui oleh peneliti klinis, masing-masing cocok untuk struktur data yang berbeda dan bukan merupakan pilihan yang dapat saling menggantikan.
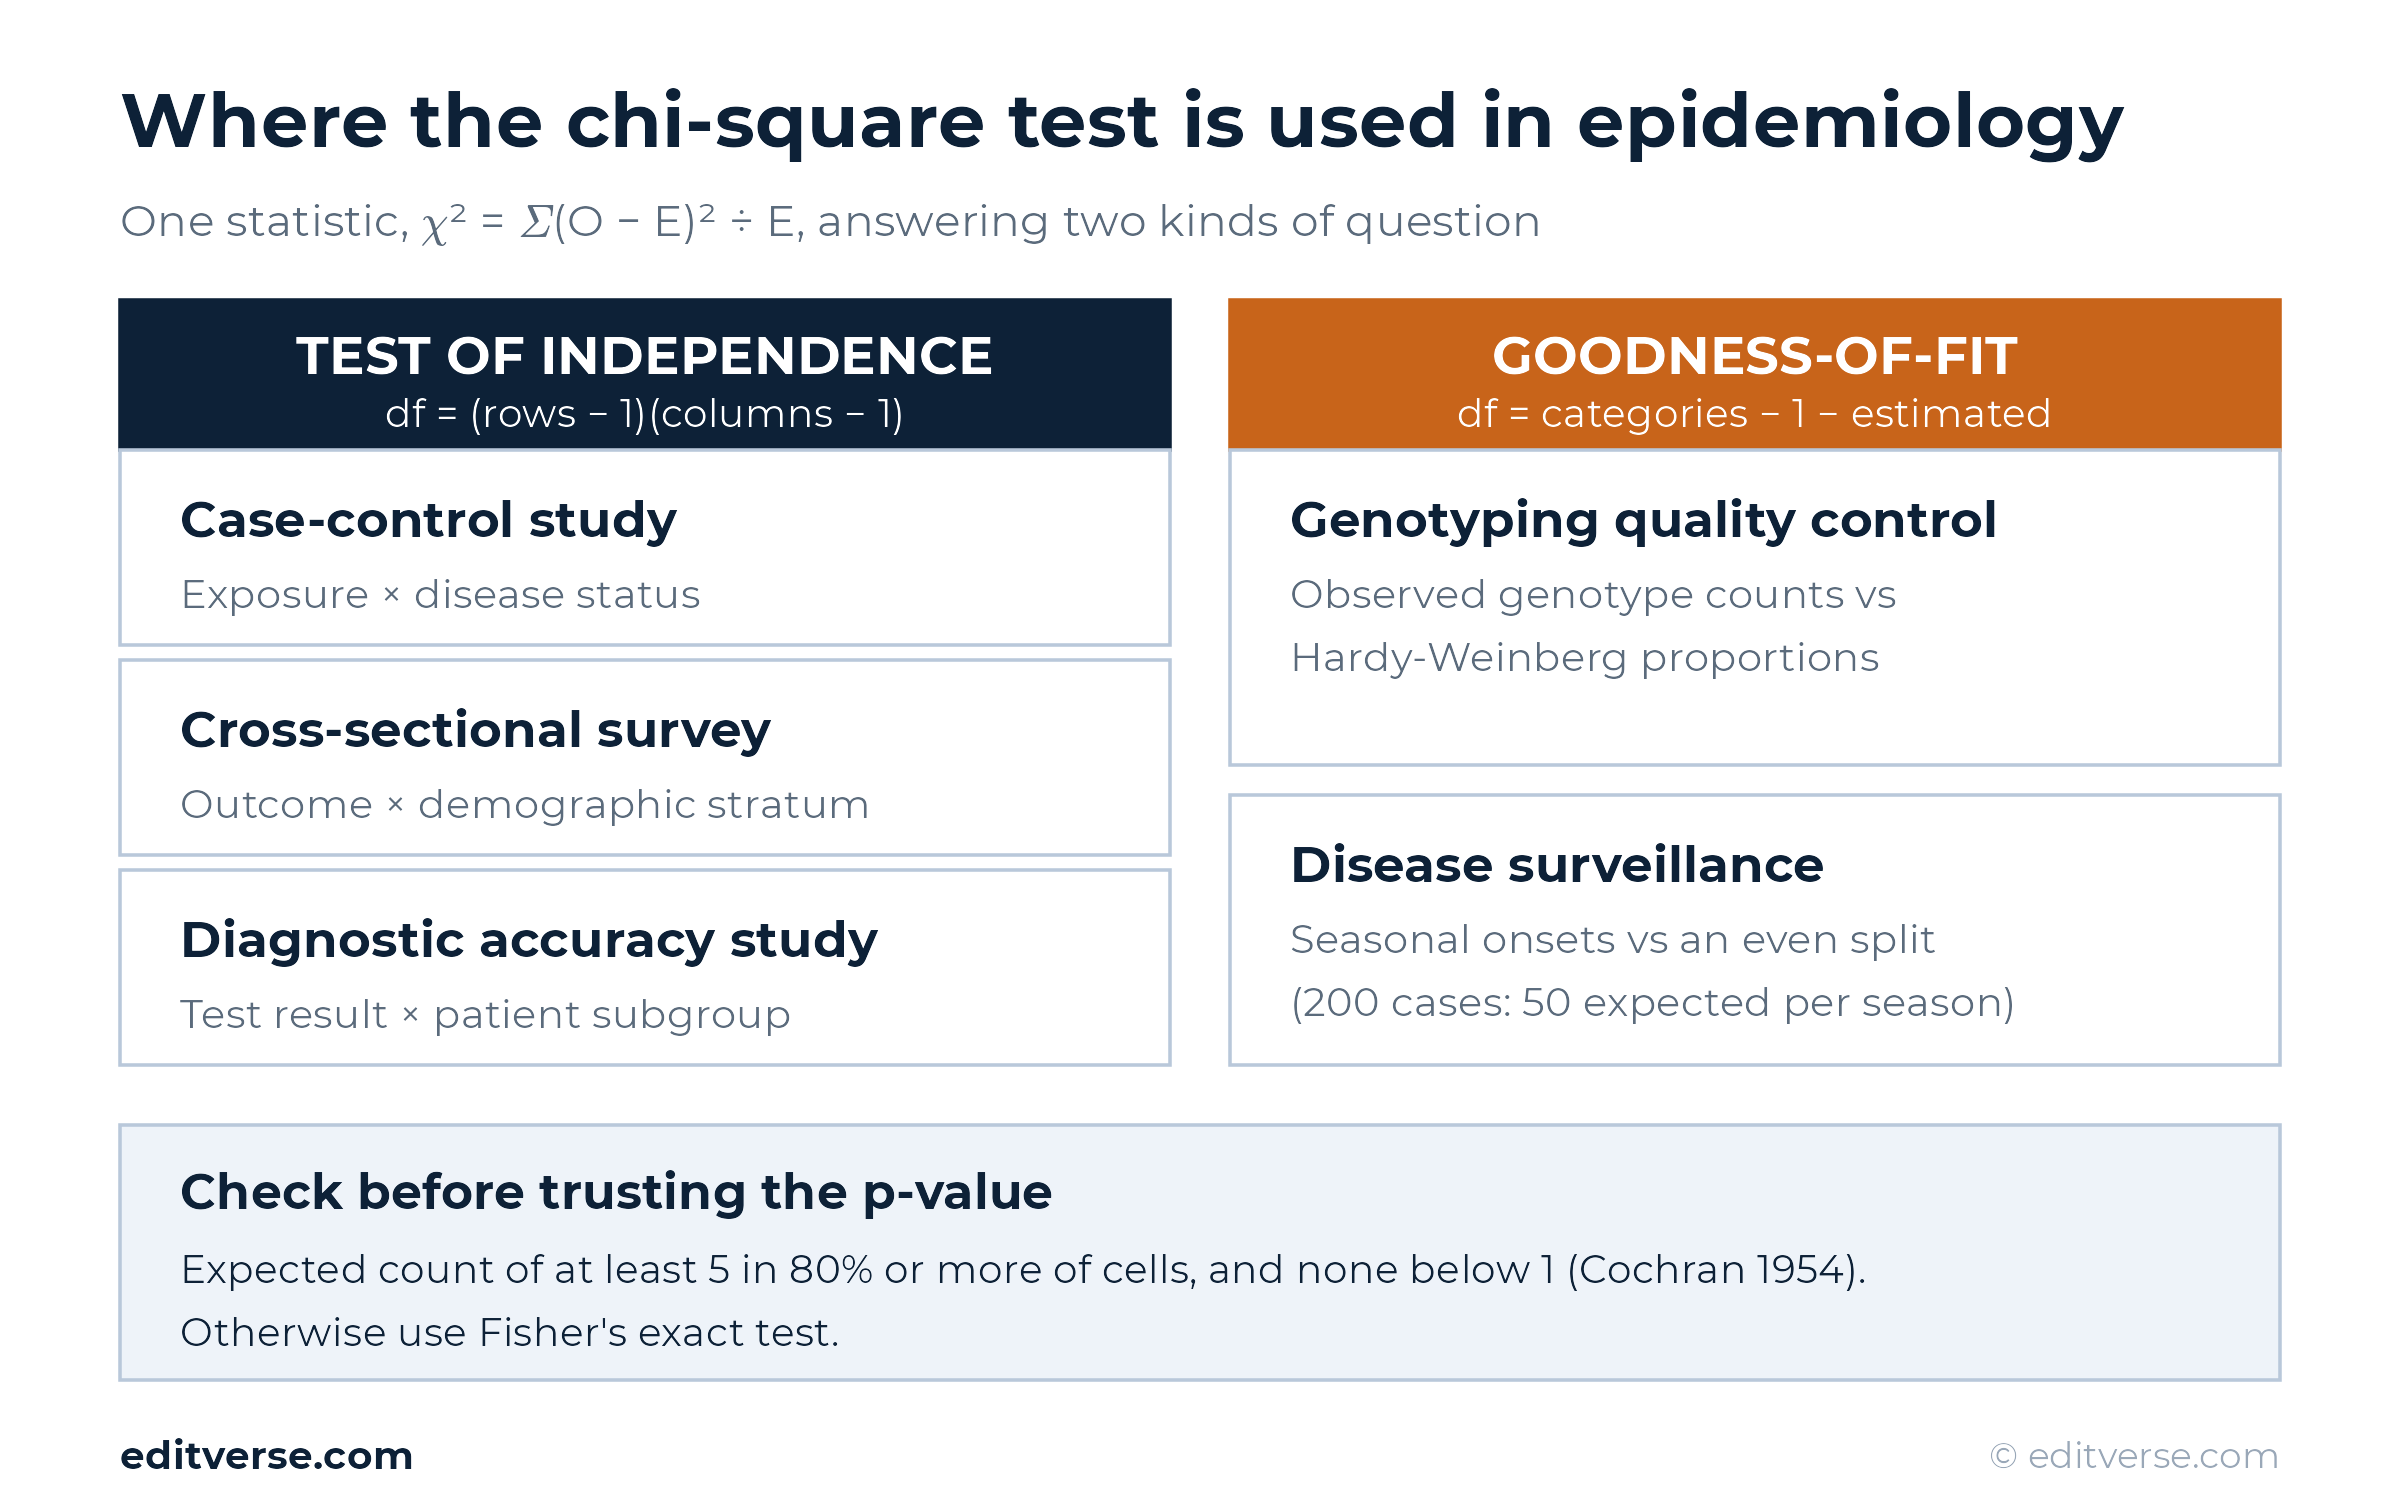
Epidemiologi genetik mengandalkan versi kecocokan sebagai langkah kontrol kualitas rutin. Studi genotipe menguji apakah jumlah genotipe yang diamati pada lokus tertentu sesuai dengan proporsi Hardy-Weinberg, dan penyimpangan yang signifikan sering kali menandakan kesalahan genotipe, stratifikasi populasi, atau tekanan seleksi yang sebenarnya, bukan temuan yang dilaporkan begitu saja. Perbedaan ini dijelaskan secara rinci dalam bab-bab metode genetika tentang pengujian Hardy-Weinberg bagi para peneliti yang membangun studi asosiasi genetik. Dalam satu pemindaian genom , uji Hardy-Weinberg satu derajat kebebasan yang dijalankan di 44 lokus penanda menunjukkan 7 lokus dengan kelebihan homozigot yang signifikan (χ² > 6), pola yang menunjukkan adanya kesalahan penentuan genotipe. Sebuah tutorial yang banyak digunakan tentang tabel 2×2 yang diterbitkan di Disability and Rehabilitation membahas tabel faktor risiko kanker payudara dari awal hingga akhir dan berpendapat bahwa editor jurnal harus mensyaratkan baik jumlah sel yang diamati maupun yang diharapkan dalam setiap tabel yang diterbitkan, bukan hanya statistik uji saja, sehingga pembaca dapat menilai sendiri apakah ambang batas Cochran telah terpenuhi.
Di luar bidang genetika, uji independensi muncul dalam perbandingan kasus-kontrol paparan berdasarkan status penyakit, survei potong lintang yang membandingkan hasil kategorikal di berbagai strata demografis, dan studi diagnostik yang membandingkan hasil tes di berbagai subkelompok pasien. Data pengawasan diperiksa dengan versi uji kecocokan (goodness-of-fit) setiap kali perlu dibandingkan dengan pola yang diharapkan, baik musiman maupun lainnya, persis seperti yang ditunjukkan di atas.
Kesalahan Umum dalam Pelaporan Uji Chi-Square
Sejumlah kesalahan berulang ditemukan baik dalam manuskrip yang dikirimkan maupun makalah yang diterbitkan.
- Memasukkan persentase, bukan jumlah mentah. Rumus chi-square beroperasi pada frekuensi, bukan proporsi, jadi mengkonversi persentase kembali ke jumlah sebenarnya sebelum pengujian adalah wajib, bukan opsional.
- Mengabaikan ambang batas jumlah yang diharapkan. Mempublikasikan nilai p chi-square dari tabel dengan beberapa sel di bawah 5, tanpa mengakui keterbatasan atau beralih ke uji eksak Fisher, termasuk di antara kesalahan statistik yang paling dapat dihindari di bidang ini.
- Menerapkan uji independensi pada data berpasangan. Pengukuran sebelum dan sesudah atau pasangan yang cocok pada subjek yang sama secara langsung melanggar asumsi independensi. Uji McNemar Ada justru untuk situasi seperti itu.
- Melaporkan signifikansi tanpa ukuran efek. Nilai p mengkonfirmasi adanya hubungan. Apakah hubungan tersebut cukup besar untuk berpengaruh secara klinis adalah pertanyaan terpisah, jadi Cramér's V, phi, atau rasio odds harus diletakkan di sebelah setiap hasil uji chi-square.
- Kesalahan dalam menghitung derajat kebebasan. Nilai yang tidak sesuai mudah ditemukan oleh peninjau statistik dan menandakan bahwa analisis tidak diperiksa dengan cermat sebelum pengajuan.
Cara Melaporkan Uji Chi-Square dalam Manuskrip Anda
Sebagian besar jurnal di bidang ilmu kesehatan mengikuti versi templat pelaporan yang sama. Sebutkan nama uji, derajat kebebasan dalam tanda kurung, ukuran sampel, statistik, dan nilai p, dalam urutan tersebut, misalnya “χ²(1, N = 100) = 9.09, p = 003.” Segera diikuti dengan ukuran efek dan, untuk tabel 2×2, rasio odds atau risiko relatif dengan interval kepercayaannya. Panduan yang banyak digunakan tentang kesalahan interpretasi statistik yang diterbitkan di European Journal of Epidemiology menekankan bahwa nilai p saja, tanpa disertai estimasi interval, mendorong pembaca untuk mengartikan signifikan sebagai besar atau penting.
Tabel hasil harus menunjukkan jumlah pengamatan untuk setiap sel, bukan hanya persentase, sehingga pembaca yang cermat dapat menghitung ulang uji tersebut secara independen. Bagian metode harus menyebutkan koreksi mana, jika ada, yang diterapkan, apakah Pearson yang tidak terkoreksi, koreksi Yates, atau Fisher's exact, dan menyatakan perangkat lunak dan versi yang digunakan. Peneliti yang masih mempertimbangkan uji chi-square dibandingkan pilihan lain untuk rencana analisis yang lebih luas mungkin juga menemukan panduan Editverse tentang memilih uji statistik yang tepat bermanfaat untuk bagian manuskrip yang berada di luar data kategorikal.
Butuh Bantuan Ahli untuk Analisis Statistik Anda?
Ahli biostatistik Editverse membuat tabel kontingensi, memilih dengan tepat antara uji chi-square dan uji Fisher's exact, dan memberikan hasil yang siap dipublikasikan dengan output R yang sepenuhnya dapat direproduksi. Hitung angkanya terlebih dahulu dengan kalkulator uji chi-square gratis , atau serahkan data mentah secara langsung melalui Just Data Service untuk analisis lengkap, penulisan laporan, dan dukungan pengajuan jurnal.
Kesimpulan
Menjalankan uji chi-square dengan benar membutuhkan lebih dari sekadar memasukkan angka ke dalam rumus. Frekuensi yang diharapkan harus berasal dari hipotesis nol yang dinyatakan dengan jelas, derajat kebebasan harus sesuai dengan bentuk tabel yang sebenarnya, dan pilihan antara chi-square biasa, versi koreksi Yates, dan uji eksak Fisher harus didasarkan pada ukuran sel terkecil yang diharapkan, bukan kebiasaan. Kedua tabel yang telah dikerjakan di atas, yang diperiksa silang dengan perangkat lunak statistik independen di setiap langkahnya, menunjukkan seberapa besar hasil dapat bergeser begitu jumlah yang diharapkan menjadi kecil, dan mengapa nilai p yang disalin dari keluaran perangkat lunak tanpa memeriksa angka tersebut terlebih dahulu memberikan gambaran yang tidak lengkap.
Data kategorikal semacam ini menjadi inti dari studi kasus-kontrol, makalah akurasi diagnostik, dan penelitian asosiasi genetik, itulah sebabnya para peninjau manuskrip meneliti uji khusus ini dengan sangat cermat. Memastikan asumsi yang tepat sejak awal, dan melaporkan ukuran efek bersamaan dengan nilai p, akan mencegah permintaan revisi sebelum manuskrip tersebut ditulis.
Alat Gratis untuk Analisis Anda
- GraphProGrafik siap publikasi dengan nilai p chi-square bawaan. Gratis, tanpa pendaftaran.
- StatPro: kalkulator statistik gratis dan pemilih uji untuk hasil kategorikal.
- Flowchart ProDiagram alur CONSORT, STROBE, dan PRISMA di browser Anda.
FAQ (Pertanyaan Umum)
Untuk apa uji chi-square digunakan?
Uji chi-square memeriksa apakah jumlah kategori yang diamati berbeda dari jumlah yang diharapkan di bawah hipotesis nol, baik karena dua variabel kategorikal saling berhubungan (uji independensi) atau karena distribusi salah satu variabel tidak sesuai dengan pola yang dinyatakan (uji kecocokan).
Apa rumus uji chi-kuadrat?
χ² = Σ (O − E)² / E, di mana O adalah jumlah yang diamati pada setiap sel, E adalah jumlah yang diharapkan pada sel tersebut di bawah hipotesis nol, dan penjumlahan dilakukan di setiap sel dalam tabel.
Berapa derajat kebebasan yang dimiliki oleh uji chi-kuadrat?
Tabel kontingensi memiliki (baris − 1) × (kolom − 1) derajat kebebasan, sehingga tabel 2×2 memiliki tepat 1 derajat kebebasan. Uji kecocokan memiliki jumlah kategori dikurangi 1, dikurangi satu lagi untuk setiap parameter yang diestimasi dari sampel.
Kapan saya harus menggunakan uji Fisher's exact test sebagai pengganti uji chi-square?
Gunakan uji Fisher's exact test jika lebih dari 20% sel dalam tabel memiliki nilai harapan di bawah 5, atau jika ada satu sel pun yang memiliki nilai harapan di bawah 1, sesuai dengan panduan Cochran tahun 1954.
Apakah saya harus selalu menerapkan koreksi kontinuitas Yates?
Para ahli statistik berbeda pendapat. Beberapa bukti menunjukkan bahwa koreksi tersebut terlalu konservatif untuk tabel 2×2 yang lebih besar, sementara penelitian terbaru lainnya merekomendasikannya, atau uji pasti yang setara, khususnya untuk penelitian medis. Melaporkan versi mana yang digunakan lebih penting daripada memilih standar universal.
Apa perbedaan antara uji chi-square independensi dan uji kecocokan model?
Uji independensi membandingkan dua variabel kategorikal satu sama lain di dalam tabel kontingensi. Uji kecocokan membandingkan distribusi yang diamati dari satu variabel dengan distribusi yang ditentukan sebelumnya.
Apakah hasil chi-square yang signifikan menunjukkan seberapa kuat asosiasinya?
Tidak. Signifikansi hanya menunjukkan bahwa suatu asosiasi kemungkinan besar bukan disebabkan oleh kebetulan pada tingkat alfa yang dipilih. Kekuatan memerlukan ukuran efek terpisah seperti Cramér's V, phi, atau rasio peluang.
Apakah uji chi-square dapat digunakan pada data kontinu?
Tidak secara langsung. Pengukuran kontinu perlu dikelompokkan ke dalam kategori terlebih dahulu, yang akan menghilangkan informasi, sehingga uji t, ANOVA, atau model regresi biasanya merupakan pilihan yang lebih baik ketika hasilnya benar-benar kontinu.
Referensi
- Pearson K. Tentang kriteria bahwa suatu sistem penyimpangan dari probabilitas dalam kasus sistem variabel yang berkorelasi sedemikian rupa sehingga dapat diasumsikan secara wajar berasal dari pengambilan sampel acak. Majalah Filsafat. 1900;50(302):157–175. doi.org/10.1080/14786440009463897
- Fisher RA. Tentang interpretasi χ² dari tabel kontingensi, dan perhitungan P. JR Stat Soc. 1922;85(1):87–94. doi.org/10.2307/2340521
- Yates F. Tabel kontingensi yang melibatkan angka kecil dan uji χ². Suplemen JR Stat Soc. 1934;1(2):217–235. doi.org/10.2307/2983604
- Cochran WG. Beberapa metode untuk memperkuat uji χ² umum. Biometrics. 1954;10(4):417–451. doi.org/10.2307/3001616
- Koreksi kontinuitas Haviland MG. Yates dan analisis tabel kontingensi 2 x 2. Statistik Medis. 1990;9(4):363–367. PMID 2362976
- Prescott RJ. Uji signifikansi dua arah untuk tabel kontingensi 2 x 2. Apa alternatifnya? Statistik Medis. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. Analisis data epidemiologi yang melibatkan tabel kontingensi 2 x 2, tinjauan umum tentang uji eksak Fisher dan koreksi kontinuitas Yates. J Biopharm Stat. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. Modul seri Biostatistik 4, membandingkan kelompok, variabel kategorikal. India J Dermatol. 2016;61(4):385–392. PMID 27512183
- Wang J, Shete S. Pengujian penyimpangan dari proporsi Hardy-Weinberg. Metode Mol Biol2012;850:77–102. PMID 22307695
- Rigby AS. Metode statistik dalam epidemiologi. VII. Tinjauan umum uji chi2 untuk analisis tabel kontingensi 2 x 2. Rehabilitasi Disabilitas. 2002;23(16):693–697. PMID 11732558
- Greenland S, Senn SJ, Rothman KJ, dkk. Uji statistik, nilai P, interval kepercayaan, dan kekuatan, panduan untuk kesalahan interpretasi. Jurnal Epidemiologi Eropa. 2016;31(4):337–350. PMID 27209009
- Kelompok Kolaboratif RECOVERY. Deksametason pada pasien rawat inap dengan Covid-19. N Engl J Med. 2021;384(8):693–704. doi.org/10.1056/NEJMoa2021436
- Bewick V, Cheek L, Ball J. Tinjauan statistik 8: data kualitatif, uji asosiasi. Perawatan Kritis. 2004;8(1):46–53. PMID 14975045
- McHugh ML. Uji chi-kuadrat independensi. Biokimia Medis. 2013;23(2):143–149. PMID 23894860
- Gomes I, Collins A, Lonjou C, dkk. Kontrol kualitas Hardy-Weinberg. Ann Hum Genet. 1999;63(6):535–538. PMID 11246455