Publié | Dernière mise à jour
Le test du χ² répond à une question précise : les effectifs observés dans un ensemble de catégories diffèrent-ils des prédictions d’indépendance ou d’un modèle établi ? Introduit par Karl Pearson en 1900 , ce test est encore utilisé chaque semaine par les épidémiologistes pour comparer les taux d’exposition entre groupes, vérifier l’exactitude des données génotypiques et déterminer si l’apparition des maladies se concentre selon les saisons plutôt que de se répartir uniformément sur l’année. Les ouvrages concurrents sur ce sujet se contentent généralement de reformuler la formule. Ici, deux tableaux de contingence sont élaborés manuellement, chaque valeur est vérifiée à l’aide d’un logiciel statistique indépendant, et l’ouvrage explique précisément à quel moment l’approximation du χ² cesse d’être fiable et qu’il convient alors d’utiliser le test exact de Fisher.
Points clés à retenir
- A test du chi carré compare les décomptes de catégories observés aux décomptes attendus dans le cadre d'un modèle nul, en utilisant la statistique χ² = Σ(O − E)² / E.
- Le test d'indépendance du chi carré vérifie si deux variables catégorielles sont liées ; test d'ajustement vérifie si la distribution d'une variable correspond à un modèle hypothétique.
- Degrés de liberté pour un tableau de contingence égal à (lignes − 1) × (colonnes − 1) ; pour la qualité de l'ajustement, ils sont égaux au nombre de catégories moins 1, moins tous les paramètres estimés à partir des données.
- Les recommandations de Cochran de 1954 stipulent que pas plus de 20 % des cellules ne devraient avoir un nombre attendu inférieur à 5, et qu'aucune cellule ne devrait avoir un nombre inférieur à 1. Dépassez ce seuil et test exact de Fisher devient le choix le plus sûr.
- Un résultat significatif au test du chi carré indique l'existence d'une association. La force de cette association est une question distincte, à laquelle on répond par un odds ratio, un risque relatif ou le V de Cramér, et non par la seule valeur p.
En mots simples
Imaginez deux groupes de patients, l'un traité et l'autre non, avec un résultat binaire (guérison, par exemple). Un test du χ² permet de déterminer si la guérison semble identique dans les deux groupes ou si elle diffère réellement. Il établit un tableau de valeurs, calcule les valeurs attendues si le traitement était sans effet, et mesure l'écart entre les valeurs observées et ces valeurs attendues. Un écart important entre les valeurs observées et les valeurs attendues produit une faible valeur p et suggère un lien réel entre le traitement et le résultat. Un écart faible indique que la tendance observée est probablement due au hasard.
Deux conditions sont essentielles avant d'interpréter un résultat. Chaque catégorie doit être véritablement distincte, car un même patient ne peut pas être compté deux fois, et le nombre attendu dans la plupart des cellules doit être d'au moins 5. Pour les petits échantillons, il convient d'utiliser le test exact de Fisher , qui sera abordé plus loin dans ce guide.
Qu'est-ce qu'un test du Chi carré ?
Les statisticiens regroupent les tests du χ² en une famille qui partage une caractéristique commune : chaque statistique de test suit une loi du χ² lorsque l’hypothèse nulle est vraie et que la taille de l’échantillon est suffisante. Deux tests de cette famille couvrent la quasi-totalité des cas d’utilisation rencontrés en pratique. Un test du χ² d’indépendance compare deux variables catégorielles mesurées chez les mêmes sujets, comme le groupe de traitement et le résultat clinique, et détermine si la valeur de l’une prédit celle de l’autre. Un test du χ² d’adéquation compare une variable catégorielle unique et vérifie si sa distribution observée correspond à une distribution prédéfinie, par exemple une répartition égale sur les quatre saisons ou un ratio génétique mendélien.
Le choix entre ces deux tests, et entre le test du chi carré et un test complètement différent, dépend de la méthode de collecte des données et de la question posée. Les lecteurs qui hésitent encore quant à la pertinence du test du chi carré pour leurs données peuvent utiliser le sélecteur de tests interactif d'Editverse ou consulter l' organigramme des tests statistiques avant de poursuivre.
Les deux versions du test du chi carré utilisent la même statistique.
χ² = Σ (O − E)² / E
O représente le nombre d'observations dans une catégorie ou une cellule, E le nombre attendu sous l'hypothèse nulle, et la somme est calculée pour toutes les cellules du tableau. Élever la différence au carré permet d'annuler le signe, de sorte que les sur- et sous-observations augmentent la statistique. Diviser par E permet de rapporter chaque différence au carré au nombre réellement attendu. Une cellule prévue pour contenir 200 observations peut absorber un écart de 10 sans problème. Une cellule prévue pour en contenir 5 ne le peut pas, et la division par E reflète directement cette différence.
Calcul de la statistique du test du chi carré
Les effectifs théoriques découlent de l'hypothèse nulle, et non d'un nombre rond choisi par commodité. Dans un tableau de contingence, l'effectif théorique d'une cellule est égal au total de sa ligne multiplié par le total de sa colonne, divisé par le total général. Cette formule découle directement de l'hypothèse d'indépendance. Si deux variables sont véritablement indépendantes, la proportion d'une colonne dans une ligne donnée doit correspondre à la part de cette ligne dans le tableau.
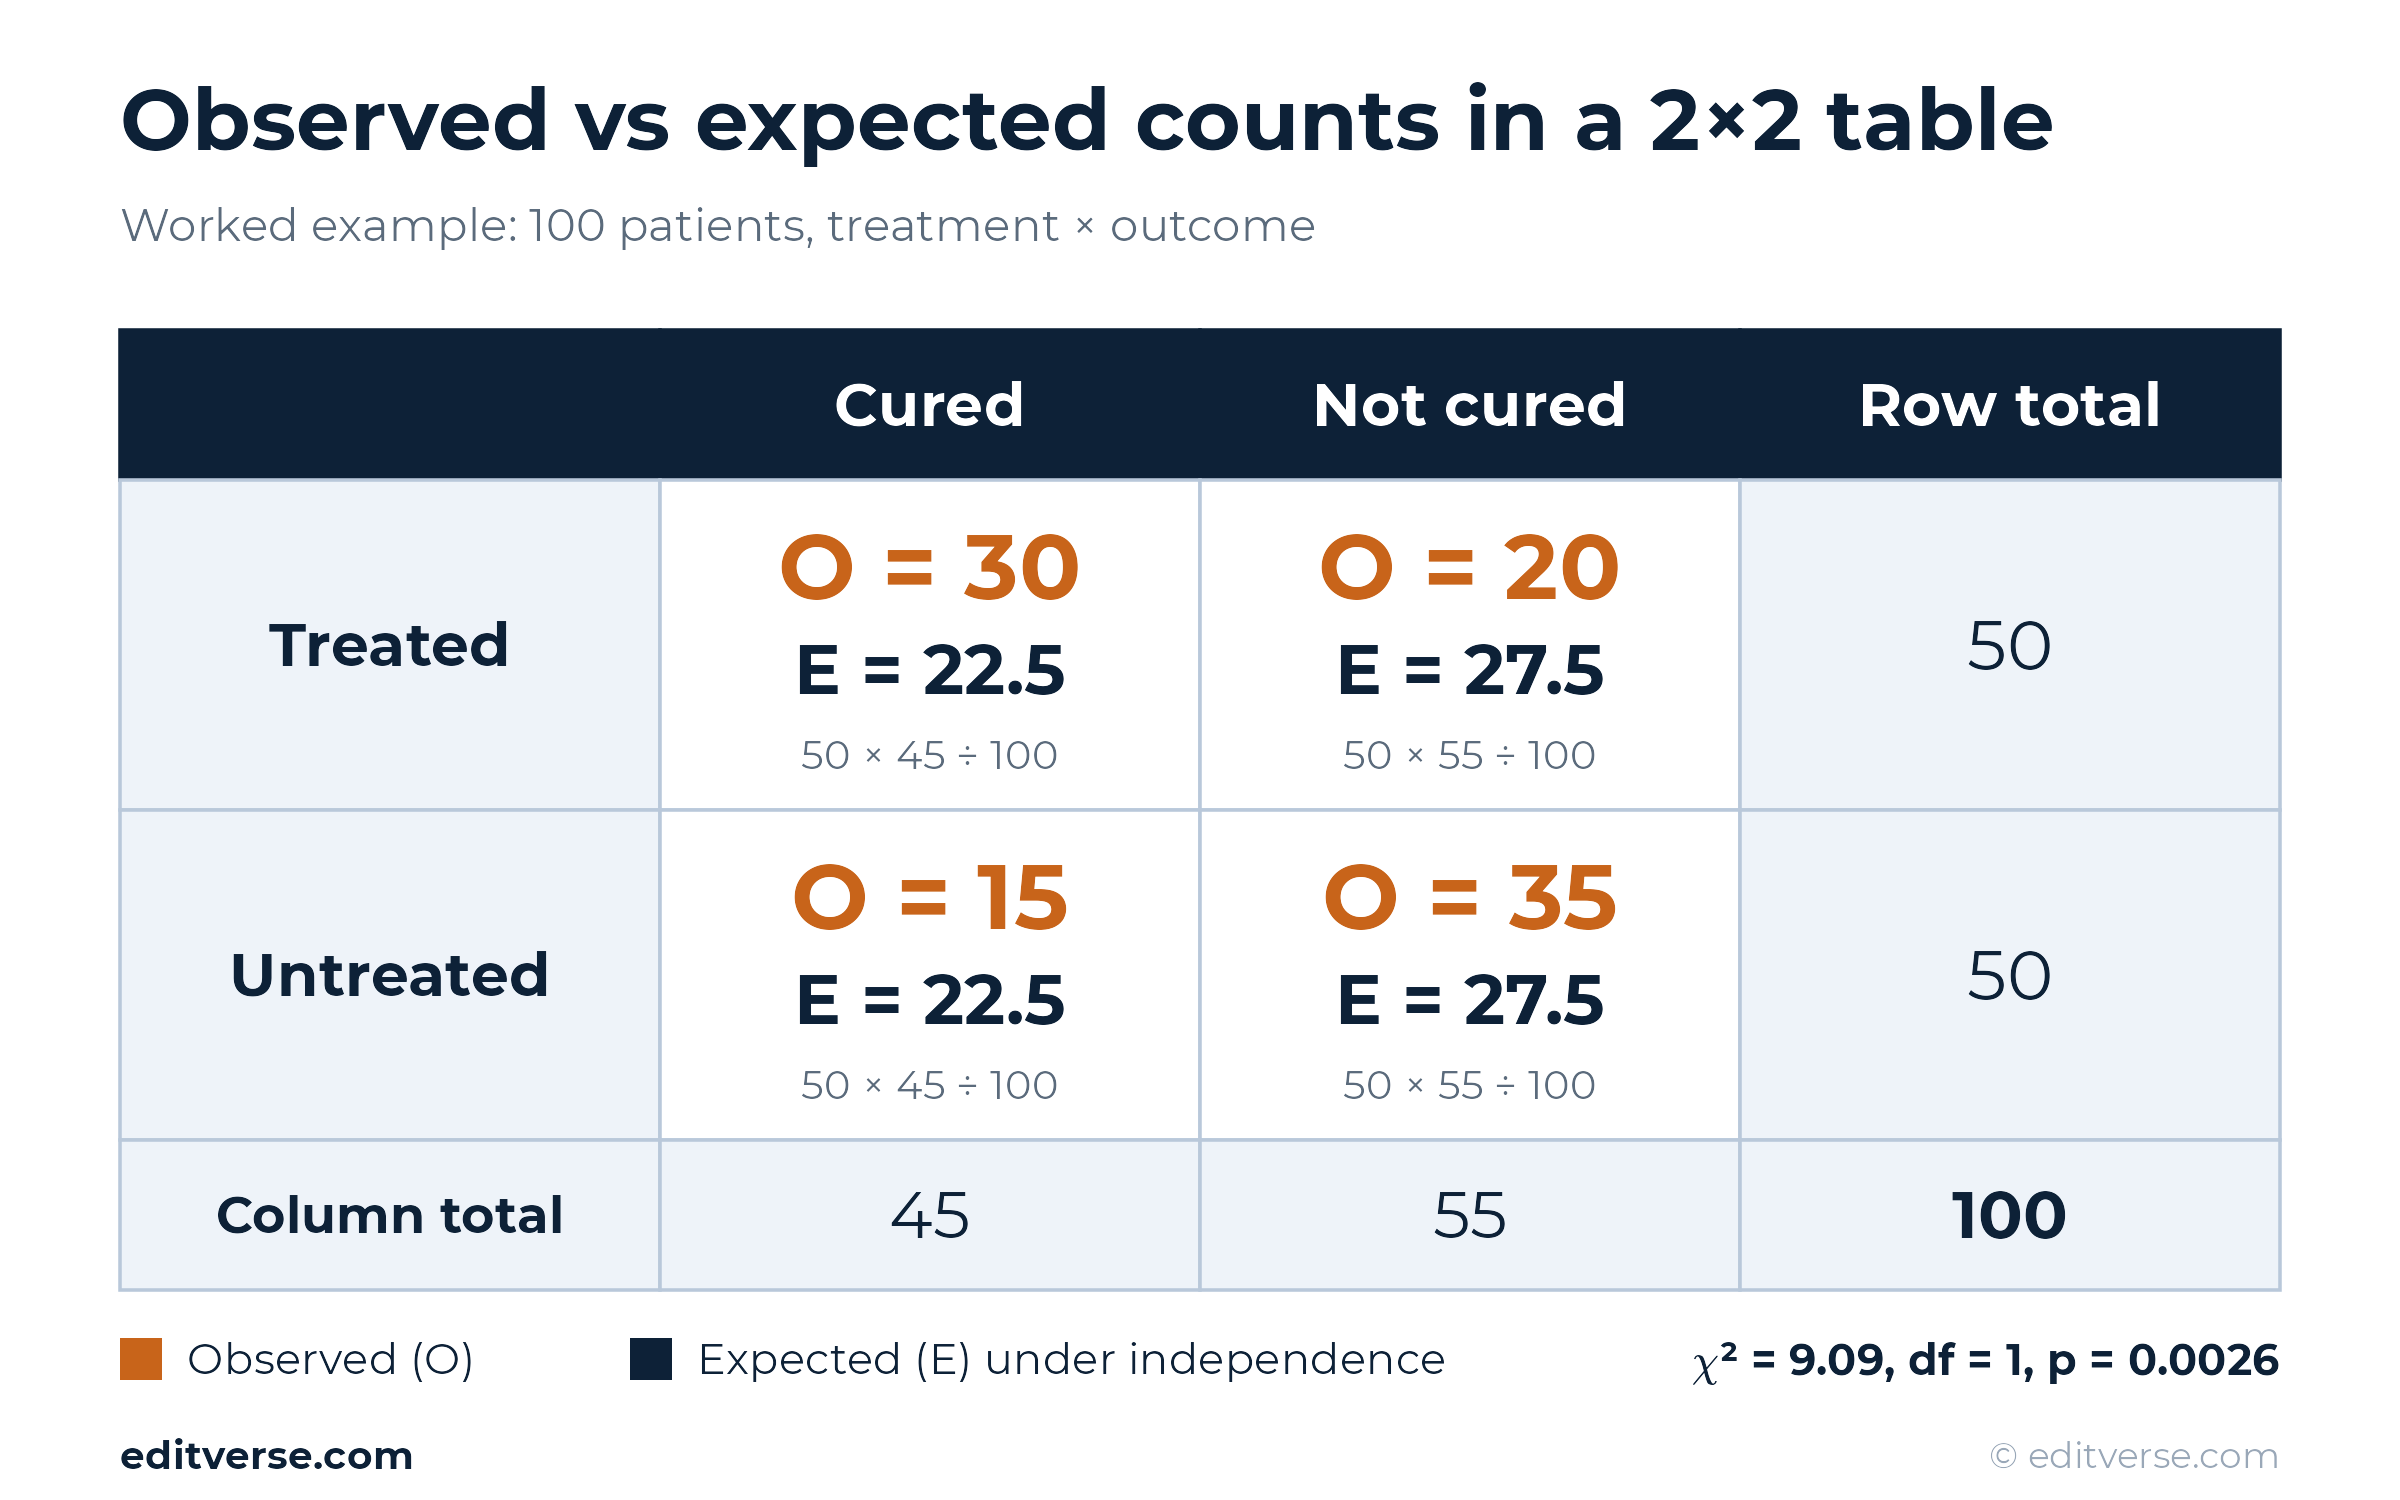
Un exemple simple permet de concrétiser ce concept. Supposons que 100 patients soient répartis en 50 groupes traités et 50 groupes non traités, et que parmi les 100 patients traités, 45 soient finalement considérés comme guéris et 55 comme non guéris. En supposant l'indépendance des groupes, le taux de guérison devrait être le même (45 %) que dans le groupe non traité. Le nombre attendu de patients guéris parmi les patients traités est donc de 50 × 45 ÷ 100, soit 22.5. Les effectifs attendus ne sont pas nécessairement des nombres entiers ; seuls les effectifs observés le sont.
Les effectifs théoriques d'adéquation fonctionnent de la même manière, mais sont calculés à partir d'une proportion hypothétique plutôt que d'une seconde variable. Tester si 200 cas de maladie se répartissent uniformément sur quatre saisons revient à fixer l'effectif théorique de chaque saison à 200 × 0.25, soit 50. Le test mesure ensuite l'écart entre les effectifs saisonniers réels et cette valeur théorique.
Degrés de liberté dans un test du chi carré
Les degrés de liberté déterminent la forme de la distribution du chi carré. Une valeur de degrés de liberté incorrecte est facile à négliger lors de la rédaction des résultats ; or, elle modifie la valeur critique à laquelle la statistique est comparée et peut faire basculer une conclusion limite de significative à non significative, et inversement. Pour un tableau de contingence à r lignes et c colonnes, les degrés de liberté sont égaux à (r − 1)(c − 1). Un tableau 2×2 standard possède donc exactement un degré de liberté, car une fois les totaux des lignes et des colonnes fixés, une seule cellule peut varier librement avant que les autres ne s'annulent par soustraction.
Les degrés de liberté d'ajustement suivent une règle similaire mais distincte. Ils sont égaux au nombre de catégories moins un, moins un degré supplémentaire pour chaque paramètre estimé à partir de l'échantillon plutôt que fixé a priori. Tester quatre saisons par rapport à une attente fixe de 25 % utilise 4 − 1 = 3 degrés de liberté, puisqu'aucune estimation n'a été effectuée à partir des données. Tester les effectifs génotypiques par rapport aux proportions de Hardy-Weinberg est plus complexe, car la fréquence allélique utilisée pour calculer les proportions génotypiques attendues est elle-même estimée à partir de ce même échantillon, et cette étape d'estimation introduit un degré de liberté supplémentaire par rapport à la simple règle du nombre moins un.
Test du Chi-carré d'indépendance : un exemple détaillé
Prenons l'exemple d'une étude comparative à deux groupes portant sur 100 patients : 50 ayant reçu un traitement et 50 n'en ayant pas reçu. Les données sont croisées avec une variable binaire indiquant la guérison ou l'absence de guérison. Ce jeu de données précis est également utilisé comme exemple dans le calculateur de test du chi carré d'Editverse ; chaque étape ci-dessous peut donc être reproduite instantanément.
| Guéri | Non guéri | Total de la ligne | |
|---|---|---|---|
| Traités | 30 | 20 | 50 |
| Non traité | 15 | 35 | 50 |
| Total de la colonne | 45 | 55 | 100 |
Les effectifs théoriques suivent la règle du total de la ligne multiplié par le total de la colonne, comme indiqué dans la section précédente. Pour les patients traités et guéris, l'effectif théorique est de 50 × 45 ÷ 100 = 22.5. Pour les patients traités mais non guéris, l'effectif théorique est de 50 × 55 ÷ 100 = 27.5. Pour les patients non traités et guéris, l'effectif théorique est de 50 × 45 ÷ 100 = 22.5. Pour les patients non traités mais non guéris, l'effectif théorique est de 50 × 55 ÷ 100 = 27.5. Chaque effectif théorique dépasse le seuil de Cochran de 5 ; l'approximation du χ² ordinaire s'applique donc sans restriction.
Chaque cellule contribue alors (O − E)² ÷ E au total. Les cellules traitées et guéries contribuent à hauteur de (30 − 22.5)² ÷ 22.5 = 2.500. Les cellules traitées mais non guéries contribuent à hauteur de (20 − 27.5)² ÷ 27.5 = 2.045. Les cellules non traitées et guéries contribuent à hauteur de (15 − 22.5)² ÷ 22.5 = 2.500. Les cellules non traitées mais non guéries contribuent à hauteur de (35 − 27.5)² ÷ 27.5 = 2.045. La somme de ces quatre contributions donne χ² = 9.091 pour 1 degré de liberté, ce qui correspond à p = 0.0026, largement inférieur au seuil conventionnel de 0.05. L'application de la correction de continuité de Yates, détaillée plus loin, abaisse la statistique à 7.919 (p = 0.0049) ; un test exact de Fisher réalisé indépendamment sur le même tableau donne p = 0.0046. Ces trois méthodes convergent vers l'hypothèse d'une association entre le traitement et le résultat, soit précisément le type de triangulation qu'un relecteur de manuscrit souhaite trouver dans la section des résultats.
La signification statistique seule ne permet pas de quantifier la force de l'association. Les chances de guérison sont de 30 à 20 chez les patients traités, contre 15 à 35 chez les patients non traités, soit un odds ratio de (30 × 35) ÷ (20 × 15) = 3.5. Le V de Cramér, une mesure de l'effet basée sur le test du χ² et comprise entre 0 et 1 pour un tableau 2×2, est égal à la racine carrée de (9.091 ÷ 100), soit 0.30, ce qui, selon les critères conventionnels, indique une association d'intensité faible à moyenne. Présenter la p-valeur à côté de l'odds ratio et du V de Cramér, plutôt que la p-valeur seule, permet de distinguer une section de résultats prête à être publiée d'une section susceptible d'entraîner des interrogations de la part des relecteurs. L'analyse par McHugh d'une étude sur la vaccination en milieu de travail suit la même séquence : 23 des 92 employés non vaccinés ont développé une pneumonie à pneumocoque contre 5 des 92 vaccinés, le test du chi carré établit que la différence n'est pas due au hasard, et le V de Cramér montre ensuite à quel point elle est forte.
Tableau de contingence et fréquences attendues : un exemple réel de tableau 2×2
Un tableau de contingence croise deux variables catégorielles, et le test du χ² compare l'effectif observé de chaque cellule à sa fréquence attendue : total de la ligne × total de la colonne ÷ total général. L'essai RECOVERY a randomisé des patients hospitalisés pour Covid-19 entre un traitement par dexaméthasone à 6 mg par jour et les soins habituels, et a comptabilisé les décès survenus dans les 28 jours. Le rapport final est disponible gratuitement sur PubMed Central , et son résumé fournit tous les effectifs nécessaires : 2 104 patients sous dexaméthasone, 4 321 dans le groupe de soins habituels, et respectivement 482 et 1 110 décès.
| le Groupe | Décédé avant le 28e jour | Survécu | Total |
|---|---|---|---|
| Dexaméthasone | 482 | 1,622 | 2,104 |
| Soins habituels | 1,110 | 3,211 | 4,321 |
| Total | 1,592 | 4,833 | 6,425 |
Étape 1 : fréquences attendues
Si la dexaméthasone était sans effet, la mortalité se répartirait proportionnellement à la taille du groupe. La mortalité globale est de 1 592 sur 6 425. Le nombre de décès attendus avec la dexaméthasone est de 1 592 × 2 104 / 6 425 = 521.33 ; celui attendu avec les soins habituels est de 1 592 × 4 321 / 6 425 = 1 070,67 . On observe respectivement 482 et 1 110 décès, ce qui signifie que le nombre de décès avec la dexaméthasone est inférieur de 39.3 à la mortalité attendue et supérieur de 39.3 à celle attendue avec les soins habituels.
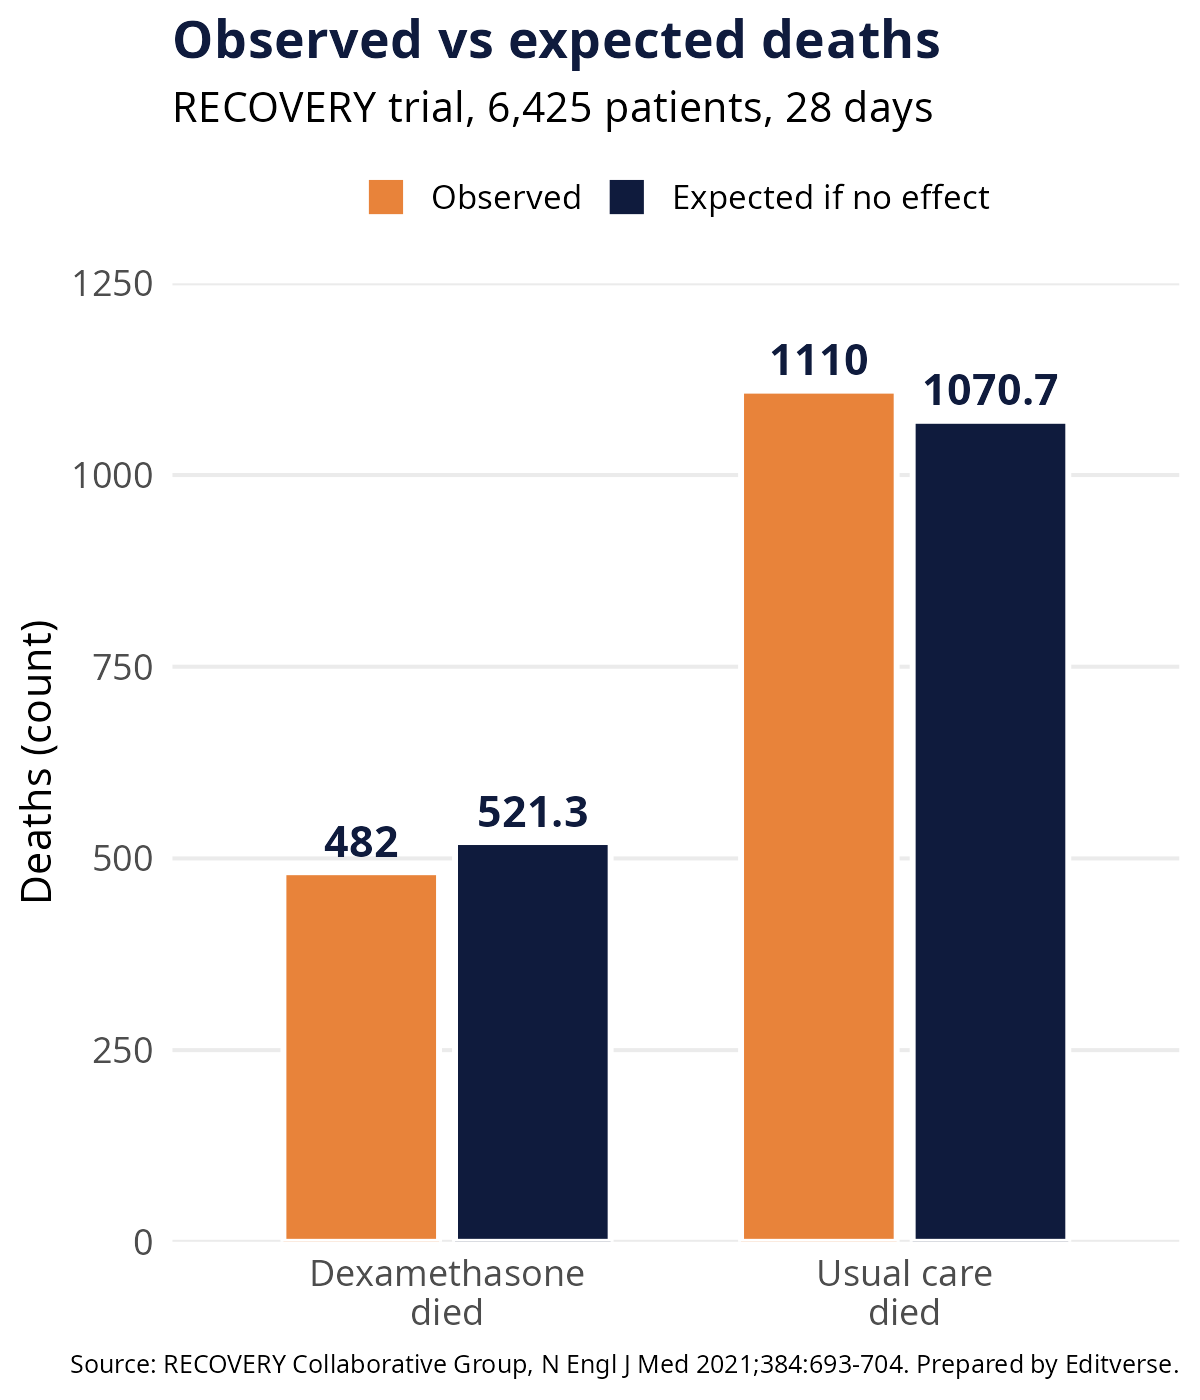
Étape 2 : la statistique de test
χ² = Σ (O − E)² / E = 5.87 à 1 degré de liberté, p = 0.015. Avec la correction de Yates, χ² = 5.72 (p = 0.017). Les résidus standardisés sont de −1.72 (dexaméthasone, décès) et +1.20 (soins habituels, décès) ; aucun n’est inférieur à ±2, donc aucune cellule ne se distingue. Tous les effectifs théoriques sont supérieurs à 500, l’approximation pour grands échantillons est donc valable. R² chisq.test et Python scipy.stats.chi2_contingency ont renvoyé des valeurs identiques.
Test d'adéquation du χ² : un deuxième exemple détaillé
Les équipes de surveillance posent souvent une question différente : non pas de savoir si deux variables sont liées, mais si la distribution de l’une d’entre elles correspond à un schéma attendu. Supposons qu’un service de santé publique enregistre 200 cas confirmés de gastro-entérite sur une année civile et souhaite déterminer si les cas se regroupent par saison ou sont répartis uniformément. Sous l’hypothèse nulle d’une distribution uniforme, sans saisonnalité, on s’attend à 50 cas pour chacune des quatre saisons (200 × 0.25 = 50 cas).
| Saison | Observé | Attendu | (O − E)² ÷ E |
|---|---|---|---|
| Hiver | 72 | 50 | 9.68 |
| Printemps | 38 | 50 | 2.88 |
| Été | 33 | 50 | 5.78 |
| Automne | 57 | 50 | 0.98 |
La somme des contributions sur les quatre saisons donne un χ² total de 19.32 pour 4 − 1 = 3 degrés de liberté, ce qui correspond à une valeur p de 0.00023. Ce résultat réfute catégoriquement l'hypothèse nulle d'une distribution uniforme. Les contributions de l'hiver (9.68) et de l'été (5.78) expliquent la majeure partie de la statistique totale, indiquant précisément où se situe l'écart. L'hiver présente une contribution nettement supérieure à celle attendue et l'été nettement inférieure, contrairement à une tendance générale où chaque saison dérive légèrement dans la même direction. Cette distinction, que la seule valeur p globale ne révèle pas, nécessite l'analyse de la contribution de chaque cellule pour être mise en évidence.
Cette structure précise se retrouve fréquemment en épidémiologie, notamment pour vérifier si les effectifs génotypiques sont conformes à l'équilibre de Hardy-Weinberg (étape de contrôle qualité du génotypage) ou si un diagnostic correspond aux proportions attendues issues d'une population de référence. Le principe reste le même : on définit les proportions nulles, on les multiplie par la taille totale de l'échantillon pour obtenir les effectifs attendus, on additionne les carrés des écarts standardisés et on compare le total à une distribution du χ² avec le même nombre de degrés de liberté.
Quand le test du Chi-carré ne fonctionne plus : effectifs théoriques faibles
La statistique du chi carré n'est jamais qu'une approximation. Sa distribution de référence suppose que les effectifs des cellules se comportent comme une variable continue, approximativement normale, pour qu'une somme discrète des carrés des écarts puisse décrire une courbe du chi carré lisse. Cette hypothèse repose sur le fait que chaque cellule présente un effectif théorique suffisamment élevé, de la même manière qu'une approximation normale d'une proportion binomiale nécessite un nombre suffisant d'essais avant de cesser de présenter des anomalies aux extrémités de la distribution. Dès que l'effectif théorique chute à 2 ou 3, les quelques valeurs que peut prendre l'effectif observé s'écartent considérablement de leur dispersion, la distribution d'échantillonnage réelle de la statistique devient irrégulière au lieu d'être lisse, et la courbe du chi carré ne la représente plus correctement.
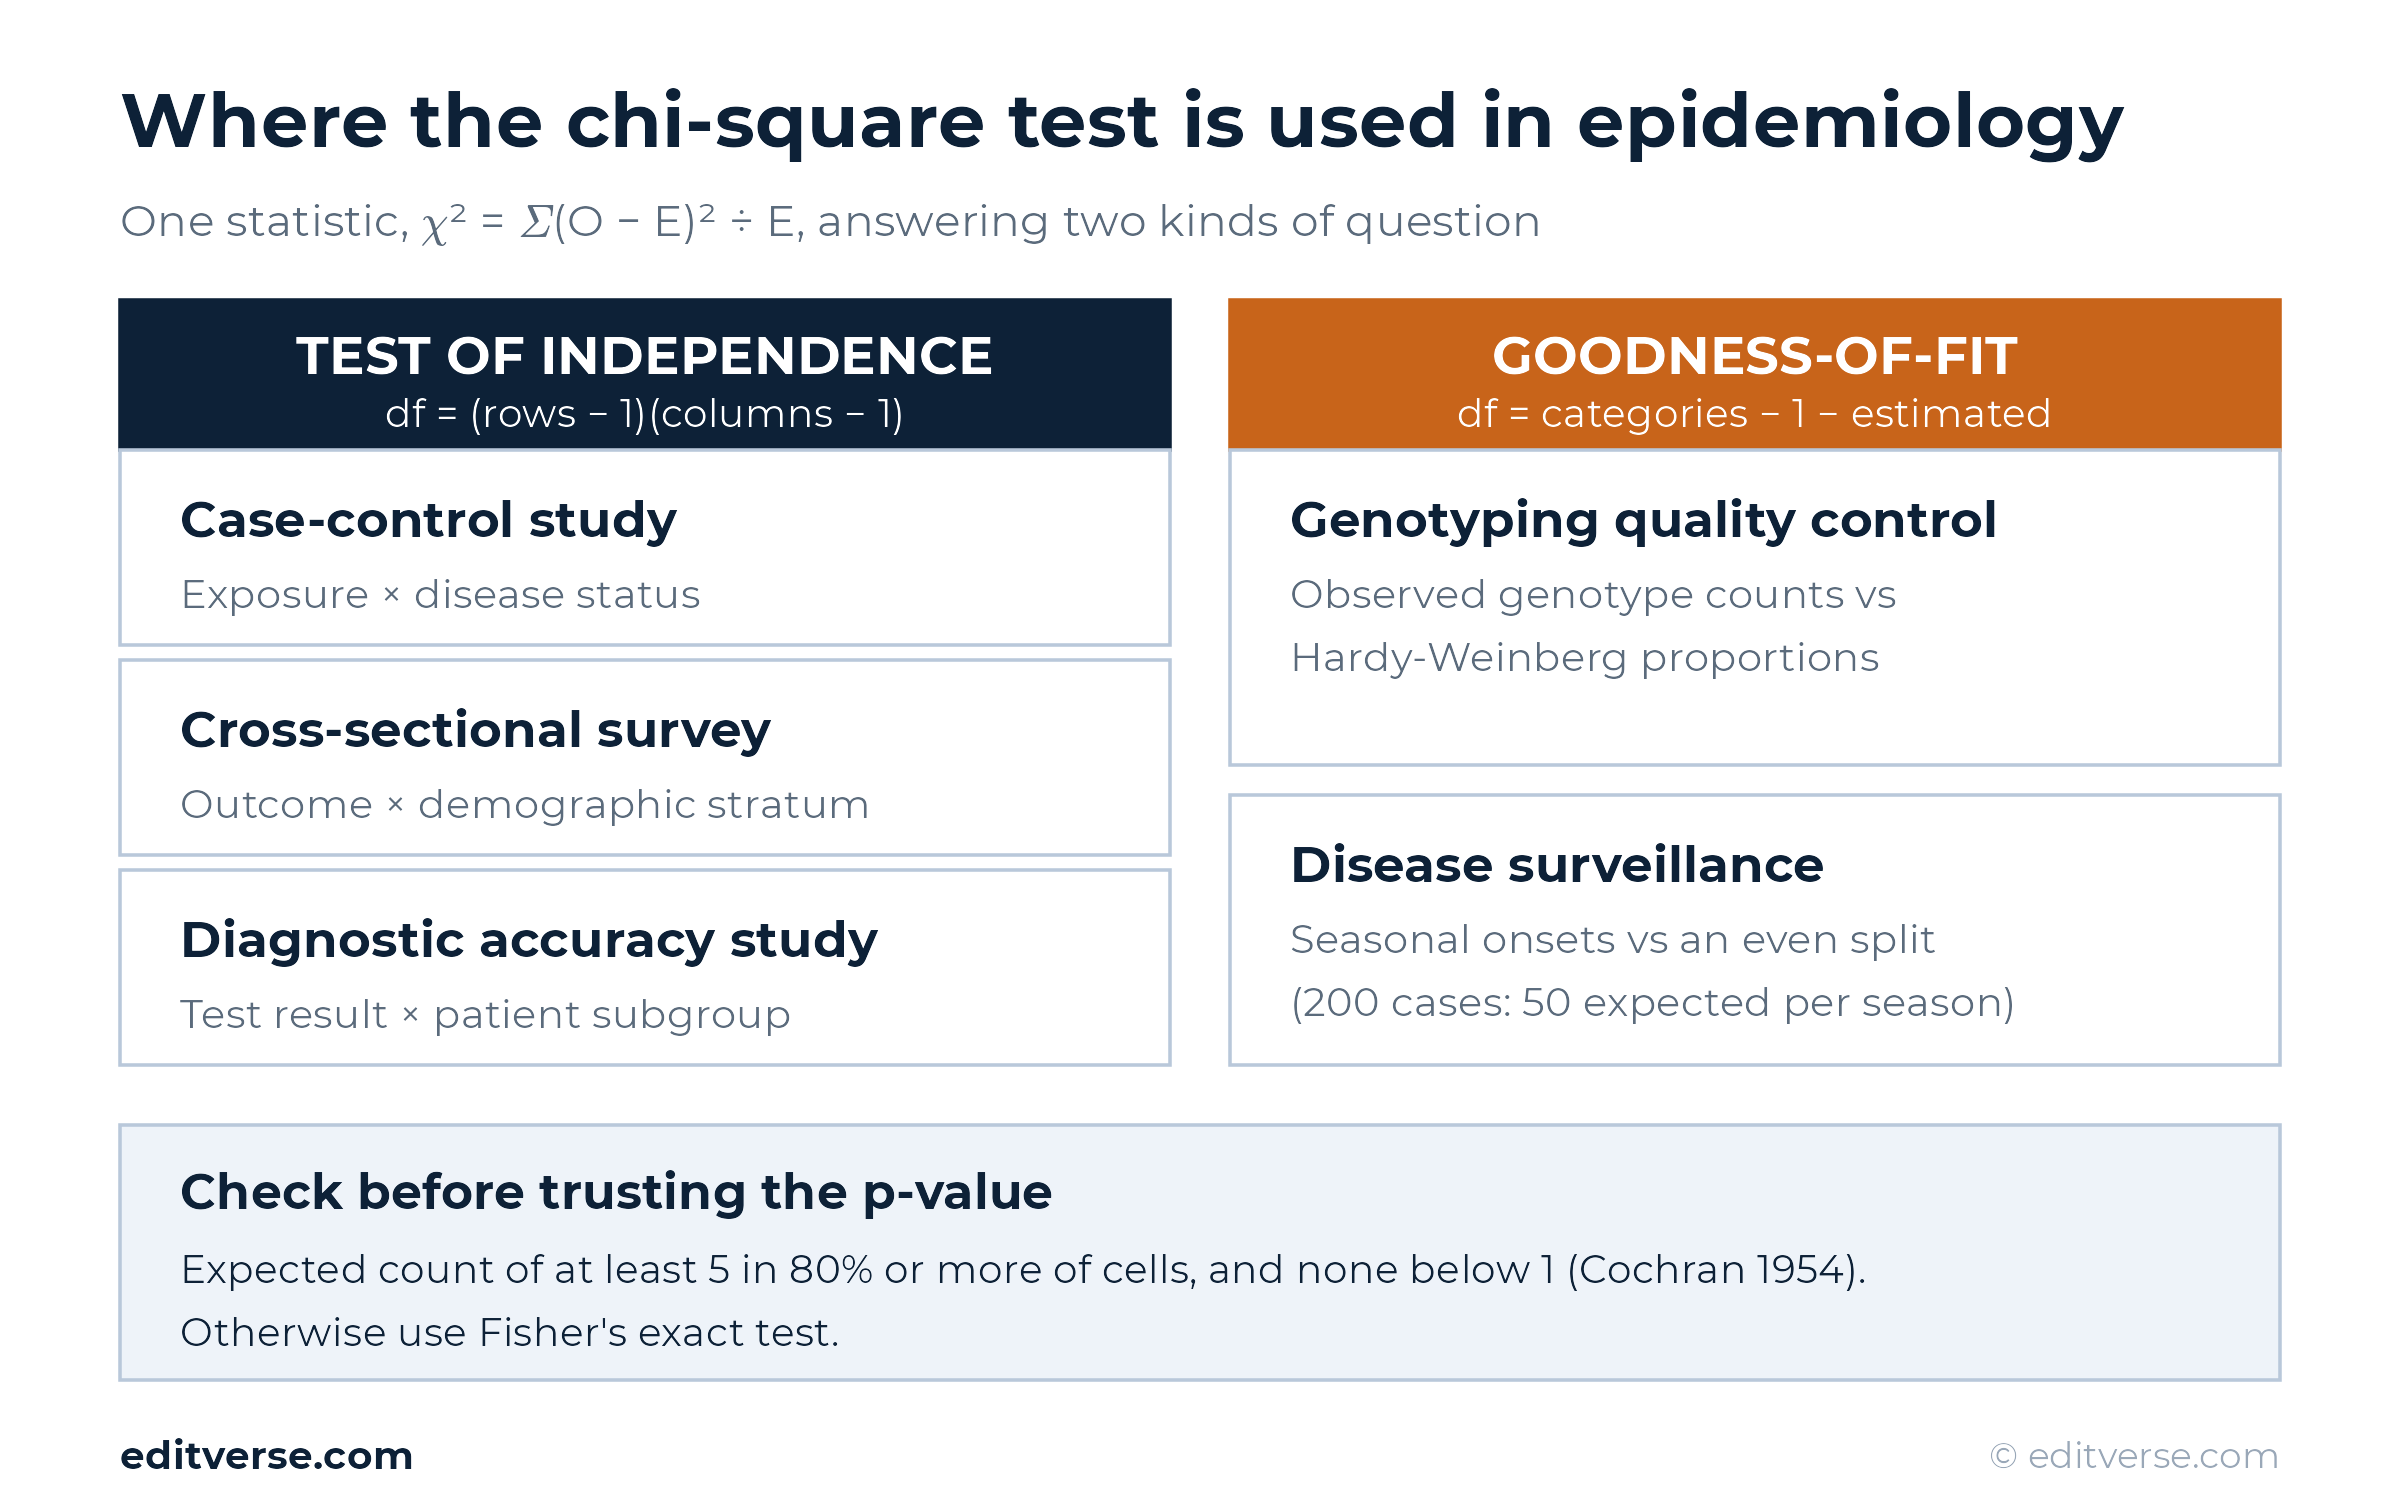
L'article de William Cochran paru en 1954 dans la revue Biometrics a transformé cette préoccupation théorique en une règle pratique encore enseignée aujourd'hui. Pas plus de 20 % des cellules ne devraient présenter un effectif théorique inférieur à 5, et aucune cellule ne devrait avoir un effectif inférieur à 1 ; si l'un ou l'autre de ces seuils est franchi, la valeur p rapportée n'est plus fiable. Les études de simulation de cette époque ont permis d'établir cette règle plutôt qu'une démonstration formelle, et des travaux ultérieurs ont confirmé cette préoccupation sous-jacente, même si le seuil exact fait débat. On peut notamment citer la littérature méthodologique sur les tests de Hardy-Weinberg, qui décrit le test d'adéquation du χ² classique comme étant très sensible aux petits échantillons ou à la fréquence des allèles rares.
Un petit tableau détaillé illustre clairement les enjeux pratiques. Prenons un tableau 2×2 avec des effectifs de 4, 1, 1 et 4, où chaque effectif théorique est égal à 2.5, largement inférieur au seuil de Cochran. La statistique du χ² non corrigée s'élève à 3.6 pour 1 degré de liberté (p = 0.058), un résultat qui pourrait laisser penser à une « tendance à la significativité ». La correction de continuité de Yates ramène ce même tableau à χ² = 1.6 (p = 0.206), et un test exact de Fisher réalisé indépendamment donne également p = 0.206, concordant presque parfaitement avec le χ² corrigé et contredisant catégoriquement la version non corrigée. Indiquer ici la p-valeur non corrigée surestimerait l'existence d'une association que le test exact ne confirme pas.
Explication de la correction de continuité de Yates
Dans un article paru en 1934 dans le Journal of the Royal Statistical Society , Frank Yates a proposé une correction pour les petits tableaux 2×2. La distribution du χ² étant continue tandis que les effectifs des cellules sont des entiers discrets, Yates a suggéré de soustraire 0.5 à la valeur absolue de chaque différence (O − E) avant de l'élever au carré. Cette correction réduit la statistique et augmente la p-valeur par rapport à la version non corrigée. Dans le petit tableau 4-1-1-4 présenté ci-dessus, cet ajustement a ramené la statistique de 3.6 à 1.6, soit précisément le type de correction nécessaire pour éviter que le test non corrigé ne surestime la significativité dans les tableaux clairsemés.
L'opportunité d'appliquer cette correction par défaut fait l'objet de débats depuis des décennies sans qu'une solution définitive n'ait été trouvée, et ce guide ne prétend pas trancher la question. L'article de Haviland, paru en 1990 dans Statistics in Medicine, soutenait que la statistique corrigée de Yates était trop conservatrice et qu'un simple test du χ² de Pearson contrôlait déjà adéquatement l'erreur de type I pour la plupart des tableaux 2×2 rencontrés par les chercheurs. Une analyse plus récente est parvenue à la conclusion inverse. L'article de Prescott, publié en 2021 dans Statistics in Medicine, recommande de tester les tableaux 2×2 en utilisant le double de la probabilité exacte unilatérale du test de Fisher, ou le χ² corrigé de Yates comme approximation, notamment pour les applications de recherche médicale. Compte tenu de ces divergences persistantes entre statisticiens rigoureux, la pratique la plus sûre consiste à indiquer la version utilisée et à privilégier le test exact de Fisher plutôt que l'une ou l'autre des variantes du χ² lorsque la taille du tableau est suffisamment réduite pour que ce choix ait une incidence.
Un essai publié illustre l'ampleur des écarts possibles entre les différentes versions. Dans l'essai sur les nitrates intraveineux utilisé par Bewick, Cheek et Ball pour illustrer les tests de tableaux de contingence , 3 des 50 patients traités et 8 des 45 sujets témoins sont décédés. Le test du χ² non corrigé donne χ² = 3.21 pour 1 degré de liberté (p = 0.073), la statistique corrigée de Yates chute à 2.16 (p = 0.141), et le test exact de Fisher, calculé en prenant le double de la probabilité unilatérale, donne p = 0.140. La version non corrigée est nettement plus proche du seuil de signification que les deux autres, ce qui justifie pleinement la mention de la version utilisée dans la section « Méthodes ».

Besoin de faire réaliser ou vérifier cette analyse ? Un biostatisticien titulaire d’un doctorat examine votre protocole d’étude, effectue l’analyse et rédige la section consacrée aux méthodes statistiques de votre manuscrit.
Test exact de Fisher : l’alternative pour les petits échantillons
Ronald Fisher a décrit l'approche exacte dans un article de 1922 paru dans le Journal of the Royal Statistical Society , s'appuyant sur la même logique des tableaux de contingence introduite par Pearson deux décennies plus tôt. Au lieu d'approximer une distribution d'échantillonnage par une courbe lisse, le test exact de Fisher fixe les totaux des lignes et des colonnes et calcule la probabilité exacte que chaque tableau possible soit au moins aussi extrême que celui observé, à l'aide de la distribution hypergéométrique. L'absence d'approximation élimine le risque de l'écart dû à la courbe lisse décrit précédemment, ce qui explique précisément pourquoi le test exact est valide là où le test du χ² classique échoue.
L'article de Sahai et Khurshid paru en 1995 dans le Journal of Biopharmaceutical Statistics détaille les compromis et souligne que le test exact peut lui-même être conservateur pour certaines configurations de tableau. Par conséquent, le passage au test exact de Fisher ne produit pas automatiquement un test plus puissant, mais seulement un test plus fiable lorsque la taille de l'échantillon est petite. Une règle de décision pratique découle directement du seuil de Cochran mentionné précédemment : effectuer le test du χ² classique lorsque chaque, ou presque chaque, effectif théorique atteint 5 ou plus, et passer au test exact de Fisher dès que cette condition n'est plus remplie, quelle que soit la taille apparente de l'échantillon global, car un total élevé peut masquer une cellule peu fournie dans un tableau déséquilibré.
Applications concrètes du test du chi carré en épidémiologie
Les recherches épidémiologiques publiées s'appuient constamment sur les tests du chi carré, presque toujours comme première étape de vérification avant une modélisation plus élaborée. Le tutoriel de biostatistiques de Hazra et Gogtay, paru dans l'Indian Journal of Dermatology, cite le chi carré de Pearson, le chi carré de McNemar pour les données binaires appariées et le chi carré de Mantel-Haenszel pour les tableaux stratifiés comme les trois variantes les plus fréquemment rencontrées par les chercheurs cliniques. Chacune est adaptée à une structure de données différente et elles ne sont pas interchangeables.
L'épidémiologie génétique utilise systématiquement le test d'adéquation du modèle comme étape de contrôle qualité. Les études de génotypage vérifient si le nombre de génotypes observés à un locus donné respecte les proportions de Hardy-Weinberg. Un écart significatif signale souvent une erreur de génotypage, une stratification de la population ou une véritable pression de sélection, plutôt qu'un résultat à interpréter sans nuance. Cette distinction est expliquée en détail dans les chapitres consacrés aux tests de Hardy-Weinberg pour les chercheurs menant des études d'association génétique. Lors d'un balayage génomique , un test de Hardy-Weinberg à un degré de liberté appliqué à 44 marqueurs a identifié 7 marqueurs présentant un excès significatif d'homozygotes apparents (χ² > 6), un profil suggérant une erreur de génotypage. Un tutoriel largement utilisé sur le tableau 2×2, publié dans Disability and Rehabilitation, analyse en détail un tableau des facteurs de risque du cancer du sein et soutient que les rédacteurs de revues devraient exiger à la fois les effectifs observés et attendus dans chaque tableau publié, et non la seule statistique de test, afin que les lecteurs puissent juger par eux-mêmes si le seuil de Cochran a été atteint.
En dehors de la génétique, le test d'indépendance est utilisé dans les études cas-témoins comparant l'exposition selon le statut pathologique, dans les enquêtes transversales comparant une variable catégorielle selon différents groupes démographiques, et dans les études diagnostiques comparant les résultats de tests entre sous-groupes de patients. Les données de surveillance sont vérifiées à l'aide du test d'adéquation dès lors qu'il est nécessaire de les comparer à un modèle attendu, saisonnier ou non, comme illustré précédemment.
Erreurs courantes dans la présentation des résultats du test du Chi-carré
Quelques erreurs se répètent aussi bien dans les manuscrits soumis que dans les articles publiés.
- Saisir des pourcentages au lieu de chiffres bruts. Les formules du chi carré fonctionnent sur les fréquences et non sur les proportions ; il est donc obligatoire, et non facultatif, de convertir un pourcentage en un nombre réel avant le test.
- Ignorer le seuil de comptage attendu. Publier une valeur p du chi carré à partir d'un tableau comportant plusieurs cellules inférieures à 5, sans reconnaître la limite ni passer au test exact de Fisher, figure parmi les erreurs statistiques les plus évitables dans ce domaine.
- Application du test d'indépendance aux données appariées. Les mesures avant-après ou les paires appariées sur les mêmes sujets violent purement et simplement l'hypothèse d'indépendance. test de McNemar existe précisément pour cette situation.
- Présenter une signification statistique sans indiquer la taille de l'effet. Une valeur p confirme l'existence d'une association. La question de savoir si cette association est suffisamment importante pour avoir une incidence clinique est distincte ; on peut alors utiliser le V de Cramér, le phi ou un rapport de cotes appartient à côté de chaque résultat du chi carré.
- Se tromper sur les degrés de liberté. Une valeur incohérente est facilement repérable par un statisticien et indique que l'analyse n'a pas été vérifiée avec soin avant sa soumission.
Comment présenter un test du chi carré dans votre manuscrit
La plupart des revues en sciences de la santé suivent une version du même modèle de présentation. Indiquez le nom du test, les degrés de liberté entre parenthèses, la taille de l'échantillon, la statistique et la p-valeur, dans cet ordre, par exemple : « χ²(1, N = 100) = 9.09, p = 003 ». Précisez ensuite la taille de l'effet et, pour un tableau 2×2, le rapport de cotes ou le risque relatif avec son intervalle de confiance. Un guide largement utilisé sur les erreurs d'interprétation statistique, publié dans l'European Journal of Epidemiology, souligne qu'une p-valeur seule, sans intervalle de confiance, peut amener les lecteurs à surinterpréter la signification statistique en la qualifiant de forte ou importante.
Un tableau de résultats doit présenter les effectifs observés pour chaque cellule, et non uniquement les pourcentages, afin qu'un lecteur attentif puisse recalculer le test indépendamment. La section « Méthodes » doit préciser la correction appliquée, le cas échéant (correction de Pearson non corrigée, correction de Yates ou correction exacte de Fisher), ainsi que le logiciel et sa version. Les chercheurs qui comparent encore le test du χ² à d'autres options pour une analyse plus globale pourront également consulter le guide d'Editverse sur le choix du test statistique approprié pour les parties du manuscrit qui ne concernent pas des données catégorielles.
Besoin d'aide d'experts pour votre analyse statistique ?
Les biostatisticiens d'Editverse créent des tableaux de contingence, choisissent judicieusement entre le test du χ² et le test exact de Fisher, et fournissent des résultats prêts à être publiés avec des fichiers R entièrement reproductibles. Commencez par effectuer vos calculs avec le calculateur gratuit de test du χ² , ou transmettez directement vos données brutes via le service Just Data pour une analyse complète, la rédaction de votre article et l'accompagnement à la soumission à une revue scientifique.
Conclusion
Pour réaliser correctement un test du χ², il ne suffit pas d'appliquer une formule. Les effectifs théoriques doivent découler d'une hypothèse nulle clairement énoncée, les degrés de liberté doivent correspondre à la forme réelle du tableau, et le choix entre le test du χ² classique, sa version corrigée par la méthode de Yates et le test exact de Fisher doit être guidé par la taille de la plus petite cellule attendue, et non par habitude. Les deux tableaux détaillés ci-dessus, vérifiés à chaque étape à l'aide d'un logiciel statistique indépendant, montrent à quel point un résultat peut varier lorsque les effectifs théoriques sont faibles, et pourquoi une p-valeur copiée directement du logiciel sans vérification préalable ne donne qu'une interprétation partielle.
Les données catégorielles de ce type sont au cœur des études cas-témoins, des articles sur la précision diagnostique et des travaux d'association génétique ; c'est précisément pourquoi les relecteurs de manuscrits examinent ce test avec une telle attention. Bien formuler les hypothèses dès le départ et indiquer la taille de l'effet ainsi que la valeur p permet d'éviter les demandes de révision avant même la rédaction du manuscrit.
Outils gratuits pour votre analyse
- GraphProGraphiques prêts à publier avec valeurs p du test du chi carré intégrées. Gratuit, sans inscription.
- StatPro: des calculateurs statistiques gratuits et un sélecteur de tests pour les résultats catégoriels.
- Flowchart Pro: Diagrammes de flux CONSORT, STROBE et PRISMA dans votre navigateur.
QFP
À quoi sert un test du chi carré ?
Un test du chi carré vérifie si les effectifs observés par catégorie diffèrent des effectifs attendus sous une hypothèse nulle, soit parce que deux variables catégorielles sont liées (test d'indépendance), soit parce que la distribution d'une variable ne correspond pas à un modèle établi (test d'adéquation).
Quelle est la formule du test du chi carré ?
χ² = Σ (O − E)² / E, où O est le nombre observé de chaque cellule, E est le nombre attendu de cette cellule sous l'hypothèse nulle, et la somme s'étend sur chaque cellule du tableau.
Combien de degrés de liberté possède un test du chi carré ?
Un tableau de contingence a (lignes − 1) × (colonnes − 1) degrés de liberté, donc un tableau 2×2 en a exactement 1. Un test d'adéquation a le nombre de catégories moins 1, moins un de plus pour chaque paramètre estimé à partir de l'échantillon.
Quand dois-je utiliser le test exact de Fisher plutôt que le test du chi carré ?
Passez au test exact de Fisher lorsque plus de 20 % des cellules d'un tableau ont un nombre attendu inférieur à 5, ou lorsqu'une seule cellule a un nombre attendu inférieur à 1, conformément aux recommandations de Cochran de 1954.
Dois-je toujours appliquer la correction de continuité de Yates ?
Les statisticiens sont partagés. Certaines données suggèrent que la correction est trop conservatrice pour les grands tableaux 2×2, tandis que d'autres travaux récents la recommandent, ou un test exact équivalent, notamment pour la recherche médicale. Indiquer la version utilisée est plus important que de choisir une valeur par défaut universelle.
Quelle est la différence entre le test du chi carré d'indépendance et le test d'adéquation ?
Le test d'indépendance compare deux variables catégorielles entre elles dans un tableau de contingence. Le test d'adéquation compare la distribution observée d'une variable à une distribution prédéfinie.
Un résultat significatif au test du chi carré m'indique-t-il la force de l'association ?
Non. La significativité indique seulement qu'une association a peu de chances d'être due au hasard au seuil alpha choisi. La force de l'association requiert une mesure de l'effet distincte, comme le V de Cramér, le phi ou un rapport de cotes.
Les tests du chi carré peuvent-ils être utilisés sur des données continues ?
Pas directement. Les mesures continues nécessitent d'abord un regroupement en catégories, ce qui entraîne une perte d'informations ; par conséquent, un test t, une ANOVA ou un modèle de régression est généralement préférable lorsque la variable dépendante est véritablement continue.
Références
- Pearson K. Sur le critère selon lequel un système donné d'écarts par rapport au probable dans le cas d'un système de variables corrélées est tel qu'il peut être raisonnablement supposé provenir d'un échantillonnage aléatoire. Philos Mag. 1900;50(302):157–175. est ce que je.org/10.1080/14786440009463897
- Fisher RA. Sur l'interprétation du χ² à partir des tableaux de contingence et le calcul de P. JR Stat Soc. 1922;85(1):87–94. est ce que je.org/10.2307/2340521
- Yates F. Tableaux de contingence impliquant de petits nombres et le test χ². Supplément JR Stat Soc. 1934;1(2):217–235. est ce que je.org/10.2307/2983604
- Cochran WG. Quelques méthodes pour renforcer les tests χ² courants. Biométrie. 1954;10(4):417–451. est ce que je.org/10.2307/3001616
- Haviland MG. Correction de Yates pour la continuité et l'analyse des tableaux de contingence 2 x 2. Stat Med. 1990;9(4):363–367. PMID 2362976
- Prescott RJ. Tests de signification bilatéraux pour les tableaux de contingence 2 x 2. Quelle est l'alternative ? Stat Med. 2021;38(22):4264–4269. PMID 31264237
- Sahai H, Khurshid A. Sur l'analyse des données épidémiologiques impliquant un tableau de contingence 2 x 2, un aperçu du test exact de Fisher et de la correction de continuité de Yates. J Biopharm Stat. 1995;5(1):43–70. PMID 7613560
- Hazra A, Gogtay N. Module 4 de la série Biostatistiques, comparaison de groupes, variables catégorielles. Indien J Dermatol. 2016;61(4):385–392. PMID 27512183
- Wang J, Shete S. Test de l'écart par rapport aux proportions de Hardy-Weinberg. Méthodes Mol Biol. 2012;850:77–102. PMID 22307695
- Rigby AS. Méthodes statistiques en épidémiologie. VII. Aperçu du test du chi2 pour l'analyse des tableaux de contingence 2 x 2. Réadaptation pour personnes handicapées. 2002;23(16):693–697. PMID 11732558
- Greenland S, Senn SJ, Rothman KJ, et al. Tests statistiques, valeurs P, intervalles de confiance et puissance, un guide des erreurs d'interprétation. Eur J Epidemiol. 2016;31(4):337–350. PMID 27209009
- Groupe de collaboration RECOVERY. Dexaméthasone chez les patients hospitalisés atteints de Covid-19. N Engl J Med. 2021;384(8):693–704. est ce que je.org/10.1056/NEJMoa2021436
- Bewick V, Cheek L, Ball J. Revue de statistiques 8 : données qualitatives, tests d'association. Soins critiques. 2004;8(1):46–53. PMID 14975045
- McHugh ML. Le test du chi carré d'indépendance. Biochimie médicale. 2013;23(2):143–149. PMID 23894860
- Gomes I, Collins A, Lonjou C, et al. Contrôle de la qualité de Hardy-Weinberg. Anne Hum Genet. 1999;63(6):535–538. PMID 11246455