
Udgivet
SYRCLE -værktøjet til risiko for bias er en udbredt metode til at vurdere intern validitet i en systematisk gennemgang af dyreinterventionsstudier. Det har ti poster, der dækker selektion, performance, detektion, frafald og rapporteringsbias plus en samlebedømmelse for andre problemer, og hver post vurderes som lav, høj eller uklar. Denne vejledning forklarer hver post, sammenligner værktøjet med CAMARADES-kvalitetstjeklisten og anvender derefter de ti poster på en reel open access-metaanalyse af prækliniske studier offentliggjort i 2026. Vi udleder dens procentdele fra tabellen pr. studie, navngiver afsnittet bag hver række og markerer de punkter, som to omhyggelige anmeldere kunne score forskelligt.
Værktøjet blev udgivet af Hooijmans og kolleger i BMC Medical Research Methodology i 2014 som en tilpasning af Cochrane-værktøjet til risiko for bias til randomiserede forsøg . Fire af dets seks forfattere var baseret på SYRCLE, Systematic Review Centre for Laboratory animal Experimentation ved Radboud University Medical Center i Nijmegen, hvilket giver værktøjet sit navn. Vores ARRIVE 2.0-vejledning dækker, hvad forfattere af dyreforsøg bør rapportere. Denne vejledning dækker den anden side af skrivebordet, hvilket er hvordan en anmelder vurderer, hvad der blev rapporteret.
Med simple ord
SYRCLE-værktøjet til risiko for bias er en tjekliste med ti spørgsmål, som en anmelder udfylder for hvert dyreforsøg i en systematisk gennemgang. Hvert spørgsmål spørger, om et trin, der beskytter mod bias, såsom tilfældig allokering, skjult allokering eller blindet resultatvurdering, blev udført tydeligt. Svaret er lav risiko, høj risiko eller uklar risiko. De fleste dyreartikler siger for lidt, så mange svar er uklare, og det mønster er i sig selv en konstatering. Nedenfor forklares de ti spørgsmål og kontrolleres derefter mod en publiceret metaanalyse, så du kan se, hvordan en udfyldt tabel ser ud, og hvor vurderingerne trænger til et nyt kig.
Hvad SYRCLE-værktøjet for risiko for bias måler
Værktøjet bevarer logikken i Cochrane-tilgangen og ændrer spørgsmålene, så de passer til dyreforsøg. Forfatterne sorterede de ti poster under seks typer af bias. Udvælgelsesbias har tre poster, præstationsbias har to, detektionsbias har to, og frafaldsbias, rapporteringsbias og anden bias har én hver. Ifølge forfatternes optælling stemmer fem ud af de ti poster overens med Cochrane-værktøjet, nemlig sekvensgenerering, allokeringsskjulning, ufuldstændige resultatdata, selektiv resultatrapportering og andre kilder til bias. De resterende fem afspejler, hvordan dyreforsøg adskiller sig fra kliniske forsøg, for eksempel husning af dyr i delte rum, fremkaldelse af sygdom før eller efter allokering og udvælgelse af dyr til resultatvurdering.
Hvert bidrag kommer med signalspørgsmål, som anmelderen svarer ja, nej eller uklart på. Et ja peger på lav risiko, et nej peger på høj risiko, og uklart betyder, at rapporten ikke giver tilstrækkelig information. Hvis et relevant signalspørgsmål for et bidrag besvares nej, vurderes det højt. Anmelderne bliver også bedt om, inden de starter, at beslutte, hvilke baselinekarakteristika og hvilke elementer med anden bias der er vigtige for deres eget anmeldelsesspørgsmål, fordi værktøjet bevidst lader disse stå åbne.
Én instruktion er let at overse. Værktøjets forfattere skriver: "Vi anbefaler ikke at beregne en opsummerende score for hvert enkelt studie, når dette værktøj bruges." Enhver score ville kræve vægte for domænerne, og disse vægte er svære at forsvare. Værktøjet er beregnet til at give en profil på ti vurderinger pr. studie, som en review derefter bruger i følsomhedsanalyse og når den vurderer evidenssikkerheden. For forsøg på mennesker er det nuværende Cochrane-værktøj RoB 2, som vi dækker i vores RoB 2-guide og, til anvendelser i forsøgsreviews, i vores guide til Cochrane RoB 2.0 i forsøg . For forudsigelsesmodeller er matchningsværktøjet PROBAST, som forklares i vores PROBAST-guide.
De 10 elementer i SYRCLE-værktøjet til risiko for bias – et overblik
| Indgang | Bias-type | Navn på indtastning | Hvad anmelderen spørger om | Markeret som matchende Cochrane-værktøjet |
|---|---|---|---|---|
| 1 | Udvælgelse bias | Sekvensgenerering | Blev allokeringssekvensen genereret med en tilfældig komponent og anvendt som planlagt? | Ja |
| 2 | Udvælgelse bias | Basiskarakteristika | Var grupperne ens i starten, eller blev analysen justeret, og blev sygdommen induceret på et sammenligneligt tidspunkt? | Ingen |
| 3 | Udvælgelse bias | Skjulning af allokering | Kunne den person, der tildeler dyr, have forudset den næste tildeling? | Ja |
| 4 | Præstationsbias | Tilfældig bolig | Var bure eller dyr placeret tilfældigt i rummet eller anlægget? | Ingen |
| 5 | Præstationsbias | Blinding af omsorgspersoner og undersøgere | Var de mennesker, der passede og behandlede dyrene, ikke klar over hvert dyrs gruppe, og var det usandsynligt, at blændingen ville bryde? | Ingen |
| 6 | Detektionsbias | Tilfældig resultatvurdering | Blev dyrene udvalgt tilfældigt, da resultaterne blev vurderet? | Ingen |
| 7 | Detektionsbias | Blinding af resultatvurderere | Var assessoren uvidende om gruppen, eller er det usandsynligt, at resultatet vil blive påvirket af at kende den? | Ingen |
| 8 | Frafaldsbias | Ufuldstændige resultatdata | Blev alle dyr analyseret, og blev manglende data forklaret, afbalanceret på tværs af grupper og håndteret fornuftigt? | Ja |
| 9 | Rapportering skævhed | Selektiv resultatrapportering | Blev alle forudspecificerede resultater rapporteret, bedømt ud fra en protokol eller ud fra metoder og resultater? | Ja |
| 10 | Anden bias | Andre kilder til bias | Var studiet fri for kontaminering, finansieringsindflydelse, fejl i analyseenheden, designspecifikke risici og erstattede frafald? | Ja |
Sådan bedømmer du de ti bidrag i praksis
Udvælgelsesbias, poster 1 til 3
Post 1 spørger, om allokeringssekvensen havde en ægte tilfældig komponent, såsom en tilfældig taltabel eller en computergenerator. Allokering efter undersøgers præference, efter et laboratorieresultat, efter tilgængelighed eller efter dyr- eller burnummer tæller som ikke-tilfældig. Post 2 spørger, om grupperne lignede hinanden i starten. Værktøjet tilføjer en anden test for dyrearbejde, som er, om sygdommen blev induceret på et sammenligneligt tidspunkt i hver gruppe. Post 3 spørger, om den person, der allokerer dyr, kunne have forudset den næste tildeling. Tredjepartskodning, central randomisering og sekventielt nummererede, uigennemsigtige forseglede kuverter beskytter allokering, mens åbne tidsplaner og alternering ikke gør.
Ydelses- og detektionsbias, poster 4 til 7
Punkt 4 er specifikt for dyrearbejde. Det spørger, om bure eller dyr blev placeret tilfældigt i rummet, fordi hyldeplacering, lys og støj kan variere på tværs af et anlæg. Værktøjet accepterer identiske opstaldningsregler, såsom grupper, der deler et bur, og behandler grupper, der holdes i forskellige rum eller på forskellige hylder, som et advarselstegn. Punkt 5 spørger, om omsorgspersoner og forskere ikke var klar over hvert dyrs behandling, og om denne blinding sandsynligvis ville holde. Farvede burmærker, synlige lægemiddeleffekter og én person, der forbereder og udfører eksperimentet, svækker det alle, og værktøjet forbinder punkt 5 tilbage til opstaldningsreglerne i punkt 4.
Post 6 spørger, om dyrene blev udvalgt tilfældigt til resultatvurdering, for eksempel med en tilfældig talgenerator. Post 7 spørger, om vurdereren var blindet. For post 7 accepterer værktøjet en ublindet vurderer, når resultatet sandsynligvis ikke vil blive påvirket, f.eks. dødelighed, og det angiver, at posten skal bedømmes for hvert hovedresultat.
Frafald, rapportering og anden bias, poster 8 til 10
Post 8 spørger, om alle dyr, der deltog i analysen, om årsagerne til manglende data ikke var relateret til resultatet, om manglende data var afbalanceret på tværs af grupper, og om en eventuel imputation var passende. Post 9 spørger, om en protokol var tilgængelig, og om alle forudspecificerede resultater blev rapporteret, eller, uden en protokol, om afsnittene om metoder og resultater viser, at alle forventede resultater forekom. Post 10 indsamler resten, inklusive poolede eller kontaminerende lægemidler, upassende indflydelse fra finansieringskilder, fejl i analyseenheden, såsom dyr i bur sammen, men analyseret som uafhængige, designspecifikke risici og nye dyr tilføjet for at erstatte frafaldne dyr.
SYRCLE risiko for bias-værktøj vs. CAMARADES kvalitetstjekliste
CAMARADES er Collaborative Approach to Meta-Analysis and Review of Animal Data from Experimental Studies, et forskningssamarbejde med base på University of Edinburgh . Dets kvalitetstjekliste med ti punkter kan generelt spores tilbage til metaanalyser af slagtilfælde. Macleod og kolleger rapporterede i Stroke i 2004, at studier, der scorede højt på et kvalitetsmål, gav mere præcise estimater af den globale effekt. Eksempelanmeldelsen nedenfor citerer tjeklisten som Sena og kolleger 2007. Denne anmeldelse, Qu og kolleger , scorer fagfællebedømt publikation, temperaturkontrol, tilfældig allokering, blindet modelinduktion, blindet resultatvurdering, anæstetikum uden iboende neurobeskyttende aktivitet, angivet dyreart, beregning af stikprøvestørrelse, overholdelse af velfærdsregler og en interessekonflikterklæring med et point for hvert ja.
| Feature | SYRCLE risiko for bias-værktøj | Kvalitetstjekliste i CAMARADES-stil |
|---|---|---|
| Spørgsmål besvaret | Hvor sandsynligt er der en systematisk fejl i dette studies resultat, post for post? | Viser rapporten ti design- og kvalitetsfunktioner? |
| Rating | Lav, høj eller uklar risiko pr. indtastning, vejledt af signalspørgsmål | Ja, nej eller uklart pr. element, med et point for hvert ja i Qu-eksemplet |
| Oversigtsscore | Ikke anbefalet af værktøjets forfattere | I alt 10 |
| Manglende information | Vurderet uklar risiko | Scorer ikke point i Qu-eksemplet |
| Elementer, der kun findes i dette værktøj | Skjulning af allokering, baseline-lighed, tilfældig boligplacering, tilfældig resultatvurdering, frafald, selektiv rapportering | Fagfællebedømt publikation, temperaturkontrol, anæstesi, beregning af stikprøvestørrelse, overholdelse af velfærdsregler, erklæring om interessekonflikter |
| Felttilpasning | Enhver dyreinterventionsundersøgelse | Flere elementer (temperaturkontrol, anæstetikum uden neurobeskyttende aktivitet) ser ud til at stamme fra slagtilfældemodeller, så andre felter tilpasser dem. |
De to instrumenter kan være uenige i den samme undersøgelse, og Qu-gennemgangen viser hvordan. På tværs af de syv undersøgelser scorede tilfældig allokering ja i 7 ud af 7 på tjeklisten, men sekvensgenerering blev kun vurderet lavt i 1 ud af 7 på SYRCLE-tabellen og uklar i de andre 6. Blindet resultatvurdering scorede nej i 7 ud af 7 på tjeklisten, og blinding af resultatvurderere var uklar i 7 ud af 7 på SYRCLE. Forfatterne forklarer det første hul med deres egne ord og bemærker, at "den metode, der blev brugt til at generere den tilfældige sekvens, ofte ikke var specificeret". En undersøgelse kan sige, at den randomiserede, og stadig opnå en uklar vurdering på indgang 1, indtil metoden er beskrevet.
Den praktiske regel følger af dette. Brug de ti SYRCLE-poster til at bedømme bias og til at understøtte risikoen for bias-trinnet, når du bedømmer sikkerhed, hvilket vores GRADE-guide forklarer, og tilføj kun CAMARADES-lignende elementer, når review-spørgsmålet også handler om rapporteringskvalitet. Hold de to i separate tabeller. Qu og kolleger gjorde præcis det, og de angiver, at deres risiko-for-bias-vurderinger for GRADE blev informeret af SYRCLE-værktøjet. For en bredere sammenligning af vurderingsværktøjer på tværs af studiedesigns, se vores guide til kvalitetsvurderingsværktøjer i systematiske reviews.
Hvordan eksemplet på metaanalysen blev valgt og kontrolleret
Vi søgte i Europe PMC efter CC BY systematiske oversigter over dyrestudier, der navngiver SYRCLE og blev udgivet fra juni 2025 og fremefter. Forespørgslen returnerede 797 poster, og vi screenede de første 300 for en hovedteksttabel, der vurderer hvert studie på alle ti poster. Vi beholdt én, hvis tabel, skriftlige optælling og licens vi alle kunne kontrollere. Artiklen er Ali og kolleger , udgivet i Frontiers in Pharmacology den 24. juli 2026 (PMID 42568838).
Fire kilder er enige om licensen. Crossref angiver versionen af artiklen under CC BY 4.0 med en startdato den 24. juli 2026, Europe PMC markerer artiklen som CC BY, JATS' fulde tekst benævner Creative Commons Attribution License, og udgiversiden linker til CC BY 4.0-dokumentet. PMC-kopien og udgiversiden har begge en rettelsesdato den 10. august 2026, og udgiversiden beskriver ændringen som mindre uden effekt på det videnskabelige indhold. Vi sammenlignede tabel 2 og afsnittet om risiko for bias i PMC-kopien med udgiversiden den 1. november 2026 og fandt tabel 2 identiske og de samme procenter i teksten.
Hver række nedenfor angiver det afsnit, hvor beviserne findes, hvad vi genudledte, og en bestemmelse. Genudledt betyder, at vores optælling fra tabel 2 gengiver procentdelen i teksten. Genudledt betyder, at optællingerne stemmer overens, og kun den første decimal afviger. Vurderingsbestemmelse betyder, at optællingerne stemmer overens, nogle gange efter afrunding, men en anden anmelder, der bruger signaleringsspørgsmålene, kunne vurdere indlægget anderledes, fordi artiklen ikke viser den understøttende tekst. Afviger betyder, at et tal ikke genudledes. Hvert citat er 25 ord eller færre, er i anførselstegn og blev kontrolleret i forhold til den fulde tekst. Dette er en aritmetisk og rapporteringsmæssig kontrol, så vi åbnede ikke de 16 primære artikler bag vurderingerne.
Empagliflozin-metaanalysen bag dette fungerende eksempel
Gennemgangen samler prækliniske studier af empagliflozin i dyremodeller af metabolisk dysfunktionsassocieret steatotisk leversygdom. Forfatterne søgte i Scopus, Web of Science, PubMed, Wiley Online Library og Cochrane Library, fandt 1,127 registre, beholdt 816 efter fjernelse af dubletter og inkluderede 16 artikler. Én artikel, Kim og kolleger 2023, bidrog med to uafhængige datasæt, så analysen har 17 rækker. Tretten artikler anvendte C57BL/6-mus og tre anvendte rotter. Doserne varierede fra 8 til 30 mg/kg pr. dag, og de samlede resultater var standardiserede gennemsnitlige forskelle under en tilfældig effektmodel.
Abstraktet navngiver SYRCLE, og den fulde beskrivelse findes i resultaterne, afsnit C ("Studiekvalitet og risiko for bias"), med tabel 2 og figur 2. Metoderne har ingen separat underafsnit om risiko for bias. Artiklen angiver, at "Risiko for bias blev evalueret af to uafhængige forskere, og uoverensstemmelserne blev løst af forskerteamlederen." Hvert studie blev vurderet lavt (+), uklart (?) eller højt (-) på ti punkter mærket A til J. Bogstaverne A til J relaterer sig til de ti poster i rækkefølgen i tabel 1 ovenfor.
SYRCLE risiko for bias-værktøjets poster 1 til 3 anvendt på eksemplet
| Indgang | Hvor i artiklen | Beviser og genudledning | Ring til os på |
|---|---|---|---|
| 1 | Resultater, afsnit C; tabel 2 kolonne A | Lav i 17 ud af 17 rækker (100.0 procent), hvilket matcher tekstens "100% af studierne". Gennemgangens første inklusionskriterium var randomiserede kontrollerede forsøg, hvilket forklarer, hvorfor hver række består. Artiklen angiver ikke, pr. studie, den tilfældige komponent (en tabel eller en generator), som værktøjet beder om, og en primær artikel, der kun siger "randomiseret", ville normalt blive vurderet som uklar. | Domsafsigelse |
| 2 | Resultater, afsnit C; tabel 2 kolonne B | Lav i 15 rækker, uklar i 2 (Abdalla (2023), Heo (2022)), høj i ingen. Vores beregninger giver 88.2 procent mod 88.3 procent i teksten. Tabel 1 rapporterer arter, gruppestørrelse og alder for de fleste rækker, hvilket giver læseren de første baseline-faktorer, men tidspunktet for sygdomsinduktion er ikke vurderet separat. | Genudledt, afrunding |
| 3 | Resultater, afsnit C; tabel 2 kolonne C | Lav i 1 række (Zambrano-Vásquez 2025) og uklar i 16. Vores beregninger giver 5.9 procent mod 5.8 procent i teksten. Diskussionen understøtter mønsteret og nævner "mangel på detaljeret rapportering af allokering, blinding af eksperimenter og randomisering til vurdering af resultater". | Genudledt, afrunding |
Post 4 til 7 anvendt på eksemplet (ydeevne- og detektionsbias)
| Indgang | Hvor i artiklen | Beviser og genudledning | Ring til os på |
|---|---|---|---|
| 4 | Resultater, afsnit C; tabel 2 kolonne D | Lav i 15 rækker og uklar i 2 (Elseweidy (2023), Perakakis (2021)). Vores beregning giver 88.2 procent mod 88.3 procent i teksten. Værktøjet accepterer identisk boligtype som en vej til lav risiko, hvilket kan være grundlaget her, men artiklen siger ikke noget. Lav i post 4 ved siden af uklar i post 3, 5 og 6 for de fleste rækker er et mønster, som en læser måske ønsker at undersøge. | Domsafsigelse |
| 5 | Resultater, afsnit C; tabel 2 kolonne E | Lav i 3 rækker (Lee 2022, Heo 2025, Zambrano-Vásquez 2025) og uklar i 14. Vores beregning giver 17.6 procent, det samme som tekstens 17.6 procent. Værktøjet knytter denne indtastning til boligreglerne i indtastning 4, så en lav vurdering på 4 med en uklar vurdering her er konsistent. | Genudledt |
| 6 | Resultater, afsnit C; tabel 2 kolonne F | Lav i 2 rækker (Heo 2025, Zambrano-Vásquez 2025) og uklar i 15. Vores beregninger giver 11.8 procent mod 11.7 procent i teksten. Artiklen formulerer dette indlæg som "tilfældigt til vurdering af resultater". | Genudledt, afrunding |
| 7 | Resultater, afsnit C; tabel 2 kolonne G | Lav i 11 rækker og uklar i 6 (Xu (2017), Abdalla (2023), Kim (2023) (a), Kim (2023) (b), Heo (2022), Ma (2022)). Vores aritmetik giver 64.7 procent, det samme som teksten. Værktøjet siger, at denne indtastning skal bedømmes for hvert hovedresultat, og artiklen giver én vurdering pr. række uden at angive, om den var resultatspecifik. Værktøjet accepterer også en ublindet vurderingsmetode for resultater, der sandsynligvis ikke vil blive påvirket, såsom dødelighed. Resultaterne i tabel 1 inkluderer histologiske scorer såsom NAFLD-aktivitetsscoren, så en læser kan spørge, hvad de 11 lave vurderinger hviler på. | Domsafsigelse |
Punkt 8 til 10 blev anvendt på eksemplet (frafald, rapportering og anden bias)
| Indgang | Hvor i artiklen | Beviser og genudledning | Ring til os på |
|---|---|---|---|
| 8 | Resultater, afsnit C; tabel 2 kolonne H | Lav i 17 ud af 17 rækker (100.0 procent), hvilket matcher teksten. Tabel 1 giver et n pr. arm og lader n stå tomt for Radlinger 2023, og artiklen viser ikke dyr allokeret i forhold til analyserede dyr. En anmelder, der følger de fire signalspørgsmål, ville ønske denne sammenligning, før hver række vurderes lavt. | Domsafsigelse |
| 9 | Resultater, afsnit C; tabel 2 kolonne I | Lav i 16 rækker og uklar i 1 (Abdalla 2023). Vores beregning giver 94.1 procent mod 94.2 procent i teksten. Værktøjet spørger, hvordan selektiv rapportering blev undersøgt, ud fra en protokol eller ud fra en sammenligning af metoder og resultater. Artiklen angiver ikke, hvilken rute der blev anvendt. | Domsafsigelse |
| 10 | Resultater, afsnit C; tabel 2 kolonne J | Lav i 14 rækker og høj i 3 (Xu 2017 og begge Kim 2023 datasæt), hvilket matcher tekstens 82.4 og 17.6 procent. De tre høje ratings kommer fra to artikler. Årsagerne er ikke angivet, og værktøjet angiver kontaminering, finansieringsindflydelse, analyseenhedsfejl, designspecifikke risici og erstattede frafald som de sædvanlige kandidater. | Genudledt |
Den fulde SYRCLE-tabel, genudledt
Matricen nedenfor kopierer de 17 rækker fra tabel 2 i artiklen som fakta og lægger vores kolonnetotaler sammen. Postnumrene 1 til 10 er i samme rækkefølge som i tabel 1 ovenfor. Cellerne bruger artiklens egne symboler med et plus for lav risiko, et spørgsmålstegn for uklar risiko og et minustegn for høj risiko.
| Studierække | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| Lee et al. (2022) | + | + | ? | + | + | ? | + | + | + | + |
| Petito-da-Silva et al. (2019) | + | + | ? | + | ? | ? | + | + | + | + |
| Nasiri-Ansari et al. (2021) | + | + | ? | + | ? | ? | + | + | + | + |
| Radlinger et al. (2023) | + | + | ? | + | ? | ? | + | + | + | + |
| Elseweidy et al. (2023) | + | + | ? | ? | ? | ? | + | + | + | + |
| Fu et al. (2025) | + | + | ? | + | ? | ? | + | + | + | + |
| Xu et al. (2017) | + | + | ? | + | ? | ? | ? | + | + | - |
| Perakakis et al. (2021) | + | + | ? | ? | ? | ? | + | + | + | + |
| Heo et al. (2025) | + | + | ? | + | + | + | + | + | + | + |
| Zambrano-Vásquez et al. (2025) | + | + | + | + | + | + | + | + | + | + |
| Abdalla et al. (2023) | + | ? | ? | + | ? | ? | ? | + | ? | + |
| Kim et al. (2023) (a) | + | + | ? | + | ? | ? | ? | + | + | - |
| Kim et al. (2023) (b) | + | + | ? | + | ? | ? | ? | + | + | - |
| Heo et al. (2022) | + | ? | ? | + | ? | ? | ? | + | + | + |
| Niu et al. (2023) | + | + | ? | + | ? | ? | + | + | + | + |
| Ma et al. (2022) | + | + | ? | + | ? | ? | ? | + | + | + |
| Kurtz et al. (2022) | + | + | ? | + | ? | ? | + | + | + | + |
| Lav (+), n | 17 | 15 | 1 | 15 | 3 | 2 | 11 | 17 | 16 | 14 |
| Uklart (?), n | 0 | 2 | 16 | 2 | 14 | 15 | 6 | 0 | 1 | 0 |
| Høj (−), n | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 3 |
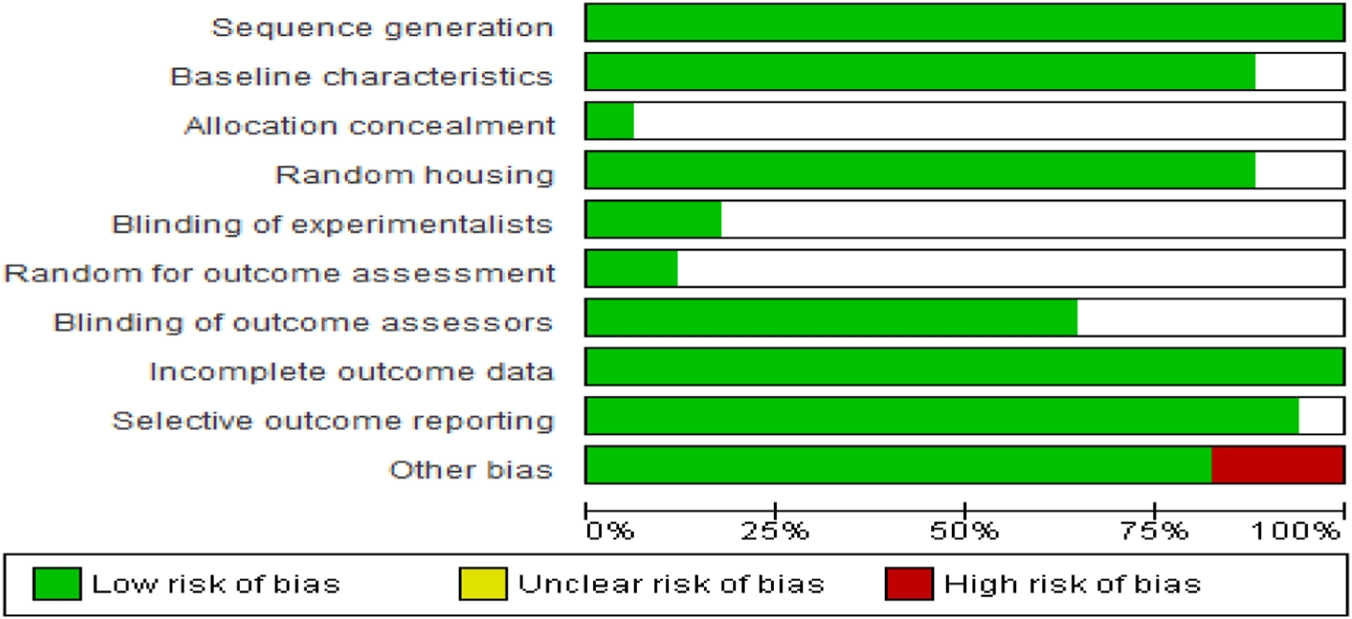
| Lav, procentdel af 17 | 100.0 | 88.2 | 5.9 | 88.2 | 17.6 | 11.8 | 64.7 | 100.0 | 94.1 | 82.4 |
Summeret over alle 170 celler indeholder tabellen 111 lave, 56 uklare og 3 høje vurderinger. Figur 1 er forfatternes egen graf over den samme tabel, og dens søjler stemmer overens med totalerne ovenfor.
Læsning af en studieprofil på tværs af de ti poster
Læsning på tværs af en række giver en studieprofil. Zambrano-Vásquez 2025 er den eneste række, der er lavt vurderet på alle ti poster. Heo 2025 er lav på ni, hvor allokeringsskjulingen er uklar. Abdalla 2023 er lav på fire poster (1, 4, 8 og 10) og uklar på de andre seks, og det er den eneste række med en uklar vurdering af selektiv rapportering af resultater. Xu 2017 og de to Kim 2023-datasæt deler én profil med lave vurderinger på poster 1, 2, 4, 8 og 9, uklare vurderinger på 3, 5, 6 og 7, og en høj vurdering på post 10.
Disse profiler beskriver et mønster og er ikke en rangering, da værktøjets forfattere fraråder at summere dem. Værktøjsartiklen foreslår at udføre en følsomhedsanalyse, der udelader studier med høj risiko. Eksempelgennemgangen udførte leave-one-out-analyser og en kontrol uden to studier med store standardafvigelser, og efter vores læsning angiver artiklen ikke, om de tre rækker med høje vurderinger blev undersøgt hver for sig.
SYRCLE-scorekortet for eksemplet
De ti poster er fordelt som 2 genudledte, 3 genudledte med afrundingsdifferencer og 5 vurderingsafgørelser. Scorekortet følger afgørelserne i tabel 3 til 5 nøjagtigt.
| Ring til os på | Entries | Hvilken |
|---|---|---|
| Genudledt | 2 | Indlæg 5 og 10 |
| Genudledt, afrunding | 3 | Indlæg 2, 3 og 6 |
| Domsafsigelse | 5 | Indlæg 1, 4, 7, 8 og 9 |
| Samlet beløb | 10 | Alle ti bidrag |
En anden kontrol dækker tallene, der omgiver tabellen. Seks elementer stemmer ikke overens på tværs af artiklen, og to af dem er ikke trivielle. Vi rapporterer dem som forskelle i vores aritmetik, ikke som fejl begået af forfatterne, fordi artiklen kan have et grundlag, som den ikke viser.
| Vare | Hvad artiklen siger | Hvad vi finder | Ring til os på |
|---|---|---|---|
| Samlede vurderinger | Artiklen angiver 64.1% lav, 34.1% uklar og 1.8% høj. | Vores optælling fra tabel 2 er 111 lav, 56 uklar og 3 høj ud af 170 celler, hvilket er 65.3%, 32.9% og 1.8%. Artiklens procenter passer til 109, 58 og 3 celler, så to celler er forskellige. | Afviger |
| Dyr | Artiklen nævner 584 dyr, hvoraf 251 er i kontrol- og interventionsgrupperne. | n'et pr. arm i tabel 1 summerer sig til 240 over de 16 rækker, der angiver det, og Radlinger-rækken giver intet n. Fordelingen til 584 og 251 er ikke vist. | Afviger |
| Procentdele pr. indtastning | 94.2, 88.3, 11.7 og 5.8 procent. | 94.1, 88.2, 11.8 og 5.9 procent. Forskellene er 0.1 procentpoint og går i begge retninger, så de følger ikke en enkelt afrundingsregel. | Minor |
| Elseweidy år | Tabel 1 og 2 viser 2023. | Teksten og referencelisten angiver 2024. | Minor |
| Ma år | Rækken er mærket Ma et al. (2022) i tabel 1. | Årskolonnen i samme række lyder 2023. | Minor |
| Figur 2 farver | Forklaringen viser gult ved uklar risiko. | De uklare segmenter er tegnet hvide. | Minor |
To rækker adskiller sig, og fire er mindre. Ingen af dem ændrer billedet, nemlig at allokering, blinding af omsorgspersoner og tilfældig resultatvurdering for det meste er uklare i disse studier. De viser, hvorfor en oversigt bør offentliggøre sine støtteerklæringer og en tabel på celleniveau, så en læser kan gentage optællingen.
Modelsætninger til rapportering af en SYRCLE-vurdering
De firkantede parenteser er pladsholdere til dine egne oplysninger. De er skabeloner og ikke tekst fra artiklen.
Sætninger du kan tilpasse
- Metoder. Risiko for bias blev vurderet med SYRCLEs risiko for bias-værktøj til dyreforsøg, som har ti bidrag. To anmeldere vurderede hvert studie uafhængigt af hinanden som lav, høj eller uklar risiko for hvert bidrag ved hjælp af signaleringsspørgsmålene og løste uenigheder ved diskussion med [tredje anmelder]. Vi beregnede ikke en opsummerende score.
- Anmeldelsesspecifikke regler. Før vurderingen var anmelderne enige om, at [grundlæggende karakteristika] og [andre bias-elementer] var relevante for denne gennemgang, og at identiske boliger på tværs af grupper ville tælle som lav risiko for indgangspunkt 4.
- Resultatniveauindgange. Blinding af effektmålere blev bedømt separat for [primært effektmål] og [sekundært effektmål].
- Support. Den sætning i hver rapport, der understøtter hver vurdering, er angivet i den supplerende tabel [S].
- Resultater. Ud af [n] studier beskrev [k] en tilfældig komponent til sekvensgenerering, og [k] beskrev allokeringsskjulning. De fleste studier blev vurderet som uklare på [entry], fordi rapporterne ikke gav informationen.
En kort SYRCLE-arbejdsgang
- Skriv revisionsspørgsmålet og bliv enige om, hvilke grundlæggende træk der er vigtige for indtastning 2, før en eventuel vurdering starter.
- Afprøv de ti bidrag på to eller tre studier med begge bedømmere, og fastlæg regler for bidrag 4, 5 og 10.
- Bedøm hvert bidrag uafhængigt af hinanden, og kopier den understøttende sætning fra opgaven ind i en støttekolonne med sidetallet.
- Bedøm indtastning 7 for hvert hovedresultat.
- Løs uenigheder, kontakt forfattere, hvor en detalje mangler, og sørg for at rapporten forbliver uklar, når den forbliver tavs.
- Vis en tabel pr. undersøgelse og en opsummerende graf, og læg ikke vurderingerne sammen til en score.
- Medtag vurderingerne i følsomhedsanalysen og i risikoen for bias-trinnet i GRADE for præklinisk evidens, og rapporter derefter gennemgangen under vores PRISMA 2020-guide.
Ofte stillede spørgsmål om SYRCLE-værktøjet til risiko for bias
Hvor mange poster har SYRCLE-værktøjet til risiko for bias?
Ti. De falder ind under seks typer bias, som er udvælgelse, præstation, detektion, frafald, rapportering og anden bias. Hvert bidrag vurderes lavt, højt eller uklart.
Er SYRCLE-værktøjet det samme som ARRIVE?
Nej. ARRIVE fortæller forfatterne, hvad de skal rapportere, mens SYRCLE lader en anmelder bedømme et studie, der allerede er blevet rapporteret. God ARRIVE-rapportering gør SYRCLE-vurderinger nemmere, fordi færre poster forbliver uklare. Se vores ARRIVE 2.0-eksempel.
Kan dyr blindes i et eksperiment?
Opslag 5 og 7 omhandler mennesker, ikke dyr. De spørger, om omsorgspersoner, undersøgere og resultatvurderere vidste, hvilken behandling hvert dyr modtog.
Skal anmeldere beregne en SYRCLE-score?
Værktøjets forfattere fraråder det, fordi en total kræver vægte, der er svære at retfærdiggøre. Anmelderne rapporterer de ti vurderinger pr. undersøgelse og bruger dem i følsomhedsanalysen.
Får ordet "randomiseret" en lav vurdering på indtastning 1?
Ikke af sig selv. Værktøjet beder om en tilfældig komponent i sekvensgenereringen, så en rapport, der kun siger, at dyrene blev randomiseret, forbliver normalt uklar, indtil metoden er angivet.
Hvilket værktøj passer til et randomiseret forsøg på mennesker?
Brug RoB 2 til forsøg på mennesker. SYRCLE er bygget til dyreinterventionsstudier.
Gratis researchværktøjer fra Editverse
- GraphPro, byg publikationsklare diagrammer, 25 typer, med indbygget t-test, ANOVA, korrelation og chi-i-anden p-værdier. Gratis, ingen tilmelding.
- StatPro, gratis statistiske beregnere og et testudvælgelsesværktøj, der dækker gruppesammenligninger, kategoriske resultater, analyse af tid til begivenhed og diagnostisk nøjagtighed.
- Flowchart Pro, generer PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE og ARRIVE flowdiagrammer direkte i din browser.
Professionel støtte til vurdering af risiko for bias og metaanalyse
Risiko for bias-tabeller og samlede estimater er to trin i en systematisk gennemgang, der kræver dokumenteret, kontrollerbart arbejde. To Editverse-tjenester er knyttet til ovenstående trin.
Risiko for biasvurdering
Brug for en tabel over risiko for bias for hvert inkluderet studie?
$350
Du sender dine inkluderede studier og deres design. Du modtager udfyldte vurderingsformularer, tabeller over risiko for bias, visualiseringer af trafiklys og en forklaring af en metodesektion. Standardbehandlingstiden er 4 til 6 hverdage. Servicesiden viser de værktøjer, den tilbyder, så send en e-mail til co ***** @ ******* se.com med dine studier, før du bestiller, hvis din protokol nævner en specifik undersøgelse.
Meta-analyse
Er udtrukne data klar til pooling?
$1,000
Du leverer de udtrukne data. Du modtager statistisk pooling med faste eller tilfældige effekter, heterogenitetsvurdering, skovplot, et tragtplot med bias-test, følsomhedsanalyse, et manuskriptklar resultatafsnit og analysefilerne. Standardlevering er 2 til 3 uger fra datamodtagelse.
Vores arbejde er i overensstemmelse med COPE, ICMJE og GPP 2022 og følger institutionelle og landespecifikke etiske krav.
God brug af SYRCLE-værktøjet til risiko for bias
SYRCLE-værktøjet til risiko for bias belønner detaljer. Eksempelgennemgangen anvender alle ti poster på 17 rækker, udgiver en tabel på celleniveau og en skriftlig optælling, og lader således en læser gentage optællingen. Alle ti procenter pr. post udledes inden for 0.1 procentpoint, og de poster, der forbliver mest uklare, såsom allokering, blinding af omsorgspersoner og tilfældig resultatvurdering, er dem, forfatterne nævner i deres diskussion. De påstande, der fortjener et andet kig, er de høje andele af lave vurderinger af sekvensgenerering, bolig, frafald og selektiv rapportering, hvor artiklen ikke viser sin støtte. Skriv støttesætningen for hver celle, bedøm post 7 for hvert resultat, behold CAMARADES-lignende elementer i deres egen tabel, og lad vurderingerne være en profil uden en total.
Referencer
- Hooijmans CR, Rovers MM, de Vries RB, Leenaars M, Ritskes-Hoitinga M, Langendam MW. SYRCLEs risiko for bias-værktøj til dyreforsøg. BMC Med Res Metode. 2014;14:43. doi:10.1186/1471-2288-14-43. PMID 24667063. PMCID PMC4230647.
- Ali LS, Mostafa MO, Alsharayiah D, Elkholy MA, Ahmed KA, El-Mansy AA m.fl. Empagliflozins leverbeskyttende virkninger ved metabolisk dysfunktionsassocieret steatotisk leversygdom: en systematisk gennemgang og metaanalyse af prækliniske studier. Front Pharmacol. 2026;17:1822157. doi:10.3389/fphar.2026.1822157. PMID 42568838. PMCID PMC13448050.
- Qu G, Bi Y, Wang L, Xu L, Zhang Y, Ma Y m.fl. Effekten af Dang Gui Shao Yao San i behandling af vaskulær demens i dyremodeller: en systematisk gennemgang og metaanalyse. Front Aging Neurosci. 2026;18:1701536. doi:10.3389/fnagi.2026.1701536. PMID 41907844. PMCID PMC13021646.
- Macleod MR, O'Collins T, Howells DW, Donnan GA. Samling af dyreforsøgsdata afslører indflydelse af studiedesign og publikationsbias. Stroke. 2004;35(5):1203-8. doi:10.1161/01.STR.0000125719.25853.20. PMID 15060322.
- Higgins JP, Altman DG, Gøtzsche PC, Jüni P, Moher D, Oxman AD, et al. Cochrane Collaborations værktøj til vurdering af risiko for bias i randomiserede forsøg. BMJ. 2011;343:d5928. doi:10.1136/bmj.d5928. PMID 22008217. PMCID PMC3196245.
- Hooijmans CR, de Vries RBM, Ritskes-Hoitinga M, Rovers MM, Leeflang MM, IntHout J, et al. Fremme af sundhedsbeslutninger ved at vurdere sikkerheden i evidensen fra prækliniske dyreforsøg. PLoS One. 2018;13(1):e0187271. doi:10.1371/journal.pone.0187271. PMID 29324741.
- Percie du Sert N, Hurst V, Ahluwalia A, Alam S, Avey MT, Baker M m.fl. ARRIVE-retningslinjerne 2.0. Opdaterede retningslinjer for rapportering af dyreforsøg. PLoS Biol. 2020;18(7):e3000410. doi:10.1371/journal.pbio.3000410. PMID 32663219. PMCID PMC7360023.