
F-istatistiği , bir hakem tarafından Mendel rastgeleleştirme makalesinde ilk aranan sayıdır ve F değeri 10'u aştığında bir aracın yeterli olduğu kuralı, 2011'den beri yazılan hemen hemen her yöntem bölümünde alıntılanmaktadır. Editverse 1,100'den fazla makaleye destek vermiştir ve istatistikçilerimizin ele aldığı kayıt ve genetik-epidemiyoloji çalışmalarında, F-istatistiği aynı zamanda yazarların bir hakem ne kazandırdığını sorduğunda en sık açıklayamadıkları sayıdır.
Bu yüzden ölçüm yaptık. Çeşitli ölçüm gücü ve örneklem örtüşme koşullarında 135,000 Mendel rastgeleleştirme çalışmasını simüle ettik, tüm işlemi iki bağımsız yazılmış programda iki kez çalıştırdık ve sonuçları karşılaştırdık. Sonuç, çoğu eğitim materyalinin ima ettiği gibi değil. Zayıf bir ölçüm aracı genellikle size yanlış bir cevap vermez. Size öyle geniş bir aralık verir ki, hiçbir cevap mümkün olmaz ve bunu tahminin kendisi sapmaya başlamadan çok önce yapar.
Basit Sözlerle
Genetik bir aracı çok küçük bir dürtü olarak düşünün. Eğer dürtü güçlü ise, varyantı taşıyan herkes gerçekten de daha fazla maruz kalır ve hastalık risklerinde neler olduğunu görebilirsiniz. Eğer dürtü zayıf ise, taşıyıcılar ve taşıyıcı olmayanlar arasındaki fark neredeyse yok denecek kadar azdır, bu nedenle hastalık üzerindeki herhangi bir etki gürültünün içinde kaybolur. F-istatistiği, dürtünün ne kadar güçlü olduğunu ölçer. Küçük olduğunda, analizinizin verdiği dürüst cevap, büyük bir zararlı etkiyi, hiçbir etkiyi ve büyük bir koruyucu etkiyi aynı anda içeren çok geniş bir aralıktır. Çalışma size yalan söylemedi. Sadece hiçbir şeyi ölçmeyi başaramadı.
"F'nin 10'dan Büyük Olması Kuralı Nereden Geliyor?"
Eşik değer, genetikten türetilmemiş, ödünç alınmıştır. Kökeni ekonometriye dayanmaktadır; burada Staiger ve Stock (1997), araçların maruziyeti çok az açıkladığı durumlarda iki aşamalı en küçük kareler yöntemini incelemiş ve ortaya çıkan sapmanın kabul edilebilir olduğu durumlarda ilk aşama F değerini 10 olarak bir çalışma kuralı olarak önermişlerdir. Bu kural, Burgess ve Thompson (2011) aracılığıyla genetik epidemiyolojiye de geçmiştir ; bu araştırmacılar, özellikle Mendel rastgeleleştirmesinde zayıf araç sapmasını incelemiş ve tahminin, karıştırılmış gözlemsel ilişki yönünde çekildiğini ve bu çekimin büyüklüğünün F istatistiği tarafından belirlendiğini göstermişlerdir.
Bu soy ağacıyla ilgili iki önemli nokta var ve bunlar genellikle göz ardı ediliyor. Birincisi, orijinal sonuç, birden fazla araç içeren iki aşamalı en küçük kareler yöntemiyle ilgilidir ve tanımladığı sapma, dahil edilen araç sayısı arttıkça artar. İkincisi, eşik, geçme notu değil, kaba bir kılavuz olarak sunulmuştur. Pierce, Ahsan ve VanderWeele (2011), araç gücü ve istatistiksel gücün ayrı sorular olduğunu ve bir aracın F=10 değerini rahatlıkla geçebileceğini, ancak bir çalışmayı, oluşturulduğu soruyu yanıtlamak için çok hassas olmayan bir şekilde bırakabileceğini belirtmiştir. Simülasyonlarımız, bu iki şeyin ne kadar birbirinden uzak olabileceğini tam olarak göstermektedir. Tasarımın kendisine yeniyseniz, Mendel rastgeleleştirmenin ne olduğu ve nasıl yapılacağına dair kılavuzumuz, bu makalede zaten bildiğinizi varsaydığımız üç araç değişkeni varsayımını kapsar ve araç değişkenleri ve iki aşamalı en küçük kareler yöntemine ilişkin açıklamamız, tahmin edicinin kendisini ele alır.
Neleri Simüle Ettik ve Bunu Nasıl Kontrol Edebilirsiniz?
Kurulum kasıtlı olarak basittir, çünkü basit bir tasarım, başarısızlık modunu karmaşık bir modelin içine gizlemek yerine anlaşılır hale getirir. Her simüle edilmiş çalışmada örneklem başına 5,000 birey bulunur. Minör alel frekansı 0.3 olan tek bir genetik varyant, araç değişkeni olarak görev yapar. Ölçülmemiş bir karıştırıcı faktör hem maruziyeti hem de sonucu etkiler; bu da gözlemsel ilişkiyi baştan beri yanıltıcı kılan şeydir. Maruziyetin sonuç üzerindeki gerçek nedensel etkisi 0.20'dir. Karıştırıcı faktör nedeniyle, sonucun maruziyete göre sıradan bir regresyonu yaklaşık 0.40 değerini verir, bu nedenle gözlemsel tahmin gerçeği iki kat fazla gösterir.
Daha sonra, ilk aşama F-istatistiğinin 3, 5, 10, 20, 50 ve 100'e yakın değerlere düşmesi için ölçüm aracının gücünü değiştirdik ve her seviyede iki koşul altında 5,000 tekrarlı çalışma yürüttük: birinde maruz kalma ve sonuç ilişkileri aynı katılımcılarda tahmin edildi, diğerinde ise tamamen ayrı iki örneklemden geldi. Her tekrarlı çalışma için nedensel tahmini, delta yöntemiyle standart hatasını, elde edilen %95 güven aralığını ve bu aralığın 0.20'lik gerçek etkiyi içerip içermediğini kaydettik.
Aşağıdaki her şekil iki kez üretilmiştir. Bir uygulama R dilinde olup, tekrarlanan bloklar üzerinde matris işlemleri kullanır. İkincisi ise Python dilinde olup, aynı miktarları yeterli istatistiklerden farklı bir rastgele sayı üreteciyle ve ortak kod olmadan hesaplar. İki motor, herhangi bir şey yazılmadan önce karşılaştırılmıştır. Monte Carlo hatası dahilinde her kararlı miktarda hemfikirdirler ve farklılık gösterdikleri yerlerde, bu farklılığın kendisi bulgudur. NHANES anket ağırlıklarının neleri düzelttiği ve neleri düzeltmediği konusundaki açıklamalarımızda olduğu gibi, yayınladığımız her veri şeklini bu iki motor standardına göre değerlendiriyoruz.
Zayıf araçların tahmine gerçekte ne gibi etkileri vardır?
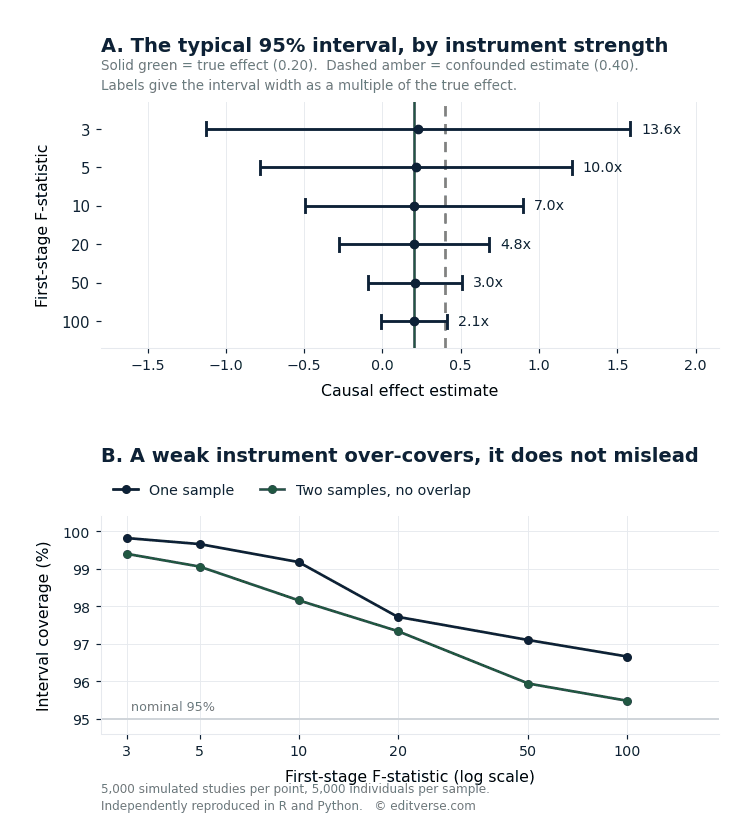
Aralık, nokta tahmini çökmeden çok önce çöker.
A paneli, tüm argümanı tek bir resimde özetliyor. Test ettiğimiz her ölçüm gücünde, medyan tahmin, gerçek etki olan 0.20'ye yakın ve gözlemsel olarak karıştırılmış 0.40 değerine hiç yaklaşmıyor. Değişen şey ise, etrafındaki aralığın genişliğidir.
| Birinci aşama F | Ortanca tahmin | Ortanca %95 güven aralığı genişliği | Genişlik, gerçek etkinin bir katı olarak | Kapsam |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8% |
| 5 | 0.213 | 1.99 | 10.0x | 99.7% |
| 10 | 0.200 | 1.39 | 7.0x | 99.2% |
| 20 | 0.202 | 0.96 | 4.8x | 97.7% |
| 50 | 0.205 | 0.60 | 3.0x | 97.1% |
| 100 | 0.199 | 0.42 | 2.1x | 96.7% |
Dördüncü sütunu okuyun ve pratik anlamı netleşecektir. F değeri 3 olduğunda, tipik güven aralığı, çalışmanın tespit etmeye çalıştığı etkiden 13.6 kat daha geniştir. Bu aralık yaklaşık olarak -1.1'den +1.6'ya kadar uzanır. Büyük bir koruyucu etkiyi, hiçbir etkiyi ve büyük bir zararlı etkiyi içerir. Verilerde bunlar arasında bir ayrım yapan hiçbir şey yoktur. F değeri 100 olduğunda bile aralık, gerçek etkinin yaklaşık iki katı büyüklüğündedir; bu, bir yön belirlemek için yeterlidir, ancak daha fazlası için yeterli değildir.
Aralık genişliği, F'nin ters kareköküne yakın bir oranda küçülür. Her genişliği F'nin kareköküyle çarpmak, altı seviye boyunca sırasıyla 4.63, 4.51, 4.37, 4.30, 4.25 ve 4.24 değerlerini verir; bu değerler neredeyse sabittir ve yalnızca delta yöntemi standart hatasının kendisinin bozulmaya başladığı en zayıf cihazlarda yukarı doğru bir kayma gösterir. Pratik sonuç olarak, hassasiyetinizi ikiye katlamak, cihaz gücünü yaklaşık dört katına çıkarmayı gerektirir; bu da iki örnekli bir tasarımda, biraz daha gevşek bir p-değeri eşiği yerine çok daha büyük bir GWAS maruziyeti anlamına gelir.
Aralık, kapsamı aşıyor, bu da yanlış olmakla aynı şey değil.
Panel B, kapsama oranını göstermektedir: %95'lik aralığı gerçek etkiyi içeren tekrarlanan çalışmaların oranı. Yöntem tam olarak reklam edildiği gibi çalışsaydı, bu oran her yerde %95'te olurdu. Ancak öyle değil. F değeri 3 olduğunda, tek örneklem aralığı gerçeği %99.8 oranında kapsarken, F değeri 100 olduğunda bu oran %96.7'ye düşmektedir. İki örneklem aralığı, tek örneklem aralıklarının biraz altında seyrederek en yüksek güçte %95.5'e ulaşmaktadır.
Aşırı kapsama, mevcut bilgilere göre çok büyük bir standart hatanın işaretidir. Bu, zayıf bir aracın yanıltıcı olmaktan ziyade muhafazakar aralıklar ürettiği anlamına gelir. Bu, yayınlanmış bir sıfır sonucunu yorumlayan herkes için gerçekten önemli bir ayrımdır. Zayıf bir araç temelinde hiçbir etki bildirmeyen bir Mendel rastgeleleştirme makalesi, hiçbir etkinin olmadığını göstermemiştir. Sadece tasarımının bir etkiyi tespit edemeyeceğini göstermiştir. Bunlar farklı iddialardır ve hakemler giderek yazarlardan hangisini yaptıklarını belirtmelerini istemektedir.
Ortalama değer diye bir şey yoktur ve iki motor bunu kanıtlamıştır.
İki uygulamamız arasında bir nicelik uyuşmuyordu ve bu uyuşmazlık öğretici nitelikteydi. F değeri 3 olduğunda, R motoru tek örneklem koşulunda ortalama 0.64 tahmini verdi. Aynı tasarımı çalıştıran Python motoru ise 0.24 verdi. İki örneklem koşulunda ise iki motor sırasıyla 0.77 ve 1.01 değerlerini verdi. Bu makaledeki diğer tüm nicelikler Monte Carlo hatası dahilinde eşleşirken, bu nicelikler eşleşmedi.
Bu, programların hiçbirinde bir hata değil. Buradaki nedensel tahmin, iki regresyon katsayısının oranıdır ve payda keyfi olarak sıfıra yakın bir değere ulaşabildiğinde, oranın sonlu bir beklentisi yoktur. Bu tür bir niceliğin örnek ortalaması, kaç tekrar çalıştırırsanız çalıştırın yakınsamaz, bu nedenle iki dürüst program bu konuda süresiz olarak farklı görüşte olacaktır. Medyan, aralık genişliği ve kapsama alanı normal olarak yakınsar, bu nedenle yukarıdaki tabloda ortalama değil, bunlar rapor edilmiştir. Ağır kuyrukları dikkate almadan varyantlar arasında bir ortalamaya dayanan herhangi bir Mendel rastgeleleştirme sonucu, aynı istikrarsız zeminde durmaktadır; bu da ana Mendel rastgeleleştirme kılavuzumuzda tartışılan pleiotropiye dayanıklı tahmincilerin düz ortalamalar yerine medyanları ve modları kullanmasının nedenlerinden biridir. Bu dört tahmincinin her birinin sizi aslında neyden koruduğuna dair tamamlayıcı simülasyonumuz, bunları altı pleiotropi rejiminde test eder ve dördünün de aynı fikirde olduğu ve dördünün de yanlış olduğu bir rejim bulur.
Örnekleme örtüşmesi yalnızca enstrüman zayıf olduğunda gerçekleşir.
İki örneklemli Mendel rastgeleleştirme, maruz kalma GWAS'ı ve sonuç GWAS'ının farklı kişilerde ölçüldüğünü varsayar. Pratikte bu varsayım sürekli olarak ihlal edilir, çünkü çok büyük birkaç biyobanka yayınlanan GWAS'ların büyük bir kısmına katkıda bulunur ve aynı katılımcılar, yazarların mutlaka farkında olmadan, bir analizin her iki tarafında da yer alır. Burgess, Davies ve Thompson (2016), örtüşmenin iki örneklemli bir tahmini tek örneklemli davranışa doğru, yani karışık gözlemsel ilişkiye doğru geri ittiğini ortaya koymuştur.
Bu etkinin büyüklüğünü doğrudan test ettik ve üç farklı cihaz gücünde örtüşme oranını %0'dan %100'e kadar değiştirdik.
| Katılımcıların örtüşmesi | F = 3'da medyan sapma | F = 5'da medyan sapma | F = 10'da medyan sapma |
|---|---|---|---|
| 0% | -0.004 | -0.011 | -0.003 |
| 25% | -0.016 | -0.008 | -0.010 |
| 50% | -0.003 | -0.012 | 0.000 |
| 75% | + 0.015 | -0.005 | + 0.011 |
| 100% | + 0.026 | + 0.005 | + 0.005 |
F değeri 3 ve tam örtüşme durumunda, medyan tahmin, gerçek etki 0.20 iken yaklaşık 0.026 yukarı çekilir; bu da karışıklık yaratan değere doğru yaklaşık %13'lük bir kaymaya karşılık gelir ve her iki motor da bunu bağımsız olarak yeniden üretir. F değeri 10 olduğunda ise sıralı bir örüntü kalmaz. İki sorun toplanmak yerine çarpılır: örtüşme zayıf bir aracı yanlı bir araca dönüştürür, ancak güçlü bir araçta neredeyse hiç fark edilmez.
Raporlamanın anlamı doğrudan. İki GWAS çalışmasının örtüştüğünü belirtmek yeterli değil, örtüşmediklerini iddia etmek de yeterli değil. Bir değerlendiricinin ihtiyacı olan şey, ölçüm aracının gücüyle birlikte örtüşme oranıdır, çünkü ilki ancak ikincisi ışığında yorumlanabilir. Her ikisi de olumsuz olduğunda, dürüst yanıt tartışmada bir uyarıda bulunmak değil, farklı bir veri kaynağı kullanmaktır.
F'nin 10'dan Büyük Olma Kuralının Sonuçlarımızın Gösterdiğinden Daha Önemli Olmasının Sebebi Nedir?
Simülasyonlarımız tek bir araç kullanıyor ve bunlardan zayıf araçların zararsız olduğu sonucuna varmak ciddi bir yanlış yorumlama olurdu. Test ettiğimiz yeni tanımlanmış durum, mevcut en dostane durumdur. Burgess ve Thompson'ın (2011) tanımladığı önyargı, araç sayısı arttıkça büyür; bu nedenle, 200 marjinal olarak anlamlı varyant içeren bir tasarım, tek varyantlı kurulumumuzun gösteremediği bir şeye maruz kalır. Bu, tam olarak, daha fazla araç elde etmek için genom çapındaki anlamlılık eşiğini 5 x 10⁻⁸'den 1 x 10⁻⁵'e düşürmenin yarattığı durumdur; bu, seyrek genetik mimariye sahip maruz kalmalar için artık yaygın bir uygulamadır.
Dürüst bir yaklaşımda iki önemli nokta daha dikkate alınmalıdır. Çok değişkenli Mendel rastgeleleştirmesinde ilgili nicelik, sıradan F-istatistiği değil, Sanderson ve meslektaşları (2019) tarafından tanıtılan koşullu F-istatistiğidir ; bu istatistik, araçların maruziyetleri birbirinden ayırt edebilme yeteneğini ölçer, her birini ayrı ayrı tahmin etmekle kalmaz. Makalelerde burada sıklıkla yanlış istatistik rapor edilmektedir. Ayrıca, araçlar hata ile ölçüldüğünde MR-Egger tahmini güvenilmez hale gelir ve bunun teşhisi Bowden ve meslektaşlarının (2016) I-kare-GX istatistiğidir . Düşük bir değer, pleiotropiye karşı savunmak için güvendiğiniz duyarlılık analizinin kendisinin güvenilir olmadığı anlamına gelir.
Hakemler Yayınlanmış MR Makalelerinde Gerçekte Neler Buluyor?
Yukarıda açıklanan standart ile pratikte uygulanan standart arasındaki fark artık ölçülmüştür. Rosas-Chavez ve Merriman (2025), 2016 ile 2024 yılları arasında yayınlanan hiperürisemi ve gut ile ilgili 86 iki örneklemli Mendel rastgeleleştirme çalışmasını sistematik olarak değerlendirmiş ve her birini yapılandırılmış bir kalite ölçütüne göre puanlamıştır. Bulguları, kendi sayısal verileriyle şöyledir:
- 66% İlgililik varsayımını karşıladılar; yani genom çapında anlamlılık veya 10'un üzerinde bildirilen bir F-istatistiği elde ettiler. Her üç makaleden biri bu şartı sağlamadı.
- 51% Katılımcılar arasında hiçbir örtüşme olmayan veri kümeleri kullanıldı; kendi açıklamalarına göre bu durum, yukarıda açıklanan etkileşime maruz kalan literatürün yaklaşık yarısını oluşturuyor.
- 59% İstatistiksel güce hiç değinilmedi.
- 17% Üç temel araçsal değişken varsayımının tamamı karşılandı.
- 14% Herhangi bir tekrarlama analizi gerçekleştirilmedi.
- 11% 2021'den sonra yayınlanan makalelerin bir kısmı şu şartlara uyuyordu: STROBE-MR raporlama kılavuzu.
Bu incelemede genel kalite puanları 21 üzerinden 0 ile 19 arasında değişmekte olup ortalama 9.1'dir. Bu bir hastalık alanıdır ve diğer alanlar farklılık gösterebilir, ancak şu anda mevcut olan MR raporlama kalitesinin en sistematik denetimidir ve işaret ettiği yön, kendi istatistikçilerimizin gönderilen makalelerde gördükleriyle örtüşmektedir. Altı makaleden beşi kendi sonuçlarının dayandığı varsayımları karşılayamadığında, editörler herkes için çıtayı yükselterek yanıt verir; bu nedenle metodolojik bütünlük, stilistik bir konu olmaktan ziyade bir kapı bekçiliği konusu haline gelmiştir. Gözlemsel çalışmalar için STROBE raporlamasına ilişkin kılavuzumuz , STROBE-MR'nin genişlettiği ana kılavuzu kapsamaktadır.
Bir değerlendiricinin kontrol edebilmesi için, ölçüm cihazının yeterlilik düzeyini nasıl raporlayabilirsiniz?
Tek bir rakamı raporlayıp geçmek, sorguyu oluşturan şeydir. Aşağıda istatistikçilerimizin yöntemler bölümüne yazdıkları ve metodolojik bir inceleyicinin böyle bir bölümü açtığında aradığı şeyler yer almaktadır.
- Enstrüman başına ve birleştirilmiş F-istatistikleri. Her ikisini de raporlayın. Her birinin F değeri 1.3'e yakın olan otuz varyanttan oluşturulmuş toplam F değeri 40, üç güçlü varyanttan oluşturulmuş toplam F değeri 40'tan farklıdır ve yalnızca varyant başına tablo, hangisine sahip olduğunuzu gösterir.
- Maruz kalma varyansının açıklanan oranı. Ölçüm cihazı setinin R-kare değerini belirtin. Bu, hassasiyeti belirleyen ve okuyucunun aralığınızın kullanışlı olacak kadar dar olup olmadığını değerlendirebilmesi için ihtiyaç duyduğu niceliktir.
- Sonuçlardan önce belirtilen seçim eşiği. Eğer genom çapında anlamlılık eşiğinin altında gevşeme yaşadıysanız, bunu belirtin, nedenini açıklayın ve okuyucunun bulgunun gevşemeye bağlı olup olmadığını görebilmesi için her iki eşikteki analizi de raporlayın.
- Kümelenme parametreleri ve referans paneli. Bağlantı dengesizliği eşiği, pencere boyutu ve hangi panelin kullanıldığı. Bağımsız olmayan aletler, görünür gücü artırır.
- Örtüşme oranı ve kaynağı. Her bir GWAS'a katkıda bulunan kohortların adlarını belirtin ve paylaşılan oranı tahmin edin. Eğer tahmin edemiyorsanız, bunu belirtin ve yorumlama için analizi tek örneklem tasarımı olarak ele alın.
- Sadece önem ifadesi değil, aynı zamanda kesin bir ifade. Tasarımınızın tespit edebileceği minimum etki büyüklüğünü bildirin. Yukarıdaki kapsama sonuçlarının da gösterdiği gibi, bu bilgi olmadan elde edilen sıfır sonuç yorumlanamaz.
- Herhangi bir çok değişkenli analiz için koşullu F-istatistiği. Sıradan F fonksiyonu, çok değişkenli Mendel rastgeleleştirme yönteminin sorduğu soruyu yanıtlamaz.
Bu Başarısızlığa Yol Açan Üç Hata
10'dan büyük F değerlerini asgari sınır yerine geçme notu olarak ele almak. 10'u geçmek bir çalışmayı yeterli kılmaz. Verilerimize göre, 10'luk bir F değeri bile ölçülen etkiden yedi kat daha geniş bir aralık bırakmaktadır. Eşik, hassasiyetin yeterli hale geldiği noktayı değil, sapmanın endişe kaynağı haline geldiği noktayı işaretler.
Daha fazla araç elde etmek için p-değeri eşiğini gevşetmek. Bu, zayıf araç alanına girmenin en yaygın yoludur ve yazarın amaçladığının tam tersini yapar. Klasik önyargı sonucunun uyardığı kombinasyon olan, az güç katan varyantlar eklerken araç sayısını artırır. Bir maruziyetin genom çapında anlamlı varyant sayısı çok azsa, bu, çalışmanın devam edip etmemesiyle ilgili bir bilgidir, aşılması gereken bir engel değildir.
Etkisizliğin kanıtı olarak sıfır sonuç bildirmek. Zayıf bir araçla, aralık neredeyse her şeyi kapsadığı için gerçeği %99.8 oranında tam olarak kapsar. Yetersiz güçlendirilmiş bir tasarımdan elde edilen sıfır sonuç, tasarım hakkında bir ifadedir ve bunu anlayan hakemler bunu söyleyecektir. Klinik araştırmalarda kanıt düzeylerine ilişkin kılavuzumuz , iyi yürütülmüş bir Mendel rastgeleleştirme sonucunun deneme kanıtlarına göre nerede yer aldığını ele alırken, epidemiyolojide nedensel çıkarım genel bakışımız , bu tasarımın ait olduğu daha geniş tasarım ailesini kapsamaktadır. Zayıf bir araç tasarımından elde edilen sıfır sonuç da kendi başına yorumlanamaz; bu da Mendel rastgeleleştirme makalelerinin neden reddedildiğine dair tamamlayıcı yazımızda ele alınmaktadır.
Mendel Rastgeleleştirme Çalışması için Profesyonel Destek
İstatistikçilerimizin ilk kontrol ettiği şey, kullanılan yöntemin gücüdür ve bu kontrol, analizler sipariş edilmeden önce yapılır, sonradan rapor edilmez. Eğer bir maruziyetin çok az sayıda bağımsız genom çapında anlamlı varyantı varsa veya mevcut tek sonuç GWAS'ı, maruziyet GWAS'ı ile önemli bir örneklem paylaşıyorsa, bunu en başından belirtiriz. Aksi takdirde, hiçbir hakem tarafından kabul edilmeyecek ve hiçbir okuyucu tarafından kullanılamayacak teknik olarak doğru bir analiz üretmiş oluruz.
Uygulanabilirlik Kontrolü
$450
Onay vermeden önce cihaz sayısı, F-istatistiği, örneklem örtüşmesi ve mevcut literatür kontrol edilir. Devam edin, değiştirin veya durdurun, bunu yazılı olarak bildirin. Daha sonra sipariş edeceğiniz herhangi bir çalışma için tam olarak kredilendirilir. 5 iş günü.
İki Örnekli MR
$2,900
Kamuya açık GWAS özet istatistiklerinden elde edilen tam çalışma: dört tahminleyici, MR-PRESSO, Steiger filtreleme, enstrümantal PheWAS, tekli dışlama yöntemi, ayrıca tamamlanmış bir STROBE-MR kontrol listesi ve çalıştırılabilir R kodu. 15 iş günü.
Genişletilmiş Tasarımlar
$ 3,500 başlayan fiyatlarla
Koşullu F-istatistikleri, arabuluculuk MR'ı, kolokalizasyon, ilaç-hedef MR'ı ve doğrusal olmayan MR ile çok değişkenli MR. Herhangi bir çalışmaya başlamadan önce sabit fiyat teklifi ve yazılı kapsam.
Eğer hâlâ genetik tasarım ile anket, kanser kayıt defteri veya travma kayıt defteri analizi arasında seçim yapma konusunda kararsızsanız, çalışmanız için hangi sağlık veri tabanını kullanmanız gerektiğine dair kılavuzumuz , her bir kaynağın hangi soruları yanıtlayabileceğini ve hangilerini yanıtlayamayacağını açıklamaktadır.
Editverse'den Ücretsiz Araştırma Araçları
- GraphProYayınlanmaya hazır 25 farklı grafik oluşturun; dahili t-testi, ANOVA, korelasyon ve ki-kare p-değerleri içerir. Ücretsiz, kayıt gerekmez.
- StatProGrup karşılaştırmaları, kategorik sonuçlar, olay zamanı analizi ve tanısal doğruluk konularını kapsayan ücretsiz istatistiksel hesap makineleri ve test seçme aracı.
- Akış Şeması ProPRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE ve ARRIVE akış diyagramlarını doğrudan tarayıcınızda oluşturun.
Mendel Rastgeleleştirmesinde Enstrüman Gücü Hakkında Sıkça Sorulan Sorular
10'un üzerinde bir F-istatistiği yayın için yeterli midir?
Gerekli, ancak yeterli değil. Simülasyonlarımız, F değeri 10 olduğunda tipik %95'lik aralığın, tahmin edilen etkiden yedi kat daha geniş olduğunu göstermektedir; bu, tasarımın ciddi şekilde yanlı olmadığını belirlemek için yeterlidir, ancak çoğu araştırma sorusunu yanıtlamak için yeterli değildir. Hakemler, F istatistiğinin yanı sıra, çalışmanın tespit edebileceği en küçük etkiyi gösteren bir hassasiyet ifadesi de beklemektedirler.
Birden fazla enstrüman için F-istatistiğini nasıl hesaplarım?
Bir dizi bağımsız varyant için, birleşik F değeri, açıklanan toplam maruziyet varyans oranından ve örneklem büyüklüğünden, F'nin R-kare ile n eksi k eksi 1'in çarpımının, 1 eksi R-kare ile k'ye bölünmesiyle elde edilen formül kullanılarak hesaplanabilir; burada k, kullanılan araç sayısıdır. Varyant başına F istatistiğini de raporlayın, çünkü yüksek birleşik değer ya birkaç güçlü araçtan ya da birçok zayıf araçtan kaynaklanabilir ve yalnızca ilki güven vericidir.
Zayıf araç yanlılığı, tahmini sıfır hipotezine mi yoksa karışıklık içeren tahmine mi doğru yönlendirir?
Bu, tasarıma bağlıdır. Tek örneklemli bir analizde, yanlılık gözlemsel ilişkinin karışıklığına yöneliktir. Katılımcıların örtüşmediği gerçek anlamda iki örneklemli bir analizde ise sıfır hipotezine yöneliktir. Kısmi örtüşme ikisi arasında yer alır; bu nedenle örtüşme oranı, araç gücünün yerine değil, onunla birlikte rapor edilmelidir.
Daha fazla enstrüman elde etmek için p-değeri eşiğini gevşetebilir miyim?
Yapabilirsiniz, ancak genellikle sorunu iyileştirmek yerine daha da kötüleştirir. Daha düşük bir eşik değerinde seçilen varyantlar, enstrüman sayısını artırırken açıklanan maruziyet varyansının oranına çok az katkıda bulunur ve aşırı tanımlanmış durumda zayıf enstrüman yanlılığı, enstrüman sayısıyla birlikte artar. Eşik değerini gevşetirseniz, okuyucunun sonucun geçerli olup olmadığını görebilmesi için analizi her iki eşik değerinde de raporlayın.
Eğer maruz kaldığım genetik varyantların sayısı genom çapında anlamlılık düzeyi açısından sınırlıysa ne olacak?
O halde dürüst cevap, Mendel rastgeleleştirme çalışmasının henüz bu maruziyet için doğru tasarım olmadığı olabilir. Aralık, neredeyse her şeyi içerecek kadar geniş olacaktır ve ne tahmin ne de sıfır sonuç yorumlanabilir olmayacaktır. Bu, analizden sonra değil, önce çözülmesi gereken bir sorudur; fizibilite değerlendirmesi de bunun içindir.
İki GWAS çalışmasının katılımcılarının aynı olup olmadığını nasıl anlarım?
Her yayındaki ve ek materyallerindeki katkıda bulunan kohort listelerini okuyun. Yayınlanan GWAS çalışmalarının önemli bir bölümünde çok büyük biyobankalar yer almaktadır; bu nedenle, ortak bir özellik üzerine yapılan herhangi iki büyük çalışma için varsayılan varsayım, kontrol edene kadar bir miktar örtüşme olduğudur. Örtüşme nicel olarak belirlenemiyorsa, analizi tek örneklem tasarımı olarak yorumlayın.
Sonuç
İki programda bağımsız olarak yeniden üretilen 135,000 simüle edilmiş Mendel rastgeleleştirme çalışmasında, F istatistiğinin genellikle kullanıldığı amaçtan farklı bir şeyi yönettiği ortaya çıktı. Ortanca tahmin, test ettiğimiz her araç gücünde gerçeğe yakın kaldı. Altı kat değişen şey, etrafındaki aralığın genişliğiydi; F=100'de gerçek etkinin 2.1 katından F=3'te 13.6 katına çıktı. Örnek örtüşmesi yalnızca aracın zaten zayıf olduğu yerlerde tespit edilebilir bir kaymaya neden oldu ve o zaman bile kayma, etrafındaki belirsizliğe kıyasla küçüktü.
Pratik açıdan bakıldığında, araç gücü, bir çalışmanın herhangi bir şeye cevap verip veremeyeceğiyle ilgili bir sorudur ve ikincil olarak önyargıyla ilgilidir. Bu yeniden çerçeveleme, kontrolün ne zaman yapılması gerektiği sorusunu değiştirir. Sonuç tablosunda bildirilen bir F-istatistiği, zaten yürütülmüş bir çalışmanın açıklamasıdır. Tasarım sırasında hesaplanan bir F-istatistiği ise, çalışmanın yürütülüp yürütülmeyeceğine dair bir karardır. En sistematik yayınlanmış denetimdeki makalelerin yalnızca %17'sinin üç temel varsayımın tamamını karşıladığı ve yalnızca %14'ünün tekrarlama girişiminde bulunduğu göz önüne alındığında, analizden önce yapılan kontroller, incelemeyi geçen bir makaleyi geçemeyen bir makaleden ayıran kontrollerdir.
Referanslar
- Staiger D, Stock JH. Zayıf araçlarla enstrümantal değişkenler regresyonu. Econometrica. 1997;65(3):557-586. doi: 10.2307 / 2171753
- Burgess S, Thompson SG. Mendel rastgeleleştirme çalışmalarında zayıf araçlardan kaynaklanan yanlılıktan kaçınma. Epidemiyoloji Dergisi. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL, Ahsan H, VanderWeele TJ. Çoklu genetik varyantlar kullanan Mendel rastgeleleştirme çalışmaları için güç ve araç gücü gereksinimleri. Epidemiyoloji Dergisi. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S, Davies NM, Thompson SG. İki örneklemli Mendel rastgeleleştirmesinde katılımcı örtüşmesinden kaynaklanan yanlılık. Genetik Epidemiyoloji. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J, Del Greco MF, Minelli C, Davey Smith G, Sheehan NA, Thompson JR. MR-Egger regresyonu kullanılarak iki örneklemli Mendel rastgeleleştirme analizleri için özet verilerin uygunluğunun değerlendirilmesi: I-kare istatistiğinin rolü. Epidemiyoloji Dergisi. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E, Davey Smith G, Windmeijer F, Bowden J. Tek örneklem ve iki örneklem özet veri ortamlarında çok değişkenli Mendel rastgeleleştirmesinin incelenmesi. Epidemiyoloji Dergisi. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F, Merriman TR. Mendel rastgeleleştirme çalışmaları: kalite değerlendirmesi için bir ölçüt. Gut, Ürat ve Kristal Birikimi Hastalıkları. 2025; 3 (2): 8. doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW, Richmond RC, Woolf BAR ve diğerleri. Mendel rastgeleleştirmesini kullanarak epidemiyolojide gözlemsel çalışmaların raporlanmasının güçlendirilmesi: STROBE-MR bildirisi. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236
Simülasyon detayları: Örnek başına 5,000 birey, minör alel frekansı 0.3 olan tek bir biallelik araç, hem maruz kalma hem de sonuç üzerinde ölçülmemiş karıştırıcı yükü 0.5, gerçek nedensel etki 0.20, karışık gözlemsel ilişki 0.40. Araç gücü, 3, 5, 10, 20, 50 ve 100'lük birinci aşama F değerlerini hedefleyecek şekilde kalibre edilmiştir. Hücre başına 5,000 tekrar. R 4.3.3 ve Python 3'te NumPy ile bağımsız olarak uygulanmıştır; oran tahmincisinin ortalaması hariç (bunun sonlu bir beklentisi yoktur ve yukarıda tartışılmıştır), bildirilen tüm değerler Monte Carlo hatası dahilinde motorlar arasında uyumludur.