
Publisert
STROBE -MR-sjekklisten er en rapporteringsstandard på 20 punkter for studier som bruker genetiske varianter som instrumentelle variabler for å estimere årsakseffekter. Skrivankova og kolleger publiserte den i 2021 som en uttalelse i JAMA og som en lang forklarende og utdypende artikkel i BMJ [1] [2] . Forfatterne oppfordrer tidsskrifter til å be om utfylte sjekklister ved innsending. Denne veiledningen forklarer hva hvert punkt spør om, viser hvor hvert svar hører hjemme i et manuskript, og anvender deretter hvert punkt i en reell åpen tilgangsstudie av Mendelsk randomisering, rad for rad, med en seksjonspeker og en dom for hver.
Med enkle ord
STROBE-MR er en liste med 20 rapporteringselementer for Mendelske randomiseringsartikler. Den ber forfatterne om å si hvordan de genetiske variantene ble valgt, hvor sterke de er, hvor de to datasettene kommer fra, om utvalgene overlapper hverandre, hvilke tester som undersøkte antagelsene, og hvor dataene og koden kan finnes. En leser skal kunne bedømme studien uten å gjette. Hvis et element ikke gjelder, si det og oppgi årsaken.
Hva STROBE-MR-sjekklisten dekker
STROBE-MR er den mendelske randomiseringsmotparten til STROBE-retningslinjen for observasjonsstudier, som vi dekker i vår STROBE-veiledning . Forklaringsartikkelen går gjennom de 20 punktene med publiserte eksempler på transparent rapportering, og forfatterne oppbevarer sjekklisten som et levende dokument på et eget nettsted [1] . De skrev den fordi det var liten enighet om hvordan man skulle rapportere dette designet. Empirisk arbeid de siterer, fant at mange rapporter ikke oppga eller undersøkte de mendelske randomiseringsforutsetningene og ga for lite detaljer om datakildene sine [1].
En revisjon fra 2022 viser hvor stort gapet var. Woolf og kolleger vurderte 87 studier med to utvalg som brukte MR-Base-plattformen og fant rapporteringen generelt dårlig, med et gjennomsnitt på 53 % av elementene rapportert per studie. Bare 44 % ga nok detaljer til å bedømme relevansantagelsen, 31 % for uavhengighetsantagelsen og 32 % for antagelsene om falsifiseringstester, mens 89 % ga nok for eksklusjonsbegrensningen [4] . Den revisjonen brukte sin egen skreddersydde sjekkliste i stedet for STROBE-MR, så prosentandelene viser hva som har en tendens til å forsvinne og er ikke en STROBE-MR-poengsum.
Omfang er viktig før du åpner sjekklisten. STROBE-MR er for rapporter om Mendelske randomiseringsanalyser. En randomisert studie følger CONSORT, og CONSORT 2025 (30 elementer) erstattet CONSORT 2010, slik vår CONSORT-guide forklarer. En konvensjonell kohort- eller kasuskontrollstudie følger STROBE. Forfatterne av STROBE-MR oppgir også at sjekklisten ikke er et formelt verktøy for å vurdere studiekvalitet, at den ikke bør gjøres om til en kvalitetsskala, og at den ikke er en veiledning for å designe eller gjennomføre en studie [1] . Vi har det i bakhodet når vi scorer eksemplet nedenfor.
STROBE-MR-sjekklisteelementer etter manuskriptseksjon
Tabell 1 parafraserer de 20 punktene i STROBE-MR-sjekklisten fra forklaringsoppgaven [1] og grupperer dem etter manuskriptdelen der svaret hører hjemme. Underpunkter med bokstaver er listet opp sammen. Høyre kolonne angir en vanlig måte hver gruppe gjør feil på, basert på ordlyden i selve punktene.
| STROBE-MR-vare | Seksjon | Hva skal rapporteres | Vanlig felle |
|---|---|---|---|
| 1 | Tittel og abstrakt | Nevn Mendelsk randomisering som design når det er et hovedformål med studien. | Et sammendrag som kun sier genetisk analyse, uten å navngi designet. |
| 2 og 3 | Introduksjon | Forklar eksponeringen, om en årsakssammenheng er plausibel, hvorfor Mendelsk randomisering passer til spørsmålet, og angi målene med eventuelle forhåndsspesifiserte årsakshypoteser. | En begrunnelse som aldri sier hvorfor en studie eller en kohort ikke er nok. |
| 4 (a til e) | Metoder, datakilder | For hver kilde oppgi settingen, deltakerne og utvalgsstørrelsen, om styrke ble beregnet på forhånd, hvordan varianter ble målt og filtrert, hvordan eksponering og utfall ble vurdert, og etisk godkjenning. En kildetabell anbefales. | Et datasett som kun er navngitt etter identifikatoren, uten populasjons- eller saksdefinisjon. |
| 5 | Metoder, antagelser | Angi de tre kjerneforutsetningene (relevans, uavhengighet, eksklusjonsbegrensning) for hovedanalysen, pluss eventuelle ekstra forutsetninger for sensitivitetsanalyser. | Liste opp forutsetningene uten å si hvordan hver enkelt ble undersøkt. |
| 6 (a til e) | Metoder, hovedanalyse | Beskriv enheter og skala, hvordan varianter og vekter ble håndtert, estimatoren og kovariatene, manglende data og multippel testing. | En effekt rapportert per enhet av en uforklarlig skala. |
| 7 og 8 | Metoder, kontroller | Si hvilke metoder eller forkunnskaper som støtter antagelsene, og list opp alle sensitivitets- eller tilleggsanalyser. | En F-statistikk behandlet som bevis på at instrumentene er gyldige. |
| 9 (a og b) | Metoder, programvare og registrering | Navngi programvare, pakker, versjoner og innstillinger, og angi om protokollen ble registrert, når og hvor. | En pakke med navn uten versjon. |
| 10 (a til d) | Resultater, beskrivende data | Rapporter tall på hvert trinn, sammendragsstatistikk, heterogenitet i enhver metaanalysert kilde, og for design med to utvalg, likheten mellom variant-eksponeringsassosiasjoner og overlappingen mellom utvalgene. | Stillhet ved overlapping når begge datasettene trekker på én biobank. |
| 11 (a til d) | Resultater, hovedfunn | Rapporter assosiasjoner mellom variant-eksponering og variant-utfall, Mendelske randomiseringsestimater på en tolkbar skala, absolutt risiko der det er relevant, og plott. | Log-odds ble ikke konvertert, og det er ikke vist noen plott av dataene per variant. |
| 12 og 13 | Resultater, antagelseskontroller og sensitivitet | Rapporter antagelsessjekkene og heterogenitetsstatistikken, sensitivitetsanalysene, eventuelle tester av årsakssammenheng, sammenligning med ikke-Mendelsk-randomiserte estimater og ekstra plott, for eksempel «leave-one out». | En pleiotropitest rapportert uten noen kommentar til dens styrke. |
| 14 og 15 | Diskusjon | Oppsummer hovedresultatene mot målene, og diskuter deretter begrensninger som dekker antagelsene, annen skjevhet og upresisjon, inkludert retningen og størrelsen på eventuell skjevhet. | Begrensninger som lister opp problemer uten å si hvilken vei de presser estimatet. |
| 16 og 17 | Diskusjon | Tolk med forsiktighet, diskuter mekanisme og gen-miljø-ekvivalens, klinisk relevans og generaliserbarhet til andre populasjoner, eksponeringstidspunkt og eksponeringsnivåer. | Kausal formulering sterkere enn antagelsene tillater. |
| 18 til 20 | Annen informasjon | Beskriv finansiering og bidragsyternes rolle, gi tilgang til dataene og koden, og erklær interessekonflikter. | Koden er beskrevet som tilgjengelig på forespørsel. |
Punkt 4, 6, 10 og 13 i STROBE-MR-sjekklisten har flest underpunkter, og det er der mesteparten av rapporteringsarbeidet ligger. Lesere som ønsker statistikken bak dem, kan starte med innleggene våre om svake instrumenter og F-statistikken , pleiotropi og de fire standardestimatorene og potensberegningen som de fleste artikler utelater , og forklaringen av Mendelsk randomisering dekker metoden fra ende til annen.
Eksemplet med åpen tilgang vi brukte for STROBE-MR-sjekklisten
Vi valgte en Mendelsk randomiseringsstudie med to utvalg, publisert i oktober 2026 i Endocrinology, Diabetes & Metabolism av Zaka og kolleger [3] . Den spør om genetisk forutsagt serum 25-hydroksyvitamin D er assosiert med type 2 diabetes hos sørasiater. Forfatterne oppgir at arbeidet er rapportert i samsvar med STROBE-MR, og PMC-posten viser ingen tilleggsfil, så vi scoret fullteksten, tabellene og figurene mot STROBE-MR-sjekklisten. Artikkelen er lisensiert CC BY 4.0. Crossref viser versjonen av posten under denne lisensen, og Europe PMC og PMCs åpen tilgangspost har samme lisens.
- Design. To-utvalgs Mendelsk randomisering med sammendragsstatistikk fra OpenGWAS-databasen OpenGWAS.
- Eksponering. Serum 25-hydroksyvitamin D fra en sør-asiatisk britisk biobank GWAS (n = 7 380), instrumentert med tre varianter.
- Utfall. Type 2-diabetes fra en metaanalyse av 16 sørasiatiske kohorter (n = 50 533, med 16 677 tilfeller) [5].
- Hovedresultat. Invers variansvektet oddsratio 1.06 (95 % KI 0.83 til 1.36) per 1 SD av genetisk forutsagt 25-hydroksyvitamin D.
Hver dom nedenfor er vår lesning av artikkelen mot det parafraserte elementet. Vi bruker fire etiketter. Rapportert betyr at artikkelen svarer på elementet med sine egne ord. Vurdering betyr at fornuftige lesere kan være uenige, vanligvis fordi svaret er delvis eller står et annet sted. Ikke funnet i artikkelen betyr at vi ikke fant noen påstand i fullteksten eller PDF-filen. Ikke aktuelt betyr at elementet er avhengig av noe som sammendragsnivådata ikke kan gi, eller av en analyse som artikkelen ikke kjørte og forklarer. Sitatene er ordrett og korte.
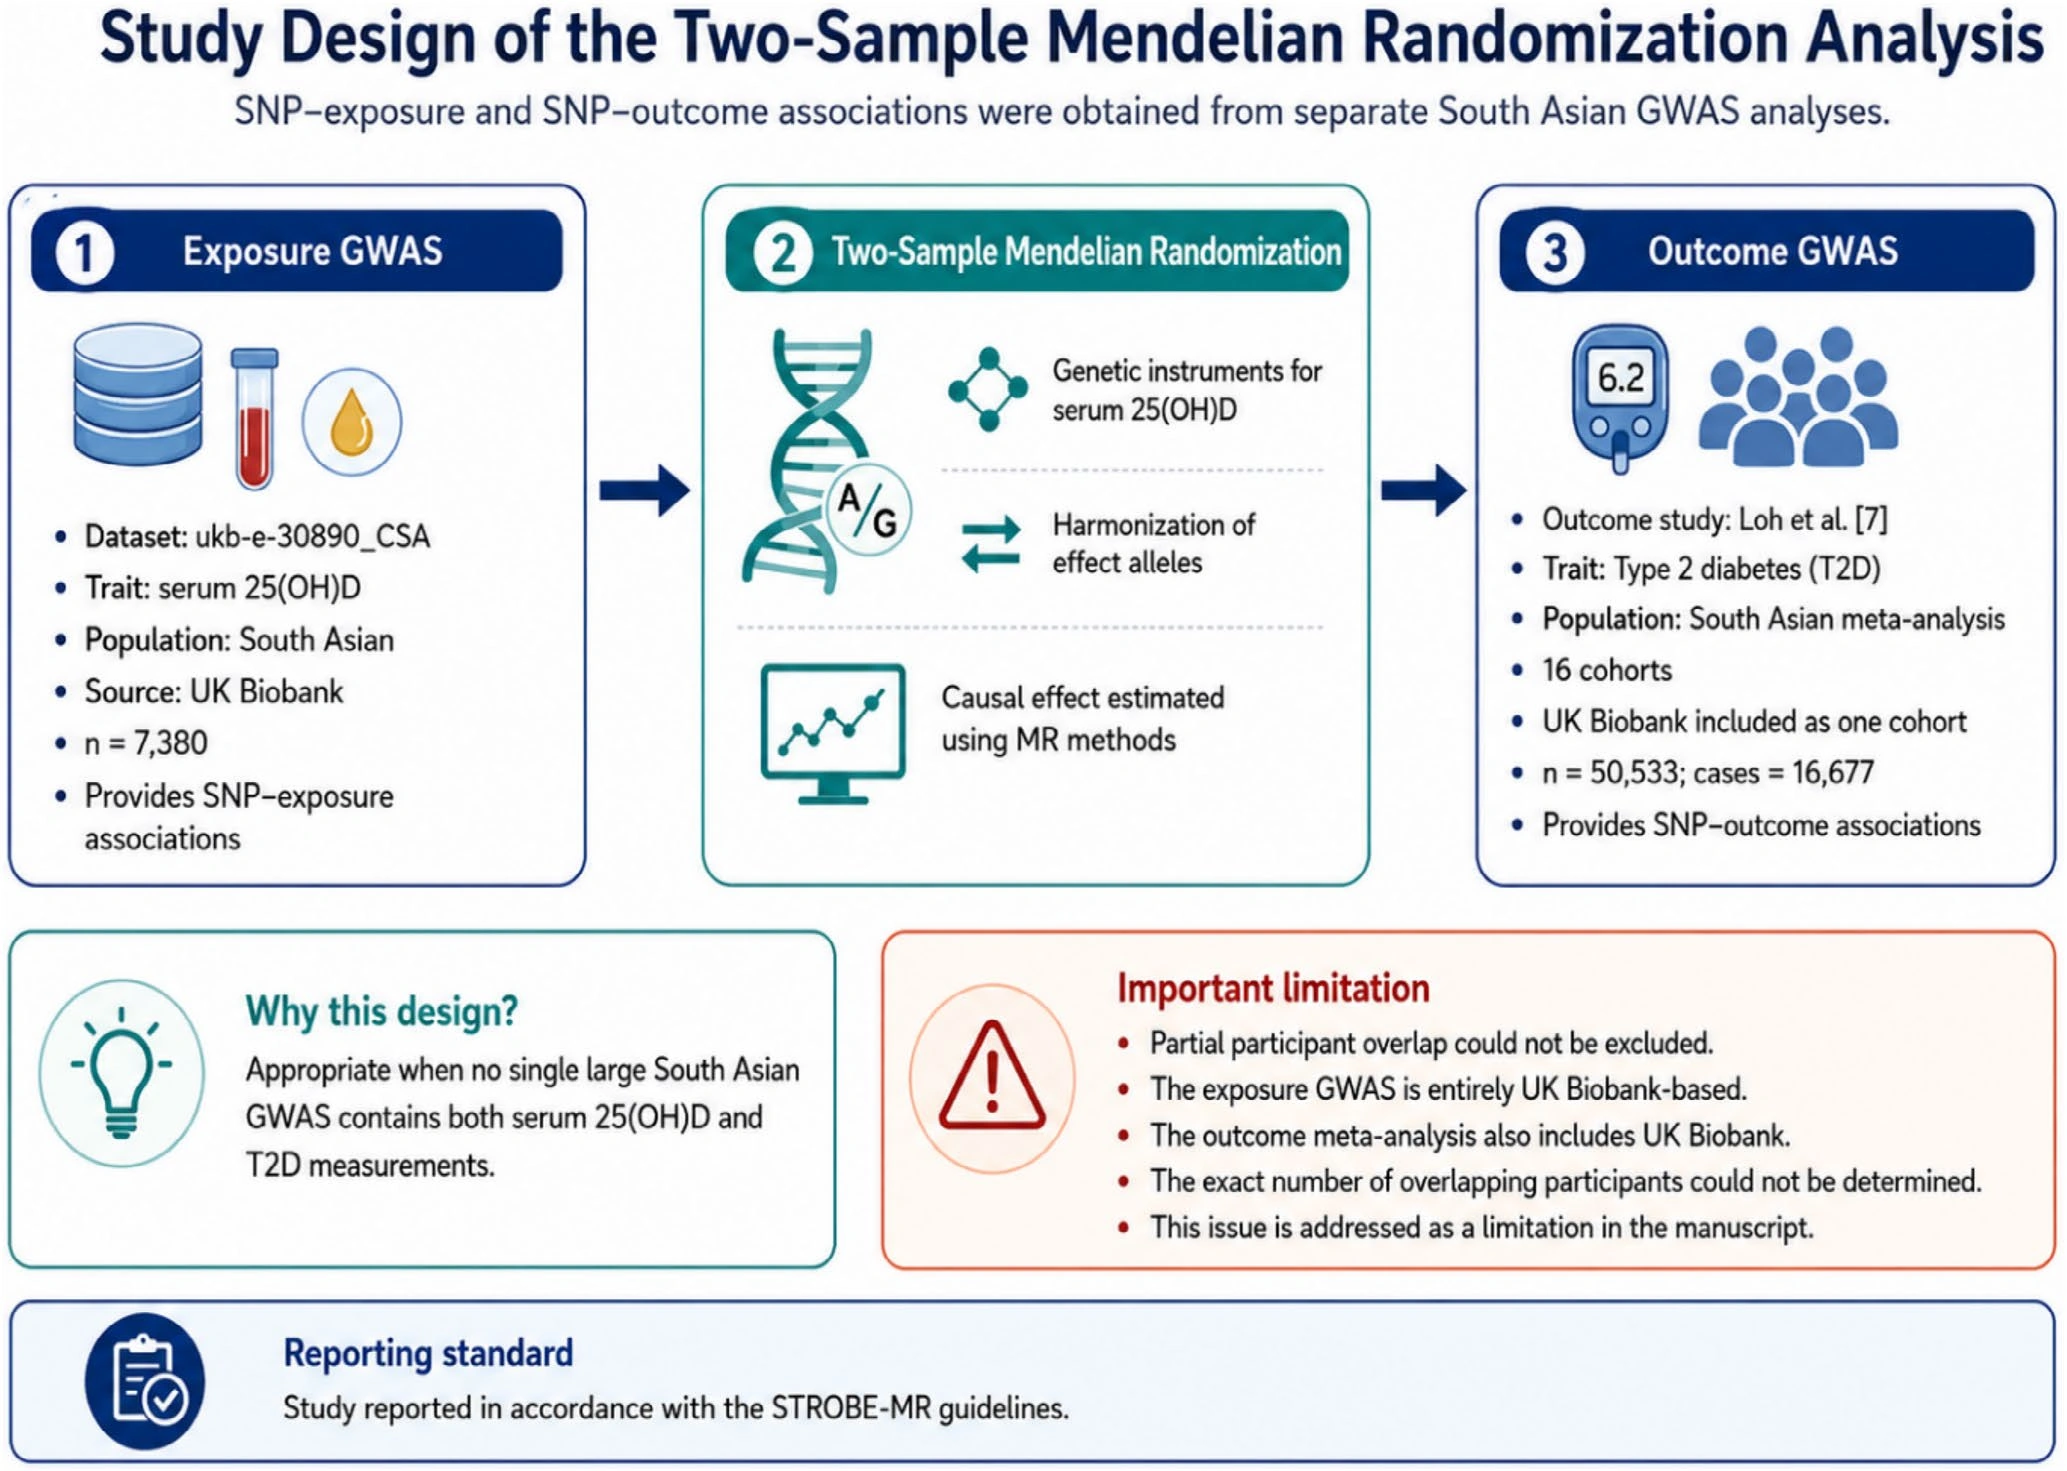
Figur 1 besvarer allerede deler av punkt 4, fordi den viser begge datakildene, utvalgsstørrelsene deres og overlappingsproblemet på én side. Det er den typen tidlig designsammendrag punkt 4 ber om.
STROBE-MR-sjekkliste anvendt på eksemplet, element for element
| Sak | Hvor i artikkelen | Hva artikkelen gjør | Kjennelse |
|---|---|---|---|
| 1 | Tittel; Sammendrag | Tittelen navngir designet som en «Exploratory Two-Sample Mendelian Randomization Study», og abstraktet Metoder åpner med en to-utvalgsanalyse ved bruk av OpenGWAS-sammendragsstatistikk. | rapportert |
| 2 | Introduksjon | Gir byrden av vitamin D-mangel og type 2-diabetes i Sør-Asia, en mekanisme gjennom reseptorer i pankreatiske betaceller, problemet med forvirrende og omvendt årsakssammenheng i observasjonsdata, og argumentet for Mendelsk randomisering. | rapportert |
| 3 | Slutt på introduksjonen | Sier målet som «å evaluere sammenhengen mellom genetisk predikerte vitamin D-nivåer og risiko for type 2-diabetes hos sørasiater». Målet snakker om sammenheng, og ingen forhåndsspesifisert årsakshypotese er betegnet som sådan. | Domsavgjørelse |
| 4 | Avsnitt 2.1; Tabell 1; Figur 2 i artikkelen | Presenterer designet tidlig, med en tabell over datasettidentifikatorer, trekk, aner og utvalgsstørrelse, og et designdiagram. | rapportert |
| 4a | Seksjon 2.1 og 2.2 | Navngir eksponeringen GWAS (South Asian UK Biobank subset) og utfallsmetaanalysen av 16 kohorter. Rekrutteringsperioder og settinger for de bidragende kohortene er overlatt til kildeartiklene. | Domsavgjørelse |
| 4b | Avsnitt 2.2; Tabell 1; Avsnitt 2.6 | Gir utvalgsstørrelser og definisjon av type 2-diabetes-tilfellet. Styrkeberegningen beskrives som post hoc, mens oppgaven spør om en ble utført før hovedanalysen. | Domsavgjørelse |
| 4c | § 2.3 | Rapporterer den genomomfattende terskelen, den avslappede terskelen som brukes for to varianter, klumping ved r2 under 0.001 i et vindu på 10 000 kb mot et sørasiatisk referansepanel, proxy- og palindromisk håndtering, og genomoppbyggingen. | rapportert |
| 4d | § 2.2 | Definerer type 2-diabetes etter sykehistorie eller behandling, fastende glukose, 2-timers glukose eller HbA1c, og angir den rangnormaliserte skalaen for 25-hydroksyvitamin D. Laboratoriemetoden for måling av eksponeringen er ikke beskrevet. | Domsavgjørelse |
| 4e | Avsnitt 2.2; Etikkuttalelse | Oppgir at arbeidet er en sekundæranalyse av offentlige sammendragsdata og at «formell etisk godkjenning ikke var nødvendig». | rapportert |
| 5 | § 2.4 | Lister opp relevans, eksklusjonsbegrensning og uavhengighet som de tre kjerneforutsetningene. Forutsetningene bak sensitivitetsestimatorene vises kun som en merknad i tabell 3 (minst 50 % gyldige varianter for den vektede medianen). | Domsavgjørelse |
| 6a | Seksjon 2.3 og 2.5 | Rapporterer effekter per 1 SD av den rangnormaliserte eksponeringen, som log-odds konvertert til oddsforhold. | rapportert |
| 6b | Seksjon 2.3 og 2.5 | Behandler den enkle genomomfattende varianten som et Wald-forholdsinstrument og settet med tre varianter med inverse variansvekter. | rapportert |
| 6c | § 2.5 | Navngir estimatorene. Artikkelen sier ikke hvilke kovariater som ble brukt i noen av GWAS-ene. | Domsavgjørelse |
| 6d | § 2.3 | Oppgir at alle tre variantene var tilgjengelige i utfallsdataene, og at ingen proxyer var nødvendig. Den har ingen bredere uttalelse om manglende data. | Domsavgjørelse |
| 6e | Ingen uttalelse funnet | Analysen fokuserer på én eksponering og ett utfall, så elementet biter kanskje ikke, men artikkelen er taus. | Domsavgjørelse |
| 7 | Seksjon 2.3 og 2.4 | Bruker F-statistikk og varians forklart per variant og sier at «F > 10 indikerer akseptabel konvensjonell instrumentstyrke, men etablerer ikke i seg selv uavhengighets- eller eksklusjons-begrensningsforutsetningene». | rapportert |
| 8 | Seksjon 2.5 og 3.4 | Planlegger MR-Egger, vektet median, enkel modus og vektet modus, og legger deretter til løp ved to avslappede terskler (68 og 18 varianter) og et BMI-justert utfall. | rapportert |
| 9a | § 2.5 | Navnene R 4.3.1, TwoSampleMR-pakken versjon 0.7.0 og mRnd-rammeverket for strømforsyning. | rapportert |
| 9b | Ingen uttalelse funnet | Ingen registreringserklæring vises, selv om den BMI-justerte analysen kalles «forhåndsspesifisert». | Ikke plassert i artikkelen |
| 10a | Tabell 1 | Det ble brukt data på sammendragsnivå, så det finnes ingen deltakerflyt. Tabell 1 viser størrelsene. | Ikke aktuelt |
| 10b | Avsnitt 2.2; Tabell 1 | Gir utvalgsstørrelsene og casefraksjonen (0.330). Det er ikke gitt gjennomsnitt eller standardavvik for eksponeringen. | Domsavgjørelse |
| 10c | § 2.1 | Resultatet kombinerer 16 kohorter, og ingen heterogenitetsstatistikk på tvers av dem vises. Kildeartikkelen kan rapportere en. | Domsavgjørelse |
| 10d (i) | § 2.1 | Begge datasettene er sørasiatiske, og artikkelen forklarer hvorfor en design med to utvalg var nødvendig. Den sammenligner ikke variant-eksponeringsassosiasjoner på tvers av de to utvalgene. | Domsavgjørelse |
| 10d (ii) | Avsnitt 2.1; Avsnitt 5 | Sier at «Det nøyaktige antallet overlappende deltakere i den britiske biobanken ikke kunne bestemmes ut fra den publiserte rapporten eller dens tilleggsdata», og begrenser deretter den mulige skjevheten med en verst tenkelig overlappingsandel på 0.146. | Domsavgjørelse |
| 11a | Tabell 2; figur 3 i artikkelen | Variant-eksponeringseffekter, standardfeil og p-verdier er vist i tabell 2. Variant-utfallseffekter vises kun i spredningsplottet. | Domsavgjørelse |
| 11b | Avsnitt 3.3; Tabell 3 | Rapporterer en oddsratio på 1.06 (95 % KI 0.83 til 1.36) per SD, med p = 0.630, på en tolkbar skala. | rapportert |
| 11c | Ingen uttalelse funnet | Ingen oversettelse til absolutt risiko, som passer til et primært estimat som ikke er gyldig, men artikkelen sier ikke hvorfor. | Domsavgjørelse |
| 11d | Figur 3 og 4 i artikkelen | Gir et spredningsplott med linjer for hver estimator og et traktplott. Det vises ikke noe skogplott av estimater per variant. | rapportert |
| 12a | Seksjon 3.1 og 3.2 | Rapporterer F-statistikk fra 26.4 til 33.4, Q p = 0.403 og et Egger-skjæringspunkt p = 0.462, og legger til at «et ikke-signifikant skjæringspunkt ikke bør tolkes som betryggende bevis på at horisontal pleiotropi er fraværende». | rapportert |
| 12b | Avsnitt 3.2; Tabell 3 og 4 | Gir Cochran Q for IVW og MR-Egger i hovedanalysen og for IVW ved de to avslappede terskelverdiene. | rapportert |
| 13a | Avsnitt 3.4 og 3.5; Tabell 3 og 4 | Rapporterer fire alternative estimatorer, to avslappede terskler og det BMI-justerte utfallet. | rapportert |
| 13b | Avsnitt 3.5 og 3.6; Tabell 5 | Rapporterer BMI-justert analyse og styrke på omtrent 18 %, 51 % og over 99 % for oddsratioer på 1.1, 1.2 og 1.5. | rapportert |
| 13c | § 2.3 | Ingen test av årsakssammenheng ble utført. Artikkelen sier at Steiger-filtrering ikke ble brukt, og oppgir årsaken, som var tidligere biologisk kunnskap om instrumentene. | Ikke aktuelt |
| 13d | § 4.1 | Sammenligner resultatet med tidligere Mendelske randomiseringsstudier og supplementeringsforsøk i ord. Ingen ikke-Mendelsk randomiseringsestimat er beregnet. | Domsavgjørelse |
| 13e | § 5 | Viser ikke et plott for å utelate én, og sier at MR-PRESSO- og analysene for å utelate én «ikke kunne utføres med tilstrekkelig presisjon». | Domsavgjørelse |
| 14 | Avsnitt 4, første avsnitt | Gjentar nullresultatet mot målet og bemerker at MR-Egger-estimatet var for upresist til å bekrefte det. | rapportert |
| 15 | § 5 | Lister opp syv begrensninger, og estimerer størrelsen på den mulige skjevheten for utvalgsoverlapping ved hjelp av en avgrensningstilnærming. | rapportert |
| 16a | Avsnitt 3.3, 4.1 og 6 | Tolker nullen som «et fravær av en påvisbar assosiasjon innenfor presisjonen som gis av nåværende instrumenter» og sammenligner den med tidligere arbeid. | rapportert |
| 16b | § 4.2 | Tilbyr tre forklaringer, inkludert ikke-lineære effekter. Begrepet gen-miljø-ekvivalens brukes ikke. | Domsavgjørelse |
| 16c | § 4.3 | Sier at tilskudd som tar sikte på å forebygge type 2-diabetes ikke støttes av nåværende årsakssammenheng, og at andre fordeler ikke utelukkes. | rapportert |
| 17 | Seksjon 4.2 og 5 | Merker at deltakere bosatt i Storbritannia kan avvike fra personer i Pakistan, at livslang genetisk eksponering er forskjellig fra tidsbegrensede studier, og at lineære metoder ikke kan oppdage ikke-lineære effekter. | rapportert |
| 18 | Ingen uttalelse funnet | Ingen finansieringserklæring vises i fullteksten eller PDF-filen, og Crossref oppgir ingen finansieringskilde for artikkelen. | Ikke plassert i artikkelen |
| 19 | Erklæring om datatilgjengelighet | Gir OpenGWAS-identifikatorene. For kode står det at skriptet og datasettet «blir lagt inn i et offentlig arkiv», med lenken som skal legges til. | Domsavgjørelse |
| 20 | Interessekonflikter | Opplyser at forfatterne ikke har noen interessekonflikter. | rapportert |
På tvers av de 44 radene i STROBE-MR-sjekklisten er 22 rapporterte, 18 vurderingskall, 2 finnes ikke i artikkelen og 2 er ikke aktuelle. Opptellingen beskriver hvor fullstendig artikkelen er transparent mot de omskrevete elementene, og det er ikke en kvalitetspoengsum. Flere vurderingskall kommer fra underelementer som sjekklisten selv markerer som betingede.
To rader fortjener en merknad om metode. For punkt 4b spør forklarende artikkel om det ble utført en potensberegning før hovedanalysen, og en post hoc-beregning svarer på et annet spørsmål, så vi merket det som en vurderingsprosess i stedet for et gap. For punkt 19 gir artikkelen dataidentifikatorer som alle kan følge, men kodesetningen er et løfte, og et løfte kan ikke kontrolleres.
Hva tallene i eksemplet viser
En sjekkliste for rapportering er nyttig delvis fordi den lar leseren gjenoppbygge tallene. Vi utledet overskriftsmengdene i tabell 3 fra verdier som er trykt i artikkelen. Der vi samsvarer, er rapporteringen internt konsistent, noe som er det STROBE-MR-sjekklisten er ment å muliggjøre. Der vi er uenige, er det punktet som skal kontrolleres det som ber forfatterne om å oppgi sine metoder og innstillinger.
| Antall | Vår omdanning fra trykte verdier | Artikkelrapporter | Kommentar |
|---|---|---|---|
| F-statistikk, variant rs3755967 | (0.099 / 0.017)2 = 33.9 | 33.4 | Innenfor avrunding av den viste standardfeilen |
| F-statistikk, variant rs2459139 | (0.108 / 0.020)2 = 29.2 | 29.0 | Innenfor avrunding |
| F-statistikk, variant rs72744878 | (0.101 / 0.020)2 = 25.5 | 26.4 | Innenfor avrunding, siden en standardfeil på 0.0197 skrives ut som 0.020 og gir 26.4 |
| Gjennomsnittlig F-statistikk | (33.4 + 29.0 + 26.4) / 3 = 29.6 | 29.6 | Match |
| Total varians forklart | 0.405 + 0.342 + 0.309 = 1.056 % | 1.06% | Match |
| IVW oddsratio | eksp(0.058) = 1.06 | 1.06 | Match |
| IVW p-verdi | z = 0.058 / 0.120 = 0.483, p = 0.629 | 0.630 | Match |
| IVW 95 % intervall | eksp(0.058 ± 1.96 × 0.120) = 0.84 til 1.34 | 0.83 til 1.36 | Vurdering. Artikkelen oppgir ikke hvordan intervallet ble beregnet. |
| Andre estimatorintervaller | Vektet median, enkel modus, vektet modus og MR-Egger | Som trykt | Samsvar når det beregnes på nytt fra hver beta- og standardfeil |
Den ene forskjellen som er verdt en setning er IVW-intervallet. De rapporterte 0.83 til 1.36 samsvarer også med det BMI-justerte IVW-estimatet (beta 0.062, standardfeil 0.125), mens det primære estimatet med standardfeil 0.120 gir 0.84 til 1.34. Forskjellen er liten, men avrunding av de trykte verdiene kan ikke forklare det, fordi et intervall på 0.83 til 1.36 trenger en standardfeil nær 0.126. En annen intervallmetode, for eksempel en som blåser opp standardfeilen når heterogenitet er til stede, er en mulig årsak. Punkt 6 ber forfatterne beskrive estimatoren og relatert statistikk, og én klausul som navngir intervallmetoden ville fjerne spørsmålet. I begrensningene gir overlappingspassasjen også skjevheten til omtrent 0.32 % og til omtrent 5.6 % av IVW-estimatet, slik at en leser må utlede hvilken nevner hvert tall bruker.
Fire rapporteringsleksjoner fra STROBE-MR-sjekklisten
Eksemplet inneholder fire lærdommer som gjelder for enhver STROBE-MR-sjekkliste du fullfører.
Si hva du ikke kunne oppnå, og anslå verst tenkelige scenario
Utvalgsoverlapping er det elementet som oftest får én vag setning. Her er eksponerings-GWAS utelukkende UK Biobank, og resultatmetaanalysen inkluderer UK Biobank, og forfatterne skriver at «Det nøyaktige antallet overlappende UK Biobank-deltakere kunne ikke bestemmes ut fra den publiserte rapporten eller dens tilleggsdata». De rapporterer deretter at MRlap-verktøyet mislyktes fordi kovarianstrinnet returnerte udefinerte verdier, og erstatter en avgrensningsberegning med en antatt overlappingsandel på 0.146 og fenotypisk korrelasjon på −0.12. Det er mønsterelement 10d ber om, nemlig et tall der én eksisterer og en avgrensning der den ikke gjør det.
Skill instrumentstyrke fra instrumentvaliditet
Artikkelen slår fast at «F > 10 indikerer akseptabel konvensjonell instrumentstyrke, men etablerer ikke i seg selv uavhengighets- eller eksklusjonsrestriksjonsforutsetningene». Forklaringsartikkelen påpeker et beslektet poeng, nemlig at en F-statistikk over 10 ikke utelukker svak instrumentskjevhet, og den sammenligner tommelfingerregelen med en grense for p-verdier [1] . Å skrive begge halvdelene av setningen beskytter artikkelen mot en anmelder som leser F-statistikken som en dom.
Si når en diagnose ikke har noen kraft
Med tre varianter har MR-Egger-skjæringspunktet én gjenværende frihetsgrad. Forfatterne skriver at «et ikke-signifikant skjæringspunkt ikke bør tolkes som betryggende bevis på at horisontal pleiotropi er fraværende». En pleiotropitest rapportert uten denne setningen innbyr til lesningen at studien er ren. Innlegget vårt om hva hver pleiotropiestimator beskytter mot forklarer hvorfor antallet varianter begrenser hver metode.
Lukk sløyfen mellom metoder, begrensninger og referanselisten
Fire detaljer i den publiserte artikkelen ville ført til spørsmål fra en redaktør. Avsnitt 2.3 sier at Steiger-retningsfiltrering ikke ble brukt, men avsnitt 5 sier at detaljene «bør bekreftes og rapporteres i de endelige metodene», som kan leses som et utkast til artikkelen. Datatilgjengelighetserklæringen lover en lenke til arkivet som ennå ikke er i teksten. Designfiguren (vår figur 1) siterer resultatstudien som referanse 7, mens referanselisten oppgir den som referanse 9, og referanse 7 er en gjennomgang av Davey Smith og Hemani. Overlappingsbegrensningstilnærmingen er kreditert Burgess og kolleger som referanse 11, og listen viser referanse 11 som MR-Egger-tolkningsartikkelen av Burgess og Thompson. Ingenting av dette endrer funnene. Alt dette kan fikses i en endelig lesing av bevisene, og det er derfor vi anbefaler å sjekke alle plassholdere og siteringsnummer mot sjekklisten før innsending.
Slik fullfører du din egen STROBE-MR-sjekkliste
STROBE-MR-sjekklisten fungerer best når den fylles ut mens manuskriptet skrives, ikke etter at en anmelder spør. Trinnene nedenfor følger rekkefølgen svarene vanligvis blir tilgjengelige i.
- Last ned sjekklisten fra STROBE-MR nettsted eller fra forklaringspapiret [1], og legg til en kolonne for siden eller seksjonen der hvert svar står.
- Bygg en datakildetabell tidlig i Methods, med datasettidentifikatorer, egenskap, aner, utvalgsstørrelse, saksnumre og genomoppbygging, slik eksemplet gjør i tabell 1.
- Skriv overlappingssetningen selv når overlappingen er null. Hvis du ikke kan telle den, oppgi en grense.
- Rapporter F-statistikk og varians forklart per variant, og legg deretter til en styrkeerklæring for effektstørrelsen som er viktig.
- Oppgi registreringsstatusen, inkludert en klar erklæring om ingen registrering når det er tilfelle, siden punkt 9b ber om en erklæring uansett.
- Legg inn koden og det harmoniserte datasettet før innsending, og erstatt alle plassholdere med en lenke.
- For rader som ikke gjelder, skriv en årsak på én linje i raden i stedet for å la den stå tom.
- Oppgi i metodelisten at studien fulgte STROBE-MR, og legg ved den utfylte sjekklisten hvis tidsskriftet ber om det. sjekkliste for innlevering av manuskript viser de andre filene redigerere forventer.
Vanlige feil ved rapportering av en Mendelsk randomiseringsstudie
Dette er de sjekklistene vi forventer å se oftest når en STROBE-MR-sjekkliste fullføres for sent, og hver av dem er knyttet til et bestemt element.
- Navngi datasett uten å beskrive dem. Punkt 4 ønsker populasjon, datoer, utvalgsstørrelse og case-definisjon for hver kilde.
- Rapporterer kun den primære estimatoren. Punkt 8 og 13 ønsker alle sensitivitetsanalyser, inkludert de som er uenige.
- Utelatelse av registreringsstatus. Punkt 9b ber om en uttalelse uansett.
- Ved å bruke kausal språkbruk kan ikke antagelsene holde. Punkt 16 ber forfatterne om å si at estimater kun er årsakssammenhengende under angitte forutsetninger.
- Lovende kode. Punkt 19 ønsker koden eller dens plassering, og en fremtidig lenke er ikke en plassering.
Ofte stilte spørsmål om STROBE-MR-sjekklisten
Hvor mange punkter inneholder STROBE-MR-sjekklisten?
STROBE-MR-sjekklisten har 20 elementer, og flere av dem har underelementer med bokstaver, så et utfylt skjema har mer enn 20 rader [1].
Erstatter STROBE-MR STROBE-sjekklisten?
For en Mendelsk randomiseringsrapport er STROBE-MR retningslinjen å følge. For en konvensjonell observasjonsstudie, bruk STROBE, som vår STROBE-veiledning dekker.
Bør STROBE-MR brukes til å vurdere kvaliteten på en publisert studie?
Nei. Forfatterne hevder at STROBE-MR-sjekklisten ikke bør gjøres om til en kvalitetsskala, og at den eksisterer for å gjøre vurdering mulig snarere enn å utføre den [1].
Er det nødvendig med en effektberegning for å oppfylle punkt 4b?
Punkt 4b i STROBE-MR-sjekklisten ber forfatterne rapportere utvalgsstørrelsen og om det ble utført noen potens- eller utvalgsstørrelsesberegninger før hovedanalysen. En påstand om at ingen ble utført er et gyldig svar, og en post hoc-beregning bør merkes som sådan, slik eksemplet gjør.
Gratis forskningsverktøy fra Editverse
- GraphProLag publikasjonsklare diagrammer, 25 typer, med innebygd t-test, ANOVA, korrelasjon og kji-kvadrat p-verdier. Gratis, ingen registrering.
- StatProGratis statistiske kalkulatorer og et testutvelgerverktøy som dekker gruppesammenligninger, kategoriske utfall, analyse av tid til hendelse og diagnostisk nøyaktighet.
- Flytskjema ProGenerer flytdiagrammer for PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE og ARRIVE direkte i nettleseren din.
Faglig støtte for et manuskript om mendelsk randomisering
En sjekkliste kan bare registrere hva analysen allerede inneholder. Enten du planlegger analysen eller forbereder deg på å fullføre STROBE-MR-sjekklisten, støtter Editverse forfattere i begge stadier, og arbeidet vårt følger veiledningen fra COPE, ICMJE og GPP 2022, med institusjonelle og landsspesifikke etiske krav overholdt. Den fullstendige studiepakken nedenfor inkluderer en utfylt STROBE-MR-sjekkliste.
Før du forplikter deg
$450
En senioranalytiker sjekker om spørsmålet ditt allerede er besvart, om dataene kan støtte det, og om du har den nødvendige styrken, inkludert instrumentstyrken, for et Mendelsk randomiseringsdesign. Godskrives i sin helhet mot enhver studie du bestiller. 5 virkedager.
Full studie
$2,900
To-utvalgs Mendelsk randomisering fra offentlig GWAS-sammendragsstatistikk, med instrumentstyrke, Steiger-filtrering, fire estimatorer som undersøker pleiotropi, MR-PRESSO, manuskript, plott, kjørbar TwoSampleMR-kode og en STROBE-MR-sjekkliste. 15 virkedager.
Send oss utkastet ditt og tidsskriftet du sikter deg inn på, så sier vi hvilken av de to som passer der du er.
Konklusjon
STROBE-MR-sjekklisten gjør en Mendelsk randomiseringsartikkel fra et sett med resultater til noe en leser kan revidere. Anvendt på en ekte åpen tilgangsstudie, viser den hvordan god rapportering ser ut, med kvantifiserte verst tenkelige tilfeller, ærlige notater om tester med lav styrke og et designdiagram på den første siden av Methods, og den viser hvor selv en nøye artikkel etterlater hull, nemlig registrering, finansiering, kovariater og kode. Fullfør sjekklisten før innsending, skriv en begrunnelse i hver rad som ikke gjelder, og sjekk alle plassholdere og siteringsnummer i de endelige korrekturene.
Referanser
- Skrivankova VW, Richmond RC, Woolf BAR, Davies NM, Swanson SA, VanderWeele TJ, et al. Styrking av rapporteringen av observasjonsstudier i epidemiologi ved bruk av mendelsk randomisering (STROBE-MR) forklaring og utdyping. BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233. PMID 34702754. PMC8546498.
- Skrivankova VW, Richmond RC, Woolf BAR, Yarmolinsky J, Davies NM, Swanson SA, et al. Styrking av rapporteringen av observasjonsstudier i epidemiologi ved bruk av Mendelsk randomisering. STROBE-MR-utsagnet. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID 34698778.
- Zaka A, Khan S, Shah A, Khalid AA, Khalil I, Kamrul-Hasan ABM. Sammenheng mellom genetisk predikert 25-hydroksyvitamin D og risiko for type 2 diabetes hos sørasiater. En utforskende to-utvalgs Mendelsk randomiseringsstudie. Endokrinol Diabetes Metab. 2026;9(6):e70359. doi:10.1002/edm2.70359. PMID 42912852. PMCID PMC13690357Lisens CC BY 4.0.
- Woolf B, Di Cara N, Moreno-Stokoe C, Skrivankova V, Drax K, Higgins JPT, et al. Undersøkelse av rapporteringstransparens i Mendelske randomiseringsstudier med to utvalg av sammendragsdata ved bruk av MR-Base-plattformen. Int J Epidemiol. 2022;51(6):1943-1956. doi:10.1093/ije/dyac074. PMID 35383846. PMC9749715.
- Loh M, Zhang W, Ng HK, Schmid K, Lamri A, Tong L, et al. Identifisering av genetiske effekter som ligger til grunn for type 2-diabetes i sørasiatiske og europeiske befolkninger. Kommun Biol. 2022, 5: 329. doi:10.1038/s42003-022-03248-5PMID 35393509.
Retningslinjens ordlyd er omskrevet fra STROBE-MR-forklaringsdokumentet, som er publisert under CC BY 4.0. ICMJE-anbefalingene er tilgjengelige på icmje.org.