
Publisert
.tp{farge:#333333 !viktig;linjehøyde:1.7 !viktig;margin:0 0 16px 0 !viktig}
.th2{farge:#0d2137 !viktig;margin:36px 0 14px 0 !viktig;linjehøyde:1.3 !viktig}
.th3{farge:#0d2137 !viktig;margin:24px 0 10px 0 !viktig;linjehøyde:1.35 !viktig}
.tl{farge:#003057 !viktig;skriftvekt:600;tekstdekorasjon:understrek}
.tt{border-collapse:collapse;width:100%}
.tt th{bakgrunnsfarge:#0d2137 !viktig;farge:#ffffff !viktig;tekstjustering:venstre;polstring:10px 12px !viktig;skriftstørrelse:.9rem;border:1px heldekkende #0d2137 !viktig}
.tt td{farge:#333333 !viktig;polstring:9px 12px !viktig;fontstørrelse:.9rem;vertikaljustering:topp;border:1px heldekkende #d8dee6 !viktig;linjehøyde:1.5}
.tt td.w{bakgrunnsfarge:#ffffff !viktig}
.tt td.g{bakgrunnsfarge:#f6f9fc !viktig}
.tt td.rg{bakgrunnsfarge:#f1f8f3 !viktig}
.tt td.rp{bakgrunnsfarge:#fff9ec !viktig}
.tt td.rn{bakgrunnsfarge:#fef1f1 !viktig}
.tt td.rj{bakgrunnsfarge:#f0f4fc !viktig}
.tt td.vg{bakgrunnsfarge:#d9eee0 !viktig;farge:#14532d !viktig;skriftvekt:700}
.tt td.vp{bakgrunnsfarge:#ffecc2 !viktig;farge:#6b4200 !viktig;skriftvekt:700}
.tt td.vn{bakgrunnsfarge:#fbd5d5 !viktig;farge:#7f1d1d !viktig;skriftvekt:700}
.tt td.vj{background-color:#d6e0f7 !important;color:#1e3a8a !important;font-weight:700}
DECIDE -AI-sjekklisten er rapporteringsretningslinjen for de første live, småskalatestene av et beslutningsstøttesystem for kunstig intelligens på virkelige pasienter. Den ble publisert i mai 2022 i både BMJ og Nature Medicine av Vasey og kolleger, og lister opp 17 AI-spesifikke elementer (28 rader når underelementer er telt) og 10 generiske elementer, og den ber om detaljer som retningslinjer for forsøk og modeller aldri trengte, for eksempel hvordan brukere ble trent, hvilken versjon av programvaren som kjørte for hvilken pasient, og hva som gikk galt. 1,2
De fleste guider stopper ved å liste opp elementene. Denne går lenger. Etter selve sjekklisten bruker vi den rad for rad på en reell åpen tilgangsstudie av et kirurgisk AI-system, publisert i oktober 2026, som oppgir at det fulgte DECIDE-AI, med delen av artikkelen ved siden av hver dom. DECIDE-AI-sjekklisten er den tidligere fasen som ledsager vår CONSORT-AI-sjekkliste , og vi gjentar ikke dette materialet her.
Med enkle ord
DECIDE-AI-sjekklisten er en liste på 38 rader (28 AI-rader og 10 generiske rader) for artikler som rapporterer et AI-verktøys første bruk med virkelige pasienter. Den forteller deg ikke hvordan du skal gjennomføre studien. Den forteller deg hva en leser må kunne finne, inkludert den nøyaktige programvareversjonen som brukes på hver pasient, alle feil og hvordan personene som bruker verktøyet taklet feilen. Skriv plasseringen av hver rad ved siden av før du sender inn, og skriv et kort negativt svar der studien ikke gjorde noe.
Hva DECIDE-AI-sjekklisten er, og hvor den passer inn blant retningslinjene for AI-rapportering
DECIDE-AI står for Developmental and Exploratory Clinical Investigations of Decision support systems drived by Artificial Intelligence (utviklings- og utforskende kliniske undersøkelser av beslutningsstøttesystemer drevet av kunstig intelligens). DECIDE-AI-sjekklisten er stadiumspesifikk og ikke designspesifikk. Retningslinjene retter seg mot live-evaluering, noe som betyr at beslutningene som tas med AI-systemet har en reell effekt på pasientbehandlingen, i motsetning til offline- eller skyggemodustesting der de ikke har det.1 Den foreskriver ikke et studiedesign, så en prospektiv kohort, en ikke-randomisert sammenligning eller en kasusserie kan alle bruke den, og den dekker deteksjons-, diagnostiske, prognostiske og terapeutiske systemer.1
Retningslinjen kom fra en modifisert Delphi-prosess i to runder, etterfulgt av et virtuelt konsensusmøte. Av ekspertene som deltok, fullførte 123 den første runden, 138 fullførte den andre og 16 deltok på konsensusmøtet, og forfatterne rapporterer om 151 eksperter fra 18 land på tvers av totalt 20 interessentgrupper.1 Sjekklisten er beskrevet som et sett med minimumsstandarder for rapportering, og den erstatter ikke regulatoriske krav.1
Tabellen nedenfor viser hvor DECIDE-AI-sjekklisten plasseres blant AI-retningslinjene. Den følger strukturen til fasekartet i den opprinnelige artikkelen, med våre egne ord. 1
Tabell 1. Hvor DECIDE-AI-sjekklisten plasseres blant retningslinjene for AI-rapportering. Struktur tilpasset fra Vasey et al., BMJ 2022.
| Guideline | Evalueringsfase | Studiedesignet den retter seg mot |
|---|---|---|
| STATIV-AI (nå STATIV+AI) | Preklinisk utvikling | Utvikling og validering av prediksjonsmodell |
| STARD-AI | Preklinisk utvikling og offline validering | Diagnostiske nøyaktighetsstudier |
| DECIDE-AI | Tidlig klinisk evaluering i sanntid | Ulike design, med ekstra funksjoner som endringer i systemet, forhåndsdefinerte undergrupper eller læringskurver |
| ÅND-KI | Sammenlignende prospektiv evaluering | Protokoller for randomiserte studier av AI-systemer |
| CONSORT-AI | Sammenlignende prospektiv evaluering | Rapporter om randomiserte studier av AI-systemer |
Tre punkter er viktige for innsendingen din. For det første ligger DECIDE-AI-sjekklisten mellom preklinisk arbeid og den store sammenlignende studien, så en studie som allerede har gått over til randomisering bør bruke CONSORT-AI-sjekklisten og, for en protokoll, SPIRIT-protokollveiledningen . Vår CONSORT 2025-veiledning forklarer hvorfor CONSORT 2025, med sine 30 elementer, erstattet CONSORT 2010. For det andre er DECIDE-AI-sjekklisten en rapporteringsretningslinje og ikke et vurderingsverktøy. Den sjekker om du beskrev hva du gjorde, ikke om det du gjorde var forsvarlig, og for vurdering av prediksjonsmodeller bruker anmeldere PROBAST . For det tredje, hvis spørsmålet ditt utelukkende handler om modellens nøyaktighet, les vår sammenligning av STARD og TRIPOD først, og bruk vårt beslutningstre for å velge en rapporteringsretningslinje for det bredere settet med alternativer.
DECIDE-AI-sjekklisten i korte trekk, alle 17 AI-elementer og 10 generiske elementer
Tabellen kondenserer den offisielle sjekklisten til 38 rader. Arabiske tall markerer de 17 AI-spesifikke elementene, og romertall markerer de 10 generiske elementene. Vi har omskrevet ordlyden for å holde den kort, så bruk den offisielle sjekklisten fra BMJ eller Nature Medicine-artikkelen for den nøyaktige teksten du sender inn. 1,2
Tabell 2. De 38 radene i DECIDE-AI-sjekklisten, forkortet. Kildestruktur fra Vasey et al., BMJ 2022.
| Sak | Emne | Hva som skal rapporteres (parafrasert) |
|---|---|---|
| 1 | Tittel | Navngi studien som en tidlig klinisk evaluering av et AI-beslutningsstøttesystem og angi hvilket problem den adresserer. |
| I | Abstrakt | Gi et strukturert sammendrag som dekker tiltenkt bruk, algoritmetype, setting, antall pasienter og brukere, utfall, sikkerhetsendepunkter, menneskelige faktorer, resultater og konklusjoner. |
| 2a | Tiltenkt bruk, tilstand | Beskriv tilstanden og problemet, gjeldende standardpraksis og den tiltenkte pasientgruppen. |
| 2b | Tiltenkt bruk, brukere | Beskriv de tiltenkte brukerne, den planlagte plassen i behandlingsforløpet og forventet innvirkning, inkludert på pasientutfall. |
| II | Mål | Angi målene. |
| III | Forskningsstyring | Oppgi eventuell protokoll, registreringsnummer og etikkgodkjenning. |
| 3a | Deltakere, pasienter | Beskriv rekruttering, inklusjon og eksklusjon på pasient- og datanivå, og hvordan antallet ble bestemt. |
| 3b | Deltakere, brukere | Svar på de samme spørsmålene for brukerne av AI-systemet. |
| 3c | Deltakere, tilegnelse | Beskriv trinnene som er tatt for å gjøre brukerne kjent, inkludert eventuell opplæring før studien. |
| 4a | AI-system, identitet | Oppgi versjon og algoritmetype, treningspopulasjon og preklinisk ytelse, eller en direkte referanse. |
| 4b | AI-system, innganger | Beskriv inndataene, hvordan de ble innhentet og lagt inn, forbehandling og håndtering av manglende data eller data av dårlig kvalitet. |
| 4c | AI-system, utganger | Beskriv resultatene og hvordan de ble vist til brukerne, ideelt sett med et bilde. |
| 5a | Implementering, innstilling | Beskriv hvor AI-systemet ble evaluert. |
| 5b | Implementering, arbeidsflyt | Beskriv behandlingsforløpet, når systemet ble brukt i det, hvem som tok den endelige støttede avgjørelsen og hvordan. |
| IV | Resultater | Spesifiser primære og sekundære utfall. |
| 6a | Sikkerhet og feil, definisjon | Beskriv hvordan betydelige feil eller funksjonsfeil ble definert og identifisert. |
| 6b | Sikkerhet og feil, risiko | Beskriv hvordan risikoer for pasientsikkerhet eller skade ble identifisert, analysert og redusert. |
| 7 | Menneskelige faktorer, metoder | Beskriv verktøyene, metodene eller rammeverkene for menneskelige faktorer, brukstilfellene og de involverte brukerne. |
| V | Analyse | Beskriv de statistiske metodene, forhåndsdefinerte ekstraanalyser og undergruppeanalyser. |
| 8 | etikk | Beskriv enhver metode som brukes for et etisk mål, for eksempel algoritmisk rettferdighet, og hvorfor. |
| VI | Pasientmedvirkning | Beskriv hvordan pasientene formet spørsmålet, utformingen eller oppførselen. |
| 9a | Deltakere, pasienter (resultater) | Rapporter baseline pasientkarakteristikker og manglende data i inndataene. |
| 9b | Deltakere, brukere (resultater) | Rapporter grunnleggende brukerkarakteristikker. |
| 10a | Implementering, eksponering | Rapporter brukereksponering, antall bruksområder og overholdelse av den tiltenkte implementeringen. |
| 10b | Implementering, endring av arbeidsflyt | Rapporter eventuelle vesentlige endringer i arbeidsflyten eller behandlingsforløpet. |
| VII | Hovedresultater | Rapporter de forhåndsspesifiserte resultatene, med en sammenligningsgruppe hvis det fantes en. |
| VIII | undergrupper | Rapporter forskjeller i hovedutfallene etter forhåndsspesifisert undergruppe. |
| 11 | modifikasjoner | Rapporter endringer i AI-systemet eller maskinvaren, tidspunktet og begrunnelsen for disse, og eventuelle endringer i resultatene etter hver endring. |
| 12 | Menneske-maskin-avtale | Rapporter brukerens samtykke til AI-en, årsaker til avvik fra den og eventuelle endringer i mening. |
| 13a | Sikkerhet og feil, hendelser | List opp betydelige feil med frekvens, tilsynelatende årsak, om de kan rettes og mulig innvirkning på behandlingen. |
| 13b | Sikkerhet og feil, skade | Rapporter sikkerhetsrisikoer og observerte skader, inkludert indirekte skader. |
| 14a | Menneskelige faktorer, brukervennlighet | Rapporter en brukervennlighetsevaluering ved bruk av anerkjente standarder eller rammeverk. |
| 14b | Menneskelige faktorer, læringskurver | Rapporter en evaluering av brukerens læringskurver. |
| 15 | Støtte for tiltenkt bruk | Diskuter om resultatene støtter den tiltenkte bruken i kliniske settinger. |
| 16 | Sikkerhet og feil, diskusjon | Diskuter sikkerhetsprofilen, feil og skader, deres implikasjoner og hvordan de kan reduseres. |
| IX | Styrker og begrensninger | Diskuter styrker og begrensninger. |
| 17 | Datatilgjengelighet | Si om og hvordan data og kode er tilgjengelige. |
| X | Interessekonflikter | Opplys om finansiering, rollen til bidragsytere og selskaper, og personlige konflikter for hver forfatter. |
Legg merke til hvor mange rader som ligger under sikkerhet, feil og menneskelige faktorer. Rad 3c, 6a, 6b, 7, 11, 12, 13a, 13b, 14a, 14b og 16 står til sammen for 11 av de 28 AI-radene, noe som gjenspeiler retningslinjenes fokus på sikkerhet og den menneskelige siden av systemet.
Hva gjør DECIDE-AI-sjekklisten forskjellig fra CONSORT-AI og TRIPOD+AI
Den opprinnelige artikkelen lister opp metodologiske utfordringer som dukker opp så snart et AI-system møter en klinikk, og hver av dem er knyttet til rader du blir bedt om å fullføre.1 Fire av dem endrer hvordan et manuskript skrives.
Menneskelige faktorer er en del av intervensjonen (rad 3c, 7 og 14)
DECIDE-AI-sjekklisten behandler AI-systemet og dets brukere som to samarbeidende former for intelligens, så hvordan folk brukte verktøyet rapporteres som et resultat og overlates ikke til diskusjon. 1 Rad 7 spør hvilke menneskelige faktorer-metoder som ble brukt, rad 14a ber om en brukervennlighetsevaluering mot anerkjente standarder, og rad 14b ber om læringskurver. En studie som kombinerer spørreskjemaer, observasjon og intervjuer er et blandet metodeforskningsdesign , og de samme integrasjonsreglene gjelder når du skriver den opp. En liten «first-in-human»-serie er også lik i ånden pilotstudiene vi beskriver andre steder, med gjennomførbarhet og forbedring som mål.
Systemet har lov til å endre seg (rad 4a og 11)
I en legemiddelstudie er produktet fikset. I tidlig AI-arbeid blir programvaren, maskinvaren og brukergrensesnittet ofte revidert mellom pasienter. Rad 4a spør etter versjon, og rad 11 spør for hver endring, når den skjedde, hvorfor og hva som skjedde med resultatene etterpå. Uten den loggen kan ikke en leser se hvilket system et gitt resultat tilhører.
Feil er data (rad 6, 13 og 16)
Retningslinjen ber forfatterne om å definere betydelige feil på forhånd, liste opp alle som oppsto med forekomst og tilsynelatende årsak, si om de kunne korrigeres, og diskutere hva det betyr for pasientbehandlingen.1 Rammeverket speiler fase 1 og 2 -legemiddelstudier, der sikkerhet er det første spørsmålet. Det beskytter også mot datasettskift, der små forskjeller mellom treningsdata og kliniske data endrer ytelsen.1
Samsvar mellom mennesker og kunstig intelligens er rapportert (rad 12)
Rad 12 i DECIDE-AI-sjekklisten spør om hvor ofte brukerne var enige i systemet, hvorfor de avvek fra det, og om AI-en ombestemte seg. CONSORT-AI og TRIPOD+AI spør om brukerinteraksjon og hvilken ekspertise brukerne trenger, men vi fant ingen rad i noen av dem som spør om enighetsrater og årsaker til å avvike fra AI-utdataene. For en modellfokusert artikkel dekker vår TRIPOD+AI-sjekklisteveiledning rapporteringen som kommer tidligere i prosessen.
Eksempel på bruk av DECIDE-AI-sjekklisten på en ekte åpen tilgangsstudie
For å vise sjekklisten i bruk, scoret vi én publisert artikkel. Khan og kolleger rapporterte en første-i-menneske-evaluering av sanntids AI-anatomisk segmentering under endoskopisk hypofysekirurgi, i Pituitary i oktober 2026. Den er publisert under en CC BY 4.0-lisens, og det er derfor vi kan sitere den og gjengi to av figurene. Vi bekreftet lisensen tre steder, i Crossref-lisensfeltet for versjon av posten, i Europe PMC-lisensfeltet og i JATS-tillatelsene for fullteksten.
Vi valgte den av en praktisk grunn. Det er en ekte artikkel som anvender DECIDE-AI-sjekklisten, med et IDEAL Stage 1-design, en registrert studie, åtte pasienter og et kirurgisk team på fire brukere. Den inkluderer også sin egen utfylte DECIDE-AI-sjekkliste som tilleggsmateriale 2. Vi scoret artikkelteksten først og sammenlignet med forfatternes sjekkliste etterpå, så konklusjonene nedenfor er en uavhengig lesning av fullteksten. IDEAL-rammeverket, for lesere som ikke kjenner det, er en trinnvis vei for å evaluere kirurgisk innovasjon.4
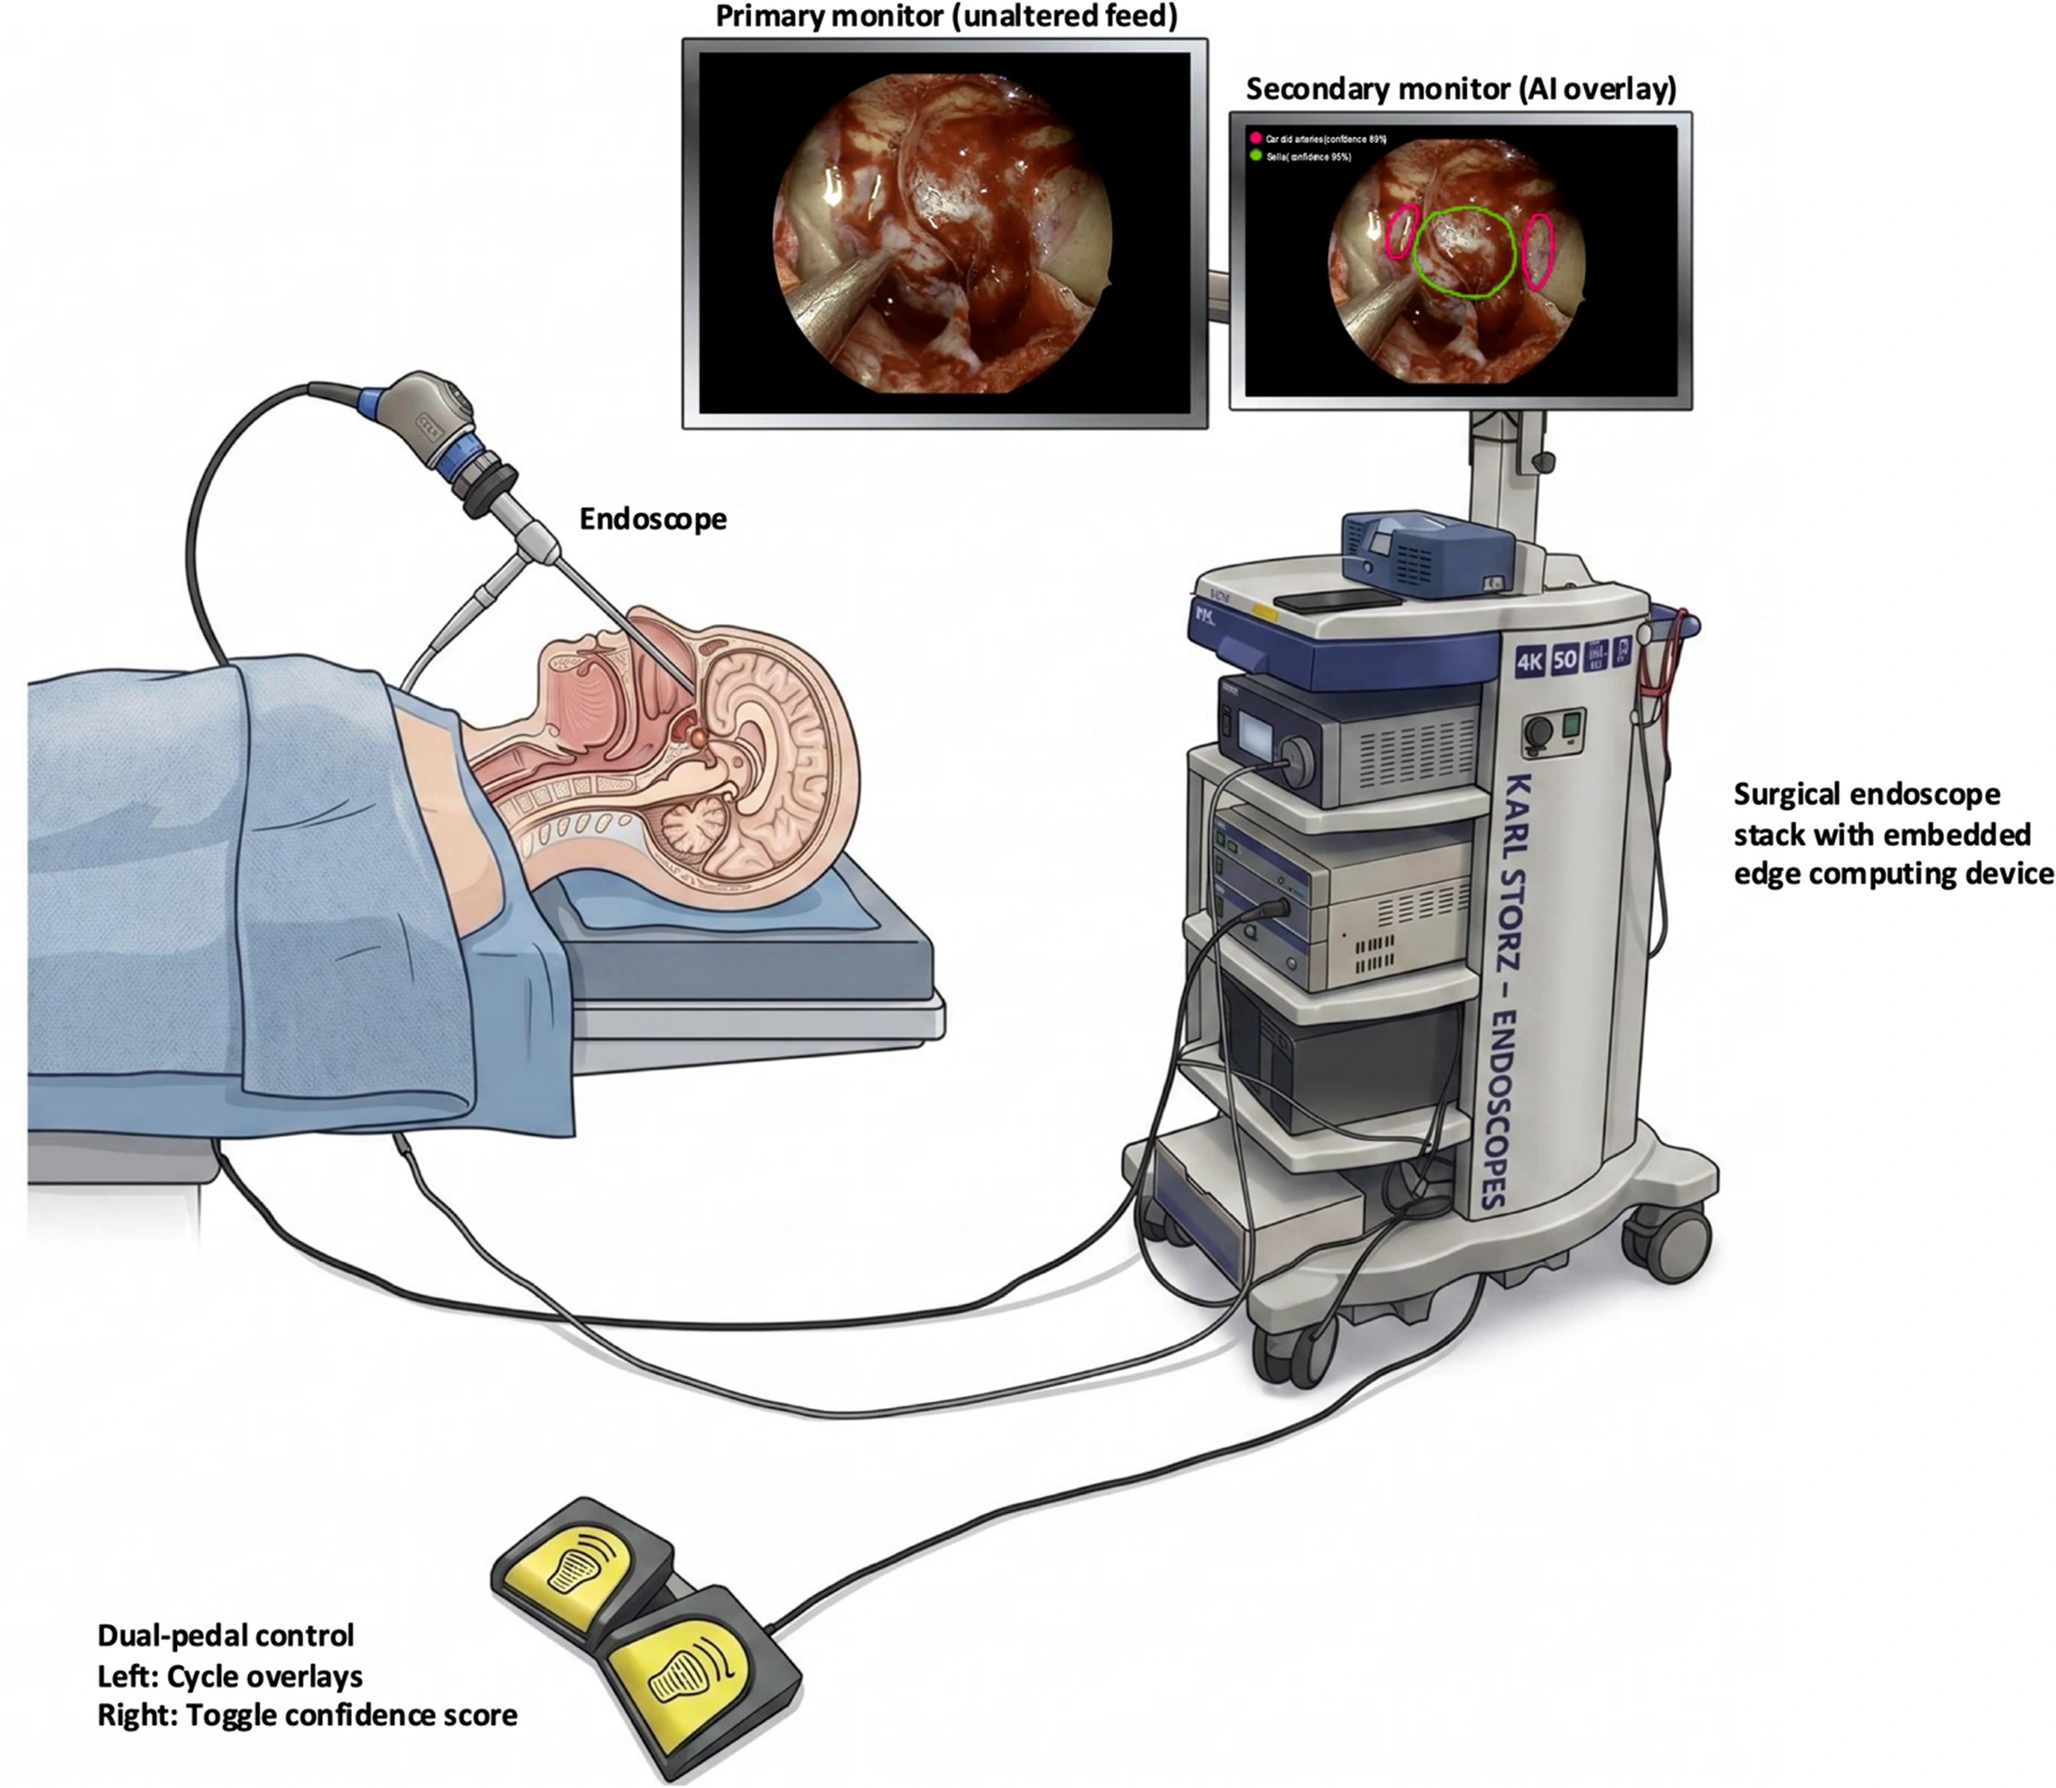
I studien skisserte en datasynsmodell sella og halspulsårene på en sekundær skjerm ved siden av den uendrede kirurgiske ernæringen, og det kirurgiske teamet slo på overlegget med en fotpedal. Registreringen er oppført på ClinicalTrials.gov , og fullteksten finnes på PubMed Central.
Hvordan lese dommene
Rapportert betyr at raden er besvart i teksten. Delvis rapportert betyr at noen elementer er til stede og andre mangler. Ikke funnet betyr at vi ikke kunne finne den i fullteksten og de to tilleggene vi kunne lese. Vurdering betyr at en rimelig anmelder kunne gitt raden poeng uansett, og notatet forklarer hvorfor. Dette er en Editverse-lesning av teksten og ikke en offisiell DECIDE-AI-sjekklistevurdering.
Tabell 3. DECIDE-AI sjekklisterader scoret mot Khan et al., Hypofyse 2026 (CC BY 4.0). Les hele teksten på nytt.
| Sak | Hvor man skal lete i avisen | Hva avisen rapporterer | Kjennelse |
|---|---|---|---|
| 1 | Tittel | Tittelen nevner en første evaluering i mennesket av sanntids AI-assistert anatomisk segmentering i nevrokirurgi. Ordene beslutningsstøtte forekommer ikke. | Domsavgjørelse |
| I | Abstrakt | Strukturert med fire overskrifter. Angir algoritmetypen (en DINOv3-avledet synstransformator), setting på ett senter, åtte pasienter, utfall og hovedfunn. Antall brukere og eventuelle skalapoeng mangler. | Delvis rapportert |
| 2a | Bakgrunn, avsnitt 1 til 3 | Rammer inn navigasjonsfeil i endoskopisk hypofysekirurgi som en pasientsikkerhetsrisiko, navngir eksisterende bildeveiledning og definerer populasjonen i Methods som voksne som gjennomgår elektiv endoskopisk transsfenoidal kirurgi for hypofyseadenom. | rapportert |
| 2b | Bakgrunn, avsluttende avsnitt og styrker og begrensninger | Brukerne er det kirurgiske teamet, og grensesnittet er bygget rundt kirurgen. Avsnittet om begrensninger sier deretter at systemet «opprinnelig ble distribuert som et opplærings- og utdanningsverktøy snarere enn et primært beslutningsstøttesystem», så den tiltenkte rollen er først tydeligst på slutten. | Domsavgjørelse |
| II | Bakgrunn, siste avsnitt og metoder, oversikt | Målet er å vurdere gjennomførbarheten av anatomisk segmentering under levende endoskopisk hypofysekirurgi, samtidig som systemet forbedres iterativt. | rapportert |
| III | Metoder, oversikt | Oppgir et registernummer og en etikkreferanse (IRAS 127474) med samtykke. Teksten sier at studien ble «registrert i en database for kliniske studier (NCT07568366; registrert 5. mai 2026)». Vi fant ingen rekrutteringsdatoer, så en leser kan ikke se om registreringen kom før det første tilfellet, og ingen separat protokollhenvisning. | Delvis rapportert |
| 3a | Metoder, prosedyre for konseptutprøving og resultater, oversikt | Seks pasienter var planlagt, eksklusjoner er listet opp, og utvalget er beskrevet som «en liten, forhåndsspesifisert utviklingskohort snarere enn et statistisk styrket utvalg». Resultatene rapporterer deretter åtte påfølgende pasienter rekruttert, og diskusjonen refererer til «seks av de åtte planlagte tilfellene». Endringen fra seks til åtte er ikke forklart. Kvalifisering på datanivå er ikke beskrevet. | Domsavgjørelse |
| 3b | Metoder, prosedyre for konseptutprøving og resultater, oversikt | Én behandlende kirurg og team utførte hver sak, og resultatene navngir fire brukere (tre kirurger og én sykepleier). Hvordan brukerne ble valgt, deres kvalifisering og hvordan antallet ble bestemt er ikke oppgitt. | Delvis rapportert |
| 3c | Metoder, prosedyre for konseptbevisstudie | Teamet var orientert rundt en høykvalitetssimulator med en "standardisert orientering om tiltenkt bruk, tolkning av utdata og systemets begrensninger". | rapportert |
| 4a | Metoder, systemoversikt | Navngir en ViT-B-arkitektur trent på 2157 rammer fra 110 pasienter med en pasientnivådeling (97 trening, 13 test). «Hold-out Dice» var 86.4 % for sella og 21.8 % for carotis, med carotis-recall 13.6 %. Modellversjonene V1, V2, V2.1 og V2.2 er merket i tabell 1 i artikkelen. «Ingen formell ytelsesterskel ble forhåndsspesifisert», selv om en Dice nær 70 % for sella ble behandlet som et rimelig minimum. | rapportert |
| 4b | Metoder, systemoversikt | Videoinngangen er beskrevet i detalj, 1920 x 1080 piksler med 24 bilder per sekund fra endoskopstakken gjennom et opptakskort. Hvordan lavkvalitetsbilder ble håndtert under bruk i sanntid er ikke beskrevet. | Delvis rapportert |
| 4c | Metoder, systemoversikt og figur 1 og 2 i artikkelen | Konturer i stedet for fylte masker, overlegg av som standard og slått på med fotpedal, en utjevnet konfidensprosent ved siden av hver etikett og en ende-til-ende-latens på 50 til 100 ms i preoperativ testing. | rapportert |
| 5a | Metoder, systemoversikt og prosedyre for konseptutprøving | Et enkelt senter, Nasjonalt sykehus for nevrologi og nevrokirurgi, med overlegget på den eksisterende sekundære monitoren i endoskopstakken. | rapportert |
| 5b | Metoder, prosedyre for konseptbevisstudie | Kirurgien foregikk rutinemessig på det uendrede primære displayet, og overlegget ble brukt under anatomisk orientering før sellotomi og durotomi. Hvem som tok den endelige avgjørelsen er underforstått (kirurgen, med overlegget deaktivert som standard) og er ikke oppgitt som sådan. | Domsavgjørelse |
| IV | Metoder, datainnsamling, analyse og systemiterasjon | Primære utfall dekker konseptbevis, gjennomførbarhet (FIM-spørreskjema) og sikkerhetsobservasjon. Sekundære utfall dekker utdanningsutbytte og tilbakemeldinger fra brukere (AIM, SUS og STIAS). | rapportert |
| 6a | Metoder, prosedyre for konseptbevisstudie | En forhåndssjekk, «en standardisert funksjonssjekk ble utført», med rotårsaksanalyse av eventuelle feil, pluss en subjektiv ventetidsrapport. Det finnes ingen formell definisjon av en betydelig feil eller funksjonsfeil og ingen alvorlighetsgradering. | Delvis rapportert |
| 6b | Metoder, datainnsamling og figur 1-forklaringen til artikkelen | Sikkerheten ble overvåket gjennom antall hendelser for kirurgdistraksjon og forstyrrelser i arbeidsflyten på operasjonsvideo, blindede OSATS og operasjonstid mot en matchet retrospektiv kohort, og rutinemessige kliniske utfall. Dataflyten ble rutet for å unngå å kompromittere den primære kirurgiske datastrømmen. | rapportert |
| 7 | Metoder, datainnsamling | Bruker standardinstrumenter (FIM, AIM, SUS, STIAS, MAILS) pluss strukturerte observasjonsnotater fra en forsker. Brukerne er kirurger og sykepleiere som samhandlet med systemet, og grensesnittdesignet er basert på tidligere simuleringsstudier. | rapportert |
| V | Metoder, datainnsamling og tilleggsmateriale 1 | Sammendragsstatistikk og tematisk analyse av kvalitative data. Tilleggsmateriale 1 oppgir at ingen formell hypotesetesting ble utført fordi utvalget er lite. | rapportert |
| 8 | Hele teksten | Artikkelen omtaler ikke algoritmisk rettferdighet eller noen etikkrelatert metode. Forfatternes egen sjekkliste sier at dette ikke er rapportert, men dekket i tidligere arbeid fra samme senter. | Ikke funnet |
| VI | Hele teksten | Ingen uttalelse om pasientmedvirkning i artikkelen. Forfatternes sjekkliste sier at medvirkning er planlagt i fremtidige studier. | Ikke funnet |
| 9a | Resultater, oversikt og tabell 1 | Alder, kjønn, diagnose og tumorstørrelseskategori er oppgitt per tilfelle. Ingen uttalelse om manglende data i inndataene, bortsett fra de to tilfellene der systemet ikke startet. | Delvis rapportert |
| 9b | Resultater, oversikt | Fire brukere med opplæringsnivå (én behandlende, én seniorforsker, én assistent-sykepleier, én kondisjonssykepleier), aldersgruppe, kjønn og KI-kompetanse (MAILS median 6.1, IQR 5 til 7.1). | rapportert |
| 10a | Resultater, oversikt | Systemet ble brukt i seks av åtte tilfeller, på tvers av fire av fem operasjonsøkter. «Meningsfull bruk av systemet var begrenset til selgerfasen, som tiltenkt». Eksponering per bruker og tidspunktet overlegget ble slått på er ikke oppgitt. | Delvis rapportert |
| 10b | Resultater, sikkerhet og figur 3 i artikkelen | Det var «ingen hendelser med betydelig distraksjon fra hovedkirurgen eller forstyrrelser i arbeidsflyten til det kirurgiske teamet». Figur 3 i artikkelen viser også at bare én sykepleier var i bruk i systemet og planlegger å flytte eller legge til en skjerm. | rapportert |
| VII | Resultater, gjennomførbarhet, sikkerhet, tilbakemeldinger om bredere implementering og tabell 1 | De fleste forhåndsspesifiserte utfallene rapporteres med medianer og IQR-er (FIM 4.8, AIM 4, SUS 78, STIAS 4.3 av 7). Utdanningsutbytte, målt med et Kirkpatrick-basert spørreskjema, vises kun som en påstand om at alle deltakerne så utdanningspotensial. I versjonen av tabell 1 vi leste, er FIM-cellen tom for tilfelle 6 og 8. | Delvis rapportert |
| VIII | Hele teksten | Ingen forhåndsspesifiserte undergrupper er beskrevet, så raden gjelder kanskje ikke. Forfatternes sjekkliste sier at den ikke ble rapportert fordi dette er en liten IDEAL trinn 1-studie. | Domsavgjørelse |
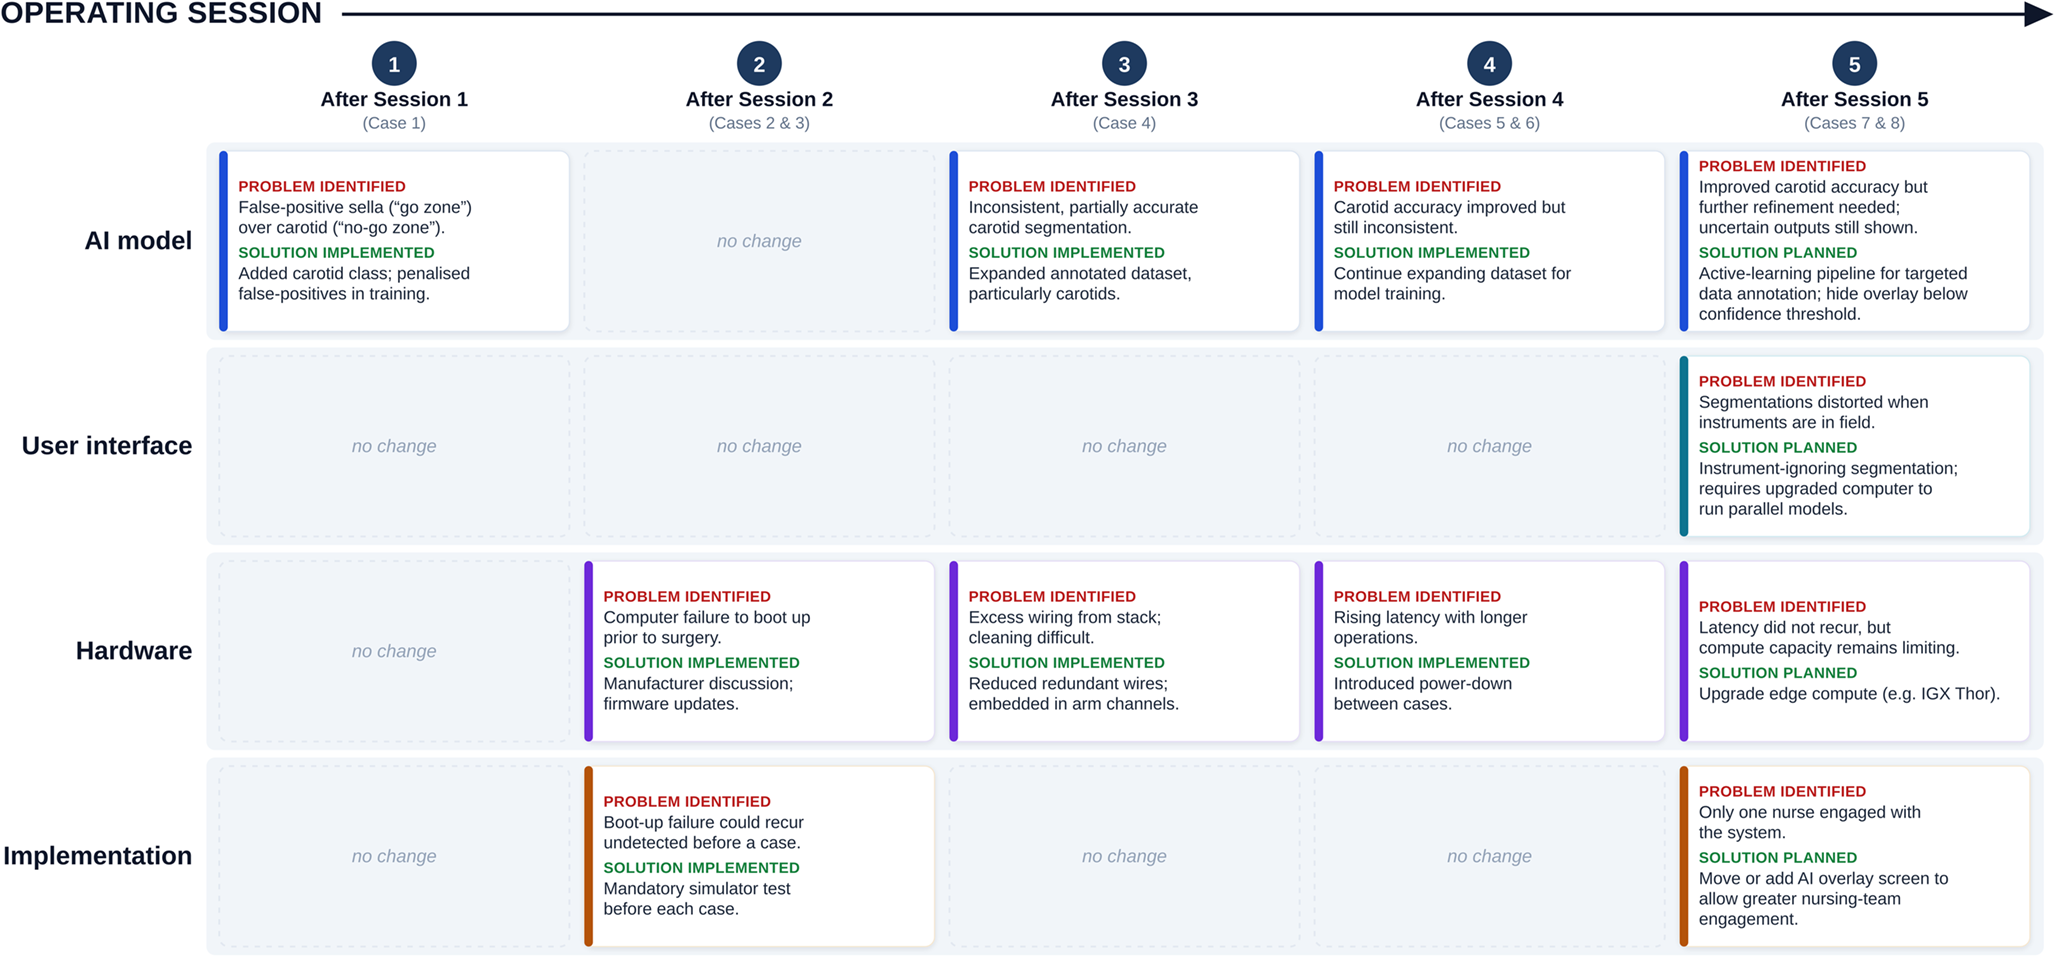
| 11 | Resultater, enhetsiterasjon, tabell 1 og figur 3 i artikkelen | Figur 3 i artikkelen viser, per operasjonsøkt, problemet som ble funnet og endringen som ble gjort for AI-modellen, maskinvaren, grensesnittet og implementeringen, og tabell 1 viser modellversjonen per tilfelle. Endringen i utfallet etter hver versjon er kvalitativ (for eksempel carotis "mer nøyaktig og konsistent enn forrige økt"), og ingen Dice er rapportert for senere versjoner. | Domsavgjørelse |
| 12 | Resultater, tabell 1, og styrker og begrensninger | Tabell 1 viser kirurg-AI-justering per tilfelle i ord. Det er ingen tilfeller av uenighet, grunner til å avvike fra overlegget eller ombestemmelser, og forfatterne erkjenner at «mindre oppmerksomhet er gitt til tilfeller der modellen potensielt overgikk mennesker eller endret deres beslutning positivt». | Delvis rapportert |
| 13a | Resultater, oversikt, sikkerhet og enhetsiterasjon | To av åtte tilfeller (tilfelle 2 og 3) gikk tapt på grunn av én oppstartsfeil etter en omstart, noe som ble fikset gjennom en diskusjon med produsenten, en endring av oppstartsstart og en fastvareoppdatering. «Dette var en feil på plattformnivå snarere enn en feil i CVAI-applikasjonen.» Andre hendelser var en falsk positiv sella-kontur over carotis, overleggsforvrengning fra instrumenter og opplevd latens på omtrent 100 ms i ett tilfelle. | rapportert |
| 13b | Resultater, sikkerhet | Ingen intraoperative komplikasjoner, inkludert vaskulær eller nevral skade. To pasienter hadde behandlingskrevende hyponatremi, én i et tilfelle uten systemet (tilfelle 2) og én med det (tilfelle 5). Gjennomsnittlig OSATS i sellærfase i de seks utplasserte tilfellene var 27.2 av 30, mot 28.6 i den retrospektive kohorten. | rapportert |
| 14a | Resultater, bredere implementeringstilbakemeldinger og menneskelige faktorer | Brukbarhet rapporteres med System Usability Scale (median 78, IQR 65 til 79), sammen med akseptabilitet (AIM) og tillit (STIAS). | rapportert |
| 14b | Hele teksten | Ingen analyse av læringskurven. Forfatternes sjekkliste oppgir IDEAL Stage 1-designet som årsak, og diskusjonen lister opp læringskurver for senere studier. | Ikke funnet |
| 15 | Diskusjon, hovedfunn og konklusjon | Angir at sanntidssegmentering var mulig i levende kirurgi, at de fleste begrensningene kunne korrigeres, og at en større serie på ett senter (IDEAL stadium 2a) er neste trinn. | rapportert |
| 16 | Diskusjon, hovedfunn og litteraturavsnitt | Nevn den falsk-positive omrisset over carotis og overlay-forvrengning fra instrumenter som hovedfarene, og figur 3 i artikkelen viser de planlagte tiltakene, inkludert å skjule overlayet under en konfidensgrense. | rapportert |
| IX | Diskusjon, styrker og begrensninger | Navngir det enkle senteret, det enkle kirurgiske teamet og de små seriene, fokuset på AI-feil og utplasseringen som et opplæringsverktøy. | rapportert |
| 17 | Bakgrunnsstoff, datatilgjengelighet | Uttalelsen lyder «Tilgjengelig på rimelig forespørsel og med forbehold om institusjonell godkjenning». Ingenting sies om kode eller tilgang til modellen. | Delvis rapportert |
| X | Bakgrunnssak, finansiering, konkurrerende interesser og takksigelser | Finansieringskilder og personlige aksjeposter og ansettelse i kommersielle selskaper er oppgitt. Medtronic, NVIDIA og Encord takkes for samarbeidet, men rollene til disse selskapene og investorene er ikke beskrevet. | Delvis rapportert |
På tvers av de 38 radene scoret vi 18 som Rapportert, 11 som Delvis rapportert, 6 som Vurdering og 3 som Ikke funnet. De tre Ikke funnet-radene (8, VI og 14b) er de forfatterne selv flagger som ikke rapportert i sin egen sjekkliste, med en begrunnelse, og rad VIII er den fjerde de flagger. Artikkelen er sterk på de delene DECIDE-AI ble skrevet for å avdekke, som er feil, modifikasjoner og brukervennlighet, og hullene ligger i styringsdetaljer, deltakertall, data og kode, og selskapenes roller.
Hva det kommenterte eksemplet lærer om DECIDE-AI-sjekklisten
Gi planlagte og faktiske tall, og forklar hvorfor de er forskjellige
Rad 3a spør hvordan antallet pasienter ble bestemt. Metodene planlegger seks pasienter, resultatene rekrutterer åtte, og diskusjonen kaller seks av de åtte utplasseringene de planlagte tilfellene. Hver påstand kan være sann, men en leser kan ikke forene dem uten en setning om hvorfor målet flyttet seg. I en serie i tidlig fase, hvor utvalget er lite per design, er tallene det første en anmelder sjekker.
Skriv de negative svarene, slik forfatterne gjorde
Forfatternes tilleggssjekkliste registrerer rad 8, VI, VIII og 14b som ikke rapportert, hver med en kort begrunnelse, som for eksempel IDEAL Stage 1-designet. Det er god praksis, og det er det retningslinjen ønsker, fordi en oppgitt begrunnelse er bedre enn en blank. Begrunnelsene står imidlertid i tillegget, slik at en leser av artikkelen alene ikke ser dem. Én setning i begrensningsavsnittet ville ha med seg den samme informasjonen inn i artikkelen.
Logg alle versjoner, slik som figur 3 i artikkelen gjør
Rad 11 spør om tidspunktet og begrunnelsen for hver endring, samt resultatene etter den. Figur 3 i artikkelen er en kompakt modell av de to første, med en kolonne per operasjonsøkt og en rad for hver av AI-modellene, brukergrensesnittet, maskinvaren og implementeringen. Metodene legger til at modellen ble trent på nytt «ved hjelp av data fra alle 110 pasienter og hver påfølgende pasient som er inkludert i studien». Når treningsdataene vokser med hvert tilfelle, oppfylles rad 4a best ved å oppgi treningsstørrelsen for hver merkede versjon.
Definer en betydelig feil før det første tilfellet
Rad 6a spør hvordan betydelige feil ble definert. Eksemplet kjører en funksjonalitetssjekk før bruk og en rotårsaksanalyse for feil, noe som er fornuftig, men det sier ikke på forhånd hva som teller som en betydelig feil. Det er viktig her fordi den første modellens sella-omriss gikk over carotis (en «go-zone» over en «no-go-zone» i figuren ovenfor), mønsteret en kirurg ville anse som farligst, og carotis-klassen i seg selv var svak i preklinisk testing (Dice 21.8 %, husker 13.6 %). En definisjon på én linje, for eksempel ethvert overlegg som plasserer en sikker omriss over en no-go-struktur, ville la leseren telle hendelser på samme måte som teamet gjorde.
Tell avtale, ikke bare beskriv den
Rad 12 er der AI-rapporter i tidlig fase oftest forblir vage. Eksemplet registrerer justering per tilfelle med ord, for eksempel er sella nøyaktig og carotis bare delvis korrekt. En enkel telling per struktur og per tilfelle, med en årsak for hvert avvik fra overlegget, gjør de samme observasjonene om til data. Forfatterne navngir dette gapet selv, og bemerker at tilfeller der modellen hjalp til med en beslutning fikk mindre oppmerksomhet.
Nevn hva selskaper og investorer gjorde
Rad X spør om rollen til investorer og ethvert selskap. Eksemplet oppgir tydelig aksjeposter og sysselsetting, og takker tre selskaper for samarbeidet, men sier ikke hva hver bidro med. En enkelt setning om hvem som leverte maskinvaren, opptaksplattformen og annoteringsverktøyene, og om noen av dem så manuskriptet, fullfører raden. For rad 17 hører en kode- og modellsetning hjemme ved siden av datasetningen, selv når svaret er at ingen av dem kan deles.
Kjør en konsistenspassering mellom abstrakt og tabeller
Sammendraget rapporterer at systemet demonstrerte "akseptabel sanntidsnøyaktighet for sella-segmentering på pikselnivå". I resultatene vises nøyaktighet i sanntid som kvalitative justeringsnotater i tabell 1, uten kvantitativ nøyaktighet i sanntid. FIM-kolonnen i tabell 1, slik vi leser den, er tom for to av seks distribuerte tilfeller, mens teksten gir en median. Ingenting av dette endrer funnene, og alt er billig å fikse før innsending.
Slik fullfører du DECIDE-AI-sjekklisten før du sender inn
Rutinen nedenfor fungerer for et ferdig manuskript og en innsending av DECIDE-AI-sjekkliste, og de to første trinnene fungerer bedre hvis du tar dem mens studien fortsatt planlegges.
- Last ned den offisielle sjekklisten fra BMJ- eller Nature Medicine-artikkelen og behold versjonsdatoen i filnavnet.
- Planlegg studiet rundt radene slik at tilvenningsinformasjon (3c), feildefinisjoner (6a), endringslogg (11) og brukervennlighetsinstrumenter (14a) er i protokollen før den første pasienten.
- Bestem hva som gjelder ved å markere rader som ikke gjelder, for eksempel undergrupper eller læringskurver, og skrive årsaken i manuskriptet så vel som i sjekklisten.
- Fyll hver rad i DECIDE-AI-sjekklisten med en plassering Bruk side- og linjetall fra innleveringsfilen, og skriv et kort negativt svar for hver rad du ikke gjorde.
- Avstemme alle tall på tvers av sammendraget, metodene, resultatene, tabellene og figurene, med start i planlagte og rekrutterte pasienter og brukere.
- Legg til versjonsloggen som en tabell eller figur, med dato, årsak og effekt av hver endring av modellen, maskinvaren eller grensesnittet.
- Tell feilene etter type med en rate, en årsak og om hver av dem kan korrigeres, og drøft hva hver av dem betyr for pasientbehandlingen.
- Statdata, kode og bedriftsroller i baksaken, inkludert hvem som leverte maskinvare, programvare og innspillingsverktøy.
Blandede design krever også god praksis for spørreundersøkelser, og vår veiledning for spørreskjemadesign i epidemiologiske studier hjelper med instrumenter for brukervennlighet og akseptabilitet. Hvis systemet er et prediksjonsverktøy bygget på rutinedata, gir vår gjennomgang av AI i implementering av helsetjenester en bredere kontekst, og en student som tilordner et avhandlingskapittel til riktig retningslinje kan bruke veiledningen for rapportering av medisinske avhandlinger . For observasjonsdelene av en klinisk serie er STROBE-veiledningen fortsatt standard følgesvenn.
Neste trinn etter DECIDE-AI-sjekklisten er en sammenlignende studie. Når du kommer til den, gå til CONSORT-AI-sjekklisten og SPIRIT-protokollveiledningen . Retningslinjene er åpent tilgjengelige, og registeret for eksempelstudien finnes på ClinicalTrials.gov . IDEAL-rammeverket som DECIDE-AI er i tråd med er beskrevet av IDEAL Collaboration og i en oppdatering fra 2019 i Annals of Surgery.4
Gratis forskningsverktøy fra Editverse
- GraphProLag publikasjonsklare diagrammer, 25 typer, med innebygd t-test, ANOVA, korrelasjon og kji-kvadrat p-verdier. Gratis, ingen registrering.
- StatProGratis statistiske kalkulatorer og et testutvelgerverktøy som dekker gruppesammenligninger, kategoriske utfall, analyse av tid til hendelse og diagnostisk nøyaktighet.
- Flytskjema ProGenerer flytdiagrammer for PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE og ARRIVE direkte i nettleseren din.
Profesjonell støtte for DECIDE-AI-rapportering
En tidlig klinisk evaluering er enklere å rapportere når designspørsmålene er avgjort før den første pasienten, og manuskriptet redigeres mot sjekklisten etterpå. To Editverse-tjenester er knyttet til dette. Den første er et sett med metodologiske konsultasjonssesjoner, nyttige når du bestemmer utfall, utvalg av brukere og pasienter, datainnsamling og validitet for en blandet metode-forstudie. Den andre er substansiell redigering av selve manuskriptet. Editverse-redigerings- og skrivestøtte er i samsvar med COPE, ICMJE og GPP 2022, og med de etiske kravene til din institusjon og ditt land.
Metodikkkonsultasjon
$400
Tre 45-minutters økter med doktorgradsmetodologer som dekker gjennomgang av forskningsdesign, utvalg, datainnsamling og validitet, med et skriftlig metodisk rammeverk. Planlagt over 4 til 6 uker.
Avansert redigering
$550
Innholdsmessig redigering, vitenskapelig språklig polering, APA-, AMA- eller Vancouver-stilredigering og verifisering av referanselister. Fast pris, 7 til 10 virkedager, én gratis revisjonsrunde.
Konklusjon
DECIDE-AI-sjekklisten ber om 38 rader som til sammen beskriver et AI-verktøys første kontakt med virkelige pasienter, og radene som betyr mest er de som studieretningslinjene aldri spurte om, nemlig feil, versjoner, brukeravtale og brukervennlighet. Vårt utarbeidede eksempel viser mønsteret. En artikkel kan logge hver modellendring og navngi feilene åpent, og fortsatt la endringen i antall pasienter, en definisjon av en betydelig feil, en kodeerklæring og rollen til dens kommersielle partnere være uforklarlig. Start fra DECIDE-AI-sjekklisten når du planlegger studien, skriv en plassering mot hver rad når du utarbeider, og kjør en konsistensgjennomgang før du sender inn. En anmelder som kan finne hver rad på få minutter, bruker gjennomgangen på forskningen din.
Ofte Stilte Spørsmål
Hvor mange punkter inneholder DECIDE-AI-sjekklisten?
DECIDE-AI-sjekklisten har 17 AI-spesifikke elementer, som utvides til 28 rader når underelementene er telt, pluss 10 generiske elementer nummerert med romertall. Det gir 38 rader totalt.
Er DECIDE-AI-sjekklisten kun for randomiserte studier?
Nei. DECIDE-AI-sjekklisten er stadiumspesifikk og foreskriver ikke et studiedesign. Den er ment for tidlig, litenskala, klinisk evaluering i sanntid, og en prospektiv kohort, en ikke-randomisert sammenligning eller en kasusserie kan alle bruke den. Randomiserte studier av AI bruker CONSORT-AI.
Hva teller som tidlig klinisk evaluering for DECIDE-AI?
AI-systemet brukes på virkelige pasienter, og resultatene påvirker behandlingen i liten skala. Offline-testing eller skyggemodustesting, der resultatene ikke påvirker beslutninger, faller utenfor retningslinjen.
Hvordan er DECIDE-AI-sjekklisten forskjellig fra TRIPOD+AI og CONSORT-AI?
TRIPOD+AI dekker utvikling og validering av prediksjonsmodeller, og CONSORT-AI dekker randomiserte studier. DECIDE-AI-sjekklisten ligger midt imellom og inkluderer menneskelige faktorer, brukeravtale, systemmodifikasjoner og detaljert feilrapportering.
Erstatter DECIDE-AI-sjekklisten de andre AI-retningslinjene?
Nei. Retningslinjene dekker ulike stadier, så et prosjekt kan bruke DECIDE-AI-sjekklisten for sin første kliniske serie og CONSORT-AI senere for en randomisert studie. Merk at CONSORT 2025 erstattet CONSORT 2010, og at CONSORT-AI ble bygget som en utvidelse av CONSORT 2010.
Bør forfattere sende inn en utfylt DECIDE-AI-sjekkliste sammen med manuskriptet?
Mange tidsskrifter ber om en utfylt sjekkliste med side- eller linjenummer for hver rad. Sjekk forfatterens instruksjoner, og skriv et kort negativt svar for alle rader du ikke tok opp.
Hvor er den offisielle DECIDE-AI-sjekklisten publisert?
Sjekklisten er publisert i BMJ og i Nature Medicine, begge fra mai 2022. BMJ-versjonen er åpen tilgang.
Referanser
- Vasey B, Nagendran M, Campbell B, Clifton DA, Collins GS, Denaxas S, et al. Rapporteringsretningslinje for tidlig klinisk evaluering av beslutningsstøttesystemer drevet av kunstig intelligens: DECIDE-AI. BMJ. 2022;377:e070904. doi:10.1136/bmj-2022-070904. PMID: 35584845. PMCID: PMC9116198. PubMed, PMC.
- Vasey B, Nagendran M, Campbell B, Clifton DA, Collins GS, Denaxas S, et al. Rapporteringsretningslinje for tidlig klinisk evaluering av beslutningsstøttesystemer drevet av kunstig intelligens: DECIDE-AI. Nat Med. 2022;28(5):924-933. doi:10.1038/s41591-022-01772-9. PMID: 35585198. Nature Medicine.
- Khan DZ, Mao Z, Wijekoon A, Das A, Williams SC, Blandford A, et al. Første evaluering på mennesker av sanntids pikselnivå AI-assistert anatomisk segmentering i nevrokirurgi: hypofysekirurgi som et eksempel. Hypofyse. 2026;29(5):163. doi:10.1007/s11102-026-01762-x. PMID: 42829367. PMCID: PMC13634013. CC BY 4.0. PubMed, PMC.
- Hirst A, Philippou Y, Blazeby J, Campbell B, Campbell M, Feinberg J, et al. Ingen kirurgisk innovasjon uten evaluering: utvikling og videreutvikling av IDEAL-rammeverket og anbefalingene. Ann Surg. 2019;269(2):211-220. doi:10.1097/SLA.0000000000002794. PMID: 29697448. PubMed.