
Statistik F adalah angka yang pertama kali dicari oleh penilai dalam makalah randomisasi Mendel, dan aturan yang terkait dengannya, bahwa suatu instrumen dianggap memadai jika nilai F melebihi 10, dikutip di hampir setiap bagian metode yang ditulis sejak tahun 2011. Editverse telah mendukung lebih dari 1,100 manuskrip, dan dalam pekerjaan registri dan epidemiologi genetik yang ditangani oleh ahli statistik kami, statistik F juga merupakan angka yang paling sering tidak dapat dijelaskan oleh penulis ketika seorang penilai bertanya apa manfaatnya bagi mereka.
Jadi, kami mengukurnya. Kami mensimulasikan 135,000 studi randomisasi Mendel di berbagai kekuatan instrumen dan kondisi tumpang tindih sampel, menjalankan keseluruhan proses dua kali dalam dua program yang ditulis secara independen, dan membandingkan hasilnya. Hasilnya bukanlah seperti yang tersirat dalam sebagian besar tutorial. Instrumen yang lemah biasanya tidak memberikan jawaban yang salah. Instrumen tersebut memberikan interval yang sangat lebar sehingga tidak ada jawaban yang mungkin, dan hal itu terjadi jauh sebelum estimasi itu sendiri mulai bergeser.
Dalam Kata Sederhana
Bayangkan instrumen genetik sebagai dorongan yang sangat kecil. Jika dorongannya kuat, setiap orang yang membawa varian tersebut benar-benar akan terpapar lebih banyak, dan Anda dapat melihat apa yang terjadi pada risiko penyakit mereka. Jika dorongannya lemah, perbedaan antara pembawa dan bukan pembawa hampir tidak ada, sehingga efek apa pun pada penyakit terkubur dalam kebisingan. Statistik F mengukur seberapa kuat dorongan tersebut. Ketika nilainya kecil, jawaban jujur yang diberikan analisis Anda adalah rentang yang sangat luas sehingga mencakup efek berbahaya yang besar, tidak ada efek sama sekali, dan efek perlindungan yang besar, semuanya sekaligus. Studi tersebut tidak berbohong kepada Anda. Studi tersebut hanya gagal mengukur apa pun.
Asal Mula Aturan F Lebih Besar Dari 10
Ambang batas ini dipinjam, bukan berasal dari genetika. Ambang batas ini berasal dari ekonometrika, di mana Staiger dan Stock (1997) mempelajari metode kuadrat terkecil dua tahap ketika instrumen hanya menjelaskan sedikit paparan dan mengusulkan nilai F tahap pertama sebesar 10 sebagai aturan praktis untuk menentukan kapan bias yang dihasilkan dapat ditoleransi. Aturan ini kemudian masuk ke epidemiologi genetik melalui Burgess dan Thompson (2011) , yang secara khusus meneliti bias instrumen lemah dalam randomisasi Mendel dan menunjukkan bahwa estimasi tersebut tertarik ke arah asosiasi observasional yang dikacaukan, dengan besarnya tarikan ditentukan oleh statistik F.
Dua hal tentang silsilah tersebut penting dan biasanya diabaikan. Pertama, hasil aslinya berkaitan dengan metode kuadrat terkecil dua tahap dengan beberapa instrumen, dan bias yang dijelaskannya meningkat seiring dengan jumlah instrumen yang disertakan. Kedua, ambang batas tersebut ditawarkan sebagai panduan kasar, bukan nilai lulus. Pierce, Ahsan, dan VanderWeele (2011) mengemukakan poin terkait bahwa kekuatan instrumen dan kekuatan statistik adalah pertanyaan yang terpisah, dan bahwa suatu instrumen dapat dengan mudah mencapai F sama dengan 10 sambil membuat studi terlalu tidak tepat untuk menjawab pertanyaan yang dirancang untuknya. Simulasi kami menunjukkan seberapa jauh kedua hal tersebut dapat terpisah. Jika Anda baru mengenal desain itu sendiri, panduan kami tentang apa itu randomisasi Mendel dan bagaimana cara melakukannya mencakup tiga asumsi variabel instrumental yang diasumsikan artikel ini sudah Anda ketahui, dan penjelasan kami tentang variabel instrumental dan metode kuadrat terkecil dua tahap mencakup estimator itu sendiri.
Apa yang Kami Simulasikan, dan Bagaimana Anda Dapat Memeriksanya
Pengaturannya sengaja dibuat sederhana, karena desain yang sederhana membuat mode kegagalan mudah dipahami daripada menyembunyikannya di dalam model yang rumit. Setiap studi simulasi memiliki 5,000 individu per sampel. Satu varian genetik dengan frekuensi alel minor 0.3 bertindak sebagai instrumen. Faktor pengganggu yang tidak terukur memengaruhi baik paparan maupun hasil, yang merupakan penyebab asosiasi observasional menyesatkan sejak awal. Efek kausal sebenarnya dari paparan terhadap hasil adalah 0.20. Karena adanya faktor pengganggu, regresi biasa dari hasil terhadap paparan menghasilkan sekitar 0.40, sehingga estimasi observasional melebih-lebihkan kebenaran dengan faktor dua.
Kemudian, kami memvariasikan kekuatan instrumen sehingga statistik F tahap pertama mendekati 3, 5, 10, 20, 50, dan 100, dan pada setiap level kami menjalankan 5,000 studi replikasi dalam dua kondisi: satu di mana asosiasi paparan dan hasil diperkirakan pada peserta yang sama, dan satu di mana keduanya berasal dari dua sampel yang sepenuhnya terpisah. Untuk setiap replikasi, kami mencatat estimasi kausal, kesalahan standarnya dengan metode delta, interval kepercayaan 95% yang dihasilkan, dan apakah interval tersebut mengandung efek sebenarnya sebesar 0.20.
Setiap gambar di bawah ini dihasilkan dua kali. Satu implementasi menggunakan R dan menggunakan operasi matriks pada blok replikasi. Yang kedua menggunakan Python dan menghitung kuantitas yang sama dari statistik yang memadai dengan generator angka acak yang berbeda dan tanpa kode yang sama. Kedua mesin tersebut dibandingkan sebelum ada yang ditulis. Keduanya sepakat pada setiap kuantitas stabil hingga kesalahan Monte Carlo, dan jika terjadi perbedaan, perbedaan itu sendiri merupakan temuan. Kami menerapkan standar dua mesin ini pada setiap gambar data yang kami publikasikan, seperti dalam penjelasan kami tentang apa yang diperbaiki dan tidak diperbaiki oleh bobot survei NHANES.
Apa yang Sebenarnya Dilakukan Instrumen yang Lemah terhadap Estimasi?
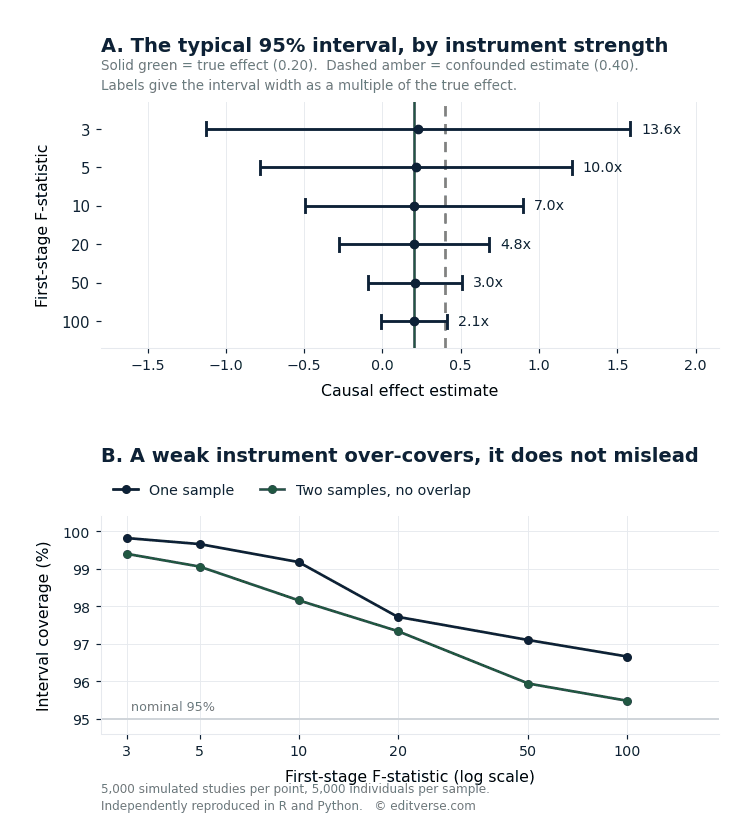
Interval tersebut menyempit jauh sebelum estimasi titiknya terjadi.
Panel A adalah keseluruhan argumen dalam satu gambar. Pada setiap kekuatan instrumen yang kami uji, estimasi median berada dekat dengan efek sebenarnya sebesar 0.20 dan jauh dari nilai observasional yang bias sebesar 0.40. Yang berubah secara dramatis adalah lebar interval di sekitarnya.
| Tahap pertama F | Estimasi median | Lebar interval kepercayaan 95% median | Lebar sebagai kelipatan dari efek sebenarnya | Liputan |
|---|---|---|---|---|
| 3 | 0.227 | 2.71 | 13.6x | 99.8% |
| 5 | 0.213 | 1.99 | 10.0x | 99.7% |
| 10 | 0.200 | 1.39 | 7.0x | 99.2% |
| 20 | 0.202 | 0.96 | 4.8x | 97.7% |
| 50 | 0.205 | 0.60 | 3.0x | 97.1% |
| 100 | 0.199 | 0.42 | 2.1x | 96.7% |
Bacalah kolom keempat dan makna praktisnya akan menjadi jelas. Pada nilai F sebesar 3, interval kepercayaan tipikal 13.6 kali lebih lebar daripada efek yang coba dideteksi oleh penelitian. Interval tersebut membentang dari sekitar minus 1.1 hingga plus 1.6. Interval ini mencakup efek perlindungan yang besar, tidak ada efek, dan efek berbahaya yang besar. Tidak ada dalam data yang membedakan antara ketiganya. Pada nilai F sebesar 100, interval tersebut masih sekitar dua kali ukuran efek sebenarnya, yang cukup untuk menetapkan arah tetapi tidak lebih dari itu.
Lebar interval menyusut mendekati akar kuadrat terbalik dari F. Mengalikan setiap lebar dengan akar kuadrat dari F-nya memberikan 4.63, 4.51, 4.37, 4.30, 4.25, dan 4.24 di keenam level, yang hampir konstan dan hanya bergeser ke atas pada instrumen terlemah, di mana kesalahan standar metode delta itu sendiri mulai menurun. Konsekuensi praktisnya adalah menggandakan presisi Anda membutuhkan kekuatan instrumen yang kira-kira empat kali lipat, yang dalam desain dua sampel berarti paparan GWAS yang jauh lebih besar daripada ambang batas nilai p yang sedikit lebih longgar.
Interval tersebut mencakup lebih dari yang seharusnya, yang tidak sama dengan salah.
Panel B menunjukkan cakupan: proporsi studi replikasi yang interval 95%-nya mengandung efek sebenarnya. Jika metode tersebut berperilaku persis seperti yang diiklankan, angka ini akan berada di 95% di mana-mana. Namun kenyataannya tidak demikian. Pada F sebesar 3, interval satu sampel mencakup kebenaran 99.8% dari waktu, turun menjadi 96.7% pada F sebesar 100. Interval dua sampel sedikit lebih rendah daripada interval satu sampel dan mencapai 95.5% pada kekuatan tertinggi.
Cakupan yang berlebihan adalah ciri khas dari kesalahan standar yang terlalu besar untuk informasi yang tersedia. Ini berarti instrumen yang lemah menghasilkan interval yang konservatif, bukan menyesatkan. Ini adalah perbedaan yang benar-benar penting bagi siapa pun yang menafsirkan hasil nol yang dipublikasikan. Sebuah makalah randomisasi Mendel yang melaporkan tidak adanya efek berdasarkan instrumen yang lemah belum menunjukkan bahwa tidak ada efek yang ada. Makalah tersebut menunjukkan bahwa desainnya tidak dapat mendeteksi efek tersebut. Itu adalah klaim yang berbeda, dan para peninjau semakin sering meminta penulis untuk menyatakan klaim mana yang mereka buat.
Nilai rata-rata tidak ada, dan dua mesin telah membuktikannya.
Satu besaran menunjukkan hasil yang tidak konsisten antara kedua implementasi kami, dan ketidaksesuaian ini memberikan pelajaran berharga. Pada nilai F sebesar 3, mesin R menghasilkan estimasi rata-rata 0.64 pada kondisi satu sampel. Mesin Python, yang menjalankan desain yang identik, menghasilkan 0.24. Pada kondisi dua sampel, kedua mesin menghasilkan 0.77 dan 1.01. Setiap besaran lain dalam artikel ini sesuai dalam batas kesalahan Monte Carlo, sedangkan besaran ini tidak.
Itu bukan kesalahan pada kedua program tersebut. Estimasi kausal di sini adalah rasio dari dua koefisien regresi, dan ketika penyebut dapat mendekati nol secara sembarangan, rasio tersebut tidak memiliki ekspektasi yang terbatas. Rata-rata sampel dari kuantitas tersebut tidak akan konvergen tidak peduli berapa banyak replikasi yang Anda jalankan, sehingga dua program yang jujur akan berbeda pendapat tentang hal itu tanpa batas waktu. Median, lebar interval, dan cakupan semuanya konvergen secara normal, itulah sebabnya tabel di atas melaporkan hal-hal tersebut dan bukan rata-rata. Setiap hasil randomisasi Mendel yang bergantung pada rata-rata di seluruh varian tanpa mengakui distribusi ekor tebal berada di atas landasan yang tidak stabil yang sama, yang merupakan salah satu alasan mengapa estimator yang tahan terhadap pleiotropi yang dibahas dalam panduan randomisasi Mendel utama kami menggunakan median dan modus daripada rata-rata biasa. Simulasi pendamping kami tentang apa yang sebenarnya dilindungi oleh masing-masing dari empat estimator tersebut mengujinya di enam rezim pleiotropi dan menemukan satu di mana keempatnya sepakat dan keempatnya salah.
Sampel Hanya Tumpang Tindih Saat Instrumen Lemah
Randomisasi Mendel dua sampel mengasumsikan GWAS paparan dan GWAS hasil diukur pada orang yang berbeda. Dalam praktiknya, asumsi tersebut terus-menerus dilanggar, karena sejumlah besar biobank berkontribusi pada sebagian besar GWAS yang dipublikasikan, dan peserta yang sama muncul di kedua sisi analisis tanpa disadari oleh penulis. Burgess, Davies, dan Thompson (2016) menetapkan bahwa tumpang tindih mendorong estimasi dua sampel kembali ke perilaku satu sampel, yang berarti kembali ke asosiasi observasional yang membingungkan.
Kami menguji ukuran efek tersebut secara langsung, dengan memvariasikan tumpang tindih dari 0% hingga 100% pada tiga kekuatan instrumen.
| Tumpang tindih peserta | Bias median pada F = 3 | Bias median pada F = 5 | Bias median pada F = 10 |
|---|---|---|---|
| 0% | -0.004 | -0.011 | -0.003 |
| 25% | -0.016 | -0.008 | -0.010 |
| 50% | -0.003 | -0.012 | 0.000 |
| 75% | +0.015 | -0.005 | +0.011 |
| 100% | +0.026 | +0.005 | +0.005 |
Pada nilai F sebesar 3 dengan tumpang tindih sempurna, estimasi median tertarik ke atas sekitar 0.026 pada efek sebenarnya sebesar 0.20, pergeseran sekitar 13% menuju nilai yang tercampur, dan kedua mesin mereproduksinya secara independen. Pada nilai F sebesar 10, tidak ada pola berurutan yang tersisa. Kedua masalah tersebut saling memperkuat daripada menambah: tumpang tindih mengubah instrumen yang lemah menjadi instrumen yang bias, tetapi pada instrumen yang kuat, hal itu hampir tidak berpengaruh.
Implikasi pelaporannya sangat jelas. Menyatakan bahwa dua studi GWAS saling tumpang tindih tidaklah cukup, begitu pula dengan menyatakan bahwa keduanya tidak tumpang tindih. Yang dibutuhkan oleh seorang penilai adalah fraksi tumpang tindih bersamaan dengan kekuatan instrumen, karena yang pertama hanya dapat diinterpretasikan berdasarkan yang kedua. Ketika keduanya tidak menguntungkan, respons yang jujur bukanlah peringatan dalam diskusi, melainkan sumber data yang berbeda.
Mengapa Aturan F Lebih Besar Dari 10 Masih Lebih Penting Daripada yang Ditunjukkan Hasil Kami
Simulasi kami menggunakan satu instrumen, dan akan menjadi kesalahan interpretasi yang serius jika menyimpulkan dari simulasi tersebut bahwa instrumen yang lemah tidak berbahaya. Kasus yang baru saja kami identifikasi dan uji adalah kasus yang paling ramah. Bias yang dijelaskan oleh Burgess dan Thompson (2011) meningkat seiring dengan jumlah instrumen, sehingga desain dengan 200 varian yang signifikan secara marginal akan terpapar sesuatu yang tidak dapat ditunjukkan oleh pengaturan varian tunggal kami. Inilah tepatnya situasi yang tercipta akibat pelonggaran ambang batas signifikansi genomik dari 5 x 10⁻⁸ menjadi 1 x 10⁻⁵ untuk mendapatkan lebih banyak instrumen, yang sekarang menjadi praktik umum untuk paparan dengan arsitektur genetik yang jarang.
Dua poin tambahan perlu dipertimbangkan dalam setiap pembahasan yang jujur. Dalam randomisasi Mendelian multivariabel, kuantitas yang relevan bukanlah statistik F biasa sama sekali, melainkan statistik F kondisional yang diperkenalkan oleh Sanderson dan rekan-rekannya (2019) , yang mengukur apakah instrumen dapat membedakan paparan satu sama lain daripada hanya memprediksi masing-masing secara terpisah. Makalah-makalah secara rutin melaporkan statistik yang salah di sini. Secara terpisah, ketika instrumen diukur dengan kesalahan, estimasi MR-Egger menjadi tidak dapat diandalkan, dan diagnostiknya adalah statistik I-squared-GX dari Bowden dan rekan-rekannya (2016) . Nilai yang rendah berarti analisis sensitivitas yang Anda andalkan untuk melindungi terhadap pleiotropi itu sendiri tidak dapat dipercaya.
Apa yang Sebenarnya Ditemukan oleh Para Peninjau dalam Makalah Riset Pasar yang Dipublikasikan
Kesenjangan antara standar yang dijelaskan di atas dan standar yang diterapkan dalam praktik kini telah diukur. Rosas-Chavez dan Merriman (2025) secara sistematis mengevaluasi 86 studi randomisasi Mendelian dua sampel tentang hiperurisemia dan asam urat yang diterbitkan antara tahun 2016 dan 2024, dengan memberi skor masing-masing studi berdasarkan metrik kualitas terstruktur. Temuan mereka, dalam angka mereka sendiri:
- 66% Satu dari tiga makalah memenuhi asumsi relevansi, yang berarti signifikansi di seluruh genom atau statistik F yang dilaporkan di atas 10. Satu dari tiga makalah tidak memenuhi asumsi tersebut.
- 51% menggunakan kumpulan data tanpa tumpang tindih partisipan, yang menurut laporan mereka sendiri menyebabkan sekitar setengah dari literatur terpapar pada interaksi yang dijelaskan di atas.
- 59% membahas kekuatan statistik sama sekali.
- 17% Memenuhi ketiga asumsi inti variabel instrumental.
- 14% melakukan analisis replikasi apa pun.
- 11% dari makalah yang diterbitkan setelah tahun 2021 mematuhi Pedoman pelaporan STROBE-MR.
Skor kualitas keseluruhan dalam tinjauan tersebut berkisar dari 0 hingga 19 pada skala hingga 21, dengan rata-rata 9.1. Ini adalah satu bidang penyakit, dan bidang lain mungkin berbeda, tetapi ini adalah audit kualitas pelaporan MR yang paling sistematis yang tersedia saat ini dan arah yang ditunjukkannya sesuai dengan apa yang dilihat oleh ahli statistik kami sendiri dalam manuskrip yang dikirimkan. Ketika lima dari enam makalah gagal memenuhi asumsi yang menjadi dasar kesimpulan mereka sendiri, editor menanggapi dengan menaikkan standar untuk semua orang, itulah sebabnya kelengkapan metodologis telah menjadi masalah penyaringan daripada masalah gaya. Panduan kami untuk pelaporan STROBE untuk studi observasional mencakup pedoman induk yang diperluas oleh STROBE-MR.
Bagaimana Melaporkan Kekuatan Instrumen Agar Penilai Dapat Memeriksanya?
Melaporkan satu angka dan kemudian melanjutkan ke langkah berikutnya adalah yang memicu kueri. Berikut adalah apa yang ditulis oleh para ahli statistik kami di bagian metode, dan apa yang dicari oleh peninjau metodologi ketika mereka membukanya.
- Statistik F per instrumen dan gabungan. Laporkan keduanya. Nilai F gabungan sebesar 40 yang dibangun dari tiga puluh varian, masing-masing dengan nilai F mendekati 1.3, adalah objek yang berbeda dari nilai F gabungan sebesar 40 yang dibangun dari tiga varian kuat, dan hanya tabel per-varian yang menunjukkan mana yang Anda miliki.
- Proporsi varians paparan yang dijelaskan. Sebutkan nilai R-squared untuk perangkat instrumen tersebut. Inilah yang menentukan presisi, dan merupakan besaran yang dibutuhkan pembaca untuk menilai apakah interval pengukuran Anda cukup sempit untuk dapat bermanfaat.
- Ambang batas seleksi, yang dinyatakan sebelum hasil. Jika Anda melakukan pelonggaran di bawah ambang batas signifikansi genomik, sebutkan hal tersebut, jelaskan alasannya, dan laporkan analisis pada kedua ambang batas tersebut sehingga pembaca dapat melihat apakah temuan tersebut bergantung pada pelonggaran tersebut.
- Parameter penggumpalan dan panel referensi. Ambang batas ketidakseimbangan keterkaitan, ukuran jendela, dan panel mana yang digunakan. Instrumen yang tidak independen akan meningkatkan kekuatan yang tampak.
- Fraksi tumpang tindih, beserta sumbernya. Sebutkan kelompok kohort yang berkontribusi pada setiap GWAS dan perkirakan proporsi yang sama. Jika Anda tidak dapat memperkirakannya, nyatakan hal itu, dan perlakukan analisis tersebut sebagai desain satu sampel untuk interpretasi.
- Pernyataan yang tepat, bukan hanya pernyataan yang signifikan. Laporkan ukuran efek minimum yang dapat dideteksi oleh desain Anda. Hasil nol tanpa ini tidak dapat diinterpretasikan, seperti yang ditunjukkan oleh hasil cakupan di atas.
- Statistik F bersyarat untuk analisis multivariabel apa pun. Nilai F biasa tidak menjawab pertanyaan yang diajukan oleh randomisasi Mendel multivariabel.
Tiga Kesalahan yang Menyebabkan Kegagalan Ini
Memperlakukan nilai F lebih besar dari 10 sebagai nilai lulus, bukan sebagai nilai minimum. Melebihi 10 tidak membuat sebuah penelitian memadai. Pada angka-angka kita, nilai F sebesar 10 masih menyisakan interval tujuh kali lebih lebar daripada efek yang diukur. Ambang batas menandai titik di bawahnya bias menjadi masalah, bukan titik di atasnya presisi menjadi cukup.
Melonggarkan ambang batas nilai p untuk mendapatkan lebih banyak instrumen. Ini adalah jalur paling umum menuju wilayah instrumen lemah, dan hal ini justru bertentangan dengan maksud penulis. Hal ini menambahkan varian yang memberikan sedikit kekuatan sekaligus meningkatkan jumlah instrumen, yang merupakan kombinasi yang diperingatkan oleh hasil bias klasik. Jika suatu paparan memiliki terlalu sedikit varian yang signifikan secara genomik, itu adalah informasi tentang apakah penelitian harus dilanjutkan, bukan hambatan yang harus diatasi.
Melaporkan hasil nol sebagai bukti tidak adanya efek. Dengan instrumen yang lemah, interval tersebut mencakup kebenaran 99.8% dari waktu justru karena mencakup hampir semuanya. Hasil nol dari desain yang kurang bertenaga adalah pernyataan tentang desain tersebut, dan peninjau yang memahami hal ini akan mengatakannya. Panduan kami tentang tingkat bukti dalam penelitian klinis mencakup posisi hasil MR yang dieksekusi dengan baik relatif terhadap bukti uji coba, dan tinjauan kami tentang inferensi kausal dalam epidemiologi mencakup keluarga desain yang lebih luas yang termasuk di dalamnya. Hasil nol dari desain instrumen yang lemah juga tidak dapat diinterpretasikan sendiri, yang merupakan subjek dari artikel pendamping kami tentang mengapa makalah randomisasi Mendel ditolak mentah-mentah.
Dukungan Profesional untuk Studi Randomisasi Mendel
Kekuatan instrumen adalah hal pertama yang diperiksa oleh ahli statistik kami, dan hal ini diperiksa sebelum analisis apa pun ditugaskan, bukan dilaporkan setelahnya. Jika suatu paparan memiliki terlalu sedikit varian signifikan di seluruh genom yang independen, atau jika satu-satunya GWAS hasil yang tersedia memiliki sampel yang sama secara substansial dengan GWAS paparan, kami akan menyatakannya sejak awal. Alternatifnya adalah menghasilkan analisis yang secara teknis benar tetapi tidak akan diterima oleh peninjau dan tidak dapat digunakan oleh pembaca.
Pemeriksaan Kelayakan
$450
Jumlah instrumen, statistik F, tumpang tindih sampel, dan literatur yang ada diperiksa sebelum Anda berkomitmen. Lanjutkan, ubah, atau hentikan, secara tertulis. Dikreditkan sepenuhnya terhadap studi apa pun yang Anda pesan selanjutnya. 5 hari kerja.
MR Dua Sampel
$2,900
Studi lengkap dari statistik ringkasan GWAS publik: empat estimator, MR-PRESSO, penyaringan Steiger, instrumen PheWAS, leave-one-out, ditambah daftar periksa STROBE-MR yang lengkap dan kode R yang dapat dijalankan. 15 hari kerja.
Desain yang Diperluas
Dari Rp 3,500
MR multivariabel dengan statistik F bersyarat, MR mediasi, kolokalisasi, MR target obat, dan MR non-linear. Penawaran harga tetap dan ruang lingkup tertulis sebelum pekerjaan dimulai.
Jika Anda masih memilih antara desain genetik dan analisis survei, registri kanker, atau registri trauma, panduan kami tentang basis data kesehatan mana yang harus digunakan studi Anda menjelaskan apa yang dapat dan tidak dapat dijawab oleh setiap sumber.
Alat Riset Gratis dari Editverse
- GraphProBuat grafik siap publikasi, 25 jenis, dengan uji t, ANOVA, korelasi, dan nilai p chi-square bawaan. Gratis, tanpa pendaftaran.
- StatPro: kalkulator statistik gratis dan alat pemilihan tes yang mencakup perbandingan kelompok, hasil kategorikal, analisis waktu kejadian, dan akurasi diagnostik.
- Flowchart Pro: Hasilkan diagram alur PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE, dan ARRIVE langsung di browser Anda.
Pertanyaan yang Sering Diajukan Tentang Kekuatan Instrumen dalam Randomisasi Mendel
Apakah nilai statistik F di atas 10 cukup untuk publikasi?
Hal itu perlu, tetapi tidak cukup. Simulasi kami menunjukkan bahwa pada nilai F sebesar 10, interval 95% yang umum masih tujuh kali lebih lebar daripada efek yang diestimasi, yang cukup untuk membuktikan bahwa desain penelitian tidak terlalu bias tetapi tidak cukup untuk menjawab sebagian besar pertanyaan penelitian. Para penilai semakin mengharapkan pernyataan presisi di samping statistik F, yang menunjukkan efek terkecil yang dapat dideteksi oleh penelitian tersebut.
Bagaimana cara menghitung statistik F untuk beberapa instrumen?
Untuk sekumpulan varian independen, nilai F gabungan dapat dihitung dari proporsi total varians paparan yang dijelaskan dan ukuran sampel, menggunakan rumus F sama dengan R-kuadrat dikalikan dengan jumlah n dikurangi k dikurangi 1, dibagi dengan jumlah 1 dikurangi R-kuadrat, dikalikan k, di mana k adalah jumlah instrumen. Laporkan juga statistik F per varian, karena nilai gabungan yang tinggi dapat dihasilkan baik oleh beberapa instrumen yang kuat maupun oleh banyak instrumen yang lemah, dan hanya yang pertama yang meyakinkan.
Apakah bias instrumen lemah mendorong ke arah hipotesis nol atau ke arah estimasi yang dikacaukan?
Hal ini bergantung pada desainnya. Dalam analisis satu sampel, biasnya cenderung pada asosiasi observasional yang membingungkan. Dalam analisis dua sampel yang sebenarnya tanpa tumpang tindih partisipan, biasnya cenderung pada hipotesis nol. Tumpang tindih parsial berada di antara keduanya, itulah sebabnya fraksi tumpang tindih harus dilaporkan bersamaan dengan kekuatan instrumen, bukan sebagai penggantinya.
Bisakah saya menurunkan ambang batas nilai p untuk mendapatkan lebih banyak instrumen?
Anda bisa melakukannya, tetapi biasanya malah memperburuk masalah daripada memperbaikinya. Varian yang dipilih pada ambang batas yang longgar hanya sedikit menambah proporsi varians paparan yang dijelaskan sementara jumlah instrumen meningkat, dan bias instrumen lemah dalam kasus identifikasi berlebihan meningkat seiring dengan jumlah instrumen. Jika Anda melonggarkan ambang batas, laporkan analisis pada kedua ambang batas tersebut sehingga pembaca dapat melihat apakah hasilnya tetap valid.
Bagaimana jika paparan saya hanya memiliki segelintir varian yang signifikan secara genom?
Maka jawaban jujurnya mungkin adalah bahwa studi randomisasi Mendel bukanlah desain yang tepat untuk paparan tersebut saat ini. Intervalnya akan cukup lebar untuk mencakup hampir semua hal, dan baik estimasi maupun hasil nol darinya tidak akan dapat diinterpretasikan. Ini adalah pertanyaan yang layak diselesaikan sebelum analisis, bukan setelahnya, yang merupakan tujuan dari penilaian kelayakan.
Bagaimana saya tahu apakah dua studi GWAS memiliki peserta yang sama?
Bacalah daftar kohort yang berkontribusi dalam setiap publikasi dan materi tambahannya. Biobank yang sangat besar muncul dalam sebagian besar GWAS yang dipublikasikan, jadi asumsi default untuk dua studi besar tentang sifat umum adalah bahwa ada beberapa tumpang tindih sampai Anda memeriksanya. Jika tumpang tindih tidak dapat dikuantifikasi, interpretasikan analisis tersebut sebagai desain satu sampel.
Kesimpulan
Dalam 135,000 studi randomisasi Mendel yang disimulasikan, yang direproduksi secara independen dalam dua program, statistik F ternyata mengatur sesuatu yang berbeda dari apa yang biasanya dimaksudkan. Estimasi median tetap mendekati kebenaran pada setiap kekuatan instrumen yang kami uji. Yang berubah enam kali lipat adalah lebar interval di sekitarnya, dari 2.1 kali efek sebenarnya pada F sebesar 100 menjadi 13.6 kali pada F sebesar 3. Tumpang tindih sampel hanya menghasilkan pergeseran yang terdeteksi di mana instrumen sudah lemah, dan bahkan pergeseran tersebut kecil dibandingkan dengan ketidaktepatan di sekitarnya.
Secara praktis, kekuatan instrumen adalah pertanyaan tentang apakah suatu penelitian dapat menjawab sesuatu, dan hanya secara sekunder merupakan pertanyaan tentang bias. Pembingkaian ulang ini mengubah kapan pengecekan harus dilakukan. Statistik F yang dilaporkan dalam tabel hasil adalah deskripsi dari penelitian yang telah dijalankan. Statistik F yang dihitung selama perancangan adalah keputusan tentang apakah akan menjalankannya atau tidak. Mengingat hanya 17% dari makalah dalam audit yang paling sistematis yang dipublikasikan memenuhi ketiga asumsi inti, dan hanya 14% yang mencoba replikasi, pengecekan yang dilakukan sebelum analisis adalah yang membedakan manuskrip yang lolos tinjauan dari yang tidak.
Referensi
- Staiger D, Stock JH. Regresi variabel instrumental dengan instrumen lemah. Econometrica. 1997;65(3):557-586. doi: 10.2307 / 2171753
- Burgess S, Thompson SG. Menghindari bias dari instrumen yang lemah dalam studi randomisasi Mendel. International Journal of Epidemiology. 2011;40(3):755-764. doi:10.1093/ije/dyr036 (PMID 21414999)
- Pierce BL, Ahsan H, VanderWeele TJ. Persyaratan kekuatan dan kekuatan instrumen untuk studi randomisasi Mendel menggunakan beberapa varian genetik. International Journal of Epidemiology. 2011;40(3):740-752. doi:10.1093/ije/dyq151 (PMID 20813862)
- Burgess S, Davies NM, Thompson SG. Bias akibat tumpang tindih partisipan dalam randomisasi Mendel dua sampel. Epidemiologi Genetik. 2016;40(7):597-608. doi:10.1002/gepi.21998
- Bowden J, Del Greco MF, Minelli C, Davey Smith G, Sheehan NA, Thompson JR. Menilai kesesuaian data ringkasan untuk analisis randomisasi Mendelian dua sampel menggunakan regresi MR-Egger: peran statistik I-kuadrat. International Journal of Epidemiology. 2016;45(6):1961-1974. doi:10.1093/ije/dyw220
- Sanderson E, Davey Smith G, Windmeijer F, Bowden J. Pemeriksaan randomisasi Mendelian multivariabel dalam pengaturan data ringkasan sampel tunggal dan dua sampel. International Journal of Epidemiology. 2019;48(3):713-727. doi:10.1093/ije/dyy262
- Rosas-Chavez F, Merriman TR. Studi randomisasi Mendel: metrik untuk evaluasi kualitas. Penyakit Asam Urat, Urat, dan Pengendapan Kristal. 2025; 3 (2): 8. doi:10.3390/gucdd3020008 (PMID 42487900)
- Skrivankova VW, Richmond RC, Woolf BAR, dkk. Memperkuat pelaporan studi observasional dalam epidemiologi menggunakan randomisasi Mendel: pernyataan STROBE-MR. JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236
Detail simulasi: 5,000 individu per sampel, instrumen bialelik tunggal pada frekuensi alel minor 0.3, beban confounder tak terukur 0.5 pada paparan dan hasil, efek kausal sebenarnya 0.20, asosiasi observasional yang dikacaukan 0.40. Kekuatan instrumen dikalibrasi untuk menargetkan nilai F tahap pertama sebesar 3, 5, 10, 20, 50, dan 100. 5,000 replikasi per sel. Diimplementasikan secara independen di R 4.3.3 dan Python 3 dengan NumPy; semua kuantitas yang dilaporkan sesuai antara kedua mesin dalam batas kesalahan Monte Carlo kecuali rata-rata estimator rasio, yang tidak memiliki ekspektasi terbatas dan dibahas di atas.