
Udgivet | Sidst opdateret
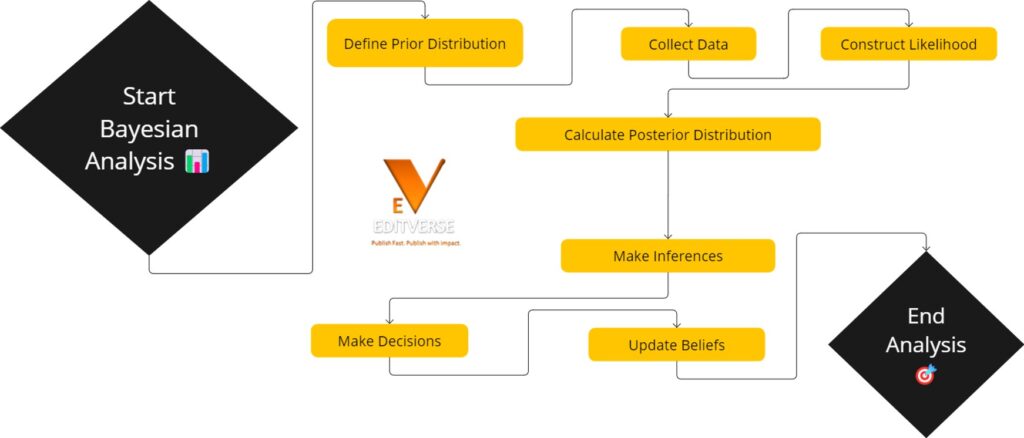
Epidemiologer tyr i stigende grad til Bayesianske metoder inden for epidemiologi, når et studie har for få tilfælde til, at standardfrekventistiske værktøjer fungerer godt, når tidligere forskning allerede peger på et plausibelt interval for en parameter, eller når sygdomsrisikoen skal kortlægges på tværs af hundredvis af små områder på én gang. I stedet for at producere et enkelt punktestimat og en p-værdi kombinerer en Bayesiansk analyse, hvad der allerede var kendt om en parameter, med nye studiedata og rapporterer derefter en fuld sandsynlighedsfordeling for den parameter i stedet for ét tal. Det følgende gennemgår mekanismerne i denne proces, de specifikke epidemiologiske problemer, hvor den ekstra kompleksitet betaler sig, softwareforskerne, der kører den ind, og et publiceret kræftovervågningsstudie, der viser den tilgang, der anvendes på tværs af 218 virkelige samfund.
Hvad Bayesianske metoder bidrager med til epidemiologi
Frekventistisk statistik dominerede medicinsk forskning i det meste af det tyvende århundrede, bygget op omkring p-værdier, konfidensintervaller og en streng regel mod at bruge andet end det aktuelle datasæt. Bayesiansk statistik for klinisk forskning, beskrevet i en Lancet- metodegennemgang fra 2024 af Goligher, Heath og Harhay , behandler sandsynlighed som et mål for styrken af tro snarere end en langsigtet frekvens, hvilket giver en undersøgelse mulighed for formelt at kombinere tidligere information med nye data for at producere en opdateret eller posterior sandsynlighedsfordeling for enhver interessemængde. Moderne databehandling fjernede den største praktiske barriere for denne tilgang. Simuleringsbaseret estimering, der engang krævede specialiseret hardware, kører nu på en bærbar computer, hvilket er en stor del af grunden til, at Bayesianske metoder er gået fra en statistisk minoritetsfilosofi til rutinemæssig brug på tværs af kræftovervågning, lægemiddelovervågning og udbrudsmodellering i løbet af de sidste to årtier.
Bayes' sætning og logikken bag at opdatere tro
Enhver Bayesiansk model hviler på den samme ligning. Bayes' sætning siger, at den posteriore sandsynlighed for en parameter givet dataene er proportional med sandsynligheden for dataene givet den pågældende parameter, ganget med den forudgående sandsynlighed for selve parameteren. Udskrevet for en parameter θ og observerede data X, er forholdet P(θ|X) ∝ P(X|θ) × P(θ). Tre dele udfører alt arbejdet her. Den forudgående, P(θ), indfanger, hvad der allerede er kendt eller rimeligt antaget om parameteren, før den aktuelle undersøgelse udføres. Sandsynligheden, P(X|θ), beskriver, hvor sandsynlige de observerede data ville være under forskellige kandidatværdier for parameteren. Den posteriore, P(θ|X), er den opdaterede fordeling, der er resultatet af at kombinere de to, og den bliver det objekt, som en Bayesiansk epidemiolog rent faktisk rapporterer og fortolker.
Selve teoremet er to århundreder ældre end moderne epidemiologi. Bayes' sætning er opkaldt efter Thomas Bayes, en præst, der aldrig selv udgav resultatet, og essayet, der indeholdt det, blev posthumt læst op for Royal Society af filosoffen Richard Price i 1763, en milepæl, som en historisk gennemgang fra 2014 i Cadernos de Saúde Pública af Martinez og Achcar markerede på dens 250-års jubilæum i 2013. Frekventistiske metoder skubbede Bayesianske tilgange til kanten af anvendt statistik i det meste af de følgende to århundreder og vendte først tilbage til rutinemæssig epidemiologisk brug, da Markov-kæde Monte Carlo-beregning gjorde komplekse posteriorer håndterbare.
Forudgående, sandsynlighed og efterfølgende i praksis
Et illustrativt eksempel viser mekanismerne uden behov for et komplet datasæt. Antag, at en sundhedsmyndighed ønsker at estimere prævalensen af et nyligt identificeret patogen i et distrikt, før der har fundet lokale tests sted. National overvågning antyder en prævalens et sted omkring 4 procent, men med reel usikkerhed, så teamet koder denne antagelse som en Beta(4, 96) prior-fordeling, der centrerer sig omkring 4 procent, men stadig tillader værdier fra et godt stykke under 1 procent til over 10 procent. En undersøgelse af 200 lokale beboere finder derefter 14 positive tilfælde. Fordi beta-fordelingen er den konjugerede prior for en binomial sandsynlighed, er den posteriore blot en anden beta-fordeling, Beta(4 + 14, 96 + 186), der løber ud til Beta(18, 282) og centrerer sig omkring et posteriort prævalensestimat på omkring 6 procent, trukket mellem de nationale prior og de lokale data i forhold til, hvor meget information hver enkelt indeholder. Disse tal er illustrative og er ikke hentet fra et specifikt offentliggjort udbrud, valgt kun for at vise, hvordan en prior og en sandsynlighed kombineres aritmetisk til en posterior.
| Semester | Hvad det repræsenterer | Epidemiologisk eksempel |
|---|---|---|
| Tidligere distribution | Tro på en parameter før man har set dataene fra den aktuelle undersøgelse | Regionalt prævalensestimat fra en tidligere national undersøgelse |
| Sandsynlighedsfunktion | Sandsynligheden for de observerede data under forskellige parameterværdier | Chance for at observere 14 positive tests ud af 200 givet en reel prævalens |
| Posterior fordeling | Opdateret tro efter kombination af tidligere og sandsynlighed | Revideret distriktsprævalensestimat efter den lokale undersøgelse |
| Troværdigt interval | Område, der indeholder parameteren med en angivet posterior sandsynlighed | 95 procent troværdigt interval for distriktets sande prævalens |
| Konjugat prior | En prior, der kombineret med en given sandsynlighed giver en posterior af samme familie | Beta-aprior parret med en binomial sandsynlighed for en andel |
| Markov-kæden Monte Carlo | Simuleringsmetode til prøveudtagning fra posteriorer uden lukket løsning | Estimering af en rumlig sygdomskortlægningsmodel med hundredvis af parametre |
Troværdige intervaller versus konfidensintervaller
Forskere misforstår rutinemæssigt, hvad et 95 procents konfidensinterval betyder, og behandler det som en 95 procents chance for, at den sande værdi falder inden for et specifikt beregnet interval. Et konfidensinterval lover kun, at 95 procent af de intervaller, der er konstrueret på denne måde, på tværs af mange gentagne undersøgelser, ville indeholde den sande parameter, som er en udtalelse om proceduren, ikke om det specifikke interval, der er tale om. Et Bayesiansk troværdigt interval siger præcis, hvad folk ønsker, at konfidensintervaller sagde, at givet de observerede data og den valgte prior, er der en 95 procents posterior sandsynlighed for, at parameteren ligger inden for det angivne interval. Goligher, Heath og Harhays 2024 Lancet- gennemgang gennemgår denne sondring som en af de mere praktisk vigtige forskelle mellem de to rammer, da det ændrer, hvordan et troværdigt interval legitimt kan beskrives for klinikere, tidsskriftredaktører og beslutningstagere.
Hvorfor epidemiologer vælger Bayesianske metoder
Små stikprøver skaber det klareste argument for en Bayesiansk tilgang. En analyse fra 2025 i Journal of Data Science af Xie, Rolka og Barker modellerede prævalensen af sjældne sygdomme på amtsniveau ved hjælp af en Bayesiansk hierarkisk stikprøvevægtet nul-oppustet model, specifikt fordi mange amter havde for få observerede tilfælde til, at standardundersøgelsesbaseret estimering kunne producere stabile resultater. Pædiatriske forsøg og forsøg med sjældne sygdomme står over for et relateret problem, og en metodeartikel fra 2022 i BMC Medical Research Methodology af Turner og kolleger beskrev lån af information på tværs af patientundergrupper i et pædiatrisk HIV-forsøg ved hjælp af en Bayesiansk hierarkisk model, så et lille undergruppeestimat kunne trække statistisk styrke fra relaterede undergrupper i stedet for at stå alene på en håndfuld deltagere. Bayesianske modeller håndterer denne form for delvis pooling naturligt, fordi hver parameter på gruppeniveau i sig selv er trukket fra en fælles populationsniveaufordeling i stedet for at blive estimeret isoleret.
At inkorporere ægte tidligere evidens er lige så vigtigt som at håndtere små stikprøver. Når en systematisk gennemgang, et tidligere forsøg eller en veletableret regional baseline allerede begrænser, hvor en parameter sandsynligvis vil falde, giver Bayesiansk analyse et studie mulighed for formelt at bruge disse oplysninger i stedet for at kassere dem og genvurdere alt fra en blank tavle, hvilket under alle omstændigheder er tættere på, hvordan epidemiologer ræsonnerer uformelt.
Hierarkiske og flerniveaumodeller til indlejrede populationsdata
Folkesundhedsdata findes sjældent på ét enkelt niveau. Patienter grupperes inden for klinikker, klinikker grupperes inden for distrikter, og distrikter grupperes inden for lande, og hvert niveau i denne struktur bærer sin egen variationskilde. Hierarkiske eller flerniveau-bayesianske modeller repræsenterer hvert niveau eksplicit, hvilket lader parametre for individuelle klinikker eller distrikter variere omkring en fælles fordeling på højere niveau i stedet for at tvinge en enkelt fast effekt på hver gruppe eller, i den anden ende, estimere hver gruppe i fuldstændig isolation. Estimater for små eller usædvanlige grupper trækkes eller krympes mod det samlede gennemsnit i forhold til, hvor lidt lokale data understøtter dem, mens grupper med rigelige data overlades til at tale for sig selv. Denne reduktion er netop det, der lader Turner og kolleger producere brugbare undergruppespecifikke behandlingseffektestimater fra et pædiatrisk forsøg, der er for lille til at analysere en enkelt undergruppe alene ved hjælp af konventionelle metoder. En ledsagende vejledning om flerniveaumodellering for indlejrede medicinske data dækker mekanismerne for faste effekter og tilfældige effekter bag denne tilgang mere dybdegående.
Bayesiansk sygdomskortlægning og estimering af små områder
Kortlægning af sygdomsrisiko på tværs af mange små geografiske områder er et af de miljøer, hvor Bayesianske metoder inden for epidemiologi konsekvent overgår enklere alternativer. Rå sygdomsrater i små områder er notorisk ustabile, da en kommune med 3,000 indbyggere kan se sin rate svinge voldsomt baseret på to eller tre ekstra tilfælde på et enkelt år. Besag-York-Mollié-modellen, eller BYM-modellen, adresserer dette ved at kombinere en ustruktureret tilfældig effekt med en rumligt struktureret effekt, der låner styrke fra geografisk tilstødende områder, udjævner støj, samtidig med at den bevarer ægte rumlige klynger af forhøjet eller reduceret risiko. Statistikeren Andrew Gelman og medforfattere offentliggjorde en fuld fungerende implementering af BYM-modellen i det probabilistiske programmeringssprog Stan i en artikel fra 2020 i Spatial and Spatio-temporal Epidemiology , hvilket gør metoden langt mere tilgængelig for anvendte epidemiologer end den specialiserede software, den oprindeligt krævede. En tidligere anvendelse af Catelan, Lagazio og Biggeri byggede en hierarkisk bayesiansk model på tre niveauer til at studere dødeligheden af lungekræft i 287 kommuner i Toscana, Italien, i perioden 1995 til 1999, ved hjælp af posterior klassifikationssandsynligheder til at markere områder med reelt forhøjet risiko, samtidig med at der kontrolleres for problemet med multiple tests, der opstår, når hundredvis af små områder sammenlignes samtidigt. Rumlige og miljømæssige risikofaktorer interagerer med denne type modellering på måder, der er dækket yderligere i en relateret artikel om miljømæssig og rumlig statistik inden for folkesundhed.
Et fungerende eksempel: Kortlægning af kræft i små områder i British Columbia
Et studie fra 2022 i Frontiers in Oncology af Simkin og kolleger ved BC Cancer viser den fulde arbejdsgang anvendt på reelle overvågningsdata i stedet for en simulering. Holdet hentede incidente tilfælde af lunge-, bryst-, livmoderhals- og kolorektalkræft diagnosticeret blandt beboere i British Columbia mellem 2011 og 2018 fra BC Cancer Registry og kortlagde derefter risikoen på tværs af 218 Community Health Service Areas ved hjælp af en modificeret BYM2-model. Indirekte aldersstandardisering producerede forventede tilfælde og standardiserede incidensforhold for hvert område i forhold til den provinsielle rate, Morans I kvantificerede, hvor stærkt naboområder delte lignende risikoniveauer, og selve BYM2-modellen genererede posteriore mediane relative risici med fuldt troværdige intervaller for hvert område, hvilket udjævnede ustabile antal i små områder, samtidig med at de stadig markerede reelle lokale klynger.
| Kræfttype | Hændelsessager, 2011-2018 | Geografiske enheder |
|---|---|---|
| Lunge | 26,448 | 218 områder for lokalsamfundets sundhedsvæsen |
| Kvindebryst | 28,466 | |
| Cervikal | 1,478 | |
| Kolorektal | 25,457 |
Det praktiske udbytte af dette studie var lige så meget tilgængelighed som nøjagtighed. Simkin og kolleger pakkede hele modellerings- og kortlægningsarbejdsgangen ind i open source-pakken smallareampapp R, specifikt fordi, som de bemærker, den tekniske kapacitet for disse metoder fortsat er begrænset på tværs af kræftregistre, og et reproducerbart værktøj sænker barrieren for andre provinsielle og statslige registre til at køre den samme analyse på deres egne data.
Bayesianske metoder i sygdomsovervågning og signaldetektion
Lægemiddelovervågning var en tidlig bruger af Bayesiansk signaldetektion, længe før "bayesiansk" blev et almindeligt ord i generel epidemiologi. En metodegennemgang fra 2009 i Pharmacoepidemiology and Drug Safety af Bate og Evans beskrev, hvordan regulatorer screener spontane bivirkningsrapporter ved hjælp af empiriske Bayes-metoder såsom det empiriske Bayes geometriske middelværdi, som reducerer støjende rå rapporteringsforhold mod et mere konservativt estimat for lægemiddel-hændelsespar med få rapporter, hvilket reducerer falske alarmer uden at kræve, at analytikere ignorerer sjældne, men ægte sikkerhedssignaler. Kræftovervågning viser en parallel tendens på populationsniveau. En systematisk gennemgang i International Journal of Public Health af Wah, Ahern og Earnest identificerede 38 undersøgelser offentliggjort mellem 2014 og 2018, der anvendte fuldt Bayesianske rumligt-temporale modeller på kræftincidens- og dødelighedsdata, hvilket beviser, at den samme reduktionslogik bag lægemiddelovervågningssignaldetektion nu understøtter, hvordan registre sporer ændringer i kræftrisiko over både sted og tid.
Software til Bayesiansk epidemiologi
Fire platforme dækker det meste anvendte Bayesianske epidemiologiske arbejde i dag. Stan kører Hamiltonsk Monte Carlo-sampling og ligger til grund for BYM-sygdomskortlægningsimplementeringen udgivet af Gelman og medforfattere, der håndterer store hierarkiske og rumlige modeller effektivt nok til rutinemæssigt arbejde i registerskala. JAGS, en ældre, men stadig bredt undervist motor, bruger Gibbs-sampling og er fortsat almindelig i epidemiologikurser og ældre analysekode. WinBUGS var pioner inden for tilgængelig MCMC-software til epidemiologer i 1990'erne og findes stadig lejlighedsvis i ældre publicerede metoder, selvom de fleste aktive projekter siden er migreret til Stan eller JAGS. R-pakken brms, udviklet af Paul-Christian Bürkner og demonstreret for ordinale regressionsmodeller i en artikel fra 2021 i British Journal of Mathematical and Statistical Psychology , lader forskere specificere Stan-modeller ved hjælp af velkendt R-regressionsformelsyntaks, hvilket har gjort fuld Bayesiansk hierarkisk modellering tilgængelig for epidemiologer uden baggrund i probabilistisk programmering. En sammenligning af regressionsmetoder, herunder hvor Bayesiansk justering ændrer svaret, er dækket i en relateret artikel om regressionsmodeller i medicinsk forskning.
Markov-kæden Monte Carlo og konvergenskontrol
Lukkede posteriorfordelinger findes kun for et lille sæt af simple modeller, så den mest anvendte Bayesianske epidemiologi er afhængig af Markov-kæden Monte Carlo, en familie af algoritmer, der trækker korrelerede prøver fra en Markov-kæde konstrueret til at konvergere på den posteriorfordeling, der skal anvendes. Det er standardpraksis at køre flere uafhængige kæder, normalt mindst tre eller fire, fra forskellige startværdier, da kæder, der lander på lignende svar fra forskellige udgangspunkter, giver direkte bevis for konvergens, mens uenighed mellem kæder signalerer et problem, som analytikeren skal løse, før de stoler på et rapporteret estimat. Analytikere kasserer typisk en indledende opvarmningsfase og undersøger derefter sporplot, den potentielle skalareduktionsstatistikke, undertiden kaldet R-hat, og den effektive stikprøvestørrelse for at bedømme, om kæderne udforskede posteriorfordelingen tilstrækkeligt, og om de resulterende estimater er præcise nok til at rapportere. Komplekse hierarkiske og rumlige modeller, præcis af den slags, der bruges i sygdomskortlægning, er mere tilbøjelige til langsom blanding og konvergensproblemer end simple regressionsmodeller, så konvergensdiagnostik fortjener mindst lige så meget opmærksomhed i et manuskripts metodeafsnit som selve modelspecifikationen.
Almindelige faldgruber i Bayesiansk epidemiologisk rapportering
Adoptionen har overhalet den rigorøse rapportering i dele af den bayesianske litteratur. En systematisk gennemgang fra 2026 i BMC Medical Research Methodology af Marks og kolleger undersøgte bestemmelse af stikprøvestørrelse på tværs af publicerede bayesianske randomiserede kliniske forsøg og fandt, at fuldt bayesianske metoder, på trods af deres teoretiske popularitet, sjældent anvendes korrekt i praksis, hvor mange forsøg låner bayesiansk sprog til et design, der forbliver hyppigt nedenunder. Tre praktiske fejl dukker gentagne gange op i indsendte manuskripter. Følsomhedsanalyse på tværs af alternative, rimelige priors rapporteres ofte ikke, hvilket efterlader læserne ude af stand til at bedømme, hvor meget den valgte prior faktisk drev konklusionen. Konvergensdiagnostik for MCMC-kæder udelades ofte helt, selvom en dårligt blandet kæde kan producere en selvsikker, men forkert posterior. Vage, uinformative priors bliver nogle gange omdøbt til "objektive" uden at anerkende, at en ægte flad prior stadig kan forme resultater meningsfuldt i små stikprøvemiljøer, hvilket er præcis de miljøer, hvor forskere i første omgang griber til bayesianske metoder. En statistisk anmelder i et tidsskrift vil se efter alle tre, før en Bayesiansk analyse accepteres, og manuskripter, der behandler dem på forhånd, går gennem fagfællebedømmelse med langt færre større revisionsanmodninger.
Hvordan Editverse-statistikere støtter Bayesianske epidemiologiske projekter
Specifikation af en passende prior, opbygning af en hierarkisk eller rumlig model, der matcher en undersøgelses faktiske datastruktur, og diagnosticering af MCMC-konvergensproblemer kræver alle praktisk Bayesiansk modelleringserfaring, som mange manuskripter gennemgår peer review uden. Editverses biostatistikteam arbejder direkte med epidemiologiske forskere om prior-specifikation, Stan- og brms-modelkode, konvergensdiagnostik og metodesektionens sprog, der tilfredsstiller statistiske anmeldere i tidsskrifter, der i stigende grad forventer Bayesiansk stringens snarere end lånte frekventistiske vaner. Editverses manuskript- og statistiske analysetjenester dækker dette arbejde fra den indledende modelspecifikation til det endelige indsendte manuskript, og den gratis statistiske testvælger er et nyttigt udgangspunkt for at bekræfte, om en Bayesiansk tilgang eller en konventionel frekventistisk test passer bedre til et givet datasæt, før man forpligter sig til en af dem.

Relateret læsning om Bayesianske og epidemiologiske metoder
- Bayesiansk statistik som drivkraft for medicinsk forskning til at begynde med for en mere blid første gennemgang af de samme kerneideer.
- Bayesiansk analyse i praksis: Casestudier fra adaptive kliniske forsøg for hvordan disse samme værktøjer ændrer forsøgsdesign snarere end overvågning.
- Kausal inferens' indvirkning på epidemiologi og folkesundhed for hvordan Bayesianske og kausale rammer krydser hinanden.
- Avancerede modeller til data om infektionssygdomme for ikke-lineære og kompartmentelle modeller, der ofte parres med Bayesiansk estimering.
- Effektanalyse gjort nemt for hvordan stikprøvestørrelsesplanlægning adskiller sig mellem frekventistiske og bayesianske designs.
- Kaplan-Meier overlevelsesanalyse for den frekventistiske modstykke til Bayesiansk overlevelsesmodellering i onkologiske data.
Ofte stillede spørgsmål
Hvad er den væsentligste praktiske forskel mellem Bayesiansk og frekventistisk epidemiologi?
En frekventistisk analyse producerer et punktestimat, en p-værdi og et konfidensinterval, der udelukkende er bygget ud fra den aktuelle undersøgelses data. En Bayesiansk analyse kombinerer disse data med en tidligere fordeling, der repræsenterer eksisterende viden, og rapporterer derefter en fuld posterior fordeling og et troværdigt interval, der kan fortolkes direkte som en sandsynlighedserklæring om selve parameteren.
Hvornår gør en Bayesiansk tilgang den største forskel inden for epidemiologi?
Små eller sjældne sygdomskortlægninger, sygdomskortlægning i små områder på tværs af mange geografiske enheder og hierarkiske data med klinikker eller distrikter indlejret i større regioner er de omgivelser, hvor Bayesianske hierarkiske modeller klarer sig tydeligst bedre end konventionelle tilgange med fast effekt, hovedsageligt på grund af den delvise pooling, de anvender på tværs af relaterede grupper.
Er et 95 procents troværdighedsinterval det samme som et 95 procents konfidensinterval?
Nej. Et troværdigt interval angiver, at der, givet dataene og den valgte prior, er en 95 procents posterior sandsynlighed for, at den sande parameter ligger inden for intervallet. Et konfidensinterval garanterer kun, at 95 procent af intervaller, der er bygget på samme måde på tværs af gentagne undersøgelser, ville indeholde den sande værdi, hvilket er en udtalelse om den langsigtede procedure snarere end det specifikke beregnede interval.
Hvilken software bruger epidemiologer til at køre Bayesianske modeller?
Stan og R-pakken brms håndterer det meste af det nuværende arbejde, JAGS er stadig almindeligt i undervisning og ældre kode, og WinBUGS var pioner inden for feltet i 1990'erne, men er for det meste blevet erstattet af hurtigere og mere fleksible værktøjer som Stan.
Kræver en Bayesiansk analyse en stor mængde forudgående data for at være brugbar?
Nej. Et studie kan bruge en bevidst svag, minimalt informativ prior og lade de observerede data dominere posteriorfordelingen, hvilket er almindelig praksis, når der ikke findes stærke prior-evidenser. Tilgangen giver stadig den fulde posteriorfordeling og gyldige, troværdige intervaller, selv under en svag prior.
Hvordan evaluerer anmeldere en Bayesiansk analyse i et indsendt manuskript?
Statistiske anmeldere kontrollerer typisk, at den valgte prior er berettiget, og at dens indflydelse testes gennem følsomhedsanalyse, at MCMC-konvergensdiagnostik såsom R-hat og effektiv stikprøvestørrelse rapporteres, og at artiklen fortolker troværdige intervaller korrekt i stedet for at beskrive dem med frekventistisk sprog lånt fra konfidensintervaller.