
การตีพิมพ์
การคำนวณกำลังการทดสอบแบบสุ่มเมนเดล ( Mendelian randomization power calculation)เป็นขั้นตอนเดียวในกระบวนการทั้งหมดที่ไม่เสียค่าใช้จ่ายใดๆ และมักถูกข้ามไปอยู่ดี Rosas-Chavez และ Merriman ได้ตรวจสอบงานวิจัย MR สองกลุ่มตัวอย่าง 86 ชิ้นเกี่ยวกับภาวะกรดยูริกในเลือดสูงและโรคเกาต์ที่ตีพิมพ์ระหว่างปี 2016 ถึง 2024 และพบว่า 59 เปอร์เซ็นต์กล่าวถึงกำลังการทดสอบ ซึ่งหมายความว่า 41 เปอร์เซ็นต์รายงานค่าประมาณเชิงสาเหตุ ไม่ว่าจะเป็นบวกหรือศูนย์ โดยไม่มีการระบุว่างานวิจัยนั้นสามารถตรวจพบผลที่ต้องการได้หรือไม่ (Gout, Urate, and Crystal Deposition Disease 2025;3(2):8, doi:10.3390/gucdd3020008 ) ผลลัพธ์ที่เป็นศูนย์จากการออกแบบที่มีกำลังการทดสอบต่ำ และผลลัพธ์ที่เป็นศูนย์จากผลกระทบที่ไม่มีอยู่จริงนั้นดูเหมือนกันบนหน้ากระดาษ มีเพียงการคำนวณกำลังการทดสอบเท่านั้นที่จะบอกผู้อ่านได้ว่ากำลังอ่านผลลัพธ์แบบใดอยู่
บทความนี้เป็นการจำลองครั้งที่สามในชุดการสุ่มแบบเมนเดลของเรา และเป็นการปิดวงจรที่สองบทความแรกได้เปิดไว้ บทความของเราเกี่ยวกับสิ่งที่สถิติ F บอกคุณจริงๆแสดงให้เห็นว่าเครื่องมือที่อ่อนแอจะทำให้ความกว้างของช่วงความเชื่อมั่นเพิ่มขึ้น แทนที่จะเป็นค่าประมาณจุด บทความของเราเกี่ยวกับสิ่งที่ตัวประมาณค่าทั้งสี่ตัวปกป้องคุณ แสดงให้เห็นว่าพลีโอโทรปีสามารถทำให้วิธีการที่แตกต่างกันสี่วิธีเห็นพ้องต้องกันในคำตอบที่ผิดพลาดเดียวกัน บทความทั้งสองไม่ได้ตอบคำถามพื้นฐานที่ผู้ตรวจสอบถามก่อนที่การวินิจฉัยเหล่านั้นจะมีความเกี่ยวข้องด้วยซ้ำ นั่นคือ เมื่อพิจารณาจากเครื่องมือที่คุณมีและกลุ่มตัวอย่างผลลัพธ์ที่คุณมี การศึกษาของคุณจะสามารถค้นพบผลกระทบที่คุณอ้างว่ากำลังทดสอบได้หรือไม่ เราสร้างแบบจำลองกำลังการสุ่มแบบเมนเดลสองกลุ่มตัวอย่าง ตรวจสอบความถูกต้องอย่างอิสระใน Python และ R และเรียกใช้กับขนาดการศึกษาที่หลากหลายซึ่งปรากฏในวรรณกรรมที่ตีพิมพ์
ในคำง่ายๆ
ก่อนที่จะทำการศึกษาแบบสุ่มทางพันธุกรรม (Mendelian randomization) คุณสามารถคำนวณล่วงหน้าได้ว่าโอกาสที่จะตรวจพบผลกระทบที่แท้จริงนั้นมีมากน้อยเพียงใด เช่นเดียวกับการคำนวณจำนวนผู้ป่วยที่จำเป็นในการทดลองทางคลินิก คำตอบส่วนใหญ่ขึ้นอยู่กับตัวเลขสองตัว คือ จำนวนคนในชุดข้อมูลผลลัพธ์ และตัวแปรทางพันธุกรรมนั้นอธิบายถึงการสัมผัสได้มากน้อยเพียงใด งานวิจัย MR ที่ตีพิมพ์หลายฉบับใช้กลุ่มตัวอย่างแบบกรณีศึกษาและกลุ่มควบคุมที่มีขนาดไม่ใหญ่มาก และใช้ตัวแปรทางพันธุกรรมเพียงตัวเดียว ซึ่งเป็นการผสมผสานที่ทำให้พลาดผลกระทบที่แท้จริงแต่มีขนาดปานกลางมากกว่าที่จะพบ เมื่อเกิดเหตุการณ์เช่นนั้น บทความจะรายงานผลลัพธ์เป็นศูนย์ราวกับว่าการสัมผัสไม่มีผลกระทบเชิงสาเหตุ ในขณะที่ความจริงแล้วการศึกษานั้นไม่สามารถบอกได้เลยว่าจะเป็นอย่างไร
ปัจจุบันผู้รีวิวตรวจสอบอะไรบ้างจริงๆ
การสุ่มแบบเมนเดล (Mendelian randomization) ได้เปลี่ยนจากวิธีการเฉพาะทางไปเป็นรายการตรวจสอบของผู้ทบทวนงานวิจัยในช่วงประมาณหนึ่งทศวรรษ และรายการตรวจสอบนี้มีสามส่วน Skrivankova และเพื่อนร่วมงานได้จัดทำเป็นทางการในชื่อ STROBE-MR statement ซึ่งเป็นส่วนขยาย 20 ข้อของ STROBE ที่สร้างขึ้นโดยเฉพาะสำหรับการศึกษาตัวแปรเครื่องมือทางพันธุกรรม และตีพิมพ์ร่วมกันใน BMJ และ JAMA (JAMA 2021;326(16):1614-1621, doi:10.1001/jama.2021.18236 ) ข้อ 7 ขอให้ผู้เขียนอธิบายวิธีการประเมินสมมติฐานของตน และเอกสารอธิบายเพิ่มเติมระบุอย่างชัดเจนว่าสถิติ F เป็นเครื่องมือในการตัดสินความแข็งแกร่งของเครื่องมือ ซึ่งเป็นหัวข้อของประเด็นแรกของเรา ข้อ 4b ถามสิ่งอื่นที่แตกต่างออกไป ข้อกำหนดนี้บังคับให้ผู้เขียนรายงานขนาดของกลุ่มตัวอย่างและระบุว่าได้ทำการคำนวณกำลังการทดสอบหรือขนาดของกลุ่มตัวอย่างก่อนการวิเคราะห์หลักหรือไม่ โดยระบุว่ากำลังการทดสอบที่ดีที่สุดนั้นอ่านได้จากความกว้างของช่วงความเชื่อมั่น 95 เปอร์เซ็นต์เมื่อการศึกษาเสร็จสมบูรณ์แล้ว (BMJ 2021;375:n2233, doi:10.1136/bmj.n2233 )
การตรวจสอบโรคเกาต์และภาวะกรดยูริกในเลือดสูงเป็นเพียงการตรวจสอบเชิงปริมาณเดียวที่เราพบว่ามีการปฏิบัติตามข้อกำหนดนั้นบ่อยแค่ไหน และรูปแบบที่ได้จากการตรวจสอบทั้งสามครั้งนั้นสอดคล้องกันมากกว่าที่จะน่าเชื่อถือ ร้อยละ 66 ของการศึกษา 86 เรื่องเป็นไปตามข้อสมมติฐานเรื่องความเกี่ยวข้องของความแข็งแกร่งของเครื่องมือ ร้อยละ 51 ใช้กลุ่มตัวอย่างการสัมผัสและผลลัพธ์ที่ไม่ซ้ำซ้อนกัน ร้อยละ 59 กล่าวถึงกำลังการทดสอบ และมีเพียงร้อยละ 17 เท่านั้นที่ตรงตามข้อสมมติฐานตัวแปรเครื่องมือหลักทั้งสามข้อพร้อมกัน ร้อยละ 11 ของเอกสารหลังปี 2021 ปฏิบัติตาม STROBE-MR อย่างครบถ้วน ดังนั้น การศึกษาหนึ่งๆ อาจรายงานค่าสถิติ F ที่สูง การออกแบบตัวอย่างเดี่ยวที่ชัดเจน แต่ยังคงไม่เปิดเผยว่ามีโอกาสที่จะตรวจพบผลกระทบที่กล่าวถึงในบทคัดย่อหรือไม่
สูตรเบื้องหลังการคำนวณกำลังของการสุ่มแบบเมนเดล
Brion, Shakhbazov และ Visscher ได้วางกรอบแนวคิดที่วงการนี้ยังคงใช้กันอยู่ โดยอาศัยทฤษฎีเชิงอะซิมโทติกสำหรับตัวแปรต้นที่มีการเปลี่ยนแปลงอย่างต่อเนื่องและตัวทำนายทางพันธุกรรมเพียงตัวเดียว พวกเขาแสดงให้เห็นว่าพลังทางสถิติที่ขนาดตัวอย่างคงที่นั้นลดลงเหลือเพียงสองปริมาณ คือ สัดส่วนของความแปรปรวนในตัวแปรต้นที่ตัวแปรเครื่องมืออธิบายได้ และผลกระทบเชิงสาเหตุที่แท้จริงที่กำลังทดสอบอยู่ (International Journal of Epidemiology 2013;42(5):1497-1501, doi :10.1093/ije/dyt179 ) Burgess ได้ขยายแนวทางนี้ไปยังผลลัพธ์แบบไบนารีและทำงานกับขนาดตัวอย่างในทิศทางตรงกันข้าม จากพลังเป้าหมายกลับไปยัง N ที่การศึกษาต้องการ (International Journal of Epidemiology 2014;43(3):922-929, doi:10.1093/ije/dyu005 )
สำหรับการออกแบบตัวอย่างสองกลุ่มที่งานวิจัย MR เกือบทุกงานใช้ในปัจจุบัน ความสัมพันธ์ระหว่างการสัมผัสและผลลัพธ์ที่ประเมินจากตัวอย่าง GWAS ที่แยกจากกัน ค่าความคลาดเคลื่อนมาตรฐานของการประมาณอัตราส่วนส่วนใหญ่จะถูกกำหนดโดยตัวอย่างผลลัพธ์ เนื่องจาก GWAS ของการสัมผัสที่อยู่เบื้องหลังลักษณะที่ได้รับการศึกษามาอย่างดีมักจะมีขนาดใหญ่กว่ามาก และการประมาณค่าในขั้นตอนแรกจึงมีความแม่นยำมากกว่า สำหรับตัวแปรการสัมผัสและผลลัพธ์ที่เป็นมาตรฐาน ค่าความคลาดเคลื่อนมาตรฐานโดยประมาณของการประมาณค่าเชิงสาเหตุจะแปรผันตามหนึ่งหารด้วยรากที่สองของขนาดตัวอย่างผลลัพธ์คูณด้วยค่า R กำลังสองของตัวแปรเครื่องมือ ตัวแปรเครื่องมือที่อ่อนแอและตัวอย่างผลลัพธ์ขนาดเล็กจะล้มเหลวในลักษณะเดียวกัน ทั้งสองอย่างจะทำให้ผลคูณนั้นลดลง และพารามิเตอร์ความไม่เป็นศูนย์กลางที่อยู่เบื้องหลังการคำนวณกำลังคือผลกระทบที่แท้จริงคูณด้วยรากที่สองของปริมาณเดียวกันนั้น การรายงานค่าสถิติ F และการรายงานกำลังเป็นการตอบคำถามพื้นฐานเดียวกันจากสองมุมมองที่แตกต่างกัน ซึ่งเป็นเหตุผลว่าทำไม STROBE-MR จึงขอทั้งสองอย่าง
เราทดสอบมันอย่างไร
เราสร้างสูตรคำนวณกำลังการสุ่มแบบเมนเดลในรูปแบบปิดข้างต้น และตรวจสอบกับแหล่งข้อมูลอิสระสามแหล่ง โดยใช้เกณฑ์การตรวจสอบความถูกต้องแบบเดียวกับสองขั้นตอนก่อนหน้าของเรา ขั้นแรก เราตรวจสอบการจำลองแบบเวกเตอร์ที่รวดเร็ว ซึ่งดึงค่าประมาณ SNP-exposure และ SNP-outcome ของแต่ละตัวอย่างโดยตรงจากการแจกแจงตัวอย่าง กับการจำลองแบบช้าที่สร้างจีโนไทป์ การสัมผัส และผลลัพธ์ในระดับบุคคล และเรียกใช้การถดถอยจริง บนชุดพารามิเตอร์สามชุด ทั้งสองแบบมีความสอดคล้องกันภายในข้อผิดพลาดแบบมอนเตคาร์โลที่จำนวนตัวอย่างจำลองไม่กี่ร้อยตัว ขั้นที่สอง เราเรียกใช้ตารางทั้งหมดสองครั้ง ครั้งหนึ่งใน Python ด้วย NumPy และอีกครั้งใน R อย่างอิสระ ที่ 200,000 ตัวอย่างจำลองต่อเซลล์ โดยใช้ตัวสร้างเลขสุ่มที่แตกต่างกันและไม่มีการใช้โค้ดร่วมกัน ขั้นที่สาม เราเปรียบเทียบเครื่องมือจำลองทั้งสองกับสูตรในรูปแบบปิด ค่าความคลาดเคลื่อนมาตรฐานของวิธีเดลต้าสำหรับอัตราส่วนวอลด์สองตัวอย่าง ซึ่งส่งต่อความไม่แน่นอนจากทั้งการประมาณค่าการสัมผัส SNP และผลลัพธ์ SNP แทนที่จะถือว่าเครื่องมือเป็นที่ทราบอย่างแม่นยำ เป็นไปตามกรอบข้อมูลสรุปของ Burgess, Butterworth และ Thompson (Genetic Epidemiology 2013;37(7):658-665, doi:10.1002/gepi.21758 )
เซลล์ทุกเซลล์ในการทดลองทั้งสองด้านล่างนี้ให้ผลลัพธ์ที่สอดคล้องกันในการตรวจสอบทั้งสามครั้ง โดยมีความคลาดเคลื่อนเพียงหนึ่งหรือสองเปอร์เซ็นต์จากค่ากำลังจำลอง ซึ่งที่จำนวนการจำลอง 200,000 ครั้งนั้นแม่นยำกว่าค่าความคลาดเคลื่อนพื้นฐานของ Monte Carlo สามารถขอรับสคริปต์และผลลัพธ์ได้หากต้องการ ความสอดคล้องนี้ครอบคลุมช่วงพารามิเตอร์ที่สำคัญสำหรับการออกแบบการศึกษาจริง ดังนั้นแบบฟอร์มปิดจึงน่าเชื่อถือในส่วนนั้น และส่วนที่เหลือของโพสต์นี้รายงานค่าจำลอง ซึ่งไม่ได้ตั้งสมมติฐานแบบง่ายๆ เกี่ยวกับเครื่องมือที่ทราบอย่างสมบูรณ์แบบ
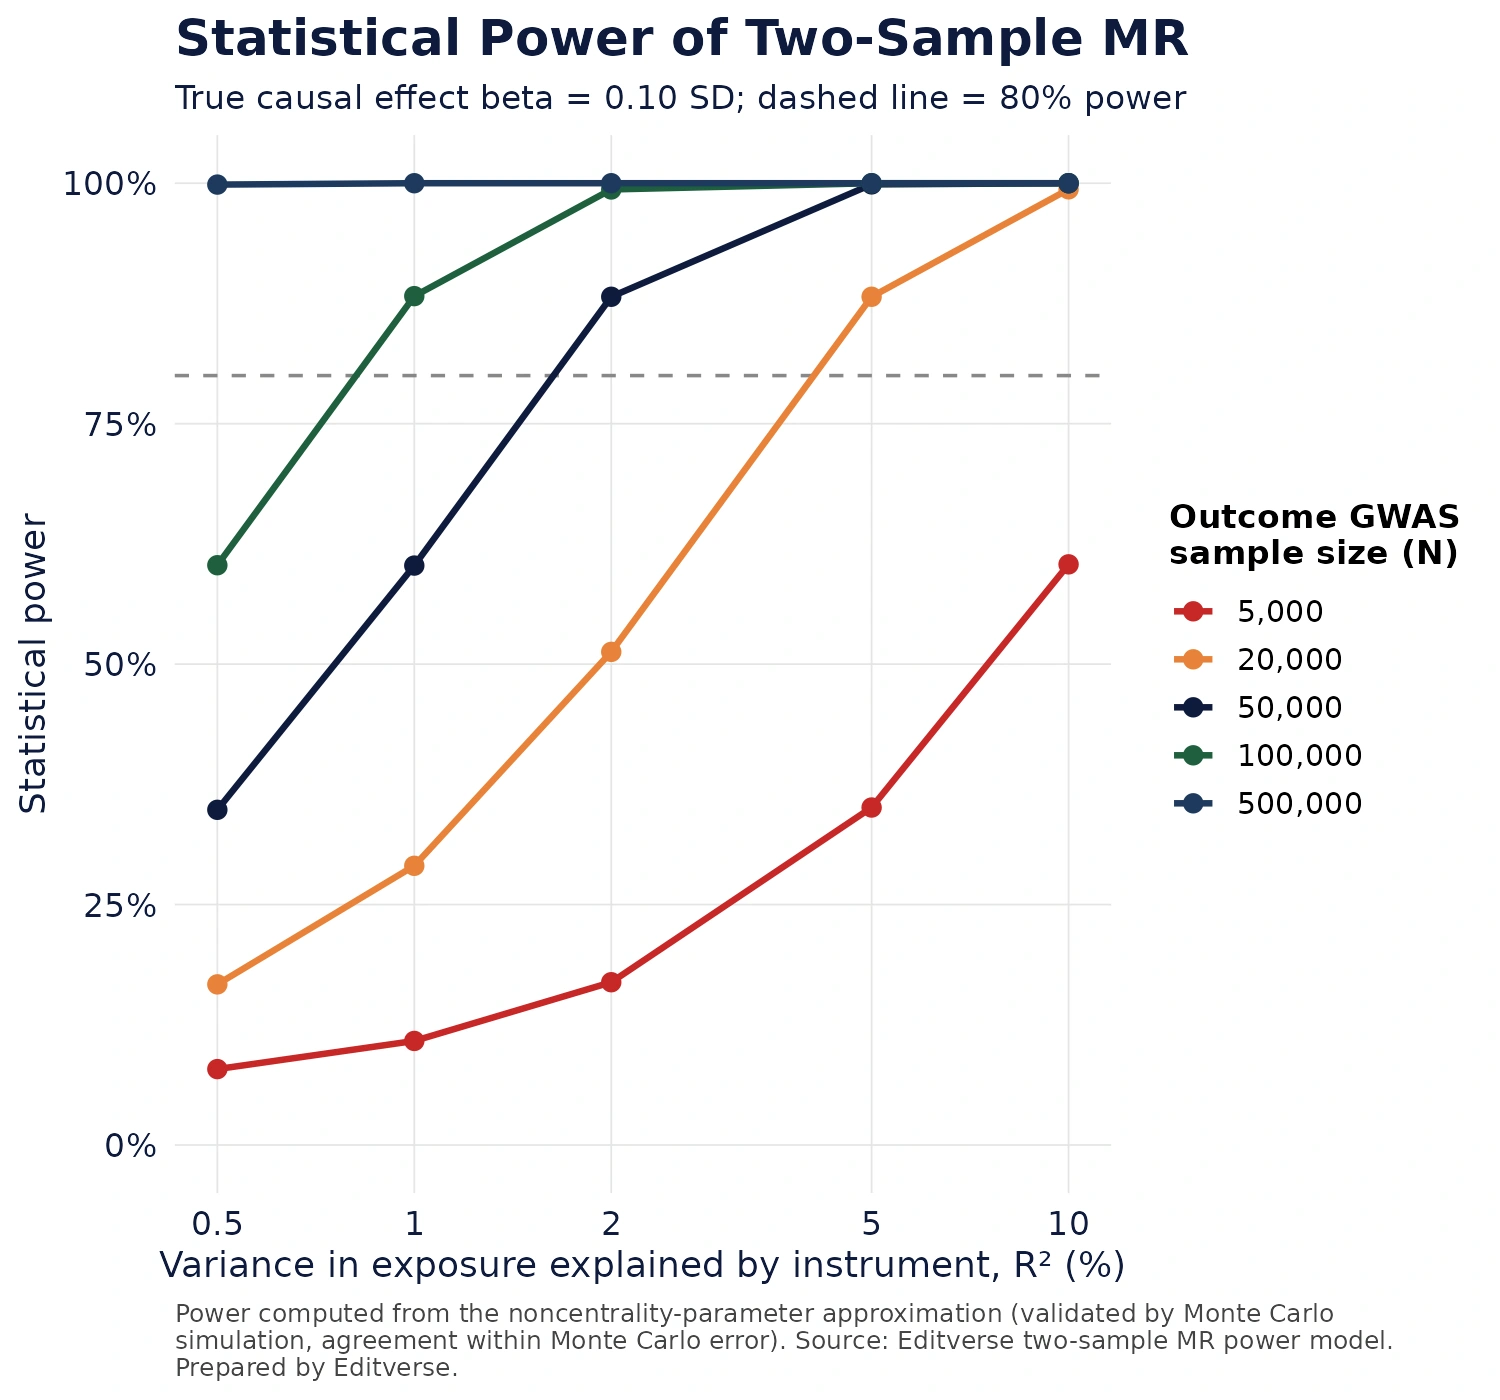
การพิจารณาจากพื้นผิวจะยืนยันรูปร่างของสูตรมากกว่าสิ่งใดที่น่าประหลาดใจเมื่อพิจารณาแยกต่างหาก และนั่นคือจุดประสงค์ของการตรวจสอบความถูกต้อง ในกลุ่มตัวอย่างผลลัพธ์ 500,000 ซึ่งเป็นช่วงการศึกษาที่การวิเคราะห์ไบโอแบงก์ขนาดใหญ่ส่วนใหญ่ใช้ในปัจจุบัน กำลังการทดสอบจะสูงกว่า 99 เปอร์เซ็นต์ แม้แต่ที่ความแรงของเครื่องมือที่น้อยที่สุดในตาราง ในกลุ่มตัวอย่างผลลัพธ์ 5,000 ซึ่งเป็นขนาดที่ยังคงพบได้ทั่วไปในการศึกษาแบบกรณีควบคุมของผลลัพธ์ที่พบได้น้อย กำลังการทดสอบไม่ถึง 80 เปอร์เซ็นต์ในแกน R squared ที่เราทดสอบ โดยสูงสุดที่ 60 เปอร์เซ็นต์ แม้ว่าเครื่องมือเดียวจะอธิบายความแปรปรวนของการสัมผัสได้ถึง 10 เปอร์เซ็นต์ก็ตาม ระหว่างสองขั้วนี้ แกนทั้งสองจะแลกเปลี่ยนกันโดยตรง กลุ่มตัวอย่างผลลัพธ์ 20,000 ต้องการเครื่องมือที่อธิบายความแปรปรวนของการสัมผัสได้ประมาณ 4 ถึง 5 เปอร์เซ็นต์ เพื่อให้ได้กำลังการทดสอบตามปกติ ซึ่งเป็นเกณฑ์ที่เครื่องมือ SNP เดี่ยวเพียงไม่กี่ตัวเท่านั้นที่ผ่านได้ และโดยปกติแล้วต้องรวมตัวแปรที่มีนัยสำคัญทั่วทั้งจีโนมหลายตัวเข้าเป็นคะแนนพหุพันธุกรรม
หกแบบ แต่ให้ผลลัพธ์ขนาดเดียวกัน
การตรวจสอบแบบจำลองโดยใช้ตารางพารามิเตอร์เชิงนามธรรม สิ่งที่ผู้ตรวจสอบต้องการทราบคือ การออกแบบที่ดูธรรมดาในต้นฉบับที่ส่งมานั้น เคยสามารถค้นพบสิ่งที่อ้างว่าค้นพบได้หรือไม่ เราสร้างการออกแบบการศึกษาหกแบบ ครอบคลุมช่วงที่ตีพิมพ์ของ MR สองกลุ่มตัวอย่าง ผลลัพธ์แบบกรณีควบคุมขนาดเล็กที่มี SNP หลักเพียงตัวเดียว ผลลัพธ์แบบกลุ่มขนาดกลางที่มี SNP ตัวเดียวหรือคะแนน SNP หลายตัวแบบรวม และผลลัพธ์จากธนาคารชีวภาพขนาดใหญ่ ครอบคลุมความแข็งแกร่งของเครื่องมือสามระดับ จากนั้นคำนวณกำลังสำหรับแต่ละแบบที่ขนาดผลกระทบที่แท้จริงสามขนาด ได้แก่ 0.05 SD เล็กน้อย 0.10 SD ปานกลาง และ 0.20 SD มาก
| ออกแบบ | ผลลัพธ์ N / R² | กำลังไฟฟ้าที่เบต้า=0.05 | กำลังไฟฟ้าที่เบต้า=0.10 | กำลังไฟฟ้าที่เบต้า=0.20 |
|---|---|---|---|---|
| การศึกษาแบบกรณีควบคุมขนาดเล็ก โดยใช้ SNP ตัวนำเดี่ยว | 4,000 / 0.5% | 5.5% | 7.3% | 14.1% |
| กลุ่มกลาง, SNP ตัวนำเดี่ยว | 25,000 / 0.8% | 10.7% | 29.3% | 79.1% |
| เครื่องมือวัดหลาย SNP ในช่วงกลางกลุ่มตัวอย่าง | 25,000 / 2% | 19.9% | 60.4% | 99.2% |
| ธนาคารชีวภาพขนาดใหญ่, SNP ตัวนำเดี่ยว | 400,000 / 0.5% | 60.8% | 99.4% | 100% |
| ธนาคารชีวภาพขนาดใหญ่ เครื่องมือวิเคราะห์ SNP หลายตัว | 400,000 / 3% | 99.98% | 100% | 100% |
| ธนาคารชีวภาพขนาดใหญ่ การเปิดเผยข้อมูลที่มีประสิทธิภาพ | 400,000 / 8% | 100% | 100% | 100% |
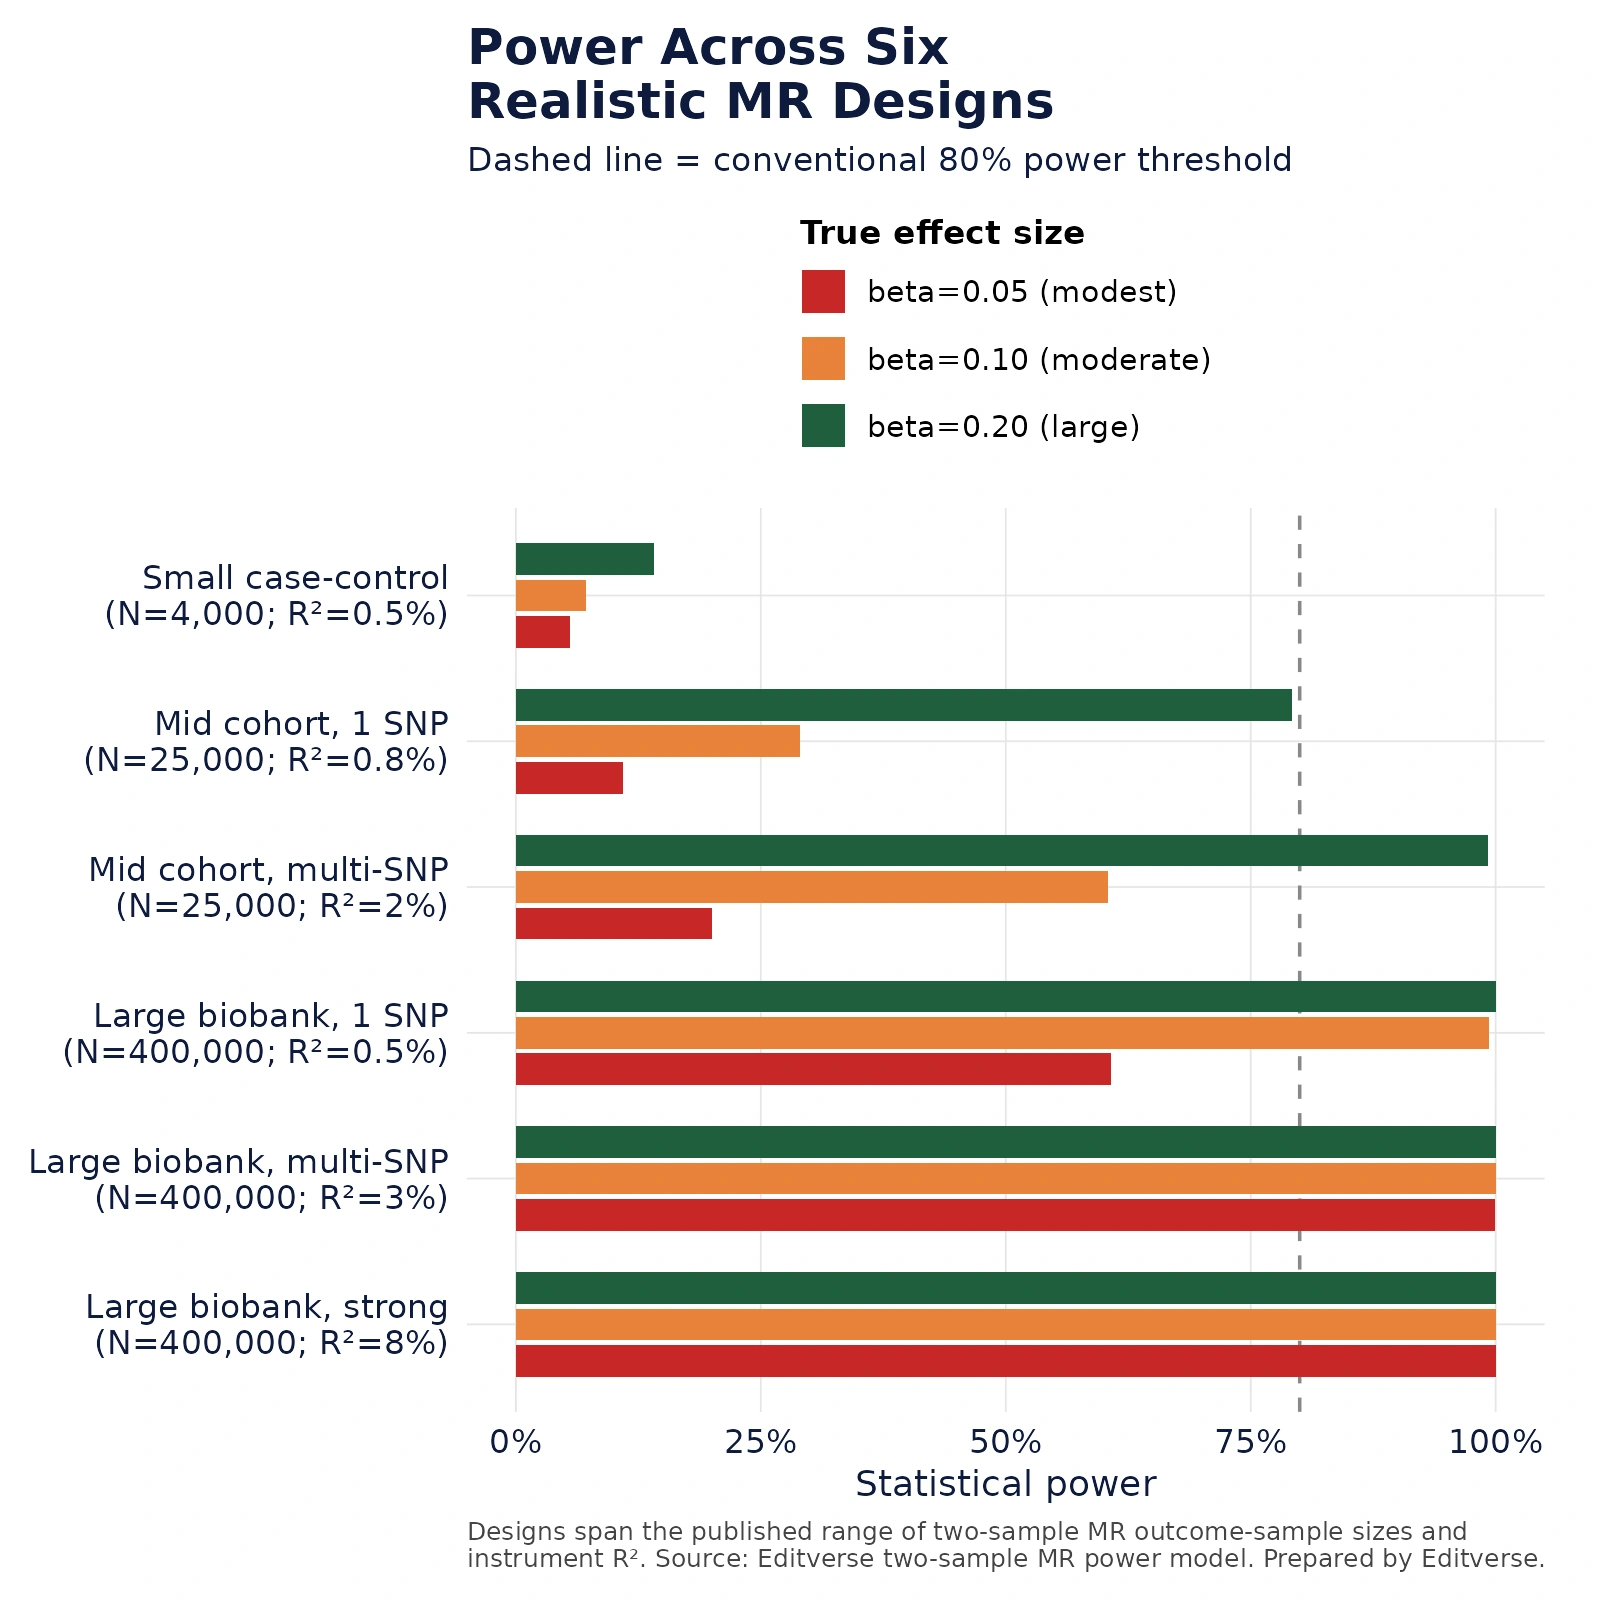
จากการออกแบบทั้งหกแบบ มีสองแบบที่ไม่สามารถบรรลุระดับกำลังการทดสอบมาตรฐานสำหรับผลกระทบขนาดปานกลาง และแบบที่สามก็ทำได้เพียงเล็กน้อย ผลลัพธ์จากการศึกษาแบบกรณีควบคุมขนาดเล็กยังคงมีกำลังการทดสอบต่ำกว่า 15 เปอร์เซ็นต์ แม้จะมีผลกระทบขนาดใหญ่ถึง 0.20 SD ซึ่งหมายความว่าผลลัพธ์ที่เป็นศูนย์จากการออกแบบนั้นแทบจะไม่มีประโยชน์ ไม่ว่าความสัมพันธ์เชิงสาเหตุที่แท้จริงจะเป็นอย่างไรก็ตาม กลุ่มตัวอย่างขนาดกลางที่มี SNP หลักเพียงตัวเดียวจำเป็นต้องมีผลกระทบขนาดใหญ่ก่อนที่กำลังการทดสอบจะเกิน 80 เปอร์เซ็นต์ และการสัมผัสส่วนใหญ่ที่น่าสนใจในเชิงประยุกต์ เช่น การเปลี่ยนแปลงเล็กน้อยในตัวบ่งชี้ทางชีวภาพหรือตัวบ่งชี้การอักเสบ ไม่คาดว่าจะทำให้ผลลัพธ์เปลี่ยนแปลงไปมากนัก มีเพียงการออกแบบธนาคารชีวภาพขนาดใหญ่สองแบบที่มีเครื่องมือหลาย SNP แบบรวมเท่านั้นที่มีกำลังการทดสอบเกิน 80 เปอร์เซ็นต์ แม้แต่ในขนาดผลกระทบที่เล็กที่สุดที่ทดสอบ ซึ่งเป็นชุดค่าผสมที่กลายเป็นมาตรฐานในพื้นที่โรคที่มีทรัพยากรการศึกษาความสัมพันธ์ทั่วทั้งจีโนมจำนวนมหาศาล เช่น ไขมัน ความดันโลหิต และดัชนีมวลกาย และพบได้น้อยกว่ามากในการสัมผัสที่ได้รับการศึกษาน้อยกว่า
เหตุใดผลลัพธ์ที่เป็นศูนย์ซึ่งมีประสิทธิภาพต่ำจึงยังถูกตีพิมพ์ว่าเป็นผลการค้นพบที่แท้จริง
ในวิธีการสุ่มแบบเมนเดล (Mendelian randomization) การไม่มีหลักฐานถูกมองว่าเป็นหลักฐานของการไม่มีอยู่จริงบ่อยกว่าที่วิธีการนี้อนุญาต เนื่องจากค่าประมาณอัตราส่วนไม่ได้ดูไม่แน่นอนน้อยลงอย่างเห็นได้ชัดเมื่อได้มาจากงานวิจัยที่มีกำลังการทดสอบต่ำกว่าเมื่อเทียบกับงานวิจัยที่มีกำลังการทดสอบสูงกว่า อัตราส่วนความเสี่ยงเฉพาะสาเหตุจากกลุ่มตัวอย่างขนาดเล็กอย่างน้อยก็มีช่วงความเชื่อมั่นที่กว้างพอที่จะให้ผู้อ่านประเมินได้ ค่าประมาณ MR ที่เป็นศูนย์พร้อมช่วงความเชื่อมั่นปานกลางดูเหมือนคำตอบที่ชัดเจนแม้ว่างานวิจัยนั้นจะไม่มีโอกาสที่สมจริงในการปฏิเสธสมมติฐานว่างสำหรับขนาดผลกระทบที่จะมีความสำคัญทางคลินิกก็ตาม
นี่คือกลไกเบื้องหลังงานวิจัย 41 เปอร์เซ็นต์ในการตรวจสอบของ Rosas-Chavez และ Merriman ที่ไม่ได้กล่าวถึงเรื่องกำลังการทดสอบเลย เมื่อบทความวิจัยรายงานค่าประมาณจุดใกล้ศูนย์และช่วงความเชื่อมั่นที่ตัดผ่านค่าดังกล่าว บทความนั้นจะถือว่าสมบูรณ์โดยไม่ต้องกล่าวถึงกำลังการทดสอบ และทั้งผู้เขียนและผู้ตรวจสอบส่วนใหญ่ก็ไม่ได้ถามคำถามต่อไปว่า งานวิจัยนั้นถูกออกแบบมาเพื่อให้เห็นผลกระทบที่มีขนาดที่มีความสำคัญทางชีววิทยาหรือทางคลินิกหรือไม่ ข้อกำหนด STROBE-MR ข้อ 4b มีอยู่เพื่อแก้ไขช่องว่างนี้โดยเฉพาะ โดยขอให้ผู้เขียนระบุตั้งแต่ต้นว่าได้ทำการคำนวณกำลังการทดสอบหรือไม่ และเอกสารอธิบายก็ระบุอย่างตรงไปตรงมาว่า ความกว้างของช่วงความเชื่อมั่นหลังจากนั้นเป็นตัวบ่งชี้ที่ซื่อสัตย์ที่สุดว่างานวิจัยนั้นสามารถสนับสนุนผลลัพธ์อะไรได้บ้าง
วิธีแก้ไขที่ได้ผลจริงนั้นใช้เพียงแค่หนึ่งย่อหน้าและหนึ่งตัวเลข ก่อนที่จะสั่งการหรือส่งผลการวิเคราะห์ MR ให้ทำการคำนวณกำลังการสุ่มแบบเมนเดล (Mendelian randomization power calculation) เพื่อหาผลกระทบที่ตรวจจับได้ขั้นต่ำที่กำลัง 80 เปอร์เซ็นต์ โดยพิจารณาจากค่า R squared ของตัวแปรเครื่องมือที่ทราบ และขนาดของกลุ่มตัวอย่างผลลัพธ์ที่ทราบ โดยใช้แนวทางพารามิเตอร์ที่ไม่เป็นศูนย์กลางแบบเดียวกับที่อยู่เบื้องหลังรูปที่ 1 จากนั้นระบุตัวเลขนั้นในวิธีการควบคู่ไปกับค่าสถิติ F ผลลัพธ์ที่เป็นศูนย์ที่รายงานควบคู่ไปกับผลกระทบที่ตรวจจับได้ขั้นต่ำที่ 0.03 SD นั้นเป็นผลลัพธ์ที่แท้จริง ผลลัพธ์ที่เป็นศูนย์ที่รายงานควบคู่ไปกับผลกระทบที่ตรวจจับได้ขั้นต่ำที่ 0.25 SD ควบคู่ไปกับเอกสารทางวิชาการที่ชี้ให้เห็นว่าผลกระทบที่แท้จริงหากมีอยู่จริงนั้นใกล้เคียงกับ 0.10 SD นั้นเป็นข้อจำกัดของการออกแบบที่ถูกนำเสนอในรูปแบบของข้อสรุป
ความตึงเครียดกับซี่ล้ออีกสองซี่
การเพิ่มประสิทธิภาพโดยการเพิ่มตัวแปรทางพันธุกรรมเข้าไปในเครื่องมือเป็นการตอบสนองที่ชัดเจนต่อค่า R squared ที่ต่ำ และมันจะไปมีปฏิสัมพันธ์กับโหมดความล้มเหลวอีกสองแบบในชุดนี้ แทนที่จะหลีกเลี่ยงมัน SNP ที่เพิ่มเข้ามาแต่ละตัวที่รวมอยู่ในคะแนนจะเพิ่มค่า R squared และประสิทธิภาพ ซึ่งเป็นสิ่งที่ดีสำหรับข้อกังวลในโพสต์นี้ แต่ตัวแปรที่เพิ่มเข้ามาแต่ละตัวก็เป็นโอกาสเพิ่มเติมสำหรับภาวะพลีโอโทรปีในแนวนอน ซึ่งเป็นโหมดความล้มเหลวที่เราได้วิเคราะห์ไว้ในส่วนที่สอง โดยที่เส้นทางต้นน้ำที่ใช้ร่วมกันสามารถทำให้ตัวประมาณค่าทั่วไปทั้งสี่ตัวเคลื่อนไปสู่คำตอบที่ผิดเหมือนกัน ในขณะที่ดูเหมือนว่ามีความสอดคล้องกัน เครื่องมือขนาดใหญ่และทรงพลังไม่ได้หมายความว่าจะเป็นเครื่องมือที่ถูกต้องเสมอไป และการวินิจฉัยภาวะพลีโอโทรปีจากโพสต์นั้นไม่ได้มีความจำเป็นน้อยลงเมื่อเครื่องมือมีขนาดใหญ่ขึ้น
อคติจากเครื่องมือที่อ่อนแอมีความสัมพันธ์กับกำลังการทดสอบในทิศทางตรงกันข้าม งานวิจัยชิ้นแรกของเราพบว่า ค่าสถิติ F ในขั้นตอนแรกที่ต่ำจะทำให้ช่วงความเชื่อมั่นกว้างขึ้นโดยไม่เปลี่ยนแปลงค่าประมาณจุดมัธยฐานในกรณีที่ระบุได้ ซึ่งฟังดูเหมือนว่าจะให้ผลลัพธ์เป็นค่าว่างที่แท้จริงมากกว่าผลบวกเท็จ เมื่อรวมกับผลการค้นพบในที่นี้ ผลลัพธ์ที่เป็นค่าว่างที่แท้จริงจากเครื่องมือที่อ่อนแอ มักจะเป็นค่าว่างที่มีกำลังการทดสอบต่ำด้วย ซึ่งหมายความว่าข้อบกพร่องในการออกแบบเดียวกันที่ทำให้ช่วงความเชื่อมั่นกว้างขึ้น ยังลดโอกาสในการตรวจพบผลกระทบที่แท้จริงอีกด้วย งานวิจัยอาจรายงานช่วงความเชื่อมั่นที่กว้าง มีจุดศูนย์กลางที่ถูกต้อง และไม่มีนัยสำคัญทางสถิติ จากเครื่องมือ SNP เดี่ยวที่อ่อนแอ และในขณะเดียวกันก็ไม่มีอคติทางเทคนิค แต่ในทางปฏิบัติไม่สามารถตอบคำถามวิจัยของตนเองได้ นี่เป็นครั้งที่สามในชุดนี้ที่วิธีการซึ่งทำงานตรงตามที่ทฤษฎีทางสถิติคาดการณ์ไว้ ยังคงสร้างงานวิจัยที่ทำให้เข้าใจผิด เพราะทฤษฎีอธิบายสิ่งที่ตัวประมาณค่าทำ และไม่ได้กล่าวถึงว่าการออกแบบให้ข้อมูลเพียงพอที่จะใช้หรือไม่
เครื่องมือวิจัยฟรีจาก Editverse
- กราฟโปรสร้างแผนภูมิพร้อมเผยแพร่ได้ 25 แบบ พร้อมฟังก์ชันคำนวณค่า p-value ของ t-test, ANOVA, ความสัมพันธ์ และไคสแควร์ ในตัว ฟรี ไม่ต้องลงทะเบียน
- สแตทโปร: เครื่องมือคำนวณทางสถิติฟรี และเครื่องมือเลือกแบบทดสอบที่ครอบคลุมการเปรียบเทียบกลุ่ม ผลลัพธ์เชิงหมวดหมู่ การวิเคราะห์ระยะเวลาจนถึงเหตุการณ์ และความแม่นยำในการวินิจฉัย
- โฟลว์ชาร์ท โปร: สร้างแผนผังกระบวนการทำงาน PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE และ ARRIVE ได้โดยตรงในเบราว์เซอร์ของคุณ
การสนับสนุนทางวิชาชีพสำหรับการศึกษาแบบสุ่มทางพันธุกรรม (Mendelian Randomization Study)
การคำนวณกำลังการทดสอบควรทำในขั้นตอนการออกแบบ ไม่ใช่ขั้นตอนการตอบคำถามจากผู้ตรวจสอบ เพราะการศึกษาที่ปรากฏว่ามีกำลังการทดสอบไม่เพียงพอหลังจากได้รับข้อมูลแล้ว ไม่สามารถแก้ไขได้ด้วยการเขียนส่วนการอภิปรายที่ดีขึ้น นักสถิติชีวภาพของเราจะทำการคำนวณความแข็งแกร่งของเครื่องมือและกำลังการทดสอบก่อนเริ่มการวิเคราะห์ใดๆ รายงานผลกระทบขั้นต่ำที่ตรวจจับได้ควบคู่ไปกับผลลัพธ์ที่เป็นศูนย์ทุกครั้ง และตรวจสอบเครื่องมือกับการวินิจฉัยภาวะพหุผลจากตัวประมาณค่ามากกว่าหนึ่งตัว โดยปฏิบัติตามรายการตรวจสอบ STROBE-MR ทีละรายการ แทนที่จะปรับเปลี่ยนภายหลังจากการร้องขอของผู้ตรวจสอบ
การตรวจสอบความเป็นไปได้
$450
ตรวจสอบว่ามีเครื่องมือที่ใช้ได้สำหรับการศึกษาของคุณหรือไม่ ค่า R squared ที่น่าจะเป็นไปได้เมื่อเทียบกับแหล่งข้อมูล GWAS สาธารณะ และผลกระทบขั้นต่ำที่ตรวจจับได้ที่ขนาดตัวอย่างผลลัพธ์ที่มีอยู่ ก่อนที่คุณจะตัดสินใจทำการศึกษาอย่างเต็มรูปแบบ เครดิตเต็มจำนวนสำหรับการศึกษาใดๆ ที่คุณว่าจ้างในภายหลัง 5 วันทำการ
การศึกษา MR สองกลุ่มตัวอย่าง
$2,900
การวิเคราะห์เชิงสาเหตุแบบเต็มรูปแบบพร้อมสถิติ F, กำลังการทดสอบ และผลกระทบขั้นต่ำที่ตรวจจับได้ รายงานควบคู่ไปกับการประมาณค่า ตรวจสอบภาวะพลีโอโทรปีโดยใช้ IVW, MR-Egger, ค่ามัธยฐานถ่วงน้ำหนัก และค่าฐานนิยมถ่วงน้ำหนัก ปรับใช้ MR-PRESSO และการกรอง Steiger รวมถึงต้นฉบับ รูปภาพ และรายการตรวจสอบ STROBE-MR ที่เสร็จสมบูรณ์ สถิติสรุป GWAS สาธารณะ เราจัดหาให้ ใช้เวลา 15 วันทำการ
การออกแบบเพิ่มเติม
เริ่มต้นที่ $ 3,500
การวิเคราะห์ MR แบบหลายตัวแปรครอบคลุมการสัมผัสที่สัมพันธ์กัน การออกแบบแบบสองทิศทางและการกรองแบบ Steiger เครื่องมือ PheWAS เทียบกับเส้นทางพหุผลที่เป็นไปได้ และการคำนวณกำลังร่วมกันระหว่างการสัมผัสสองรายการขึ้นไปที่วิเคราะห์ร่วมกัน เสนอราคาคงที่และขอบเขตงานเป็นลายลักษณ์อักษรก่อนเริ่มงานใดๆ
หัวข้อหลักของชุดบทความนี้คือ " การสุ่มแบบเมนเดลอธิบายอย่างละเอียด " ซึ่งครอบคลุมวิธีการทั้งหมดตั้งแต่การเลือกตัวแปรเครื่องมือไปจนถึงการรายงานผล และบทวิเคราะห์วิธีการใช้ตัวแปรเครื่องมือจะอธิบายกลไกทางสถิติที่ใช้ในการคำนวณกำลังการทดสอบ หากคุณยังลังเลอยู่ว่าการสุ่มแบบเมนเดลเหมาะสมกับคำถามของคุณหรือไม่ ฐานข้อมูลสุขภาพที่คุณควรใช้ในการศึกษาของคุณจะเปรียบเทียบกับแบบแผนการวิจัยจากทะเบียนและแบบสำรวจ และคู่มือระดับหลักฐานในการวิจัยทางคลินิก ของเรา จะอธิบายว่าแบบแผนการวิจัยเชิงสาเหตุที่มีกำลังการทดสอบสูงเช่นนี้อยู่ในระดับใดเมื่อเทียบกับหลักฐานจากการทดลอง
สรุป
การคำนวณกำลังการทดสอบแบบสุ่มเมนเดลไม่ใช่ขั้นตอนที่ทำหลังจากวิเคราะห์เสร็จแล้ว แต่เป็นการตรวจสอบว่าข้อสรุปหลักของงานวิจัยนั้น ไม่ว่าจะเป็นผลบวกหรือผลลบ เป็นผลจากปัจจัยเสี่ยงหรือผลจากขนาดตัวอย่างของงานวิจัยเอง แบบจำลองที่ได้รับการตรวจสอบแล้วของเราได้กำหนดค่าตัวเลขให้กับสองปริมาณที่ตัดสินผลการทดสอบ ได้แก่ ขนาดตัวอย่างของผลลัพธ์และค่า R กำลังสองของตัวแปรเครื่องมือ และการออกแบบงานวิจัยที่สมจริงทั้งหกแบบที่เราทดสอบแสดงให้เห็นว่า รูปแบบงานวิจัยจำนวนมากที่ยังคงพบได้ทั่วไปในงานวิจัย เช่น ผลลัพธ์ของกลุ่มตัวอย่างขนาดเล็กที่จับคู่กับตัวแปรหลักเพียงตัวเดียว ไม่สามารถบรรลุถึงกำลังการทดสอบตามปกติสำหรับผลกระทบที่นักวิจัยส่วนใหญ่จะพิจารณาว่าคุ้มค่าที่จะรายงาน
ไม่มีส่วนใดในสามส่วนในชุดข้อมูลนี้ที่อธิบายถึงวิธีการที่ผิดพลาด สถิติ F, ตัวประมาณค่าที่ทนทานต่อภาวะพลีโอโทรปีทั้งสี่ และการคำนวณกำลังการทดสอบ ล้วนทำงานตรงตามทฤษฎีทางสถิติที่ระบุไว้ สิ่งที่พวกมันมีเหมือนกันคือ ไม่มีส่วนใดส่วนหนึ่งสามารถใช้แทนอีกสองส่วนได้ และบทความที่รายงานเพียงส่วนใดส่วนหนึ่ง เช่น สถิติ F ที่สูงกว่า 10 โดยไม่มีการระบุถึงกำลังการทดสอบ หรือสมมติฐานว่างที่ชัดเจนโดยไม่มีผลกระทบขั้นต่ำที่ตรวจจับได้ ก็ถือว่าตรงตามข้อกำหนดของรายการตรวจสอบ STROBE-MR โดยไม่ได้ตอบคำถามที่ผู้ตรวจสอบที่รอบคอบกำลังถามจริงๆ การรายงานทั้งสามส่วนนั้นใช้พื้นที่เพียงย่อหน้าสั้นๆ การละเว้นส่วนใดส่วนหนึ่งคือวิธีที่ข้อจำกัดในการออกแบบกลายเป็นข้อสรุปที่ตีพิมพ์
อ้างอิง
- Brion MJA, Shakhbazov K, Visscher PM. การคำนวณกำลังทางสถิติในการศึกษาแบบสุ่มเมนเดล Int J Epidemiol. 2013;42(5):1497-1501. ดอย: 10.1093 / ije / dyt179
- Burgess S. การคำนวณขนาดตัวอย่างและกำลังในการสุ่มแบบเมนเดลด้วยตัวแปรเครื่องมือเดี่ยวและผลลัพธ์แบบไบนารี Int J Epidemiol. 2014;43(3):922-929. doi:10.1093/ije/dyu005
- Burgess S, Butterworth A, Thompson SG. การวิเคราะห์การสุ่มแบบเมนเดลด้วยตัวแปรทางพันธุกรรมหลายตัวโดยใช้ข้อมูลสรุป Genet Epidemiol. 2013;37(7):658-665. doi:10.1002/gepi.21758
- Skrivankova VW, Richmond RC, Woolf BAR และคณะ การเสริมสร้างการรายงานการศึกษาเชิงสังเกตในระบาดวิทยาโดยใช้การสุ่มแบบเมนเดล: คำแถลง STROBE-MR JAMA. 2021;326(16):1614-1621 ดอย:10.1001/jama.2021.18236
- Skrivankova VW, Richmond RC, Woolf BAR และคณะ การเสริมสร้างการรายงานผลการศึกษาเชิงสังเกตในระบาดวิทยาโดยใช้การสุ่มแบบเมนเดล (STROBE-MR): คำอธิบายและการขยายความ BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233
- Rosas-Chavez F, Merriman TR. การศึกษาแบบสุ่มเมนเดล: ตัวชี้วัดสำหรับการประเมินคุณภาพ Gout Urate Crystal Deposition Dis. 2025;3(2):8. doi:10.3390/gucdd3020008