
การตีพิมพ์
รายการตรวจสอบ STROBE-MRเป็นมาตรฐานการรายงาน 20 รายการสำหรับการศึกษาที่ใช้ตัวแปรทางพันธุกรรมเป็นตัวแปรเครื่องมือเพื่อประเมินผลกระทบเชิงสาเหตุ Skrivankova และเพื่อนร่วมงานได้ตีพิมพ์ในปี 2021 ในรูปแบบของข้อความใน JAMA และในรูปแบบบทความอธิบายและขยายความอย่างละเอียดใน BMJ [1] [2]ผู้เขียนสนับสนุนให้วารสารต่างๆ ขอรายการตรวจสอบที่กรอกครบถ้วนเมื่อส่งต้นฉบับ คู่มือนี้จะอธิบายว่าแต่ละรายการถามอะไร แสดงตำแหน่งที่คำตอบแต่ละข้อควรอยู่ในต้นฉบับ และจากนั้นจะนำแต่ละรายการไปใช้กับการศึกษาแบบสุ่มเมนเดลแบบเปิดเผยข้อมูลจริงทีละแถว พร้อมด้วยตัวชี้ส่วนและคำตัดสินสำหรับแต่ละรายการ
ในคำง่ายๆ
STROBE-MR คือรายการข้อกำหนดการรายงาน 20 ข้อสำหรับงานวิจัยเกี่ยวกับการสุ่มแบบเมนเดล (Mendelian randomization) ข้อกำหนดนี้ขอให้ผู้เขียนระบุวิธีการเลือกตัวแปรทางพันธุกรรม ความแข็งแกร่งของตัวแปรเหล่านั้น แหล่งที่มาของชุดข้อมูลทั้งสองชุด ตัวอย่างซ้ำซ้อนกันหรือไม่ การทดสอบใดบ้างที่ใช้ตรวจสอบสมมติฐาน และสามารถค้นหาข้อมูลและโค้ดได้ที่ใด ผู้อ่านควรสามารถตัดสินงานวิจัยได้โดยไม่ต้องคาดเดา หากข้อใดไม่เกี่ยวข้อง โปรดระบุและให้เหตุผล
รายการตรวจสอบ STROBE-MR ครอบคลุมอะไรบ้าง
STROBE-MR เป็นแนวทางการสุ่มแบบเมนเดลที่เทียบเท่ากับแนวทาง STROBE สำหรับการศึกษาเชิงสังเกต ซึ่งเราได้กล่าวถึงไว้ในคู่มือ STROBE ของเรา เอกสารอธิบายจะอธิบายรายละเอียด 20 รายการพร้อมตัวอย่างที่ตีพิมพ์เกี่ยวกับการรายงานที่โปร่งใส และผู้เขียนได้จัดทำรายการตรวจสอบเป็นเอกสารที่ปรับปรุงอยู่เสมอในเว็บไซต์เฉพาะ[1]พวกเขาเขียนขึ้นเนื่องจากยังไม่มีข้อตกลงที่ชัดเจนเกี่ยวกับวิธีการรายงานการออกแบบนี้ งานวิจัยเชิงประจักษ์ที่พวกเขาอ้างถึงพบว่ารายงานจำนวนมากไม่ได้ระบุหรือตรวจสอบสมมติฐานการสุ่มแบบเมนเดล และให้รายละเอียดเกี่ยวกับแหล่งข้อมูลน้อยเกินไป[1 ]
การตรวจสอบในปี 2022 แสดงให้เห็นว่าช่องว่างนั้นใหญ่เพียงใด Woolf และเพื่อนร่วมงานได้ประเมินการศึกษาแบบสองกลุ่มตัวอย่างจำนวน 87 เรื่องที่ใช้แพลตฟอร์ม MR-Base และพบว่าการรายงานโดยทั่วไปไม่ดี โดยมีการรายงานรายการเฉลี่ยเพียง 53% ต่อการศึกษา มีเพียง 44% เท่านั้นที่ให้รายละเอียดเพียงพอสำหรับการตัดสินสมมติฐานความเกี่ยวข้อง 31% สำหรับสมมติฐานความเป็นอิสระ และ 32% สำหรับสมมติฐานของการทดสอบการพิสูจน์ความเท็จ ในขณะที่ 89% ให้รายละเอียดเพียงพอสำหรับข้อจำกัดการยกเว้น[4]การตรวจสอบดังกล่าวใช้รายการตรวจสอบเฉพาะของตนเองแทนที่จะใช้ STROBE-MR ดังนั้นเปอร์เซ็นต์จึงแสดงสิ่งที่มักจะหายไปและไม่ใช่คะแนน STROBE-MR
ขอบเขตมีความสำคัญก่อนที่คุณจะเปิดเช็คลิสต์ STROBE-MR ใช้สำหรับรายงานการวิเคราะห์การสุ่มแบบเมนเดล การทดลองแบบสุ่มเป็นไปตาม CONSORT และ CONSORT 2025 (30 รายการ) ได้เข้ามาแทนที่ CONSORT 2010 ตามที่คู่มือ CONSORT ของเรา อธิบายไว้ การศึกษาแบบกลุ่มหรือแบบกรณีควบคุมทั่วไปเป็นไปตาม STROBE ผู้เขียน STROBE-MR ยังระบุด้วยว่าเช็คลิสต์นี้ไม่ใช่เครื่องมืออย่างเป็นทางการสำหรับการประเมินคุณภาพการศึกษา ไม่ควรนำไปใช้เป็นมาตรวัดคุณภาพ และไม่ใช่แนวทางสำหรับการออกแบบหรือดำเนินการศึกษา[1]เราคำนึงถึงเรื่องนี้เมื่อเราให้คะแนนตัวอย่างด้านล่าง
รายการตรวจสอบ STROBE-MR แยกตามส่วนของต้นฉบับ
ตารางที่ 1 สรุปรายการตรวจสอบ STROBE-MR ทั้ง 20 รายการจากเอกสารคำอธิบาย[1]และจัดกลุ่มตามส่วนของต้นฉบับที่คำตอบนั้นเกี่ยวข้อง รายการย่อยที่มีตัวอักษรกำกับจะแสดงไว้ด้วยกัน คอลัมน์ด้านขวาระบุวิธีทั่วไปที่แต่ละกลุ่มมักทำผิดพลาด โดยพิจารณาจากถ้อยคำของรายการเหล่านั้นเอง
| รายการ STROBE-MR | Section | สิ่งที่ต้องรายงาน | กับดักทั่วไป |
|---|---|---|---|
| 1 | ชื่อเรื่องและบทคัดย่อ | ระบุการสุ่มแบบเมนเดล (Mendelian randomization) เป็นรูปแบบการวิจัยเมื่อเป็นจุดประสงค์หลักของการศึกษา | บทคัดย่อที่ระบุเพียงการวิเคราะห์ทางพันธุกรรม โดยไม่ได้ระบุชื่อวิธีการออกแบบ |
| และ 2 3 | บทนำ | อธิบายถึงปัจจัยเสี่ยง ความเป็นไปได้ของความสัมพันธ์เชิงสาเหตุ เหตุผลที่การสุ่มแบบเมนเดลเหมาะสมกับคำถาม และระบุวัตถุประสงค์พร้อมสมมติฐานเชิงสาเหตุที่กำหนดไว้ล่วงหน้า | เหตุผลที่ไม่ได้ระบุเหตุผลว่าทำไมการทดลองหรือการศึกษาแบบกลุ่มจึงไม่เพียงพอ |
| 4 (a ถึง e) | วิธีการและแหล่งข้อมูล | สำหรับแต่ละแหล่งข้อมูล โปรดระบุบริบท ผู้เข้าร่วม และขนาดของกลุ่มตัวอย่าง ว่ามีการคำนวณกำลังการทดสอบล่วงหน้าหรือไม่ วิธีการวัดและคัดกรองตัวแปร วิธีการประเมินการสัมผัสและผลลัพธ์ และการอนุมัติทางจริยธรรม แนะนำให้จัดทำตารางแสดงแหล่งข้อมูลด้วย | ชุดข้อมูลที่ตั้งชื่อตามตัวระบุเท่านั้น โดยไม่มีคำจำกัดความของประชากรหรือกรณีศึกษา |
| 5 | วิธีการและข้อสมมติฐาน | ระบุข้อสมมติหลักสามประการ (ความเกี่ยวข้อง ความเป็นอิสระ และข้อจำกัดในการยกเว้น) สำหรับการวิเคราะห์หลัก พร้อมทั้งข้อสมมติเพิ่มเติมใดๆ สำหรับการวิเคราะห์ความไว | ระบุข้อสมมติฐานโดยไม่บอกว่าแต่ละข้อได้รับการตรวจสอบอย่างไร |
| 6 (a ถึง e) | วิธีการ การวิเคราะห์หลัก | อธิบายหน่วยและมาตราส่วน วิธีจัดการกับตัวแปรและน้ำหนัก ตัวประมาณค่าและตัวแปรควบคุม ข้อมูลที่ขาดหายไป และการทดสอบหลายครั้ง | ผลกระทบที่รายงานต่อหน่วยของมาตราส่วนที่ไม่สามารถอธิบายได้ |
| และ 7 8 | วิธีการ, การตรวจสอบ | ระบุว่าวิธีการใดหรือความรู้เดิมใดที่สนับสนุนข้อสมมติฐาน และแสดงรายการการวิเคราะห์ความไวหรือการวิเคราะห์เพิ่มเติมทั้งหมด | ค่าสถิติ F ถือเป็นหลักฐานยืนยันว่าเครื่องมือวัดมีความถูกต้อง |
| 9 (ก และ ข) | วิธีการ ซอฟต์แวร์ และการลงทะเบียน | ระบุชื่อซอฟต์แวร์ แพ็กเกจ เวอร์ชัน และการตั้งค่า พร้อมทั้งระบุว่าโปรโตคอลดังกล่าวได้รับการลงทะเบียนหรือไม่ เมื่อใด และที่ใด | แพ็กเกจที่ไม่มีการระบุเวอร์ชัน |
| 10 (ก ถึง ง) | ผลลัพธ์ ข้อมูลเชิงพรรณนา | รายงานตัวเลขในแต่ละขั้นตอน สถิติสรุป ความแตกต่างในแหล่งข้อมูลที่นำมาวิเคราะห์แบบเมตา และสำหรับแบบแผนการศึกษาแบบสองกลุ่มตัวอย่าง ความคล้ายคลึงกันของความสัมพันธ์ระหว่างตัวแปรและการสัมผัส รวมถึงการทับซ้อนกันระหว่างกลุ่มตัวอย่าง | ไม่มีข้อมูลเกี่ยวกับการทับซ้อนกันเมื่อชุดข้อมูลทั้งสองดึงข้อมูลจากธนาคารชีวภาพเดียวกัน |
| 11 (ก ถึง ง) | ผลการศึกษาและข้อค้นพบหลัก | รายงานความสัมพันธ์ระหว่างตัวแปรทางพันธุกรรมกับปัจจัยเสี่ยง และความสัมพันธ์ระหว่างตัวแปรทางพันธุกรรมกับผลลัพธ์ การประมาณค่าแบบเมนเดลเลียนแรนดอมในมาตราส่วนที่ตีความได้ ความเสี่ยงสัมบูรณ์ในกรณีที่เกี่ยวข้อง และแผนภูมิ | ค่าลอการิทึมของอัตราส่วนความน่าจะเป็นยังไม่ได้ถูกแปลง และไม่มีการแสดงข้อมูลต่อตัวแปรแต่ละตัวในกราฟ |
| และ 12 13 | ผลลัพธ์ การตรวจสอบสมมติฐาน และความไวต่อการเปลี่ยนแปลง | รายงานผลการตรวจสอบสมมติฐานและสถิติความแตกต่าง การวิเคราะห์ความไว การทดสอบทิศทางเชิงสาเหตุ การเปรียบเทียบกับค่าประมาณที่ไม่ใช่แบบสุ่มเมนเดล และแผนภาพเพิ่มเติม เช่น แผนภาพการตัดออกทีละตัว | มีการรายงานผลการทดสอบพลีโอโทรปีโดยไม่มีการแสดงความคิดเห็นใดๆ เกี่ยวกับประสิทธิภาพของการทดสอบ |
| และ 14 15 | การสนทนา | สรุปผลลัพธ์สำคัญเทียบกับวัตถุประสงค์ จากนั้นอภิปรายข้อจำกัดต่างๆ รวมถึงข้อสมมติฐาน อคติ และความไม่แม่นยำอื่นๆ ตลอดจนทิศทางและขนาดของอคติเหล่านั้น | ข้อจำกัดที่ระบุปัญหาโดยไม่ได้บอกว่าปัญหาเหล่านั้นส่งผลต่อการประมาณการไปในทิศทางใด |
| และ 16 17 | การสนทนา | ควรตีความอย่างระมัดระวัง อภิปรายกลไกและความเท่าเทียมกันระหว่างยีนและสิ่งแวดล้อม ความสำคัญทางคลินิก และความสามารถในการนำไปใช้กับประชากรกลุ่มอื่น ระยะเวลาและระดับการสัมผัส | การใช้ถ้อยคำที่แสดงถึงสาเหตุนั้นรุนแรงกว่าที่สมมติฐานกำหนดไว้ |
| เพื่อ 18 20 | ข้อมูลอื่น ๆ | อธิบายแหล่งที่มาของเงินทุนและบทบาทของผู้ให้ทุน ให้สิทธิ์ในการเข้าถึงข้อมูลและรหัสโปรแกรม และแจ้งผลประโยชน์ทับซ้อน | รหัสที่อธิบายไว้ สามารถขอรับได้เมื่อร้องขอ |
รายการที่ 4, 6, 10 และ 13 ของแบบตรวจสอบ STROBE-MR มีรายการย่อยมากที่สุด และเป็นส่วนที่ต้องใช้ความพยายามในการรายงานมากที่สุด ผู้อ่านที่ต้องการทราบสถิติเบื้องหลังรายการเหล่านี้ สามารถเริ่มต้นได้จากบทความของเราเกี่ยวกับเครื่องมือที่อ่อนแอและสถิติ F , พลีโอโทรปีและตัวประมาณค่ามาตรฐานสี่ตัวและการคำนวณกำลังการทดสอบที่บทความส่วนใหญ่ละเว้นและคำอธิบายเกี่ยวกับการสุ่มแบบเมนเดลจะครอบคลุมวิธีการตั้งแต่ต้นจนจบ
ตัวอย่างการเข้าถึงแบบเปิดที่เราใช้สำหรับรายการตรวจสอบ STROBE-MR
เราเลือกการศึกษาการสุ่มแบบเมนเดลสองตัวอย่างที่ตีพิมพ์ในเดือนตุลาคม 2026 ในEndocrinology, Diabetes & Metabolismโดย Zaka และเพื่อนร่วมงาน[3]โดยถามว่าระดับ 25-ไฮดรอกซีวิตามินดีในซีรั่มที่ทำนายทางพันธุกรรมมีความสัมพันธ์กับโรคเบาหวานประเภทที่ 2 ในชาวเอเชียใต้หรือไม่ ผู้เขียนระบุว่างานวิจัยนี้รายงานตาม STROBE-MR และบันทึก PMC ไม่แสดงไฟล์เสริม ดังนั้นเราจึงให้คะแนนข้อความ ตาราง และรูปภาพทั้งหมดตามรายการตรวจสอบ STROBE-MR บทความนี้ได้รับอนุญาตภายใต้ CC BY 4.0 Crossref ระบุเวอร์ชันของบันทึกภายใต้ใบอนุญาตดังกล่าว และ Europe PMC และบันทึกการเข้าถึงแบบเปิดของ PMC ก็ใช้ใบอนุญาตเดียวกัน
- ออกแบบ การสุ่มแบบเมนเดลสองกลุ่มตัวอย่าง พร้อมสถิติสรุปจากฐานข้อมูล OpenGWAS โอเพ่นจีดับบลิวเอส.
- การเปิดรับแสง. ระดับ 25-ไฮดรอกซีวิตามินดีในซีรั่มจากการศึกษา GWAS ของกลุ่มตัวอย่างชาวเอเชียใต้ในสหราชอาณาจักร (n = 7,380) โดยใช้ตัวแปรสามตัวเป็นตัวชี้วัด
- ผล. โรคเบาหวานประเภทที่ 2 จากการวิเคราะห์ข้อมูลเชิงเมตาของกลุ่มตัวอย่างชาวเอเชียใต้ 16 กลุ่ม (n = 50,533 โดยมีผู้ป่วย 16,677 ราย) [5].
- ผลลัพธ์หลัก อัตราส่วนความน่าจะเป็นถ่วงน้ำหนักตามค่าผกผันของความแปรปรวน 1.06 (ช่วงความเชื่อมั่น 95% 0.83 ถึง 1.36) ต่อค่าเบี่ยงเบนมาตรฐาน 1 หน่วยของ 25-ไฮดรอกซีวิตามินดีที่ทำนายได้จากพันธุกรรม
คำตัดสินแต่ละข้อด้านล่างนี้คือการตีความบทความของเราเทียบกับข้อความที่เรียบเรียงใหม่ เราใช้ป้ายกำกับสี่แบบรายงานแล้วหมายความว่าบทความตอบคำถามนั้นด้วยคำพูดของตัวเองการตัดสินใจหมายความว่าผู้อ่านที่มีเหตุผลอาจมีความเห็นแตกต่างกัน โดยปกติแล้วเป็นเพราะคำตอบนั้นไม่สมบูรณ์หรืออยู่ในส่วนอื่นไม่พบในบทความหมายความว่าเราไม่พบข้อความใด ๆ ในข้อความฉบับเต็มหรือในไฟล์ PDF ไม่เกี่ยวข้องหมายความว่าข้อความนั้นขึ้นอยู่กับบางสิ่งบางอย่างที่ข้อมูลระดับสรุปไม่สามารถให้ได้ หรือขึ้นอยู่กับการวิเคราะห์ที่บทความไม่ได้ดำเนินการและอธิบายไว้ ข้อความที่ยกมาเป็นคำพูดที่ตรงตามต้นฉบับและสั้น
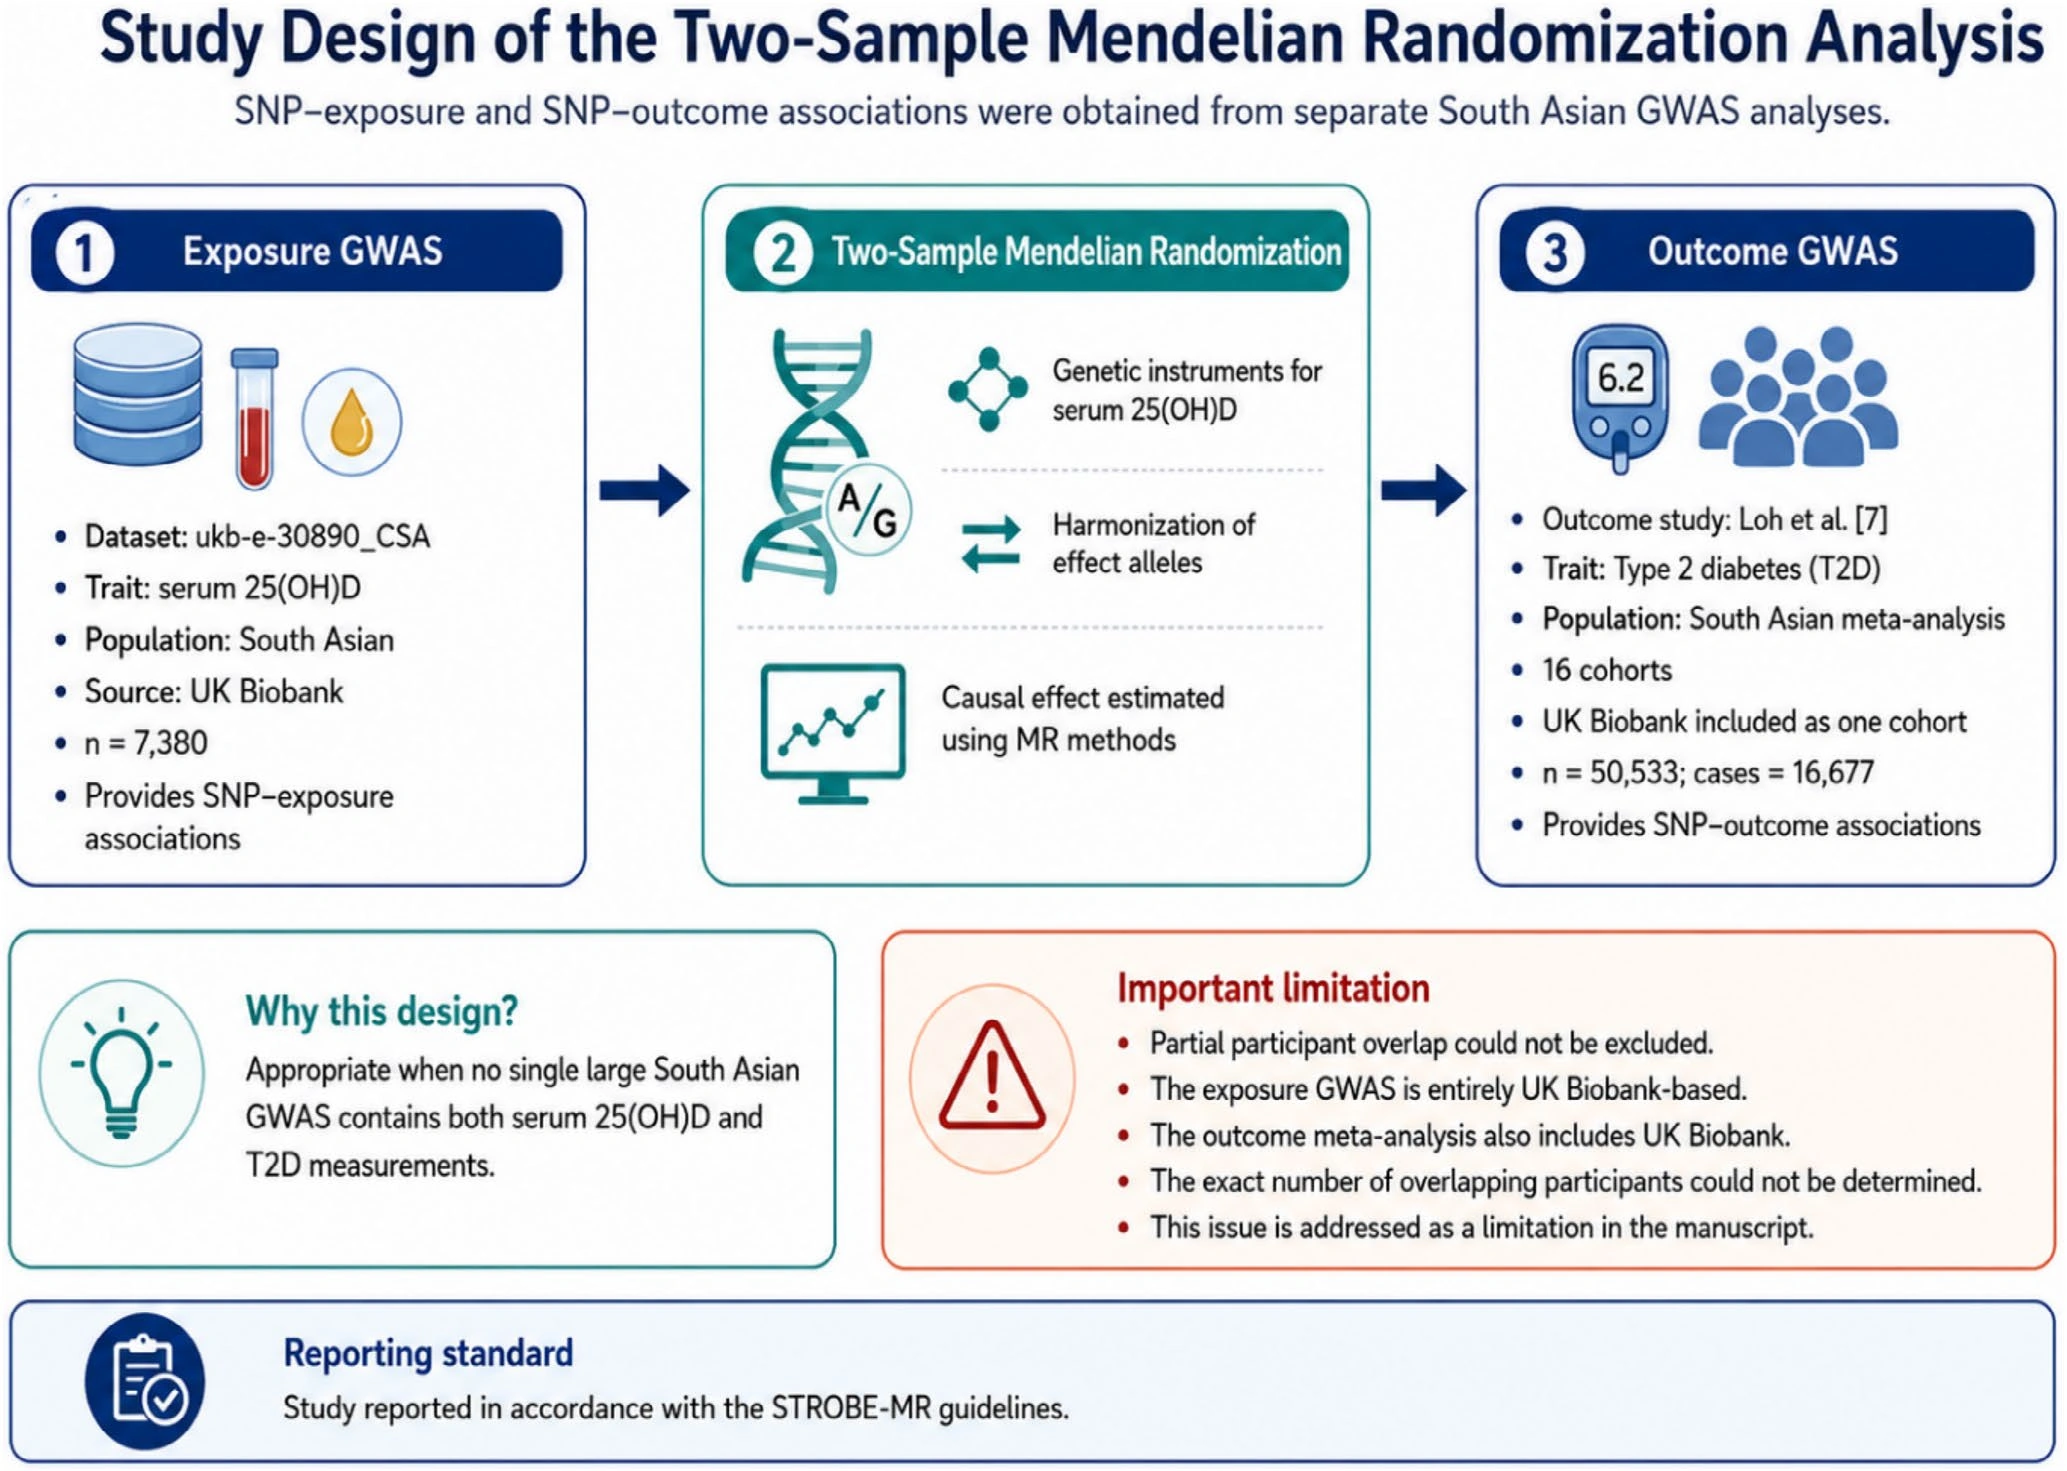
รูปที่ 1 ตอบคำถามข้อที่ 4 ไปบางส่วนแล้ว เพราะแสดงแหล่งข้อมูลทั้งสองแหล่ง ขนาดของกลุ่มตัวอย่าง และปัญหาการทับซ้อนกันของข้อมูลในหน้าเดียวกัน นี่คือบทสรุปการออกแบบเบื้องต้นที่ตรงตามที่คำถามข้อนี้ต้องการ
การนำแบบตรวจสอบ STROBE-MR มาใช้กับตัวอย่างทีละรายการ
| รายการ | ส่วนไหนของบทความ | บทความนี้ทำอะไร | คำตัดสิน |
|---|---|---|---|
| 1 | ชื่อเรื่อง; บทคัดย่อ | ชื่อเรื่องระบุว่าเป็น "การศึกษาการสุ่มแบบเมนเดลสองกลุ่มตัวอย่างเชิงสำรวจ" และบทคัดย่อในส่วนวิธีการเริ่มต้นด้วยการวิเคราะห์สองกลุ่มตัวอย่างโดยใช้สถิติสรุปของ OpenGWAS | รายงาน |
| 2 | บทนำ | กล่าวถึงภาระของภาวะขาดวิตามินดีและโรคเบาหวานชนิดที่ 2 ในเอเชียใต้ กลไกผ่านตัวรับในเซลล์เบต้าของตับอ่อน ปัญหาของการรบกวนและสาเหตุย้อนกลับในข้อมูลเชิงสังเกต และเหตุผลสนับสนุนการสุ่มแบบเมนเดล | รายงาน |
| 3 | จบส่วนบทนำ | ระบุเป้าหมายว่า “เพื่อประเมินความสัมพันธ์ระหว่างระดับวิตามินดีที่ทำนายได้จากพันธุกรรมและความเสี่ยงต่อโรคเบาหวานชนิดที่ 2 ในชาวเอเชียใต้” เป้าหมายดังกล่าวพูดถึงความสัมพันธ์ และไม่ได้ระบุสมมติฐานเชิงสาเหตุที่ชัดเจนไว้ | การตัดสินใจ |
| 4 | ส่วนที่ 2.1; ตารางที่ 1; รูปที่ 2 ของบทความ | นำเสนอการออกแบบตั้งแต่เนิ่นๆ โดยมีตารางแสดงตัวระบุชุดข้อมูล คุณลักษณะ เชื้อสาย และขนาดตัวอย่าง พร้อมทั้งแผนภาพการออกแบบ | รายงาน |
| 4a | มาตรา 2.1 และ 2.2 | ระบุชื่อการศึกษา GWAS เกี่ยวกับการสัมผัส (กลุ่มตัวอย่างย่อยจาก UK Biobank ในเอเชียใต้) และการวิเคราะห์เมตาของผลลัพธ์จาก 16 กลุ่มตัวอย่าง ระยะเวลาการรับสมัครและสถานที่ของกลุ่มตัวอย่างที่ร่วมให้ข้อมูลนั้นอ้างอิงจากเอกสารต้นฉบับ | การตัดสินใจ |
| 4b | ส่วนที่ 2.2; ตารางที่ 1; ส่วนที่ 2.6 | ระบุขนาดตัวอย่างและคำจำกัดความของกรณีโรคเบาหวานประเภทที่ 2 การคำนวณกำลังการทดสอบถูกอธิบายว่าเป็นแบบย้อนหลัง ในขณะที่คำถามถามว่ามีการคำนวณกำลังการทดสอบก่อนการวิเคราะห์หลักหรือไม่ | การตัดสินใจ |
| 4c | 2.3 มาตรา | รายงานนี้กล่าวถึงเกณฑ์ทั่วทั้งจีโนม เกณฑ์ที่ผ่อนปรนที่ใช้สำหรับตัวแปรสองตัว การรวมกลุ่มที่ r2 ต่ำกว่า 0.001 ในหน้าต่าง 10,000 กิโลเบส เทียบกับแผงอ้างอิงชาวเอเชียใต้ การจัดการพร็อกซีและพาลินโดรม และการสร้างจีโนม | รายงาน |
| 4d | 2.2 มาตรา | นิยามโรคเบาหวานประเภทที่ 2 โดยพิจารณาจากประวัติหรือการรักษา ระดับน้ำตาลในเลือดขณะอดอาหาร ระดับน้ำตาลในเลือด 2 ชั่วโมงหลังรับประทานอาหาร หรือ HbA1c และระบุมาตราส่วนมาตรฐานของ 25-ไฮดรอกซีวิตามินดี แต่ไม่ได้อธิบายวิธีการทางห้องปฏิบัติการในการวัดระดับการได้รับสารดังกล่าว | การตัดสินใจ |
| 4e | ส่วนที่ 2.2; คำแถลงด้านจริยธรรม | ระบุว่างานดังกล่าวเป็นการวิเคราะห์ข้อมูลสรุปสาธารณะในลำดับที่สอง และ “ไม่จำเป็นต้องได้รับการอนุมัติทางจริยธรรมอย่างเป็นทางการ” | รายงาน |
| 5 | 2.4 มาตรา | ระบุความเกี่ยวข้อง ข้อจำกัดในการยกเว้น และความเป็นอิสระเป็นสมมติฐานหลักสามประการ สมมติฐานที่อยู่เบื้องหลังตัวประมาณค่าความไวจะปรากฏเป็นเพียงหมายเหตุในตารางที่ 3 เท่านั้น (อย่างน้อย 50% ของตัวแปรที่ถูกต้องสำหรับค่ามัธยฐานถ่วงน้ำหนัก) | การตัดสินใจ |
| 6a | มาตรา 2.3 และ 2.5 | รายงานผลกระทบต่อค่าเบี่ยงเบนมาตรฐาน 1 ค่าของการสัมผัสที่ปรับตามลำดับ โดยแปลงค่าลอการิทึมของอัตราต่อรองเป็นอัตราส่วนของอัตราต่อรอง | รายงาน |
| 6b | มาตรา 2.3 และ 2.5 | ถือว่าตัวแปรเดี่ยวทั่วทั้งจีโนมเป็นเครื่องมืออัตราส่วนวอลด์ และชุดตัวแปรสามตัวมีน้ำหนักผกผันของความแปรปรวน | รายงาน |
| 6c | 2.5 มาตรา | บทความระบุชื่อตัวประมาณค่า แต่ไม่ได้ระบุว่าใช้ตัวแปรควบคุมใดบ้างในการศึกษา GWAS ทั้งสองครั้ง | การตัดสินใจ |
| 6d | 2.3 มาตรา | ระบุว่าตัวแปรทั้งสามชนิดมีอยู่ในข้อมูลผลลัพธ์ และไม่จำเป็นต้องใช้ตัวแปรทดแทนใดๆ ไม่มีคำอธิบายเพิ่มเติมเกี่ยวกับข้อมูลที่ขาดหายไป | การตัดสินใจ |
| 6e | ไม่พบข้อความใดๆ | การวิเคราะห์มุ่งเน้นไปที่ปัจจัยเสี่ยงหนึ่งอย่างและผลลัพธ์หนึ่งอย่าง ดังนั้นแม้ว่าสิ่งนั้นอาจไม่ส่งผลกระทบโดยตรง แต่บทความกลับไม่ได้กล่าวถึงเรื่องนี้ | การตัดสินใจ |
| 7 | มาตรา 2.3 และ 2.4 | ใช้สถิติ F และความแปรปรวนที่อธิบายได้ต่อตัวแปรแต่ละตัว และระบุว่า “F > 10 บ่งชี้ถึงความแข็งแกร่งของเครื่องมือตามแบบแผนที่ยอมรับได้ แต่ไม่ได้เป็นการยืนยันสมมติฐานความเป็นอิสระหรือข้อจำกัดการยกเว้นโดยตัวมันเอง” | รายงาน |
| 8 | มาตรา 2.5 และ 3.4 | วางแผนโดยใช้ MR-Egger, ค่ามัธยฐานถ่วงน้ำหนัก, โหมดแบบง่าย และโหมดถ่วงน้ำหนัก จากนั้นเพิ่มการทดลองที่เกณฑ์ผ่อนปรนสองระดับ (68 และ 18 รูปแบบ) และผลลัพธ์ที่ปรับตามค่า BMI | รายงาน |
| 9a | 2.5 มาตรา | ชื่อโปรแกรมคือ R 4.3.1, แพ็กเกจ TwoSampleMR เวอร์ชัน 0.7.0 และเฟรมเวิร์ก mRnd สำหรับการคำนวณกำลังขยาย | รายงาน |
| 9b | ไม่พบข้อความใดๆ | ไม่มีข้อความการลงทะเบียนปรากฏขึ้น แม้ว่าการวิเคราะห์ที่ปรับตามดัชนีมวลกาย (BMI) จะถูกเรียกว่า "กำหนดไว้ล่วงหน้า" ก็ตาม | ไม่พบในบทความ |
| 10a | 1 ตาราง | ใช้ข้อมูลระดับสรุป ดังนั้นจึงไม่มีการแสดงลำดับการไหลของผู้เข้าร่วม ตารางที่ 1 แสดงขนาดของผู้เข้าร่วม | ไม่สามารถใช้งาน |
| 10b | ส่วนที่ 2.2; ตารางที่ 1 | ระบุขนาดตัวอย่างและสัดส่วนกรณี (0.330) ไม่ได้ระบุค่าเฉลี่ยหรือค่าเบี่ยงเบนมาตรฐานของการสัมผัส | การตัดสินใจ |
| 10c | 2.1 มาตรา | ผลลัพธ์นี้รวมกลุ่มตัวอย่าง 16 กลุ่ม และไม่พบสถิติความแตกต่างระหว่างกลุ่มตัวอย่างเหล่านั้น อย่างไรก็ตาม เอกสารต้นฉบับอาจรายงานสถิติดังกล่าวไว้ | การตัดสินใจ |
| 10ง (i) | 2.1 มาตรา | ข้อมูลทั้งสองชุดมาจากเอเชียใต้ และบทความอธิบายถึงเหตุผลที่ต้องใช้การออกแบบการวิจัยแบบสองกลุ่มตัวอย่าง แต่ไม่ได้เปรียบเทียบความสัมพันธ์ระหว่างตัวแปรทางพันธุกรรมกับการสัมผัสปัจจัยเสี่ยงในกลุ่มตัวอย่างทั้งสองกลุ่ม | การตัดสินใจ |
| 10ง (ii) | มาตรา 2.1; มาตรา 5 | ระบุว่า “ไม่สามารถระบุจำนวนผู้เข้าร่วมโครงการ UK Biobank ที่ซ้ำซ้อนได้อย่างแน่ชัดจากรายงานที่เผยแพร่หรือข้อมูลเพิ่มเติม” จากนั้นจึงกำหนดขอบเขตของอคติที่เป็นไปได้ด้วยสัดส่วนการซ้ำซ้อนในกรณีที่เลวร้ายที่สุดที่ 0.146 | การตัดสินใจ |
| 11a | ตารางที่ 2 และรูปที่ 3 ของบทความ | ผลกระทบของตัวแปรต่อการสัมผัส ค่าความคลาดเคลื่อนมาตรฐาน และค่า p แสดงอยู่ในตารางที่ 2 ผลกระทบของตัวแปรต่อผลลัพธ์จะปรากฏเฉพาะในแผนภาพกระจายเท่านั้น | การตัดสินใจ |
| 11b | ส่วนที่ 3.3; ตารางที่ 3 | รายงานอัตราส่วนความเสี่ยง (odds ratio) เท่ากับ 1.06 (ช่วงความเชื่อมั่น 95% 0.83 ถึง 1.36) ต่อ 1 SD โดยมีค่า p = 0.630 บนมาตราส่วนที่ตีความได้ | รายงาน |
| 11c | ไม่พบข้อความใดๆ | ไม่มีการแปลงเป็นความเสี่ยงสัมบูรณ์ ซึ่งเหมาะสมกับการประมาณค่าเบื้องต้นที่เป็นศูนย์ แต่บทความไม่ได้ระบุเหตุผล | การตัดสินใจ |
| 11d | รูปที่ 3 และ 4 ของบทความ | แสดงแผนภาพกระจายพร้อมเส้นสำหรับตัวประมาณแต่ละตัวและแผนภาพกรวย ไม่แสดงแผนภาพฟอเรสต์ของค่าประมาณต่อตัวแปรแต่ละตัว | รายงาน |
| 12a | มาตรา 3.1 และ 3.2 | รายงานระบุค่าสถิติ F ตั้งแต่ 26.4 ถึง 33.4, Q p = 0.403 และค่าจุดตัดของ Egger p = 0.462 และเพิ่มเติมว่า “ไม่ควรตีความค่าจุดตัดที่ไม่สำคัญว่าเป็นหลักฐานที่น่าเชื่อถือว่าไม่มีภาวะพลีโอโทรปีในแนวนอน” | รายงาน |
| 12b | ส่วนที่ 3.2; ตารางที่ 3 และ 4 | แสดงค่า Cochran Q สำหรับ IVW และ MR-Egger ในการวิเคราะห์หลัก และสำหรับ IVW ที่เกณฑ์ผ่อนปรนสองระดับ | รายงาน |
| 13a | หัวข้อ 3.4 และ 3.5; ตารางที่ 3 และ 4 | รายงานนี้กล่าวถึงตัวประมาณค่าทางเลือกสี่แบบ เกณฑ์ที่ผ่อนปรนสองแบบ และผลลัพธ์ที่ปรับตามดัชนีมวลกาย (BMI) | รายงาน |
| 13b | ส่วนที่ 3.5 และ 3.6; ตารางที่ 5 | รายงานการวิเคราะห์ที่ปรับค่าตามดัชนีมวลกาย (BMI) และกำลังการทดสอบประมาณ 18%, 51% และมากกว่า 99% สำหรับอัตราส่วนความเสี่ยง (odds ratio) ที่ 1.1, 1.2 และ 1.5 ตามลำดับ | รายงาน |
| 13c | 2.3 มาตรา | ไม่ได้มีการทดสอบทิศทางของความสัมพันธ์เชิงสาเหตุ บทความระบุว่าไม่ได้ใช้การกรองแบบ Steiger และให้เหตุผลว่าเป็นเพราะมีความรู้ทางชีววิทยาเกี่ยวกับเครื่องมือดังกล่าวมาก่อน | ไม่สามารถใช้งาน |
| 13d | 4.1 มาตรา | เปรียบเทียบผลลัพธ์กับงานวิจัยแบบสุ่มตามหลักเมนเดลและการทดลองเสริมอาหารในอดีต (โดยไม่ได้คำนวณค่าประมาณที่ไม่เป็นไปตามหลักเมนเดล) | การตัดสินใจ |
| 13e | 5 มาตรา | ไม่แสดงกราฟแบบตัดออกหนึ่งตัวอย่าง และระบุว่า MR-PRESSO และการวิเคราะห์แบบตัดออกหนึ่งตัวอย่าง "ไม่สามารถดำเนินการได้อย่างแม่นยำเพียงพอ" | การตัดสินใจ |
| 14 | มาตรา 4 วรรคแรก | ระบุผลลัพธ์ที่เป็นศูนย์อีกครั้งเมื่อเทียบกับวัตถุประสงค์ และตั้งข้อสังเกตว่าการประมาณค่า MR-Egger นั้นมีความแม่นยำน้อยเกินไปที่จะยืนยันผลลัพธ์ดังกล่าวได้ | รายงาน |
| 15 | 5 มาตรา | ระบุข้อจำกัดเจ็ดประการ และสำหรับการทับซ้อนของตัวอย่าง จะประมาณขนาดของอคติที่อาจเกิดขึ้นโดยใช้วิธีการกำหนดขอบเขต | รายงาน |
| 16a | มาตรา 3.3, 4.1 และ 6 | ตีความผลลัพธ์ที่เป็นศูนย์ว่า “ไม่มีความสัมพันธ์ที่สามารถตรวจจับได้ภายในความแม่นยำที่เครื่องมือปัจจุบันสามารถให้ได้” และนำไปเปรียบเทียบกับงานวิจัยก่อนหน้านี้ | รายงาน |
| 16b | 4.2 มาตรา | เสนอคำอธิบายสามประการ รวมถึงผลกระทบที่ไม่เป็นเชิงเส้น ไม่ได้ใช้คำว่า "ความสมดุลระหว่างยีนและสิ่งแวดล้อม" | การตัดสินใจ |
| 16c | 4.3 มาตรา | ระบุว่า การเสริมวิตามินและแร่ธาตุเพื่อป้องกันโรคเบาหวานชนิดที่ 2 ยังไม่ได้รับการสนับสนุนจากหลักฐานเชิงสาเหตุในปัจจุบัน และยังไม่แน่ชัดว่าจะมีประโยชน์ด้านอื่นๆ หรือไม่ | รายงาน |
| 17 | มาตรา 4.2 และ 5 | โปรดทราบว่าผู้เข้าร่วมที่อาศัยอยู่ในสหราชอาณาจักรอาจแตกต่างจากผู้คนในปากีสถาน การสัมผัสทางพันธุกรรมตลอดชีวิตแตกต่างจากการทดลองที่มีระยะเวลาจำกัด และวิธีการเชิงเส้นไม่สามารถตรวจจับผลกระทบที่ไม่เป็นเชิงเส้นได้ | รายงาน |
| 18 | ไม่พบข้อความใดๆ | ไม่มีการระบุแหล่งทุนสนับสนุนในเนื้อหาฉบับเต็มหรือในไฟล์ PDF และ Crossref ก็ไม่ได้ระบุผู้ให้ทุนสนับสนุนสำหรับบทความนี้ | ไม่พบในบทความ |
| 19 | คำชี้แจงความพร้อมใช้งานของข้อมูล | แสดงรหัสระบุตัวตนของ OpenGWAS สำหรับโค้ดนั้นระบุว่าสคริปต์และชุดข้อมูล "กำลังถูกฝากไว้ในที่เก็บข้อมูลสาธารณะ" โดยจะมีการเพิ่มลิงก์เข้าไป | การตัดสินใจ |
| 20 | ขัดแย้งทางผลประโยชน์ | ระบุว่าผู้เขียนไม่มีผลประโยชน์ทับซ้อนใดๆ | รายงาน |
จากทั้งหมด 44 แถวของแบบตรวจสอบ STROBE-MR พบว่า 22 แถวมีการรายงาน 18 แถวเป็นการตัดสินใจ 2 แถวไม่พบในบทความ และ 2 แถวไม่เกี่ยวข้อง ผลรวมนี้อธิบายถึงความชัดเจนของบทความเมื่อเทียบกับรายการที่เรียบเรียงใหม่ และไม่ใช่คะแนนคุณภาพ การตัดสินใจหลายรายการมาจากรายการย่อยที่แบบตรวจสอบเองระบุว่าเป็นเงื่อนไข
มีสองแถวที่ควรระบุวิธีการ สำหรับข้อ 4b เอกสารอธิบายถามว่ามีการคำนวณกำลังก่อนการวิเคราะห์หลักหรือไม่ และการคำนวณภายหลังให้คำตอบที่แตกต่างออกไป ดังนั้นเราจึงทำเครื่องหมายว่าเป็นดุลยพินิจแทนที่จะเป็นช่องว่าง สำหรับข้อ 19 บทความให้ตัวระบุข้อมูลที่ทุกคนสามารถทำตามได้ แต่คำสั่งโค้ดเป็นคำสัญญา และคำสัญญาไม่สามารถตรวจสอบได้
ตัวเลขในตัวอย่างแสดงให้เห็นอะไรบ้าง
รายการตรวจสอบการรายงานมีประโยชน์ส่วนหนึ่งเพราะช่วยให้ผู้อ่านสามารถสร้างตัวเลขขึ้นมาใหม่ได้ เราได้คำนวณปริมาณหลักในตารางที่ 3 ใหม่จากค่าที่พิมพ์ในบทความ เมื่อค่าตรงกัน การรายงานก็จะมีความสอดคล้องกันภายใน ซึ่งเป็นสิ่งที่รายการตรวจสอบ STROBE-MR มุ่งหวังที่จะทำให้เป็นไปได้ เมื่อค่าแตกต่างกัน รายการที่ต้องตรวจสอบคือรายการที่ขอให้ผู้เขียนระบุวิธีการและสภาพแวดล้อมในการดำเนินการ
| จำนวน | การคำนวณใหม่ของเราจากค่าที่พิมพ์ไว้ | รายงานบทความ | Comment |
|---|---|---|---|
| ค่าสถิติ F, ตัวแปร rs3755967 | (0.099 / 0.017)2 = 33.9 | 33.4 | ภายในค่าความคลาดเคลื่อนมาตรฐานที่แสดงผลโดยการปัดเศษ |
| ค่าสถิติ F, ตัวแปร rs2459139 | (0.108 / 0.020)2 = 29.2 | 29.0 | ภายในการปัดเศษ |
| ค่าสถิติ F, ตัวแปร rs72744878 | (0.101 / 0.020)2 = 25.5 | 26.4 | เมื่อพิจารณาจากการปัดเศษ เนื่องจากค่าความคลาดเคลื่อนมาตรฐาน 0.0197 พิมพ์ออกมาเป็น 0.020 และให้ค่า 26.4 |
| ค่าเฉลี่ยสถิติ F | (33.4 + 29.0 + 26.4) / 3 = 29.6 | 29.6 | การจับคู่ |
| ความแปรปรวนทั้งหมดที่อธิบายได้ | 0.405 + 0.342 + 0.309 = 1.056% | 1.06% | การจับคู่ |
| อัตราส่วนความน่าจะเป็นของ IVW | exp(0.058) = 1.06 | 1.06 | การจับคู่ |
| ค่า p ของ IVW | z = 0.058 / 0.120 = 0.483, p = 0.629 | 0.630 | การจับคู่ |
| ช่วงความเชื่อมั่น 95% ของ IVW | exp(0.058 ± 1.96 × 0.120) = 0.84 ถึง 1.34 | เพื่อ 0.83 1.36 | เป็นการตัดสินใจโดยใช้ดุลพินิจ บทความไม่ได้ระบุวิธีการคำนวณช่วงเวลาดังกล่าว |
| ช่วงประมาณการอื่นๆ | ค่ามัธยฐานถ่วงน้ำหนัก ค่าฐานนิยมแบบง่าย ค่าฐานนิยมถ่วงน้ำหนัก และ MR-Egger | ตามที่พิมพ์ไว้ | ตรงกันเมื่อคำนวณใหม่จากค่าเบต้าและค่าความคลาดเคลื่อนมาตรฐานแต่ละค่า |
ความแตกต่างเพียงจุดเดียวที่ควรกล่าวถึงคือช่วงความเชื่อมั่นของ IVW ค่าที่รายงาน 0.83 ถึง 1.36 ตรงกับค่าประมาณ IVW ที่ปรับตาม BMI (เบต้า 0.062 ค่าความคลาดเคลื่อนมาตรฐาน 0.125) ในขณะที่ค่าประมาณหลักที่มีค่าความคลาดเคลื่อนมาตรฐาน 0.120 ให้ค่า 0.84 ถึง 1.34 ช่องว่างนั้นเล็ก แต่การปัดเศษของค่าที่พิมพ์ออกมาไม่สามารถอธิบายได้ เพราะช่วงความเชื่อมั่น 0.83 ถึง 1.36 จำเป็นต้องมีค่าความคลาดเคลื่อนมาตรฐานใกล้เคียง 0.126 วิธีการคำนวณช่วงความเชื่อมั่นที่แตกต่างกัน เช่น วิธีที่เพิ่มค่าความคลาดเคลื่อนมาตรฐานเมื่อมีความแตกต่างกัน อาจเป็นสาเหตุหนึ่ง ข้อ 6 ขอให้ผู้เขียนอธิบายตัวประมาณค่าและสถิติที่เกี่ยวข้อง และข้อความที่ระบุชื่อวิธีการคำนวณช่วงความเชื่อมั่นจะทำให้คำถามนี้หายไป ในข้อจำกัด ข้อความที่ทับซ้อนกันยังให้ค่าความเอนเอียงประมาณ 0.32% และประมาณ 5.6% ของค่าประมาณ IVW ดังนั้นผู้อ่านต้องอนุมานว่าแต่ละตัวเลขใช้ตัวหารใด
บทเรียนการรายงาน 4 ข้อจากตัวอย่างเช็คลิสต์ STROBE-MR
ตัวอย่างนี้มีบทเรียนสี่ข้อที่สามารถนำไปใช้กับแบบตรวจสอบ STROBE-MR ใดๆ ที่คุณทำเสร็จสมบูรณ์ได้
ระบุสิ่งที่คุณไม่สามารถได้รับ และประเมินสถานการณ์ที่เลวร้ายที่สุด
การทับซ้อนของกลุ่มตัวอย่างเป็นประเด็นที่มักได้รับคำอธิบายอย่างคลุมเครือที่สุด ในกรณีนี้ การศึกษา GWAS เกี่ยวกับปัจจัยเสี่ยงนั้นใช้ข้อมูลจาก UK Biobank ทั้งหมด และการวิเคราะห์เมตาของผลลัพธ์ก็รวมถึง UK Biobank ด้วย โดยผู้เขียนระบุว่า “ไม่สามารถระบุจำนวนผู้เข้าร่วมจาก UK Biobank ที่ทับซ้อนกันได้อย่างแน่ชัดจากรายงานที่ตีพิมพ์หรือข้อมูลเพิ่มเติม” จากนั้นพวกเขารายงานว่าเครื่องมือ MRlap ล้มเหลวเนื่องจากขั้นตอนความแปรปรวนร่วมส่งค่าที่ไม่กำหนดกลับมา และแทนที่ด้วยการคำนวณขอบเขตโดยสมมติสัดส่วนการทับซ้อนที่ 0.146 และความสัมพันธ์ทางฟีโนไทป์ที่ −0.12 ซึ่งเป็นรูปแบบที่ข้อ 10d ต้องการ กล่าวคือ ระบุตัวเลขเมื่อมีอยู่ และระบุขอบเขตเมื่อไม่มีอยู่
แยกความแข็งแกร่งของเครื่องมือออกจากความถูกต้องของเครื่องมือ
บทความระบุว่า “F > 10 บ่งชี้ถึงความแข็งแกร่งของเครื่องมือตามแบบแผนที่ยอมรับได้ แต่ไม่ได้เป็นการยืนยันสมมติฐานความเป็นอิสระหรือข้อจำกัดการยกเว้นโดยตัวมันเอง” เอกสารอธิบายได้กล่าวถึงประเด็นที่เกี่ยวข้องว่า ค่าสถิติ F ที่สูงกว่า 10 ไม่ได้ตัดความเป็นไปได้ของอคติจากเครื่องมือที่อ่อนแอออกไป และเปรียบเทียบกฎทั่วไปกับค่าตัดสำหรับค่า p [1]การเขียนทั้งสองส่วนของประโยคจะช่วยปกป้องเอกสารจากผู้ตรวจสอบที่อ่านค่าสถิติ F เป็นคำตัดสิน
เช่น เมื่ออุปกรณ์วินิจฉัยไม่มีพลังงาน
ด้วยตัวแปรสามตัว ค่าจุดตัดของ MR-Egger มีองศาอิสระตกค้างหนึ่งองศา ผู้เขียนระบุว่า “ไม่ควรตีความค่าจุดตัดที่ไม่สำคัญว่าเป็นหลักฐานที่น่าเชื่อถือว่าไม่มีภาวะพลีโอโทรปีในแนวนอน” การทดสอบพลีโอโทรปีที่ไม่มีประโยคดังกล่าวทำให้ตีความได้ว่าการศึกษานั้นไม่มีความผิดปกติ บทความของเราเกี่ยวกับสิ่งที่ตัวประมาณพลีโอโทรปีแต่ละตัวป้องกันนั้นอธิบายว่าเหตุใดจำนวนตัวแปรจึงจำกัดแต่ละวิธี
เชื่อมโยงส่วนต่างๆ ให้สมบูรณ์ระหว่างวิธีการ ข้อจำกัด และรายการอ้างอิง
มีรายละเอียดสี่อย่างในบทความที่ตีพิมพ์แล้วที่อาจทำให้บรรณาธิการตรวจแก้สงสัย ส่วนที่ 2.3 ระบุว่าไม่ได้ใช้การกรองทิศทางของ Steiger แต่ส่วนที่ 5 กลับระบุว่ารายละเอียด “ควรได้รับการยืนยันและรายงานในวิธีการฉบับสุดท้าย” ซึ่งดูเหมือนจะเป็นบันทึกการร่าง คำแถลงเกี่ยวกับการเข้าถึงข้อมูลสัญญาว่าจะให้ลิงก์ไปยังคลังข้อมูลที่ยังไม่มีในเนื้อหา รูปภาพการออกแบบ (รูปที่ 1 ของเรา) อ้างอิงการศึกษาผลลัพธ์เป็นเอกสารอ้างอิงที่ 7 ในขณะที่รายการอ้างอิงระบุว่าเป็นเอกสารอ้างอิงที่ 9 และเอกสารอ้างอิงที่ 7 เป็นบทวิจารณ์ของ Davey Smith และ Hemani วิธีการกำหนดขอบเขตการทับซ้อนนั้นระบุว่าเป็นผลงานของ Burgess และเพื่อนร่วมงานเป็นเอกสารอ้างอิงที่ 11 และรายการแสดงว่าเอกสารอ้างอิงที่ 11 คือบทความเกี่ยวกับการตีความ MR-Egger โดย Burgess และ Thompson ทั้งหมดนี้ไม่ได้เปลี่ยนแปลงผลการค้นพบ สามารถแก้ไขได้ทั้งหมดในการตรวจทานพิสูจน์อักษรครั้งสุดท้าย ซึ่งเป็นเหตุผลที่เราแนะนำให้ตรวจสอบตัวยึดตำแหน่งและหมายเลขการอ้างอิงทุกตัวกับรายการตรวจสอบก่อนส่ง
วิธีกรอกเช็คลิสต์ STROBE-MR ของคุณเองให้ครบถ้วน
แบบตรวจสอบ STROBE-MR จะได้ผลดีที่สุดเมื่อกรอกข้อมูลในขณะที่กำลังเขียนต้นฉบับ ไม่ใช่หลังจากที่ผู้ตรวจทานขอมา ขั้นตอนด้านล่างนี้เรียงตามลำดับที่คำตอบมักจะพร้อมใช้งาน
- ดาวน์โหลดรายการตรวจสอบจาก เว็บไซต์ STROBE-MR หรือจากเอกสารคำอธิบาย [1]และเพิ่มคอลัมน์สำหรับหน้าหรือส่วนที่แต่ละคำตอบปรากฏอยู่
- สร้างตารางแหล่งข้อมูลตั้งแต่เนิ่นๆ ในส่วนวิธีการ โดยระบุตัวระบุชุดข้อมูล ลักษณะทางพันธุกรรม เชื้อสาย ขนาดตัวอย่าง จำนวนเคส และโครงสร้างจีโนม ดังตัวอย่างในตารางที่ 1
- เขียนประโยคที่แสดงส่วนที่ทับซ้อนกัน แม้ว่าส่วนที่ทับซ้อนกันจะเป็นศูนย์ก็ตาม หากคุณไม่สามารถนับได้ ให้ระบุขอบเขต
- รายงานค่าสถิติ F และความแปรปรวนที่อธิบายได้สำหรับแต่ละตัวแปร จากนั้นเพิ่มข้อความแสดงกำลังการทดสอบสำหรับขนาดผลกระทบที่สำคัญ
- ระบุสถานะการลงทะเบียน รวมถึงระบุอย่างชัดเจนว่าไม่มีการลงทะเบียนหากเป็นเช่นนั้น เนื่องจากข้อ 9b ต้องการคำชี้แจงไม่ว่ากรณีใดก็ตาม
- กรุณาแนบโค้ดและชุดข้อมูลที่ปรับให้สอดคล้องกันก่อนส่งงาน และแทนที่ตัวยึดตำแหน่งทั้งหมดด้วยลิงก์
- สำหรับแถวที่ไม่เกี่ยวข้อง ให้เขียนเหตุผลสั้นๆ หนึ่งบรรทัดลงในแถวนั้นแทนที่จะปล่อยว่างไว้
- ระบุในส่วนวิธีการศึกษาว่าการศึกษาครั้งนี้ใช้วิธี STROBE-MR และแนบแบบตรวจสอบที่กรอกข้อมูลครบถ้วนหากวารสารร้องขอ รายการตรวจสอบการส่งต้นฉบับ แสดงรายการไฟล์อื่นๆ ที่โปรแกรมแก้ไขคาดหวัง
ข้อผิดพลาดที่พบบ่อยในการรายงานผลการศึกษาแบบสุ่มทางพันธุกรรม (Mendelian Randomization)
นี่คือข้อผิดพลาดที่เราคาดว่าจะพบเห็นบ่อยที่สุดเมื่อกรอกแบบตรวจสอบ STROBE-MR ล่าช้า และแต่ละข้อผิดพลาดจะตรงกับรายการเฉพาะรายการใดรายการหนึ่ง
- การตั้งชื่อชุดข้อมูลโดยไม่ให้คำอธิบาย ข้อ 4 ต้องการข้อมูลประชากร วันที่ ขนาดตัวอย่าง และคำจำกัดความของกรณีศึกษาสำหรับแต่ละแหล่งข้อมูล
- รายงานเฉพาะค่าประมาณหลักเท่านั้น ข้อ 8 และ 13 ต้องการการวิเคราะห์ความไวทั้งหมด รวมถึงการวิเคราะห์ที่ขัดแย้งกันด้วย
- ไม่แสดงสถานะการลงทะเบียน ข้อ 9b ต้องการคำตอบไม่ว่าจะเป็นทางใดทางหนึ่งก็ตาม
- การใช้ภาษาเชิงสาเหตุทำให้ข้อสันนิษฐานเหล่านั้นใช้ไม่ได้ผล ข้อที่ 16 ขอให้ผู้เขียนระบุว่า การประมาณการนั้นมีความสัมพันธ์เชิงสาเหตุก็ต่อเมื่ออยู่ภายใต้สมมติฐานที่ระบุไว้เท่านั้น
- โค้ดที่น่าสนใจ ข้อ 19 ต้องการรหัสหรือตำแหน่งที่ตั้ง และลิงก์ในอนาคตไม่ใช่ตำแหน่งที่ตั้ง
คำถามที่พบบ่อยเกี่ยวกับรายการตรวจสอบ STROBE-MR
รายการตรวจสอบ STROBE-MR มีกี่รายการ?
รายการตรวจสอบ STROBE-MR มี 20 รายการ และหลายรายการมีรายการย่อยที่มีตัวอักษร ดังนั้นแบบฟอร์มที่กรอกเสร็จสมบูรณ์จึงมีมากกว่า 20 แถว[1 ]
STROBE-MR ใช้แทนเช็คลิสต์ STROBE ได้หรือไม่?
สำหรับการรายงานผลการศึกษาแบบ Mendelian randomization นั้น ควรใช้ STROBE-MR เป็นแนวทาง ส่วนสำหรับการศึกษาเชิงสังเกตแบบทั่วไป ให้ใช้ STROBE ซึ่งเราได้อธิบายไว้ในคู่มือการใช้งาน STROBE แล้ว
ควรใช้ STROBE-MR ในการประเมินคุณภาพของงานวิจัยที่ตีพิมพ์หรือไม่?
ไม่ ผู้เขียนระบุว่ารายการตรวจสอบ STROBE-MR ไม่ควรเปลี่ยนเป็นมาตราส่วนคุณภาพ และมีไว้เพื่อให้การประเมินเป็นไปได้ ไม่ใช่เพื่อดำเนินการประเมิน[1 ]
จำเป็นต้องมีการคำนวณกำลังไฟฟ้าเพื่อตอบสนองข้อ 4b หรือไม่?
ข้อ 4b ของแบบตรวจสอบ STROBE-MR ขอให้ผู้เขียนรายงานขนาดตัวอย่างและว่าได้มีการคำนวณกำลังหรือขนาดตัวอย่างก่อนการวิเคราะห์หลักหรือไม่ คำตอบที่ว่าไม่ได้ดำเนินการใดๆ ถือเป็นคำตอบที่ถูกต้อง และการคำนวณภายหลังควรระบุไว้เช่นนั้น ดังตัวอย่างที่แสดงไว้
เครื่องมือวิจัยฟรีจาก Editverse
- กราฟโปรสร้างแผนภูมิพร้อมเผยแพร่ได้ 25 แบบ พร้อมฟังก์ชันคำนวณค่า p-value ของ t-test, ANOVA, ความสัมพันธ์ และไคสแควร์ ในตัว ฟรี ไม่ต้องลงทะเบียน
- สแตทโปร: เครื่องมือคำนวณทางสถิติฟรี และเครื่องมือเลือกแบบทดสอบที่ครอบคลุมการเปรียบเทียบกลุ่ม ผลลัพธ์เชิงหมวดหมู่ การวิเคราะห์ระยะเวลาจนถึงเหตุการณ์ และความแม่นยำในการวินิจฉัย
- โฟลว์ชาร์ท โปร: สร้างแผนผังกระบวนการทำงาน PRISMA 2020, PRISMA-ScR, CONSORT, STROBE, STARD, MOOSE และ ARRIVE ได้โดยตรงในเบราว์เซอร์ของคุณ
การให้คำปรึกษาเชิงวิชาชีพสำหรับต้นฉบับงานวิจัยแบบ Mendelian Randomization
แบบตรวจสอบรายการสามารถบันทึกได้เฉพาะสิ่งที่การวิเคราะห์ได้ดำเนินการไปแล้วเท่านั้น ไม่ว่าคุณจะกำลังวางแผนการวิเคราะห์หรือเตรียมที่จะกรอกแบบตรวจสอบรายการ STROBE-MR ให้เสร็จสมบูรณ์ Editverse สนับสนุนผู้เขียนในทั้งสองขั้นตอน และงานของเราเป็นไปตามแนวทางของ COPE, ICMJE และ GPP 2022 โดยคำนึงถึงข้อกำหนดด้านจริยธรรมเฉพาะสถาบันและเฉพาะประเทศ ชุดเอกสารการศึกษาฉบับสมบูรณ์ด้านล่างนี้ประกอบด้วยแบบตรวจสอบรายการ STROBE-MR ที่กรอกเสร็จสมบูรณ์แล้ว
ก่อนที่คุณจะตัดสินใจ
$450
นักวิเคราะห์อาวุโสจะตรวจสอบว่าคำถามของคุณมีคำตอบแล้วหรือไม่ ข้อมูลสนับสนุนได้หรือไม่ และคุณมีกำลังการวิเคราะห์เพียงพอหรือไม่ รวมถึงความแข็งแกร่งของเครื่องมือสำหรับการออกแบบการสุ่มแบบเมนเดล (Mendelian randomization design) หักลบเต็มจำนวนสำหรับงานวิจัยที่คุณว่าจ้าง ระยะเวลาดำเนินการ 5 วันทำการ
การศึกษาแบบเต็ม
$2,900
การสุ่มแบบเมนเดลสองกลุ่มตัวอย่างจากสถิติสรุป GWAS สาธารณะ พร้อมความแข็งแกร่งของเครื่องมือ การกรองแบบ Steiger ตัวประมาณค่าสี่ตัวที่ตรวจสอบพลีโอโทรปี MR-PRESSO ต้นฉบับ แผนภูมิ โค้ด TwoSampleMR ที่ใช้งานได้ และรายการตรวจสอบ STROBE-MR 15 วันทำการ
ส่งต้นฉบับของคุณและวารสารที่คุณสนใจมาให้เรา แล้วเราจะบอกว่าวารสารใดเหมาะสมกับคุณที่สุด
สรุป
แบบตรวจสอบ STROBE-MR เปลี่ยนงานวิจัยเกี่ยวกับการสุ่มแบบเมนเดล (Mendelian randomization) จากชุดผลลัพธ์ให้เป็นสิ่งที่ผู้อ่านสามารถตรวจสอบได้ เมื่อนำไปใช้กับงานวิจัยแบบเปิดเผยข้อมูลจริง ๆ แล้ว จะแสดงให้เห็นว่าการรายงานที่ดีควรเป็นอย่างไร โดยมีกรณีที่เลวร้ายที่สุดที่ระบุปริมาณไว้ บันทึกที่ตรงไปตรงมาเกี่ยวกับการทดสอบที่มีกำลังต่ำ และแผนภาพการออกแบบในหน้าแรกของส่วนวิธีการ และยังแสดงให้เห็นว่าแม้แต่งานวิจัยที่รอบคอบก็ยังมีช่องว่างอยู่ตรงไหนบ้าง ได้แก่ การลงทะเบียน การระดมทุน ตัวแปรควบคุม และรหัสโปรแกรม กรอกแบบตรวจสอบให้ครบถ้วนก่อนส่ง เขียนเหตุผลในทุกแถวที่ไม่เกี่ยวข้อง และตรวจสอบทุกตัวยึดตำแหน่งและหมายเลขอ้างอิงในฉบับพิสูจน์อักษรขั้นสุดท้าย
อ้างอิง
- Skrivankova VW, Richmond RC, Woolf BAR, Davies NM, Swanson SA, VanderWeele TJ และคณะ การเสริมสร้างความเข้มแข็งในการรายงานการศึกษาเชิงสังเกตในระบาดวิทยาโดยใช้การสุ่มแบบเมนเดล (STROBE-MR) คำอธิบายและการขยายความ BMJ. 2021;375:n2233. doi:10.1136/bmj.n2233. PMID 34702754. PMC8546498.
- Skrivankova VW, Richmond RC, Woolf BAR, Yarmolinsky J, Davies NM, Swanson SA และคณะ การเสริมสร้างความเข้มแข็งในการรายงานผลการศึกษาเชิงสังเกตในระบาดวิทยาโดยใช้การสุ่มแบบเมนเดล (Mendelian randomization) คำแถลง STROBE-MR JAMA. 2021;326(16):1614-1621. doi:10.1001/jama.2021.18236. PMID 34698778.
- Zaka A, Khan S, Shah A, Khalid AA, Khalil I, Kamrul-Hasan ABM. ความสัมพันธ์ระหว่างระดับ 25-ไฮดรอกซีวิตามินดีที่ทำนายได้จากพันธุกรรมและความเสี่ยงต่อโรคเบาหวานชนิดที่ 2 ในชาวเอเชียใต้ การศึกษาแบบสุ่มทางพันธุกรรมแบบสองกลุ่มตัวอย่างเชิงสำรวจ เอ็นโดครินอล เบาหวาน เมตาบ. 2026;9(6):e70359. doi:10.1002/edm2.70359. PMID 42912852. PMCID PMC13690357ลิขสิทธิ์ CC BY 4.0
- Woolf B, Di Cara N, Moreno-Stokoe C, Skrivankova V, Drax K, Higgins JPT และคณะ การตรวจสอบความโปร่งใสของการรายงานในข้อมูลสรุปสองกลุ่มตัวอย่างในการศึกษาการสุ่มแบบเมนเดลโดยใช้แพลตฟอร์ม MR-Base Int J Epidemiol. 2022;51(6):1943-1956. ดอย:10.1093/ije/dyac074. PMID35383846. PMC9749715.
- Loh M, Zhang W, Ng HK, Schmid K, Lamri A, Tong L และคณะ การระบุผลกระทบทางพันธุกรรมที่เป็นสาเหตุของโรคเบาหวานประเภทที่ 2 ในประชากรเอเชียใต้และยุโรป คอมมูน ไบโอล. 2022; 5: 329 doi:10.1038/s42003-022-03248-5PMID 35393509
ถ้อยคำในแนวทางนี้เรียบเรียงใหม่จากเอกสารอธิบาย STROBE-MR ซึ่งเผยแพร่ภายใต้ลิขสิทธิ์ CC BY 4.0 ข้อแนะนำของ ICMJE สามารถดูได้ที่icmje.org